登录社区云,与社区用户共同成长
邀请您加入社区
$\psi_0$是面向人形机器人的视觉语言动作模型,采用三系统架构:冻结的VLM(Qwen3-VL)负责理解指令,MM-DiT生成流式动作,独立RL模型控制下半身以提升稳定性。通过动作分块实现低延迟连续执行,结合第一视角灵巧任务数据采集与高效数据利用策略,在真实机器人上实现高精度操作。核心思想在于“用好数据”而非“堆数据”,显著提升训练效率与泛化能力。
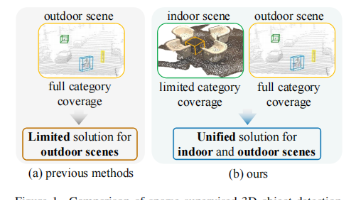
本文是对论文《Learning Class Prototypes for Unified Sparse Supervised 3D Object Detection》的深度解读。在 3D 目标检测领域,现有稀疏监督方法仅适用于室外场景,难以适配室内场景特异性类别。南京理工大学等团队提出的 CPDet3D 方法,通过学习类别原型挖掘未标注目标,结合多标签协同优化,实现室内外统一稀疏监督检测,在 Sc
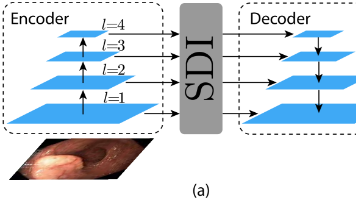
U-Net v2 模型通过创新的SDI模块优化医学图像分割中的跳跃连接机制。SDI模块利用Hadamard乘积融合高层语义与低层细节特征,结合空间和通道注意力机制增强特征表达。该模型可无缝集成到各类编解码器网络,为医学图像分割提供高效解决方案。
相较于传统CNN的局部感受野限制,Transformer能够有效捕捉如MRI、CT等图像中分布广泛的关键特征与复杂结构,从而提升对器官边界、病灶区域等细微结构的识别精度与分割一致性。为兼顾局部特征与全局语义,研究者构建了CNN与Transformer的混合模型。CNN负责提取图像中的局部纹理与形态特征,而Transformer则建模跨区域的上下文依赖。针对医学图像中病灶尺寸与形态差异显著的特点,多
其核心思路在于,运用层次化分解(hierarchical decomposition)将不同频率的模式分别处理,随后借助跨尺度注意力(cross-scale attention)机制实现特征融合。最新的研究成果是将因果图转换为图神经网络(graph neural network)的结构,并在消息传递(message passing)过程中强制实施因果约束。最新的研究成果是运用基于梯度的元学习(gr
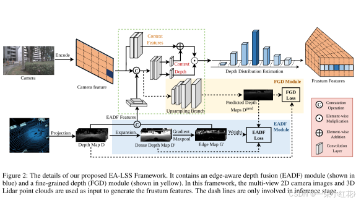
近年来,基于 Lift-Splat-Shot(LSS)的三维目标检测方法取得了显著进展。然而,深度估计不准仍是制约纯视觉及多模态三维检测模型精度的关键瓶颈,尤其在深度突变区域(即“深度跳变”问题)。本文提出了一种新颖的边缘感知 Lift-Splat-Shot(EA-LSS)框架。具体而言,我们设计了边缘感知深度融合(EADF)模块来缓解“深度跳变”问题,并引入细粒度深度(FGD)模块进一步加强对深
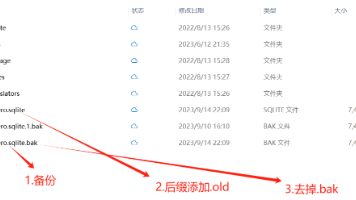
Zotero本地数据误删恢复指南:通过关闭自动同步,在Zotero安装目录的data文件夹中找到.bak备份文件(含条目数据,不含附件),选择合适日期的备份文件进行恢复。重启Zotero后,本地数据将回溯至备份点,但需注意此操作会丢失备份点后的本地修改。最后通过同步设置中的"替换在线文献库"选项,用恢复的本地数据覆盖云端数据。该方案可恢复条目但无法找回附件文件。
在大模型时代,多模态目标检测领域正迎来新的发展机遇与挑战。但由于全量微调成本过高,使得高效迁移学习与特征融合在多模态目标检测中的重要性愈发凸显。当前,相关研究正围绕模型高效迁移与参数更新、任务驱动动态融合、统一知识迁移框架、鲁棒迁移与领域泛化等方向展开创新。本文整理了多篇相关论文,旨在帮助读者了解前沿动态,掌握研究思路,助力大家在该领域取得突破。
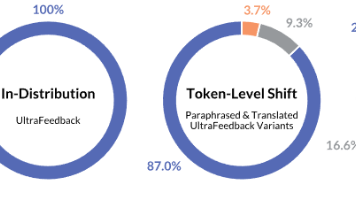
本文解读了论文《Why is Your Language Model a Poor Implicit Reward Model?》的核心发现。文章聚焦显式奖励模型(EX-RMs)和隐式奖励模型(IM-RMs)的泛化差距,通过理论分析和实验验证,指出IM-RMs因过度依赖表面文字线索,在文字表达方式变化(如释义、翻译)时表现较差,而EX-RMs更关注深层语义,泛化能力更强。同时,论文推翻了“IM-R
北大与阿里合作的BEVFusion提出了一种鲁棒性更强的BEV融合框架,核心创新在于解耦的双流架构设计。不同于主流方法依赖LiDAR查询相机特征,该框架让相机和LiDAR各自独立生成BEV特征,再通过轻量级融合模块结合。实验表明,在LiDAR故障场景下(如视场受限或点云缺失),该方法的性能优势达到15.7%-28.9% mAP,显著提升了自动驾驶系统的可靠性。与MIT版BEVFusion相比,本工
《VoxelNeXt:全稀疏体素网络的3D目标检测与追踪》提出了一种创新的全稀疏检测框架,挑战了传统依赖密集特征转换和代理预测的范式。该模型通过增强稀疏主干的感受野、采用稀疏预测头和独特的体素关联追踪机制,实现了端到端的稀疏检测流程。实验表明,VoxelNeXt在nuScenes等多个基准测试中取得领先性能,预测头计算量仅为密集方法的4%,同时消除了NMS后处理需求。研究表明物体预测可不依赖中心位
SECOND论文提出了一种高效的3D目标检测框架,主要创新包括:1) 采用稀疏卷积处理体素化点云,显著降低计算量;2) 设计正弦误差损失函数解决角度回归难题;3) 提出真值采样的数据增强方法提升模型性能。实验表明,该方法在KITTI数据集上实现20-40 FPS的实时检测,精度超越VoxelNet等基准模型。该研究为基于体素的3D检测提供了高效解决方案,对后续工作具有重要影响。
Flink介绍——实时计算核心论文之Storm论文总结
本文介绍了 Twitter 对 Storm 的使用情况。Storm 是一个实时、容错的分布式流数据处理系统。目前,Twitter 正大规模实时运用 Storm 来运行各种关键计算任务。本文阐述了 Storm 的架构,以及它实现分布式扩展和容错的方法。同时,本文还说明了查询(即拓扑结构)在 Storm 中是如何执行的,并分享了一些基于 Twitter 运行 Storm 的实际操作案例。我们还给出了实
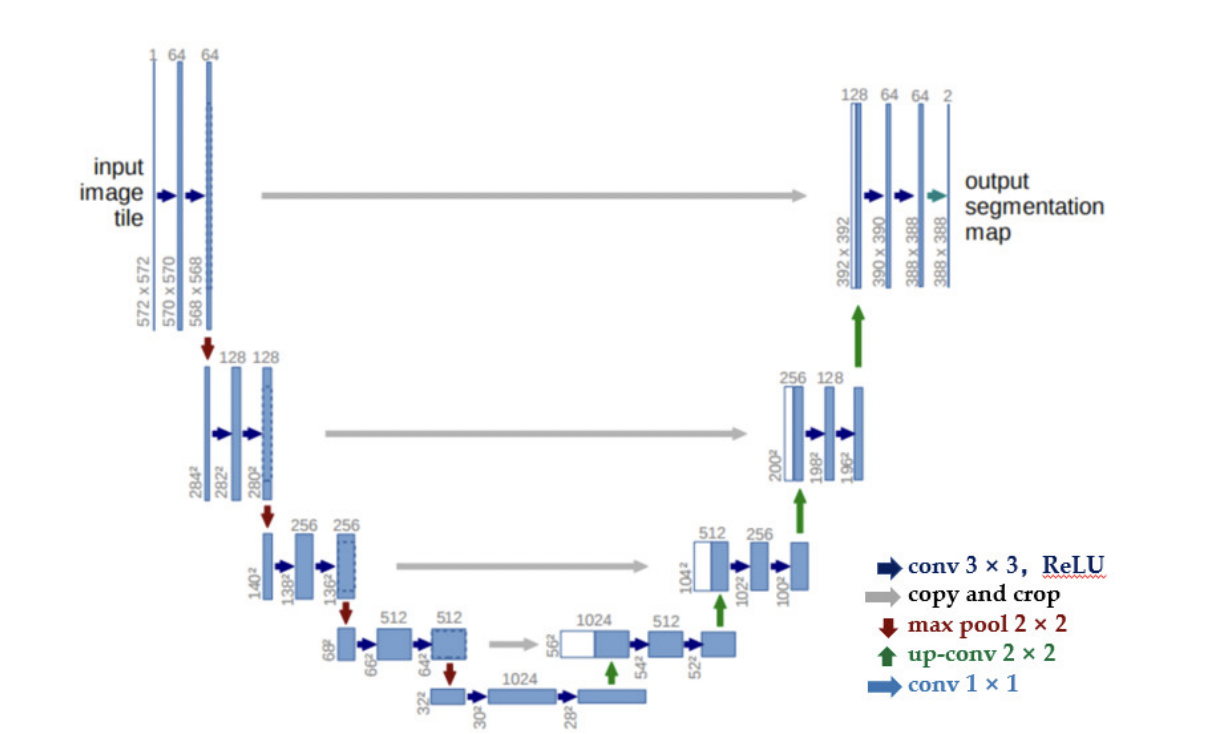
本文主要对近七年U型网络改进工作,Transformer与U型网络的结合,在Synapse和ACDC数据集上进行对比实验,最后证明transformer在图像分割上更有优势。创建新变体过程如旋转,剪切,擦除,噪点引入,遮挡,弹性变形,缩放等。黄高博士在DenseNet[26]中提出,在神经网络 中,先前层与后续层相连接共同作为下一层的输入,通过最大 化信息流以消除梯度消失,并加强特征传播、鼓励特征
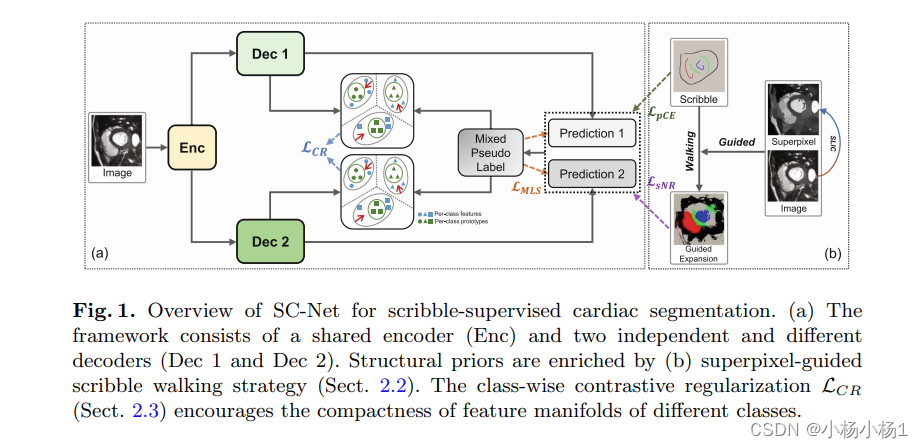
基于深度学习的分割通常需要大量数据和密集的手动描绘,这既耗时又昂贵。因此,弱监督学习试图利用稀疏的注释(如涂鸦)进行有效训练,引起了相当大的关注。然而,这种涂鸦监督本质上缺乏足够的结构信息,导致了两个关键挑战:(i)虽然在dice分数指标上取得了良好的性能,但现有方法难以执行令人满意的局部预测,因为在训练期间无法获得所需的结构先验;(ii)由于稀疏和极不完全的监督,类特征分布不可避免地不那么紧凑,
这些模型通常被设计和训练用于特定的分割任务,当应用于新任务或不同类型的成像数据时,它们的性能可能会显著下降。我们通过汇总公开可用的医学图像分割数据集中的图像,策划了一个全面的数据集,这些数据集从互联网上的各种来源获得,包括癌症影像档案(TCIA)、Kaggle、Grand-Challenge、Scientific Data、CodaLab以及医学图像计算和计算机辅助干预学会(MICCAI)的分割挑
最近,Segmentation Anything 模型(SAM)(Kirillov 等人,2023年)因其强大和多功能的视觉分割模型能力而受到了显著关注。它可以基于用户提示生成多样化和详细的分割掩模。尽管在自然图像上表现出色,许多最近的研究也显示(Deng 等人,2023年;Roy 等人,2023年;He 等人,2023年),其在医学图像分割上的表现不尽人意。使医学图像分割变得互动,例如采用像 S
尽管“分割任何模型”(SAM)在2D自然图像分割方面展示了令人印象深刻的性能,但其应用于3D体积医学图像时却显示出明显的不足,主要表现为次优的性能和不稳定的预测,需要过多的提示点才能达到期望的结果。我们的SAM-Med3D擅长捕捉3D空间信息,在医学领域的顶尖微调SAM中,以显著更少的提示点展示了具有竞争力的性能。撇开2D SAM方法和我们的SAM-Med3D之间的数值结果差异不谈,一个训练有素的
我们还对原始SAM的编码器和解码器进行了额外的微调,获得了性能良好的SAM-Med2D,这导致了迄今为止最全面的微调策略。我们比较了两种微调方法在30多个主要器官上的表现,我们的SAM-Med2D在24个器官上取得了更好的结果,与FT-SAM相比,最大改进了6.95%。然而,由于医学图像的特点,如众多的成像模式、复杂的组织和器官结构,以及少量的标注数据,大多数现有方法仅限于特定的模式、器官或病变。
总结一下今年2月第一次参加美赛的心得体会。
【论文阅读】DeepLab:语义图像分割与深度卷积网络,自然卷积,和完全连接的crf
步骤 1 时间序列的平稳性检验.通常采用 ADF 或 PP 检验方法,对原始序列进行单位根检验(判断平不平稳).如果序列不满足平稳性条件,可以通过差分变换或者对数差分变换,将非平稳时间序列转化为平稳时间序列,然后对平稳时间序列构建 ARIMA 模型;步骤 3 参数估计与诊断检验.包括检验模型参数的显著性,模型本身的有效性以及检验残差序列是否为白噪 声序列.如果模型通过检验,则模型设定基本正确,否则
中国计算机学会推荐国际学术会议和期刊目录
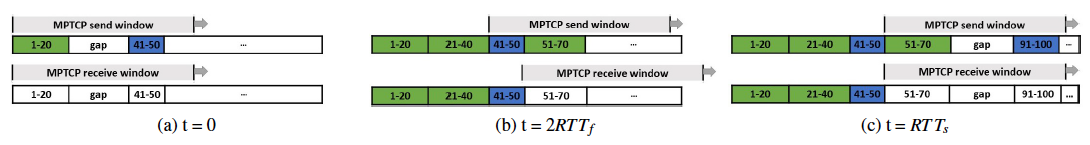
MPTCP与MPQUIC多路径传输数据包调度研究梳理总结。
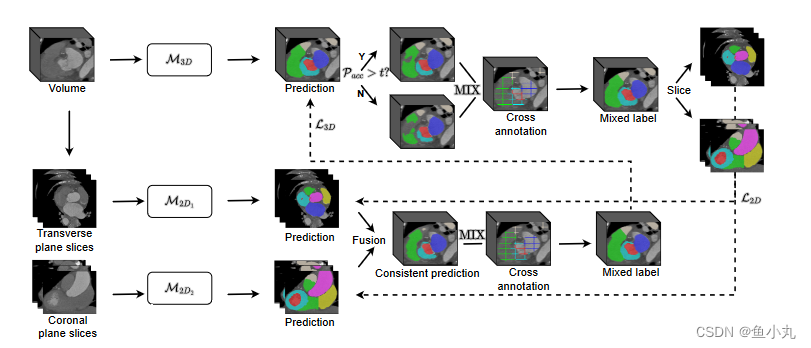
3D和2D网络相互监督 稀疏注释下,3D医学图像分割。
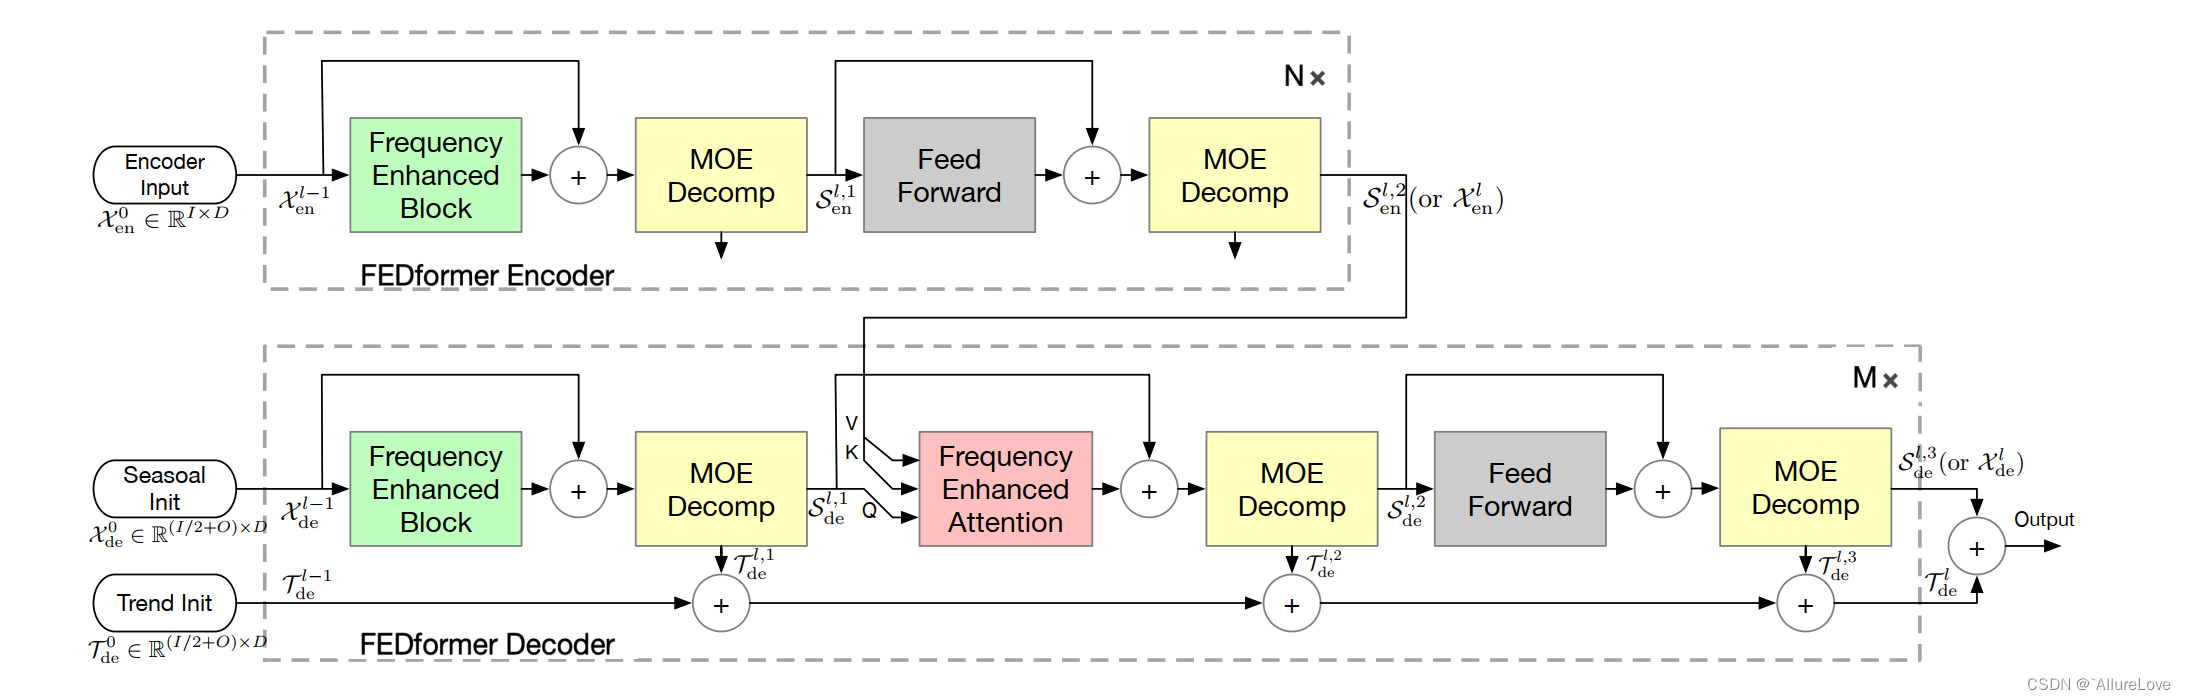
论文地址:github地址:参考解读:快速傅立叶变换:本文是阿里达摩院的一篇文章,也是针对长序列预测的,文章背景有以下几点:整体架构感觉和Autoformer有点类似,但是细节层面上的创新点主要体现在以下几个方面:Xx1...xd]Aa1...am∈Rm∗ddssdxqx∗wQQRY^UdL)UsL)XL1。
在前言中我们可以进行以下设置:设置文档的格式,这里我们需要引入数模论文格式文件cumcmthesis.cls;导入宏包以便后期论文的细致排版,如导入输出数学公式所需的宏包amsmath;设置标题。\title{基于...的...分析}在正文中介于\begin{abstract}和\end{abstract}之间的内容称为文档的摘要,并以\keywords显示关键词;\documentclass[w
论文笔记-时序预测-Autoformer
论文笔记-时序预测-FEDformer
论文笔记-时序预测-Informer
论文笔记-时序预测-Pyraformer
图像分割系列改进论文如何寻找自己的创新点呢?重点是如何发?下面将提供几种总结思路。
Cosmos Policy 基于预训练视频模型 Cosmos-Predict2,通过潜在帧插入将机器人多模态信息(如动作、感知、未来状态)以11类潜帧形式融入扩散模型序列,实现跨模态统一建模。其核心为构建世界模型、策略与价值函数,并通过策略生成rollout微调后两者,提升预测能力。推理支持并行与自回归解码,结合规划机制实现高效动作决策。该框架实现了从通用视频生成到机器人任务的高效迁移。
语言模型输出对于现实机器人来说,不可行也无用。图1举了一个例子——一个厨房机器人能够执行诸如“捡起海绵”或“去桌子旁”等技能,可能会被请求帮忙清理洒出的液体(“我洒了饮料,你能帮忙吗?”)。语言模型可能会用一个合理的叙述回应,但这对机器人来说既不可行也无用。如果场景中没有吸尘器,或者机器人无法使用吸尘器,“你可以试试吸尘器”是不可能的。通过提示工程,LLM或许能够将高阶指令拆分为子任务,但如果没有
π0基于VLM构建动作专家,创新流匹配机制:从随机噪声逐步去噪生成动作序列,利用全双向注意力提升平滑性,并采用预训练加后训练范式,在互联网数据上预训练,再以高质量任务数据微调,以激发复杂灵巧操作。
TurboVLA提出无需LLM的VLA架构,以视觉-语言交互融合替代传统V-L-A级联,0.2B参数,RTX4090实时推理小于1GB显存,性能媲美大模型。通过交叉注意力、轻量解码器实现高效动作生成。强调其新路径价值。控制字数。</think>本文笔记介绍了TurboVLA:一种无需LLM的VLA新架构,通过视觉-语言交叉注意力直接
OpenVLA,主要解决的核心问题,是面对封闭式VLA的获取困难,以及缺少针对新任务而微调VLA的方法。基本方面:参数量70亿,开源,970k个来自真实世界集合的训练数据。构建方面:基于Llama 2 语言模型,加一个融合的预训练特征的视觉编码器。结果方面:在原任务和泛化任务上均表现强劲。参数量相比之下很小,而且可以通过特殊方法在消费级GPU上微调和部署。基本介绍到这里。总体核心思路1 - 机器人
本文介绍了一套高效阅读机器人领域学术论文的方法论。建议采用三遍阅读法:快速浏览筛选论文,重点理解核心方法,深入细节复现关键算法。强调建立论文队列、做结构化笔记、团队分享讨论的重要性,并指出论文方法与工程实践的差距在于假设条件不同,需要针对性适配。文章还提供了应对面试提问的技巧,建议通过持续练习培养论文阅读直觉,构建领域知识图谱。这套方法能帮助工程师高效跟踪前沿技术,将学术成果转化为工程实践。
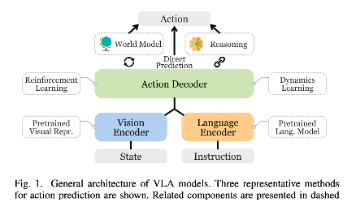
VLA综述论文详解
<think>我们已知用户要求:根据给出的内容,生成≤150字的文章摘要。内容是关于VLA的综述笔记,包含定义、组件、方法等。我们需要用中文写一个简洁摘要,不超过150字。注意是"文章摘要",要概括核心内容。不要遗漏重要信息。字数限制严格。我们将组织语言:VLA定义,本文综述其组件(视觉编码器、动力学、世界模型),控制策略,任务规划,挑战等。保持紧凑。</think>摘要:本文综述具身智能中的视觉
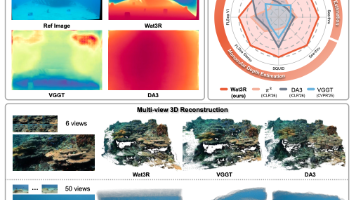
为什么值得关注?Wat3R 展示了“大模型+无监督/半监督迁移”在极度缺乏标注的恶劣环境(如水下、极端天气、航天)中应用的巨大潜力。它证明了利用简单的物理退化合成 + 大规模无标注视频,就能把陆地上学到的强几何先验完美迁移。谁应该继续阅读原论文?从事水下机器人(AUV)、水下 3D 扫描、SLAM 系统的工程研发人员,以及研究 Cross-Domain SSL、3D Feed-forward Re
涨幅能复制吗?很难。能复制的是路径:核心部件、极致降本、真实订单。概念可以点火,业绩才能续航。首日暴涨本质是市场对未来利润的提前定价——涨是价格,信是预期;真正的护城河,是把预期做成产能。这一轮周期里,慢就是新的快。
本文介绍了ICCV 2025的工作《GWM: Towards Scalable Gaussian World Models for Robotic Manipulation》,提出了一种基于3D高斯表示的新型世界模型Gaussian World Model (GWM)。该模型通过结合3D高斯溅射与扩散Transformer,实现了机器人操作任务中未来场景的准确预测。GWM包含两个核心组件:3D高斯
为什么值得关注?毫秒级在线重规划+合理的物理约束,完全可以让现有的机械臂具备媲美人类的动态抛接协同能力。它代表了物理人机交互(pHRI)从“静态互递”迈向“动态互抛”的重要里程碑。谁应该继续阅读原论文:从事机器人动力学、在线轨迹优化(MPC/SQP)、动态抓取与高精控制的硬核科研人员,原论文的约束公式设计细节极具借鉴意义。谁只看导读即可:仅需了解机器人前沿动态、具身智能应用场景或做技术泛读的同学,
前面阅读的 Agent 记忆工作,大多在回答一个问题:Agent 应该怎样保存、组织和召回过去的信息?Mem0 关注记忆的新增、更新和删除;A-MEM 关注记忆之间如何动态建立关联;MAGMA将长期经历组织成语义、时间、因果和实体多图,并根据查询意图选择关系;3DLLM-Mem 将长期记忆扩展到具身环境,用 Working Memory 查询并融合历史Agentic Plan Caching 则进
知芽的深度综述报告功能通过知识库构建、文档理解、观点关联和矛盾发现等技术环节,实现了从文献到可编辑综述的自动化流程。其核心价值在于将AI生成与引用校验结合,形成可追溯的学术写作辅助工具,而非单纯追求生成速度。使用时应明确其定位:作为叠加在传统文献管理工具上的智能工作台,既非完全自动化的"幽灵文献"生成器,也非仅提供摘要的对话机器人,而是连接资料收集与内容产出的中间层解决方案。
适用场景:项目启动阶段,10分钟完成文献综述框架搭建,为后续所有写作提供可靠数据底座。适用场景:中段写作,用它批量产出证据充足的内容,初稿速度提升3倍以上。适用场景:内容成型后,用它统一学术风格,节省大量手动润色时间。这4款工具不是简单“聊天机器人”,而是专为学术长文设计的生产力神器:覆盖从文献采集到终稿优化的全链条,帮你把精力放在核心创新上。2026年,它们已成熟适配中文科研环境,零门槛上手,直