【三维感知目标检测论文阅读】《BEVFusion: A Simple and Robust LiDAR-Camera》
继昨天讲解的由MIT提出的BEVFusion后,今天我们来看由北大和阿里合作的BEVFusion。虽然与MIT提出的BEVFusion同名且均发表于2022年,但侧重点有所不同。它提出了一个更为简洁且鲁棒的BEV融合框架,特别关注于解决由于LiDAR失效等异常情况下的鲁棒性问题。将两篇BEVFusion对比阅读,可以深入理解BEV融合的不同实现路径和设计哲学。
【三维感知目标检测论文阅读】《BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird‘s-Eye View Representatio》
论文链接:BEVFusion: A Simple and Robust LiDAR-Camera
1. 论文概述 (Overview)
这篇论文的核心论点是:当前主流的LiDAR-相机融合方法存在一个被忽视的致命缺陷——它们严重依赖LiDAR输入来查询(query)相机特征。无论是点级别融合还是特征级别融合,都是以LiDAR信息为起点。这意味着,一旦LiDAR出现故障(哪怕是局部或短暂的),整个融合框架就会失效,无法产生任何有效预测。这极大地限制了这类算法在真实场景的部署能力。
为了解决这个问题,论文提出了一个设计巧妙、思想简洁的BEVFusion框架。其核心是一种解耦(disentangled)的双流架构:相机和LiDAR分别在两个完全独立的流中提取特征并生成各自的BEV(鸟瞰图)特征图,最后再通过一个轻量级的融合模块进行结合。这种设计的最大优点在于,相机流的运行完全不依赖LiDAR的任何输入,从而根本上解决了前述的依赖问题。
实验证明,该框架不仅在正常训练设置下性能超越了当时的SOTA方法,更重要的是,在模拟LiDAR故障的鲁棒性测试中,它以15.7%至28.9% mAP的巨大优势碾压了其他方法,展现了其在真实复杂场景下的部署潜力。
2. 背景与动机:对“LiDAR依赖”融合的批判
论文开篇便一针见血地指出了当时SOTA融合方法的“阿喀琉斯之踵”——对LiDAR的强依赖性。如图1所示,当时的方法可以分为两类:
-
点级别融合 (Point-level Fusion):将原始的LiDAR点云投影到相机图像上,用这些投影点的位置去采样(sample)图像特征,然后将这些特征“画”回LiDAR点上。
-
特征级别融合 (Feature-level Fusion):先用LiDAR网络提取特征或生成3D提案(proposals),然后将这些LiDAR特征或提案投影到图像上,作为查询(query)来提取图像特征。
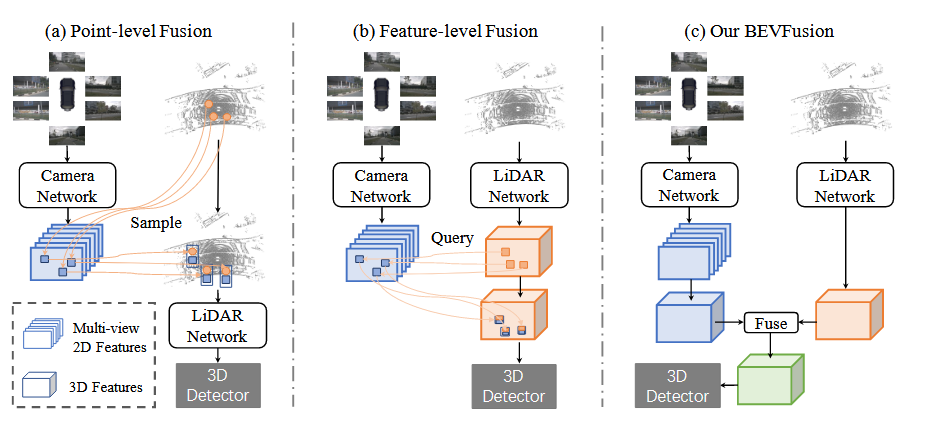
核心动机:这两种方式的共同点是,获取相机信息的“钥匙”始终掌握在LiDAR手中。在真实的自动驾驶环境中,LiDAR可能会因为各种原因出现故障:
-
物体表面材质特殊,导致激光反射率低,形成点云空洞。
-
系统内部数据传输出现瞬时故障。
-
LiDAR本身的视场角(FOV)有限,无法覆盖360度。
在这些情况下,依赖LiDAR作为查询的融合方法会立刻“瘫痪”。作者认为,一个理想的融合框架应当是:即便一种模态的数据失效,另一路模态依然能够独立工作并产生结果,而当两种模态都存在时,它们的结合能够进一步提升系统性能。BEVFusion正是为了实现这一目标而设计的。
3. BEVFusion 模型详解
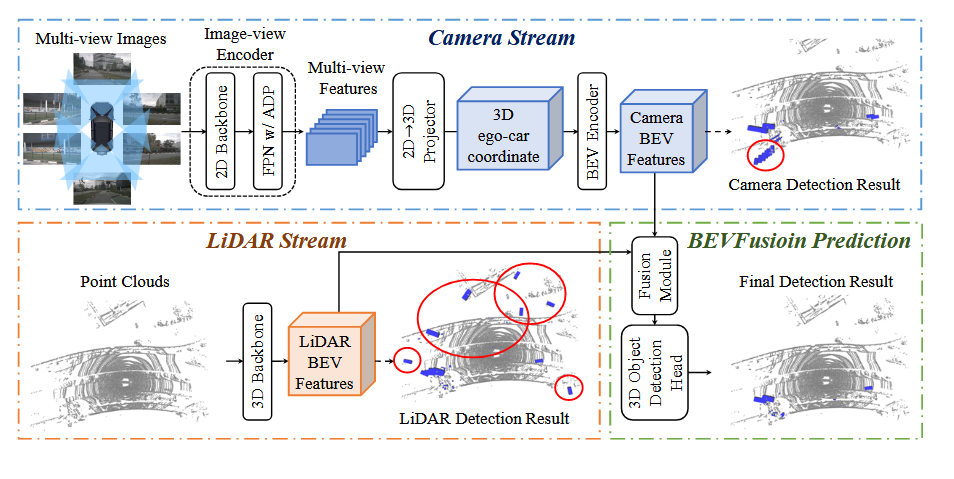
为实现上述目标,BEVFusion设计了一个清晰的解耦双流架构,如下图所示。
3.1. 两个独立的单模态数据流
框架包含两个完全并行的、端到端的单模态检测器,它们各自将传感器输入转换为BEV特征。
-
相机流 (Camera Stream):
-
输入:多视角相机图像。
-
流程:该流本身就是一个完整的、独立的相机3D检测器。它首先使用一个2D主干网络(如CB-Swin-Tiny)和FPN提取多尺度图像特征。然后,通过一个视图投射模块(View Projector),采用LSS (Lift-Splat-Shoot)的方式,预测像素深度并将2D图像特征“提拉(lift)”到3D空间,最后再“拍扁(splat)”到BEV平面,生成相机的BEV特征图。
-
特点:整个过程完全不涉及任何LiDAR数据。即使LiDAR输入为空,这个分支依然能独立完成3D检测。
-
-
LiDAR流 (LiDAR Stream):
-
输入:原始LiDAR点云。
-
流程:该流是一个标准的、独立的LiDAR 3D检测器。论文展示了它可以灵活地接入多种主流模型,如PointPillars , CenterPoint , 甚至是TransFusion-L ,来将点云编码为LiDAR的BEV特征图。
-
特点:这个分支的运行也完全不依赖相机数据。
-
3.2. 动态融合模块 (Dynamic Fusion Module)
在两个流各自生成了位于同一BEV空间下的特征图(F_Camera 和 F_LiDAR)后,一个轻量级的融合模块负责将它们结合起来。
-
工作原理:该模块首先将两个BEV特征图沿通道维度拼接(concatenate)。然后,受Squeeze-and-Excitation网络的启发,它采用一个简单的通道注意力机制。具体来说,它通过一个全局平均池化和一个小型MLP来学习一个通道注意力向量,然后用这个向量来动态地、自适应地重新加权拼接后的特征通道,从而让网络能够自主选择和强调更有用的特征。
-
后续处理:融合后的BEV特征图被送入一个通用的3D物体检测头(可以是基于锚框的、无锚框的或基于Transformer的)进行最终的预测。
4. 鲁棒性实验
这是本篇论文最核心的贡献之一。作者设计了两种贴近真实的LiDAR故障场景来验证其框架的鲁棒性:
-
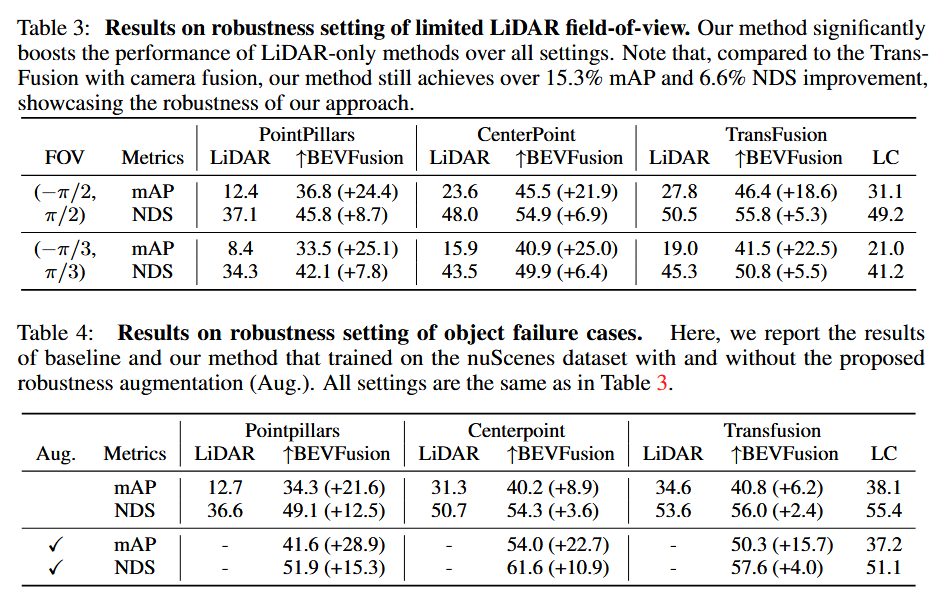
有限视场角(Limited FOV):通过程序限制LiDAR点云的有效视场角(如从360度缩减到180度或120度),模拟LiDAR部分损坏或使用非360度固态雷达的场景。
-
物体点云缺失(Objects Failure):模拟雨天或物体表面材质问题,以50%的概率随机移除一个物体内部的所有LiDAR点。
实验结果(表3、表4)非常惊人:在这些严苛的故障条件下,依赖LiDAR查询的融合方法(如TransFusion)性能急剧下降,而BEVFusion由于其独立的相机流能够“兜底”,性能远超对手,mAP提升幅度高达15.7% ~ 28.9%。这强有力地证明了其解耦设计的优越性和在真实世界中的部署价值。
5. 与MIT版BEVFusion的对比
-
核心动机不同:MIT版BEVFusion的核心动机是解决信息损失问题,即相机到LiDAR投影损失了语义信息,LiDAR到相机投影损失了几何信息,因此提出统一BEV空间是最佳选择。而北大/阿里版BEV-Fusion的核心动机是解决鲁棒性问题,即现有融合方法对LiDAR输入的强依赖性会导致系统在传感器故障时完全失效。
-
架构设计不同:尽管都采用了BEV作为统一空间,但架构有本质区别。MIT版是一个紧耦合的并行架构,相机和LiDAR分支必须同时存在才能完成一次前向传播。而北大/阿里版是一个解耦的双流架构,每个流都是一个独立的、可以端到端运行的检测器,融合是最后一步的可选增强。
-
技术贡献侧重不同:MIT版的核心技术贡献在于对视图转换(Camera-to-BEV)进行了极致的GPU级别优化,使其变得高效实用。北大/阿里版的核心技术贡献在于提出了“解耦双流”这一鲁棒的架构思想,并通过大量实验证明了其在传感器故障场景下的优越性。
总结来说,北大/阿里版的BEVFusion最大的、也是区别于所有前面论文的创新点在于:
-
深刻地洞察并指出了当时主流融合方法在系统鲁棒性上的致命缺陷——对LiDAR输入的强依赖性。
-
提出并验证了一个简洁、通用且极其鲁棒的“解耦双流”架构,使得每个传感器模态都能独立工作,而融合则作为性能的增强项,极大地提升了算法在真实世界中的可靠性和部署价值。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)