Embodied‑BenchForge:面向具身智能评测基准构建的闭环智能体工作流
Embodied‑BenchForge:面向具身智能评测基准构建的闭环智能体工作流
摘要
智能体系统为自动化构建具身评测基准提供了可行路径,但现有方案大多只能覆盖局部流程,且高度依赖预定义环境与任务集合。更关键的是,多步骤构建流程会产生存在依赖关系的中间制品;中间缺陷会不经校验直接向下游传递,污染最终基准。本文提出Embodied‑BenchForge,一套智能体框架,可以将用户指定的评测意图,完整转化为可执行的具身评测基准制品。本文将基准构建形式化为闭环基准合成(Closed‑Loop Benchmark Synthesis),融合正向制品合成与反向校验修复两大流程。
- 技能编排式制品合成:将类型化、可复用的技能组合成可执行工作流,同时维护制品依赖图,记录中间输出与相互依赖;
- 需求引导的校验与修复:为每一类制品绑定专属需求契约;校验失败时,依托溯源信息触发局部重执行或者上游回滚。
Embodied‑BenchForge产出两套评测赛道:离线问答赛道OE‑Track包含6套异构具身基准;交互式具身赛道IE‑Track包含220个完整可执行任务。对主流多模态大模型、具身智能体开展评测,证明该基准可以有效区分观测理解能力与闭环交互执行能力。质量评估、多组消融实验验证了基准质量以及校验‑修复模块的有效性;技能复用与修复案例分析证明框架具备局部恢复、跨基准复用能力。
关键词
具身AI;评测基准自动化构建;智能体工作流;闭环校验修复;技能编排
目录
- 引言
- 相关工作
- Embodied‑BenchForge框架
- 产出基准套件
- 实验
- 结论
- 参考文献
- 附录A OE/IE双赛道闭环质量控制
- 附录B 资源覆盖度与跨资源适配
- 附录C 技能分类体系与复用统计
- 附录D 构建开销与效率分析
- 附录E 实验细节与扩展结果
1 引言
多模态大模型、视觉‑语言‑动作模型推动具身智能从单纯感知,拓展到空间推理、任务规划、闭环交互。对应的具身评测基准覆盖问答、导航、家庭机器人操作等场景。可靠评测是定位模型能力边界的关键,但基准构建工作高度依赖人工。
现有自动化基准构建方案存在两大核心痛点:
- 强绑定特定环境:大多只能工作在预定义模拟器、固定任务家族;具身任务会用到图像、视频、轨迹、模拟器接口,输出包含问题、参考答案、任务指令、可执行验证器。把一份评测意图转化为整套异构制品,仍需要大量人工配置。
- 中间缺陷向下传播:基准构建包含源数据处理、证据抽取、状态结构化、任务合成、答案推导、验证器编写等一系列存在依赖关系的操作。缺少针对每一类制品的校验,中间环节错误会流入下游;仅在最终阶段做检查会浪费大量计算资源,全部重新生成又会丢弃已经校验通过的制品。
核心方案:闭环基准合成 Closed‑Loop Benchmark Synthesis。将正向的制品合成流程,和反向的校验、定位、局部修复结合。
- 正向:技能编排式制品合成,把构建操作封装为类型化可复用技能,依据评测意图组合成可执行工作流;维护制品依赖图,记录全部中间输出与依赖关系。
- 反向:需求引导的校验修复,为每类制品绑定结构、语义、执行类需求契约;校验失败时依托溯源信息,执行局部修复/上游回滚,仅重建受影响下游制品,保留其余已经校验通过的制品。
本文产出两套评测赛道:
- OE‑Track(Offline EQA 离线具身问答赛道):6套基准,覆盖家庭机器人、移动机器人、自动驾驶、机械臂、无人机、四足机器人;
- IE‑Track(Interactive Embodied交互式具身赛道):220个可执行交互任务,具备可恢复初始环境状态、动作接口、目标条件、终端验证器,同时保留交互轨迹,可支持轨迹问答。
评测11套开源/闭源模型,实验证明:该基准可以有效区分模型的观测理解能力和闭环执行完成任务能力。
本文贡献
- 提出Embodied‑BenchForge智能体框架,支持将用户评测意图,端到端生成异构的具身评测基准制品。
- 提出闭环基准合成范式:类型化技能编排合成 + 制品级需求契约 + 溯源引导局部修复/回滚。
- 构建OE‑Track、IE‑Track两套完整基准套件;大量实验验证制品质量、构建效率、技能复用性,揭示具身理解与闭环交互之间显著的模型能力鸿沟。
| 方法 | 端到端合成 | 可复用模块 | 异构资源支持 | 可执行制品 | 流程级校验修复 |
|---|---|---|---|---|---|
| AutoBencher | ✅ | ‑ | ‑ | ‑ | △ |
| BenchAgents | ✅ | △ | △ | ‑ | △ |
| Code2Bench | ✅ | △ | ‑ | ✅ | △ |
| RoboGen | △ | △ | ‑ | ✅ | △ |
| A2Eval | △ | △ | △ | △ | ‑ |
| Embodied‑BenchForge | ✅ | ✅ | ✅ | ✅ | ✅ |
✅完整支持;△部分支持;‑不支持。△代表仅有校验,不支持选择性局部重建。
2 相关工作
2.1 具身基准与任务生成
经典具身基准:ALFRED、LIBERO、EmbodiedScan、EmbodiedBench、OpenEQA,覆盖场景理解、导航、机器人操作。这些基准质量高,但构建绑定特定模拟器、资源与schema。
自动化生成方向:ProcTHOR、RoboCasa生成场景;MimicGen生成机器人演示;Eureka/RoboGen用大模型生成任务与奖励函数。这类方案局限于固定模拟器内部,无法从用户高层评测意图出发,端到端产出完整基准包。
2.2 自动化基准构建与校验
Dynabench、BenchBuilder、AutoBencher依靠人机交互、声明式需求生成NLP评测数据;BenchAgents分阶段智能体工作流;BenchBench引入心理测量学IRT分析;Code2Bench面向软件任务做依赖与覆盖率校验。
具身领域A2Eval是从已有基准做子集筛选,不生成全新可执行任务。
具身基准构建额外要求:观测、环境状态、证据、可行动作、目标、可执行验证器之间保持严格一致性。Embodied‑BenchForge通过可复用构建技能、制品专属需求契约、溯源引导修复解决该问题。
3 Embodied‑BenchForge框架
3.1 总览
整体分为两大子系统:
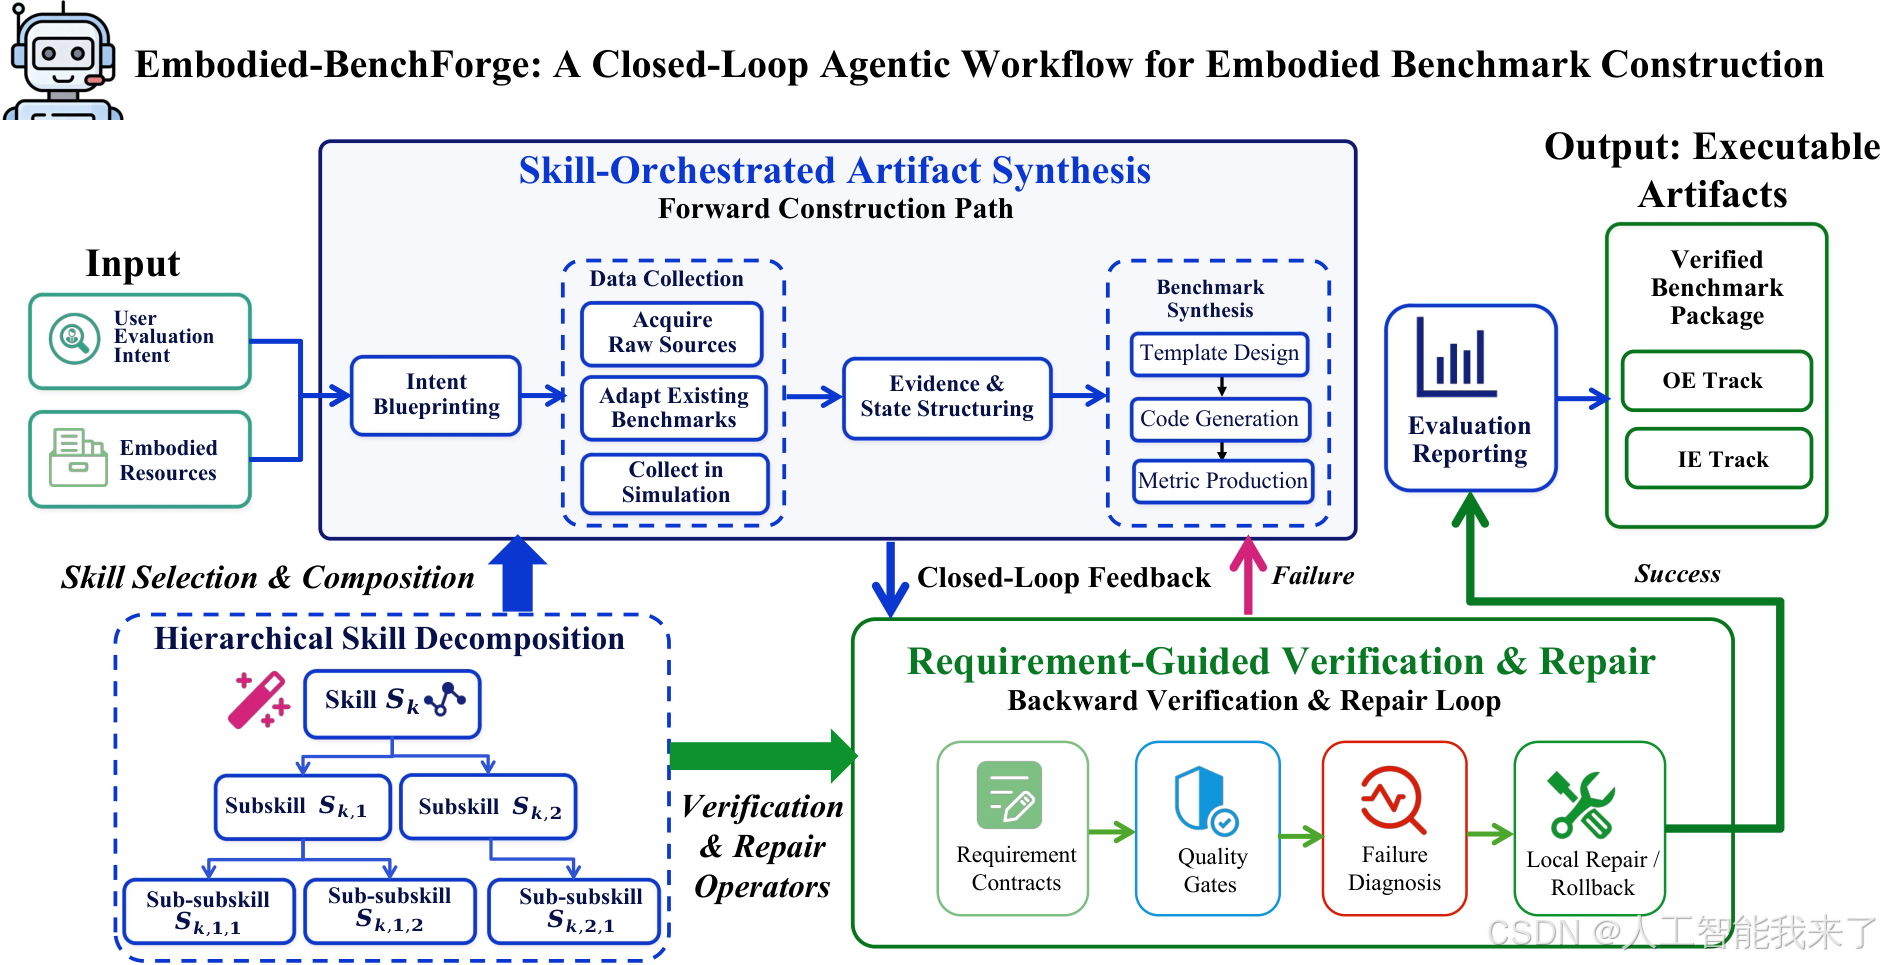
- 技能编排式制品合成(正向构建通路):接收用户评测意图与具身资源,经过意图蓝图、数据采集、证据‑状态结构化、基准合成、评测报告;
- 需求引导校验修复(反向闭环):制品送入校验流水线,执行需求契约检查、质量关卡;失败则故障诊断,执行局部修复/上游回滚,仅重建受影响制品;校验通过进入最终基准包。
制品通用形式化定义:
a i = ⟨ τ i , x i , m i , p i ⟩ a_{i}=\left\langle\tau_{i},x_{i},m_{i},p_{i}\right\rangle ai=⟨τi,xi,mi,pi⟩
τ i \tau_i τi:制品类型; x i x_i xi:内容; m i m_i mi:元数据与校验状态; p i p_i pi:构建溯源记录。
制品类型包含:意图蓝图、源记录、证据/环境状态、基准样例、评分/验证制品、评测报告。
3.2 技能编排式制品合成
技能(Skill)形式化:
s
k
=
⟨
I
k
,
O
k
,
P
k
,
F
k
⟩
s_{k}=\left\langle I_{k},O_{k},P_{k},F_{k}\right\rangle
sk=⟨Ik,Ok,Pk,Fk⟩
I
k
I_k
Ik输入制品类型,
O
k
O_k
Ok输出制品类型,
P
k
P_k
Pk执行前置条件,
F
k
F_k
Fk后端执行体(可以是大模型、确定程序、模拟器接口、评分编译器)。
复杂技能可以分层拆解为子技能,形成层级技能分解树。
正向构建流程步骤:
- 意图蓝图 Intent Blueprinting:将用户评测意图转化为能力目标、资源需求、任务规约、输出schema;
- 数据采集 Data Collection:三种模式:获取原始资源、适配已有基准、模拟器内采集;统一接口屏蔽底层资源差异;交互式模拟器暴露场景初始化、状态恢复、动作约束接口;
- 证据与状态结构化 Evidence & State Structuring
- OE离线赛道:产出带空间、时间、来源元信息的证据记录;
- IE交互式赛道:额外产出可恢复环境状态集合、合法动作空间、任务前置条件、目标变量;
- 基准合成 Benchmark Synthesis:模板设计 → 代码生成(问题、指令、答案、验证器) → 度量生成(自动评分协议);
- 评测报告 Evaluation Reporting:汇总基准构成、模型结果、诊断统计,输出基准包。
3.3 需求引导的校验与修复
为每一类制品定义需求契约集合:
κ
τ
=
{
ϕ
τ
,
1
,
…
,
ϕ
τ
,
n
}
\kappa_{\tau}=\left\{\phi_{\tau,1},\dots,\phi_{\tau,n}\right\}
κτ={ϕτ,1,…,ϕτ,n}
ϕ
τ
,
j
\phi_{\tau,j}
ϕτ,j代表一条校验谓词,分为确定性校验、执行式校验、模型辅助校验。
重要约束:模型辅助校验结果,不能覆盖确定性校验、执行校验的失败结果。
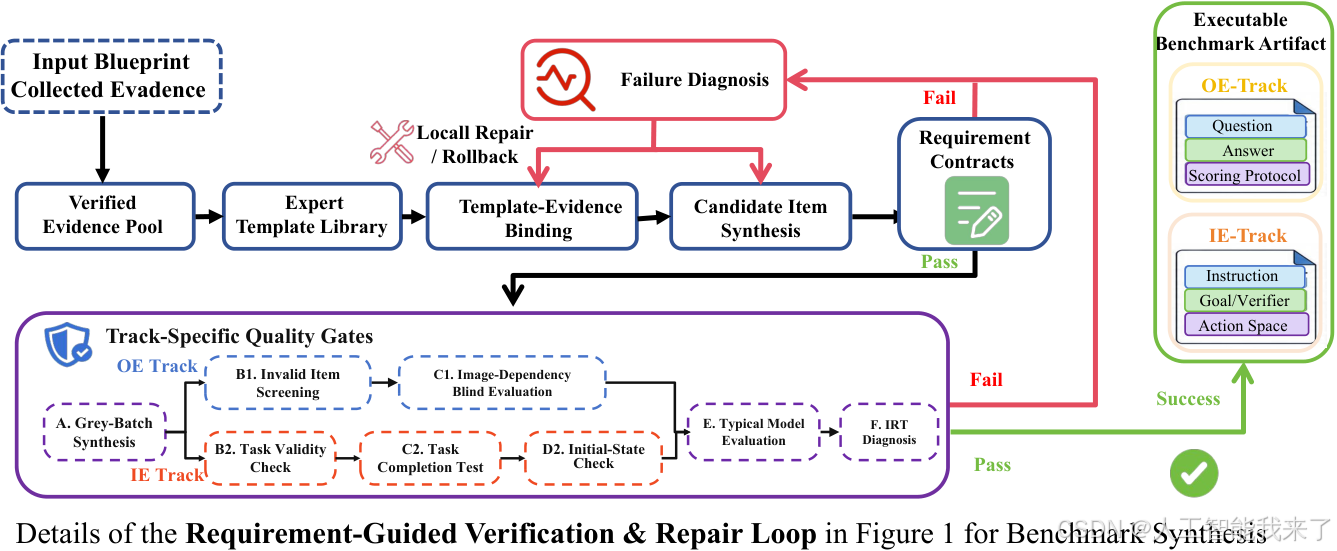
完整校验‑修复流程:
- 输入蓝图与采集证据,生成校验过的证据池;
- 专家模板库做模板‑证据绑定,生成候选基准样例;
- 执行制品需求契约校验;
- 进入赛道专属质量关卡:
- OE‑Track离线赛道:A灰批次合成 → B1无效样例过滤 → C1图像依赖盲评估;
- IE‑Track交互式赛道:A灰批次合成 → B2任务合法性校验 → C2任务完成度测试 → D2初始状态可恢复校验;
- 通过关卡后,执行E典型模型评测、F IRT项目反应理论诊断;
- 失败分支:故障诊断定位违背的契约与溯源依赖;执行局部修复/模板重绑定/候选重合成/上游回滚;仅重建下游受影响制品,保留其余已经校验通过制品;修复完成重新走全部校验关卡。
可用修复算子集合(附录A完整定义)
- 局部字段修复 Local field repair
- 模板重新绑定 Template re‑binding
- 候选重生成 Candidate re‑synthesis
- 技能重执行 Skill re‑execution
- 上游回滚 Upstream rollback
4 产出基准套件
| 基准名称 | 具身载体/场景 | 数据源 | 统计信息 |
|---|---|---|---|
| OE‑Track 离线问答赛道 | |||
| SHT 空间家庭任务 | 家庭机器人 | ALFRED模拟器 | 能力维度8 /问题类型6 /模板22 |
| SHN 空间导航 | 移动机器人 | Habitat模拟器 | 能力维度7 /问题类型4 /模板13 |
| SD 空间驾驶 | 自动驾驶 | CARLA模拟器 | 能力维度8 /问题类型6 /模板80 |
| SA 空间机械臂 | 机械臂 | LIBERO模拟器 | 能力维度9 /问题类型8 /模板203 |
| SU 空间无人机 | 无人机 | 真实航拍图像 | 能力维度9 /问题类型7 /模板260 |
| SQ 空间四足 | 四足机器人 | TartanGround | 能力维度8 /问题类型8 /模板192 |
| IE‑Track 交互式赛道 | |||
| IE‑Track | 4类家庭场景 | AI2‑THOR模拟器 | 220任务 /28场景 /2难度等级 |
- OE‑Track:每一条样例包含观测证据、问题、参考答案、可执行评分协议;
- IE‑Track:220条交互任务,具备可恢复初始状态、指令、动作空间、目标条件、终端验证器,同时保存交互轨迹,支持后续离线问答。
5 实验
5.1 实验设置
- 构建工作流调度基座:Qwen3.6‑27B;
- 制品合成与模型辅助校验:GPT‑5.5‑Pro;
- 评测对象:11个API/本地大模型;
- OE分数归一到0‑100;IE‑Track任务成功由可执行终端验证器判定;全部模型使用220个公共交互任务做严格对比。
5.2 评估指标(制品质量,LLM‑as‑Judge + 人工标注)
8个评估维度:
- UIA 用户意图对齐;2. FSQ格式可用性;3. QAC问答一致性;4. EGC证据接地正确性;
- SGC空间几何一致性;6. AFC动作‑可及性一致性;7. TSD目标信号依赖度(衡量是否依赖捷径,必须依赖视觉/空间证据);8. SSC技能挑战度。
人工标注提供参考,Judge‑Human计算一致性;Overall为综合质量得分。
5.3 效率指标
token开销、墙钟时间、单有效样例token消耗、吞吐;OE‑Track开销归一化到10000样例规模。
5.4 构建质量与构建效率
5.4.1 制品质量(OE‑Track六个基准Judge综合得分)
| 基准 | UIA | FSQ | QAC | EGC | SGC | AFC | TSD | SSC | Overall |
|---|---|---|---|---|---|---|---|---|---|
| SHT | 90.25 | 93.00 | 89.50 | 91.75 | 86.25 | 88.50 | 86.00 | 83.25 | 88.56 |
| SHN | 89.75 | 87.25 | 89.00 | 91.50 | 89.25 | 90.75 | 87.75 | 87.50 | 89.09 |
| SD | 87.25 | 88.75 | 86.50 | 91.75 | 89.25 | 89.00 | 91.50 | 87.75 | 88.97 |
| SQ | 88.50 | 94.00 | 85.75 | 91.00 | 86.50 | 88.50 | 87.00 | 85.50 | 88.34 |
| SU | 85.50 | 92.25 | 86.50 | 90.50 | 86.75 | 89.00 | 88.00 | 91.25 | 88.72 |
| SA | 92.00 | 90.00 | 91.25 | 89.50 | 94.25 | 88.00 | 91.00 | 90.00 | 90.75 |
全部基准Overall得分88.34‑90.75,跨异构载体质量稳定;TSD、SSC自动控制难度相对较弱,是后续优化点。
5.4.2 构建效率
- OE‑Track构建一万样例耗时38‑160分钟,平均86分钟;
- 20个IE交互式任务构建校验耗时1.5h;
- OE编排平均11.45M token,单有效样例1145 token,吞吐116.3样例/分钟;
- 真实航拍图像的SU基准证据处理开销最高;模拟器类SD吞吐最优。
5.5 基准评测效用
5.5.1 离线问答OE‑Track模型性能
| 模型 | SHT | SHN | SD | SQ | SU | SA | 均值 |
|---|---|---|---|---|---|---|---|
| GPT‑5.5 | 53.88 | 60.57 | 44.52 | 51.38 | 63.78 | 71.89 | 57.67 |
| Claude Opus 4.7 | 52.25 | 57.57 | 44.40 | 53.00 | 63.67 | 68.78 | 56.61 |
| Gemini‑3‑Flash | 50.50 | 45.43 | 46.96 | 51.38 | 49.89 | 67.67 | 51.97 |
| Qwen3.6‑35B | 52.75 | 46.00 | 42.40 | 50.00 | 54.00 | 54.00 | 49.86 |
| GPT‑5.4‑Mini | 48.25 | 40.00 | 46.85 | 42.50 | 45.78 | 60.00 | 47.23 |
| GPT‑5.4‑Nano | 41.00 | 39.29 | 43.50 | 35.63 | 45.67 | 52.67 | 42.96 |
| Claude Sonnet 4.6 | 49.88 | 40.86 | 36.21 | 39.50 | 42.33 | 46.44 | 42.54 |
| Qwen3.5‑4B | 37.88 | 31.14 | 40.08 | 27.38 | 32.11 | 47.22 | 35.97 |
| Claude 4.5 Haiku | 50.25 | 32.57 | 25.83 | 28.75 | 34.67 | 36.33 | 34.73 |
| Qwen3.5‑2B | 36.00 | 27.86 | 33.96 | 22.38 | 35.33 | 36.89 | 32.07 |
| Qwen3.5‑0.8B | 39.88 | 29.57 | 32.79 | 23.13 | 29.22 | 27.44 | 30.34 |
| 人类 | 84.98 | 87.80 | 82.26 | 83.77 | 88.91 | 87.63 | 85.89 |
人类均值85.89;最强模型GPT‑5.5仅57.67,存在巨大能力鸿沟。
5.5.2 交互式IE‑Track(220任务)
指标说明:
- SR:任务完成成功率;
- EQA Acc:基于轨迹的问答准确率;
- SRL:同时完成任务+轨迹问答正确占比;
- Avg.Steps:平均执行步数。
| 模型 | SR(%) | EQA Acc.(%) | SRL(%) | Avg.Steps |
|---|---|---|---|---|
| GPT‑5.5 | 83.18 | 73.64 | 61.36 | 40.13 |
| Claude Opus 4.7 | 77.73 | 70.00 | 55.00 | 39.65 |
| Gemini‑3‑Flash | 72.27 | 59.55 | 42.73 | 42.74 |
| Qwen3.6‑35B | 46.36 | 50.91 | 25.45 | 30.69 |
| GPT‑5.4‑Nano | 20.45 | 53.64 | 12.73 | 77.22 |
| GPT‑5.4‑Mini | 16.82 | 46.82 | 8.18 | 85.30 |
| Claude Sonnet 4.6 | 16.82 | 42.27 | 7.73 | 81.46 |
| Claude 4.5 Haiku | 5.00 | 55.91 | 1.36 | 99.76 |
| Qwen3.5‑4B | 0.00 | 55.91 | 0.00 | 105.54 |
| Qwen3.5‑2B | 0.00 | 46.82 | 0.00 | 35.76 |
| Qwen3.5‑0.8B | 0.00 | 22.73 | 0.00 | 132.59 |
| 人类 | 97.73 | 74.09 | 71.82 | 44.00 |
关键现象:很多小模型轨迹问答EQA还有一定准确率,但是完全无法闭环完成交互任务;证明:具身观测理解 ≠ 可执行闭环交互能力。
5.6 构建机制消融实验
5.6.1 技能复用
| 设置 | 使用总技能数 | 复用技能数 | 专属技能数 | 复用率 |
|---|---|---|---|---|
| 模拟器OE基准平均(SHT/SHN/SD/SA) | 40.3 | 39.3 | 1.0 | 97.5% |
| SU无人机(真实图像) | 41 | 34 | 7 | 82.9% |
| SQ四足 | 41 | 36 | 5 | 87.8% |
| IE‑Track交互赛道 | 44 | 36 | 8 | 81.8% |
| 全部整体统计 | 41.0 | 37.6 | 3.4 | 91.6% |
整体复用率91.6%;模拟器类基准复用率高达97.5%;仅需要少量适配专属技能,框架依靠一套公共技能主干支持异构基准构建。
5.6.2 系统级消融(六个OE基准平均)
| 配置 | LLM评判得分 | 人工得分 | 斯皮尔曼ρ一致性 | 有效率 | Δ H \Delta_H ΔH人工得分变化 |
|---|---|---|---|---|---|
| 完整系统 | 89.07 | 91.28 | 0.87 | 93.7% | ‑ |
| 去掉设计技能 | 82.10 | 83.76 | 0.84 | 86.2% | ‑7.52 |
| 去掉源接地模块 | 74.48 | 72.12 | 0.81 | 73.6% | ‑19.16 |
| 去掉证据构建技能 | 76.76 | 74.08 | 0.82 | 80.8% | ‑17.20 |
| 去掉校验‑修复整套模块 | 70.59 | 68.03 | 0.78 | 62.4% | ‑23.25 |
结论:校验修复模块对质量影响最大,去掉后人工得分下降23.25,有效率暴跌至62.4%;源接地、证据构建同样是核心不可省略组件。
5.6.3 流程质量控制消融(SpatialUAV基准,生成1000样例)
| 变体 | Quality↑ | ValidRate↑ | TSD↑ | 高区分度占比↑ | Token开销 |
|---|---|---|---|---|---|
| 仅最终阶段检查 | 68.32 | 10.4% | 76.8 | 14.6% | 1.53M |
| 移除需求契约 | 78.74 | 62.2% | 82.5 | 40.8% | 2.19M |
| 移除盲评估 | 80.89 | 73.5% | 81.6 | 37.2% | 1.65M |
| 移除灰盒评估 | 82.21 | 75.7% | 88.4 | 32.6% | 1.57M |
| 移除IRT诊断 | 88.47 | 81.1% | 89.0 | 36.7% | 2.58M |
| 移除溯源引导修复 | 88.74 | 91.8% | 89.3 | 48.1% | 3.93M |
| 完整全流程质控 | 89.21 | 93.7% | 91.2 | 49.4% | 2.62M |
只做最终检查的方案有效率仅仅10.4%;溯源修复模块在保障高质量前提下,相比关闭修复节省大量token。
5.6.4 跨赛道能力诊断
- OE离线赛道主要失败模式:结构化答案绑定错误、多视图不一致、时序推理错误;
- IE交互式赛道主要失败:空间导航、重复执行、状态恢复、动作顺序错误;
OE衡量模型能不能构建出一致的具身内部表征;IE衡量这套表征能不能支撑持续、可恢复的闭环交互行为。
6 结论
本文提出Closed‑Loop Benchmark Synthesis闭环基准合成范式,并实现Embodied‑BenchForge。
- 框架使用类型化可复用技能编排正向构建,依托需求契约、溯源追踪,实现目标导向的局部修复与上游回滚;
- 产出OE‑Track(6套离线具身问答)、IE‑Track(220个可执行交互任务);
- 实验证明制品质量高、技能复用性强;揭示模型在具身理解能力与闭环交互执行能力之间存在明显鸿沟。
未来工作:拓展更多具身场景;进一步优化自动诊断算子;拓展大规模分布式基准构建流水线。
7 参考文献
完整参考文献见原文网页 https://arxiv.org/html/2609.13082v1
附录A‑E(精简说明)
附录A:闭环质量控制完整协议,全部需求契约、质量关卡定义、IRT项目反应理论公式、5类修复算子完整逻辑、OE/IE赛道真实修复样例;
附录B:异构模拟器、真实航拍图像、轨迹资源适配细节;
附录C:完整技能分类体系、技能复用统计协议;
附录D:Token、墙钟时间分阶段开销统计;
附录E:完整复现配置、Judge提示词、人工评估协议、IRT诊断、各模型细分性能。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 0
 0
- 0


 已为社区贡献16条内容

所有评论(0)