登录社区云,与社区用户共同成长
邀请您加入社区
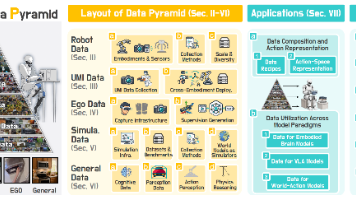
26年7月来自北京大学、南洋理工、香港科技大学、新加坡国立、香港中文大学、香港大学、杜克大学、加州伯克利分校、乔治城大学、南京大学和上海交通大学的论文“Data Pyramid for Embodied Manipulation: A Survey”。这篇综述的主要价值,是把具身操作的数据来源、采集方式、监督信号和模型用途放进同一个框架。它提供了一张较完整的数据地图,但尚未给出经过充分验证的“最优
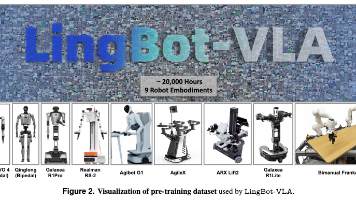
LingBot-VLA 是由蚂蚁集团提出的实用型视觉-语言-动作(VLA)基础模型,基于约20,000小时来自9种双臂机器人的真实世界数据训练而成。通过在4种机器人平台上对100项任务进行大规模评估,该模型展现出卓越的泛化能力与任务成功率,且性能随数据量增加持续提升,未见饱和。研究还构建了高效代码库,在8卡配置下实现每秒261样本吞吐量,较现有框架提速1.5–2.8倍。论文开源代码、模型与基准数据
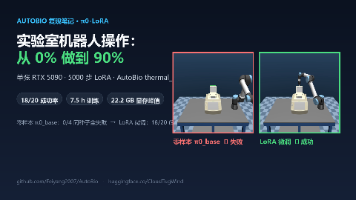
在单张RTX 5090(24GB显存)上,仅用5000步LoRA微调,成功将π0模型在AutoBio基准中“关闭热循环仪盖子”任务的机器人成功率从零样本的0%提升至90%(18/20),训练成本仅为上游全参数微调的1/200。通过修复上游代码缺陷、适配sm_120架构与无头渲染,实现消费级硬件跑通复杂生物实验任务,验证了LoRA在低成本下高效迁移的可行性。
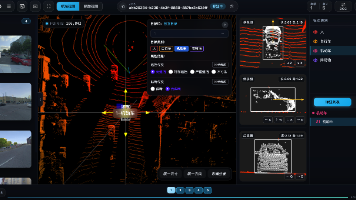
面向自动驾驶与机器人具身智能的点云标注平台,支持目标检测与语义分割,涵盖标注、审核、质检、验收全流程,可配置化管理。具备目标ID跨帧追踪、批注/修复、标签属性灵活配置等功能,助力高效数据标注与算法训练。
并重点弄清楚 Observation、Robot State、Language、Action,以及 Action 为什么还不是电机命令。
本文解析最新具身智能重磅研究 Spotter。针对传统 VLM-led 串行阻塞、端到端高延迟的痛点,Spotter 提出“小模型主导执行、VLM 异步巡检与关键帧反思”的全新协作范式。框架具备 Training-free(免微调训练)、开箱即用特性,真实机械臂成功率达 83%,执行耗时直降约 70%,代码已全面开源
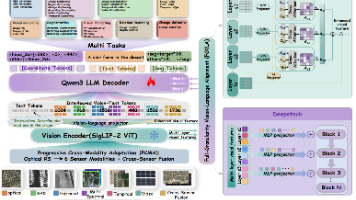
Earth-OneVision提出一种统一多模态遥感大模型架构,通过全粒度视觉语言对齐(FGVLA)、空间语言同构序列化(SLIS)与渐进式跨模态适配(PCMA),实现2B参数模型对6类传感器、9大任务的统一建模。创新性地将中间视觉层特征注入语言模型早期层,并将检测框、掩码等空间结果编码为离散Token,共享自回归解码器。构建3400万条指令数据集,在24个基准上表现媲美4B–72B模型,推动遥感
【IEEE出版、河南省科学院、河南工业大学联合主办】2026年计算机视觉与具身智能国际学术会议(CVEI 2026)
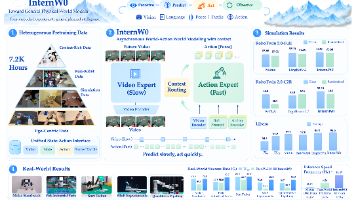
26年9月来自上海AI实验室的论文“InternW0: A Foundational Physical World Model for Efficient Real-World Interactions”。它最有价值的地方,是把视频预测、实时控制、异构数据预训练和接触反馈整合成可执行的机器人系统;但其“通用物理世界模型”定位,仍超出了当前实验充分验证的范围。
地面移动机器人和车辆的运动本质上是二点五维的——它们在一个近似平面上移动,垂直方向的变化有限。把所有传感器信息都变换到以地面为基准的俯视平面上。俯视图(Bird’s-Eye View,BEV)的好处是具体的。这个空间里尺度是恒定的,不像图像里近大远小;物体不会互相遮挡叠置;多个传感器的数据天然对齐在同一张网格上;而且下游的路径规划本来就在这个平面上工作,不需要额外转换。技术上的关键难点是如何把二维
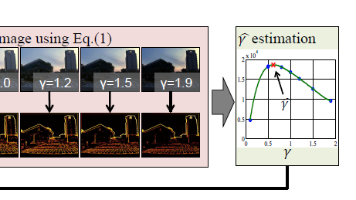
本文提出一种基于梯度信息的相机曝光自动调节方法,针对室外机器人在大动态光照下传统AE易丢失细节的问题。通过最大化图像梯度信息量作为评价目标,结合γ-校正软件仿真与五阶多项式拟合,预测虚拟最优曝光,并采用非对称比例反馈闭环迭代更新快门与增益,优先调节快门以抑制噪声。实验表明,该方法显著提升行人检测与视觉里程计性能,保留更多边缘纹理特征,有效适应复杂光照变化。
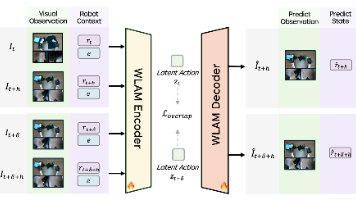
26年9月来自京东集团研究院的论文“WLA³: WORLD LATENT ACTION MODELING FOR SEMANTICS, DYNAMICS, AND KINEMATICS”。这篇论文 WLA³ 的核心价值,是将异构数据中的“状态变化”转化为统一监督,同时用于视觉语言理解、动力学建模和机器人控制。它提供有价值的系统设计和初步实机证据,但尚未充分证明学到跨具身、可干预的通用动作空间。
2026年,边端侧AI加速落地,诚恒微电子发布CH37系列SoC,以7.29平方厘米、7.7克封装集成64 TOPS算力,突破多芯片堆叠带来的延迟、带宽与能耗瓶颈。通过单芯片整合CPU、NPU与ISP,实现低延迟数据交互与多模态融合感知,支撑本地AI推理与自主决策。该芯片赋能智能机器人、无人机等终端,推动云-边-端协同架构发展。嵌入式工程师需掌握集成化编程、多传感器融合与模型部署新技能,迎接端侧智
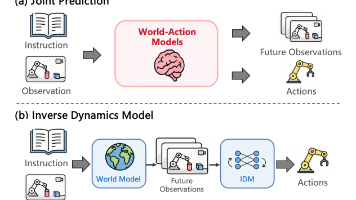
本课探讨视频扩散模型如何演变为可学习的世界模拟器。纯视频生成模型(如Sora 2)仅凭提示生成视频,而动作条件化世界模型(如Genie 3、GWM-1 Worlds)可通过动作预测未来帧,实现交互式模拟。核心架构采用时空3D分块与旋转位置编码,结合联合注意力机制。该范式已广泛应用于自动驾驶(如NVIDIA Cosmos-Drive)与机器人技术——通过VLM规划、视频模型模拟、逆动力学执行构成闭环
IMU标定的精度直接决定了机器人姿态估计的精度。姿态估计又是视觉定位、SLAM、运动控制的基础。一个具体的链路:IMU提供姿态角→姿态角用于将相机坐标系下的目标位置转换到世界坐标系→如果IMU有1°的姿态误差,一个5米外的目标在水平方向上的定位误差就会达到约8.7厘米。对于抓取任务来说,这个误差已经足以导致抓取失败。这也是为什么在端侧视觉定位系统中,IMU标定的重要性不亚于视觉模型本身的精度。
水下没有GPS——电磁波穿不透海水,机器人一下水就和全球导航卫星系统彻底失联。行业通用的答案是"声学+惯性+光学"的多传感器融合:惯导和多普勒计程仪(DVL)做航位推算打底,超短基线(USBL)/长基线(LBL)水声定位提供绝对坐标修正,相机和成像声纳负责近场感知。国内外研究则在这条工程主线上,探索把VSLAM(视觉同步定位与建图)真正纳入水下导航闭环。
26年9月来自阿联酋 MBZUAI 、加州理工、亚马逊公司FAR、维吉尼亚大学、乔治亚理工、纽约大学和加州伯克利分校的论文“World-Action Models for Robot Learning and Control: A Survey”。这篇论文的核心观点是:机器人不仅需要知道“下一步做什么”,还需要预测“这样做会带来什么后果”,并将这种预测转化为可执行、可纠错的动作。 世界-动作模型(
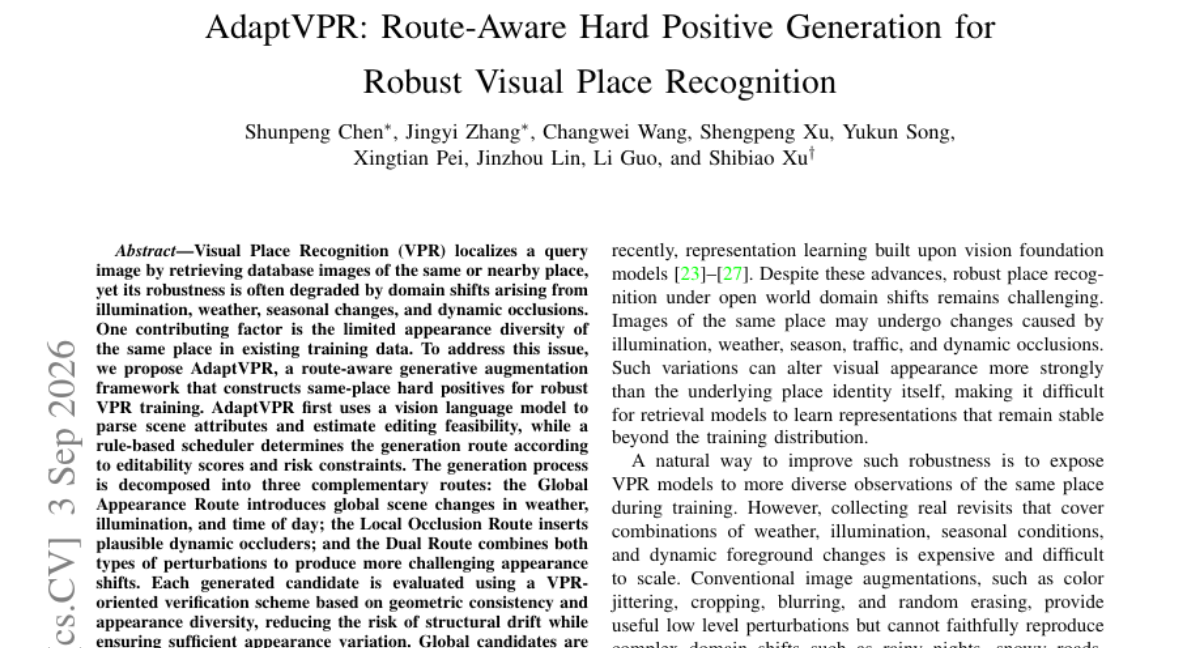
给AI训练照片"整容":一个让机器人认路更靠谱的新方法
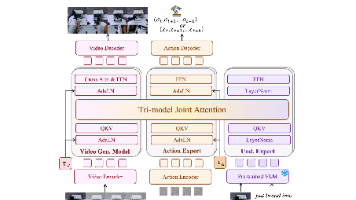
Motus(CVPR 2026)提出一种统一的潜在动作世界模型,通过混合Transformer(MoT)架构融合视觉-语言理解、视频生成与动作专家,实现五类具身建模范式的统一:VLA、WM、IDM、VGM与联合预测。引入基于光流的潜在动作表示,结合六层数据金字塔与三阶段训练流程,实现跨具身体的动作先验迁移。实验表明,该模型在仿真与真实场景中显著优于X-VLA和π⁰.⁵,性能提升达+15%至+48%
水下环境的特殊性在于:电磁波和激光被水快速吸收,陆地上一套视觉、雷达方案基本失效。行业长期依赖声纳,但声纳分辨率低、体积大、成本高,小型水下机器人往往"只带相机、不敢近距作业"。,用于海底地形与风机桩基、海缆、水下设施等目标物的三维重建。2D影像时代正在让位给3D感知时代。
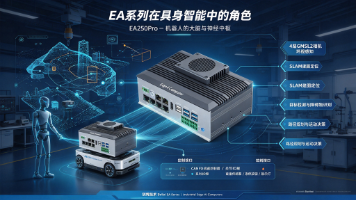
物理AI强调AI在真实世界中的感知与控制能力,如工业质检、自动驾驶;具身智能则要求AI拥有身体并在环境中自主行动,如人形机器人、AMR。二者区别在于:物理AI重“交互”,具身智能重“身体+自主”。钡铼技术EA系列边缘AI计算机,凭借高算力与模块化设计,同时支撑物理AI的闭环控制与具身智能的自主决策,成为工业场景中实现AI落地的关键硬件平台。
本数据集专注于变电站场景下多类电力设备的视觉检测,服务于电力巡检、设备状态评估及运维管理。数据涵盖16类变电站核心设备部件,适配无人机巡检、机器人巡检及固定监控的自动化识别应用。
在立体匹配环节,半全局匹配算法(SGBM)生成的视差图“满足一定精度,计算速度接近实时”,在MiddleBurry数据集上的测试表明,640×480分辨率下SGBM的计算时间约为40ms。深度图中的无效值、超出工作距离的远背景、与地面拟合的平面点,都可以在毫秒级时间内通过OpenCV的基础算子完成标记和剔除。在动态SLAM场景中,YOLOv8s语义分割模块处理RGB图像提取语义信息和物体掩码后,通
苏黎世联邦理工学院团队研发磁驱动柔性内窥镜,结合实时图像拼接与基于图像的自主导航,在活体绵羊模型中成功实现胎儿镜激光凝固术。该技术突破柔性器械在开放腔体中“无约束漂移”难题,通过纯图像反馈控制消除手部震颤,提供全局视野,显著提升手术精度与安全性,降低医生负荷,为微创手术在子宫、胃、膀胱等大型腔体中的应用带来重要突破。
如果说相机是机器人的“眼睛”,激光雷达就是机器人的“触角”——它用激光束主动探测周围空间,直接获取精确的三维距离信息。但在“如何让激光扫描空间”这个问题上,四种技术路线给出了完全不同的答案。这篇文章从物理原理出发,横向对比机械式、MEMS、OPA和FMCW四种LiDAR技术路线的工程成熟度,帮你理解它们各自适合什么场景。
26年8月来自UCLA、MIT和Utah大学的论文“RoboEdit: Turning Human Manipulation Videos into Scalable Robot Experience”。该文在机器人数据构建与视频编辑方面有较强的系统价值,但对“生成数据能否规模化提升机器人实际能力”的证明仍比较初步。 最有说服力的是成对数据管线和编辑效果,最需要补强的是物理可执行性、三维状态精度和
你从“四个字常见字”问到“六个字常见字”,核心矛盾一直没变:你要的“常见 + 能当品牌用”,在法律上不存在。如果你真的想要一个能属于自己的机器人名字,唯一的路径是接受名字不那么“常见”,走自造词路线(比如“燧岩”“星枢”)。1. 山河动力机器人(山、河、动、力、机、器、人)2. 日月星辰机器人(日、月、星、辰、机、器、人)3. 金木水火机器人(金、木、水、火、机、器、人)4. 春夏秋冬机器人(春、
机器人的视觉系统和人眼有一个本质区别:人眼能自适应地处理动态场景,而相机的传感器架构在出厂时就已经确定了它能“看见”什么、看不清什么。选错了传感器类型,后面所有的视觉算法都会在一个先天不足的输入上挣扎。这篇文章从CMOS和CCD的物理差异出发,拆解卷帘快门的运动伪影问题,然后对比结构光和ToF两种深度获取方案的误差模型,帮你建立一套完整的视觉传感器选型框架。
2026年NVIDIA Jetson边缘AI征文展现19个“小众又惊艳”的落地场景,涵盖工业巡检、机器人、本地大模型与无障碍辅助。钡铼技术EA系列基于OrinNano/OrinNX平台,提供6-275TOPS算力,以工业级宽温(-20~+75℃)、丰富接口(GMSL2/CANFD/RS485)及OOB远程运维,将开发板原型转化为可量产、可部署的工业级方案。从视觉检测到视障辅助,EA系列打通从实验室
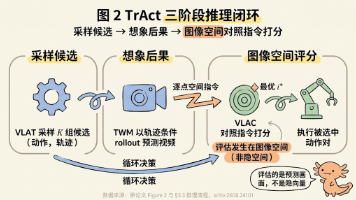
TrAct提出以视觉轨迹替代动作作为世界模型与策略的共享接口,解决动作条件化预测中因本体差异和欠定映射导致的幻觉问题。通过联合预测动作与2D轨迹(夹爪+场景网格点),并用轨迹条件化世界模型生成可评估的未来画面,再以视觉-语言模型在图像空间直接对照指令打分,实现更可靠的闭环决策。该方法将评估锚定于可解释的图像空间,显著提升仿真(0.27→0.55)与真机任务成功率(0.49→0.76),并在视频质量
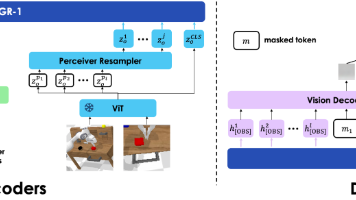
世界动作模型(WAM)旨在让机器人在统一框架下同时解决“执行动作后世界如何变化”与“应采取何种动作达成目标”两大问题。区别于传统视频生成模型,WAM聚焦于行动相关的未来表征,摒弃对无关视觉细节的过度建模。其核心在于将未来预测作为训练监督或推理工具,而非必须生成完整视频。当前研究呈现三类路径:显式联合生成未来与动作(如GR-1、UD-VLA)、仅用未来辅助训练(如LiLa-WAM)、测试时以未来模拟
GE-Act 2.0 探索大规模操作数据对通用机器人能力的提升,构建基于世界-动作模型(WAM)的框架,通过控制导向自动编码器(CoAE)、未来视觉规划(SVP)与逆动力学模型(IDM)实现零样本分布外泛化。在100项原子任务上,G1-OP成功率从17.1%升至44.1%,G2-90D从13.4%升至31.1%,验证了数据规模扩展的有效性。系统以低维潜变量连接感知与动作,支持滚动重规划与多本体兼容
OpenMAIC是由清华THU-MAIC团队开源的互动课堂系统,能将文本、PDF、音视频等材料转化为包含幻灯片、测验、互动页与项目任务的完整课程。与普通聊天机器人不同,它注重学习流程设计,支持从主题输入到大纲审核、课程生成与动态修改的全流程管理。用户可通过在线版快速体验,或通过本地部署实现私有化与深度定制。在PRO专业模式下,可精细化调整时间轴、角色阵容与教学技能,实现高效迭代。课程播放时支持实时
本系统基于RK3566开发板,采用YOLOv5与IOU跟踪算法实现行人检测与跟随。通过NPU加速推理,结合预处理、后处理及速度控制逻辑,确保机器人稳定跟随目标。使用rknn-toolkit-lite2完成模型转换与部署,支持自动锁定首行人并保持其在图像中央,具备死区与速度下限防抖机制。系统在Ubuntu 22.04环境下运行,依赖ROS2与Python虚拟环境,可实时查看检测结果与控制指令,适用于
如果你关注计算机视觉、自动驾驶、机器人或者 AI 应用,大概率都听过 YOLO。从,一路发展到,版本号越来越大。答案其实没有这么简单。因为从 YOLOv5 开始,YOLO 已经不再是一条由同一个团队持续维护的单一技术路线,而是多个团队围绕不断演进,形成了多条并行发展的技术分支。所以,一、先搞清楚:YOLO 到底是什么?YOLO,全称 You Only Look Once,最早由 Joseph Re
YOLO26不是单纯堆精度的模型,它的设计出发点是工业落地。通过移除DFL、无NMS推理简化部署;依靠STAL+ProgLoss保住小目标精度;MuSGD优化器提升训练稳定性;同时增强分割、姿态、旋转OBB能力,并且大幅优化CPU推理性能。对于工业检测、机器人、嵌入式边缘视觉项目,YOLO26是一个部署友好度很高的选择。本文仅做技术原理科普,欢迎大家在评论区交流YOLO26训练、部署踩坑经验。
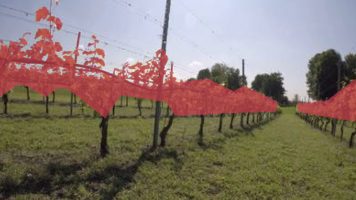
本数据集专注于葡萄园行间自主导航所需的语义分割,服务于农业机器人、精准农业及自动化植保。数据采集自真实葡萄园行间,涵盖不同天气、时段及地形条件,适配机器人视觉导航、行间路径识别及避障等应用。
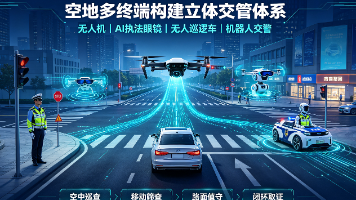
搭配城区机巢,无人机 5 分钟可达重点路段,单次巡逻预警 30 余台违停车辆,自动完成识别、取证、短信告知,形成完整执法闭环。机器人交警可复刻交通指挥手势,依托 AI 视觉识别行人闯红灯、非机动车不戴头盔、越线停车等行为,语音劝导,弥补人工执勤短板。随着 AI 视觉、北斗定位与智能终端技术落地,交管执法从单点静态抓拍,升级为空地多终端协同的立体化智能执法体系,大幅压缩交通违法侥幸空间。设备内置高清
同时依托AI视觉能力,自动识别行人闯红灯、非机动车越线停车、骑行不戴头盔等不文明交通行为,并进行实时语音劝导,实现柔性化、常态化、无人化交通治理。无人机、AI智能执法眼镜、无人巡逻车、机器人交警全面上岗,形成空中巡查、地面值守、移动筛查的立体化管控格局,彻底补齐传统交管的监管短板。无人巡逻车搭载多目高清感知设备,可自主规划巡控路线、自动巡查路面状况、实时回传现场画面至指挥中心,能够主动抓拍车辆违停
当前大模型 Agent、具身智能技术迭代快,很多高校老师面临新课备课缺少完整实战案例、源码实验环境不足的难题。本文梳理大模型智能体、视觉大模型 + 具身智能完整技术栈,同时分享面向高校教师的线上实战研修项目,覆盖 Transformer、RAG、MCP、多智能体、SAM、ROS‑SLAM、VLA 等内容,配套完整源码与实验案例,可服务课程建设与科研原型开发。
依托北斗定位+AI视觉算法,无人机可自动识别违停、压线、占道,5分钟内快速抵达重点路段,单次巡逻可预警违法车辆30台以上,实现“识别—抓拍—取证—推送—处罚”全闭环。AI视觉系统通过多帧连续图像、轨迹分析,精准判定车辆越线、闯灯、抢黄灯行为,完整记录车辆位置、行驶轨迹、信号灯状态,自动合成图片与视频证据,几乎不存在执法争议。同时,无人机、AI执法眼镜、机器人交警、无人巡逻车等新型终端全面上岗,交通
人形机器人对视觉的要求和轮式机器人不同:要同时满足宽视场感知、动态环境自定位、全身避障补盲。单相机很难兼顾,多目方案成为主流。
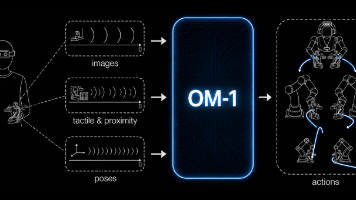
26年9月来自创业公司Reward AI的博客文章“OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans”:https://www.rewardai.com/blog/OM-1/。这篇博客介绍了 Reward AI 的机器人系统 Omnibody 和核心模型 OM-1。核心思路是:直接从人类自然操作中学习,再让同一个策略模
送餐、酒店配送、商用清洁机器人这几年放量很快,核心传感器基本都是深度相机。选型主要看四点:测距范围、抗环境光能力、是否带端侧算力、供货与生态。
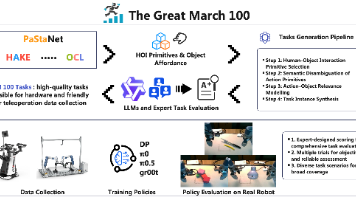
26年1月来自上海交大RHOS AI 团队、SII和阿里蚂蚁Robbyant的论文“The Great March 100: 100 Detail-Oriented Tasks for Evaluating Embodied AI Agents”。GM-100基准的构建流程首先收集现有的机器人任务,随后利用HAKE [27]进行语义扩展,并结合基于大语言模型(LLM)的生成技术,以涵盖长尾交互场景
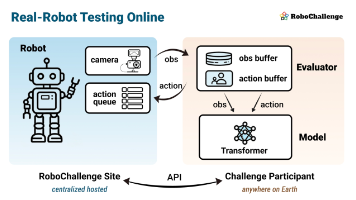
25年10月来自Dexmal 和Hugging Face的论文“RoboChallenge: Large-scale Real-robot Evaluation of Embodied Policies”。 RoboChallenge 提出一套面向VLA(视觉-语言-动作)模型的大规模真实机器人在线评测系统,
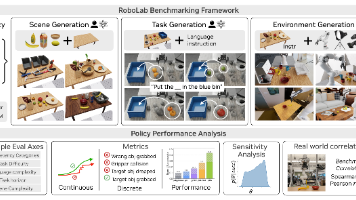
RoboLab 提出一种评估框架,旨在实现对现实世界策略的大规模评估。通过引入一套用于生成新场景和任务的精简流程,RoboLab 实现快速扩展,从而能够有效测试策略的泛化能力。配套的基准测试集 RoboLab-120 引入多种评估维度以及一系列指标和分析工具,并展示与现实世界基准测试高度一致的相关性。
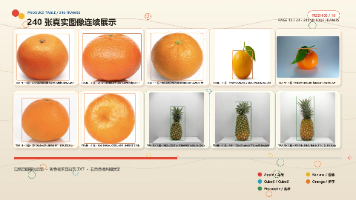
这是一套面向 YOLO 目标检测训练的水果识别数据集,数据包含完整水果、切面、不同包装、近远景和多类桌面背景。data.yamlAppleBananaCube6OrangePineapple也就是苹果、香蕉、Cube6、橙子和菠萝。虽然数据集标题重点介绍橙子、菠萝、香蕉和苹果,但配置文件中确实包含第五类Cube6,训练时不能忽略。水果目标检测与分类生鲜分拣和自动识别颜色、形状与外观对比YOLO 系
开发者用。