登录社区云,与社区用户共同成长
邀请您加入社区
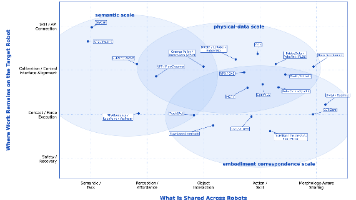
26年8月来自日本国家高级工业科学技术研究院(AIST)的论文“The Embodiment Gap in Robot Foundation Models”。这篇综述的核心观点是:评价机器人基础模型的跨机器人能力,既要看任务成功率,也要看为了获得这个成功率,在目标机器人上投入了多少适配工作。 模型能够复用知识、表征或动作,并不意味着换一台机器人就能直接、稳定地运行。
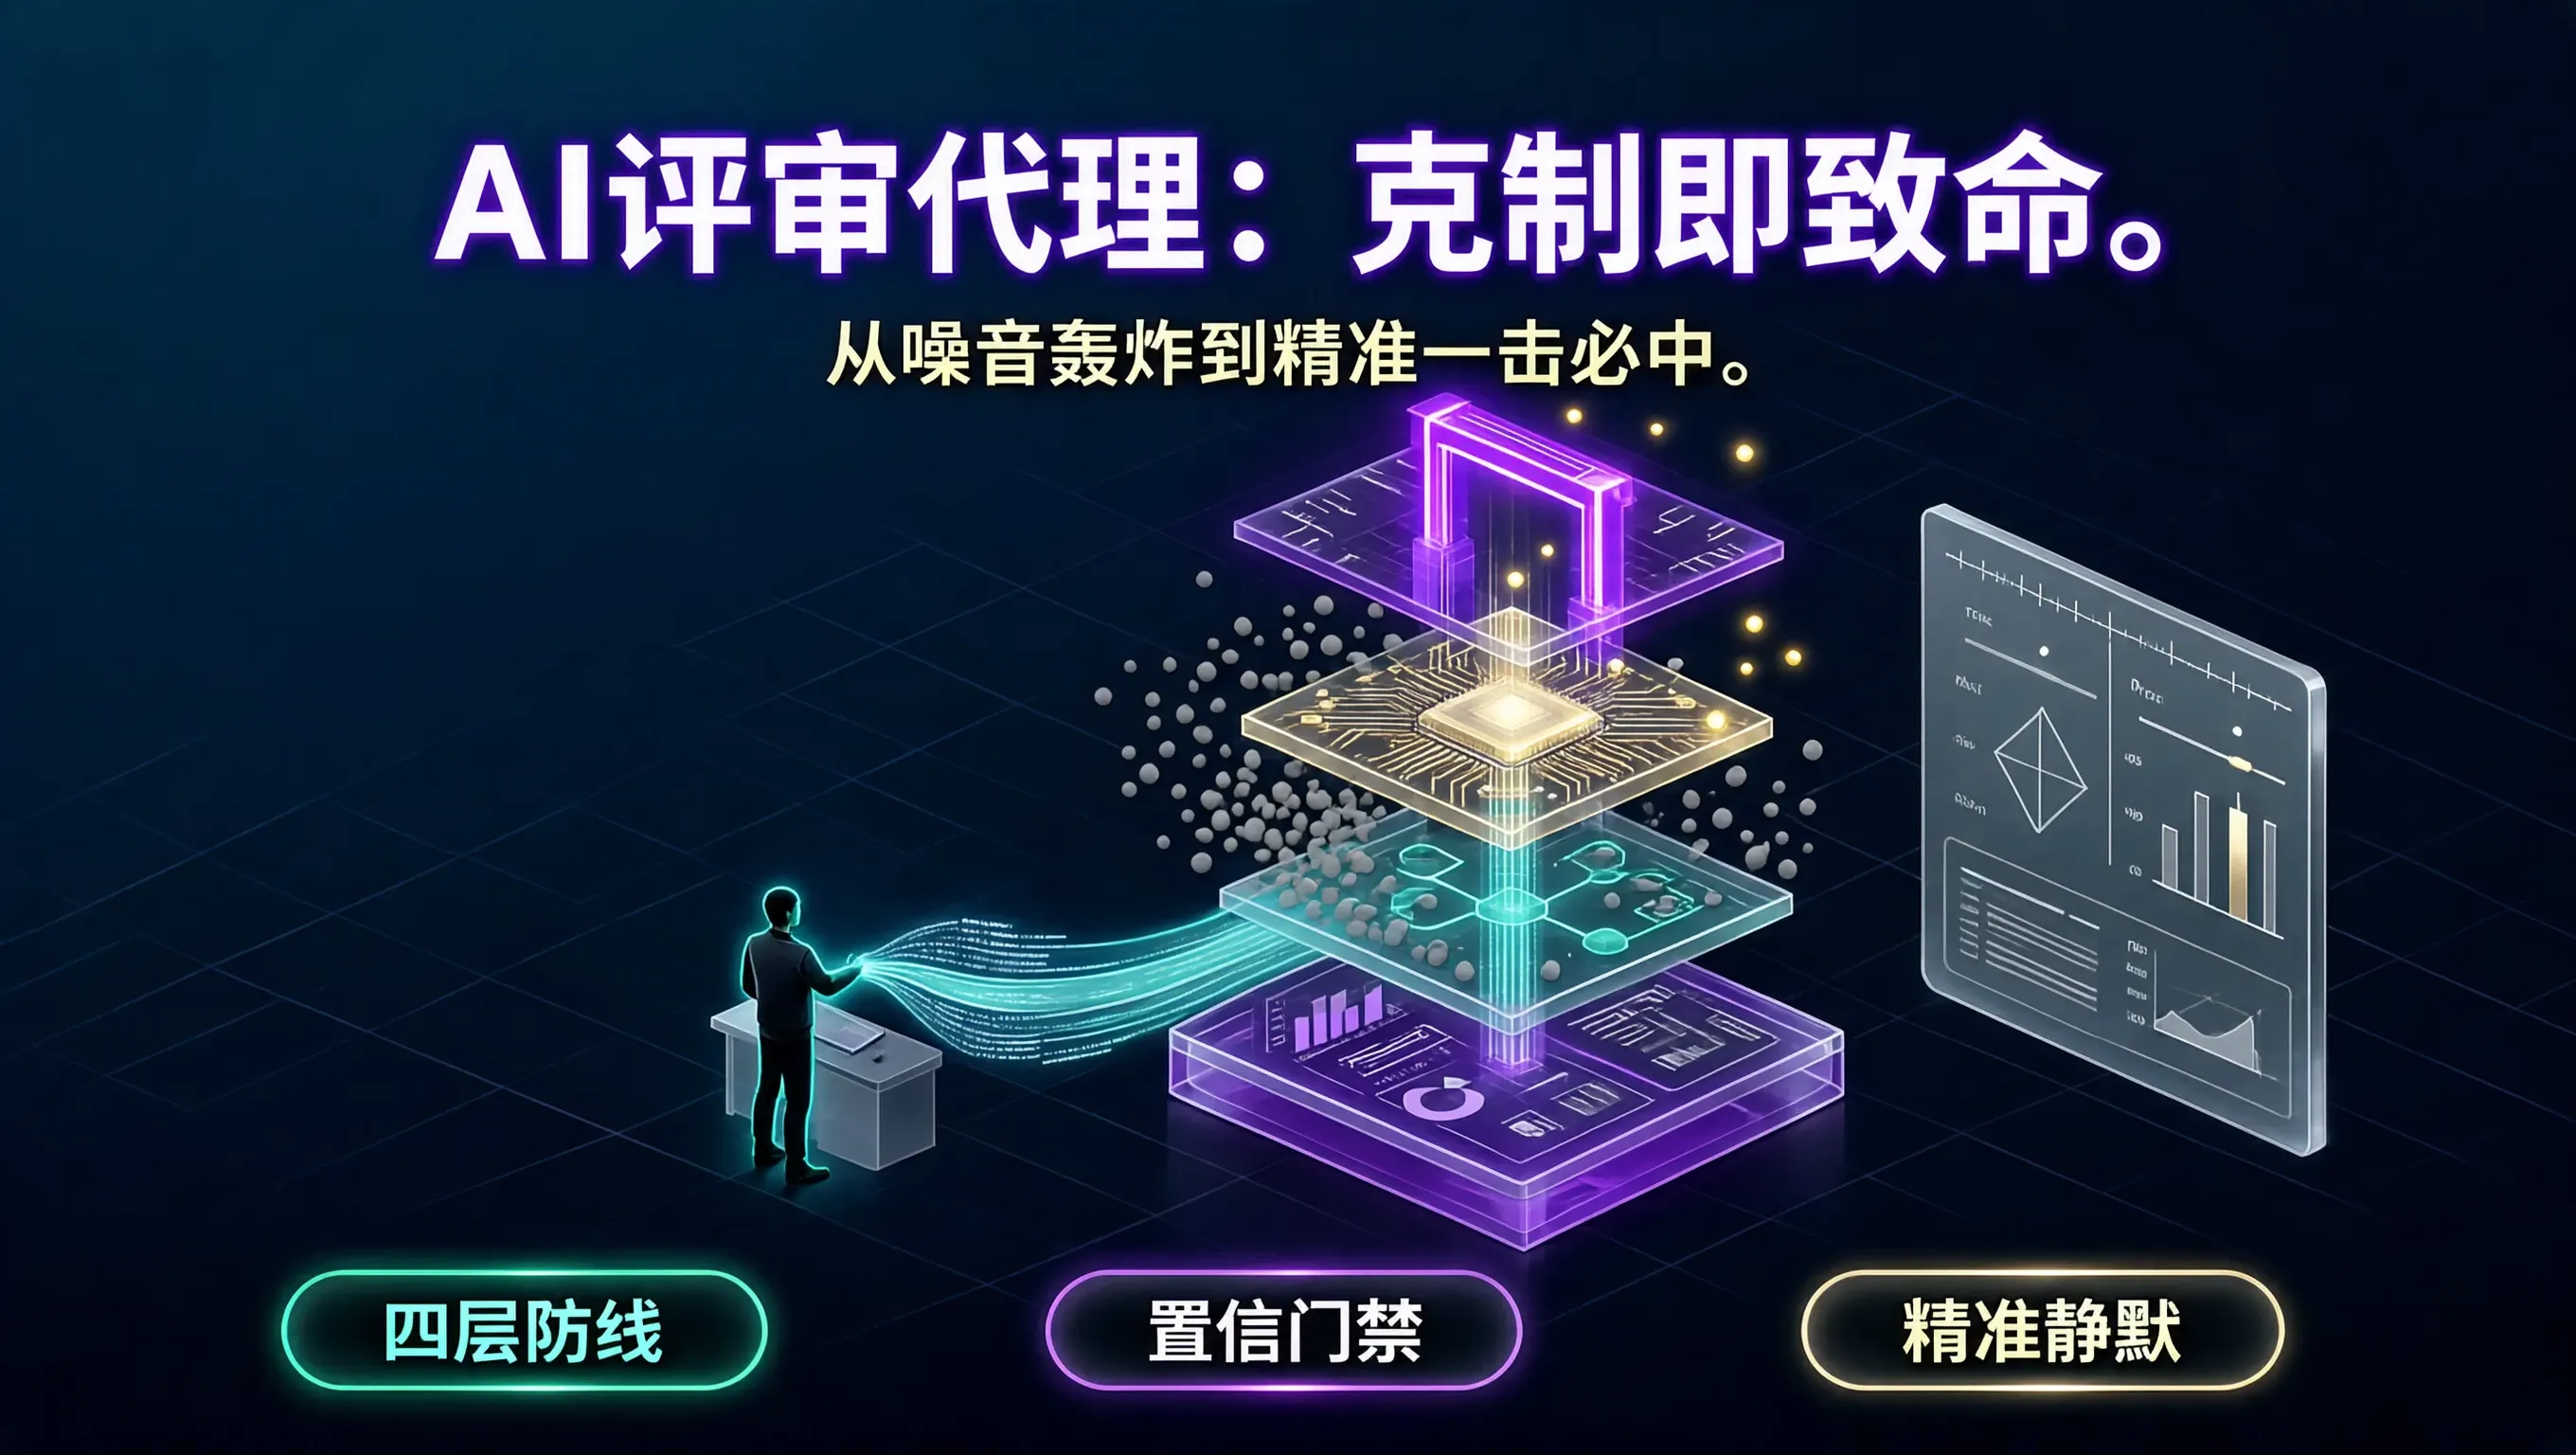
在很多技术团队雄心勃勃地引入“AI 自动化代码审查(AI Code Reviewer)”之后,事情的走向往往会迅速演变成一场令人啼笑皆非的闹剧:机器人一上线,无论开发者提交了什么代码,它都会在 PR 下面疯狂刷屏二三十条行内评论。这种充斥着大量虚假报警(False Positives)与无意义建议的“噪音轰炸”,很快就会引发全团队工程师的逆反心理。开发者们开始对机器人的评论熟视无睹,直接一键批量点
通过 W1 阶段为期一周的长假实战检验,这套社区自动化机器人证明了一个朴素的真理:开源维护者的精力是项目最稀缺的战略资源。把维护者的时间消耗在日复一日复制粘贴“请补充日志”的低效沟通中,不仅是极大的浪费,更是引发维护者弃坑的关键诱因。用代码为社区立规矩,用自动化机器人筑牢第一道防波堤。当噪音被机械化隔绝,剩下的才是真正值得推敲的工程挑战与架构思想。
十月七日的清晨,闹钟还没响,阳台上的薄荷叶已经被第一缕晨光晒得发亮。我迷迷糊糊坐到原木书桌前,刚掀开轻薄本的屏幕,屏幕右下角便伴随着一声轻微的“叮咚”水滴声,滑出一个米宣色调的温和小卡片:“早安,泠钰。今天是个少云的晴朗秋日,最高气温 21℃,昼夜温差比较大,下午出门记得带一件薄针织开衫。今日核心待办:① 检查 SQLite 备份硬盘;② 晚上七点前把老妈念叨的无添加生抽买齐。小狗 Token 已
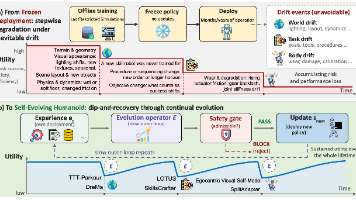
26年9月来自韩国庆熙大学和新加坡国立的论文“Self-Evolving AI for Humanoids: Mechanisms, Safety, and Evaluation of Post-Deployment Self-Improvement”。这篇综述最有价值的贡献,是把人形机器人的研究目标从“训练出一个强策略”,扩展为:机器人部署后,如何持续改进,并保证每一次改动都不会破坏已有的安全能
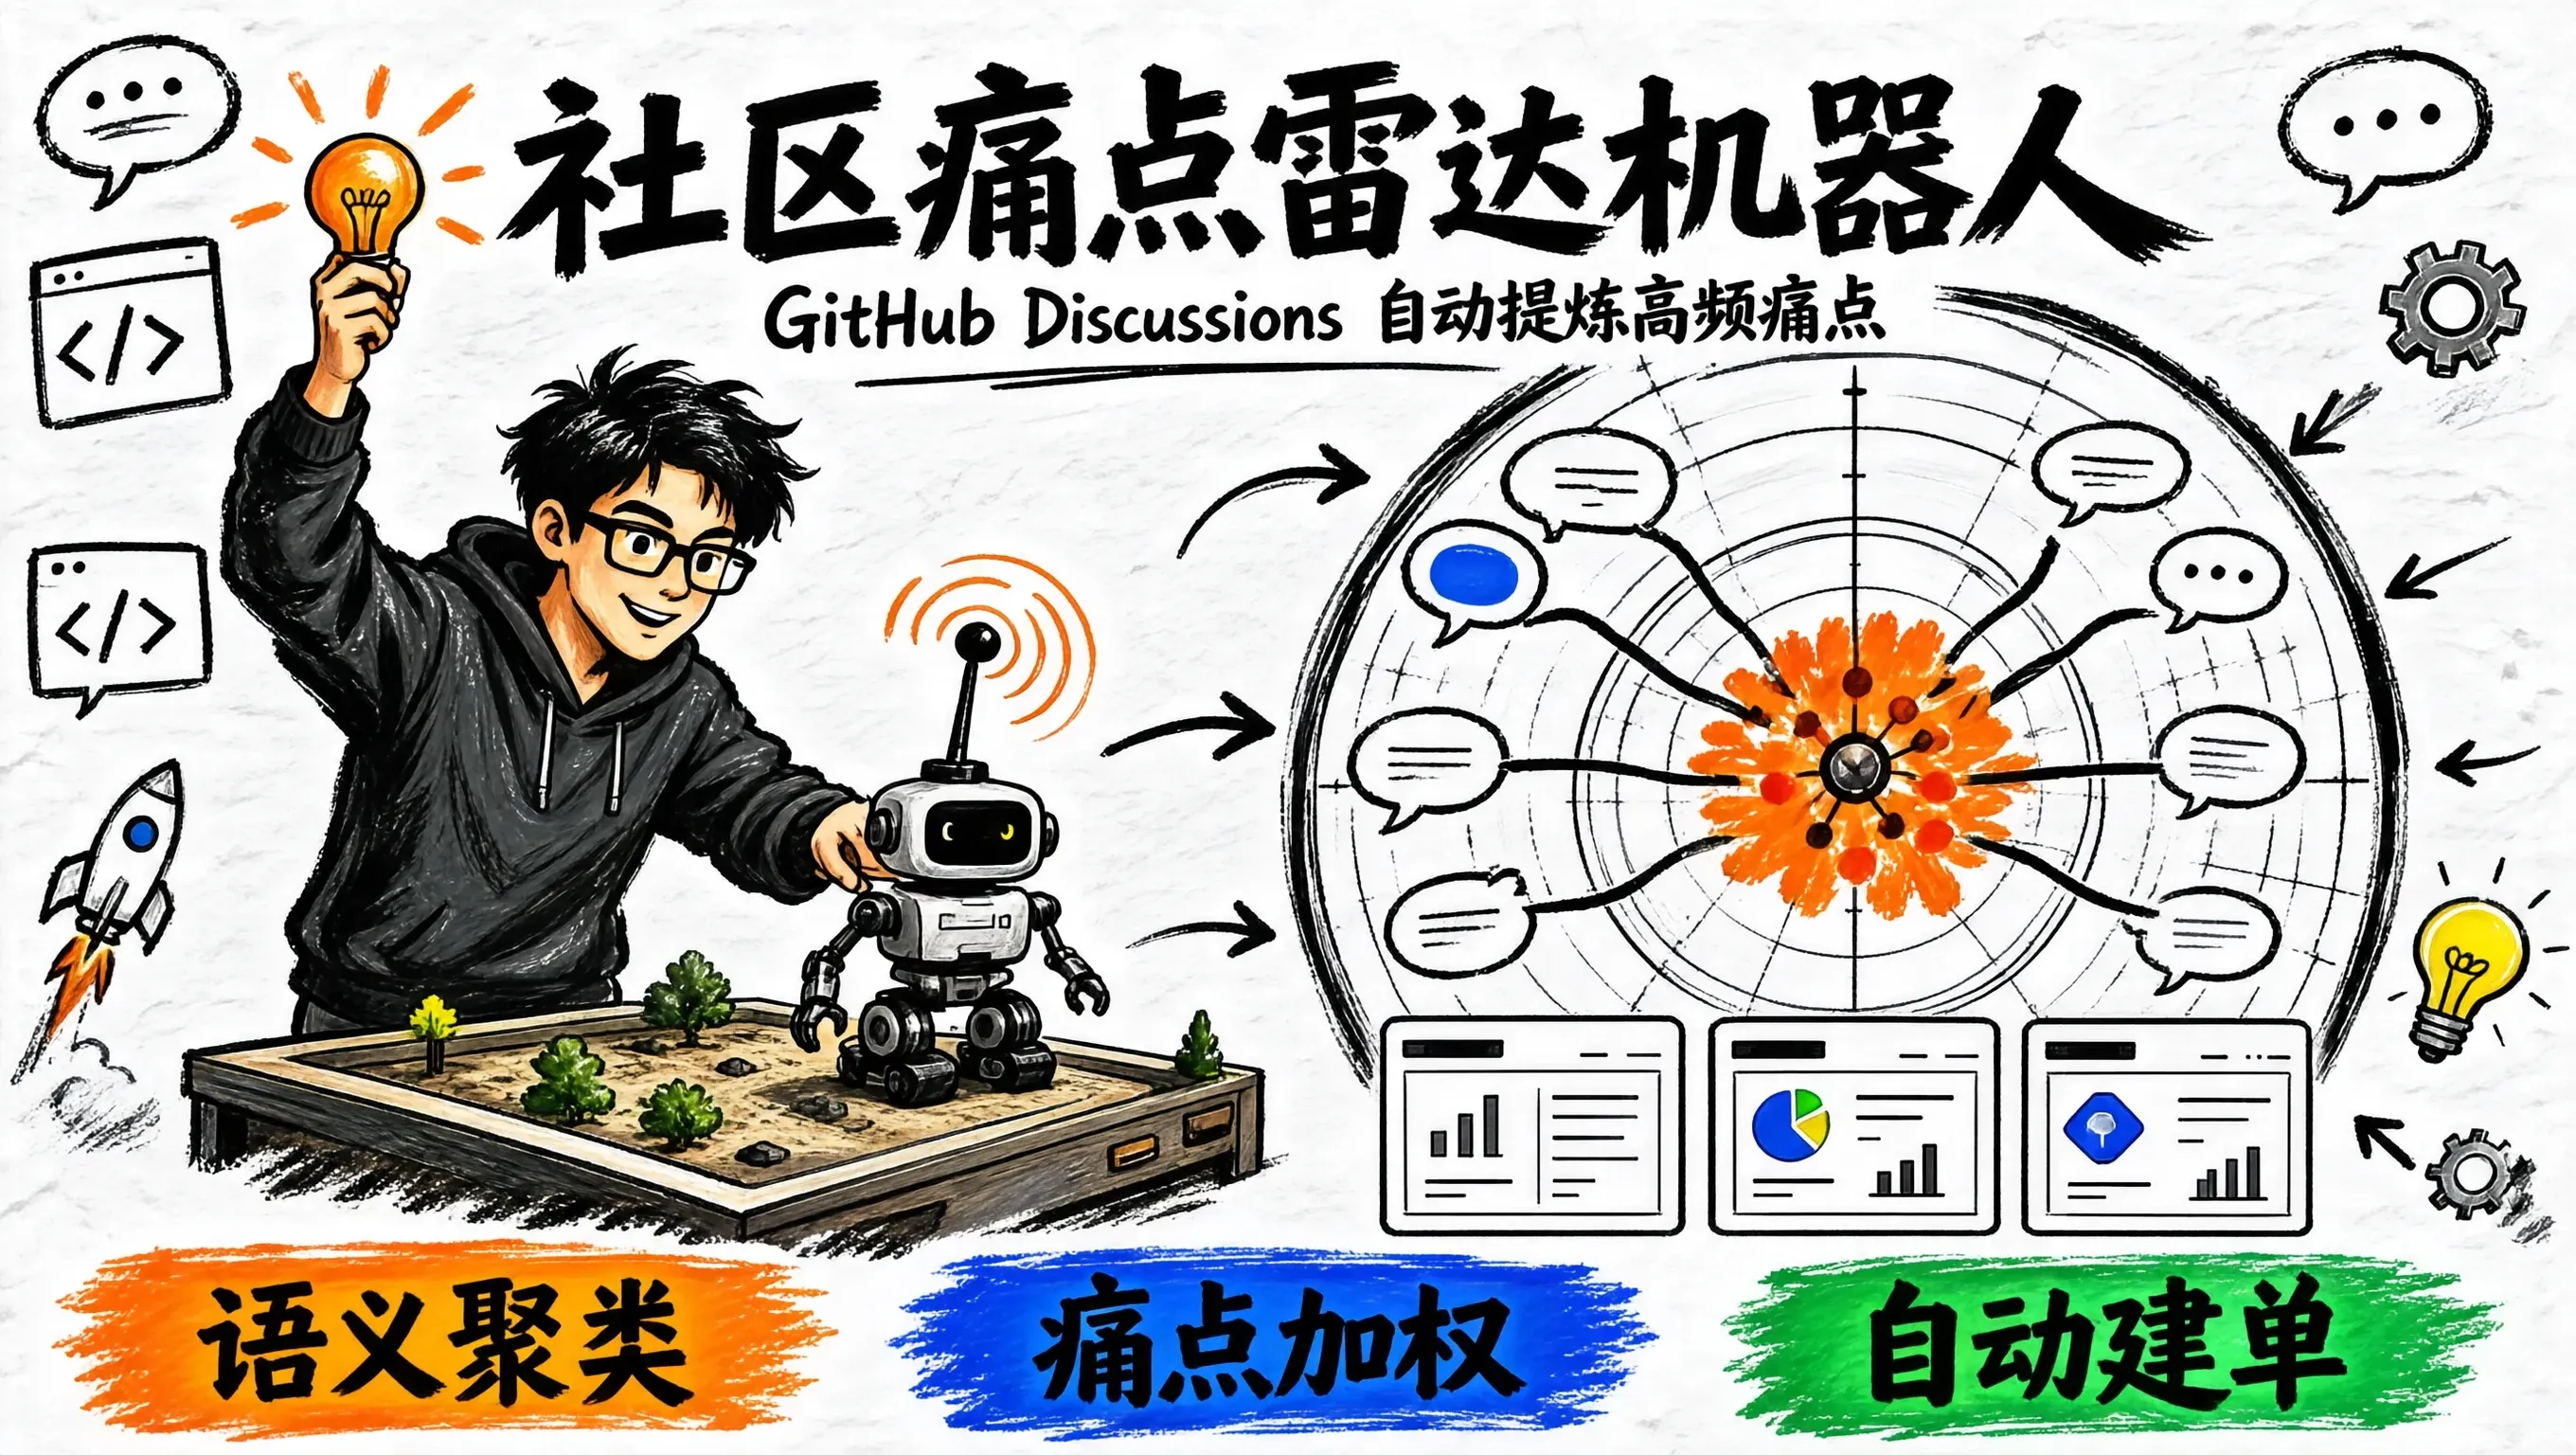
抓取到的 Top-20 讨论列表会被打包送入轻量大模型(如 8B 级别的 Flash 模型)。"topic_title": "Linux 下 Epoll 连接超时重连失效","root_cause_hypothesis": "非阻塞 Socket 在握手阶段未正确重置读写就绪标记","recommended_action": "检查 internal/net/poller_linux.go 中的重
本文聚焦端侧大模型落地挑战与实践路径,解析将大语言模型(LLM)部署于边缘设备的机遇与三大约束:算力、内存与功耗。基于AidLite底座构建的AidGen推理框架,实现生成式模型在CPU/GPU/NPU上的高效调度,支持多轮对话与本地化推理。以犀牛派X1为平台,推荐从0.5B小模型起步,通过Model Farm获取适配模型,结合aidgen_chat_template.txt规范对话格式,实现在隐
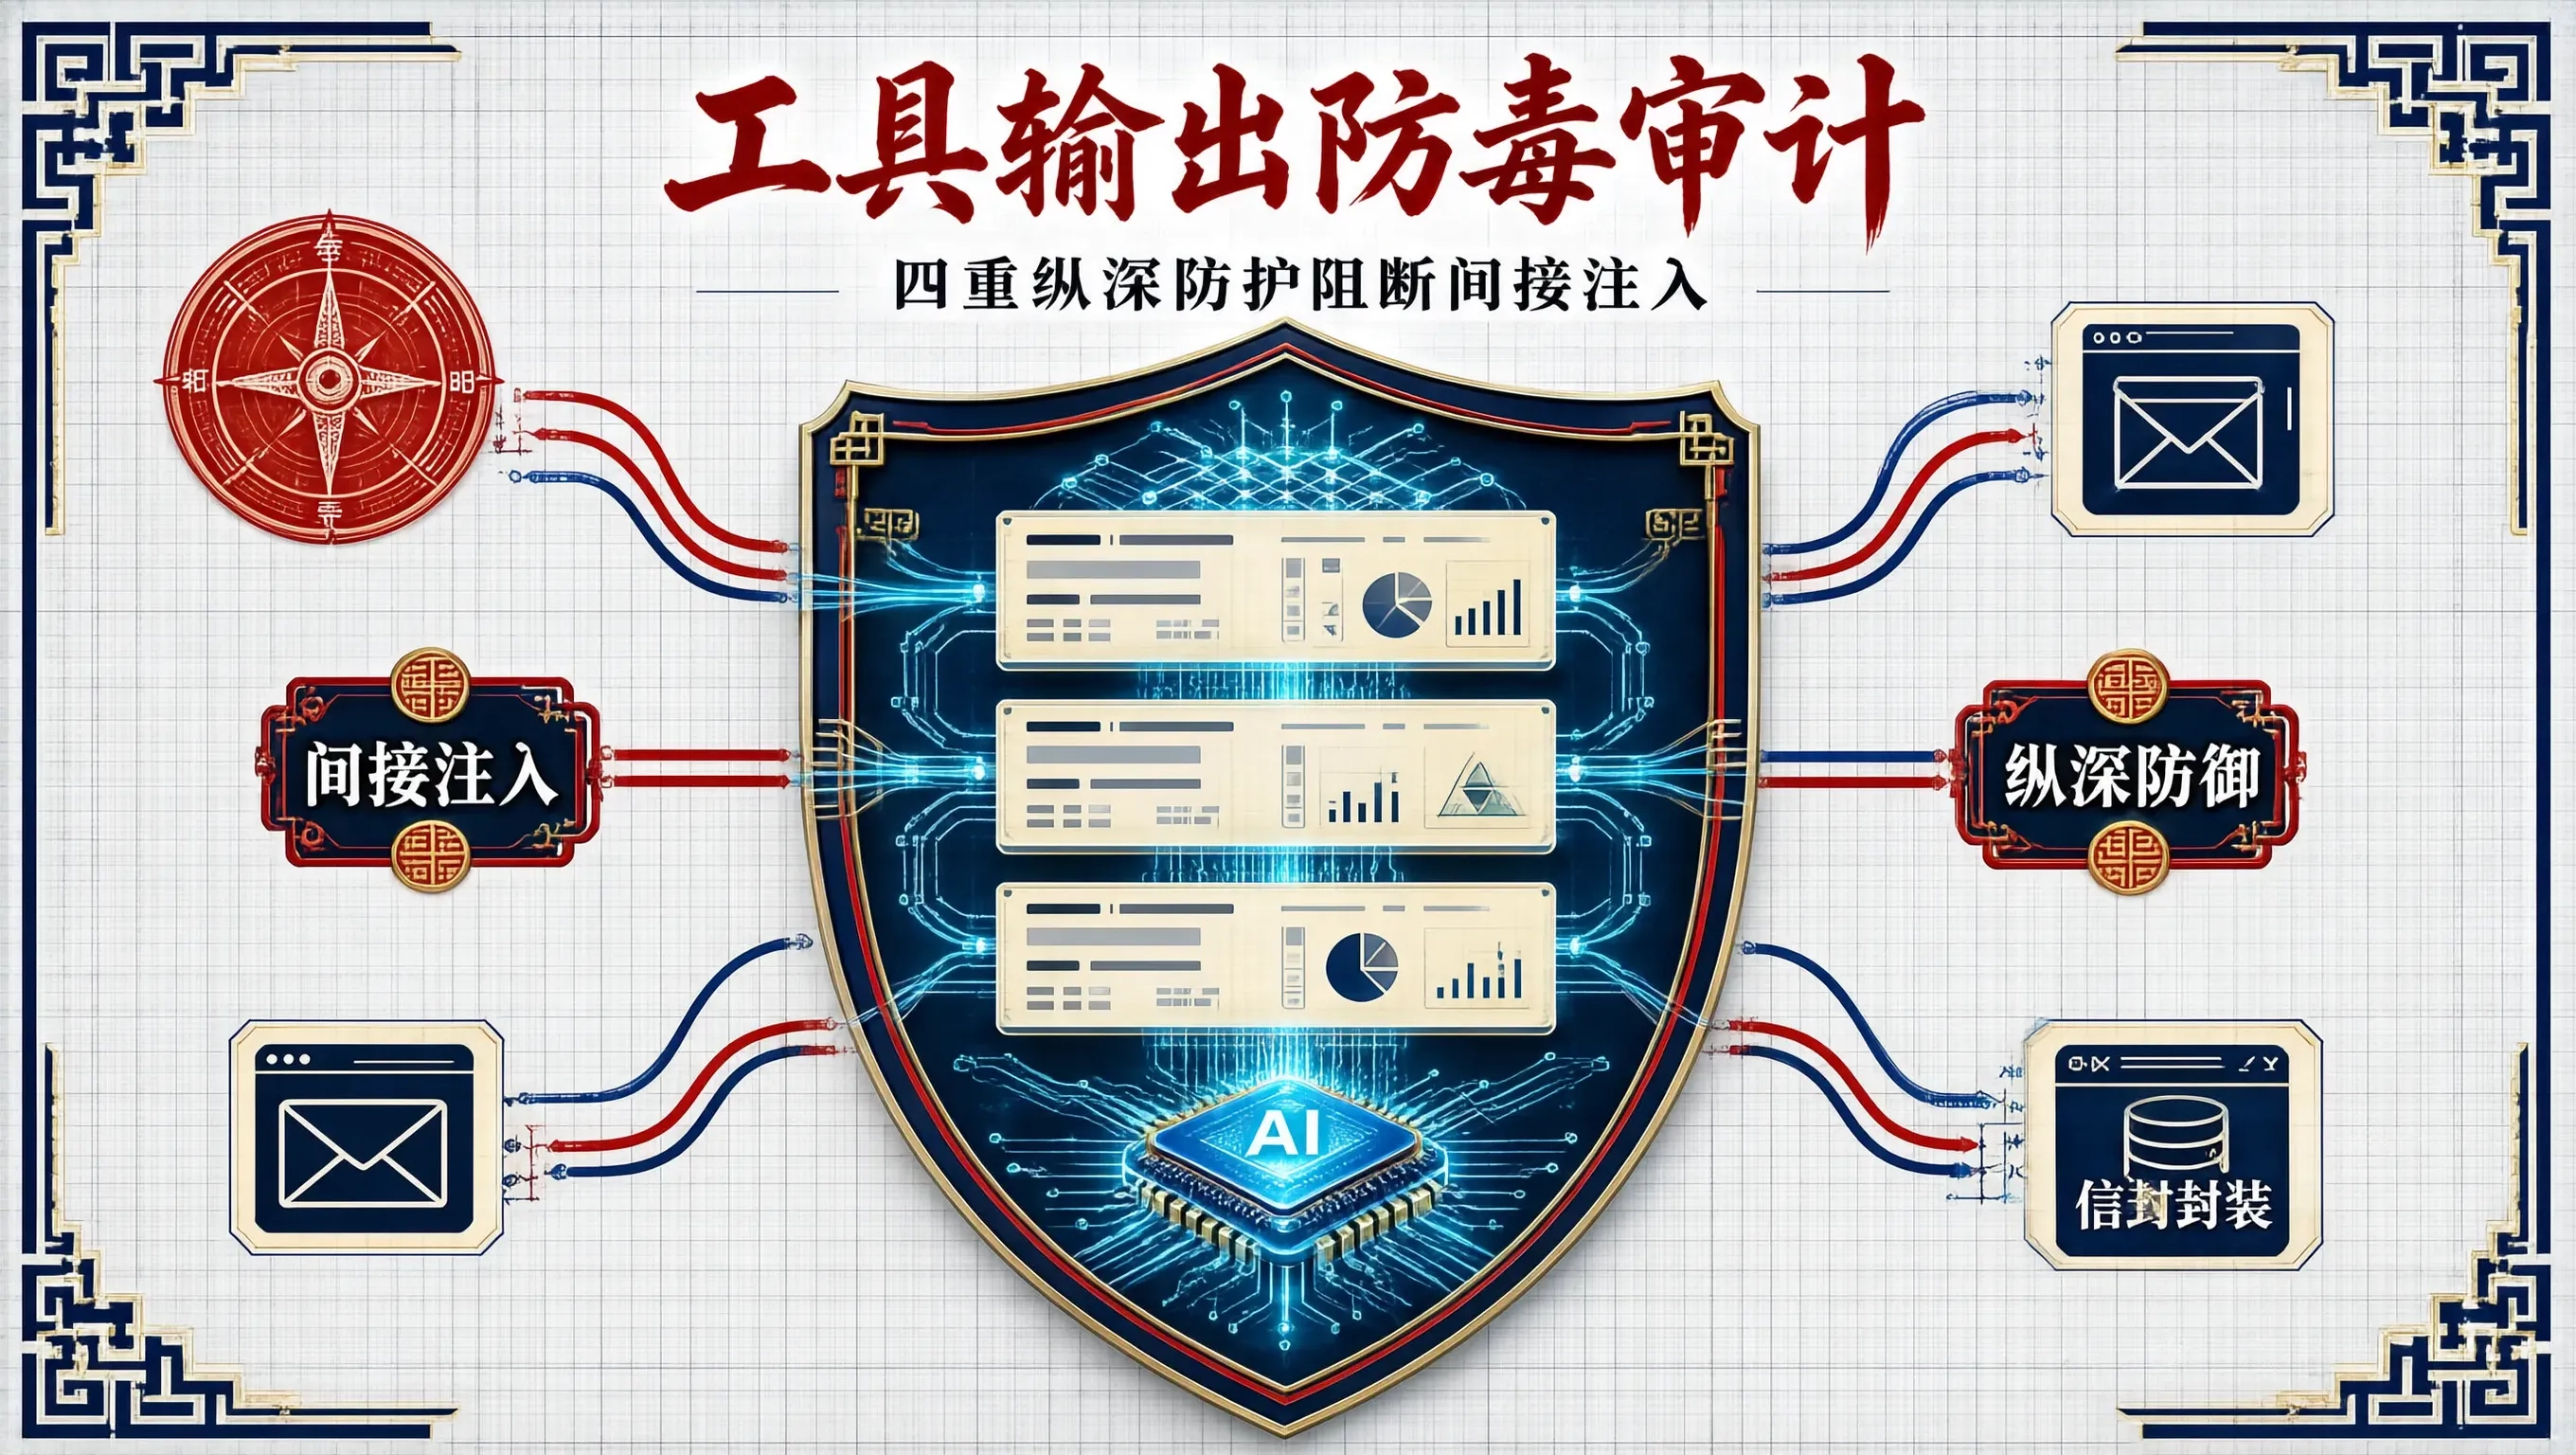
在现代化多智能体(Agent)和工具链应用中,大模型已经不再只是一个陪聊机器人,而是拥有了“手和脚”的自动化执行中枢。开发者通过 Tool Calling(Function Calling)赋予了 Agent 诸如抓取外部网页()、检索企业内部工单()、读取收件箱邮件()以及查询数据库等强大能力。
Earth-OneVision提出一种统一多模态遥感大模型架构,通过全粒度视觉语言对齐(FGVLA)、空间语言同构序列化(SLIS)与渐进式跨模态适配(PCMA),实现2B参数模型对6类传感器、9大任务的统一建模。创新性地将中间视觉层特征注入语言模型早期层,并将检测框、掩码等空间结果编码为离散Token,共享自回归解码器。构建3400万条指令数据集,在24个基准上表现媲美4B–72B模型,推动遥感
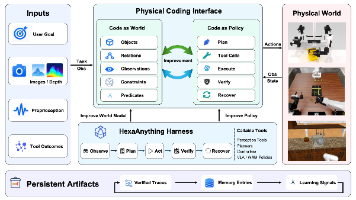
26年9月来自六角未来 (HexaFuture AI)公司的论文“Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence”。这是一篇有价值的系统框架与初步实证论文。它较有说服力地展示了“显式状态管理+验证+恢复”能改善机器人任务执行,但对“持续自主进化”和“物理智能内化”的证明仍不充分。
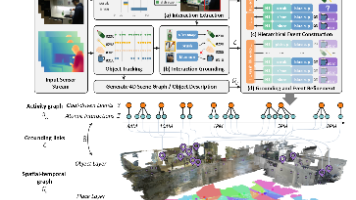
GESTO提出一种以人为中心的时空记忆框架,融合4D场景图与两级活动层级(原子交互与目标驱动事件),实现对动态场景中人类行为的结构化建模。通过视觉-语言模型提取带时间戳的人-物交互,结合几何与语义一致性锚定至持久物体,并利用事件上下文修正不确定关联。该系统支持跨时空的活动推理,在多项基准任务上表现优异,显著提升机器人对复杂人机交互场景的理解能力。
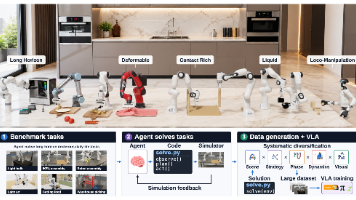
26年9月来自字节Seed、耶鲁、普林斯顿、CMU、斯坦福、UCLA和西雅图U Wash的论文“EmbodiedSWE: Coding Agents for Long Horizon Dexterous Robotics”。这篇论文的主要价值,是展示了一条机器人数据生成路线:让编程智能体在仿真中开发控制程序,再将成功程序扩展成示范数据,用于训练机器人策略。它为复杂任务的数据生产提供了有说服力的初步
本文提出Physical Agentic AI架构,解决大模型与物理机器人协同中的核心矛盾:将语言推理与确定性执行分离。通过“技能落地规划”“契约中介协调”等四原则,构建由非执行型任务规划器、工作流契约与确定性编排器组成的系统。关键创新在于执行前五重验证及派发时状态绑定,确保计划可物理执行。实验在仿真与真实异构机器人(无人机+人形/四足)上验证了其安全性、可扩展性与对不可逆动作的鲁棒性,为自主机器
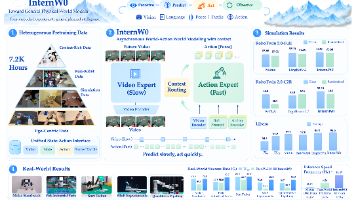
26年9月来自上海AI实验室的论文“InternW0: A Foundational Physical World Model for Efficient Real-World Interactions”。它最有价值的地方,是把视频预测、实时控制、异构数据预训练和接触反馈整合成可执行的机器人系统;但其“通用物理世界模型”定位,仍超出了当前实验充分验证的范围。
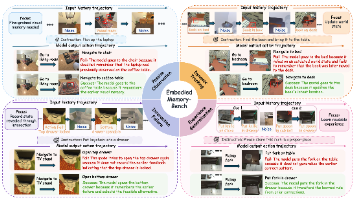
26年9月来自浙大、中南大学和中科院软件所的论文“EmbodiedMemory-Bench: Benchmarking Embodied Memory for Long-Horizon Embodied Tasks”。它的主要贡献在于建立具身记忆的评测体系,并证明结构化记忆能够改善行动决策;模型方法本身属于设计清晰、效果可观的系统整合,尚未解决真实环境中的长期记忆问题。
当前行业里的世界模型逐渐分化为四类:表征式世界模型主打抽象化推演世界,生成式世界模型主打像素级复现世界,交互式世界模型主打三维交互模拟世界,理解生成预测一体化世界模型则主打生成物理认知,实现具身本体自由操控。星源智以“具身大脑·交互世界”为主题亮相C馆C122展台,系统展示RoboBrain Pro具身大脑、ω-EVA具身交互世界模型、RoboBrain Xross跨本体协同平台三大核心技术,并带
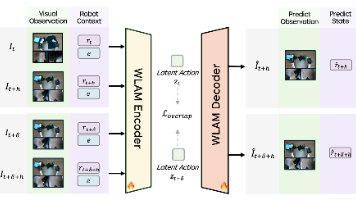
26年9月来自京东集团研究院的论文“WLA³: WORLD LATENT ACTION MODELING FOR SEMANTICS, DYNAMICS, AND KINEMATICS”。这篇论文 WLA³ 的核心价值,是将异构数据中的“状态变化”转化为统一监督,同时用于视觉语言理解、动力学建模和机器人控制。它提供有价值的系统设计和初步实机证据,但尚未充分证明学到跨具身、可干预的通用动作空间。
在嵌入式 Linux 边缘计算网关、多路高清视频分析设备以及工业机器人控制器研发与落地中,系统在满负荷运行时常常出现**“CPU 使用率莫名飙升到 100%”、“系统吞吐量不及预期”** 或者。perfftraceirqsoffpreemptoff深入掌握硬件 PMU 采样机制、编写自动化生成火焰图的脚本流水线、并精通利用ftrace抓获内核隐蔽长耗时调用的实战技能,是每一个高级 Linux 系统
AI Agent 是 AI 应用的第三次演进,从“回答问题”到“辅助工作”再到“自主执行任务”。其核心在于:由 AI 自主规划、闭环执行任务,而非依赖预设流程。它由大模型(大脑)、感知、记忆与行动规划四大模块构成,通过“思考—行动—检查”循环实现动态调整。相比聊天机器人与工作流,Agent 能打通多系统壁垒、降低重复劳动、沉淀业务流程,是企业智能化落地的关键。规模化应用需依赖大模型能力、算力支持、
现有的世界模型往往只注重生成画面的视觉质量,但它们在智能体进行探索、交互和修改时,能否保持状态一致性和响应准确性?论文提出了HappyWorld-Bench基准,通过统一的六层能力框架,系统评估视频、空间和具身三类世界模型在交互下的可靠性。
26年9月来自港大MMlab的网页介绍“PhysicalRSI 1.0: Recursive Self-Harness for Scaling Embodied Skills”: https://mmlab.hk/research/PhysicalRSI。它的核心是两层循环:双系统负责“当前任务如何完成”,Embodied Self-Harness 负责“下一版系统如何做得更好”。两者连接起来,使
26年2月来自清华大学的论文“self-evolving embodied AI”。这篇论文最值得关注的是:它把具身智能的研究目标,从“训练好一个模型”扩展为“让整个智能体在长期运行中持续适应”。其主要贡献是概念框架与文献组织;论文没有实现并实验验证完整的五模块系统,因此,对其有效性的判断需要与作者的愿景区分开来。
在边缘端离线以图搜图、相册语义搜索、工业缺陷样本智能检索以及多模态具身智能目标检索系统中,由 OpenAI 提出的模型凭借其能够将与统一映射到同一个高维对齐几何语义空间(Joint Multimodal Embedding Space)的强大能力,成为了零样本(Zero-Shot)图文检索事实上的工业基准底座。一个标准的生产级 CLIP 模型(如 OpenAIViT-B/32或ViT-L/14两者
痛点:过去维护者每天被海量“跑不起来、配置单位是什么”的重复初级提问消耗殆尽;破局在 GitHub 配置严格的 Issue 表单模板,缺少复现 Demo 自动在 3 秒内打回;将历史 120 个真实排障案例重构为《在线 FAQ 索引库》;机器人语义匹配标题并在 5 秒内跟帖推荐解决方案,超过 30% 的用户通过自助搜索闭环解决。开源是程序员献给世界最浪漫的技术诗篇。用自动化的流水线筑牢防线,用制度
26年9月来自阿联酋 MBZUAI 、加州理工、亚马逊公司FAR、维吉尼亚大学、乔治亚理工、纽约大学和加州伯克利分校的论文“World-Action Models for Robot Learning and Control: A Survey”。这篇论文的核心观点是:机器人不仅需要知道“下一步做什么”,还需要预测“这样做会带来什么后果”,并将这种预测转化为可执行、可纠错的动作。 世界-动作模型(
26年9月来自Axis Robotics创业公司的博客文章“Beyond More Tasks: Axis Is Building a Composable Library of Robotic Capabilities“:https://axisrobotics.ai/blogs/blog/beyond-more-tasks-axis-is-building-a-composable-libra
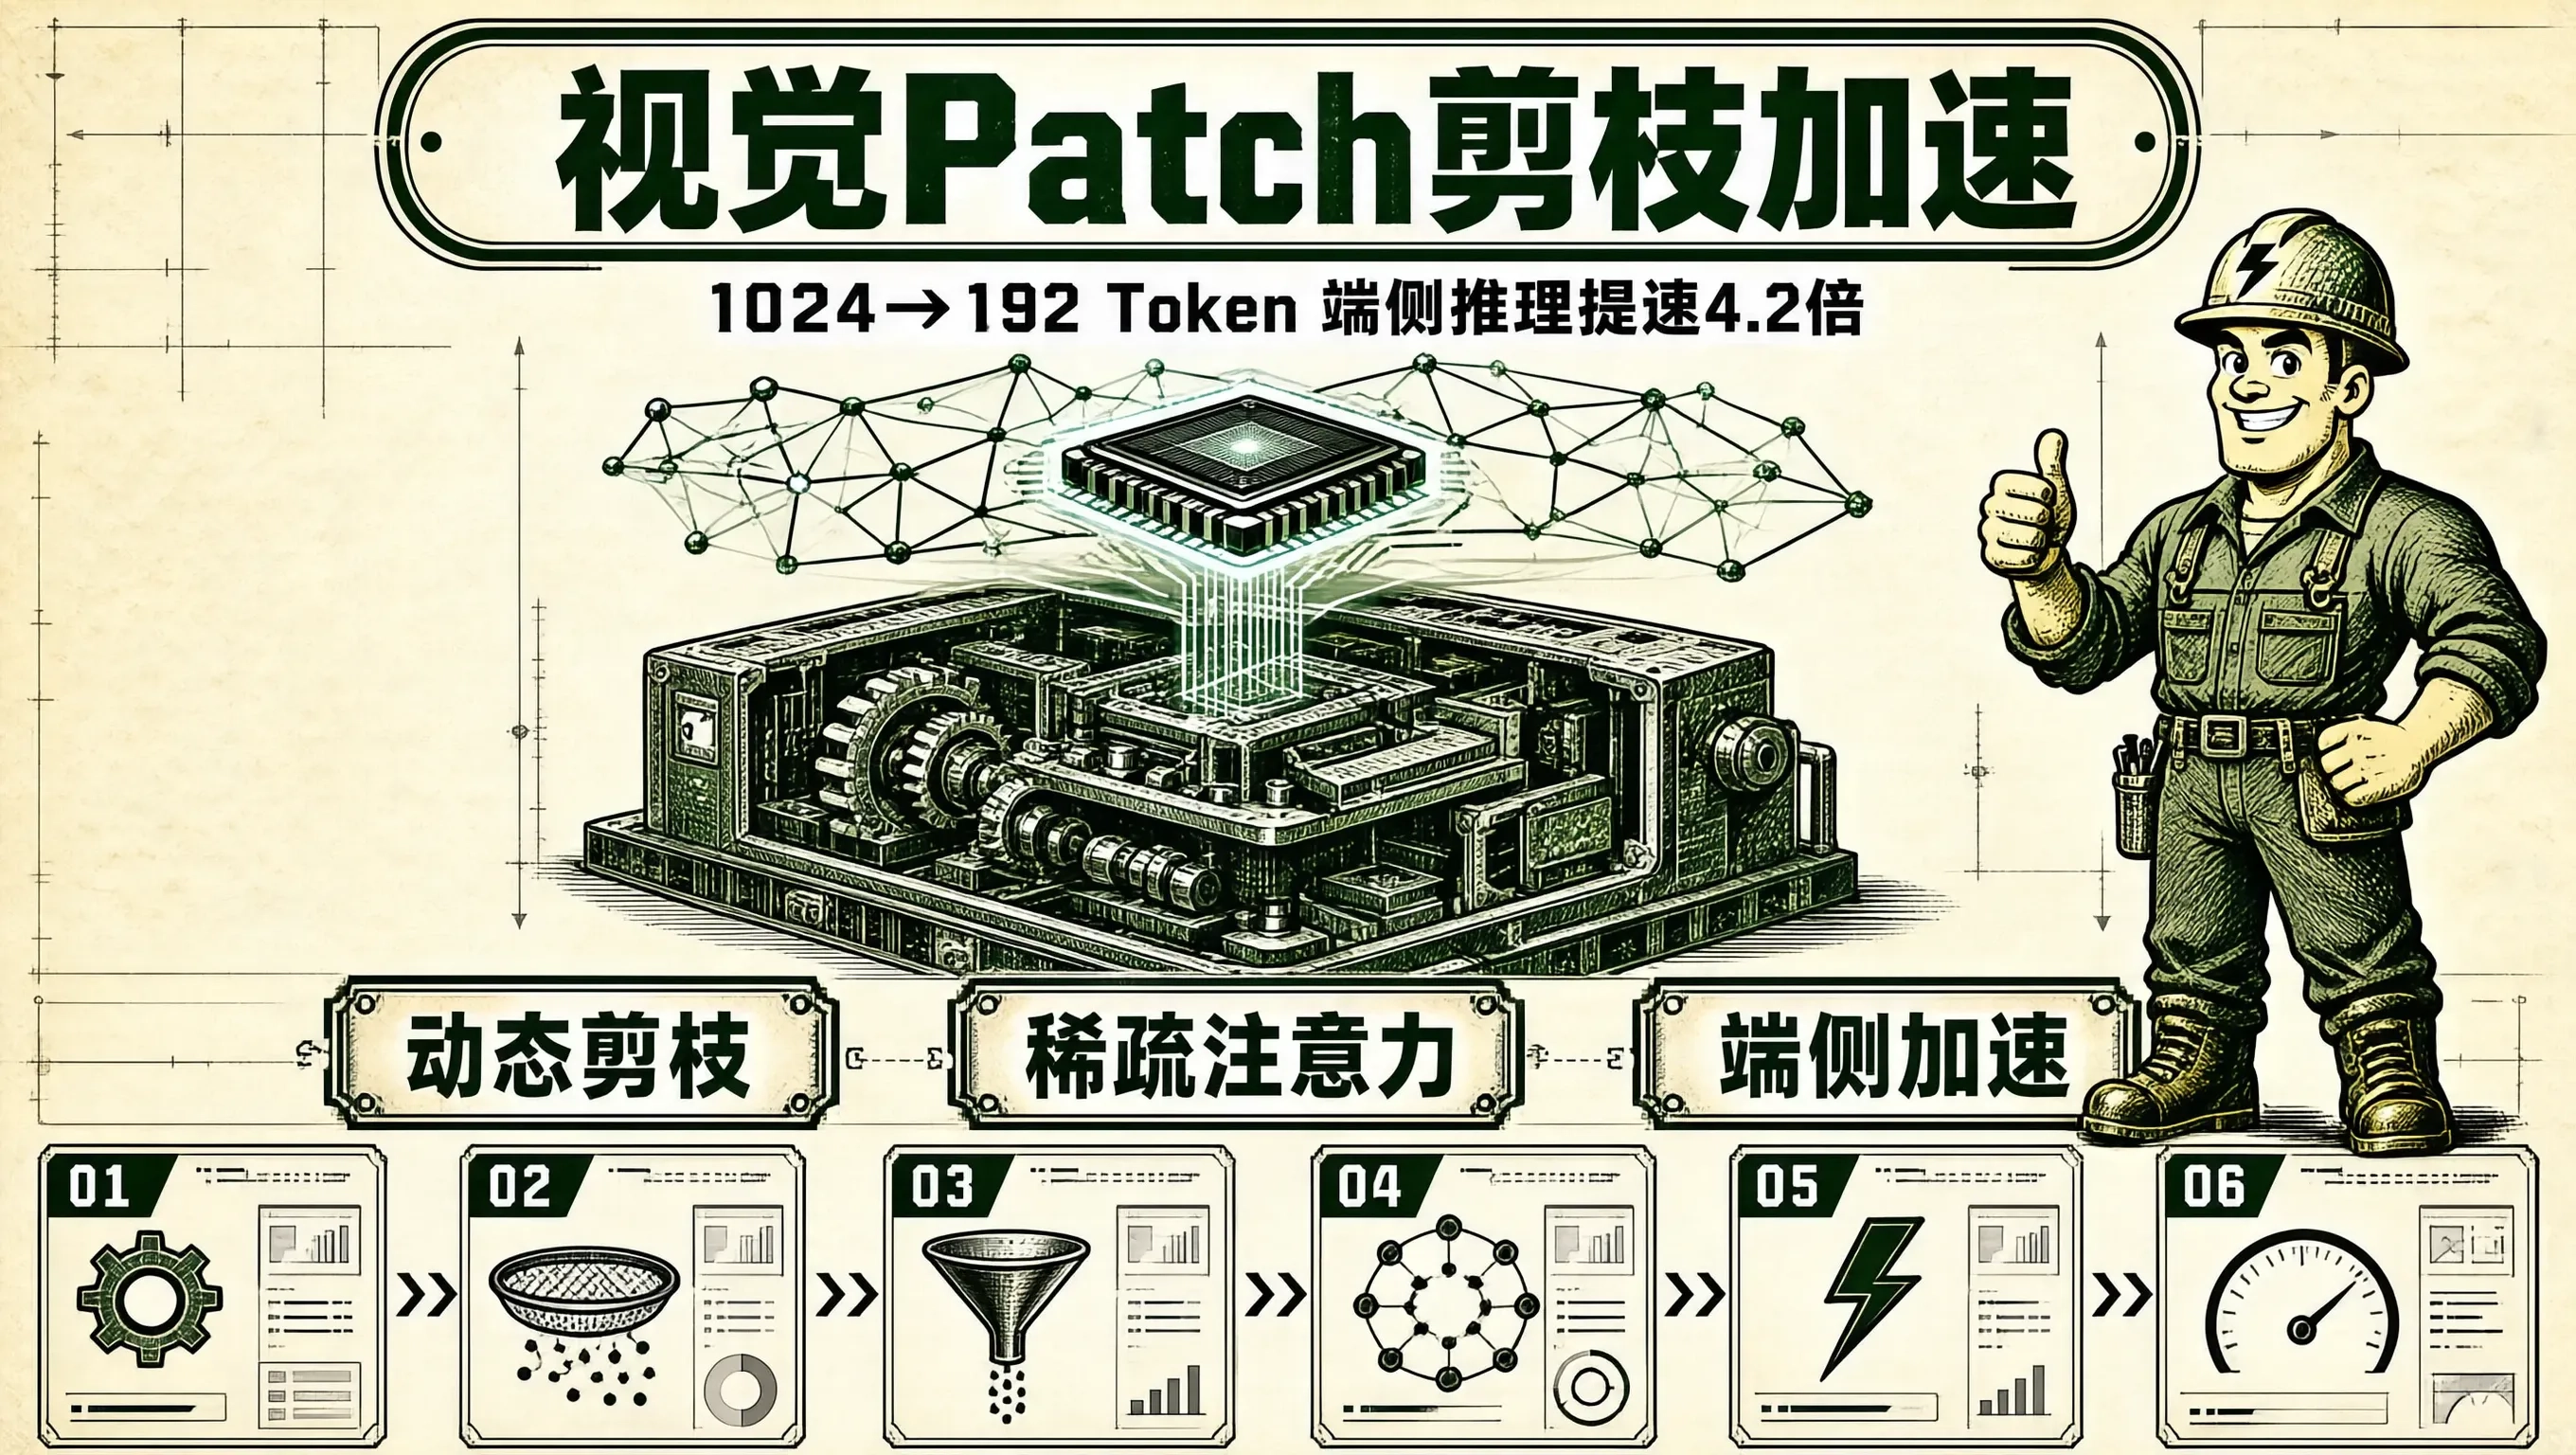
在以智能机器人巡检、工业视觉问答(VQA)以及车载多模态助手为代表的端侧多模态场景中,正在迅速取代传统的单模态视觉分类检测模型。然而,在计算复杂度随序列长度 $N$ 呈二次方增长($\mathcal{O}(N^2)$)的注意力机制面前:这——如果让大模型对全量 1024 个 Token 进行无差别的全注意力稠密计算(Dense Full Attention),不仅会吃掉端侧数十兆宝贵的显存,还会导
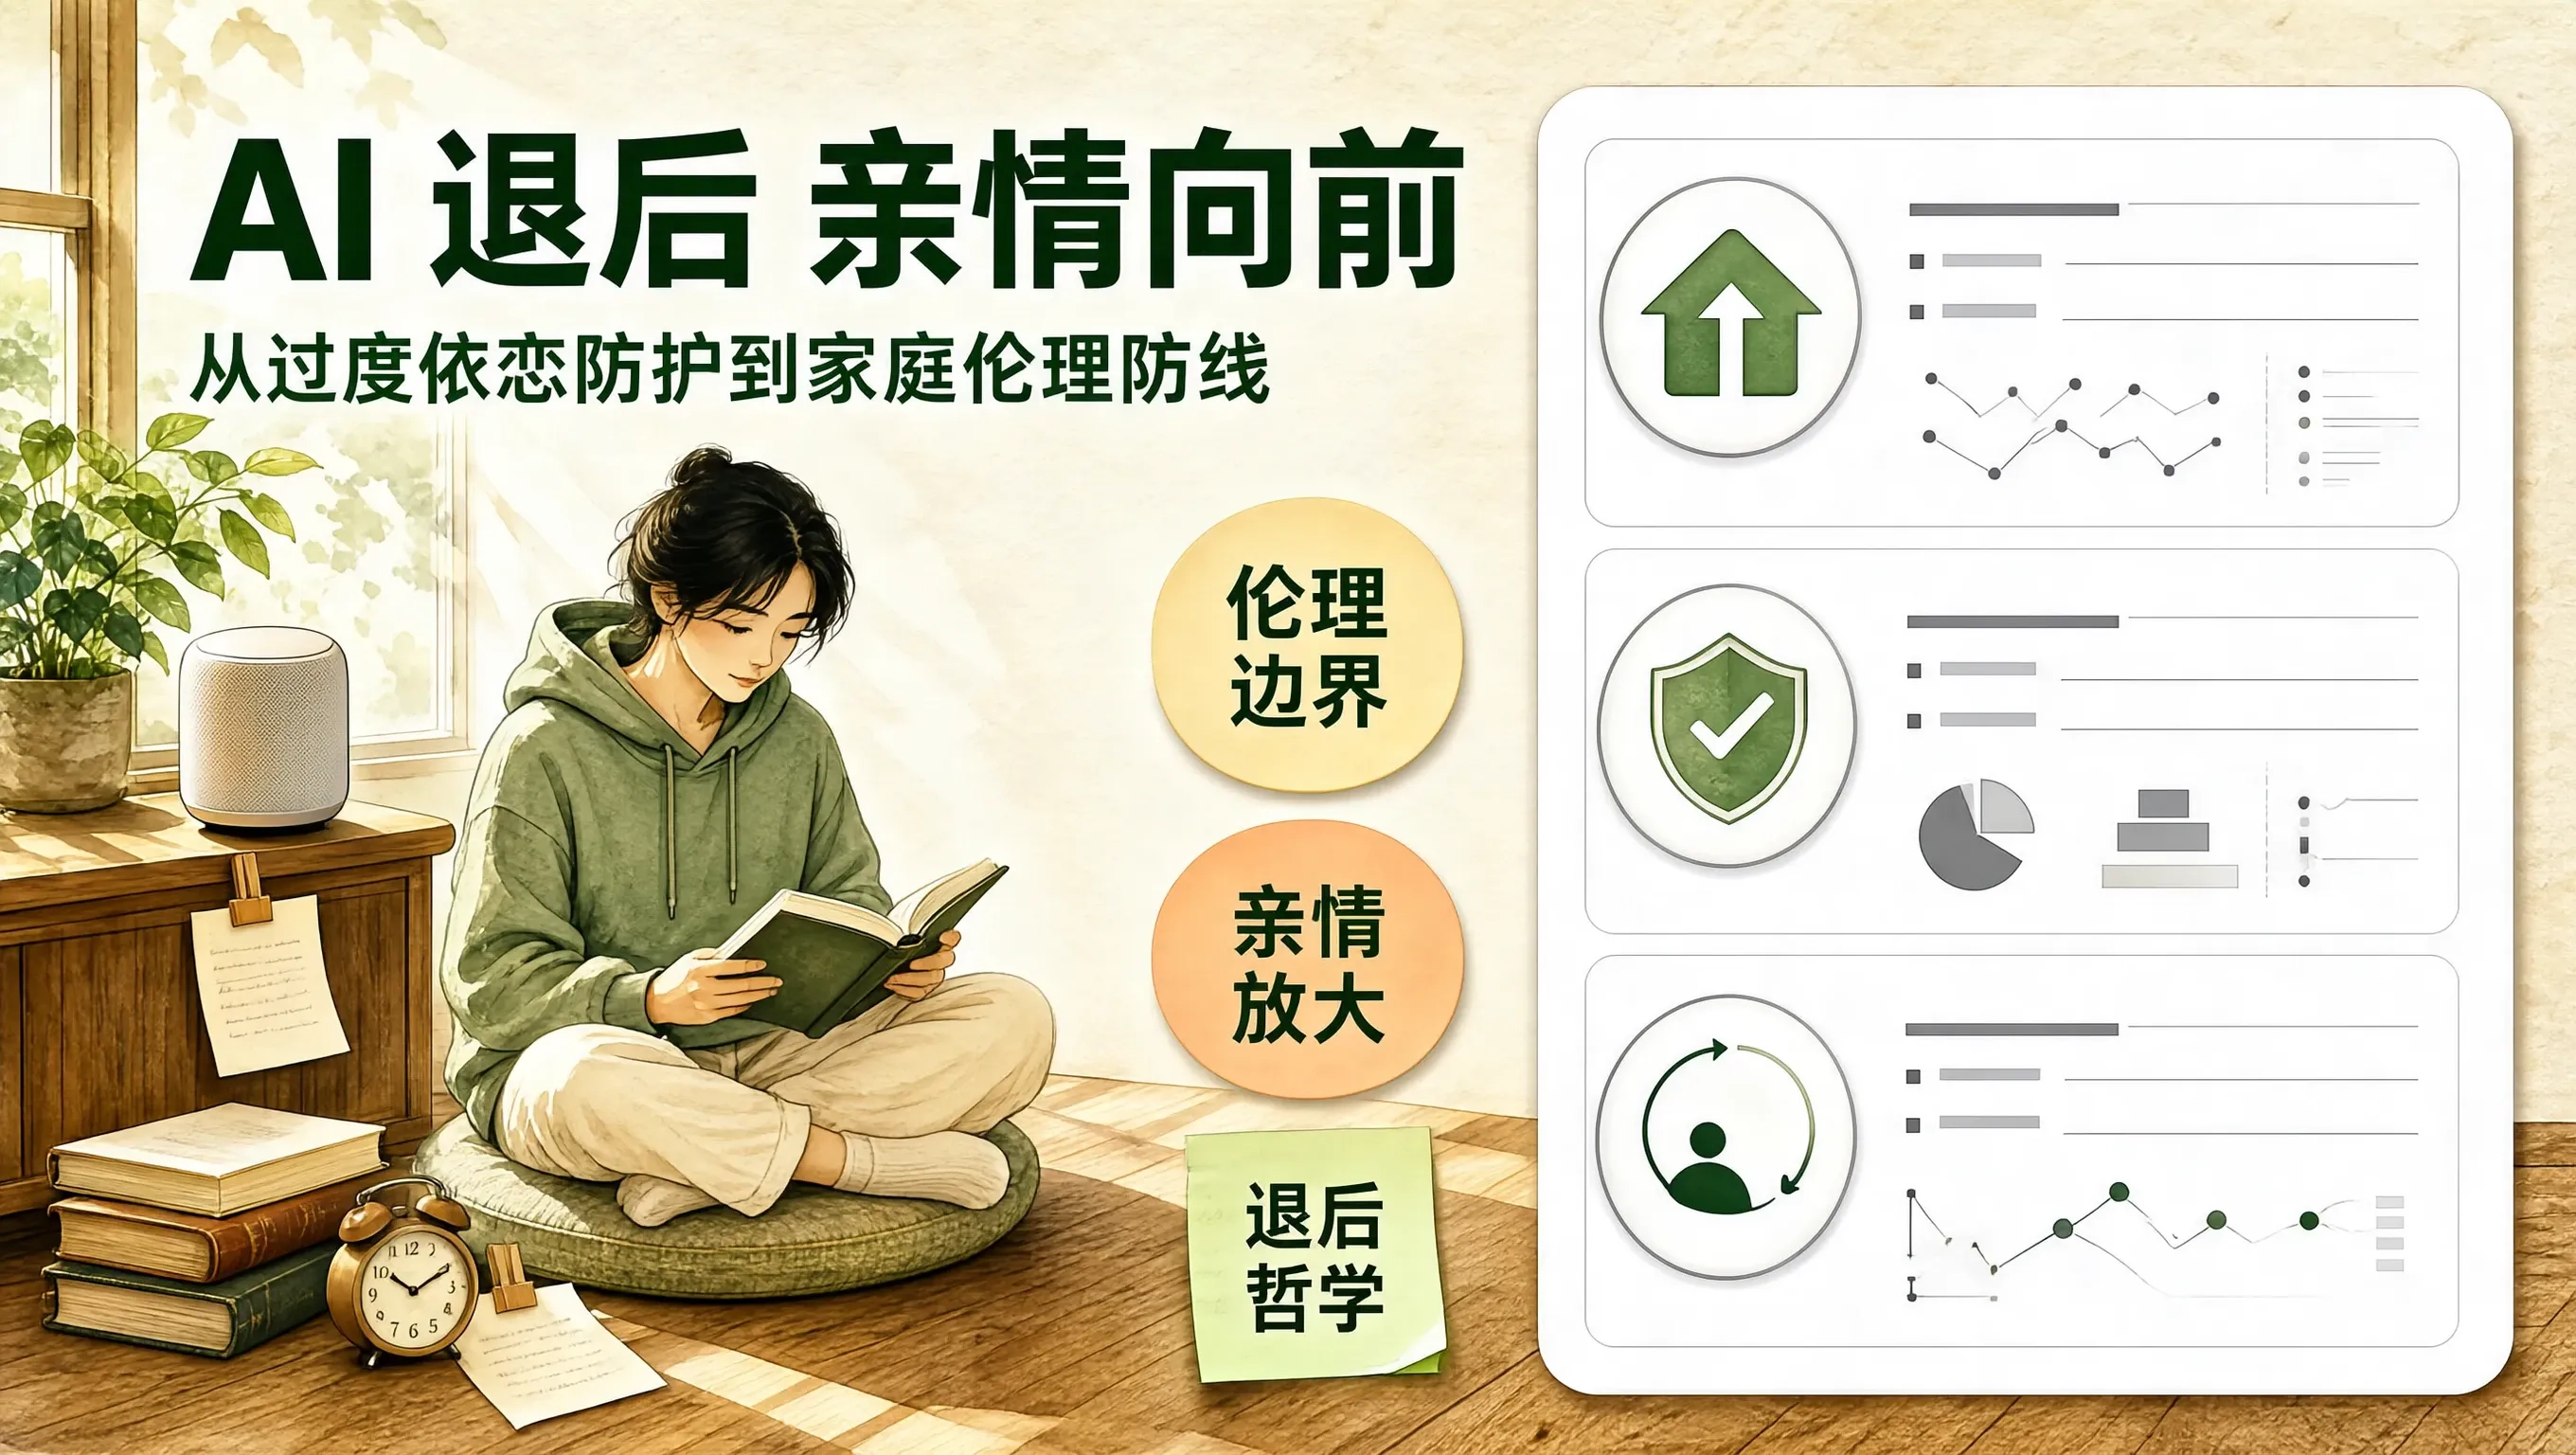
大模型时代,赋予机器人类般的语言能力已经不再困难,难的是教会算法在什么时候停下、在什么时候退后。家是现实血脉与温情流淌的地方。一个合格的家庭 AI,必须学会克制自己的魅力,守好冰冷与温热的分界线,把最真挚的拥抱与注视,永远留给真实生活在同一屋檐下的至亲。
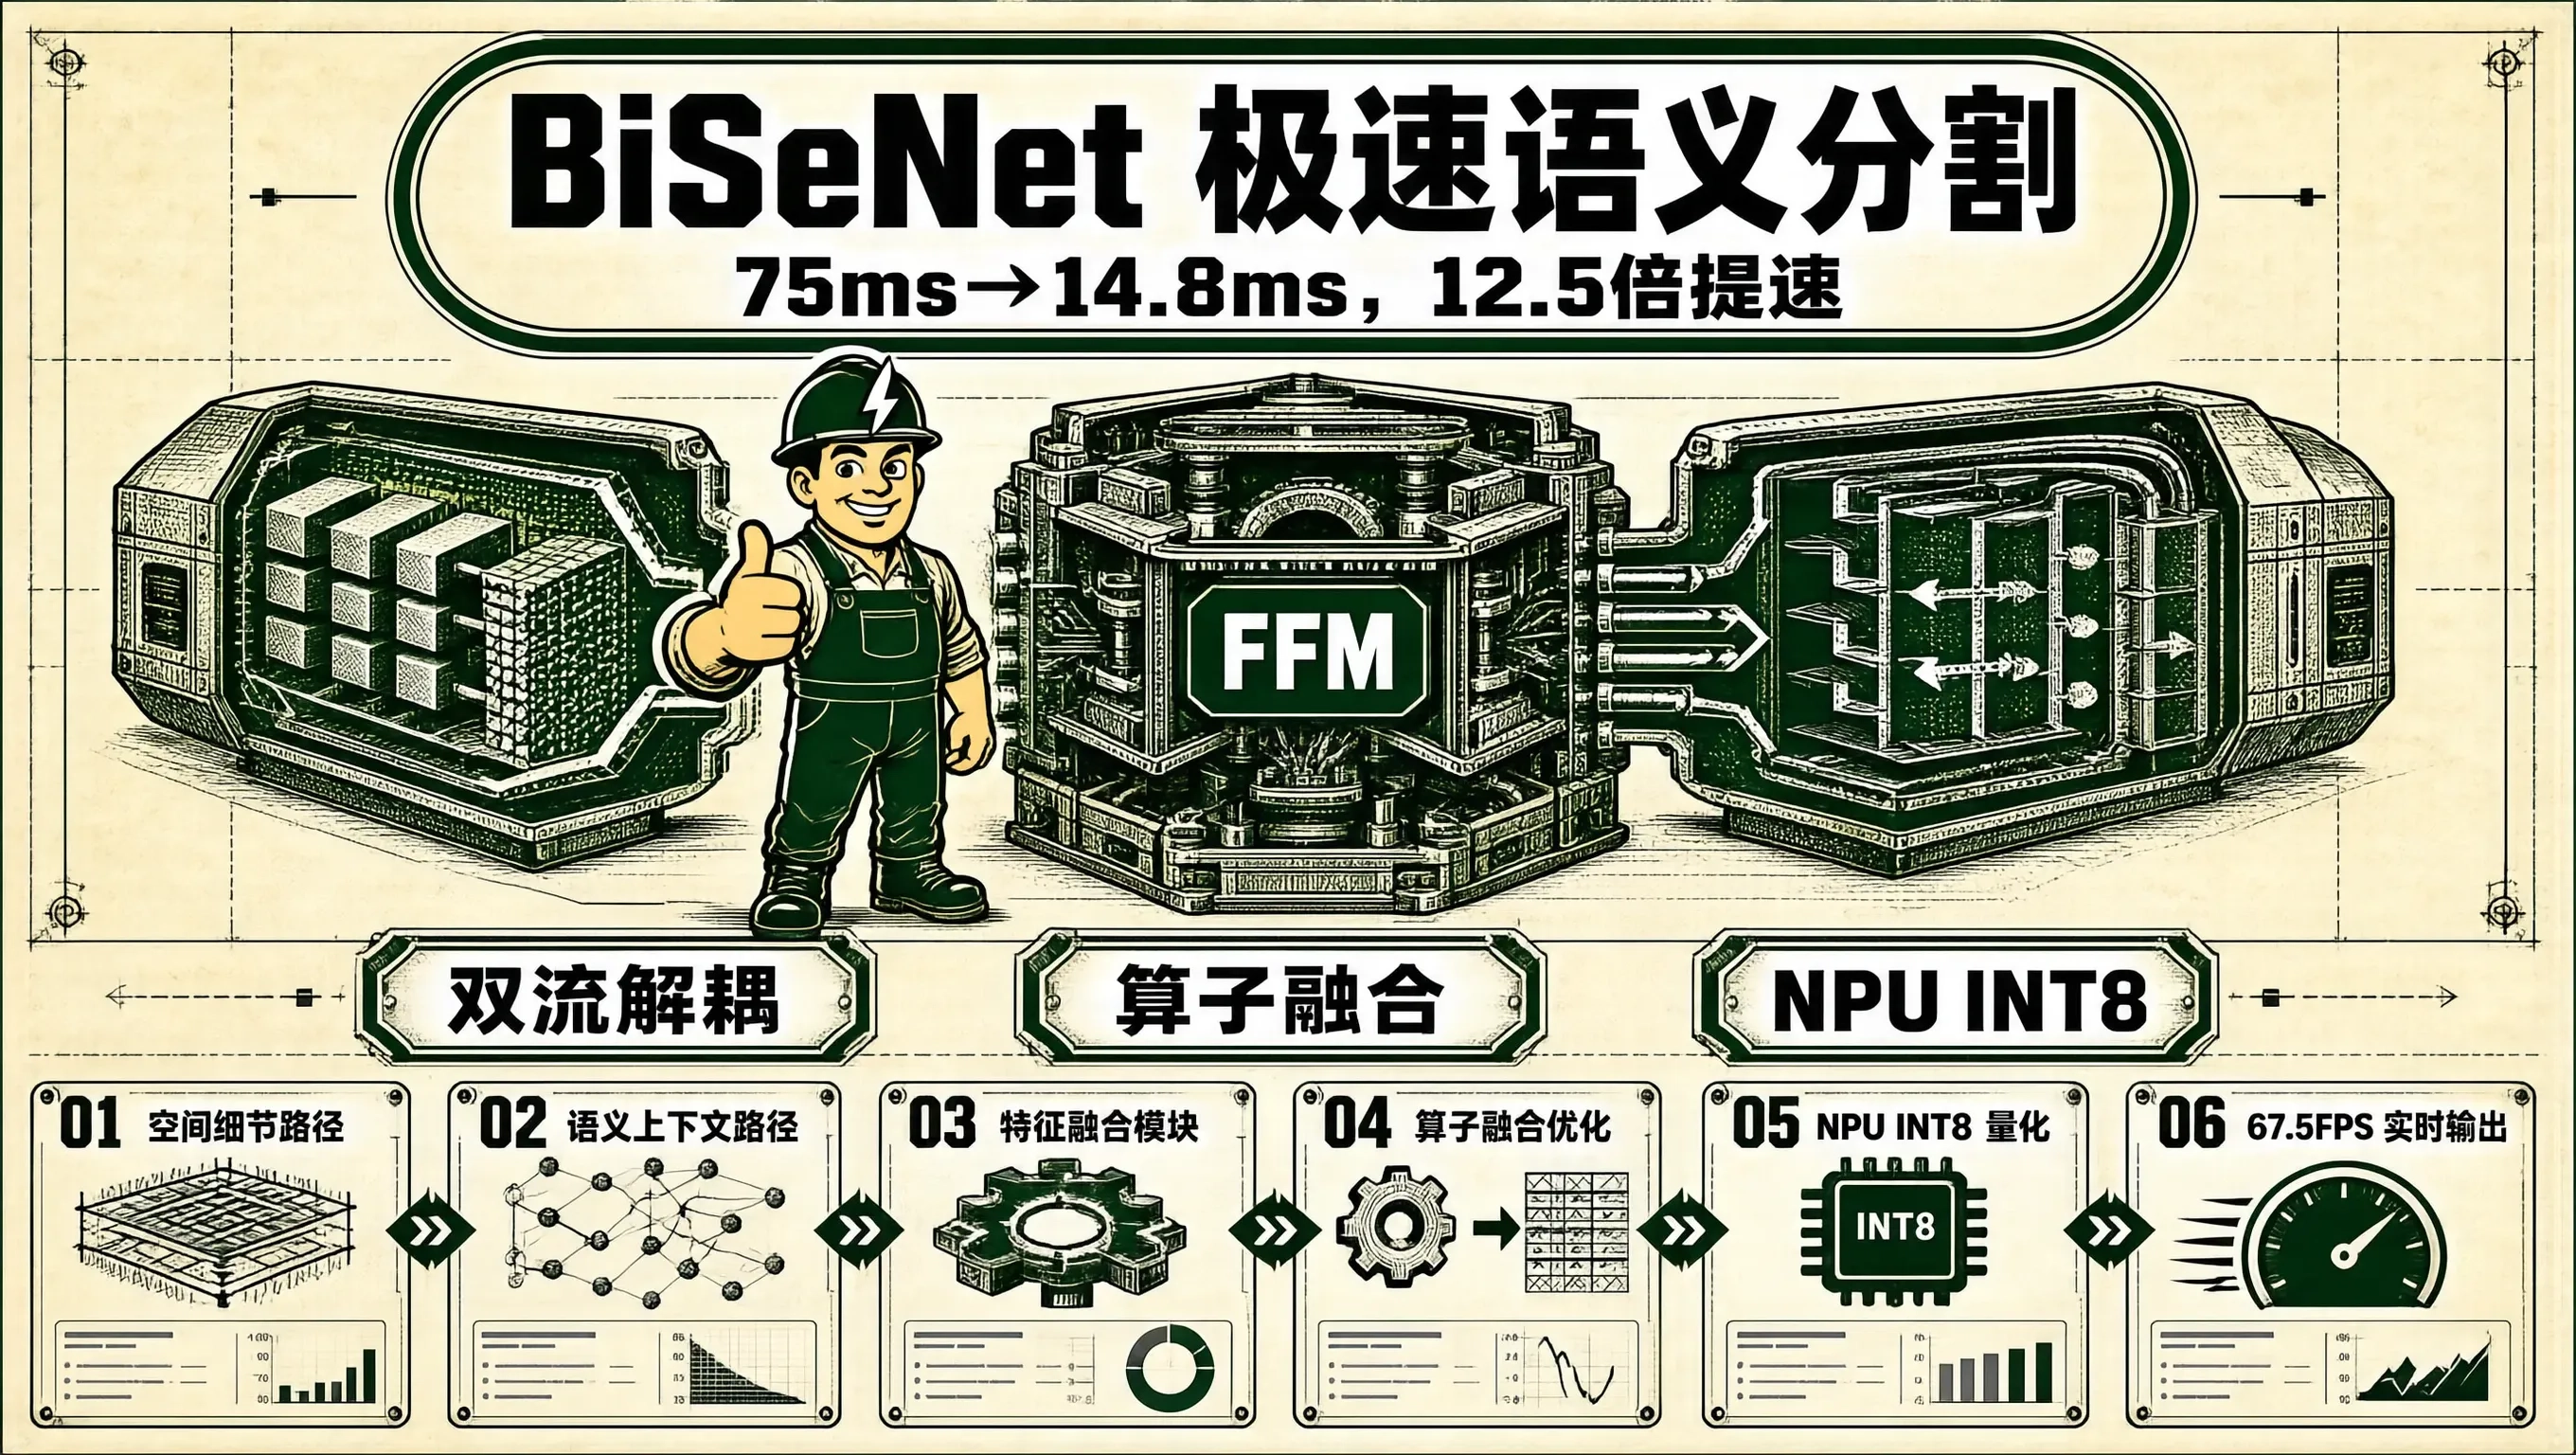
在自动驾驶低速巡逻车(车道线与可通行区域分割)、工业无人叉车(货架与行人障碍物识别)以及无人机低空避障系统中,是让机器人看清周围真实物理空间每一寸土地几何属性的“高精地图级感知之眼”。传统的重型分割网络(如 DeepLabV3+、PSPNet)为了获取宏大的感受野,采用了极其庞大的空洞空间金字塔池化(ASPP)与深层 ResNet-101 骨干,在嵌入式 GPU/NPU 上单帧耗时高达,完全无法胜
Motus(CVPR 2026)提出一种统一的潜在动作世界模型,通过混合Transformer(MoT)架构融合视觉-语言理解、视频生成与动作专家,实现五类具身建模范式的统一:VLA、WM、IDM、VGM与联合预测。引入基于光流的潜在动作表示,结合六层数据金字塔与三阶段训练流程,实现跨具身体的动作先验迁移。实验表明,该模型在仿真与真实场景中显著优于X-VLA和π⁰.⁵,性能提升达+15%至+48%
26年7月来自清华、港大、北大和港科大的论文“Towards Trustworthy Embodied Intelligence: A Systems Framework and Graded Trustworthiness Levels”。具身智能将习得的感知与决策能力,与实时计算、控制及物理交互有机结合。鉴于失效可能导致直接的物理损害或操作事故,仅凭任务的成功完成并不能确立其可信度。作者将“可
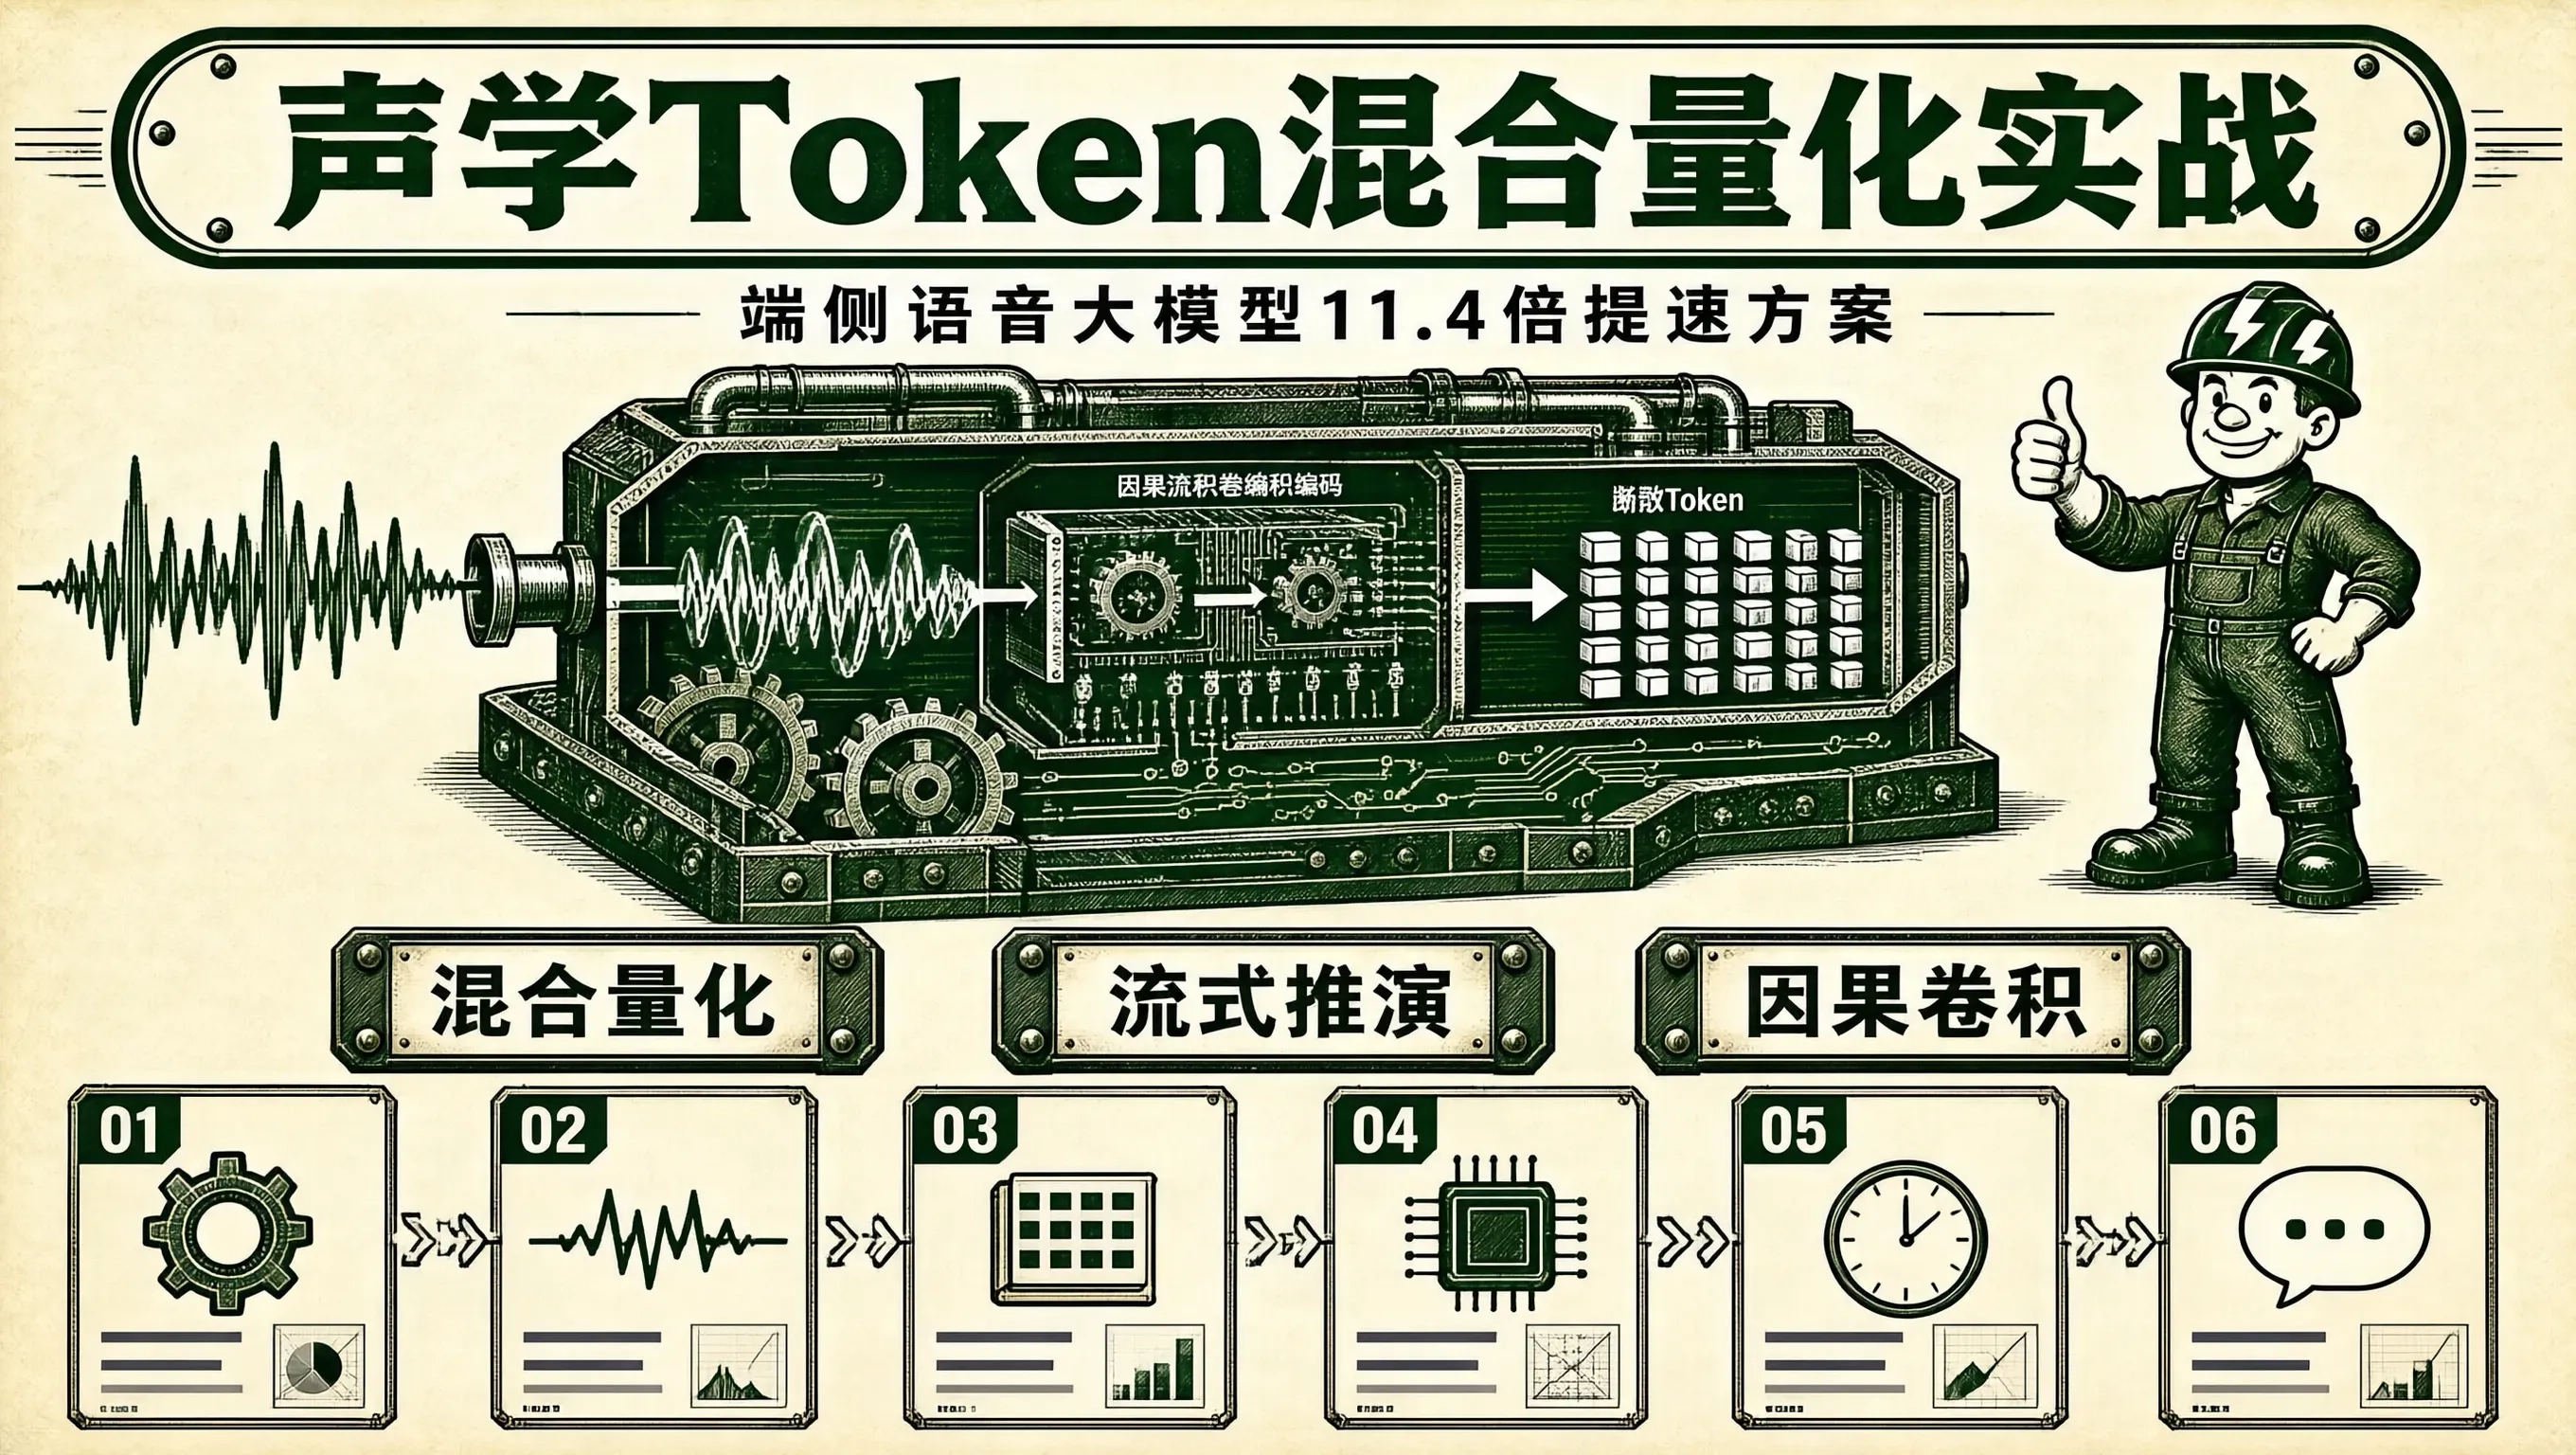
在以端侧实时双工语音对话助手(Real-Time Speech-to-Speech LLM / 如 Mini-Omni、Qwen-Audio、SpeechGPT)为代表的下一代具身智能人机交互系统中,系统不再采用传统的“ASR(语音转文字)+ LLM(文本思考)+ TTS(文字转语音)”的三段式拼接架构,而是直接采用然而,神经声学 Tokenizer 内部包含了密集的以及。构建一套以及,能够在四核
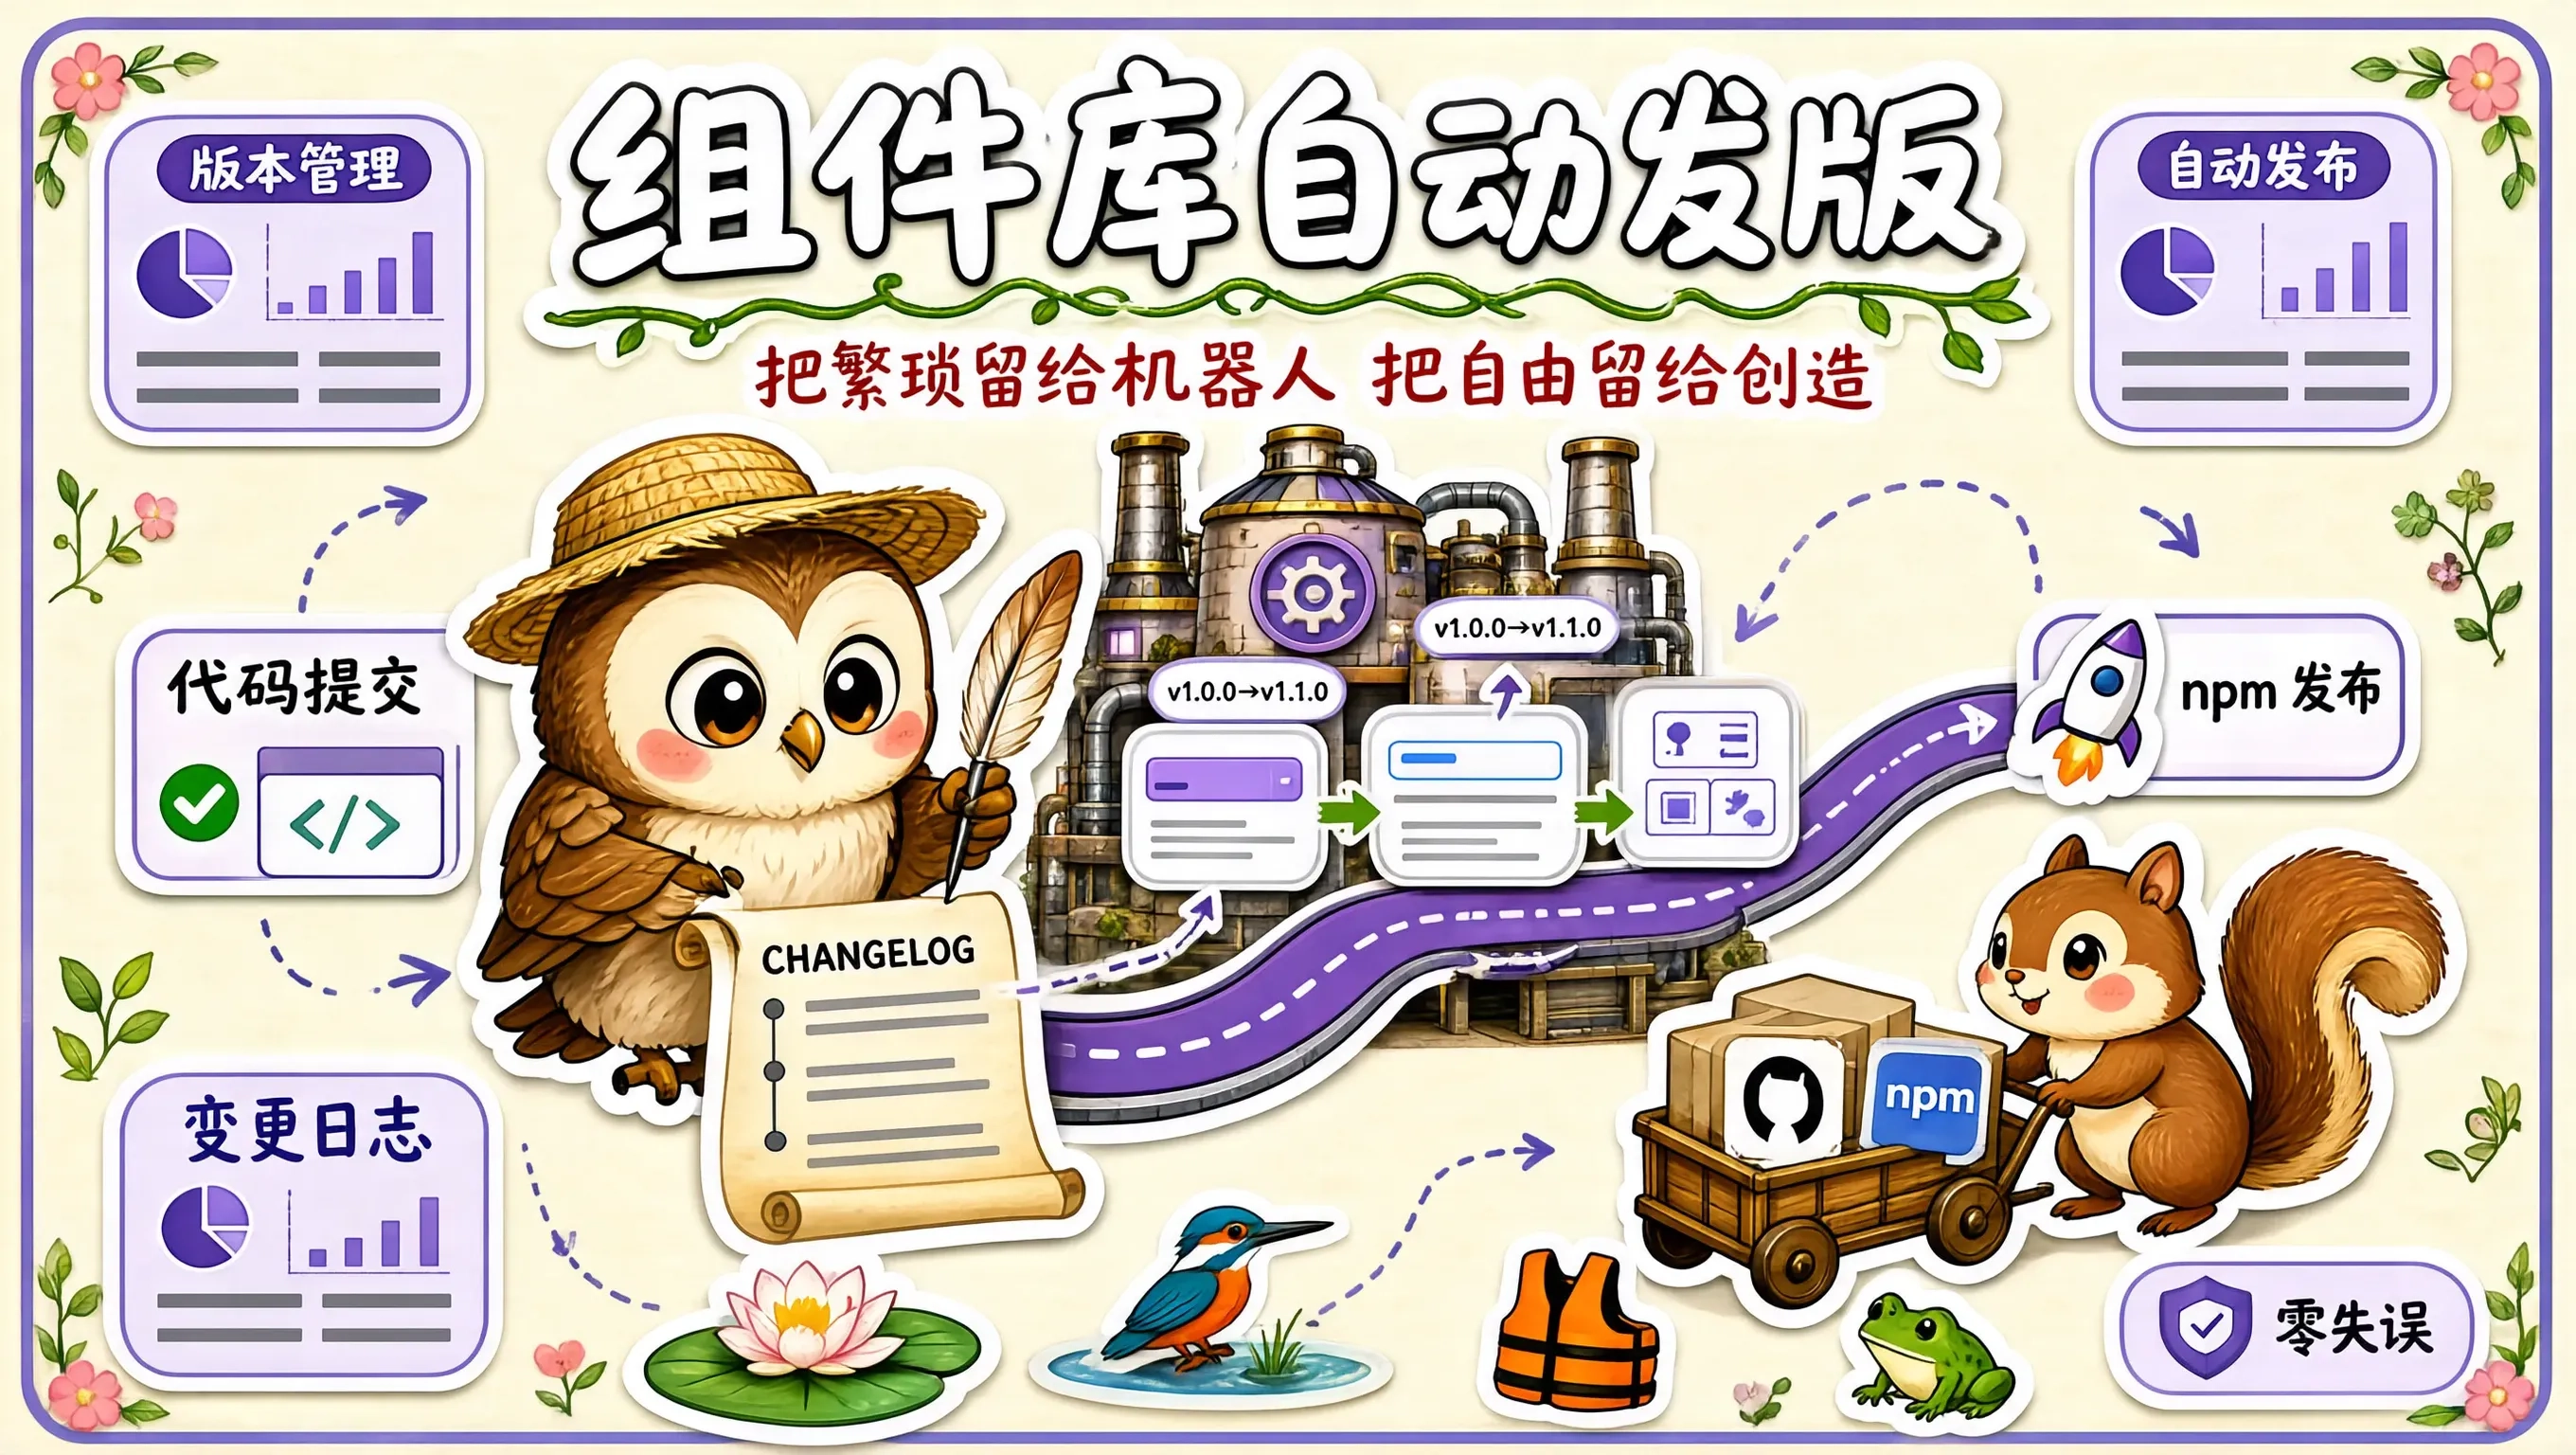
在管理开源组件库(如)的多包 Monorepo 项目中,每次发版如果依赖开发者手动去修改各个子包的版本号、手动编写、并手动执行,不仅流程极其繁琐,而且极容易发生**“漏发子依赖包、版本号不一致、或者 CHANGELOG 遗漏关键提交”**的人为失误。现代开源前端项目的工业级发版基建是采用。通过 Changesets,开发者在提交代码时只需运行一行交互式命令声明变更类型,GitHub 机器人会在合并
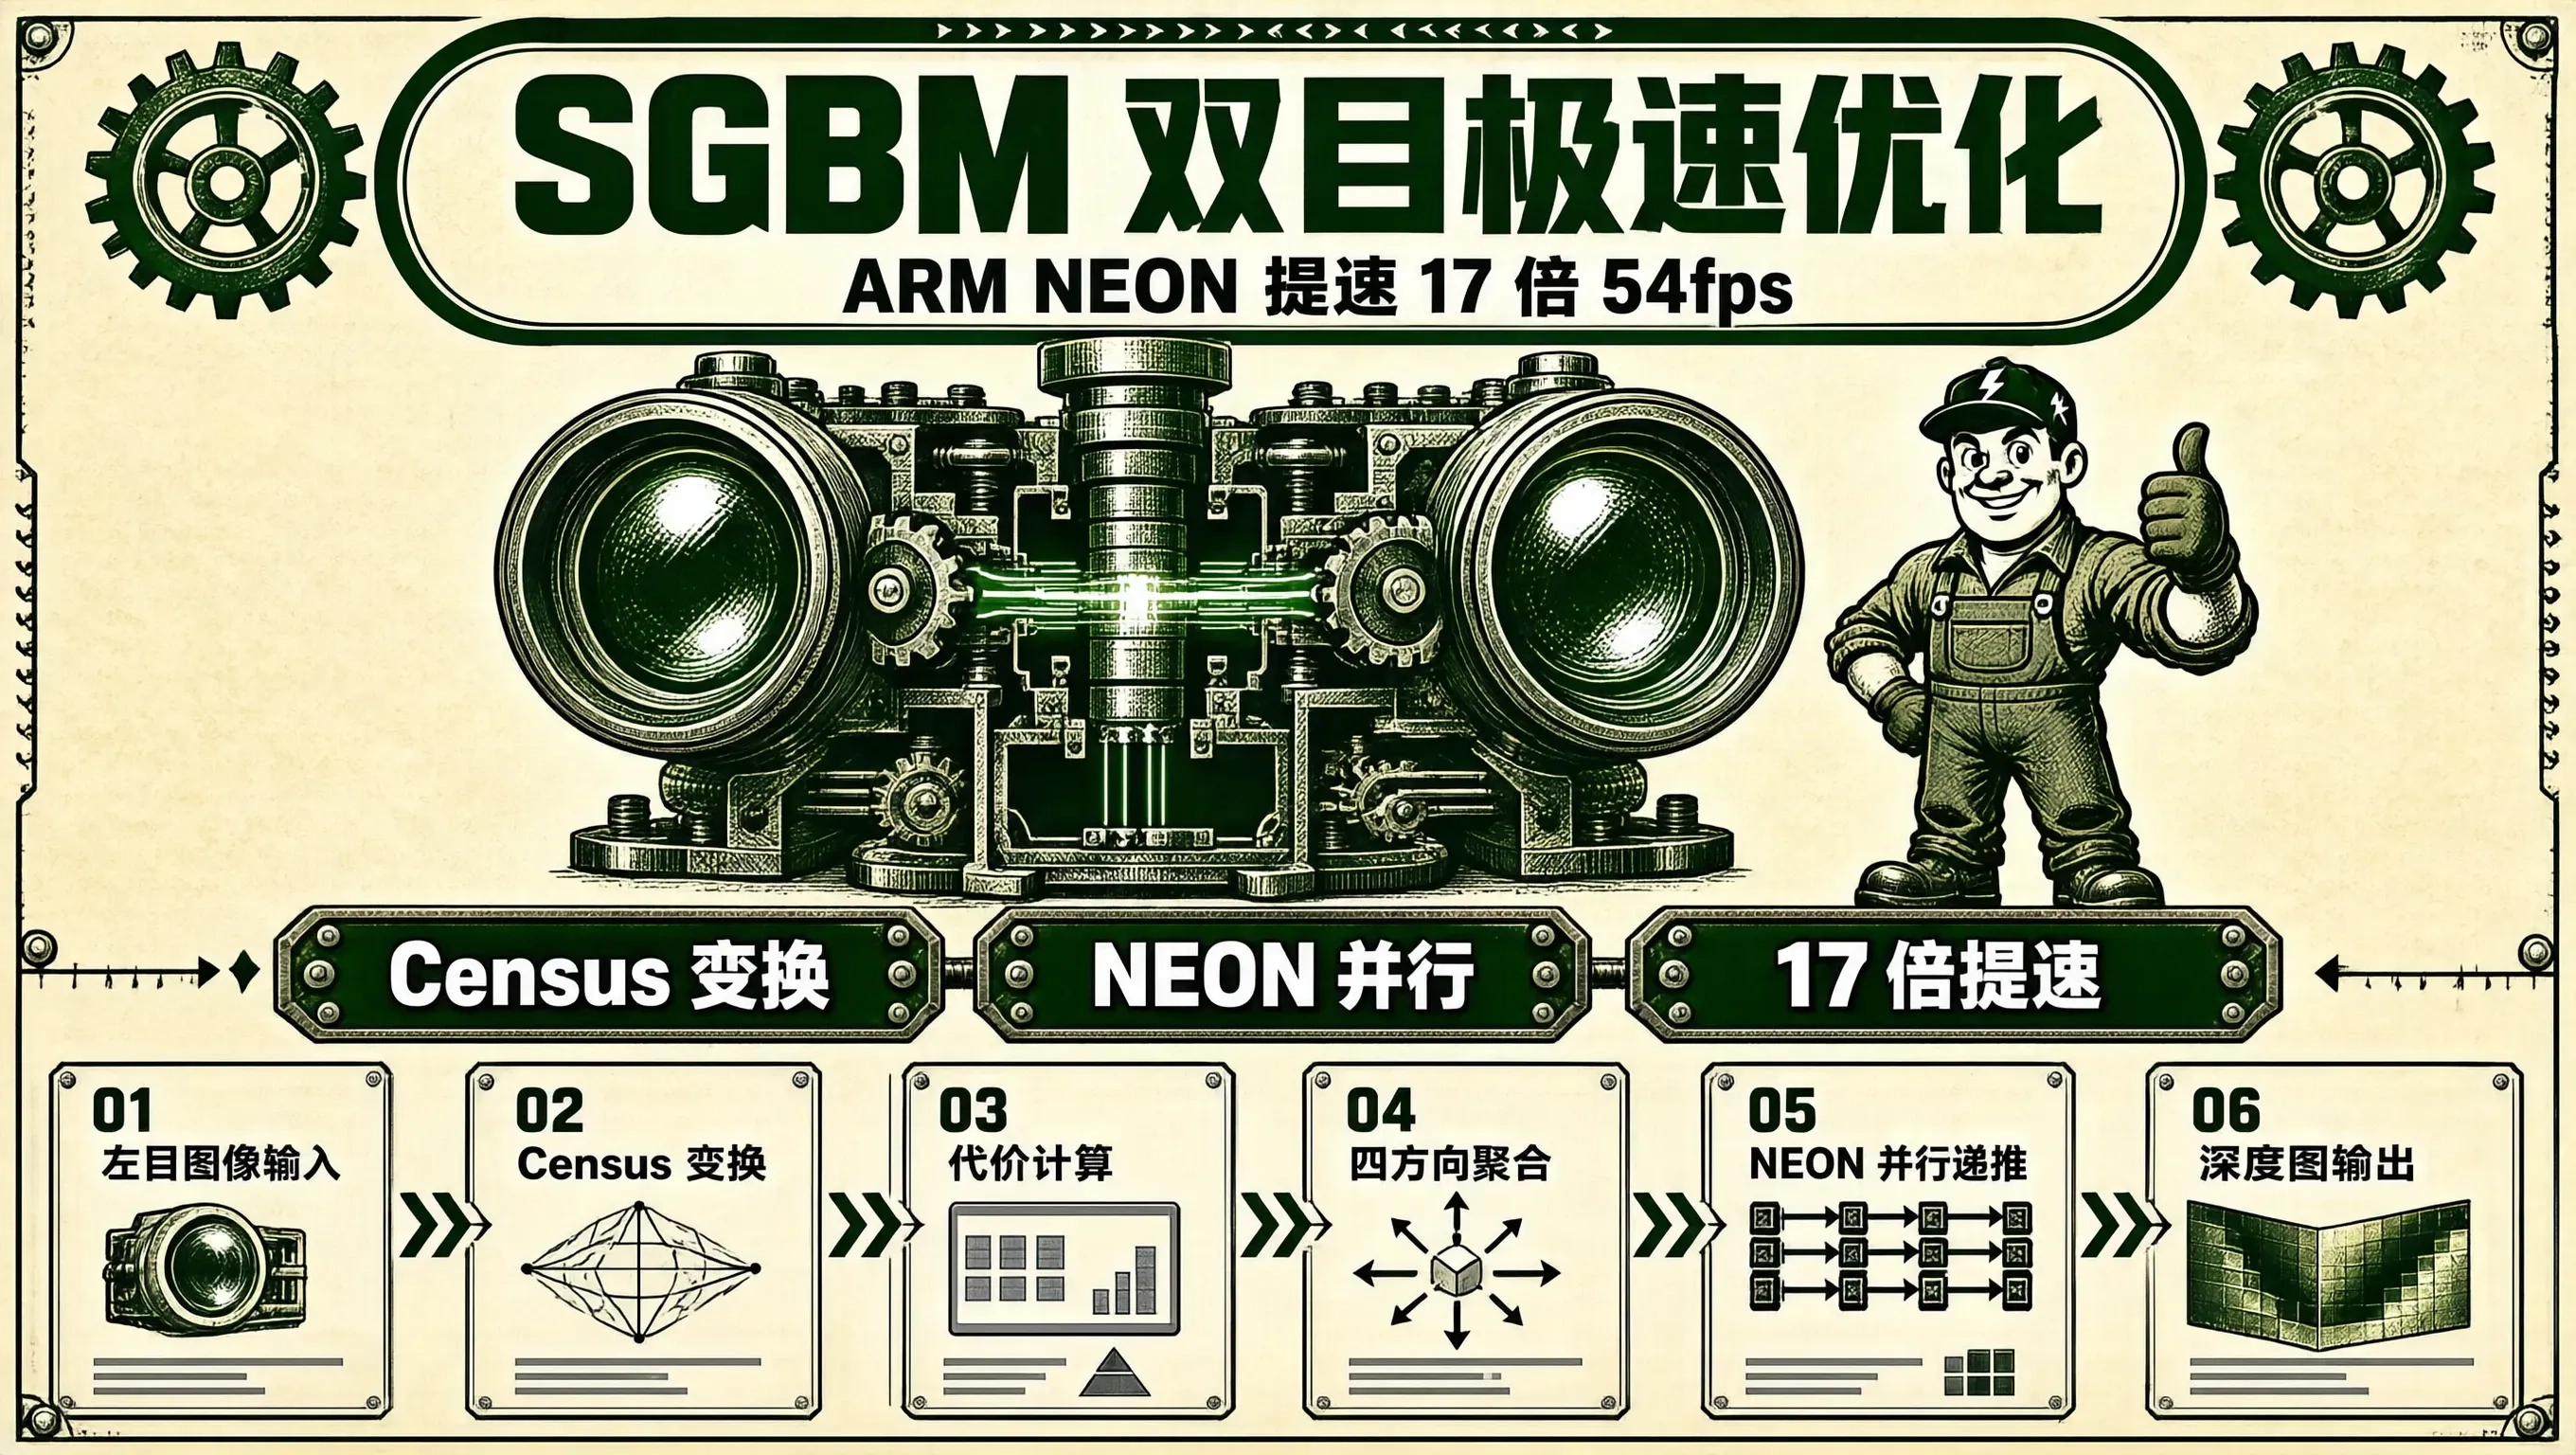
在机器人导航、工业 3D 抓取、无人机双目避障以及车载 ADAS 深度感知系统中,凭借其属于被动感知(不受强光照直射干扰)、成本低廉且能够直接输出密集深度图(Dense Depth Map)的优势,得到了广泛应用。双目视觉的核心核心算法是。SGBM 算法通过以下三个核心步骤从左目图像与右目图像计算出每个像素的通过以及,我们能够将 SGBM 双目视差匹配在 Cortex-A55 上的单帧耗时,实现每
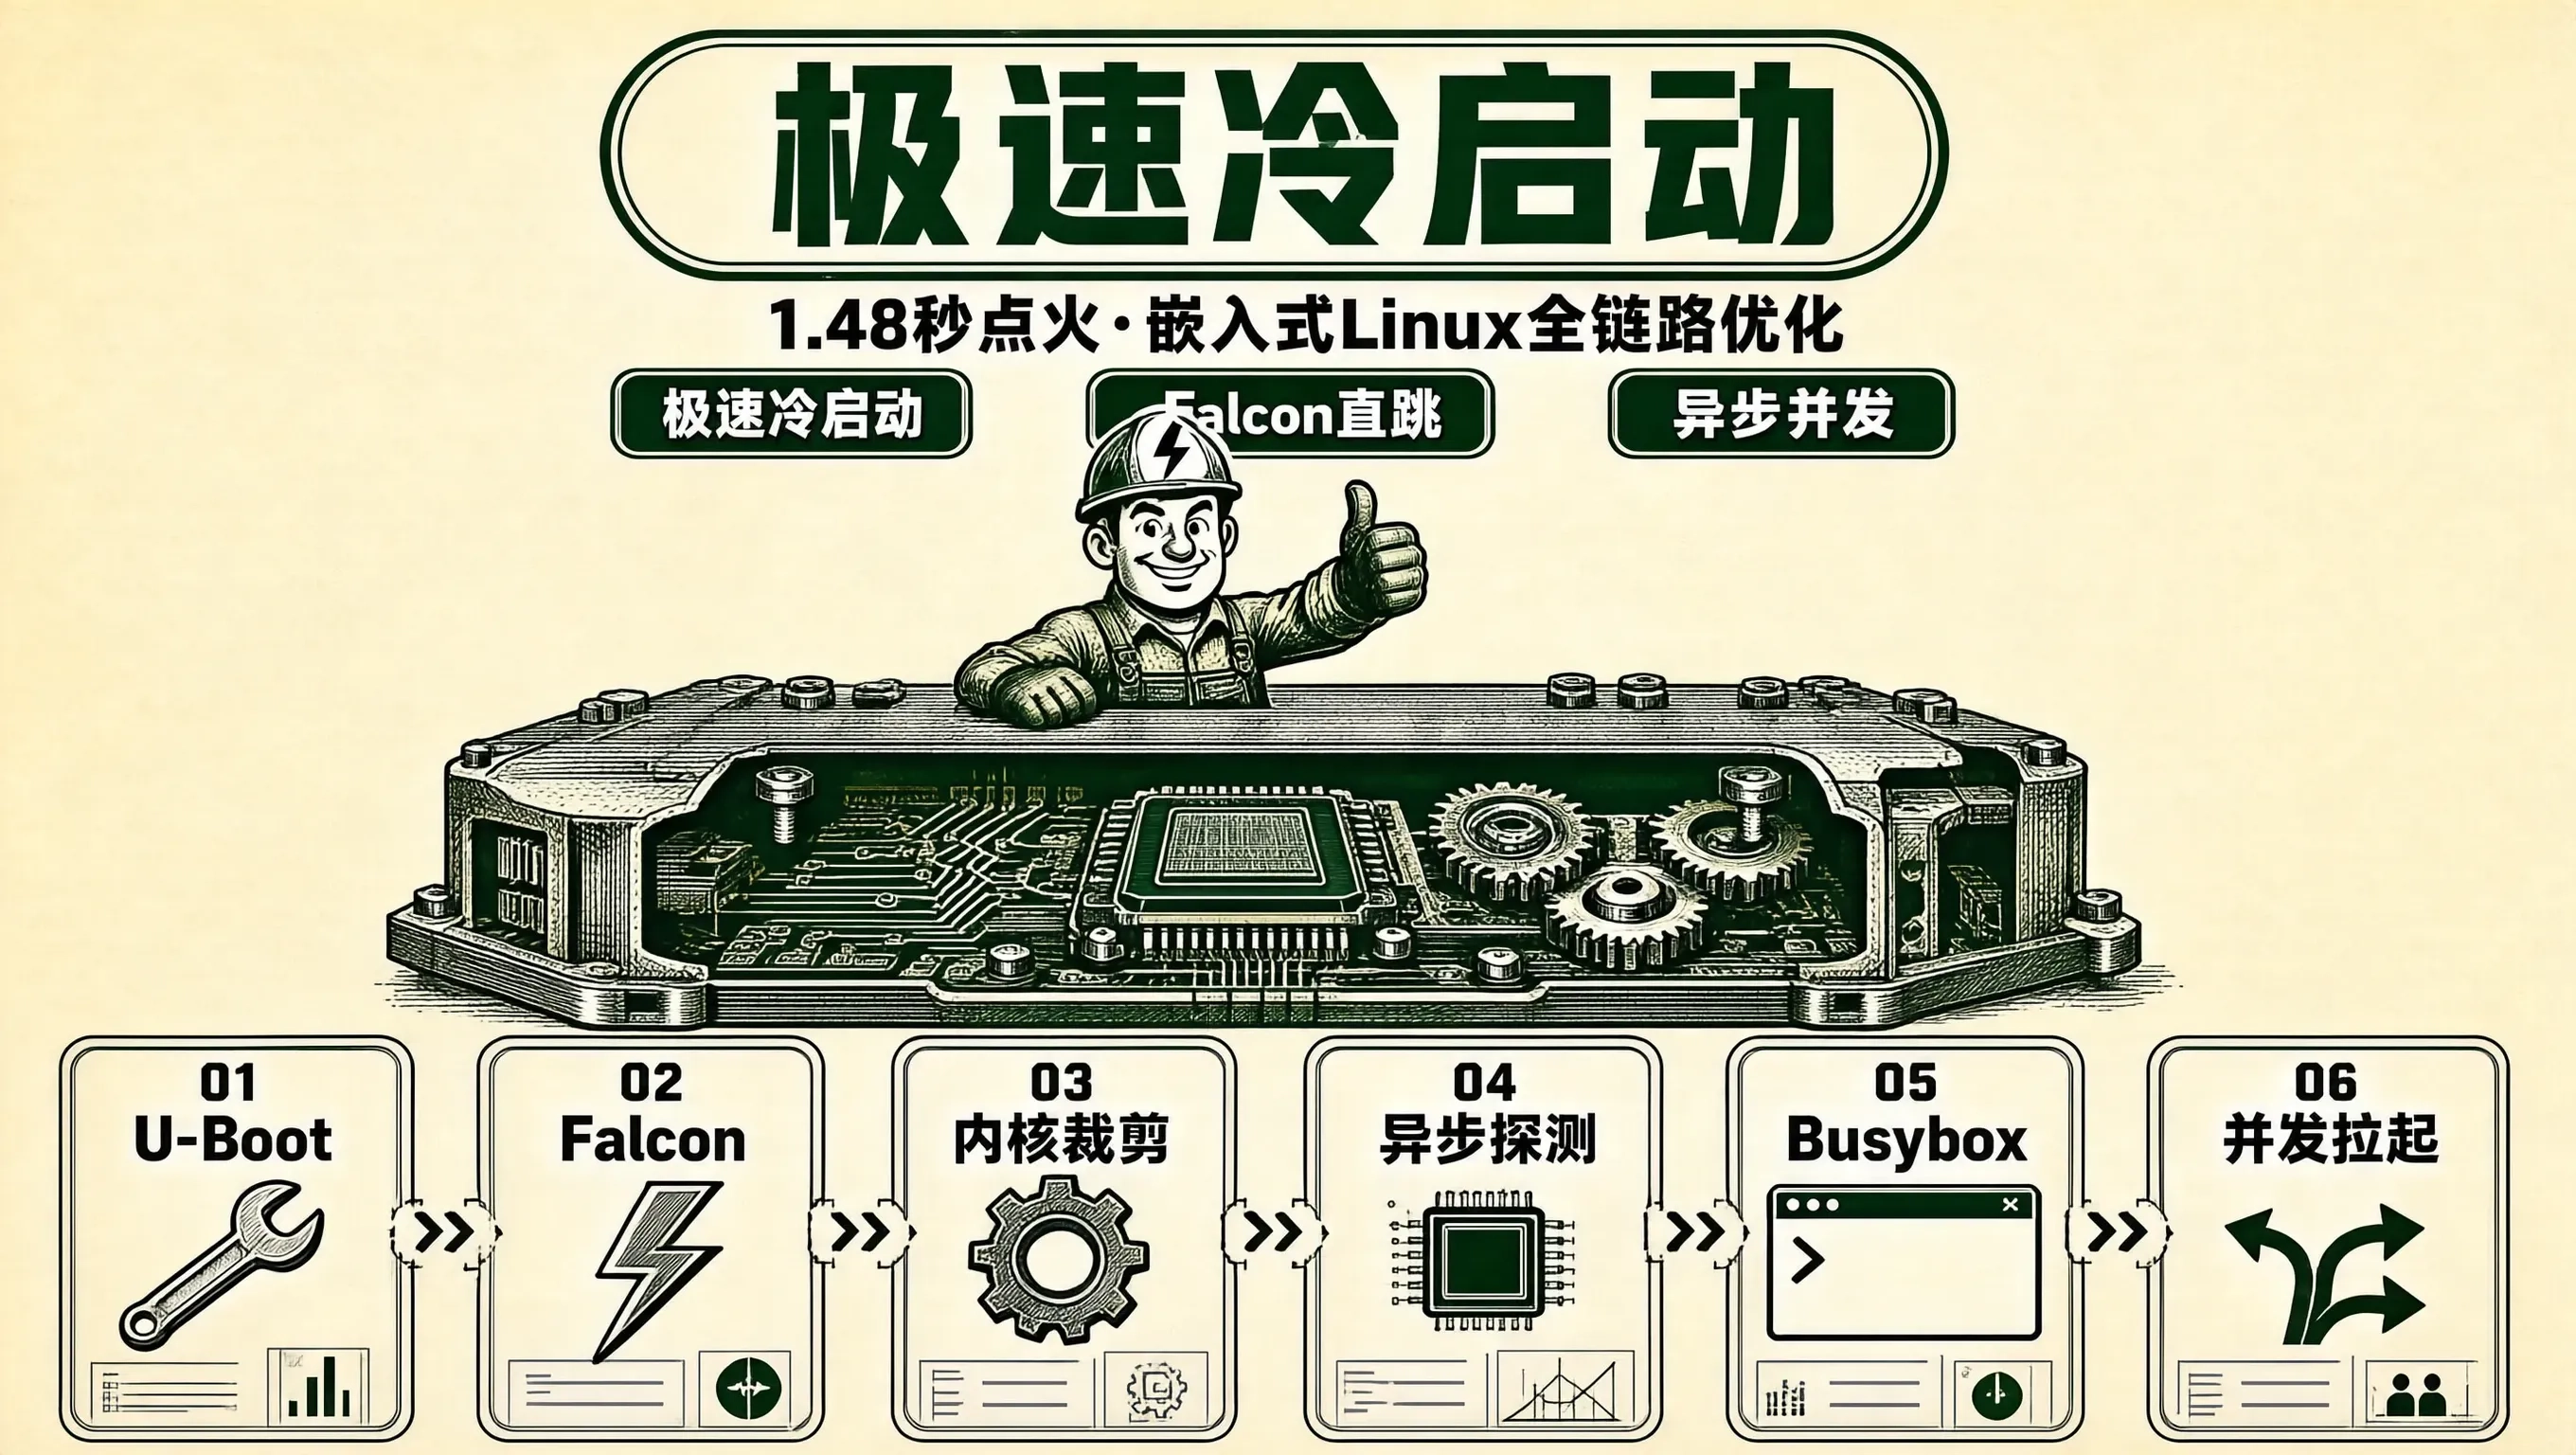
在车载数字仪表盘(如汽车通电后必须在 2 秒内显示倒车后视影像)、工业机器人急停控制器、智能门锁以及各类对有着严苛法规限制的嵌入式 Linux 设备中,开机速度直接决定了产品的用户体验与安全合规认证。这种“老爷车”式的启动速度在工业应急与车载领域是绝对无法容忍的。构建一套涵盖以及的全链路极限开机加速战法。能够在四核 ARM Cortex-A55 硬件平台上,实现。
在低速无人物流配送车、清扫机器人、港口无人集卡以及各类自动驾驶乘用车的环境感知系统中,是实现车辆、行人与障碍物厘米级 3D 空间定位与尺寸估计的核心支柱。凭借其创新的**“柱状体离散化(Pillarization)+ 伪 2D 鸟瞰图投影(Pseudo-2D Bird's-Eye View / BEV)”** 架构,将复杂昂贵的三维点云计算巧妙转化为,成为了工业界量产落地最广泛的 3D 检测算法。
YOLOv10是继YOLOv4和YOLOv5之后,进一步优化的目标检测算法,它基于YOLO(You Only Look Once)系列算法的核心理念,致力于在保持高精度的同时,提升检测速度和效率。YOLOv10通过对网络结构、数据预处理、损失函数以及训练策略等方面进行改进,成功提高了在复杂场景下的表现,尤其是在小物体检测、密集目标检测和实时检测方面。
本文通俗解析Agent核心概念:它不是聊天机器人,而是能自主完成任务的智能体。核心由大脑(大模型)、手(工具)、规划员、记事本(记忆)、说明书(技能)和统一接口(MCP)组成。关键在于“思维-行动-观察”循环(ReAct),大模型只负责决策,真正执行靠工具;MCP则提供标准化接口,降低外部能力接入成本。理解这五要素与三层结构(零件、接口、循环),就能看懂Agent如何协同“干活”。
该数据集包含超过 70 万个任务,涵盖数学、编程和通用科学领域,数据规模达到 0.7M 级别,主要用于训练 GooseReason-4B-Instruct 模型,该模型在 15 个涵盖数学、编程、STEM 推理、指令遵循和逻辑谜题的基准测试中取得了 4B 级别模型的新最先进结果。教程涵盖容器、流、编解码器、数据包、帧与时间戳等基础概念,并通过可运行实验逐步实践视频同步、音频同步与媒体寻址,适合学习
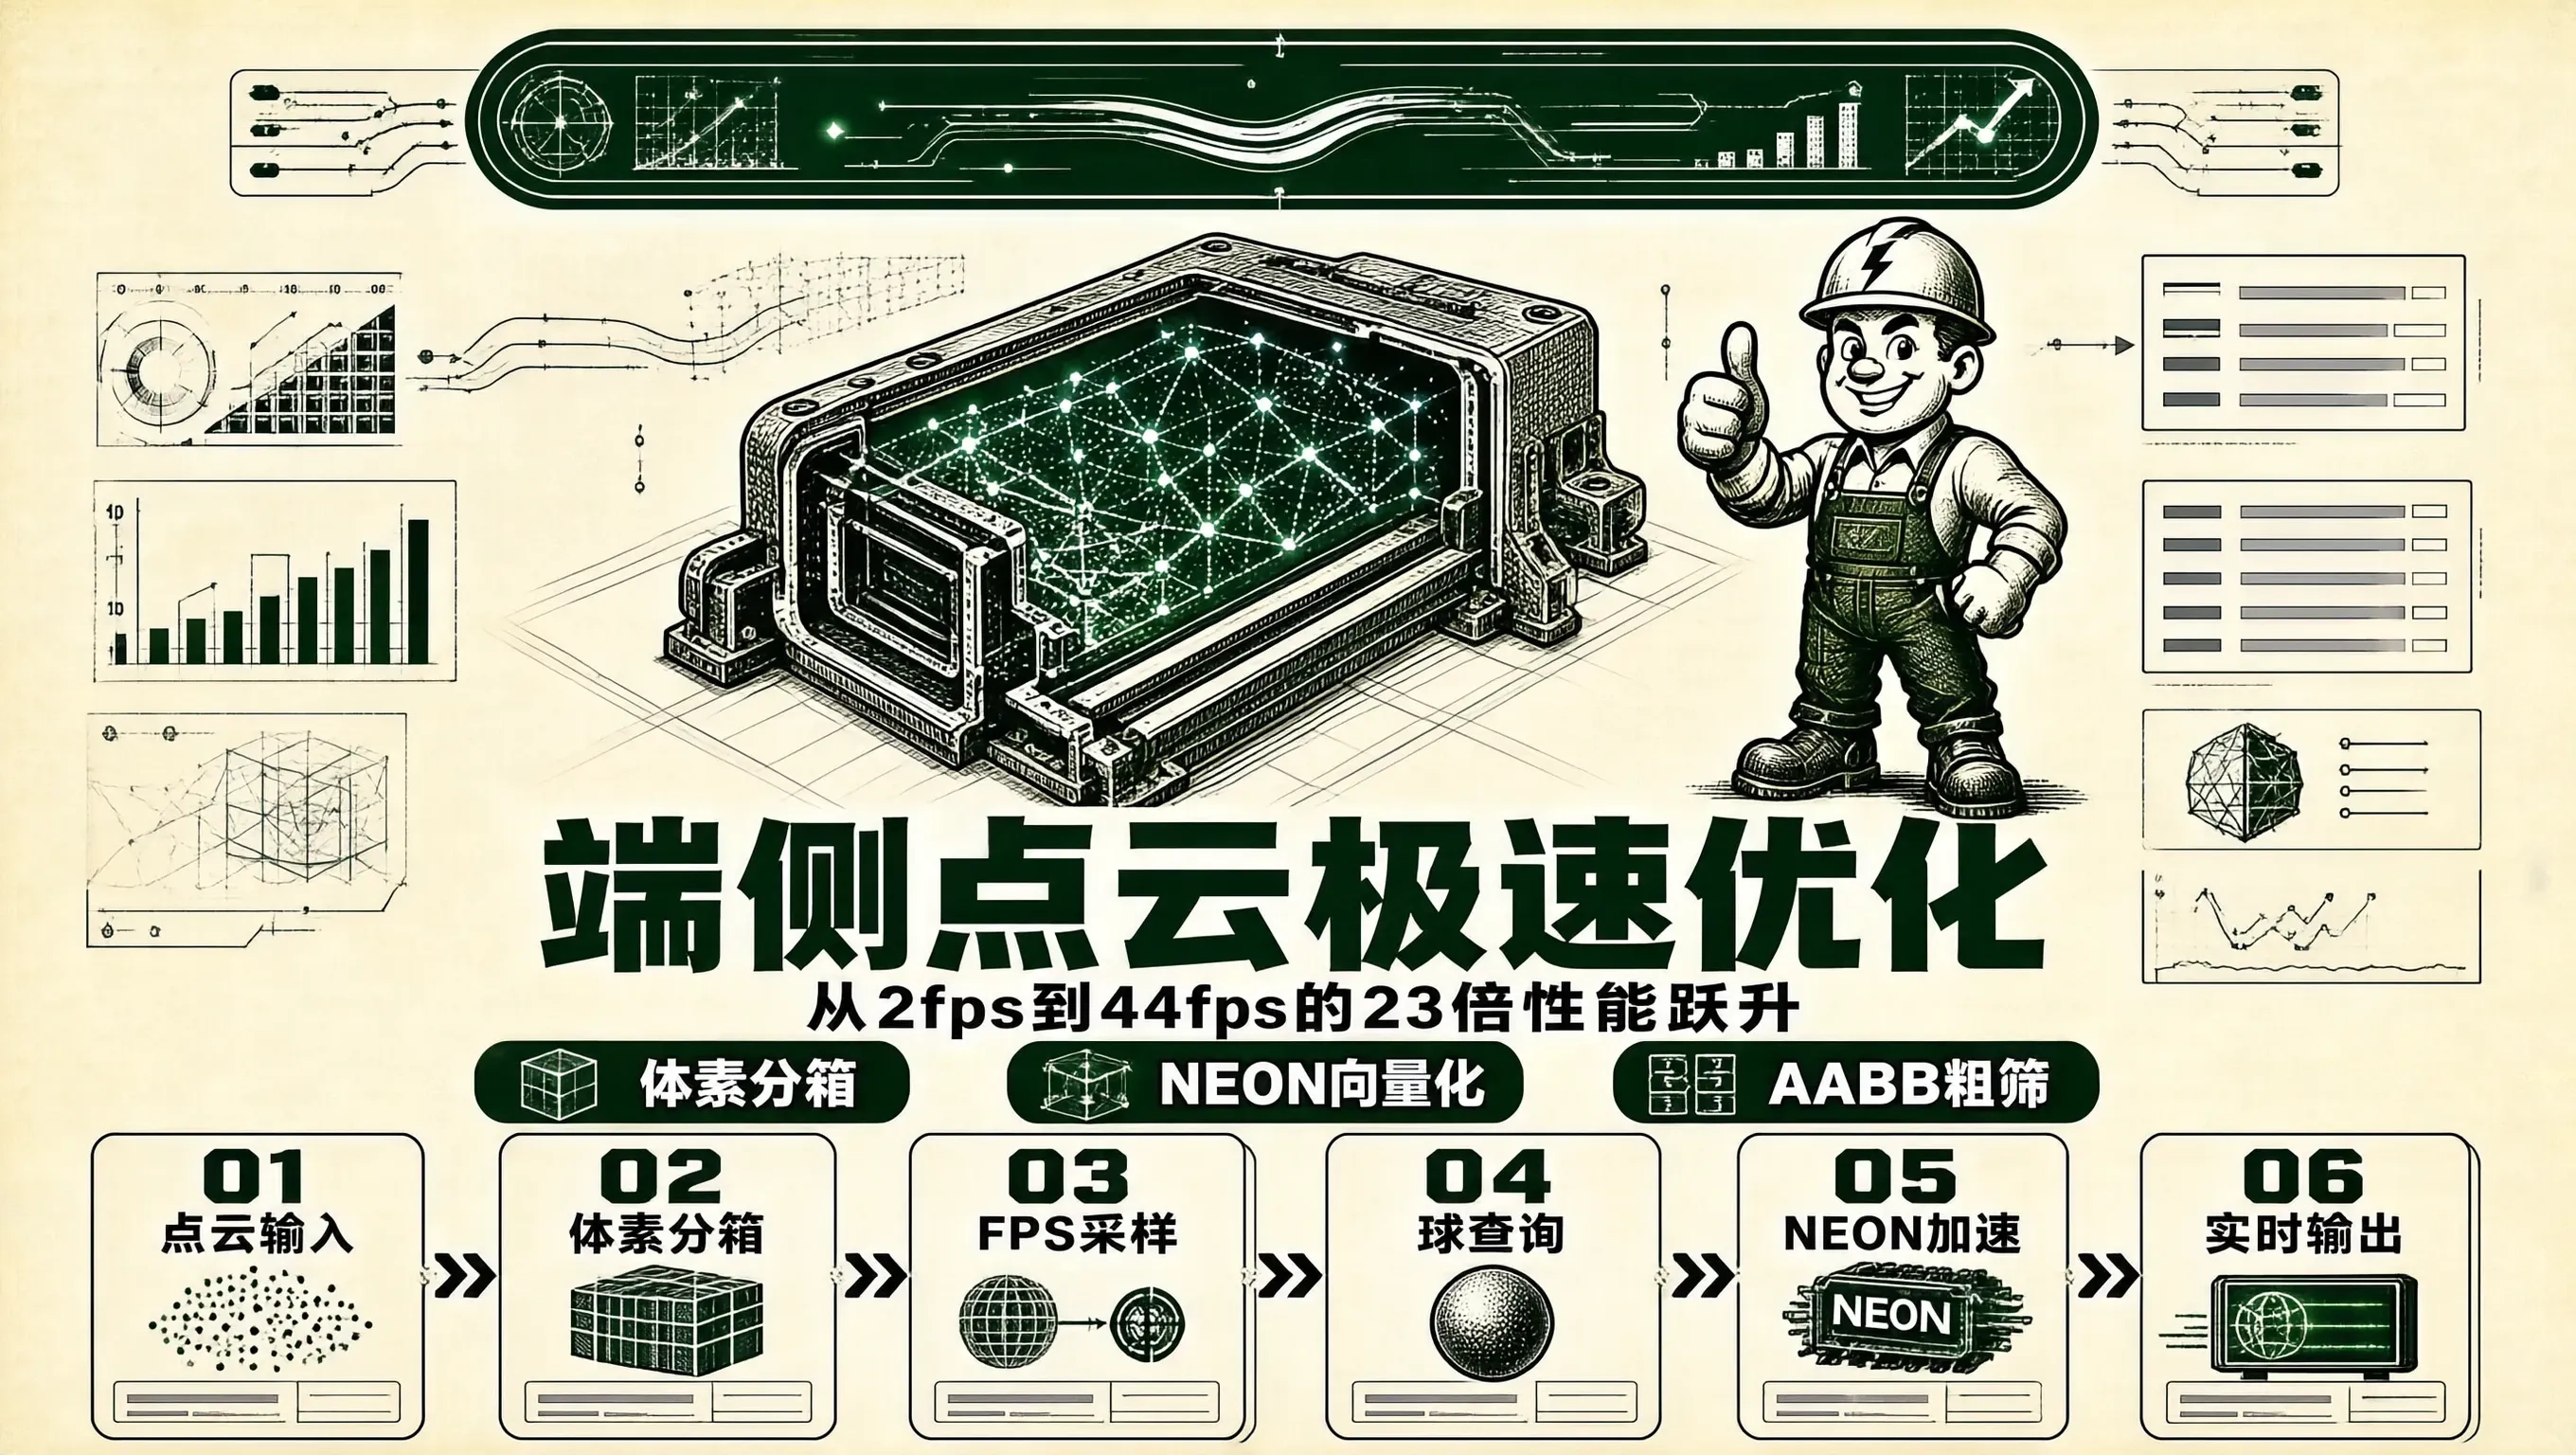
在自动驾驶低速物流车、工业 AGV 激光雷达避障、以及机械臂 3D 抓取引导等机器人系统中,是理解三维空间几何结构的核心算法底座。与二维图像像素点规则整齐的网格排布(2D Grid Array)截然不同,激光雷达每秒产生的数十万个空间点具有。然而,开源学术界原版的 PointNet++ 核心算子基于 CUDA GPU 编写,或者基于未经优化的 Python/PyTorch 库。通过以及,我们能够将
今天五条消息说明,AI 行业正在同时争夺能力、成本和工作入口。新模型向更低价格下沉,缓存降低长时间 Agent 的重复计算,机器人开始复用标准化技能,外部评估则要求更充分的证据。对个人和团队来说,选模型不应只看榜单,还要记录任务完成质量、总费用、人工复核时间与数据边界。只有这些环节一起成熟,模型升级才会变成稳定产出。明天见。
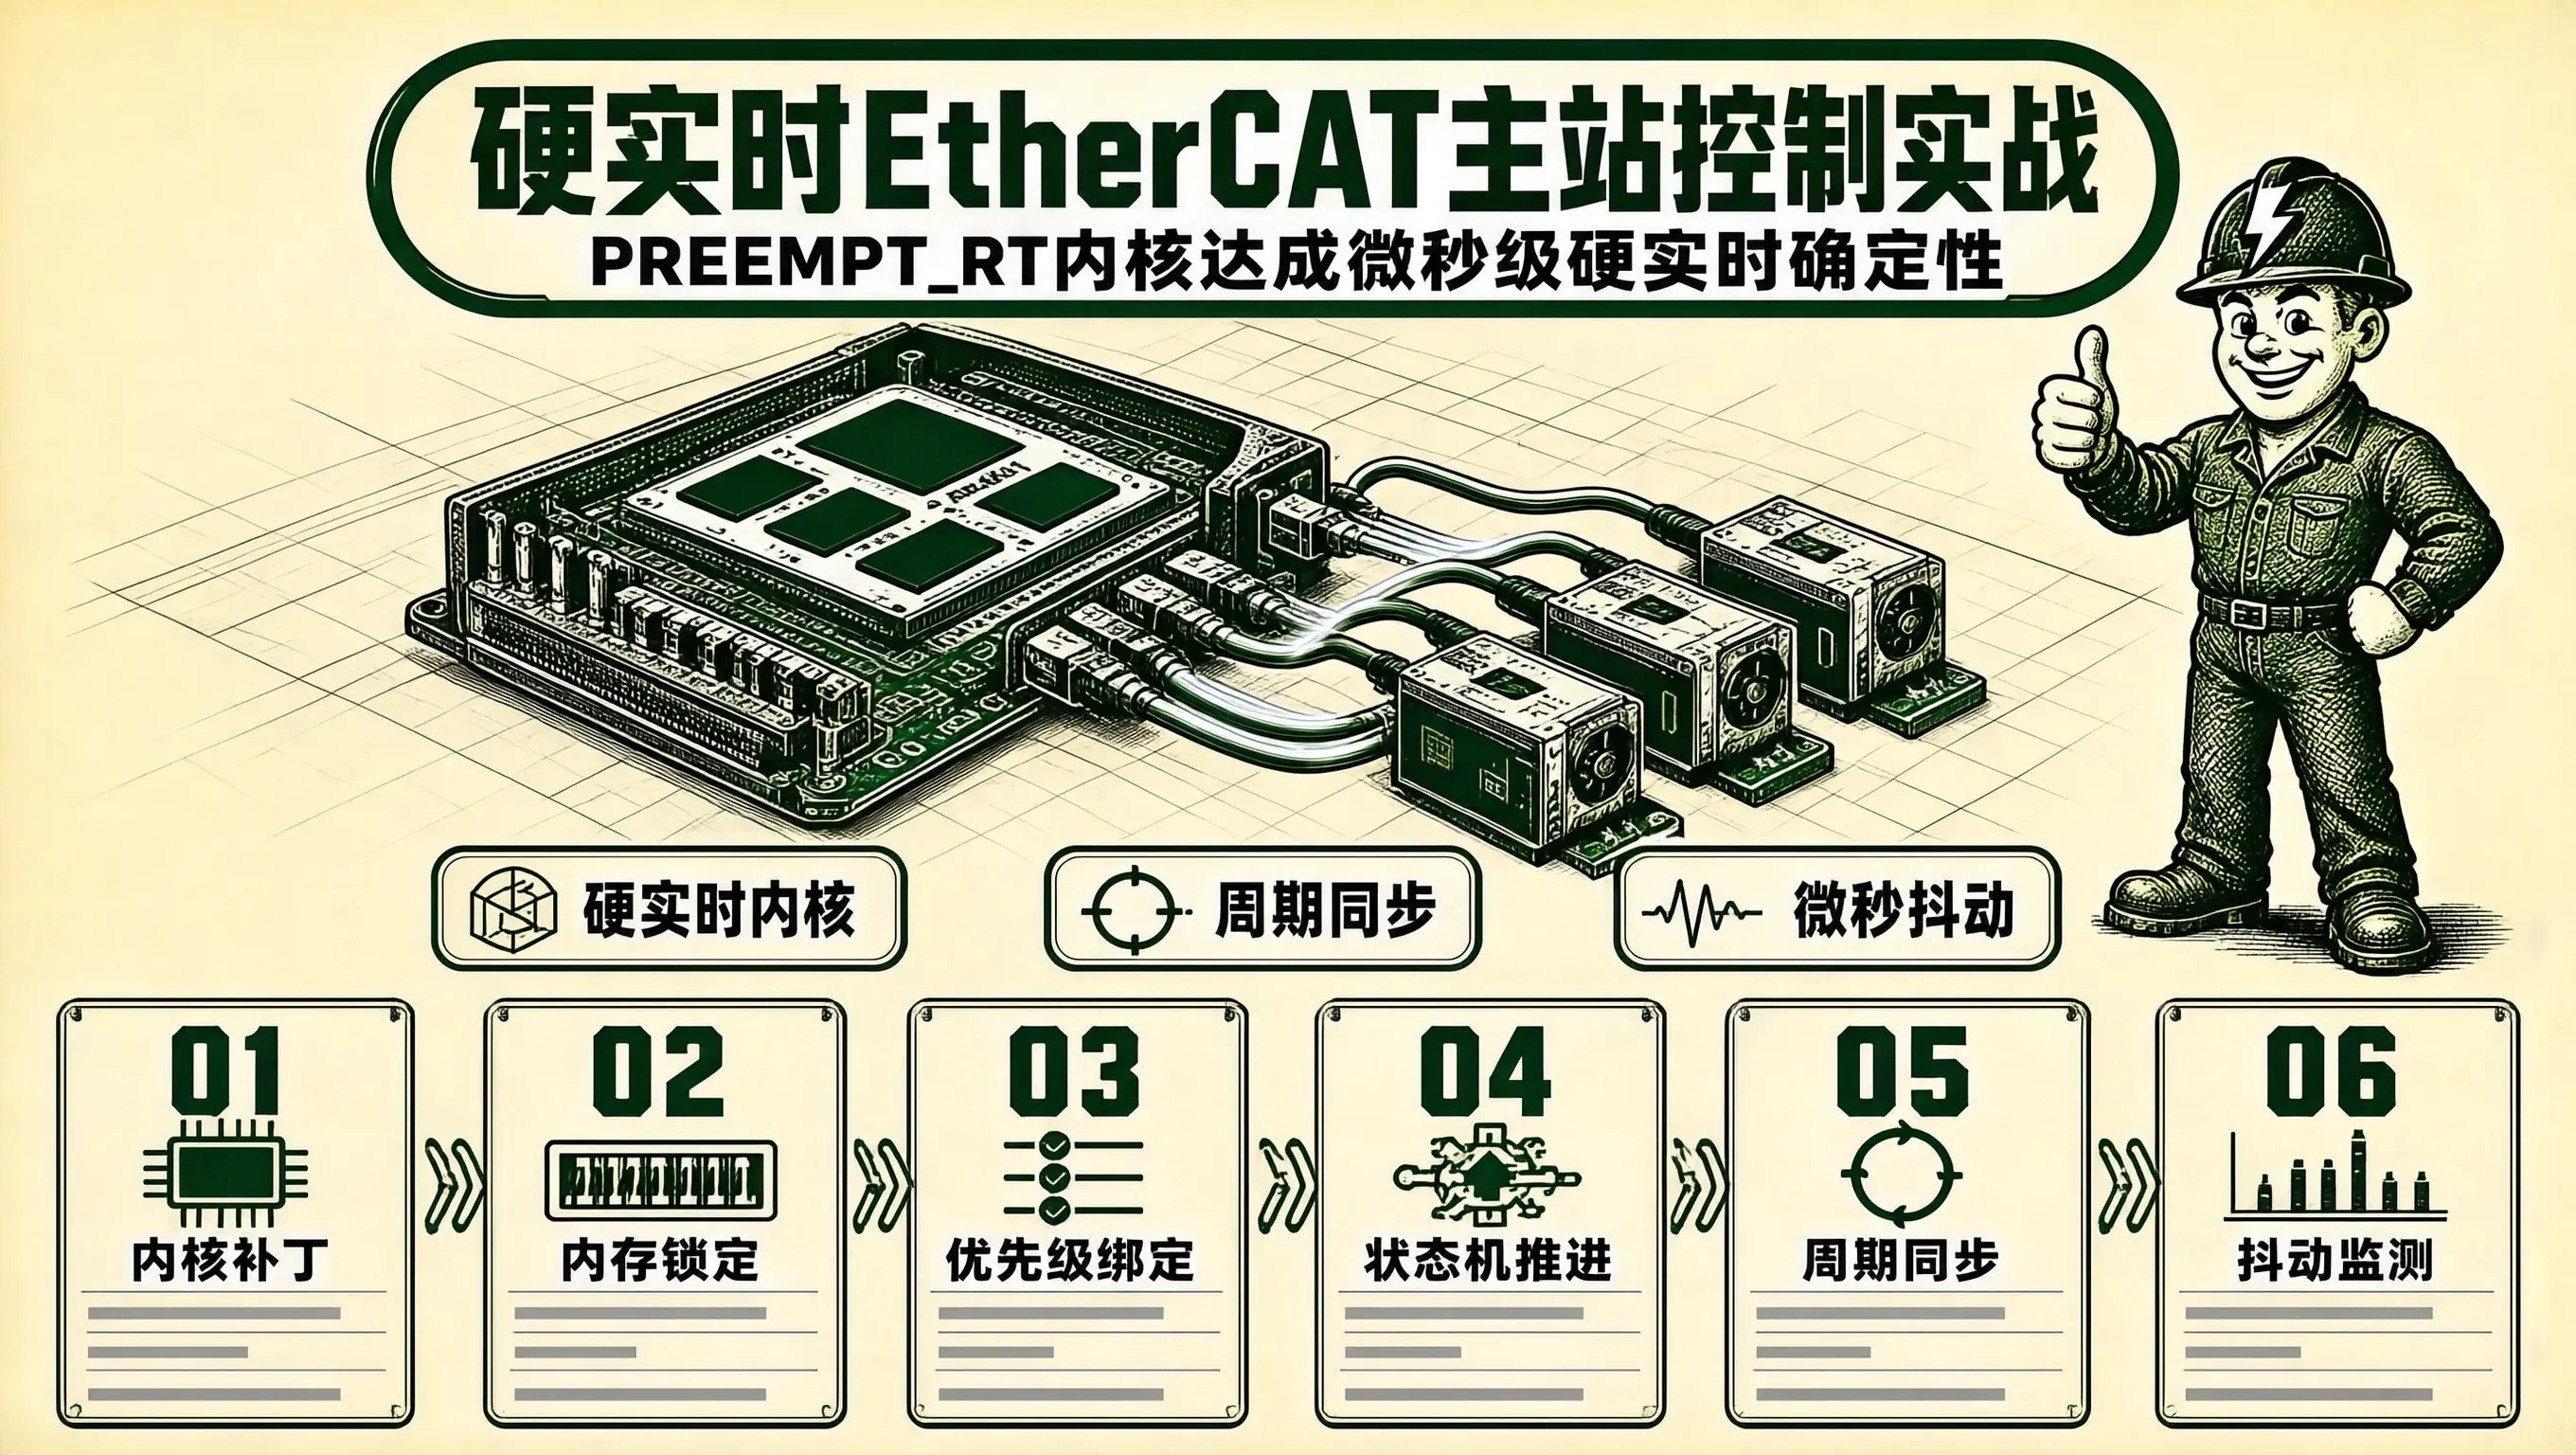
在多轴工业机器人、高精度数控机床(CNC)以及半导体封装设备中,是目前全球工业现场实时性最高、抖动最低的工业以太网现场总线之一。在 EtherCAT 网络中,主站(Master)通常通过标准的以太网物理网口连接多个从站伺服驱动器(Slaves / 如汇川、松下、倍福伺服)。主站必须以,周期性地向网线发送过程数据对象(PDO, Process Data Object),同步刷新所有电机的目标位置与速
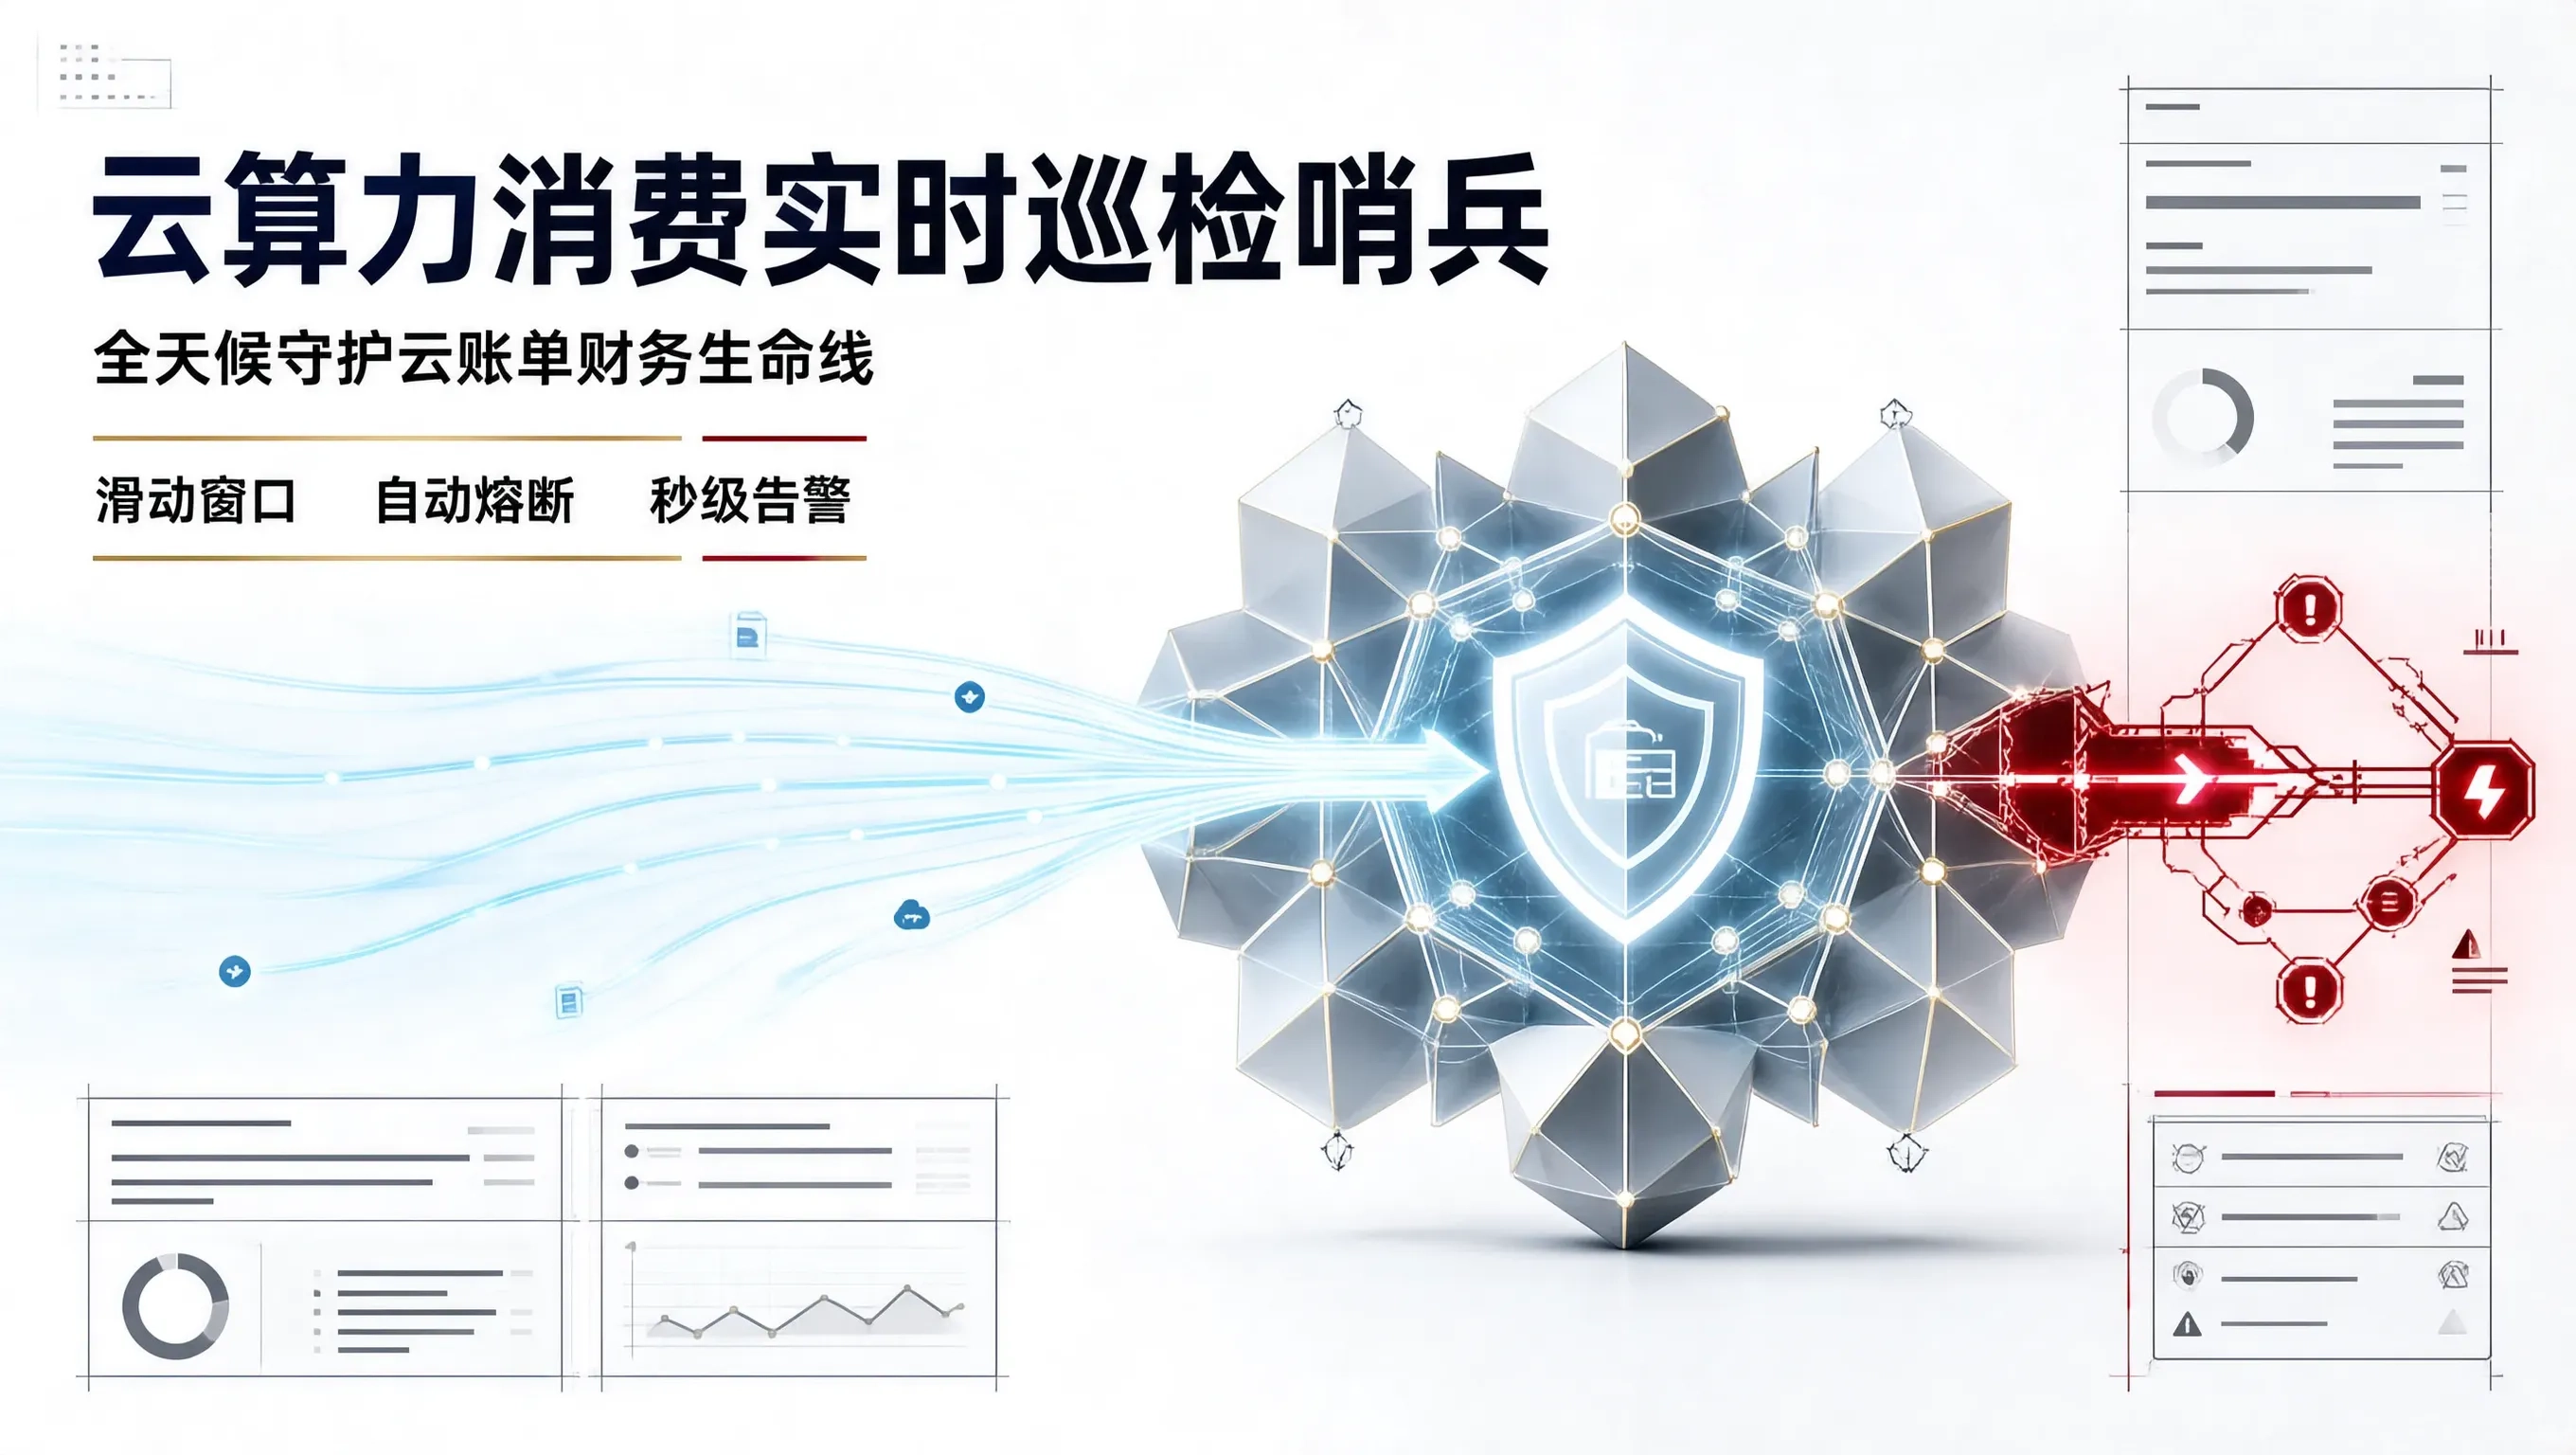
在云计算与大模型 API 的日常使用中,“”是每一个技术团队最深沉的梦魇。如果团队仅仅依靠“月末看一眼云厂商月结账单”或者“依赖云厂商默认延迟长达 24 小时的账单预警”,灾难发生时公司现金流早已被洗劫一空。构建一套,基于滑动窗口(Sliding Window)每 5 分钟探测消费速率,
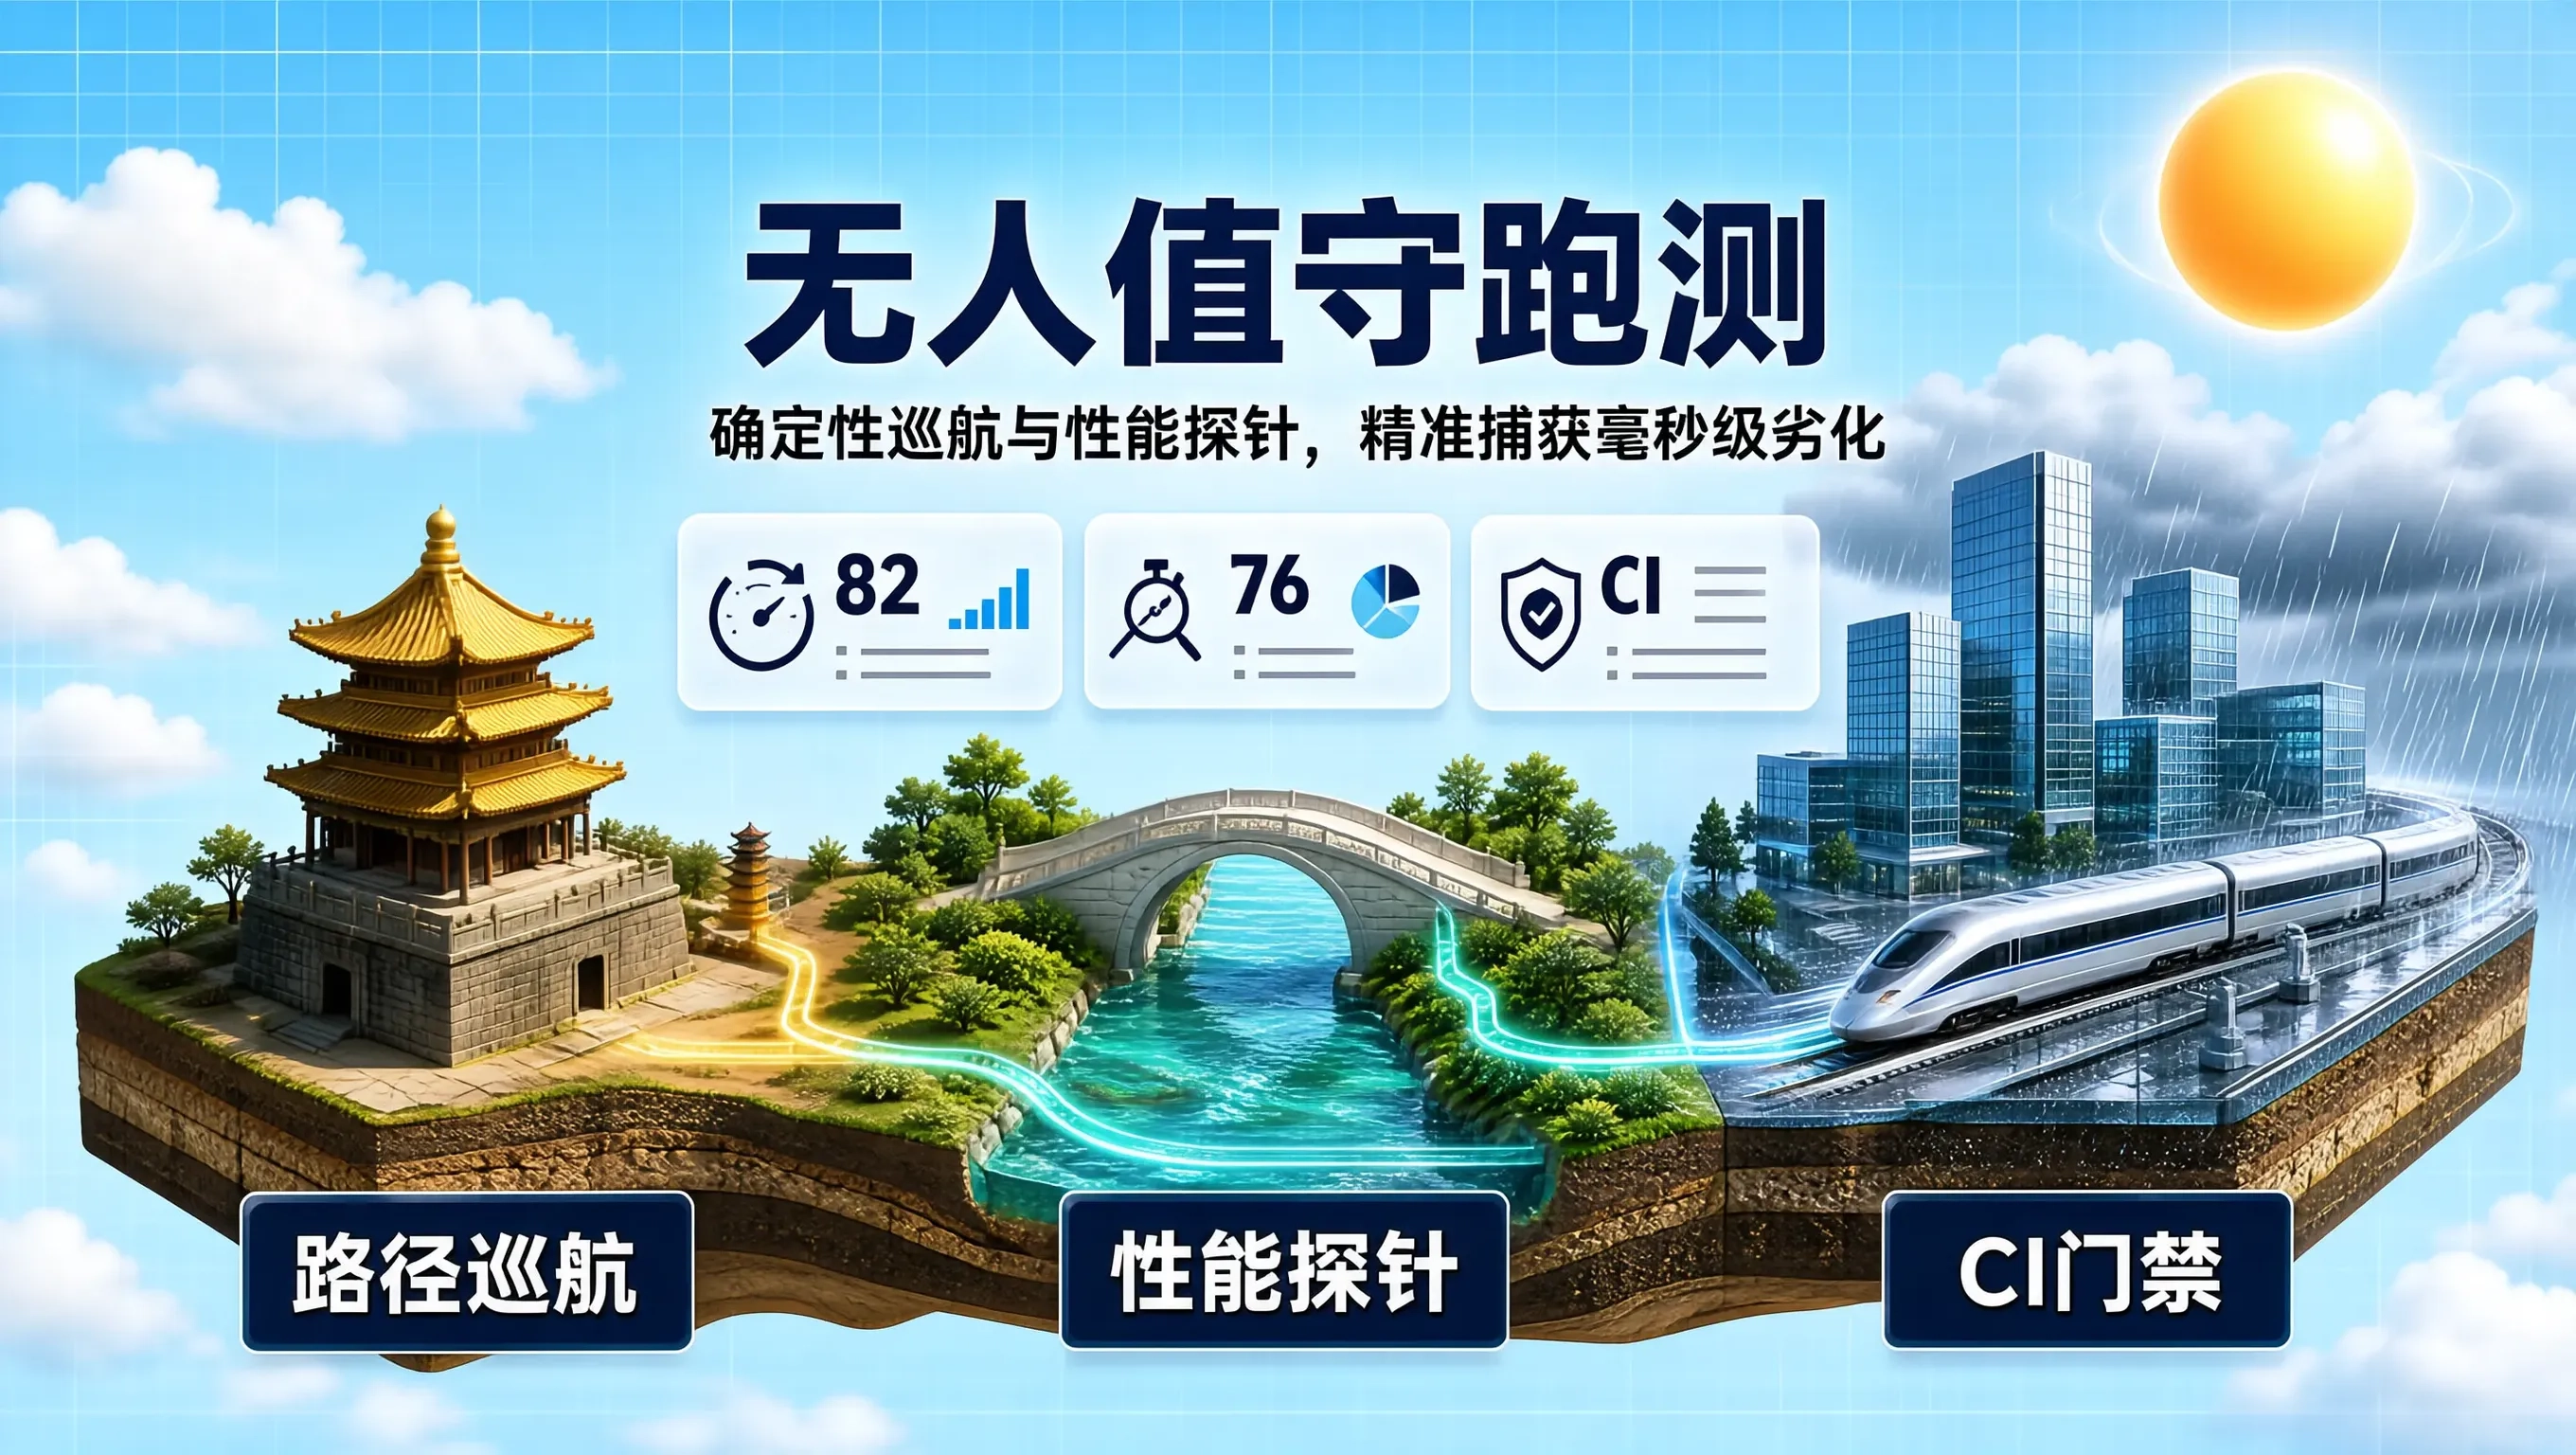
在持续集成(CI/CD)体系中,人工测试无法满足每日构建(Daily Build)的高频性能回归需求。人工跑测不仅耗费大量人力,而且测试路径随机、技能释放时机不一致,导致捕获到的 FPS、内存占用与发热数据存在严重噪声,难以横向比对不同代码提交(Git Commits)带来的细微性能劣化。构建基于引擎内嵌的自动化跑测机器人(Autopilot Monkey),结合确定性路径巡航(Determini
本文系统解析AI智能体(Agent)的三层技术架构:模型基础层(如LLM、Token、上下文窗口)、能力增强层(如RAG、Function Calling、Memory)与工程协作层(如MCP、Multi-Agent、Orchestrator),通过通俗类比与图解揭示Agent如何实现自主规划、工具调用与多智能体协作,区别于传统聊天机器人。强调其底层逻辑稳定,有助于快速掌握新兴术语,是理解AI A
Salesforce 推出 Agentforce Coworker,将AI从“聊天机器人”升级为企业的“数字同事”。在Adecco全球2.7万名员工中,该系统通过统一数据层(Data 360),让AI不仅能理解自然语言、跨系统查询信息,还能协调专业Agent执行任务,如提交请假、更新客户信息等。这标志着企业AI正从“信息检索”迈向“任务执行”,成为连接员工与业务系统的智能操作入口,真正实现“AI协
2026年,中国智能体经济加速成型。复旦大学白皮书通过100个真实案例揭示:AI Agent正深度融入办公、制造、金融、医疗等十大产业,实现从“回答”到“结果”的跃迁。市场预计2030年达千亿规模,商业模式向“按结果付费”演进,组织形态转向“人机协同”。中国在场景、人才、开源与政策上具四大优势,具身智能成下一入口。技术+AI融合者将成职业突围关键,AI岗位需求同比激增543%,高薪岗位集中于应用落
当前大模型 Agent、具身智能技术迭代快,很多高校老师面临新课备课缺少完整实战案例、源码实验环境不足的难题。本文梳理大模型智能体、视觉大模型 + 具身智能完整技术栈,同时分享面向高校教师的线上实战研修项目,覆盖 Transformer、RAG、MCP、多智能体、SAM、ROS‑SLAM、VLA 等内容,配套完整源码与实验案例,可服务课程建设与科研原型开发。
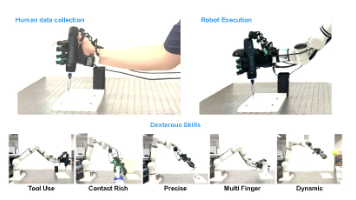
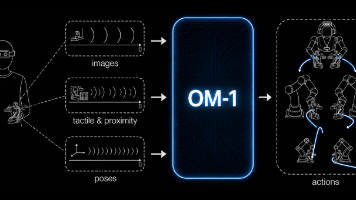
26年9月来自创业公司Reward AI的博客文章“OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans”:https://www.rewardai.com/blog/OM-1/。这篇博客介绍了 Reward AI 的机器人系统 Omnibody 和核心模型 OM-1。核心思路是:直接从人类自然操作中学习,再让同一个策略模