登录社区云,与社区用户共同成长
邀请您加入社区
最震撼的是,凭借全新的 N-gram Embedding 卸载机制,在显存爆满的情况下“借用硬盘/内存”居然也能平稳运行!通过 极致稀疏 MoE与 N-gram Embedding 内存/硬盘卸载** 的组合拳,普通个人开发者用单卡消费级显卡加上便宜的内存和 SSD,居然真的把 125B 级别的模型本地跑起来了!它不仅代表着 Qwen4 的全新技术路线,更重要的是它向开发者证明了:大模型不再是顶级
绝大多数论文说"200k"指的是,也就是的有效视频。下面按这个理解讨论。
16GB - 24GB 显存**(RTX 4070 Ti / 4080 / 4090 / 单卡 A10):推荐运行 **GGUF Q8** 或 AWQ/GPTQ格式,解锁更完整的高精推理表现。8GB - 12GB 显存**(RTX 3060 / 4060 / 3070):推荐使用 **GGUF Q4_K_M** 量化版本,配合 CPU Offloading 跑出流畅帧率。| 上下文窗口| 原生支持
开源AI无限画布Open Canvas发布,助力创作者低成本本地化部署。针对LibTV等商业平台的高额订阅成本问题,该项目提供完全开源、支持本地部署的解决方案,采用BYOK模式让用户自主控制API调用成本。核心功能包括多模态节点工作流(文本/图片/视频/音频)、数据本地存储、自动上下游衔接等,特别推荐搭配Cyberbara API实现高性价比创作。通过案例演示了从生图到视频合成的完整工作流,为个人
这是商业决策的最后一道门槛。预算充足,追求极致画质与稳定→选 Seedance 2.0。按量计费($0.68/s),一条 15 秒视频约 $10。适合客单价高、对品质要求苛刻的项目(如汽车广告、大制作短剧)。预算敏感,追求高频迭代→选 MiniMax H3。本地推理边际成本趋近于零(仅电费)。适合 MVP 验证、中小商家素材、教育内容、个人创作者。
一键部署LTX-Video:本地AI视频生成全攻略 Lightricks开源的LTX-Video凭借高效生成(秒级响应)和低显存需求(8G起)成为AI视频创作新宠。本文提供完整部署指南: 硬件要求:Win10/11系统,NVIDIA显卡(RTX2060 8G+),16GB内存,30GB SSD空间 三步部署:解压英文路径整合包→运行一键启动.bat→访问本地WebUI(127.0.0.1:7860
维度 RTX 5090 RTX PRO 5000 RTX 6000 Ada RTX PRO 6000CUDA核心 21760 14080 18176 24064显存 32GB GDDR7 48GB GDDR7 ECC 48GB GDDR6 ECC 96GB GDDR7 ECC显存位宽 512-bit 384-bit 384-bit 512-bitECC支持 ❌ ✅ ✅ ✅视频剪辑 ★★★★★ ★★
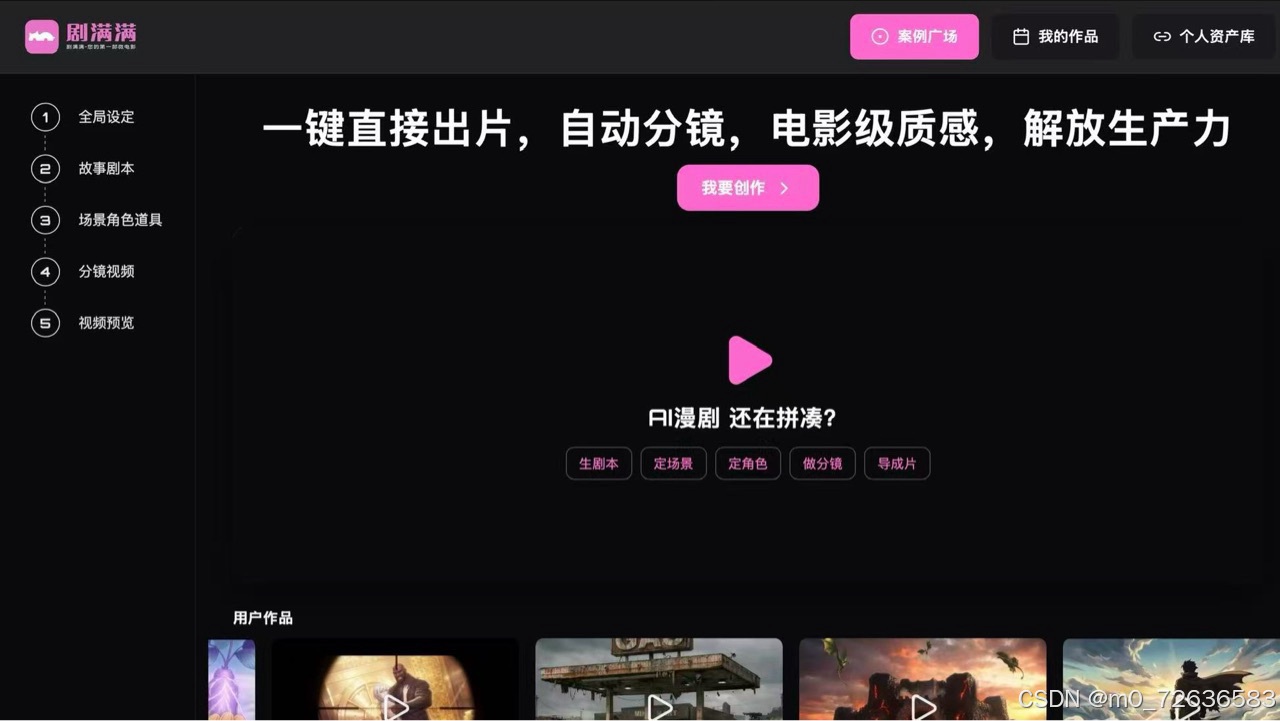
这是一套基于 Java + Vue + AIGC模型 构建的全流程 AI 漫剧生产系统。未来随着视频生成模型不断升级,AI短剧、AI动画、AI影视制作将成为内容生产的重要方向。小说输入 → AI剧本 → AI分镜 → AI画面 → AI视频 → 自动成片。随着 AIGC 技术快速发展,短剧、漫画、动画内容生产正在进入智能化时代。输入一本小说 / 一段剧本,自动生成完整 AI 漫剧短视频。帮助开发者
AI视频工具爆发式增长,但开源协议陷阱、模型接入边界常被模糊。本文深度拆解11个GitHub项目:NarratoAI实为“非商用”协议,Remotion大公司需付费;支持OpenAI兼容≠仅限云端,多款工具可接入Ollama本地部署。按场景匹配:批量短视频选MoneyPrinterTurbo,音乐驱动选CutClaw,完全免费商用选HyperFrames。附7条选择建议+5大误区,帮你避开隐形雷区
本文深入探讨了TransFace在ViT人脸识别中的优化策略及其在AIGC领域的应用实践。通过DPAP数据增强和EHSM难样本挖掘机制,TransFace显著提升了模型在遮挡、跨姿态等复杂场景下的识别准确率,并在FaceChain等AIGC应用中实现了高质量的ID保持性。文章还提供了详细的开发者实践指南,助力技术落地。
Chronos-2的上下文学习能力使其成为一个可行的通用预测模型,可以直接用于生产流程,从而显著简化流程。Chronos-2现已开源。我们邀请研究人员和从业者参与Chronos-2的研究,共同探索时序基础模型的前沿领域。FINISHED更多精彩内容 请关注我的个人公众号 公众号(办公AI智能小助手)或者 我的个人博客 https://blog.qife122.com/对网络安全、黑客技术感兴趣的朋
本文深入探讨了AIGC(人工智能生成内容)如何颠覆传统内容创作模式,重塑新闻、电商等领域的工作流程。文章分析了AIGC从提升生产效率到拓展创意边界的影响,并展望了人机协作的新范式与未来内容生态的演进方向。
这绝非简单的文字堆砌,它内在嵌入了对国自然申报规范的理解,能有效帮你规避常见的“方向偏离”“逻辑混乱”“格式错误”等基础问题,将你从繁琐的框架搭建中解放出来,专注于核心内容的精雕细琢。国自然2025年的资助率降至历史新低的12.29%,数万科研人员面对着更激烈的竞争与更严格的评审标准,对于2026年度的申报者而言,“高效准备,少走弯路”已不是口号,而是生存法则。它不仅告诉你“是什么”,更分析“为什
https://blog.csdn.net/qq_44866828/article/details/152815651?sharetype=blogdetail&shareId=152815651&sharerefer=APP&sharesource=2401_85812043&sharefrom=link
腾讯开源轻量级翻译大模型Hunyuan-MT-7B,该模型在WMT2025机器翻译比赛中以7亿参数斩获30项冠军,支持33种语言互译。其创新在于:1)参数效率高,推理速度快30%;2)上下文理解强,能处理俚语、古诗等复杂文本;3)推出集成模型Hunyuan-MT-Chimera-7B,可组合多模型提升专业翻译准确率。目前该技术已应用于腾讯会议、企业微信等产品,服务超10万开发者。腾讯将持续开源优化
摘要:本文提出了一种面向局部遮挡场景的目标检测系统,通过结合深度学习、图像处理与前端可视化技术,有效提升了遮挡环境下的检测性能。系统采用OpenMMLab框架集成多种先进算法,改进网络结构以增强遮挡特征提取能力,并利用数据增强技术提高模型鲁棒性。后端基于Python实现模型训练与数据处理,前端采用Vue框架结合Canvas技术实现实时可视化。实验表明,该系统在遮挡场景中相比传统方法具有更高检测精度
阿里Qwen2模型发布,相比Qwen1.5精简了模型尺寸(0.5B-72B共5个),新增57B-A14B MoE大模型。关键升级包括:所有模型采用GQA加速推理,7B/72B上下文扩展至128K,小模型采用tie embedding优化。架构上通过调整层数、注意力头等参数平衡效率与性能,72B模型在多项评测中超越Llama3-70B和Qwen1.5-110B。训练支持LLaMA-Factory框架
TableAgent是一款基于Alaya大模型的智能数据分析工具,由九章云极DataCanvas公司开发,旨在实现零编码的自动化数据分析流程。用户只需输入分析目标,TableAgent即可自动完成数据筛选、格式转换、模型选择、代码生成及报告输出。其特点包括会话式分析、领域微调、私有化部署、透明化过程和企业级分析支持。本文以建设银行股票数据为例,从注册账号到实践操作,展示了TableAgent的核心
在AI重塑数据分析行业的时代,数据分析师需提升业务穿透力、策略想象力和结果掌控力等核心能力,将数据转化为商业洞察,超越AI的相关性分析,识别伪洞察。真正的竞争优势在于数据分析思维和逻辑,而非工具使用。与AI协同,聚焦本质问题,创造独特价值,才能避免被取代。
别再说AI画画是缝合了——白话AI作画原理(适用于没有数学和统计学基础的人!)
TDesign AI Chat 是腾讯 TDesign 为 AIGC 场景开发的 Vue3.x 开源 UI 组件,专为构建 AI ChatBot 对话交互界面设计。最新 0.2 版本新增了思考过程、增强版输入框、加载动画等功能,并支持多语言,帮助开发者快速搭建 AI 对话应用。组件包含多个子模块,支持按需引入和自定义主题,内置 Markdown 渲染和流式传输功能,适用于类似 ChatGPT 的交
描述诸如编码者间一致性(如果适用)、成员核查或数据来源的三角测量等步骤,以增强您的发现的有效性。指定要测量的变量、数据来源、数据收集工具以及数据收集中可能遇到的挑战。指定可视化类型(图表、图形、图解)、将使用的软件/工具及其在传达洞察中的作用。概述参与者招募、调查分发、数据收集的过程以及提高响应率的潜在方法。概述参与者随机化、治疗实施、实验期间和之后的数据收集以及控制措施的程序。详细描述数据将如何
今天,带大家写一个通信方式为SSE的MCP服务器,让你的Dify拥有自主查询数据库的能力!
模型上下文协议(MCP)通过标准化的接口和交互语法,重新定义AI与物理世界的连接,提升人机协作的深度与广度。
三是基于个人同意处理人脸信息的,应当取得个人在充分知情的前提下自愿、明确作出的单独同意。为了规范应用人脸识别技术处理人脸信息活动,保护个人信息权益,国家互联网信息办公室、公安部联合出台《办法》,对应用人脸识别技术处理人脸信息的基本要求和处理规则、人脸识别技术应用安全规范、监督管理职责等作出了规定。应用人脸识别技术处理人脸信息活动,应当遵守法律法规,尊重社会公德和伦理,遵守商业道德和职业道德,诚实守
OWL 在 GAIA 基准测试中取得 58.18 平均分,在开源框架中排名第一!OWL 是一个前沿的多智能体协作框架,推动任务自动化的边界,构建在 CAMEL-AI Framework。具体可以看公众号今天推送的第二篇文章~OWL的愿景是彻底变革 AI 智能体协作解决现实任务的方式。通过利用动态智能体交互,OWL 实现了跨多领域更自然、高效且稳健的任务自动化。3月7号OWL在GitHub上开源了代
Generative Physics Simulator is all You Need
香港中文大学(CUHK)的研究团队成功开发了一种新的基础人工智能模型“VisionFM”,专注于眼科疾病的诊断与预测,特别在疾病筛查和青光眼进展预测等方面表现出色。相关研究已于上月发表在《NEJM AI》期刊上。VisionFM 的能力令人瞩目。研究显示,该模型在诊断12种眼科疾病时,其精确度不仅可与中级眼科医生相媲美,甚至在部分任务中表现更优,尤其在预测青光眼进展方面,超过了此前眼科领域的基础模
Pika Labs 的数据分析过程:1.数据收集与预处理: 从各种来源收集数据,并进行清洗、转换和标准化。2.特征工程: 从原始数据中提取有意义的特征,以供模型使用。3.模型选择与训练: 选择合适的机器学习或深度学习模型,并进行训练。4.模型评估与优化: 评估模型性能,并进行优化以提高模型精度和泛化能力。5.模型部署与推理: 将训练好的模型部署到生产环境中,进行实时或批量推理。
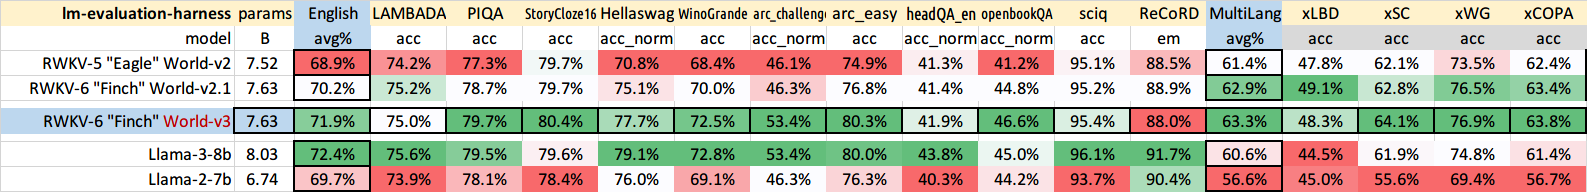
2024 年 11 月 13 日,RWKV-6-World-7B-v3 模型正式开源发布。对比 RWKV-6-World-v2.1 模型,RWKV-6-World-v3 模型新增了 World-v3 数据集(约 3.1T tokens),对比 v2.1 数据集补充了优质英文网页、代码、中文小说、多语言数据、数学数据、指令数据等。
Tora是由阿里团队推出的一种基于轨迹导向的扩散变换器(Diffusion Transformer, DiT)技术的AI视频生成框架。Tora在生成过程中可以接受多种形式的输入,包括文字描述、图片或物体移动的路线,并据此制作出既真实又流畅的视频。通过引入轨迹控制机制,Tora能够更精确地控制视频中物体的运动模式,解决了现有模型难以生成具有精确一致运动的问题。Tora采用两阶段训练过程,首先使用密集
Tableau是一款非常强大的数据可视化工具,由Tableau Software公司开发,现已被Salesforce收购。Tableau可以帮助用户轻松地连接、整合、可视化和分享数据,使复杂的数据变得易于理解和分析。Tableau提供了多种产品和服务,包括Tableau Desktop、Tableau Server、Tableau Prep等,满足不同用户的需求。
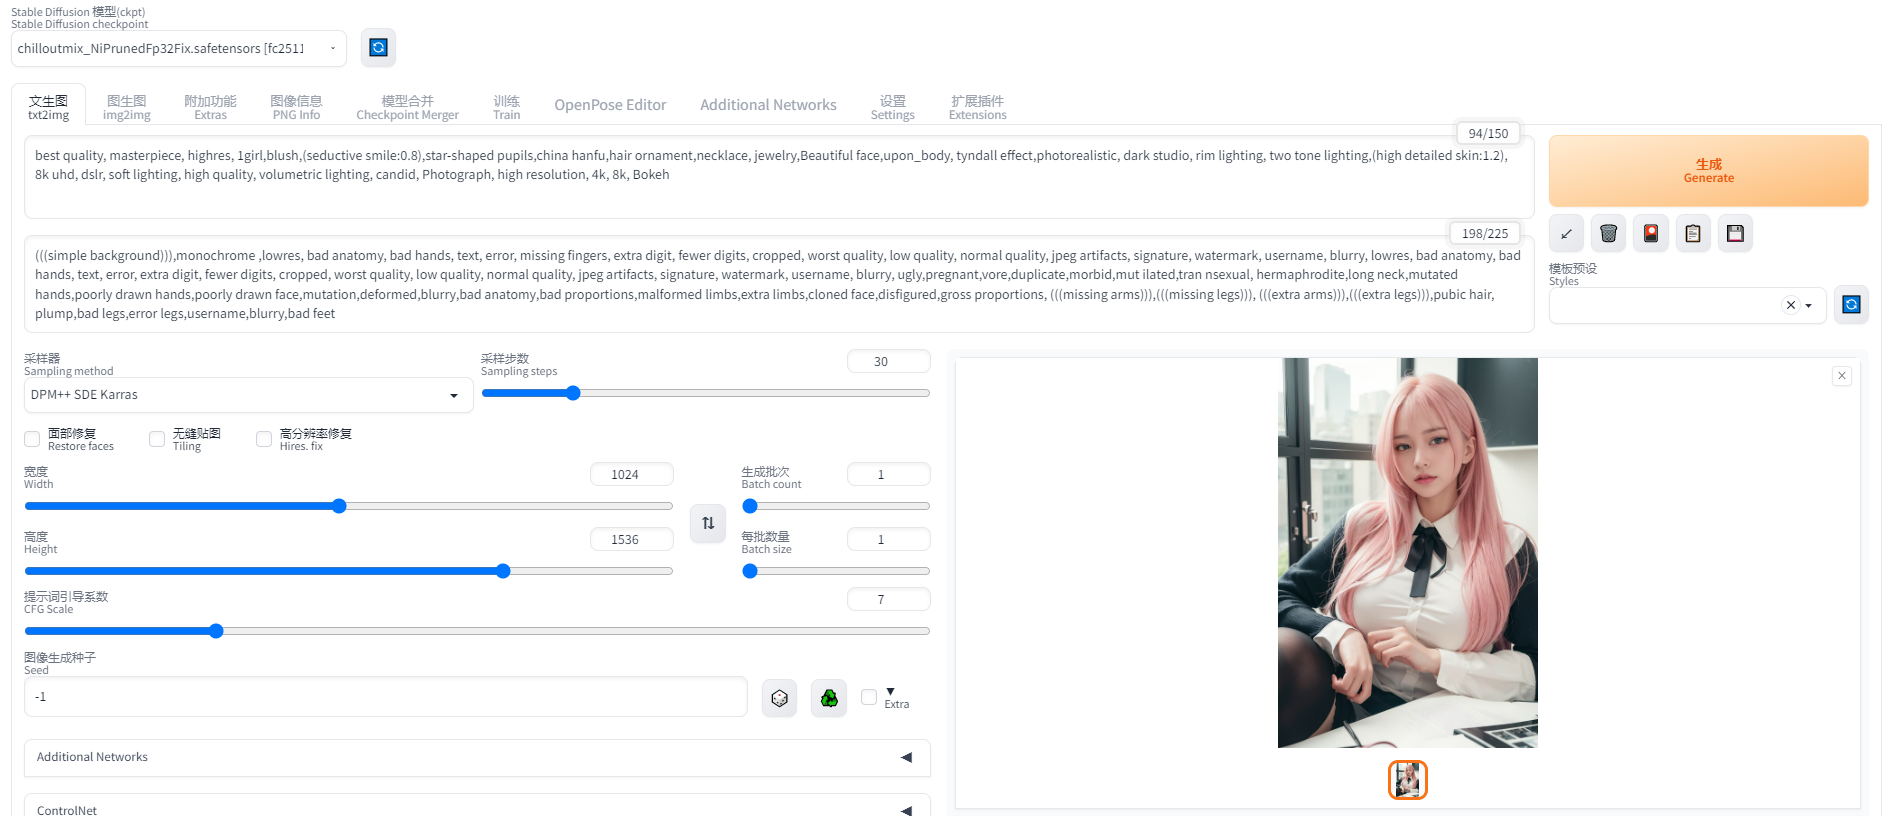
文生图(text2img):** 根据提示词 `Prompt` 的描述生成相应的图片*选择 `绘画模型(Stable Diffusion checkpoint)` ► `文生图(txt2img)` ► `填写正向提示词(Prompt)` ► `填写反向提示词(Negative prompt)` ► `选择采样器(一般选择DPM++ 2M Karras)` ► `设置采样步骤(一般设置30)` ►
玩转地表最强开源 AI 绘画模型
介绍计算机视觉(Computer Vision, CV)是人工智能的一个分支,旨在使计算机能够从图像或视频中获取信息、理解环境、并采取相应行动。CV 在 AIGC 系统中具有重要地位,被广泛应用于图像识别、物体检测、姿态估计、图像生成等任务。应用使用场景图像分类:如手写数字识别、人脸识别等。物体检测:用于自动驾驶车辆中的行...
人工智能在文本、图像和声音的创意内容生成方面已经决定性地扩展了其应用范围。在视觉领域,扩散模型被广泛用于图像生成和修改。开源项目如Stable Diffusion在文本转图像方面取得了显著进展。然而,在视频生成方面,当前模型仍面临一些挑战,如质量欠佳、视频长度有限以及运动不自然,这表明该技术还有很大的进步空间。一些开创性的研究在利用Stable Diffusion方法进行视频合成方面取得了进展,重
后续更新我们会不断完善文档内容来提供更好的技术支持。后续会增加 Blog 页面,来持续同步 CodeFuse 的最新技术/技术应用/学术前沿文章。CodeFuse 线上社区活动,包括新手任务计划参考案例、社区共建计划参考案例等,也会在这里进行同步发布。关于 CodeFuse 团队CodeFuse 团队由一群充满热情的成员组成,我们的目标是构建大型编码语言模型(Code LLMs),以支持和提升在整
是一个 Sora 的开源替代, 昨天正式发布了。该项目与另一个 Sora 开源替代。现在可以在 HF 上。
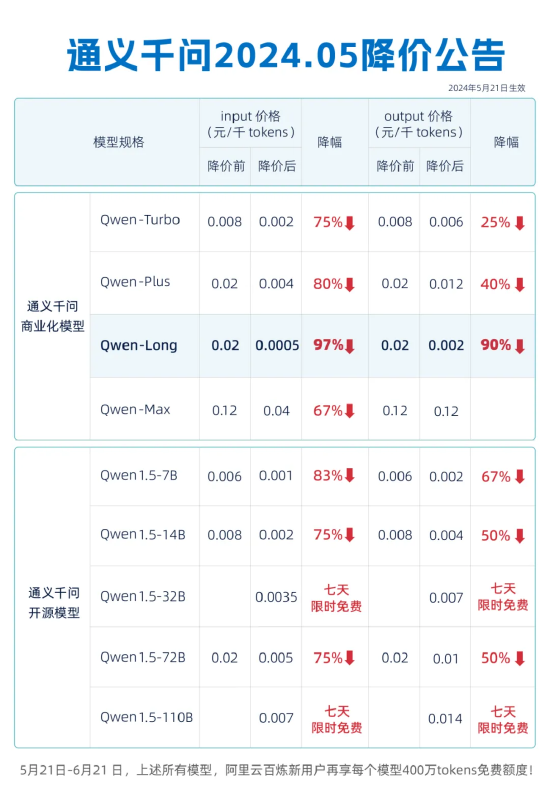
阿里云宣布通义千问GPT-4级主力模型Qwen-Turbo、Qwen-Plus、Qwen-Long、Qwen-Max等9款主力AI大模型宣布全面降价。其中,Qwen-Long API输入价格从0.02元/千tokens降至0.0005元/千tokens,最高直降97%。这意味着,1块钱可以买200万tokens,相当于5本《新华字典》的文字量。而在不久前,DeepSeek-V2价格做到了每百万to
RISC-V(发音为 "risk-five")是一种基于精简指令集计算(RISC)原则的开放源代码指令集架构(ISA)。它由加州大学伯克利分校在2010年首次发布,并迅速获得了全球学术界和工业界的广泛关注和支持。RISC-V架构的特点包括:开放标准:RISC-V ISA是开源的,允许任何人免费使用和扩展,无需授权费用,极大地促进了技术的共享和创新。简洁与模块化:RISC-V架构设计简洁,采用模块化
QAT量化,是将训练过的模型进行量化并再训练。如图5所示,为标准的QAT量化流程,包括跨层均衡(CLE)、添加量化器(Add Quantizers)、范围设置(Range Estimation)、量化参数可学习(Learnable Quantization Params)等步骤,其中在量化参数可学习中,需要直接学习量化参数,而不是在每个周期中更新它们,从而带来更高的性能,特别是在处理低比特量化时,
演示站点: https://ai.uaai.cn 官方论坛: www.jingyuai.com 京娱AI,提供完整的 Sora 复现架构方案,包含从数据处理到训练推理全流程。支持动态分辨率,训练时可直接训练任意分辨率的视频,无需进行缩放。支持多种模型结构。由于 Sora 实际模型结构未知,用户可自行选择使用原始视频、VQVAE(视频原生的模型)、SD-VAE(图像原生的模型)进行训练。
Look!👀我们的大模型商业化落地产品📖更多AI资讯请👉🏾关注Free三天集训营助教在线为您火热答疑👩🏼🏫在自然界中,涌现现象无处不在,从鸟群的和谐飞翔到生物细胞的精妙分化,例如大脑中的神经元通过简单的电化学信号相互作用,但整体上却能产生意识、思考和记忆等极其复杂的功能。这表明了从神经元到思维的过程是一种典型的涌现现象。从化学反应中的神秘图案到大脑中思维的火花,比如贝纳德对流和利斯
在当前学术出版界,一个令人瞩目的现象是,多达79%的论文由于统计方法的错误应用而未能成功发表。这不仅削弱了研究的有效性,也降低了论文的接受率。鉴于此,我们精心筛选并汇总了一系列稀缺而精华的统计分析资源,旨在为研究者提供一把攀登科研高峰的利器。这些特别资源汇集了:北卡罗来纳大学教堂山分校(University of North Carolina at Chapel Hill,最美国顶尖的五所公立大学
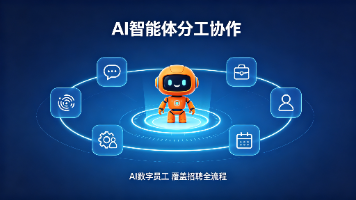
2026 年,打开任何一个招聘软件的官网,几乎都在讲 "AI":有的把智能搜索包装成 AI,有的加了一个自动回复机器人,有的则让 AI 数字员工真正参与到寻访、筛选、匹配、沟通、邀约的全流程当中。招聘生态产业正从传统模式向信息化高速发展,企业对招聘工具的要求,也从 "数字化管理" 上升到了 "数字化决策"。AI 招聘不是把 "招聘" 两个字加上 AI 前缀,而是让 AI 数字员工真正成为招聘团队的
现在的学术写作,其实是一场人类智慧与机器算法的博弈。宏智树AI提供的“双降”功能,本质上是在帮你理解学术规范、优化语言表达,让你在规则内发挥最大的潜力。不要再傻傻地手动调换语序了,那是低效的“体力活”。利用宏智树AI的语义理解能力,去重构你的论证逻辑,掩藏AI的机械痕迹,才是这个时代论文写作的“高智商”玩法。记住,工具是死的,人是活的。,微信公众号搜一搜宏智树AI),它能让你把时间真正花在研究的刀
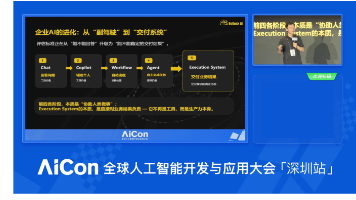
Agent本身不具备复制性。自然堂的导购机器人搬到欧莱雅完全不适用,医疗场景的方案搬到教育场景也得重来。但搭建过程的框架是具备复制性的——流程有流程模板,任务有任务模板。这意味着什么?意味着你不需要每次从零开始造Agent。只要把AgentInfra层搭好,后续不同场景的Agent落地,就是"套模板、填内容"的事。这才是AgentInfra层的真正价值:不是给每个企业造一个Agent,而是给每个企
宇树科技发布世界-动作大模型UnifoLM-X2-1.0,人形机器人实现无遥控全自主搏击。本文拆解"瞬时规划"技术原理、世界模型如何赋予机器人预测能力,以及搏击演示背后的产业信号——机器人正从实验室走向真实场景。
本文实测BunnyScholar开题报告生成软件,针对协作机器人抛光课题,可单次输出8000字以上完整方案,包含控制律推导、技术路线图及甘特进度表,支持真实文献与Word导出,较通用AI工具更专业;搭配助研君可低成本润色,助力高效完成开题
李飞飞团队发布新一代多模态世界模型Atlas:用"新视角预测"取代"预测下一个Token",从零训练打通视频生成、3D重建与时空模拟。两段手机视频即可搭建机器人仿真训练场,AI正从"看懂世界"迈向"理解空间",空间智能或成下一代AI主战场。