登录社区云,与社区用户共同成长
邀请您加入社区
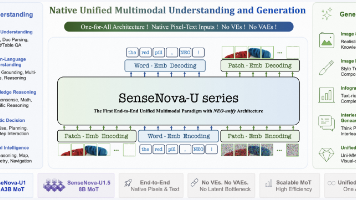
SenseNova-U1.5部署实战(多案例)
MiniMax 正式发布新一代通用全模态生成模型,作为品牌首款计划开源的多模态视听生成模型,H3 将文本模型成熟的推理、上下文技术迁移至视频生成领域,面向开发者与商业场景提供一体化音视频生成能力。
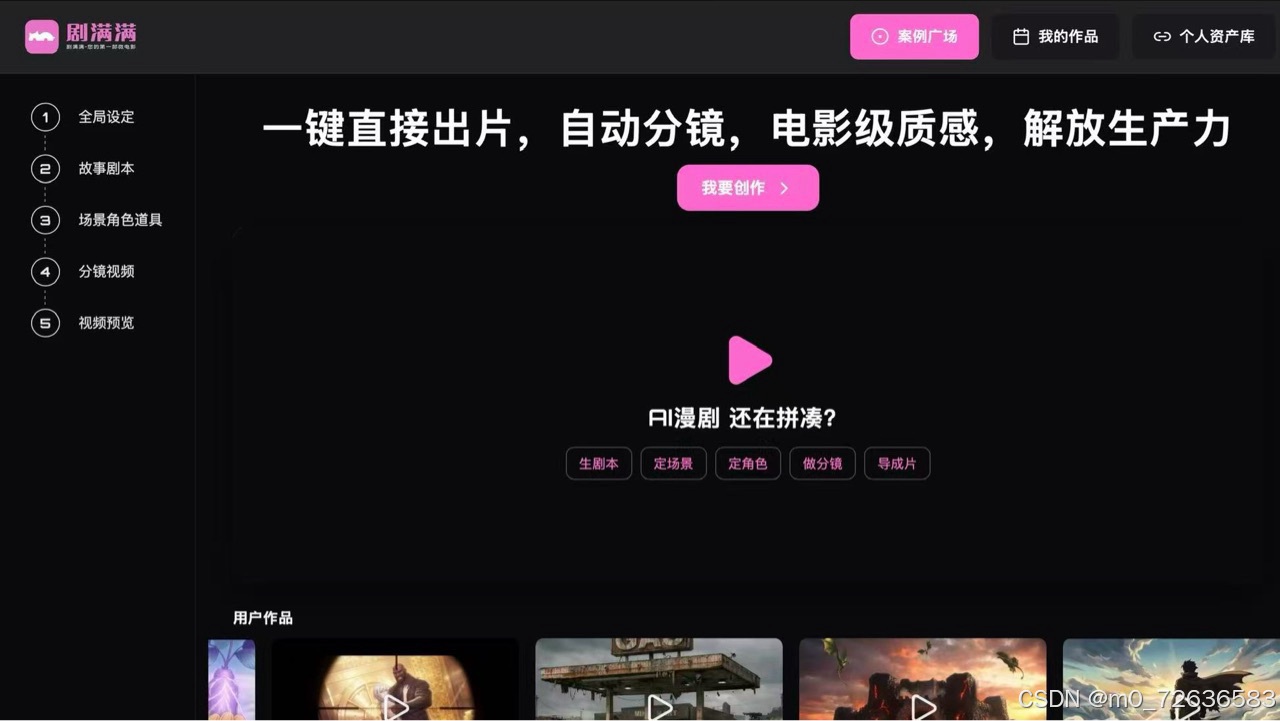
这是一套基于 Java + Vue + AIGC模型 构建的全流程 AI 漫剧生产系统。未来随着视频生成模型不断升级,AI短剧、AI动画、AI影视制作将成为内容生产的重要方向。小说输入 → AI剧本 → AI分镜 → AI画面 → AI视频 → 自动成片。随着 AIGC 技术快速发展,短剧、漫画、动画内容生产正在进入智能化时代。输入一本小说 / 一段剧本,自动生成完整 AI 漫剧短视频。帮助开发者
别再说AI画画是缝合了——白话AI作画原理(适用于没有数学和统计学基础的人!)
数据科学学习指南:免费资源大放送!这位博主在视频中分享了一份完整的数据科学学习指南,他表示这份指南是过去三年他倾心打造的成果,包含了丰富的学习资料、项目案例、面试问题等,旨在帮助大家高效地学习数据科学,最终成为数据科学家或数据分析师。这份指南包含了英文和印地语两种语言的资料,包括视频、文章和博主亲手书写的笔记。所有资料都已整理成一个完整的路线图,帮助学习者循序渐进地学习数据科学。博主强调这份...
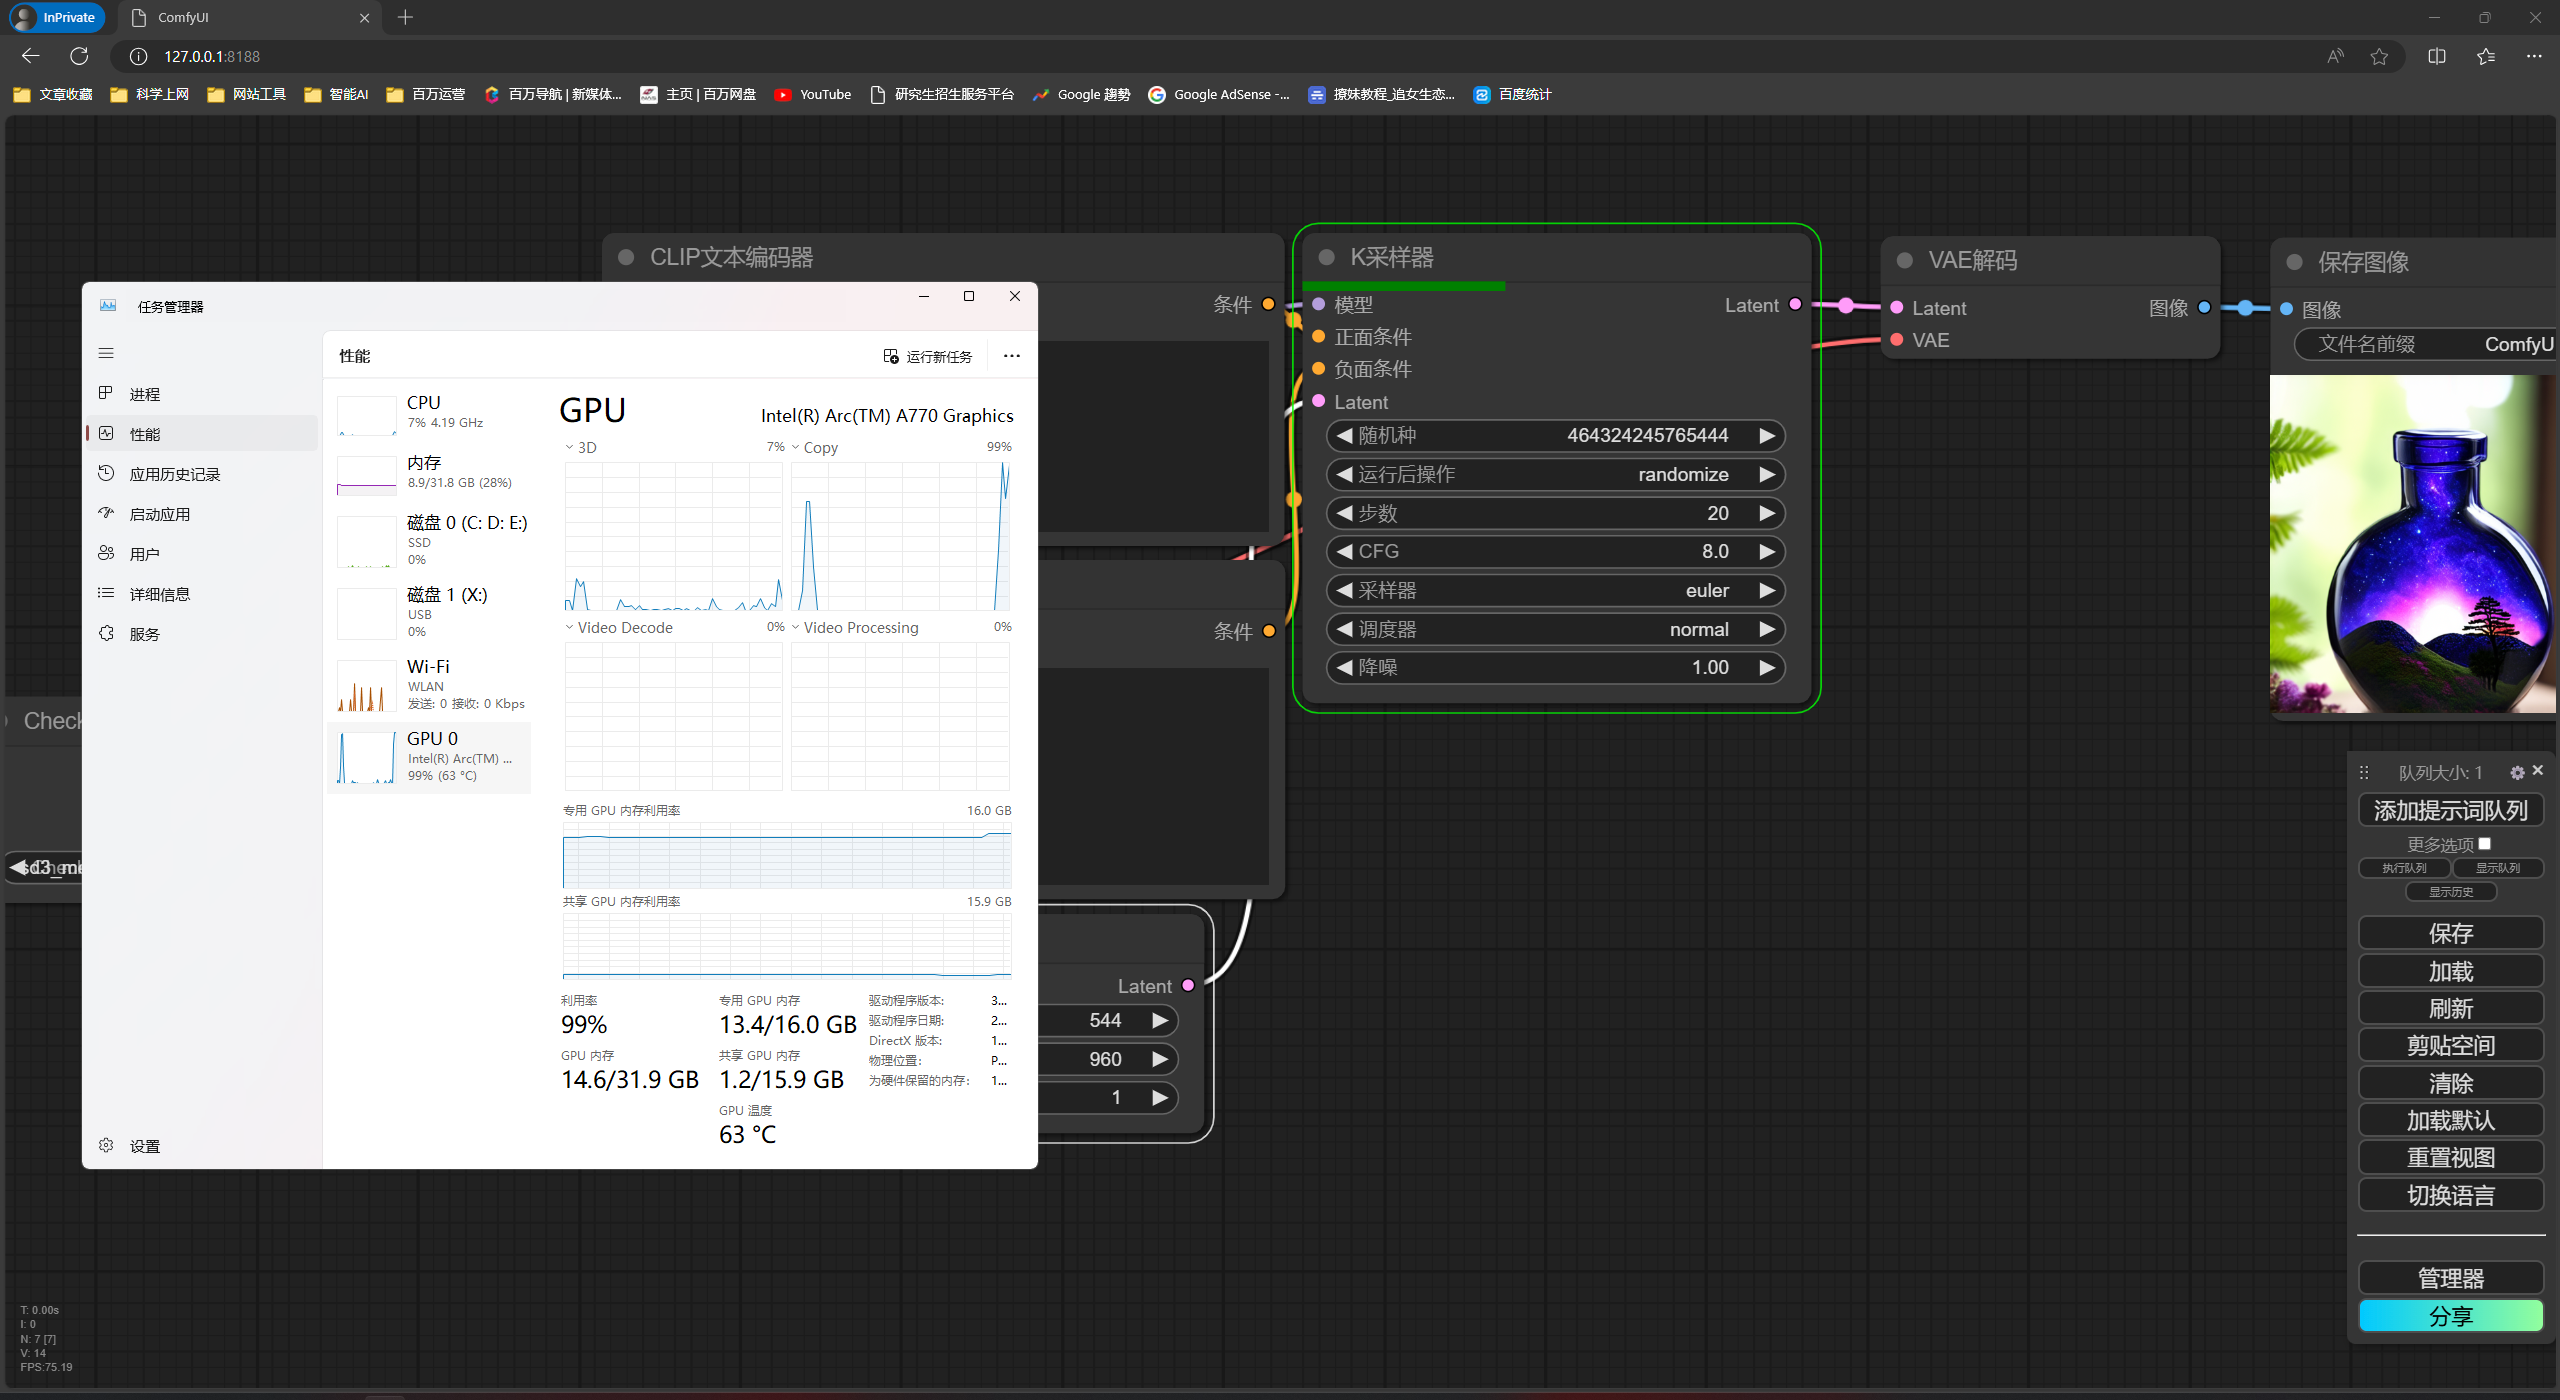
只要10步,让你在英特尔A770显卡下,安装ComfyUI,运行StableDiffusion3最新开源模型
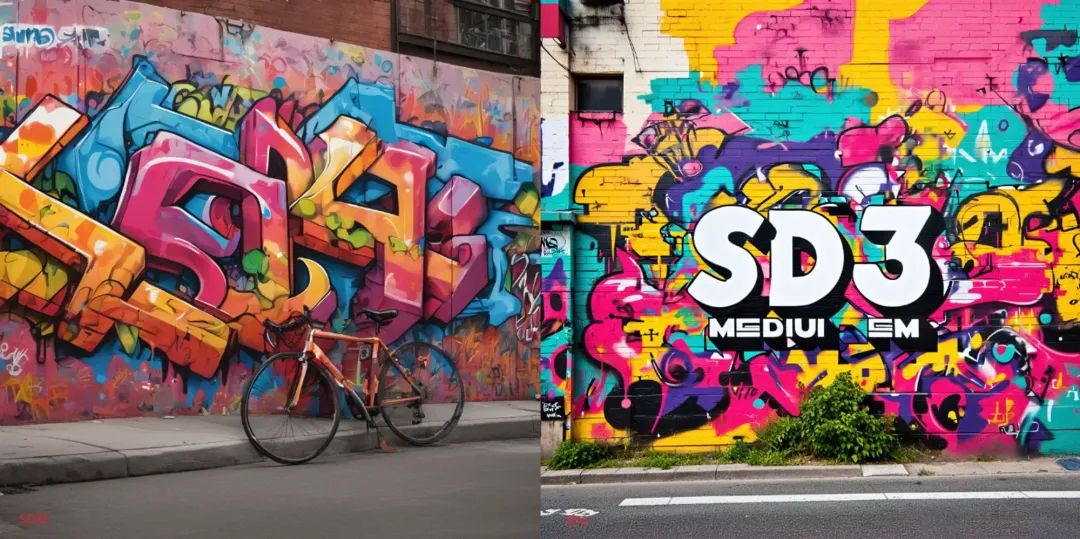
大家好,我是程序员晓晓。早在之前的文章中我就提过Stable diffusion3(2B)开源的消息,关于SD3的优势就不再赘述了,今天主要说说普通用户如何在本地进行部署。但是下载模型需要先登录Hugging Face账户,并签署一份许可协议签署完毕之后就可以看到整个项目的文件列表了注意:该下载需要科学上网,且操作较为复杂。需要的朋友可以扫描即可免费获取SD3.0整个模型文件上面的文件大致可以分为
是一个 Sora 的开源替代, 昨天正式发布了。该项目与另一个 Sora 开源替代。现在可以在 HF 上。
演示站点: https://ai.uaai.cn 官方论坛: www.jingyuai.com 京娱AI,提供完整的 Sora 复现架构方案,包含从数据处理到训练推理全流程。支持动态分辨率,训练时可直接训练任意分辨率的视频,无需进行缩放。支持多种模型结构。由于 Sora 实际模型结构未知,用户可自行选择使用原始视频、VQVAE(视频原生的模型)、SD-VAE(图像原生的模型)进行训练。
昆仑天工系列AIGC开源模型,支持AI问答、AI写作、AI绘画、AI补全代码,基于中文语料训练而成,不止ChatGPT。
例子:早期计算器、老式客服机器人。七、未来发展方向 1. 更小更轻量化的端侧AI:手机本地运行大模型,不用联网,隐私更好2. AGI通用人工智能探索:具备持续自主学习能力3. AI智能体 Agent:AI可以自动规划一连串任务,自主操作软件完成一整套工作(自动做报表、订会议、整理资料)4. 多模态统一模型:文字/图像/音频/3D无缝打通5. 具身智能:AI控制实体机器人做家务、工厂作业 八、普通人
你写个"挥拳",模型就真只给你一个挥手的动作——拳头打出去之后,肌肉怎么绷、腰胯怎么转、镜头推还是拉、地上灰扬不扬、衣服头发带不带惯性,这些它通通不知道,全靠瞎猜。不然就是俩木偶瞎比划,尴尬癌都犯了。动不动僵得像生锈的机器人,慢动作一出来直接变搞笑片,硬加特效又跟画面打架,假得离谱。下次写提示词,按这套往里填,至少让角色动起来像回事,别像商场门口的充气人。模型能懂多少算多少,你把能给的都给了,剩下
摘要: 魔珐星云(Embodia AI)是全球首个面向开发者的具身智能3D数字人开放平台,通过云-端协同架构解决传统数字人表情僵硬、高延迟、高算力门槛等问题。其核心技术在于传输轻量级参数流而非视频流,结合多模态表达生成层,实现语义与表情/动作的实时对齐,端到端延迟低于500ms,支持百元级芯片部署。平台提供六大核心优势(高质量交互、低延迟、高并发等)及三大应用方向(AI具身Agent、智能终端升级
如果你是真正有耐心想花功夫学一门技术去改变现状,我可以把这套AI教程无偿分享给你,包含了。
拥抱AI时代的商业摄影:创新、实践与未来随着科技的飞速发展,商业摄影迎来了一个全新的时代,AI的崛起为摄影行业注入了前所未有的活力。本文将探讨为什么商业摄影需要AI,以及在实际操作中如何将实拍与AI巧妙结合。为什么商业摄影需要AI?1. 降低创意成本商业摄影一直注重创意,然而,实现创意往往需要昂贵的设备和复杂的后期制作。AI的引入极大地降低了创意实现的成本,使得即使是小型摄影团队也能轻松实现高水平
超越 DALL-E 3 和 Stable Diffusion: 在 GenEval 和 DPG-Bench 等基准测试中,Janus-Pro-7B 的性能优于 OpenAI 的 DALL-E 3 和 Stability AI 的 Stable Diffusion。基于 DeepSeek-LLM: Janus-Pro 建立在 DeepSeek-LLM-1.5b-base/DeepSeek-LLM-7
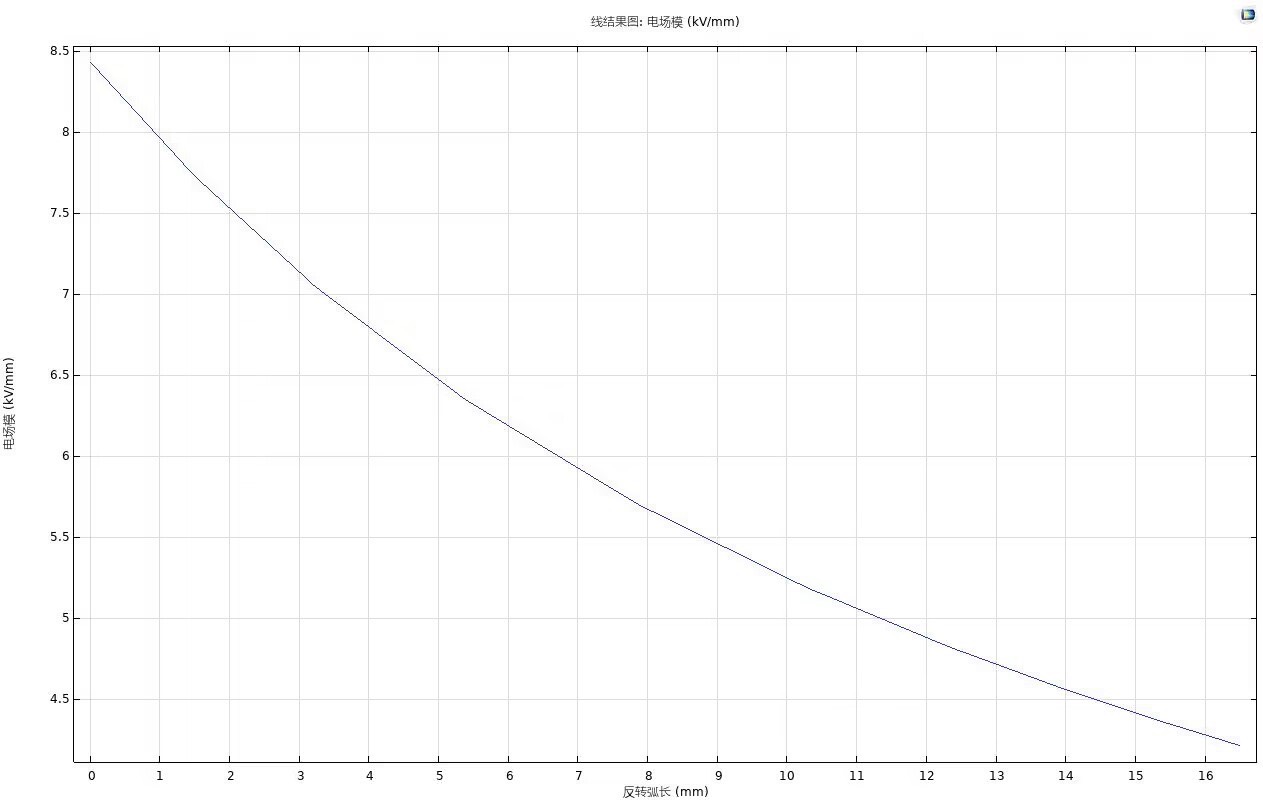
今天咱们直接上干货,用COMSOL搞个真刀真枪的电场计算模型。先别急着建几何,把材料参数理清楚是关键。电场计算的核心方程是静电场模块,但别忘记勾选空间电荷密度选项——高压下电荷迁移会影响场强分布。这里有个取巧的办法:用内置的电缆模型库,改改尺寸就能生成标准结构。comsol高压电力电缆电场计算模型,可以得到电缆内部电势、电场及各个位置电场线分布,提供comsol详细学习资料及模型。comsol高压
(还给大家准备了大量工作流和模型)让大家轻松上手无压力!
感兴趣的小伙伴,赠送全套AIGC学习资料,包含AI绘画、AI人工智能等前沿科技教程和软件工具,具体看这里。AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,
计算机科学与探索》是“北大中文+CSCD”双核心期刊,中国计算机学会(CCF)“计算机领域高质量科技期刊分级目录”T2类。文章:《少样本运动模式学习与视频生成控制策略》已录用,实现了在消费级gpu就可以完成文 本生成可控视频的训练和推理。作者已经按照修改意见进行了修改,文章质量有一定的提升,建议录用。鉴于文章尚存在一些问题且较重要,按审稿意见认真修改后需请专家。专业:控制工程(2023级研究生)文
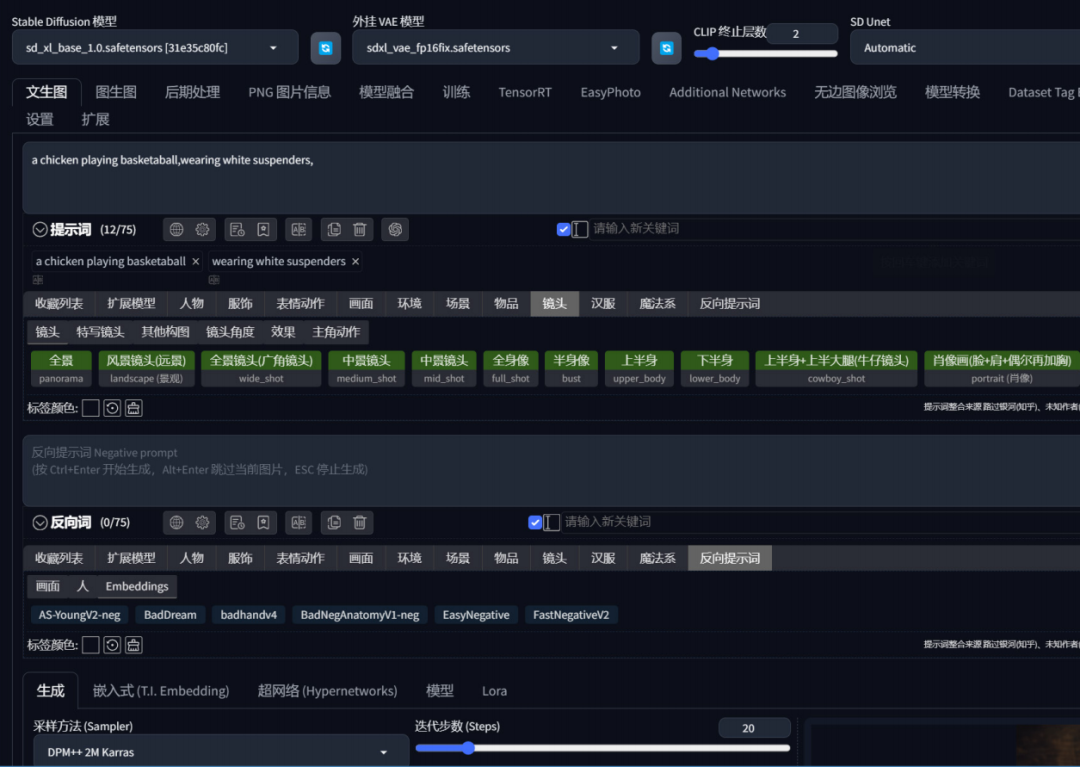
今天我们来聊聊如何在本地部署Stable Diffusion,这可是个既复杂又有趣的话题!Stable Diffusion作为一款强大的文生图AI,可以将文本描述转化为图像,而它的开源本地化部署使得我们能够在自己的计算机上使用这个AI模型,并进行定制化开发。我们会从最基础的环境配置开始,一步步深入到模型部署、生成图像的过程中,并且提供一些高阶技巧和操作,让你能够玩转Stable Diffusion
在这里仍然要极力推荐,因为就我的体验来说,它是目前最好用的了。介绍完今天本地部署的SD后,你们可以结合着用,在线先跑出小样,然后再在本地做优化。不过你的电脑配置得够强才行哈!
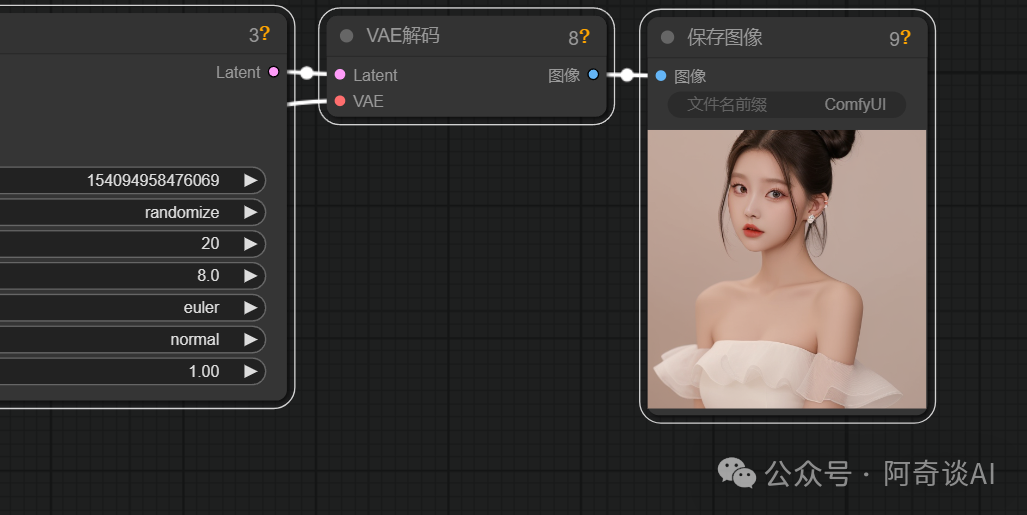
大家好!今天我要给大家介绍一个特别酷的东西——ComfyUI。你可能没听过这个名字,但相信我,一旦你了解了它,你一定会爱上它的。ComfyUI是什么呢? 简单来说,它是一个基于节点的图形用户界面,专为Stable Diffusion设计。听起来有点复杂?别担心,我会解释得简单易懂。
人工智能在艺术创作中的应用不仅限于绘画,还包括音乐、舞蹈、文学等多个领域。AI通过深度学习和神经网络等技术,能够分析和理解大量的艺术作品,从中学习和模仿艺术风格,甚至创造出新的艺术形式。AI绘画是其中最引人注目的应用之一,通过结合艺术与技术,创造出令人惊叹的视觉作品。AI在绘画艺术中的应用正在引领一场新的艺术革命。通过深度学习、神经网络和生成对抗网络等技术,AI能够生成高质量的艺术作品,并为艺术家