【youcans论文精读】U-Net v2:重新思考医学图像分割中 U-Net 的跳跃连接
欢迎关注『youcans论文精读』系列
【youcans论文精读】U-Net v2:重新思考医学图像分割中 U-Net 的跳跃连接
0. 论文简介
0.1 基本信息
2025年,Y. Peng 等 在 ISBI 2025 发表论文(IEEE 22nd International Symposium on Biomedical Imaging 【U-Net v2:重新思考医学图像分割中 U-Net 的跳跃连接】(U-Net V2: Rethinking the Skip Connections of U-Net for Medical Image Segmentation)。
本文提出 U-Net v2 这一用于医学图像分割的 U-Net 变体,其核心是通过创新的 SDI(语义与细节注入)模块,利用 Hadamard 乘积将编码器生成的高层特征(含丰富语义信息)与低层特征(含精细细节)注入到各层级特征图中,并结合空间与通道注意力机制优化特征;该模型可无缝集成到任意编解码器网络。
论文标题: U-Net V2: Rethinking the Skip Connections of U-Net for Medical Image Segmentation
作者: Yaopeng Peng; Danny Z. Chen; Milan Sonka
论文地址: ieeexplore,arxiv
引用格式: Y. Peng, D. Z. Chen and M. Sonka, “U-Net V2: Rethinking the Skip Connections of U-Net for Medical Image Segmentation,” 2025 IEEE 22nd International Symposium on Biomedical Imaging (ISBI), Houston, TX, USA, 2025, pp. 1-5, doi: 10.1109/ISBI60581.2025.10980742.

0.2 论文速览
现有模型的局限性:
- 特征融合低效:传统 U-Net 类模型依赖特征拼接(如 UNet++ 的密集连接),融合效果依赖训练数据集规模,而医疗数据常因隐私等问题受限,易引入噪声。
- 资源消耗高:密集连接需存储大量中间特征图与梯度,导致 GPU 内存占用和 FLOPs(浮点运算次数)显著增加。
- 部分方法缺陷:如 TransFuse(融合 CNN 与 Transformer 特征)、PraNet(反向注意力)等方法结构复杂,性能仍有提升空间。
U-Net v2 模型架构:
U-Net v2 核心是创新跳连机制,通过 “编码器→SDI 模块→解码器” 的三模块架构,实现语义信息与精细细节的高效注入:
- 编码器:提取输入图像的多层级特征
- SDI 模块:优化各层级特征,注入高层语义与低层细节
-
- 注意力优化
-
- 通道降维
-
- 尺寸匹配
-
- 平滑卷积
-
- Hadamard 乘积融合
-
- 解码器:接收 SDI 模块输出的 f_i⁵,完成分辨率重建与最终分割
主要结论:
- 模型有效性:U-Net v2 通过 SDI 模块和 Hadamard 乘积,实现高层语义与低层细节的高效融合,在皮肤病变、息肉分割任务中超越现有 SOTA 方法。
- 效率优势:相比 UNet++ 等模型,U-Net v2 参数更少(25.02M)、GPU 内存占用更低(411.42MB)、FLOPs 更小(5.399G),兼顾性能与效率。
- 泛用性:可无缝集成到任意编解码器网络,为医学图像分割提供通用优化方案。

0.3 摘要
- 本文提出一种用于医学图像分割的新型稳健高效 U-Net 变体 ——U-Net v2。该模型旨在增强语义信息向低层特征的注入,同时利用更精细的细节优化高层特征。
- 对于输入图像,首先通过深度神经网络编码器提取多尺度特征;随后,通过 Hadamard 乘积(哈达玛积)注入高层特征中的语义信息,并融合低层特征中的精细细节,以此增强各层级的特征图。
- 我们创新性的跳跃连接使所有层级的特征兼具丰富的语义属性与复杂精细的细节信息。经过优化的特征随后被传输至解码器,进行后续处理与分割。该方法可无缝集成到任意编解码器网络中。
- 我们在多个公开医学图像分割数据集上(针对皮肤病变分割与息肉分割任务)对该方法进行了评估,实验结果表明,新方法在保持内存与计算效率的同时,分割精度优于当前主流方法。
- 代码可通过以下链接获取:https://github.com/yaoppeng/U-Net_v2。
1. 引言
随着现代深度神经网络的发展,语义图像分割领域已取得显著进展。语义图像分割的典型范式是采用带有跳跃连接的编解码器网络 [1]。在该框架中,编码器从输入图像中提取具有层级结构的抽象特征,而解码器则接收编码器生成的特征图,重建像素级分割掩码或分割图,并为输入图像的每个像素分配类别标签。已有一系列研究 [2,3] 致力于将全局信息融入特征图并增强多尺度特征,从而大幅提升分割性能。
在医学图像分析领域,精准的图像分割在计算机辅助诊断与分析中起着关键作用。U-Net [4] 最初是为医学图像分割而提出的,其通过跳跃连接在每个层级连接编码器与解码器模块。这些跳跃连接使解码器能够获取编码器早期模块的特征,从而同时保留高层语义信息与细粒度空间细节。该方法有助于精准勾勒医学图像中目标的边界,并提取微小结构。此外,有研究采用密集连接机制,通过拼接所有层级和所有模块的特征,减少编码器与解码器中特征的差异 [5];还有研究设计了特定机制,通过拼接高低不同层级的多尺度特征来增强特征表达 [6]。
然而,基于 U-Net 的模型中,这类连接在融合低层与高层特征时的效果可能不够理想。例如,在 ResNet [7] 中,深度神经网络被构建为多个浅层网络的集合,而额外添加的残差连接表明,即便在百万级图像数据集上训练,该网络仍难以学习恒等映射函数。
对于编码器提取的特征而言,低层特征通常保留更多细节,但语义信息不足,且可能包含不必要的噪声;与之相反,高层特征虽包含更丰富的语义信息,但由于分辨率大幅降低,缺乏精准的细节(如目标边界)。仅通过拼接方式融合特征会严重依赖网络的学习能力,而这种能力往往与训练数据集的规模成正比。这一问题颇具挑战性,在医学成像领域尤为突出 —— 该领域通常受限于数据量不足。通过密集连接拼接多个层级的低层与高层特征以实现信息融合,可能会限制不同层级信息的贡献,还可能引入噪声。另一方面,尽管额外添加的卷积操作不会显著增加参数数量,但由于前向传播和反向梯度计算过程中需存储所有中间特征图及相应梯度,GPU 内存消耗会随之增加,进而导致 GPU 内存占用量与浮点运算次数(FLOPs)双重上升。
在文献 [8] 中,研究人员利用反向注意力明确建立多尺度特征间的连接;文献 [9] 则对高层特征应用 ReLU 激活函数,并将激活后的特征与低层特征相乘;此外,文献 [10] 的作者提出分别从 CNN(卷积神经网络)和 Transformer 模型中提取特征,通过在多个层级融合 CNN 与 Transformer 分支的特征来增强特征图。然而,这些方法结构复杂,且性能仍不够理想,有待进一步改进。
本文提出一种基于 U-Net 的新型分割框架 ——U-Net v2,其核心是简洁高效的跳跃连接设计。该模型首先通过 CNN 或 Transformer 编码器提取多层级特征图;随后,对于第 i 层特征图,通过简单的哈达玛积(Hadamard product)操作,明确注入高层特征(含更丰富语义信息)与低层特征(含更精细细节),从而同时增强第 i 层特征的语义表达与细节信息;之后,经过优化的特征被传输至解码器,用于分辨率重建与分割。该方法可无缝集成到任意编解码器网络中。
我们在两个医学图像分割任务(皮肤病变分割与息肉分割)中,采用公开数据集对新方法进行评估。实验结果表明,在这些分割任务中,U-Net v2 不仅持续优于当前主流方法,还能保持较低的浮点运算次数与高效的 GPU 内存占用。
2. 方法
2.1 整体架构
U-Net v2 的整体架构如图 1(a)所示,由三个主要模块构成:编码器(Encoder)、语义与细节注入(SDI,Semantic and Detail Infusion)模块以及解码器(Decoder)。
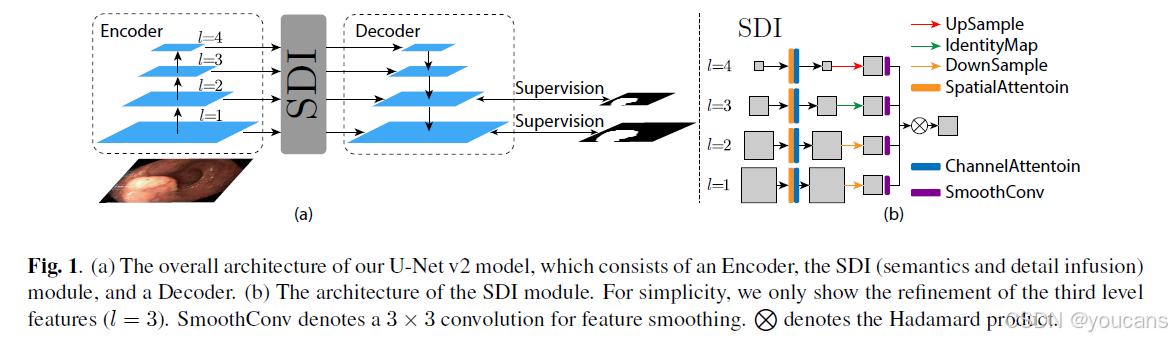
图1:(a) U-Net v2模型的整体架构,包括编码器、SDI(语义和细节融合)模块和解码器。(b) SDI模块的架构。为简化起见,我们仅展示了第三层特征的细化(l=3)。SmoothConv 表示用于特征平滑的3×3卷积。⨂表示哈达玛积(Hadamard)。
给定输入图像 I I I(其中 I ∈ R H × W × C I∈R^{H×W×C} I∈RH×W×C,H、W、C 分别表示图像的高度、宽度与通道数),编码器会生成 M 个层级的特征。我们将第 i i i 层级的特征记为 f i 0 f_i^0 fi0(满足 ≤ i ≤ M ≤i≤M ≤i≤M)。收集到的这些特征(即 { f 1 0 , f 2 0 , . . . , f M 0 } \{f_1^0, f_2^0, ..., f_M^0\} {f10,f20,...,fM0})随后会被传输至 SDI 模块,以进行进一步的优化。
2.2 语义与细节注入(SDI)模块
针对编码器生成的层级化特征图,我们首先对每个第 i i i 层级的特征 f i 0 f_i^0 fi0 应用空间注意力与通道注意力机制 [11]。该过程能使特征同时融合局部空间信息与全局通道信息,其数学表达式如下:

式中,
f
i
1
f_i^1
fi1 代表第
i
i
i 层级经过处理后的特征图;
φ
i
s
φ_i^s
φis 和
ϕ
i
c
ϕ_i^c
ϕic 分别表示第
i
i
i 层级空间注意力与通道注意力的参数。
此外,我们通过 1×1 卷积将
f
i
1
f_i^1
fi1 的通道数降至 c(其中 c 为超参数),得到的特征图记为
f
i
2
f_i^2
fi2,且满足
f
i
2
∈
R
H
i
×
W
i
×
c
f_i^2 ∈R^{H_i×W_i ×c}
fi2∈RHi×Wi×c (Hi、Wi、c 分别代表
f
i
2
f_i^2
fi2 的高度、宽度与通道数)。
接下来需将优化后的特征图传输至解码器。在解码器的每个第 i i i 层级,我们以 f i 2 f_i^2 fi2 作为目标参考,随后调整所有第 j j j 层级特征图的尺寸,使其分辨率与 f i 2 f_i^2 fi2 一致,其数学表达式如下:
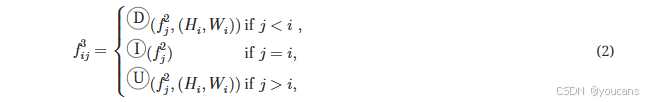
式中,D、I、U 分别表示自适应平均池化(adaptive average pooling)、恒等映射(identity mapping)以及将特征图
f
j
2
f_j^2
fj2
双线性插值(bilinearly interpolating)至
H
i
×
W
i
H_i ×W_i
Hi×Wi 分辨率的操作,其中
i
≤
i
,
j
≤
M
i≤i, j≤M
i≤i,j≤M( i、j 均为介于 1 到 M 之间的层级索引)。
之后,对每个调整尺寸后的特征图 f i j 3 f_{ij}^3 fij3 应用 3×3 卷积以实现平滑处理,其数学表达式如下:

其中, θ i , j θ_{i,j} θi,j 表示平滑卷积的参数, f i , j 4 f_{i,j}^4 fi,j4 是第 i 层中的第 j 个平滑特征图。
在将所有第 i 层特征图调整为相同分辨率后,我们对所有调整后的特征图应用逐元素的哈达玛积运算,以增强第 i 层特征,使其同时包含更丰富的语义信息和更精细的细节,具体计算如下:

其中 H(·) 表示哈达玛积(Hadamard product)运算(参见图1(b))。随后,
f
i
5
f_{i}^5
fi5 被传递至第
i
i
i 层解码器,用于进一步的分辨率重建和分割任务。
3. 实验验证
3.1 数据集
我们使用以下数据集对新提出的U-Net v2模型进行评估:
-
ISIC皮肤病变数据集:采用两个皮肤病变分割数据集——包含2050张皮肤镜图像的ISIC 2017数据集[15,16]和包含2694张皮肤镜图像的ISIC 2018数据集[15]。为公平比较,我们遵循文献[13]所述的训练集/测试集划分策略。
-
息肉分割数据集:使用五个数据集:Kvasir-SEG[17]、ClinicDB[18]、ColonDB[19]、Endoscene[20]和ETIS[21]。为公平比较,采用文献[8]的数据划分策略,具体使用ClinicDB的900张图像和Kvasir-SEG的548张图像作为训练集,其余图像作为测试集。
3.2 实验设置
我们在NVIDIA P100 GPU上使用PyTorch框架进行实验。网络采用Adam优化器进行训练,初始学习率为0.001,β₁=0.9,β₂=0.999。学习率采用多项式衰减策略,衰减指数为0.9。最大训练轮数设置为300轮,超参数c取值为32。
如文献[13]所述,我们在ISIC数据集上报告DSC(戴斯相似系数)和IoU(交并比)得分;在息肉数据集上报告DSC、IoU和MAE(平均绝对误差)得分。每个实验均运行5次,最终报告平均结果。我们采用金字塔视觉Transformer(PVT)[22]作为特征提取的编码器。
3.3 结果与分析
ISIC数据集上的先进方法对比结果如表1所示。数据显示,我们提出的U-Net v2在ISIC 2017和ISIC 2018数据集上分别将DSC指标提升了1.44%和2.48%,IoU指标提升了2.36%和3.90%。这些提升证明了我们提出的语义信息与细节增强方法的有效性。
息肉分割数据集的对比结果如表2所示。我们的U-Net v2在Kavasir-SEG、ClinicDB、ColonDB和ETIS数据集上均优于Poly-PVT[14]方法,DSC指标分别提升1.1%、0.7%、0.4%和0.3%,这进一步验证了所提方法在多层次特征融合中的稳定优势。
3.4 消融实验
我们使用ISIC 2017和ColonDB数据集进行消融实验(结果见表3)。具体而言,采用PVT[22]作为UNet++[5]的编码器。值得注意的是,当移除SDI模块时,U-Net v2即退化为带PVT主干的原始U-Net。SC代表SDI模块中的空间与通道注意力机制。从表3可见,UNet++相较于无SDI的U-Net v2出现轻微性能下降,这可能源于密集连接产生的多级特征简单拼接会引入模型混淆与噪声。实验表明SDI模块对性能提升贡献最大,证明我们提出的跳跃连接设计能持续带来性能改进。
3.5 可视化结果
图2展示了ISIC 2017数据集上的可视化案例,表明U-Net v2能有效融合语义信息与细节特征,使分割模型能够精准捕捉目标边界的细微特征。
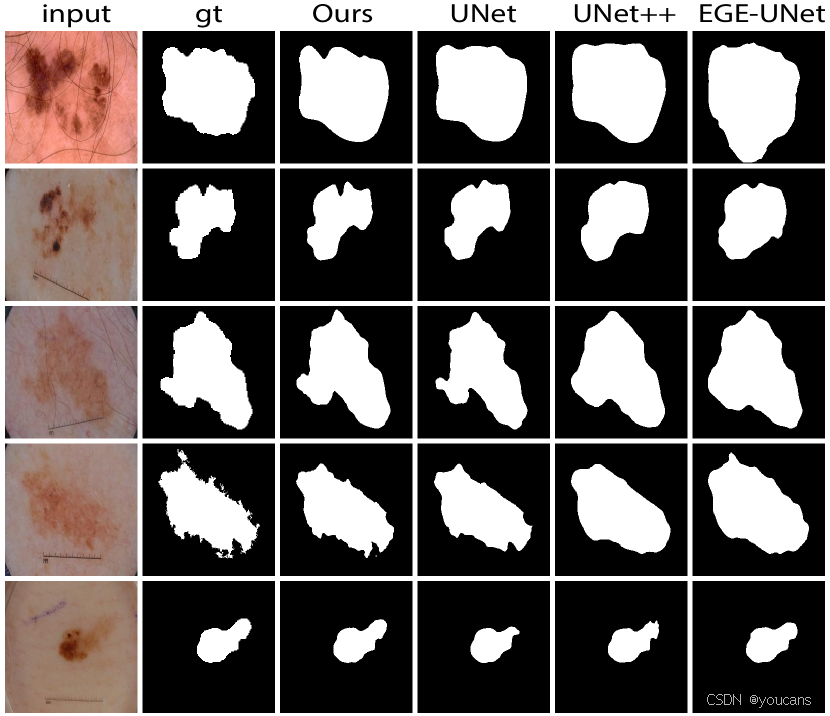
图2:ISIC 2017数据集的示例分割结果。我们使用PVT作为U-Net和UNet++的编码器。
3.6 计算效率与内存分析
为评估计算复杂度、显存占用和推理效率,我们在表4中对比了U-Net v2与U-Net[4]、UNet++[5]的参数量、显存占用、浮点运算量和帧率。实验采用float32数据类型(每个变量占用4字节显存),显存记录包含前向/反向传播中存储的参数和中间变量。(1,3,256,256)表示输入图像尺寸,所有测试均在NVIDIA P100 GPU上进行。
由表4可知,UNet++因密集连接过程中需要存储大量中间特征,导致参数量和显存占用显著增加(中间变量通常比参数消耗更多显存)。而U-Net v2在浮点运算量和帧率方面均优于UNet++,且相较于U-Net (PVT)的帧率下降幅度有限。
4. 结论
本文提出了一种新型U-Net变体——U-Net v2,其通过创新性的跳跃连接设计显著提升了医学图像分割性能。该架构采用哈达玛积运算,将高层特征的语义信息与底层特征的细节信息显式融合到编码器生成的各层级特征图中。在皮肤病变分割和息肉分割数据集上的实验验证了U-Net v2的有效性,复杂度分析表明该模型在浮点运算量和GPU显存使用方面同样具有显著优势。
5. GitHub 项目:U-Net v2 的 PyTorch 实现
5.1 U-Net v2 项目介绍
请确保已按照 requirements.txt 中指定的版本安装所有依赖包。大多数问题都是由包版本不兼容导致的。
import os.path
import warnings

import torch
from torch import nn
from unet_v2.pvtv2 import *
import torch.nn.functional as F


class ChannelAttention(nn.Module):
    def __init__(self, in_planes, ratio=16):
        super(ChannelAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)

        self.fc1 = nn.Conv2d(in_planes, in_planes // 16, 1, bias=False)
        self.relu1 = nn.ReLU()
        self.fc2 = nn.Conv2d(in_planes // 16, in_planes, 1, bias=False)

        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = self.fc2(self.relu1(self.fc1(self.avg_pool(x))))
        max_out = self.fc2(self.relu1(self.fc1(self.max_pool(x))))
        out = avg_out + max_out
        return self.sigmoid(out)


class SpatialAttention(nn.Module):
    def __init__(self, kernel_size=7):
        super(SpatialAttention, self).__init__()

        assert kernel_size in (3, 7), 'kernel size must be 3 or 7'
        padding = 3 if kernel_size == 7 else 1

        self.conv1 = nn.Conv2d(2, 1, kernel_size, padding=padding, bias=False)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = torch.mean(x, dim=1, keepdim=True)
        max_out, _ = torch.max(x, dim=1, keepdim=True)
        x = torch.cat([avg_out, max_out], dim=1)
        x = self.conv1(x)
        return self.sigmoid(x)


class BasicConv2d(nn.Module):
    def __init__(self, in_planes, out_planes, kernel_size, stride=1, padding=0, dilation=1):
        super(BasicConv2d, self).__init__()

        self.conv = nn.Conv2d(in_planes, out_planes,
                              kernel_size=kernel_size, stride=stride,
                              padding=padding, dilation=dilation, bias=False)
        self.bn = nn.BatchNorm2d(out_planes)
        self.relu = nn.ReLU(inplace=True)

    def forward(self, x):
        x = self.conv(x)
        x = self.bn(x)
        return x


class Encoder(nn.Module):
    def __init__(self, pretrain_path):
        super().__init__()
        self.backbone = pvt_v2_b2()

        if pretrain_path is None:
            warnings.warn('please provide the pretrained pvt model. Not using pretrained model.')
        elif not os.path.isfile(pretrain_path):
            warnings.warn(f'path: {pretrain_path} does not exists. Not using pretrained model.')
        else:
            print(f"using pretrained file: {pretrain_path}")
            save_model = torch.load(pretrain_path)
            model_dict = self.backbone.state_dict()
            state_dict = {k: v for k, v in save_model.items() if k in model_dict.keys()}
            model_dict.update(state_dict)

            self.backbone.load_state_dict(model_dict)

    def forward(self, x):
        f1, f2, f3, f4 = self.backbone(x)  # (x: 3, 352, 352)
        return f1, f2, f3, f4


class SDI(nn.Module):
    def __init__(self, channel):
        super().__init__()

        self.convs = nn.ModuleList(
            [nn.Conv2d(channel, channel, kernel_size=3, stride=1, padding=1) for _ in range(4)])

    def forward(self, xs, anchor):
        ans = torch.ones_like(anchor)
        target_size = anchor.shape[-1]

        for i, x in enumerate(xs):
            if x.shape[-1] > target_size:
                x = F.adaptive_avg_pool2d(x, (target_size, target_size))
            elif x.shape[-1] < target_size:
                x = F.interpolate(x, size=(target_size, target_size),
                                      mode='bilinear', align_corners=True)

            ans = ans * self.convs[i](x)

        return ans


class UNetV2(nn.Module):
    """
    use SpatialAtt + ChannelAtt
    """
    def __init__(self, channel=32, n_classes=1, deep_supervision=True, pretrained_path=None):
        super().__init__()
        self.deep_supervision = deep_supervision

        self.encoder = Encoder(pretrained_path)

        self.ca_1 = ChannelAttention(64)
        self.sa_1 = SpatialAttention()

        self.ca_2 = ChannelAttention(128)
        self.sa_2 = SpatialAttention()

        self.ca_3 = ChannelAttention(320)
        self.sa_3 = SpatialAttention()

        self.ca_4 = ChannelAttention(512)
        self.sa_4 = SpatialAttention()

        self.Translayer_1 = BasicConv2d(64, channel, 1)
        self.Translayer_2 = BasicConv2d(128, channel, 1)
        self.Translayer_3 = BasicConv2d(320, channel, 1)
        self.Translayer_4 = BasicConv2d(512, channel, 1)

        self.sdi_1 = SDI(channel)
        self.sdi_2 = SDI(channel)
        self.sdi_3 = SDI(channel)
        self.sdi_4 = SDI(channel)

        self.seg_outs = nn.ModuleList([
            nn.Conv2d(channel, n_classes, 1, 1) for _ in range(4)])

        self.deconv2 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2, padding=1,
                                          bias=False)
        self.deconv3 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)
        self.deconv4 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)
        self.deconv5 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)

    def forward(self, x):
        seg_outs = []
        f1, f2, f3, f4 = self.encoder(x)

        f1 = self.ca_1(f1) * f1
        f1 = self.sa_1(f1) * f1
        f1 = self.Translayer_1(f1)

        f2 = self.ca_2(f2) * f2
        f2 = self.sa_2(f2) * f2
        f2 = self.Translayer_2(f2)

        f3 = self.ca_3(f3) * f3
        f3 = self.sa_3(f3) * f3
        f3 = self.Translayer_3(f3)

        f4 = self.ca_4(f4) * f4
        f4 = self.sa_4(f4) * f4
        f4 = self.Translayer_4(f4)

        f41 = self.sdi_4([f1, f2, f3, f4], f4)
        f31 = self.sdi_3([f1, f2, f3, f4], f3)
        f21 = self.sdi_2([f1, f2, f3, f4], f2)
        f11 = self.sdi_1([f1, f2, f3, f4], f1)

        seg_outs.append(self.seg_outs[0](f41))

        y = self.deconv2(f41) + f31
        seg_outs.append(self.seg_outs[1](y))

        y = self.deconv3(y) + f21
        seg_outs.append(self.seg_outs[2](y))

        y = self.deconv4(y) + f11
        seg_outs.append(self.seg_outs[3](y))

        for i, o in enumerate(seg_outs):
            seg_outs[i] = F.interpolate(o, scale_factor=4, mode='bilinear')

        if self.deep_supervision:
            return seg_outs[::-1]
        else:
            return seg_outs[-1]


if __name__ == "__main__":
    pretrained_path = "/afs/crc.nd.edu/user/y/ypeng4/Polyp-PVT_2/pvt_pth/pvt_v2_b2.pth"
    model = UNetV2(n_classes=2, deep_supervision=True, pretrained_path=None)
    x = torch.rand((2, 3, 256, 256))
    ys = model(x)
    for y in ys:
        print(y.shape)
预训练 PVT 模型:谷歌云盘
- ISIC 分割任务
nnUNet 的预处理数据与原始数据可从 ISIC 2017 和 ISIC 2018 数据集下载。
通过以下命令设置 nnUNet_raw、nnUNet_preprocessed 和 nnUNet_results 环境变量:
export nnUNet_raw=/path/to/input_raw_dir
export nnUNet_preprocessed=/path/to/preprocessed_dir
export nnUNet_results=/path/to/result_save_dir
通过以下命令运行训练与测试:
python /path/to/UNet_v2/run/run_training.py dataset_id 2d 0 --no-debug -tr ISICTrainer --c
- 息肉分割任务
训练数据集可从谷歌云盘下载,测试数据集可从谷歌云盘下载。
通过以下命令运行训练与测试:
python /path/to/UNet_v2/PolypSeg/Train.py
- 适配自定义数据
在我自己的数据集上,仅使用了 4 倍下采样的结果。若需适配你的数据,可能需要修改以下代码:
需修改的代码
f1, f2, f3, f4, f5, f6 = self.encoder(x)

...
f61 = self.sdi_6([f1, f2, f3, f4, f5, f6], f6)
f51 = self.sdi_5([f1, f2, f3, f4, f5, f6], f5)
f41 = self.sdi_4([f1, f2, f3, f4, f5, f6], f4)
f31 = self.sdi_3([f1, f2, f3, f4, f5, f6], f3)
f21 = self.sdi_2([f1, f2, f3, f4, f5, f6], f2)
f11 = self.sdi_1([f1, f2, f3, f4, f5, f6], f1)
需删除的代码
for i, o in enumerate(seg_outs):
    seg_outs[i] = F.interpolate(o, scale_factor=4, mode='bilinear')
删除上述代码后,模型将使用所有分辨率的结果,而非仅使用 4 倍下采样的结果。
5.2 U-Net v2 在训练与测试中的使用示例
以下代码片段展示了如何在训练和测试阶段使用 U-Net v2。
- 训练阶段
from unet_v2.UNet_v2 import *

n_classes=2
pretrained_path="/path/to/pretrained/pvt"
model = UNetV2(n_classes=n_classes, deep_supervision=True, pretrained_path=pretrained_path)

x = torch.rand((2, 3, 256, 256))

ys = model(x)  # ys is a list because of deep supervision
现在您可以使用ys和label计算损失并进行反向传播。
- 测试阶段
model.eval()
model.deep_supervision = False

x = torch.rand((2, 3, 256, 256))
y = model(x)  # y is a tensor since the deep supervision is turned off in the testing phase
print(y.shape)  # (2, n_classes, 256, 256)

pred = torch.argmax(y, dim=1)
为方便使用,U-Net v2 的模型文件已复制至路径 ./unet_v2/UNet_v2.py。
5.3 U-Net v2 关键代码
import os.path
import warnings

import torch
from torch import nn
from unet_v2.pvtv2 import *
import torch.nn.functional as F


class ChannelAttention(nn.Module):
    def __init__(self, in_planes, ratio=16):
        super(ChannelAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)

        self.fc1 = nn.Conv2d(in_planes, in_planes // 16, 1, bias=False)
        self.relu1 = nn.ReLU()
        self.fc2 = nn.Conv2d(in_planes // 16, in_planes, 1, bias=False)

        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = self.fc2(self.relu1(self.fc1(self.avg_pool(x))))
        max_out = self.fc2(self.relu1(self.fc1(self.max_pool(x))))
        out = avg_out + max_out
        return self.sigmoid(out)


class SpatialAttention(nn.Module):
    def __init__(self, kernel_size=7):
        super(SpatialAttention, self).__init__()

        assert kernel_size in (3, 7), 'kernel size must be 3 or 7'
        padding = 3 if kernel_size == 7 else 1

        self.conv1 = nn.Conv2d(2, 1, kernel_size, padding=padding, bias=False)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = torch.mean(x, dim=1, keepdim=True)
        max_out, _ = torch.max(x, dim=1, keepdim=True)
        x = torch.cat([avg_out, max_out], dim=1)
        x = self.conv1(x)
        return self.sigmoid(x)


class BasicConv2d(nn.Module):
    def __init__(self, in_planes, out_planes, kernel_size, stride=1, padding=0, dilation=1):
        super(BasicConv2d, self).__init__()

        self.conv = nn.Conv2d(in_planes, out_planes,
                              kernel_size=kernel_size, stride=stride,
                              padding=padding, dilation=dilation, bias=False)
        self.bn = nn.BatchNorm2d(out_planes)
        self.relu = nn.ReLU(inplace=True)

    def forward(self, x):
        x = self.conv(x)
        x = self.bn(x)
        return x


class Encoder(nn.Module):
    def __init__(self, pretrain_path):
        super().__init__()
        self.backbone = pvt_v2_b2()

        if pretrain_path is None:
            warnings.warn('please provide the pretrained pvt model. Not using pretrained model.')
        elif not os.path.isfile(pretrain_path):
            warnings.warn(f'path: {pretrain_path} does not exists. Not using pretrained model.')
        else:
            print(f"using pretrained file: {pretrain_path}")
            save_model = torch.load(pretrain_path)
            model_dict = self.backbone.state_dict()
            state_dict = {k: v for k, v in save_model.items() if k in model_dict.keys()}
            model_dict.update(state_dict)

            self.backbone.load_state_dict(model_dict)

    def forward(self, x):
        f1, f2, f3, f4 = self.backbone(x)  # (x: 3, 352, 352)
        return f1, f2, f3, f4


class SDI(nn.Module):
    def __init__(self, channel):
        super().__init__()

        self.convs = nn.ModuleList(
            [nn.Conv2d(channel, channel, kernel_size=3, stride=1, padding=1) for _ in range(4)])

    def forward(self, xs, anchor):
        ans = torch.ones_like(anchor)
        target_size = anchor.shape[-1]

        for i, x in enumerate(xs):
            if x.shape[-1] > target_size:
                x = F.adaptive_avg_pool2d(x, (target_size, target_size))
            elif x.shape[-1] < target_size:
                x = F.interpolate(x, size=(target_size, target_size),
                                      mode='bilinear', align_corners=True)

            ans = ans * self.convs[i](x)

        return ans


class UNetV2(nn.Module):
    """
    use SpatialAtt + ChannelAtt
    """
    def __init__(self, channel=32, n_classes=1, deep_supervision=True, pretrained_path=None):
        super().__init__()
        self.deep_supervision = deep_supervision

        self.encoder = Encoder(pretrained_path)

        self.ca_1 = ChannelAttention(64)
        self.sa_1 = SpatialAttention()

        self.ca_2 = ChannelAttention(128)
        self.sa_2 = SpatialAttention()

        self.ca_3 = ChannelAttention(320)
        self.sa_3 = SpatialAttention()

        self.ca_4 = ChannelAttention(512)
        self.sa_4 = SpatialAttention()

        self.Translayer_1 = BasicConv2d(64, channel, 1)
        self.Translayer_2 = BasicConv2d(128, channel, 1)
        self.Translayer_3 = BasicConv2d(320, channel, 1)
        self.Translayer_4 = BasicConv2d(512, channel, 1)

        self.sdi_1 = SDI(channel)
        self.sdi_2 = SDI(channel)
        self.sdi_3 = SDI(channel)
        self.sdi_4 = SDI(channel)

        self.seg_outs = nn.ModuleList([
            nn.Conv2d(channel, n_classes, 1, 1) for _ in range(4)])

        self.deconv2 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2, padding=1,
                                          bias=False)
        self.deconv3 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)
        self.deconv4 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)
        self.deconv5 = nn.ConvTranspose2d(channel, channel, kernel_size=4, stride=2,
                                          padding=1, bias=False)

    def forward(self, x):
        seg_outs = []
        f1, f2, f3, f4 = self.encoder(x)

        f1 = self.ca_1(f1) * f1
        f1 = self.sa_1(f1) * f1
        f1 = self.Translayer_1(f1)

        f2 = self.ca_2(f2) * f2
        f2 = self.sa_2(f2) * f2
        f2 = self.Translayer_2(f2)

        f3 = self.ca_3(f3) * f3
        f3 = self.sa_3(f3) * f3
        f3 = self.Translayer_3(f3)

        f4 = self.ca_4(f4) * f4
        f4 = self.sa_4(f4) * f4
        f4 = self.Translayer_4(f4)

        f41 = self.sdi_4([f1, f2, f3, f4], f4)
        f31 = self.sdi_3([f1, f2, f3, f4], f3)
        f21 = self.sdi_2([f1, f2, f3, f4], f2)
        f11 = self.sdi_1([f1, f2, f3, f4], f1)

        seg_outs.append(self.seg_outs[0](f41))

        y = self.deconv2(f41) + f31
        seg_outs.append(self.seg_outs[1](y))

        y = self.deconv3(y) + f21
        seg_outs.append(self.seg_outs[2](y))

        y = self.deconv4(y) + f11
        seg_outs.append(self.seg_outs[3](y))

        for i, o in enumerate(seg_outs):
            seg_outs[i] = F.interpolate(o, scale_factor=4, mode='bilinear')

        if self.deep_supervision:
            return seg_outs[::-1]
        else:
            return seg_outs[-1]


if __name__ == "__main__":
    pretrained_path = "/afs/crc.nd.edu/user/y/ypeng4/Polyp-PVT_2/pvt_pth/pvt_v2_b2.pth"
    model = UNetV2(n_classes=2, deep_supervision=True, pretrained_path=None)
    x = torch.rand((2, 3, 256, 256))
    ys = model(x)
    for y in ys:
        print(y.shape)
6. 参考文献
[1] Jonathan Long, Evan Shelhamer, and Trevor Darrell, “Fully convolutional networks for semantic segmentation,” in IEEE CVPR, 2015, pp. 3431–3440.
[2] Hengshuang Zhao, Jianping Shi, Xiaojuan Qi, Xiaogang Wang, and Jiaya Jia, “Pyramid scene parsing network,” in CVPR, 2017, pp. 2881–2890.
[3] Shu Liu, Lu Qi, Haifang Qin, Jianping Shi, and Jiaya Jia, “Path aggregation network for instance segmentation,” in CVPR, 2018, pp. 8759–8768.
[4] Olaf Ronneberger, Philipp Fischer, and Thomas Brox, “U-Net: Convolutional networks for biomedical image segmentation,” in MICCAI, Proceedings, Part III. Springer, 2015, pp. 234–241.
[5] Zongwei Zhou, Md Mahfuzur Rahman Siddiquee, Nima Tajbakhsh, and Jianming Liang, “UNet++: A nested UNet architecture for medical image segmentation,” in DLMIA 2018. Springer, 2018, pp. 3–11.
[6] Jiawei Zhang, Yuzhen Jin, Jilan Xu, Xiaowei Xu, and Yanchun Zhang, “MDU-Net: Multi-scale densely connected U-Net for biomedical image segmentation,” arXiv preprint arXiv:1812.00352, 2018.
[7] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun, “Deep residual learning for image recognition,” in CVPR, 2016, pp. 770–778.
[8] Deng-Ping Fan, Ge-Peng Ji, Tao Zhou, Geng Chen, Huazhu Fu, Jianbing Shen, and Ling Shao, “PraNet: Parallel reverse attention network for polyp segmentation,” in MICCAI. Springer, 2020, pp. 263–273.
[9] Jun Wei, Yiwen Hu, Ruimao Zhang, Zhen Li, S Kevin Zhou, and Shuguang Cui, “Shallow attention network for polyp segmentation,” in MICCAI, Proceedings, Part I 24. Springer, 2021, pp. 699–708.
[10] Yundong Zhang, Huiye Liu, and Qiang Hu, “Trans-Fuse: Fusing Transformers and CNNs for medical image segmentation,” in MICCAI, Proceedings, Part I 24. Springer, 2021, pp. 14–24.
[11] Sanghyun Woo, Jongchan Park, Joon-Young Lee, and In So Kweon, “CBAM: Convolutional block attention module,” in ECCV, 2018, pp. 3–19.
[12] Jiacheng Ruan, Suncheng Xiang, Mingye Xie, Ting Liu, and Yuzhuo Fu, “MALUNet: A multi-attention and light-weight UNet for skin lesion segmentation,” in BIBM. IEEE, 2022, pp. 1150–1156.
[13] Jiacheng Ruan, Mingye Xie, Jingsheng Gao, Ting Liu, and Yuzhuo Fu, “EGE-UNet: An efficient group enhanced UNet for skin lesion segmentation,” arXiv preprint arXiv:2307.08473, 2023.
[14] Bo Dong, Wenhai Wang, Deng-Ping Fan, Jinpeng Li, Huazhu Fu, and Ling Shao, “Polyp-PVT: Polyp segmentation with Pyramid Vision Transformers,” arXiv preprint arXiv:2108.06932, 2021.
[15] Noel Codella, Veronica Rotemberg, Philipp Tschandl, M Emre Celebi, Stephen Dusza, David Gutman, Brian Helba, Aadi Kalloo, Konstantinos Liopyris, Michael Marchetti, et al., “Skin lesion analysis toward melanoma detection 2018: A challenge hosted by the International Skin Imaging Collaboration (ISIC),” arXiv preprint arXiv:1902.03368, 2019.
[16] Matt Berseth, “ISIC 2017-skin lesion analysis towards melanoma detection,” arXiv preprint arXiv:1703.00523, 2017.
[17] Debesh Jha, Pia H Smedsrud, Michael A Riegler, P˚al Halvorsen, Thomas de Lange, Dag Johansen, and H˚avard D Johansen, “Kvasir-SEG: A segmented polyp dataset,” in MMM, Part II 26, 2020, pp. 451–462.
[18] Jorge Bernal, F Javier S´anchez, Gloria Fern´andez-Esparrach, Debora Gil, Cristina Rodr´ıguez, and Fernando Vilari˜no, “WM-DOVA maps for accurate polyp highlighting in colonoscopy: Validation vs. saliency maps from physicians,” CMIG, vol. 43, pp. 99–111, 2015.
[19] Nima Tajbakhsh, Suryakanth R Gurudu, and Jianming Liang, “Automated polyp detection in colonoscopy videos using shape and context information,” TMI, vol. 35, no. 2, pp. 630–644, 2015.
[20] David V´azquez, Jorge Bernal, F Javier S´anchez, Gloria Fern´andez-Esparrach, Antonio M L´opez, Adriana Romero, Michal Drozdzal, Aaron Courville, et al., “A benchmark for endoluminal scene segmentation of colonoscopy images,” Journal of Healthcare Engineering, vol. 2017, 2017.
[21] Juan Silva, Aymeric Histace, Olivier Romain, Xavier Dray, and Bertrand Granado, “Toward embedded detection of polyps in WCE images for early diagnosis of colorectal cancer,” Journal of CARS, vol. 9, pp. 283–293, 2014.
[22] Wenhai Wang, Enze Xie, Xiang Li, Deng-Ping Fan, Kaitao Song, Ding Liang, Tong Lu, Ping Luo, and Ling Shao, “Pyramid Vision Transformer: A versatile backbone for dense prediction without convolutions,” in IEEE/CVF CVPR, 2021, pp. 568–578.
引用格式: Y. Peng, D. Z. Chen and M. Sonka, “U-Net V2: Rethinking the Skip Connections of U-Net for Medical Image Segmentation,” 2025 IEEE 22nd International Symposium on Biomedical Imaging (ISBI), Houston, TX, USA, 2025, pp. 1-5, doi: 10.1109/ISBI60581.2025.10980742.
版权说明:
youcans@xidian 作品,转载必须标注原文链接:
【youcans论文精读】U-Net v2:重新思考医学图像分割中 U-Net 的跳跃连接(https://youcans.blog.csdn.net/article/details/155301263)
Crated:2025-11


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 13
 0
- 0


 已为社区贡献60条内容

所有评论(0)