【论文阅读】Do As I Can, Not As I Say:Grounding Language in Robotic Affordances
1. 一句话总结
将机器人接入LLMs(大语言模型),让机器人做为LLMs的眼睛和操作手,让LLMs提供关于任务的语义;通过预训练skill库,使LLMs具备和真实世界交互的能力。
2. 核心问题
问题定义
语言模型输出对于现实机器人来说,不可行也无用。
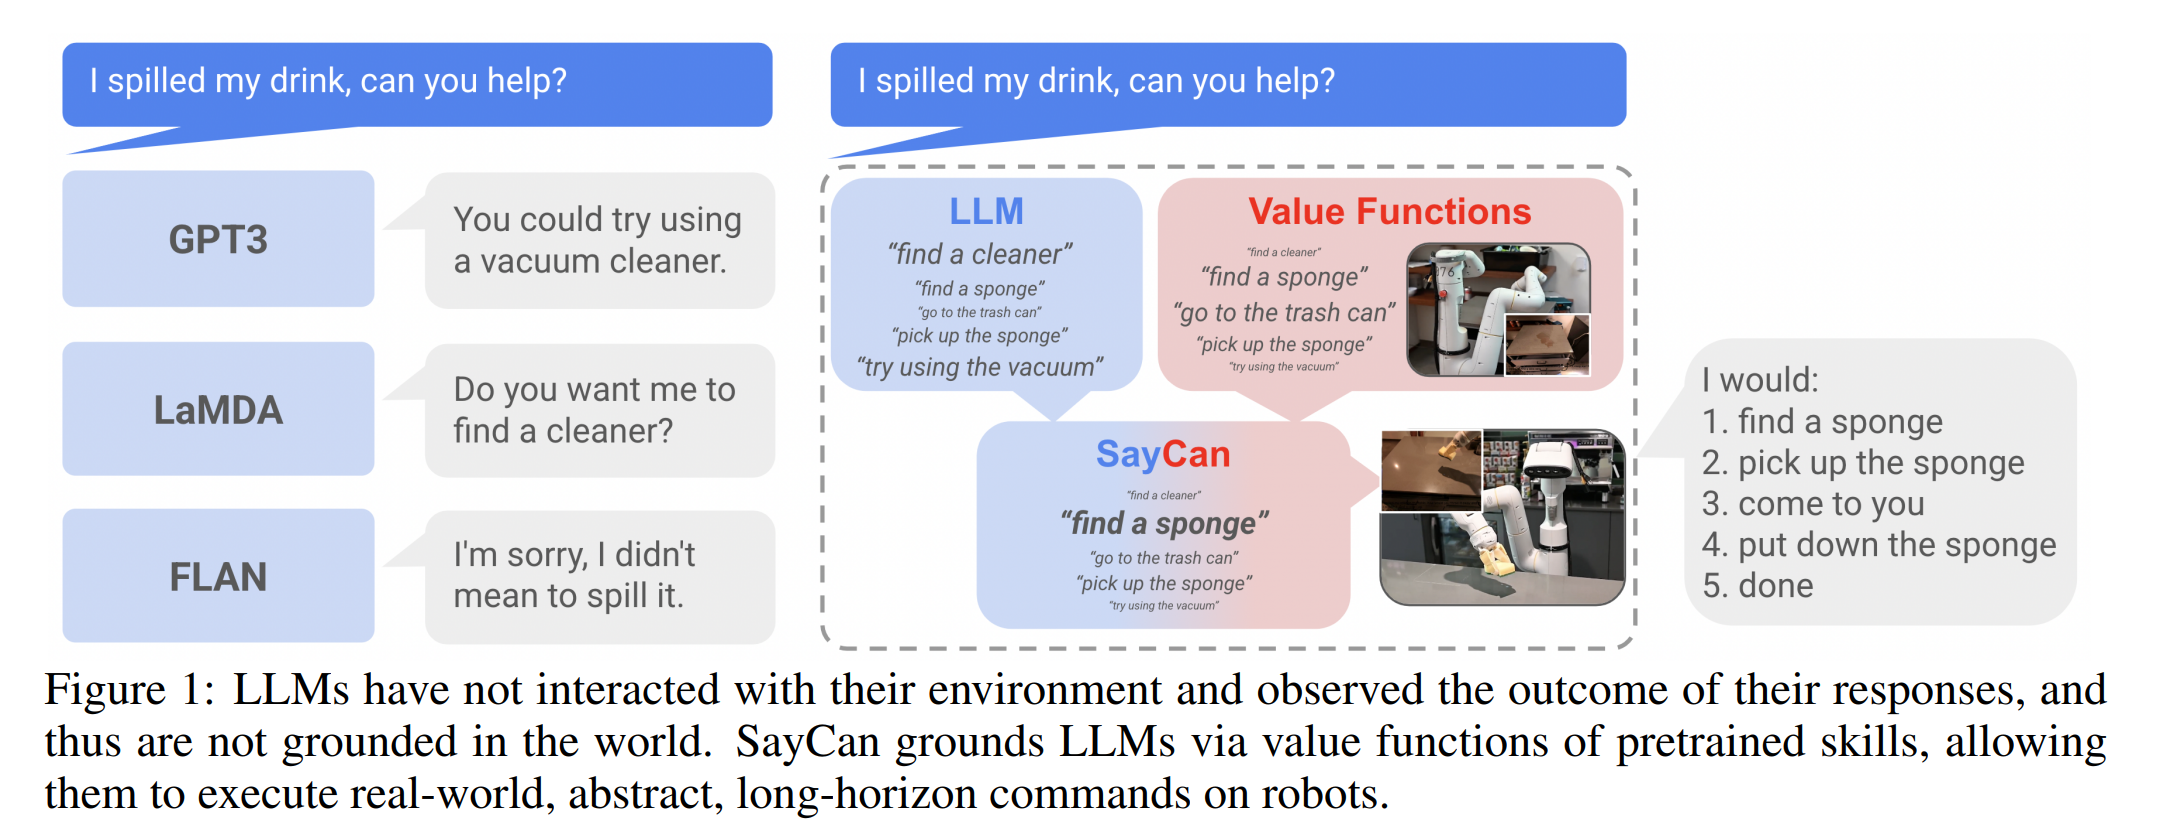
图 1 举了一个例子——一个厨房机器人能够执行诸如“捡起海绵”或“去桌子旁”等技能,可能会被请求帮忙清理洒出的液体(“我洒了饮料,你能帮忙吗?”)。 语言模型可能会用一个合理的叙述回应,但这对机器人来说既不可行也无用。如果场景中没有吸尘器,或者机器人无法使用吸尘器,“你可以试试吸尘器”是不可能的。 通过提示工程,LLM或许能够将高阶指令拆分为子任务,但如果没有描述机器人能力、机器人现状 以及 环境信息的上下文,它是无法做到的。
问题描述
我们的系统接收用户提供的自然语言指令 i 描述机器人应执行的任务。指令可以很长、抽象或含糊。我们还假设自己被赋予一套技能 Π,其中每个技能 π∈Π 执行一个简短的任务,比如拾取某个特定物品,并附有简短的语言描述 ℓπ (例如,“找一块海绵”)以及一个 affordable 函数 p(cπ|s,ℓπ), 表示 的概率 c-用描述来完成技能 ℓπ 成功从国家 s. 直观地说, p(cπ|s,ℓπ) 意思是“如果我让机器人做 ℓπ,能行吗?” 用现实学习的术语来说, p(cπ|s,ℓπ) 如果我们取奖励为,则是技能的价值函数。 1 成功完成且 0 否则。
3. 核心方法
受该例子启发,我们研究如何提取大型语言模型中的知识,使具身智能体(如机器人)能够遵循高级文本指令。 该机器人配备了一套能够进行低级别视觉运动控制的“原子”行为技能。 我们利用这样一个事实:除了让LLM仅仅解释指令外,我们还能用它来评估某个技能在完成高级教学过程中进展的可能性。 然后,如果每个技能都有一个 affordable 函数,量化其从当前状态成功的可能性(例如学习的价值函数),那么其价值可以用来加权该技能的概率。 这样,LLM描述每个技能对完成指令的贡献概率,而赋性函数描述每个技能成功的概率——两者结合即可获得每个技能执行指令的概率 成功. 赋能函数使LLM能够感知当前场景,而将完成任务限制在技能描述内则使LLM能够了解机器人的能力。 此外,这种组合还会形成一个完全可解释的步骤序列,机器人将执行以完成指令——通过语言表达的可解释计划。
核心方法
我们的方法SayCan提取并利用LLMs中的知识,应用于物理化任务。 LLM(Say)为高层次目标提供任务基础,以确定有用的行动,而学习的可赋函数(Can)则为确定计划可执行的内容提供了世界基础。
讲人话就是:大模型讲的话是没有结合实际的,学习了affordable函数(就是评估这件事到底能不能做)之后的大模型讲的话就是结合实际的了。
怎么评估这件事到底能不能做成功呢,需要结合机器人的能力、现状以及环境信息来评。
我们使用强化学习(RL)来学习语言条件值函数,这些函数为世界的可能性提供了可预见。 我们对101个现实世界机器人任务进行了评估该方法 这些项目涉及移动机器人在真实厨房中以零次方式完成大量语言指令。 我们的实验验证了 SayCan 能够执行时间延伸的抽象指令。通过赋能性将LLM扎根于现实世界,几乎使性能是非基础基线的两倍。 此外,通过用不同的大型语言模型评估系统性能,我们表明仅通过增强底层语言模型即可提升机器人性能。
4. 效果
在模拟厨房中,PaLM-SayCan实现了84%的规划成功率和74%的执行率。 我们还会在实验室环境外和实际厨房中对PaLM-SayCan进行测试,以验证策略和价值函数在该环境中的性能。我们发现规划绩效下降了3%,执行下降了14%。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)