【三维感知目标检测论文阅读】《VoxelNeXt: Fully Sparse VoxelNet for 3D Object Detection and Tracking》
作为纯激光雷达3D目标检测的收尾,今天我带来的论文是《VoxelNeXt: Fully Sparse VoxelNet for 3D Object Detection and Tracking》。VoxelNeXt代表了近年来纯稀疏网络架构的趋势。它挑战了“必须将稀疏特征转换为密集特征图,并依赖于锚框或中心点等代理来进行预测”的普遍做法。它摒弃了传统的密集预测头和非极大值抑制(NMS)后处理,构建了一个端到端的、完全稀疏的检测框架,设计思想简洁而高效,是探索未来检测器架构演进方向的重要参考。
论文链接:VoxelNeXt: Fully Sparse VoxelNet for 3D Object Detection and Tracking
1. 论文概述 (Overview)
VoxelNeXt 提出了一种全稀疏(fully sparse)的3D物体检测和追踪框架 。其核心思想是,抛弃所有手工设计的代理(如锚框、中心点)和复杂的稀疏到密集(sparse-to-dense)转换步骤,直接基于稀疏的体素特征来预测物体 。
为此,论文构建了一个强大的稀疏卷积网络,它能够以一种端到端稀疏的方式完成检测任务 。这种设计的优越性体现在:
-
简洁高效:整个流程无需区域提案网络(RPN)、密集的预测头,甚至摆脱了非极大值抑制(NMS)后处理 。
-
性能优越:在nuScenes、Waymo和Argoverse2等多个大规模数据集上,VoxelNeXt在检测和追踪任务中均取得了顶尖的性能,尤其是在nuScenes追踪基准上排名第一 。
-
更好的速精平衡:相比于以CenterPoint为代表的密集头检测器,VoxelNeXt在精度相当甚至更高的情况下,计算成本(尤其是预测头的计算量)大幅降低,实现了更优的速度-精度权衡 。
这篇论文首次证明了,一个全稀疏的体素框架足以胜任高精度的LiDAR 3D物体检测与追踪任务 。
2. 背景与动机:对“密集”预测头的反思
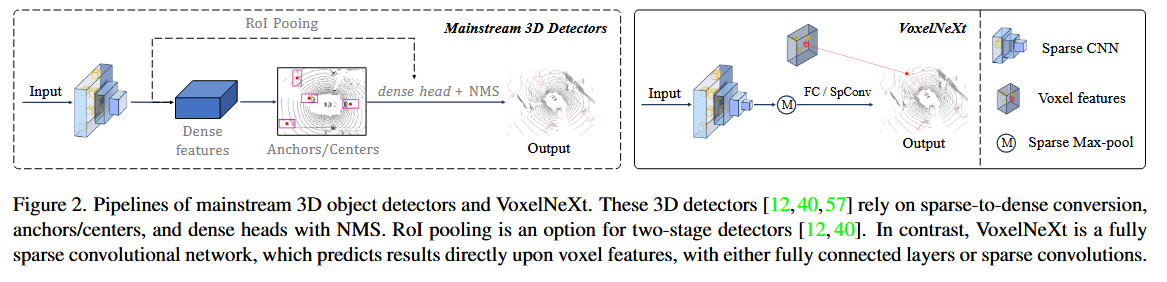
当时主流的3D检测器(如SECOND, PointPillars, PV-RCNN, CenterPoint)虽然强大,但大多遵循一个共同的范式:
-
使用稀疏卷积网络(Sparse CNN)提取3D特征。
-
将稀疏的3D特征转换并压实成一个密集的2D鸟瞰图(BEV)特征图 。
-
在一个密集的预测头上,利用锚框(anchors)或中心点(centers)等代理来预测物体 。
这种范式的核心问题在于效率低下和流程复杂:
-
计算浪费:论文通过可视化CenterPoint的热力图(Heatmap)指出,在密集的BEV特征图上,绝大多数区域的预测值都接近于零(背景),但密集卷积头却需要对所有位置进行计算,造成了巨大的计算浪费 。
-
流程冗余:由于密集预测会产生大量重叠的检测框,必须依赖NMS等复杂的后处理步骤来筛选结果,这使得整个检测流程不够简洁优雅 。
VoxelNeXt的动机正是要打破这一传统,探索一个真正从头到尾都保持稀疏的检测方案,从而解决上述问题 。
3. VoxelNeXt 模型详解
VoxelNeXt的核心在于对一个标准的稀疏CNN网络进行最少的改造,使其能够直接从稀疏体素进行预测。其流程如下图所示,比主流检测器大大简化 。
3.1. 对稀疏主干网络的改造 (Sparse CNN Backbone Adaptation)
为了让稀疏网络有足够强的能力直接进行预测,论文做了以下几点关键改造:
-
增加下采样层以扩大感受野:标准稀疏主干网络通常有4个下采样阶段(最深层特征的步长为8)。作者发现,这不足以为直接预测提供足够的上下文信息,尤其是对大物体 。VoxelNeXt的解决方案非常简单:额外增加两个下采样层,获得步长为16和32的更深层特征 。通过将最后三个阶段的特征(步长8, 16, 32)上采样到同一分辨率并进行稀疏拼接,每个体素的有效感受野(ERF)被显著扩大,使其能够“看到”更大的范围,从而有能力从单个体素特征预测整个物体 。
-
稀疏高度压缩 (Sparse Height Compression):为了提高效率,模型可以将3D稀疏特征压缩到2D。不同于主流方法将特征“压实”成密集图,VoxelNeXt采用全稀疏的方式:直接将所有3D体素“投影”到x-y地平面上,并对落在同一2D位置的体素特征进行求和 。这个操作非常高效,耗时不到1毫秒 。
-
空间体素剪枝 (Spatially Voxel Pruning):在网络下采样过程中,为了进一步减少对背景点的计算,模型会根据特征的幅度,逐步地剪除那些不重要的体素,只对特征响应强的体素进行后续的扩张和卷积计算 。
3.2. 稀疏预测头 (Sparse Prediction Head)
这是VoxelNeXt的预测核心,完全基于稀疏特征进行。
-
体素选择 (Voxel Selection):网络首先为每个非空体素预测一个分类分数 。在训练时,距离真值框中心最近的体素被指定为正样本 。
-
稀疏最大池化 (Sparse Max Pooling - 无需NMS):在推理时,为了取代传统的NMS,VoxelNeXt使用了一个巧妙的稀疏最大池化层 。该操作只在非空的体素位置上进行,高效地选出每个局部区域内得分最高的体素作为最终的“查询体素”(query voxel),从而自然地移除了冗余预测,使得整个流程无需NMS后处理 。
-
边界框回归 (Box Regression):对于每个被选中的查询体素,网络直接从其特征向量中回归出边界框的各项属性(如相对位置、尺寸、朝向、速度等)。
3.3. 对3D追踪的扩展 (Extension to 3D Tracking)
VoxelNeXt的框架可以很自然地扩展到3D追踪任务。之前的方法(如CenterPoint)通常是追踪预测出的物体中心点,但预测出的中心可能存在偏差。
VoxelNeXt提出了体素关联(Voxel Association)的方案 。除了追踪预测的中心点外,它还记录并追踪每个预测框所对应的查询体素的位置 。因为查询体素是真实存在的输入数据,其位置信息比模型预测的中心点更可靠,从而为帧间匹配提供了更鲁棒的依据 。实验证明,这种方法显著提升了追踪性能 。
4. 关键发现与实验结果
-
预测不依赖于中心点:论文的一个重要发现是,负责预测物体的查询体素通常不在物体中心 。统计显示(表7),只有不到10%的框是由靠近中心的体素预测的 。大部分预测来自于物体边界附近,甚至对于行人这样的小物体,预测体素常常在物体之外 。这一发现有力地挑战了以中心点为核心的检测范式,并证明了VoxelNeXt直接从任何信息丰富的体素进行预测的合理性。
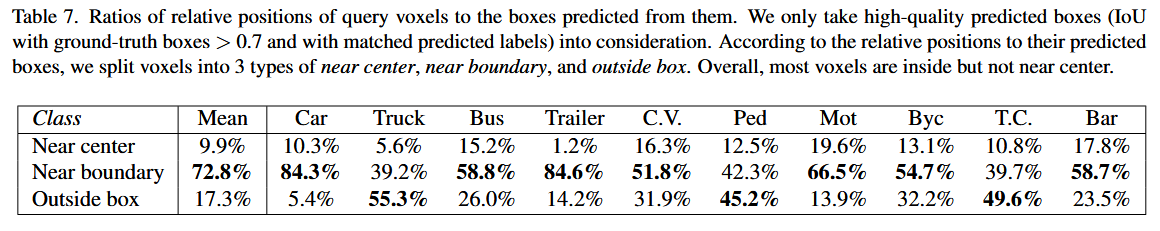
表7:查询体素的相对位置与其预测方框的比率
-
性能与效率:
-
VoxelNeXt的预测头计算量极小(5.1G FLOPs),远低于CenterPoint的123.7G FLOPs,而mAP和NDS指标更高 。
-
在nuScenes、Waymo和Argoverse2等多个基准测试中,VoxelNeXt都取得了领先的检测性能,同时保持了高效率 。
-
在nuScenes 3D追踪任务上,VoxelNeXt在所有只使用LiDAR的方法中排名第一 。
-
5. 总结 (Conclusion)
VoxelNeXt是一篇具有开创性的论文,它成功地构建了一个全稀疏的3D检测与追踪框架。通过对稀疏主干网络的简单增强和精巧的稀疏预测头设计,它证明了手工代理(锚框/中心点)和复杂的密集头并非3D检测的必需品 。VoxelNeXt的框架更简洁、更高效,且性能卓越,为3D感知领域提供了一个优雅且强大的新范式。
纯激光雷达的方法到这里就暂时告一段落,下一篇文章,我将带领大家探索如何融合相机提供的丰富纹理和颜色信息,以应对激光雷达稀疏性带来的挑战,并提升检测的鲁棒性

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 13
 0
- 0


 已为社区贡献3条内容

所有评论(0)