【三维感知目标检测论文阅读】《SECOND:Sparsely Embedded Convolutional Detectio》
在读完前两篇综述后,我们可以正式深入研究3D目标检测领域。首先我们聚焦于纯激光雷达的3D目标检测方法,建立对点云处理和网络结构的基础认知。今天我带来的论文是《SECOND: Sparsely Embedded Convolutional Detection》 (2018年)。作为早期基于体素(Voxel)方法的代表作之一,SECOND引入了稀疏卷积的概念,有效解决了3D卷积在处理稀疏点云时计算量过大的问题。理解SECOND是掌握后续Voxel-based方法的基础。
论文链接:SECOND:Sparsely Embedded Convolutional Detectio
1. 论文概述 (Overview)
SECOND 提出了一种新颖的3D物体检测框架,它主要面向自动驾驶等应用场景中的LiDAR点云数据 。该框架的核心思想是充分利用点云数据的稀疏性。传统3D卷积网络在处理体素化后的点云时,会将大量没有点云的空白区域也纳入计算,导致巨大的计算浪费 。SECOND通过引入和改进稀疏卷积网络,显著提升了模型的训练和推理速度 。
此外,论文还针对3D检测中的具体挑战,提出了两大创新:
-
新的角度损失函数 (Angle Loss):用于更精确地回归物体的朝向 。
-
新的数据增强方法 (Data Augmentation):通过在训练时智能地“粘贴”物体,加快模型收敛并提升性能 。
最终,该方法在当时的KITTI 3D物体检测基准上取得了顶尖的成果,同时保持了非常快的推理速度 。
2. 背景与动机 (Background & Motivation)
3D物体检测是自动驾驶和机器人视觉的关键技术 。与2D图像相比,LiDAR点云能提供精确的深度和空间信息 。当时的3D检测方法主要有几类,但各有缺陷:
-
基于视图的方法 (View-Based Methods):将点云投影为鸟瞰图(BEV)或前视图 。这种方法的缺点是会丢失大量的高度信息,影响3D边界框回归的准确性 。
-
基于3D卷积的方法 (3D-Based Methods):如VoxelNet ,将点云划分为体素网格,然后使用3D卷积网络进行特征提取 。这种方法能更好地保留3D空间信息,但最大的问题是计算量巨大,因为3D卷积的计算复杂度随分辨率成立方增长 ,难以实现实时应用 。
-
基于点的方法 (Point-Based Methods):如PointNet ,直接处理原始点云。但这类方法通常难以处理大规模场景的点云,需要先用2D检测结果进行过滤 。
SECOND的动机正是在VoxelNet等方法的启发下,解决3D卷积的效率瓶颈 ,同时优化检测精度,特别是长期困扰3D检测的朝向估计问题 。
3. SECOND 模型详解 (The SECOND Detector)
SECOND检测器的整体架构如下图所示,主要包含三个部分:体素特征提取器 (Voxel Feature Extractor)、稀疏卷积中间层 (Sparse Convolutional Middle Layer) 和 区域提议网络 (Region Proposal Network, RPN) 。
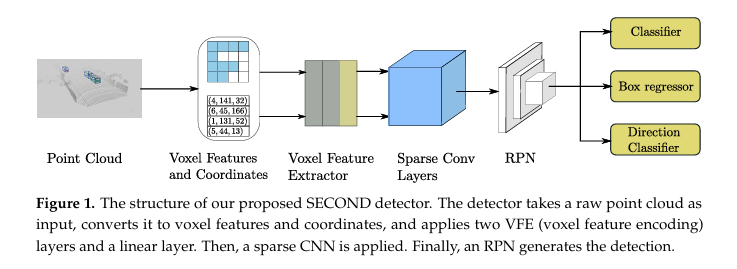
3.1. 点云处理与体素特征提取 (Voxelization & VFE)
-
点云分组 (Grouping):首先,将限定范围内的点云进行裁剪 。然后,将裁剪后的点云空间划分为一个个离散的3D网格,即体素(Voxel) 。遍历所有点,将它们分配到各自所属的体素中 。这个过程会生成体素的坐标和每个体素内的点云数据 。由于LiDAR点云非常稀疏,绝大多数体素是空的 。
-
体素特征提取 (VFE):对于每个非空体素,使用一个体素特征编码(VFE)层来学习其内部特征 。一个VFE层包含一个全连接网络(FCN),它会对体素内的每个点进行特征提取,然后通过**元素级最大池化(Element-wise Max Pooling)**将所有点的特征聚合成一个代表该体素的全局特征 。SECOND中通常使用两个VFE层和一个额外的FCN层来增强特征表达能力 。
3.2. 稀疏卷积中间层 (Sparse Convolutional Middle Extractor)
这是SECOND模型的核心创新所在。该层负责处理VFE输出的稀疏体素特征,并将其降维成类似鸟瞰图的2D特征图 。
-
什么是稀疏卷积? 稀疏卷积是一种特殊的卷积操作,它只在存在有效输入数据(即非空体素)的位置进行计算,并生成输出 。由于LiDAR点云体素化后99%以上的区域都是空的 ,使用稀疏卷积可以跳过对这些空白区域的无效计算,从而极大地提升效率。
-
SECOND的改进:
-
架构设计:该中间层由多个稀疏卷积块组成(图3中的黄框和白框)。它交替使用两种稀疏卷积:子流形卷积 (Submanifold Convolution),它保持输出的稀疏结构不变 ;以及普通稀疏卷积 (Normal Sparse Convolution),它用于降低空间维度(主要是高度Z轴) 。
-
GPU规则生成算法:稀疏卷积的效率瓶颈在于如何快速地找到输入和输出位置的对应关系(即生成“规则”)。传统方法基于CPU和哈希表,速度慢且涉及CPU-GPU数据传输 。SECOND设计了一个完全基于GPU的并行化规则生成算法(图2下半部分) ,它通过并行收集、去重和查找,显著加快了稀疏卷积的运算速度 。实验表明,其实现比当时主流的
SparseConvNet库快得多 。
-
-
从稀疏到稠密:在通过稀疏卷积将特征图的高度维度压缩到1或2之后,网络会将稀疏的3D张量转换为一个稠密的2D特征图 ,然后将其输入到下游的RPN网络中 。
3.3. 区域提议网络 (Region Proposal Network - RPN)
SECOND的RPN借鉴了SSD(Single Shot MultiBox Detector)的设计 。它接收来自中间层的2D特征图作为输入,并负责预测最终的物体边界框 。
-
架构:该RPN包含三个阶段,每个阶段都由多个卷积层构成 。网络首先对特征图进行下采样,然后在不同尺度的特征图上进行预测,最后通过上采样将不同尺度的预测结果拼接(Concatenate)起来,形成一个统一的特征图 。
-
输出:最后,通过三个并行的1x1卷积,分别预测每个预设锚点(Anchor)的:
-
类别 (Class):是前景(如车)还是背景。
-
边界框回归参数 (Box Regression):包括中心点(x, y, z)、尺寸(w, l, h)和朝向(theta)共7个值 。
-
方向 (Direction):物体是朝前还是朝后 。
-
4. 核心贡献与创新点 (Core Contributions)
4.1. 创新的角度损失函数 (Sine-Error Loss for Angle)
3D物体的朝向估计一直是个难题。之前的方法存在问题:例如,直接回归角度值时,一个预测框的方向与真值正好相反(如角度差为pi),这时的IoU(交并比)其实是完全一样的,但模型会收到一个巨大的惩罚,导致学习不稳定 。
SECOND提出了一种优雅的解决方案:正弦误差损失 (Sine-Error Loss) 。 Lθ=SmoothL1(sin(θprediction−θtarget)) 这个损失函数的巧妙之处在于:
-
解决了0度和180度歧义:当角度差为0或pi(180度)时,sin(0)和sin(pi)都等于0,因此损失都为0,模型不会再被错误地惩罚 。
-
解决了方向模糊:由于sin(x)无法区分正向和反向(例如,sin(0.1)和sin(pi+0.1)的绝对值相同但符号相反),作者额外增加了一个辅助方向分类器,用一个简单的分类损失来判别物体的朝向是正是反 。
实验证明,这种方法比当时其他角度编码方式(如AVOD中的矢量编码)性能更优 。
4.2. 创新的数据增强方法 (Ground-Truth Sampling)
LiDAR训练数据中,一个场景里的物体(Ground Truths)数量往往很少,这限制了模型的学习效率和最终性能 。
为此,SECOND提出了一种非常实用的数据增强策略:
-
建立数据库:首先,遍历整个训练集,将所有真实物体(连同其内部的点云数据)单独提取出来,建立一个“物体数据库” 。
-
随机采样与粘贴:在训练时,从这个数据库中随机挑选若干个物体,并将它们“粘贴”到当前正在训练的点云场景中 。
-
碰撞检测:为了避免生成不真实的场景(如物体互相重叠),在粘贴后会进行碰撞检测,移除那些与其他物体发生碰撞的采样物体 。
这种方法极大地增加了每个训练场景中的物体数量和多样性,让模型学习得更快、更好 。从训练曲线(图7)可以看出,使用该方法后,模型的收敛速度和最终性能都得到了显著提升 。
5. 实验与结果 (Experiments & Results)
-
数据集:论文在自动驾驶领域最权威的 KITTI 数据集上进行了评估 。
-
性能:在KITTI测试集的3D检测任务中,SECOND(仅使用LiDAR)的性能全面超越了之前的标杆VoxelNet,并且在“简单”和“中等”难度下优于许多融合了图像数据的方法(如AVOD-FPN) 。
-
速度:得益于稀疏卷积的优化,SECOND的速度优势巨大。其大模型在GTX 1080 Ti上推理耗时仅为0.05秒 (20 FPS),小模型更是达到了0.025秒 (40 FPS) ,远快于VoxelNet的0.23秒 。这使得它能够轻松满足实时应用的需求。
-
消融实验 (Ablation Studies):
-
角度损失:实验证明,论文提出的
Sine-Error损失函数在各项指标上均优于基线方法 。 -
数据增强:对比实验清晰地显示,使用“真值采样”数据增强后,模型的收敛速度和最终AP(平均精度)都有了大幅提升 。
-
6. 总结 (Conclusion)
《SECOND》是一篇在3D物体检测领域具有重要影响力的论文。它精准地抓住了当时基于体素的3D检测方法的核心痛点——计算效率,并通过引入和优化稀疏卷积,提供了一个高效且高精度的解决方案。同时,它在角度回归和数据增强方面的创新也极具实用价值,对后续研究产生了深远影响。
尽管该方法在行人和自行车等小物体上的检测性能仍有提升空间 ,但它为如何在保持高精度的前提下实现实时LiDAR 3D检测指明了清晰的方向。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 16
 0
- 0


 已为社区贡献3条内容

所有评论(0)