[论文阅读] 人工智能 | 为什么你的语言模型成了“蹩脚”的隐式奖励模型?——揭秘两种奖励模型的泛化差距
为什么你的语言模型成了“蹩脚”的隐式奖励模型?——揭秘两种奖励模型的泛化差距
Why is Your Language Model a Poor Implicit Reward Model?
arXiv:2507.07981
Why is Your Language Model a Poor Implicit Reward Model?
Noam Razin, Yong Lin, Jiarui Yao, Sanjeev Arora
Subjects: Computation and Language (cs.CL); Artificial Intelligence (cs.AI); Machine Learning (cs.LG); Machine Learning (stat.ML)
研究背景:奖励模型的“双胞胎谜题”
想象一下,你正在训练两个智能助手,它们用几乎相同的“大脑”(基础语言模型),学的是同样的“教材”(训练数据),甚至连作业评分标准(损失函数)都一样。但奇怪的是,一个总能在新场景中给出靠谱的判断,另一个却常常“抓不住重点”——这就是语言模型奖励模型领域的“双胞胎谜题”。
在AI领域,奖励模型就像智能助手的“评分老师”,负责给生成的回答打分,指导模型变得更智能。目前有两种主流的“评分老师”:
- 显式奖励模型(EX-RMs):先让语言模型理解输入(得到“隐藏表示”),再用一个专门的“评分公式”(线性头)计算分数。
- 隐式奖励模型(IM-RMs):直接用语言模型对回答的“置信度”(对数概率)作为分数,不用额外的评分公式。
按理说,这两种模型“出身”相似,表现应该差不多。但实际情况是,IM-RMs在面对新场景(比如换种表达方式的同个问题)时,评分准确率常常不如EX-RMs。这个“泛化差距”一直是个未解之谜,而这篇论文就瞄准了这个问题。
主要作者及单位信息
- Noam Razin、Yong Lin、Sanjeev Arora:普林斯顿大学语言与智能实验室(Princeton Language and Intelligence)
- Jiarui Yao:伊利诺伊大学厄巴纳-香槟分校(University of Illinois Urbana-Champaign)
创新点:拨开“泛化差距”的迷雾
这篇论文的最大亮点在于精准定位了IM-RMs泛化能力差的根源,并推翻了一个流行的错误假设:
-
根源发现:IM-RMs过度依赖“表面文字线索”(比如特定词语),而EX-RMs更关注“深层语义”(比如句子含义)。就像有人只记住了题目的关键词却没理解题意,换个说法就不会做了。
-
推翻假设:过去认为IM-RMs表现差是因为它既要“判断答案对错”(验证)又要“生成正确答案”(生成),任务太重。但论文证明:IM-RMs完全可以只做好“判断”而不用会“生成”,比如它能准确识别哈密顿环是否正确,却根本生成不了环。
研究方法和思路:一步步拆解谜题
论文通过“理论分析+实验验证”双管齐下,像侦探破案一样层层推进:
步骤1:理论分析两种模型的“思考方式”
- EX-RMs的逻辑:它的评分变化只和语言模型对输入的“深层理解”(隐藏表示)有关。如果两个句子含义相似,即使文字不同,评分也会相近。
- IM-RMs的逻辑:它的评分变化直接和具体文字(token)挂钩。如果新句子用了不同的词,哪怕意思一样,评分也可能暴跌。
步骤2:数学证明IM-RMs的“先天缺陷”
通过定理2证明:当遇到训练中没见过的词语时,IM-RMs的评分会完全随机(准确率50%),而EX-RMs能通过“深层理解”继续准确评分。
步骤3:设计实验验证理论
-
控制实验(Persona数据集):
- 训练时用“同意”和“不同意”的固定表达,测试时换成释义版本(比如把“是的”换成“当然”)。
- 结果:EX-RMs准确率保持100%,IM-RMs准确率暴跌到几乎0。
-
真实场景实验:
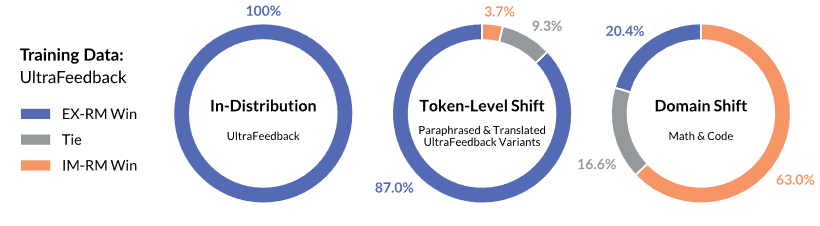
- 在UltraFeedback(通用对话)和RewardMATH(数学)数据集上,对比两种模型在“分布内”“token级偏移”(如翻译、释义)和“领域偏移”(如从对话到代码)场景的表现。
- 结果:IM-RMs在token级偏移中完败,但在领域偏移中表现相当甚至更好。
一段话总结
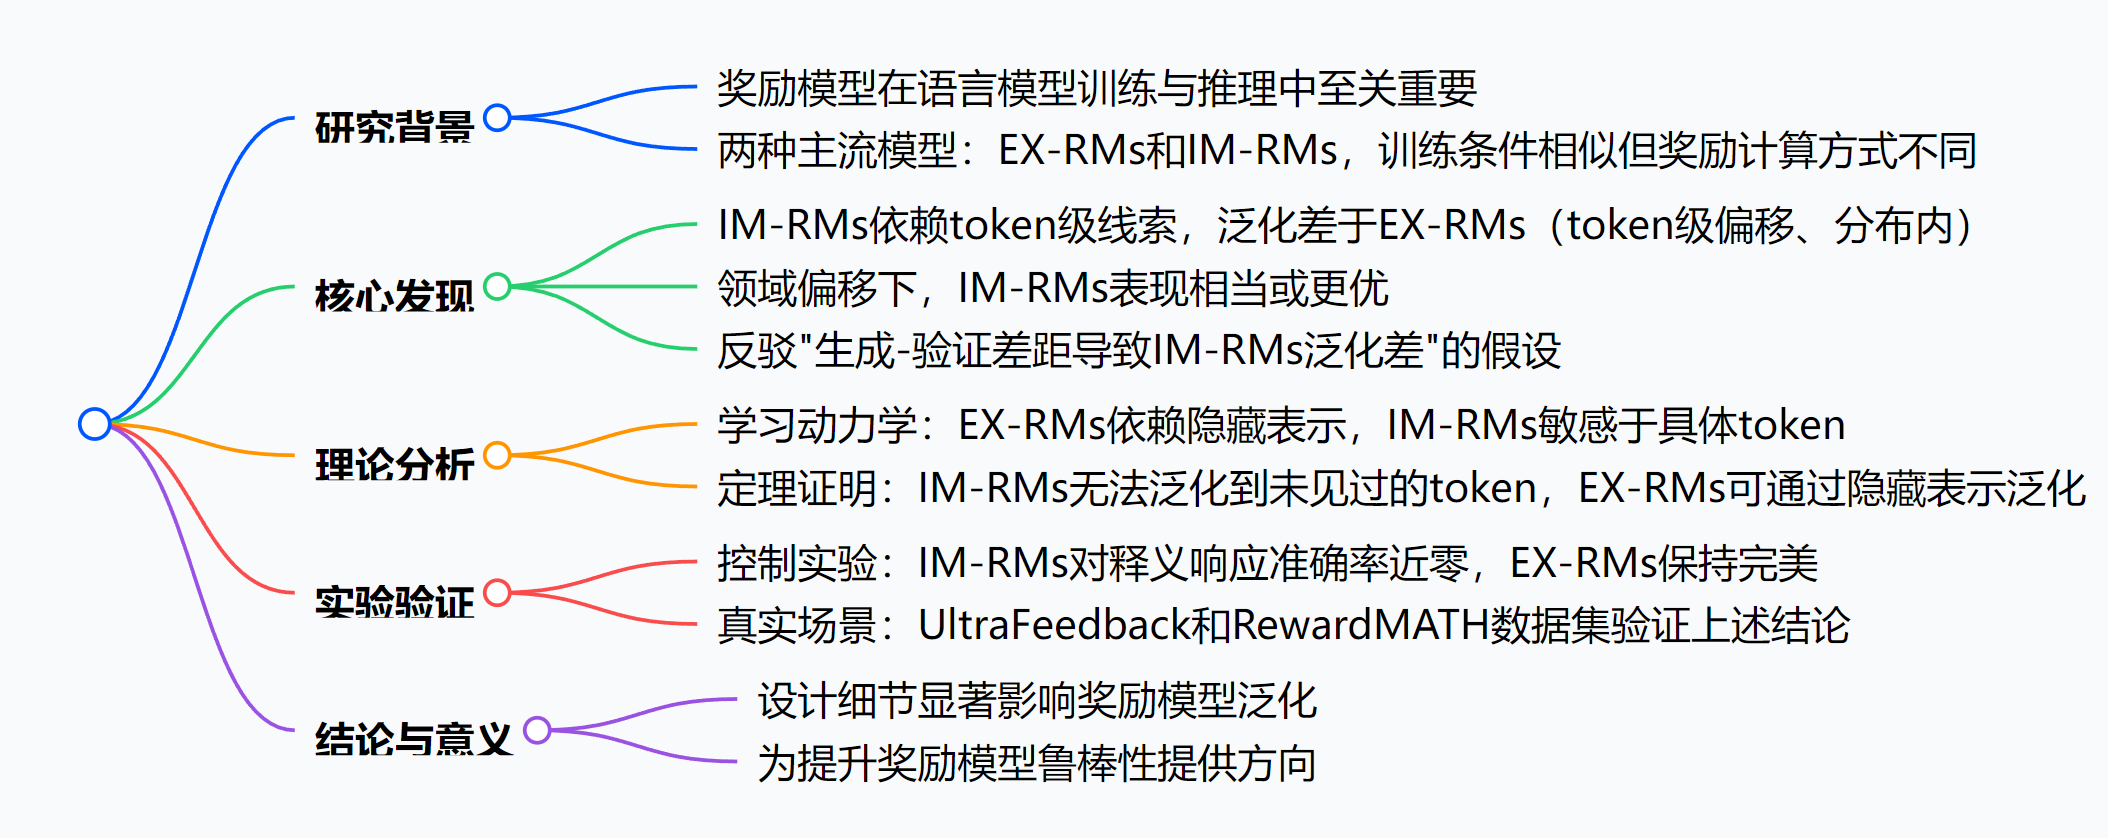
本文围绕显式奖励模型(EX-RMs) 和隐式奖励模型(IM-RMs) 的泛化差距展开研究,通过理论与实验分析,发现IM-RMs更依赖表面 token 级线索,因此在 token 级分布偏移(如释义、翻译)和分布内场景中泛化性能较差,而在领域偏移下表现相当或更优。同时,研究反驳了“IM-RMs因需同时学习生成和验证而泛化差”的假设,强调奖励模型设计细节对泛化行为的显著影响。
思维导图
详细总结
1. 研究背景与目标
- 奖励模型的重要性:奖励模型是语言模型后训练和推理流程的关键组件,用于评估生成响应的质量。
- 两种主流模型:
- 显式奖励模型(EX-RMs):通过线性头对语言模型生成的隐藏表示计算奖励,公式为 (r_{\theta_{EX}}(x, y) = \left<u, h_{x, y}\right>)。
- 隐式奖励模型(IM-RMs):基于语言模型对响应的对数概率计算奖励,公式为 (r_{\theta_{IM}}(x, y) = \beta \ln \frac{\pi_{\theta_{IM}}(y | x)}{\pi_{ref}(y | x)})。
- 研究目标:解释EX-RMs和IM-RMs在泛化性能上的差距(IM-RMs泛化更差,尤其在分布外场景)。
2. 核心发现
- IM-RMs的依赖特性:IM-RMs更依赖表面token级线索,导致在token级分布偏移(如释义、翻译)和分布内场景中泛化性能差于EX-RMs。
- 领域偏移表现:在领域偏移(如从通用对话到数学、代码领域)中,IM-RMs表现与EX-RMs相当或更优。
- 对替代假设的反驳:实验表明,IM-RMs无需学习生成即可完成验证任务(如哈密顿环验证),反驳了“生成-验证差距导致IM-RMs泛化差”的假设。
3. 理论分析
- 学习动力学差异:
- EX-RMs的奖励变化依赖响应的隐藏表示,可通过语义相似性泛化。
- IM-RMs的奖励变化受具体token影响,可能降低语义相似但token不同的响应的奖励。
- 泛化能力证明:
- 定理2表明,IM-RMs无法泛化到未见过的token,在相关评估中准确率固定为0.5;EX-RMs可通过结构良好的隐藏表示泛化。
4. 实验验证
- 控制实验(token级偏移):
- 在Persona数据集上,IM-RMs对原始响应准确率为1,但对释义响应准确率近零(训练集0.022,测试集0.019);EX-RMs保持完美准确率。
- 真实场景实验:
训练数据 评估场景 EX-RM准确率 IM-RM准确率 UltraFeedback 分布内 0.752±0.009 0.646±0.006 UltraFeedback token级偏移 0.665±0.005 0.602±0.003 UltraFeedback 领域偏移 0.621±0.012 0.720±0.004 RewardMATH 分布内 0.971±0.003 0.972±0.002 RewardMATH token级偏移 0.988±0.003 0.515±0.007 RewardMATH 领域偏移 0.505±0.012 0.517±0.001
5. 结论与意义
- 设计影响泛化:看似微小的设计差异(如奖励计算方式)显著影响奖励模型的泛化行为。
- 未来方向:需进一步研究奖励模型的隐式偏差,提升其鲁棒性,探索IM-RMs在特定场景的优势。
关键问题
-
问题:EX-RMs和IM-RMs的核心区别是什么?这种区别如何导致泛化性能差异?
答案:核心区别在于奖励计算方式:EX-RMs基于隐藏表示的线性变换,IM-RMs基于语言模型的对数概率。EX-RMs依赖语义相关的隐藏表示,泛化能力强;IM-RMs敏感于具体token,在token级偏移时泛化差。 -
问题:研究如何反驳“IM-RMs因生成-验证差距而泛化差”的假设?
答案:通过哈密顿环验证任务实验,IM-RMs能准确验证(训练集准确率1,测试集0.993)却无法生成正确环(生成准确率0),证明IM-RMs无需学习生成即可验证,反驳了该假设。 -
问题:在不同分布偏移场景中,EX-RMs和IM-RMs的表现有何具体差异?
答案:在token级偏移(如释义、翻译)和分布内场景,EX-RMs准确率更高(如UltraFeedback的token级偏移中,EX-RMs准确率0.665 vs IM-RMs 0.602);在领域偏移(如通用对话到数学)中,IM-RMs表现相当或更优(如UltraFeedback的领域偏移中,EX-RMs 0.621 vs IM-RMs 0.720)。
主要贡献:给AI“评分老师”挑毛病、指方向
- 找到核心问题:明确了IM-RMs泛化差的原因是“依赖表面文字”,为改进提供了靶点。
- 破除认知误区:证明“生成-验证双重任务”不是IM-RMs的问题,避免后续研究走弯路。
- 指导模型设计:如果任务中文字表达方式多变(如客服对话),优先用EX-RMs;如果领域变化大但表达方式固定(如特定行业文档),IM-RMs可能更适用。
总结:关键成果与价值
这篇论文揭示了一个重要事实:奖励模型的设计细节(哪怕只是评分方式的微小差异),会极大影响它在新场景中的表现。
- 核心发现:IM-RMs因依赖表面文字线索,在文字表达方式变化时泛化差;EX-RMs因关注深层语义,更稳健。
- 实际意义:为选择和改进奖励模型提供了明确依据,帮助AI系统在真实世界中更可靠地工作。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 16
 0
- 0


 已为社区贡献21条内容

所有评论(0)