从 OCR 到智慧路灯:具身智能视觉实战
1 工效组合展示
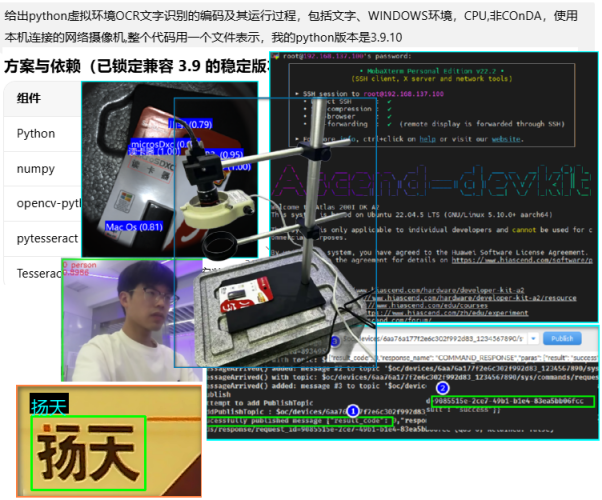
2 具身智能工业视觉获取与分析应用
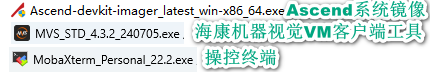
2.1 工具软件安装
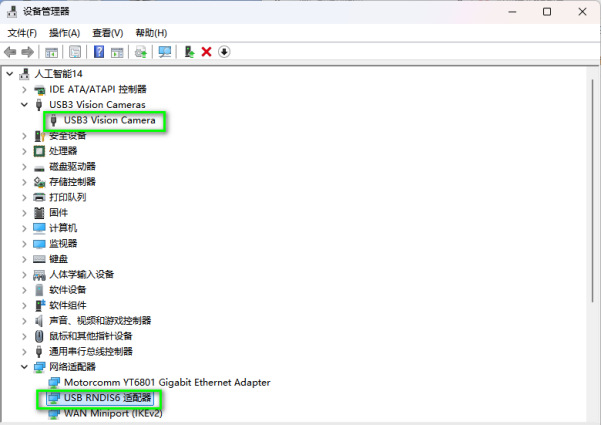
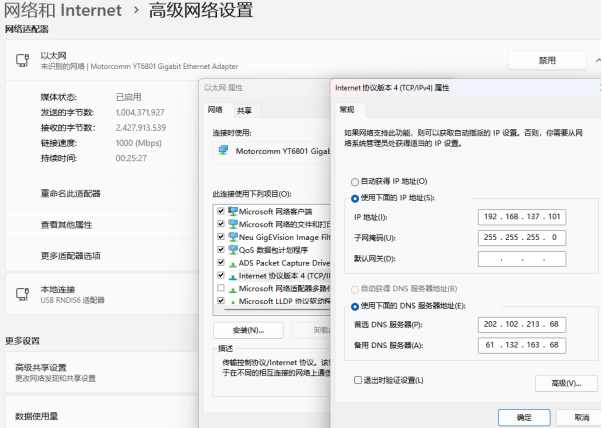
2.2 工业视觉环境构建与应用
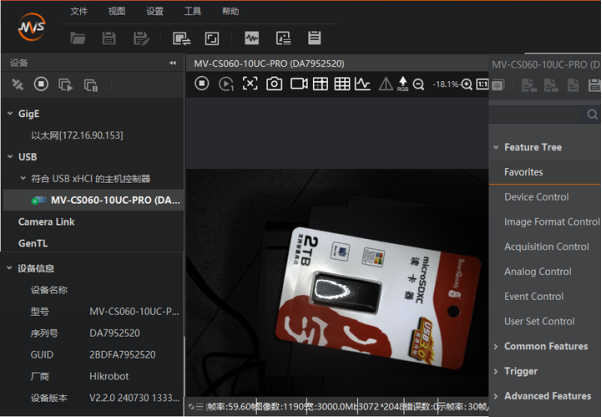
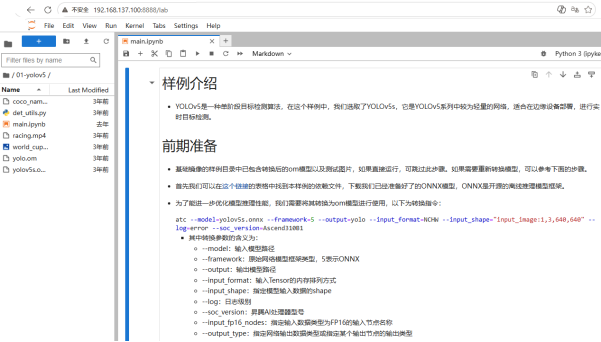
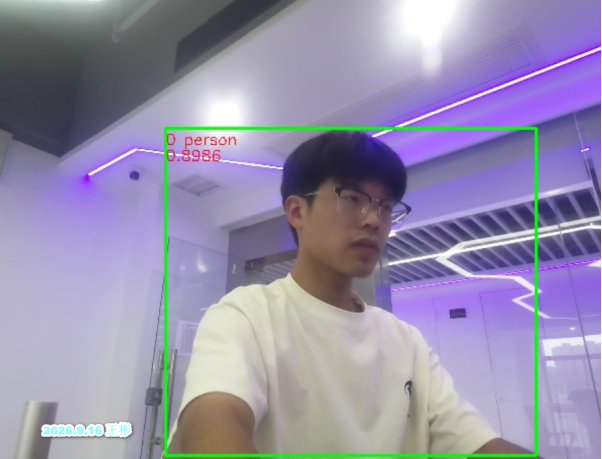
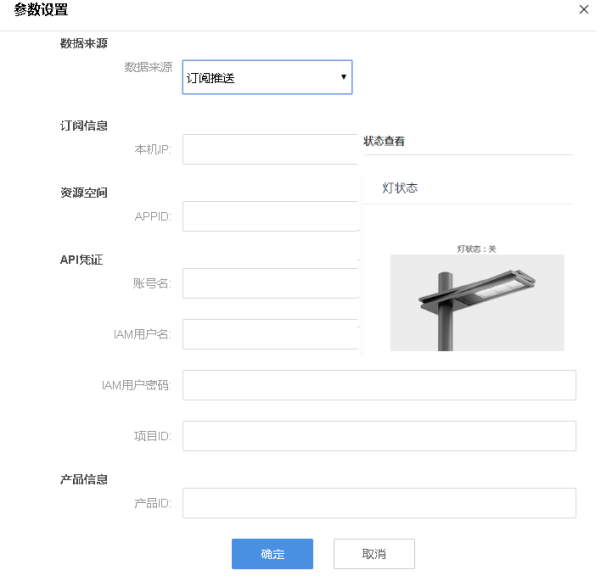
2.3 昇腾工业视觉终端应用展现
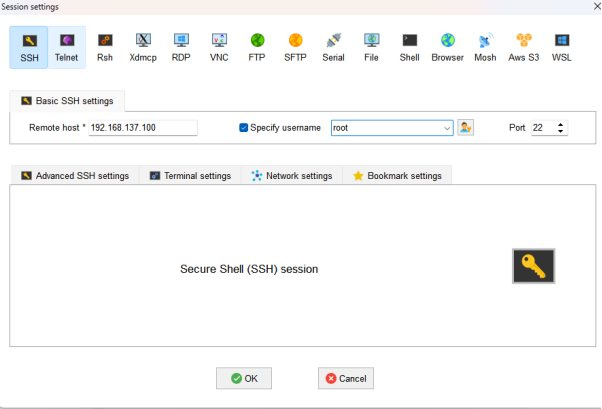
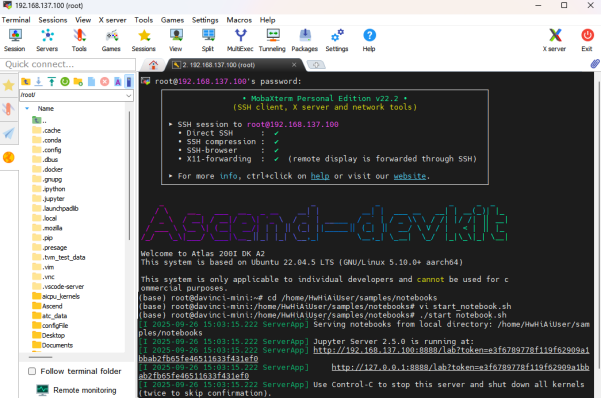
3 具身智能工业视觉识别快速编码实现
3.1 IMA-DS借力
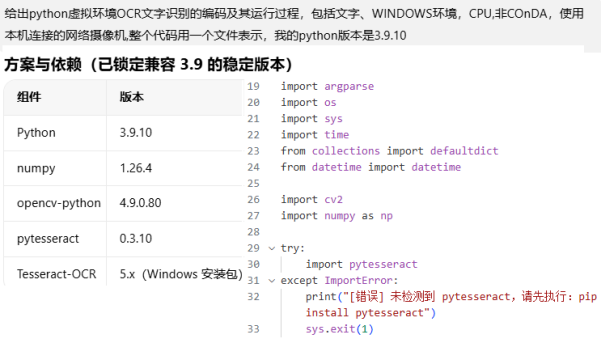
给出python虚拟环境OCR文字识别的编码及其运行过程,包括文字、WINDOWS环境,CPU,非COnDA,使用本机连接的网络摄像机,整个代码用一个文件表示,我的python版本是3.9.10
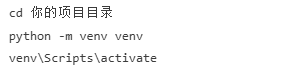
3.2 运行环境构造

3.3 编码实现
import argparse
import os
import sys
import time
from collections import defaultdict
from datetime import datetime
import cv2
import numpy as np
try:
import pytesseract
except ImportError:
print("[错误] 未检测到 pytesseract,请先执行:pip install pytesseract")
sys.exit(1)
# =============================================================================
# 配置区(按需修改)
# =============================================================================
# 1) 网络摄像机 RTSP 地址
# 海康威视 : rtsp://用户名:密码@IP:554/Streaming/Channels/101
# 大华 : rtsp://用户名:密码@IP:554/cam/realmonitor?channel=1&subtype=0
# 通用 : rtsp://IP:554/live
# 不同厂商 / 固件的路径不同,请以设备说明书或厂商工具为准
RTSP_URL = "rtsp://admin:password@192.168.1.64:554/Streaming/Channels/101"
# 传输协议:tcp 更稳定(避免 UDP 被防火墙拦截导致 30 秒超时),udp 延迟更低
RTSP_TRANSPORT = "tcp"
# 2) Tesseract 可执行文件路径
# 若安装时已勾选“加入系统 PATH”,可改为空字符串 "" 让它自动查找
TESSERACT_CMD = r"C:\Program Files\Tesseract-OCR\tesseract.exe"
# 3) OCR 识别语言:chi_sim = 简体中文,eng = 英文,可组合
OCR_LANG = "chi_sim+eng"
# 4) OCR 识别模式(--psm),常用取值:
# 6 = 假设画面是一块均匀的文本块(适合屏幕、票据、门牌等)
# 11 = 稀疏文本,适合画面中文字分布零散的场景
# 12 = 稀疏文本 + OSD 模式
OCR_PSM = 6
# 5) 抓帧间隔(秒),控制 OCR 频率,避免 CPU 满负荷
INTERVAL = 2.0
# 6) 图像预处理方式:original / gray / binary / adaptive
# gray = 灰度(推荐,通用性好)
# binary = 灰度 + Otsu 二值化(适合黑底白字 / 高对比度)
# adaptive = 自适应阈值(适合光照不均匀)
# original = 不处理,直接用彩色原图
PREPROCESS = "gray"
# 7) 识别置信度下限(0~100),低于该值的文字将被过滤
MIN_CONF = 40
# 8) 是否保存识别截图(保存到 ./ocr_snapshots 目录)
SAVE_SNAPSHOT = True
# 9) 是否将识别结果追加写入日志文件 ocr_results.txt
SAVE_LOG = False
# 10) 是否显示实时画面窗口(无显示器 / 远程环境请设为 False)
SHOW_WINDOW = True
# =============================================================================
# 图像预处理
# =============================================================================
def preprocess(frame, mode="gray"):
"""返回适合 OCR 的灰度图或原图。"""
if mode == "original":
return frame
gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
if mode == "gray":
return gray
if mode == "binary":
# Otsu 自动阈值二值化
return cv2.threshold(gray, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)[1]
if mode == "adaptive":
# 自适应阈值,更适合光照不均的监控画面
return cv2.adaptiveThreshold(
gray, 255,
cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
cv2.THRESH_BINARY,
31, 15,
)
return gray
# =============================================================================
# OCR 识别
# =============================================================================
def ocr_image(image, lang, tesseract_cmd, psm):
"""对单张图执行 OCR,返回 tesseract 原始结构化数据。"""
if tesseract_cmd:
pytesseract.pytesseract.tesseract_cmd = tesseract_cmd
config = f"--oem 3 --psm {psm}"
return pytesseract.image_to_data(
image, lang=lang, config=config, output_type=pytesseract.Output.DICT
)
def parse_results(data, min_conf=40):
"""把 tesseract 的逐词结果聚合成“一行一条”,并过滤低置信度。"""
lines = defaultdict(list)
for i in range(len(data["text"])):
text = (data["text"][i] or "").strip()
if not text:
continue
try:
conf = float(data["conf"][i])
except (ValueError, TypeError):
conf = 0.0
if conf < min_conf:
continue
key = (data["block_num"][i], data["par_num"][i], data["line_num"][i])
lines[key].append(
(data["left"][i], data["top"][i],
data["width"][i], data["height"][i], text, conf)
)
results = []
for words in lines.values():
words.sort(key=lambda w: w[0]) # 同一行内按 x 坐标从左到右排列
text = " ".join(w[4] for w in words)
x1 = min(w[0] for w in words)
y1 = min(w[1] for w in words)
x2 = max(w[0] + w[2] for w in words)
y2 = max(w[1] + w[3] for w in words)
avg_conf = sum(w[5] for w in words) / len(words)
results.append({"text": text, "box": (x1, y1, x2, y2), "conf": avg_conf})
# 按“从上到下、从左到右”排序
results.sort(key=lambda r: (r["box"][1], r["box"][0]))
return results
# =============================================================================
# 摄像头连接(带重试)
# =============================================================================
def connect_camera(url, retries=5, transport="tcp"):
"""连接 RTSP 网络摄像机,失败自动重试。"""
# 用 TCP 传输,并把打开超时缩短为 5 秒,避免默认 UDP 长时间无响应
os.environ["OPENCV_FFMPEG_CAPTURE_OPTIONS"] = (
f"rtsp_transport;{transport};stimeout;5000000"
)
for i in range(retries):
cap = cv2.VideoCapture(url, cv2.CAP_FFMPEG)
if cap.isOpened():
# 尽量降低缓冲,减小画面延迟
cap.set(cv2.CAP_PROP_BUFFERSIZE, 1)
ok, _ = cap.read()
if ok:
print(f"[成功] 已连接摄像机:{url}")
return cap
cap.release()
print(f"[重试 {i + 1}/{retries}] 连接失败,3 秒后重试...")
time.sleep(3)
raise RuntimeError("无法连接网络摄像机,请检查 RTSP 地址、账号密码与网络连通性")
def save_snapshot(frame, out_dir="ocr_snapshots"):
os.makedirs(out_dir, exist_ok=True)
name = datetime.now().strftime("%Y%m%d_%H%M%S_%f") + ".jpg"
path = os.path.join(out_dir, name)
cv2.imwrite(path, frame)
return path
def append_log(text):
with open("ocr_results.txt", "a", encoding="utf-8") as f:
f.write(f"{datetime.now():%Y-%m-%d %H:%M:%S}\t{text}\n")
# =============================================================================
# 主流程
# =============================================================================
def main():
parser = argparse.ArgumentParser(description="网络摄像机 OCR 文字识别")
parser.add_argument("--url", default="", help="RTSP 地址,默认使用配置区 RTSP_URL")
parser.add_argument("--transport", default=RTSP_TRANSPORT, choices=["tcp", "udp"],
help="RTSP 传输协议,tcp 更稳定,udp 延迟更低")
parser.add_argument("--lang", default=OCR_LANG, help="OCR 语言,如 chi_sim+eng")
parser.add_argument("--psm", type=int, default=OCR_PSM, help="Tesseract 识别模式")
parser.add_argument("--interval", type=float, default=INTERVAL, help="抓帧 间隔(秒)")
parser.add_argument("--preprocess", default=PREPROCESS,
choices=["original", "gray", "binary", "adaptive"],
help="图像预处理方式")
parser.add_argument("--min-conf", type=float, default=MIN_CONF, help="置信 度下限")
parser.add_argument("--tesseract", default=TESSERACT_CMD, help="tesseract.exe 路径")
parser.add_argument("--no-save", action="store_true", help="不保存截图")
parser.add_argument("--log", action="store_true", help="写入识别日志")
parser.add_argument("--no-window", action="store_true", help="不显示画面窗口")
args = parser.parse_args()
url = args.url or RTSP_URL
save_snap = SAVE_SNAPSHOT and not args.no_save
save_log = SAVE_LOG or args.log
show_win = SHOW_WINDOW and not args.no_window
cap = connect_camera(url, transport=args.transport)
print("=" * 60)
print("开始 OCR 识别,按 Ctrl+C 退出;显示窗口时按 q 也可退出")
print("=" * 60)
try:
while True:
ret, frame = cap.read()
if not ret or frame is None:
print("[掉线] 正在重连...")
cap.release()
time.sleep(3)
cap = connect_camera(url, transport=args.transport)
continue
# 1. 预处理(返回灰度图或原图)
proc = preprocess(frame, args.preprocess)
# 2. OCR 识别
data = ocr_image(proc, args.lang, args.tesseract, args.psm)
# 3. 解析结果
results = parse_results(data, min_conf=args.min_conf)
now = datetime.now().strftime("%H:%M:%S")
if results:
print(f"\n[{now}] 识别到 {len(results)} 行文字:")
for r in results:
print(f" [{r['conf']:.0f}%] {r['text']}")
# 在原图上画框
x1, y1, x2, y2 = r["box"]
cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)
if save_log:
for r in results:
append_log(r["text"])
if save_snap:
p = save_snapshot(frame)
print(f" [已保存截图] {p}")
else:
print(f"[{now}] 未识别到文字")
# 4. 显示画面
if show_win:
cv2.imshow("Network Camera OCR", frame)
if cv2.waitKey(1) & 0xFF == ord("q"):
break
time.sleep(args.interval)
except KeyboardInterrupt:
print("\n[退出] 用户中断")
finally:
cap.release()
cv2.destroyAllWindows()
print("已释放摄像头资源,程序结束")
if __name__ == "__main__":
main()
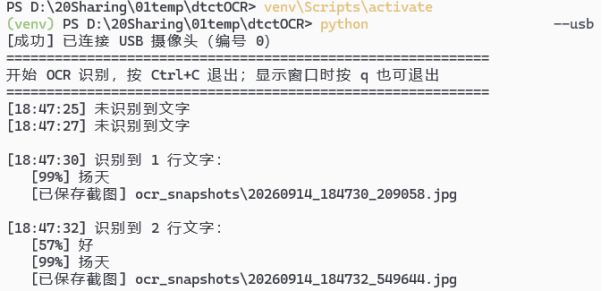
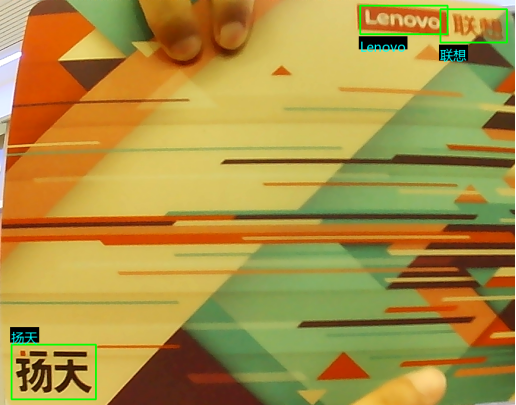
3.4 运行测试
4 IoTDA中转空间构建
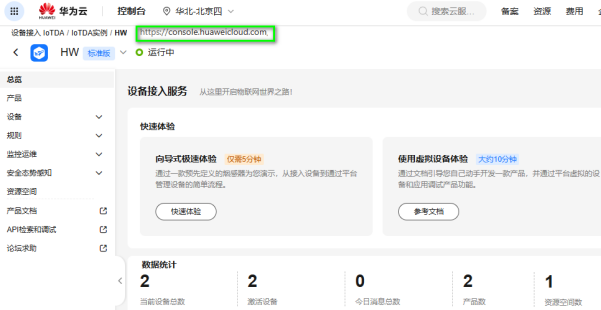
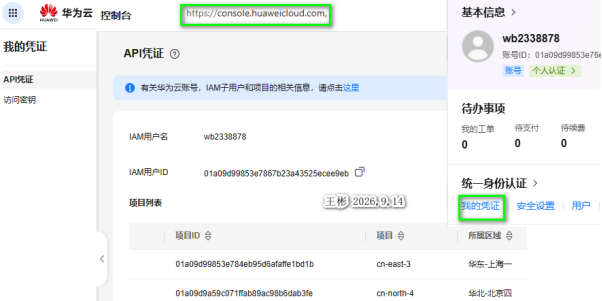
4.0 IoTDA构造
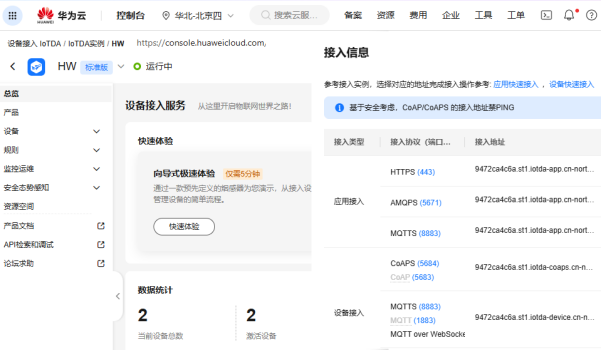
4.1 产品及其模型构建
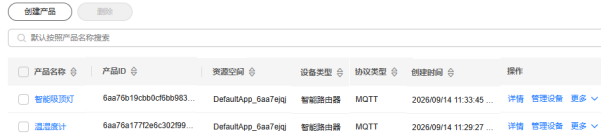
4.1.1 温湿度计
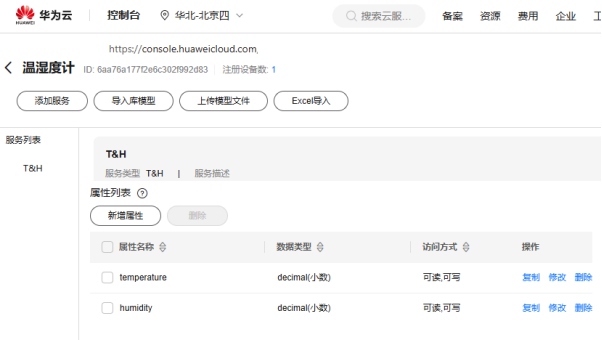
温湿度计产品信息如下:
产品信息:
- 产品名称:温湿度计 - 协议类型:MQTT
- 数据格式:JSON - 所属行业:智能家居
- 所属子行业:智能家居
服务列表:
- 服务 ID:T&H - 属性名称:temperature
- 数据类型:decimal - 访问权限:可读可写
- 取值范围:-100~100 - 属性名称:humidity
- 数据类型:decimal - 访问权限:可读可写
- 取值范围:0~100
点击“产品 》 创建产品”
4.1.2 吸顶灯
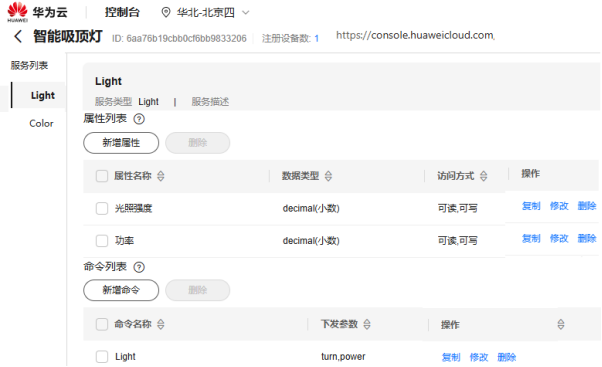
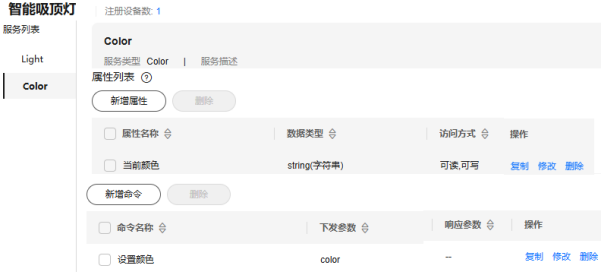
智能吸顶灯产品信息如下:
产品信息:
-- 产品名称:智能吸顶灯-- 协议类型:MQTT -- 数据格式:JSON
-- 所属行业:智能家居 -- 所属子行业:智能家居
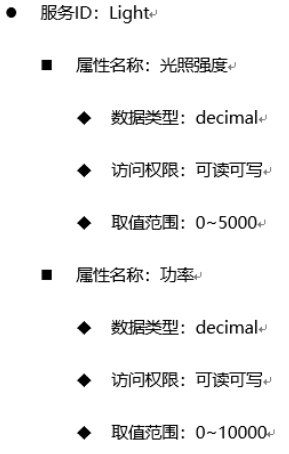
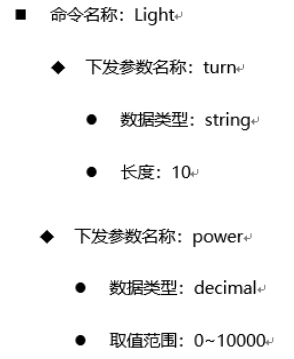
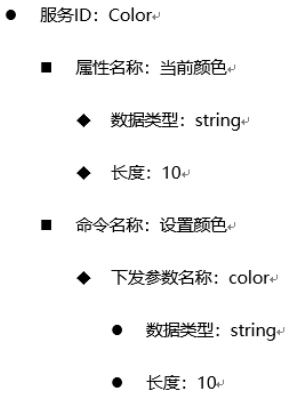
4.2 设备实例化应用
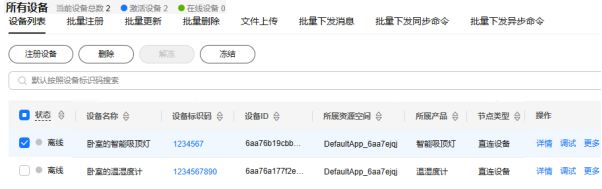
4.2.1 温湿度计设备注册及模拟测试
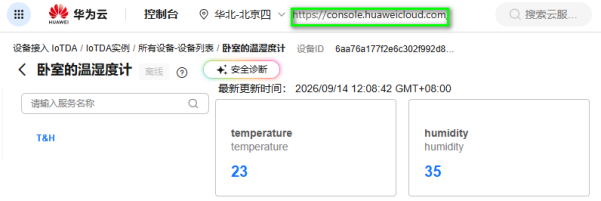
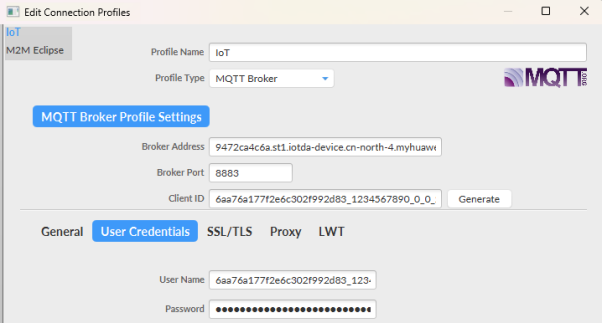
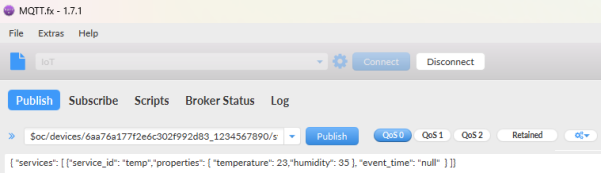
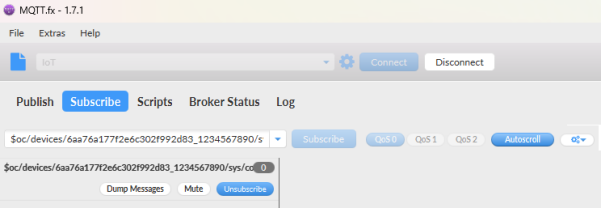
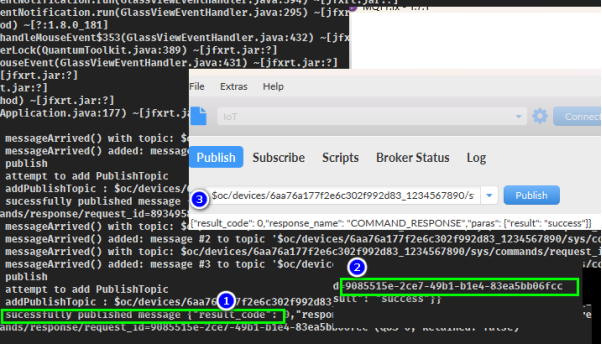
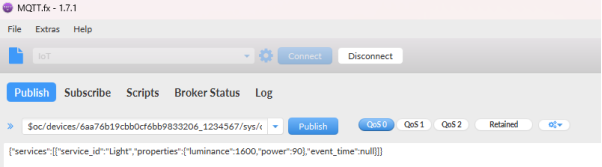
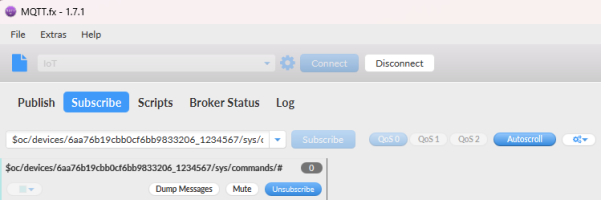
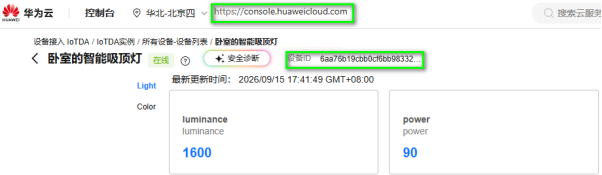
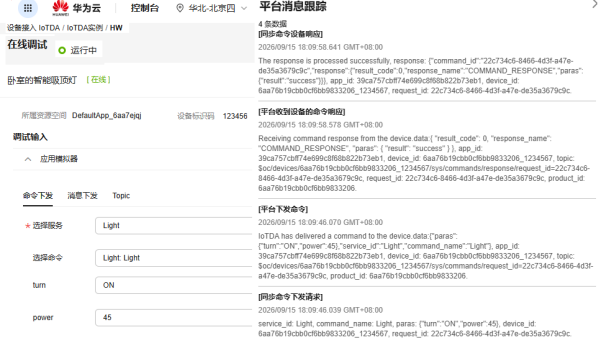
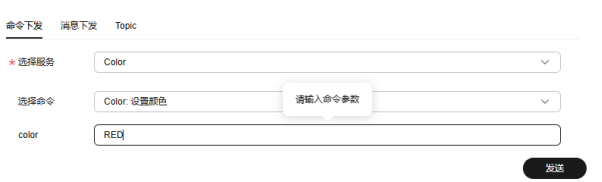
4.2.2 吸顶灯设备注册及模拟测试
5 CodeArts智慧路灯快速构建与部署
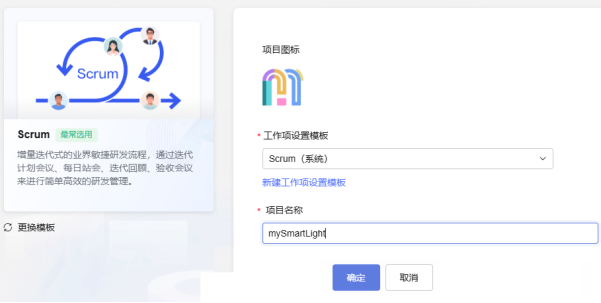
5.1 应用项目创建
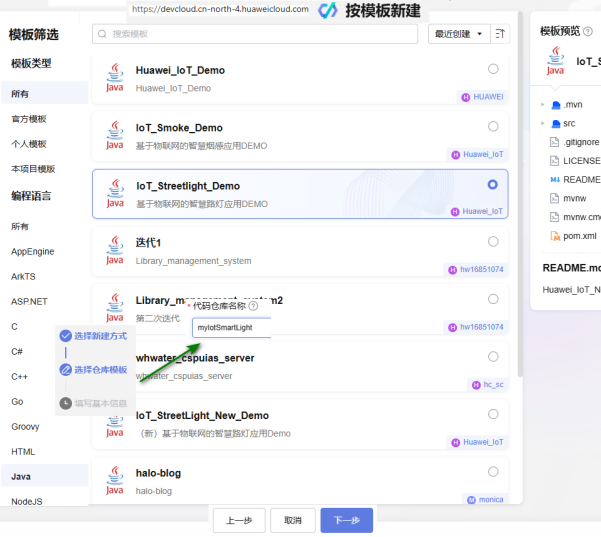
5.2 代码托管操作
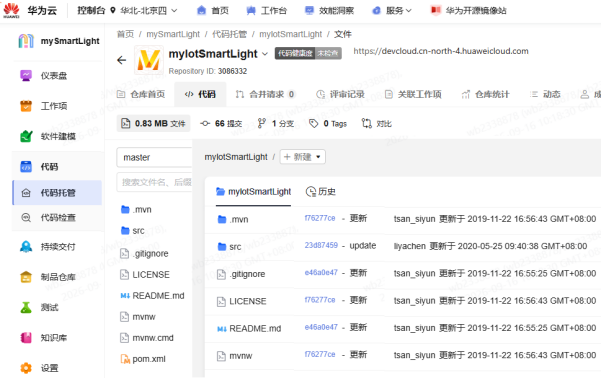
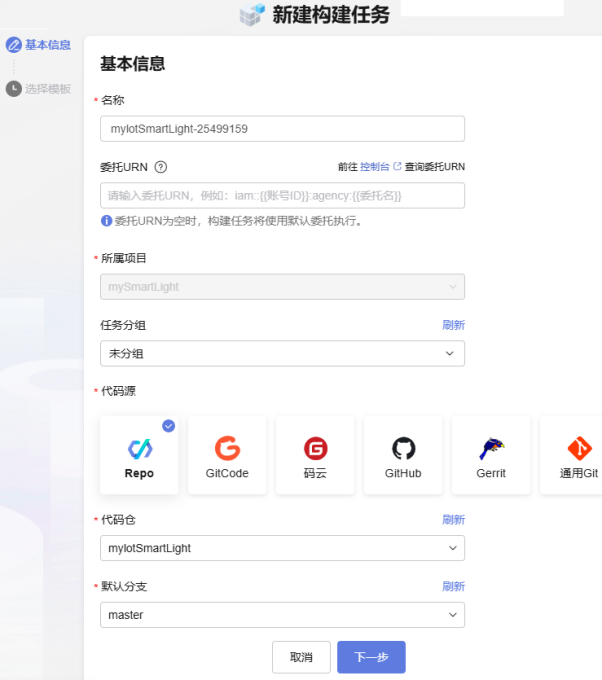
5.3 构建任务设立
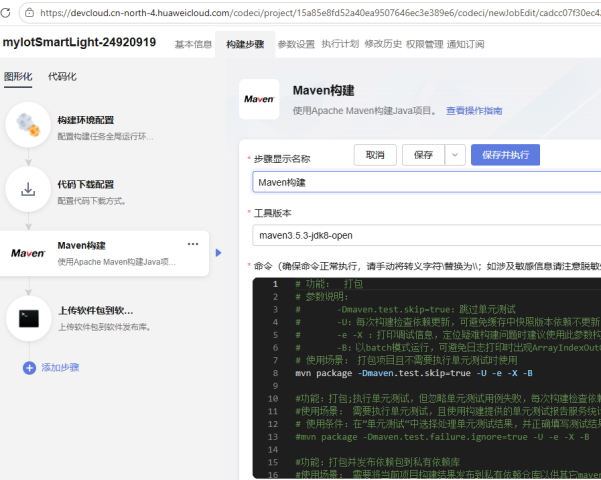
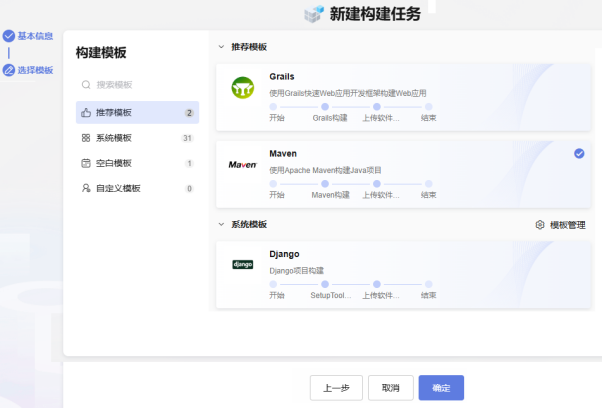
5.4 项目构建实现
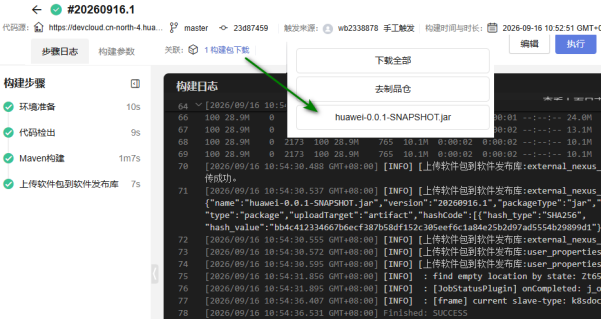
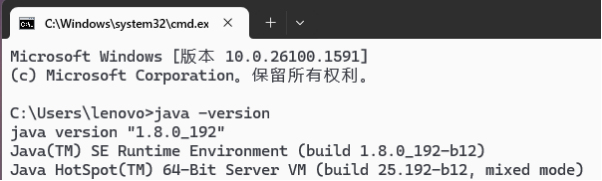
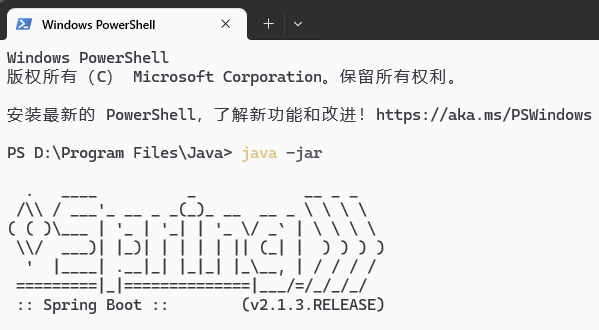
5.5 项目部署运行

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)