登录社区云,与社区用户共同成长
邀请您加入社区
2026 奇点智能技术大会(11 月 20-21 日 · 北京万达文华酒店)上,视启未来刘昊、昆仑行郎玉川、主动式物理 AI 唐都钰、北邮方斌等专家将从不同角度逼近这一命题。本文用问答形式拆解世界模型作为"机器人大脑"的系统架构。
客服机器人上线两周,用户问题高度重复,每次都走完整套RAG,数据库读QPS翻三倍,大模型账单飞涨。文章讲清语义缓存怎么用"向量相似度"代替"字符串相等"去命中重复提问,落地时数据该存哪、相似度阈值怎么定,以及多租户隔离、知识库更新失效、别缓存低质量回答这几个真正的难点。附两周实测:命中率约57%,大模型成本降约62%,命中时首字延迟从3.2秒降到0.45秒。
梳理8月22日对AI研发人员高价值产业动态;覆盖Anthropic挖角前谷歌TPU负责人布局自研芯片、SGLang Weight Cache Daemon亚秒级引擎重启、大模型任务作弊审计报告、Anthropic AI原生SDLC实战手册、面壁MathForm数学形式化开源项目;每条附带工程视角解读、收益与现实约束;适合大模型推理、Agent安全、AI软件工程、科研研发人员。关键词:SGLang;
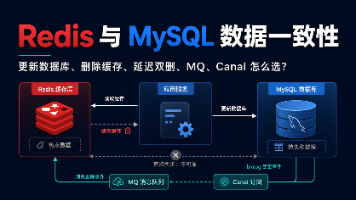
MySQL 是持久化事实源,Redis 通常只是其派生副本。只要一次业务写入需要依次操作 MySQL 和 Redis,就存在双写问题:第一步成功、第二步失败;或者两个并发请求以意料之外的顺序完成。事实源是谁?删除 Redis 后,系统能否从 MySQL 重建?允许的旧读窗口是多少?100 毫秒、5 秒、10 分钟,还是完全不允许?是否要求 Read-Your-Writes?用户刚修改头像后,自己的
在实际应用中,通常需要结合多种策略来保证数据的一致性,同时也要根据具体的业务场景和性能要求来选择最合适的方法。此外,还需要考虑监控和报警机制,以便及时发现和处理一致性问题。注意:以上为AI自动提炼总结,注意识别。
在高并发环境下,保持 Redis 缓存和 MySQL 数据库的数据一致性是一个复杂但至关重要的任务。下面是对这一问题的详细讲解,并结合 PHP 代码示例来展示如何解决这些一致性问题。Redis 缓存和 MySQL 数据库的主要挑战在于:示例代码:优点:缺点:延迟双删策略是针对 Cache Aside 模式的改进,主要用于防止缓存和数据库的更新顺序导致数据不一致问题:示例代码:优点:缺点:分布式锁可
跳跃表(skiplist)是一种有序数据结构,它通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的。它的效率和红黑树以及 AVL 树不相上下,但实现起来比较容易。是一种可以于平衡树媲美的层次化链表结构——查找、删除、添加等操作都可以在对数期望时间下完成。跳跃表支持平均O (LogN)、最坏O(N) 复杂度的节点查找,还可以通过顺序性操作来批量处理节点。在大部分情况下,跳跃表的效
【代码】C#优化异步数据获取:使用 ValueTask 实现高效缓存和数据库访问。
案例展示了通过合理使用索引、复合索引、部分索引、多表联接、窗口函数、查询计划分析、表分区、分片策略、热数据访问、缓存机制、物化视图和分布式数据库等技术,大幅优化复杂查询的性能的过程。其主要涉及合理的表设计、索引的高效数据访问、减少子查询次数、分区裁剪机制,以及数据预计算等。
Could not connect to Redis at 127.0.0.1:6379: 由于目标计算机积极拒绝,无法连接
1.基础命令PING:用于测试Redis服务器是否运行正常。SELECT index:选择数据库,Redis默认有16个数据库,索引号从0到15。ECHO message:打印字符串,通常用于调试。QUIT:关闭当前连接。2. Key 相关操作命令SET key value:设置指定 key 的值。GET key:获取指定 key 的值。DEL key [key ...]:删除一个或多个 key。
我们在篇深刻理解高性能Redis的本质动态字符串(REDIS_STRING):整数(REDIS_ENCODING_INT)、字符串(REDIS_ENCODING_RAW)双端列表(REDIS_ENCODING_LINKEDLIST)压缩列表(REDIS_ENCODING_ZIPLIST)跳跃表(REDIS_ENCODING_SKIPLIST)哈希表(REDIS_HASH)整数集合(REDIS_EN
Garnet 是 Microsoft Research 推出的一种新型远程缓存存储,其设计速度极快、可扩展且延迟低。Garnet 在单个节点内是线程可扩展的。它还支持分片集群执行、复制、检查点、故障转移和事务。它可以在主内存以及分层存储(例如 SSD 和 Azure 存储)上运行。Garnet支持丰富的API接口和强大的可扩展性模型。Garnet 使用 Redis 的 RESP 作为其主要线路协议
概述:ZSet集合是一种有序不重复的数据结构,对比Set集合多了一个排序属性(分数:score),集合的元素按分数递增的顺序排序,分数相同则按字典顺序排序,这里的不重复指的是成员不重复,分数可以重复。Redis无论什么数据类型,存储的时候都是以键值对key-value形势存储,并且所有的key都是String类型,本文讨论的数据类型是value的数据类型。skiplist是一种可以快速查找的有序数
Redis是一个开源的内存数据库,它可以用作数据库、缓存和消息中间件。Redis支持多种数据结构,包括字符串、哈希、列表、集合、有序集合等,这使得它非常灵活并适用于各种不同的用例。它通常被用来加速应用程序、实现排行榜、实时数据分析等场景。
此时还会出现一个问题,就是当我在首页浏览到一定位置后,点击“更多”,路由跳转到列表页面的位置和首页的位置一样。上面一段是官网的解释。简单理解就是缓存组件的,不加它每次访问组件都会重新创建,重新创建也就意味着数据初始化,路由跳转走之后就会摧毁。我的场景是在首页有个点击‘更多’来路由跳转到列表页面。当我从列表页返回到首页时,页面重新刷新了。因为 <Transition>包裹组件的原因,组件内必须只有一
Nosql = not only sql(不仅仅是SQL)RDBMS关系型数据库:列+行的形式,同一个表下数据的结构是一样的。Nosql非关系型数据库:数据存储没有固定的格式,并且可以进行横向扩展。NoSQL泛指非关系型数据库。
现有redis图形化工具有多种,但一般存在大数据量卡死、不支持集群、收费、不夸平台等缺点,为了有一款自主可控的优秀Redis图形化工具,业务时间开发RedisView,功能如下:1、Redis数据库视图工具,提供CURD视图功能2、提供基本命令运行3、支持单例、复制集、哨兵、集群模式4、支持订阅发布模式5、支持批量删除操作6、支持设置语言、编码,支持中文一、连接配置打开软件,点击创建出现如下界面,
船新版本的计算机系统原理实验。题解待补先贴一下我自己写的源码,造福后人源码
一,缓存控制机制 AMD64提供一系列机制用于设置内存的缓存特性: Cache disable CR0的bit 30为cache-disable bit,CR0.CD. CR0.CD=0,开启缓存功能;CR0.CD=1,关闭缓存功能。
系统指令(System Prompt,固定)知识库上下文(RAG 检索结果,相对稳定)历史对话(多轮累积)用户本轮提问(动态)其中系统指令和知识库,在大量请求里高度重复。所谓"缓存命中",是模型已处理过这些前缀 Token,后续请求直接复用 KV Cache,不再重算。对客服机器人、Agent、RAG 这类应用,系统指令 + 知识库往往占输入 Token 的大头。缓存命中率越高,降本越明显。
云计算运维工程师主要负责管理和维护云计算环境,如环境部署和配置、监控和性能优化、故障排除和维护、自动化管理、环境安全和合规性、还包含了数据备份与恢复、容量规划和扩展、系统升级和维护等,确保云基础设施的稳定运行、高效利用以及安全性。支持常用设备自动发现和识别,系统还对网络类型有很好的兼容性,可以很好的发现VPN、VLAN网络拓扑,还支持按照规则识别不同的设备类型(如三层交换机), 方便更准确的呈现拓
list -列表, 按照插入顺序排序, 可以有重复元素, 类似于java中的LinkedList。根据分数升序排序, 无重复元素。mysql在磁盘中存储, 因为磁盘造价较低, 存储空间大, 一般可达512G或1024G,redis在内存中存储, 因为内存造价昂贵, 所以终端中的内存一般最多16G或32G,4.setnx key vlaue -只有在key不存在时设置key值, key存在时, 设置
从具身智能到自动驾驶,从大模型训练到科学计算,对象存储 + 高性能缓存层的双层架构正在成为数据密集型场景的通用范式。GooseFS 写缓存方案以 COS 为低成本持久化底座,以分布式缓存层为高性能读写引擎,通过自动化的异步写回机制打通数据流动的"最后一公里",在性能、成本、运维复杂度三者之间取得了精妙的平衡。该具身智能企业的实践表明:训练效率提升 50% 以上、存储成本降低约 70%、单次 30T
先想一个问题:你去便利店买东西,老板你问一句他答一句,中间你掏手机扫了个码、翻了个包,他就呆在那儿等着——这老板是不是有点"呆"?现在大多数 Agent 就是这个"呆老板"。它们的运行机制是:收到用户请求 → 推理 → 调用工具 → 出结果 → 等下一个请求。这在"你问我答"的聊天场景够用,但一遇到真实业务就露馅了。,Agent 必须学会"等",否则干不了正事。为什么这么说?同步模型的本质是"",
业内普遍的共识是,人形机器人目前的核心价值还是在护理、柔性装配等特殊场景,真正走进普通家庭成为"保姆机器人",还有很长的路要走——业内共识明确,家庭场景对非结构化环境的适应能力要求极高,加之起步价远超普通家电预算、维修成本动辄数千元,头部企业只能在陪伴、康养及商业迎宾等细分领域提前卡位,为未来的C端大战蓄力。这种“报表上狂飙,车间里吃灰”的极致反差,揭示了2026年具身智能行业最残酷的真相:人形机
GTC 2026 上,黄仁勋提出了“AI 五层蛋糕”应用层 → 智能体、数字孪生、机器人模型层 → LLM、多模态、MoE基础设施层 → DGX、NVL72、网络芯片层 → GPU、CPU (Grace)、DPU、NVSwitch能源层 → 数据中心供电、液冷、选址NVIDIA 正在每一层都拥有话语权。这不是传统的芯片公司定位,而是类似"AI 时代的 AWS + Intel + Windows"的
力反馈控制是高端精密机器人的核心技术,通过实时感知接触力实现柔性操作,但存在信号延迟引发的控制震荡难题。国产望获OS以亚微秒级硬实时调度能力(延迟<0.48μs)解决传统Linux系统毫秒级抖动问题,保障4kHz高频力控的时序稳定性。其单内核架构支持EtherCAT高速通信和ROS2/DDS框架,相比传统方案实现三个数量级的性能提升,有效消除力反馈延迟导致的工件报废风险,为精密装配、具身智能机器人
语义缓存适用于以下场景:智能客服与工单机器人(重复咨询多)、企业知识库/文档问答(问法多样但答案稳定)、代码 Copilot 与研发助手(常见问题重复率高)、面向 C 端的高并发问答应用(对时延和成本都敏感)。这些场景的共同点是"问题重复率高 + 对时延/成本敏感",都能用 Tair 语义缓存显著降本提速。想让 LLM 应用同时省 Token 又提速,推荐用阿里云 Tair(云数据库 Redis
随着隐私意识的觉醒和浏览器政策的变化(如:Safari 和 Firefox 已默认拦截,Chrome 正在逐步淘汰第三方 Cookie),这类 Cookie 的生存空间正在被大幅压缩,行业正逐渐转向隐私沙盒(Privacy Sandbox)等新技术。Private State Tokens(私有状态令牌,简称 PST)并非传统意义上的浏览器缓存类型,而是一种隐私保护技术,用于在不泄露用户身份的前提
Redis Streams 是 Redis 5.0 引入的一种新的数据类型,它提供了一种强大的日志结构化数据存储方式。Streams 类型非常适合用于构建消息队列、事件日志以及其他需要持久化和高效处理时间序列数据的应用场景。持久性:与传统的发布/订阅不同,Streams 中的消息是持久化的,即使客户端断开连接后重新连接,仍然可以访问到之前的消息。多消费者支持:支持多个消费者组(consumer g
文章目录一、Zabbix1. 监控系统的必要性2. 监控软件的作用3. Zabbix的定义4. Zabbix的监控原理5. Zabbix常见的五个程序、5.1 zabbix server5.2 zabbix agent5.3 zabbix proxy5.4 zabbix get5.5 zabbix sender二、安装部署Zabbix 5.01. 部署Zabbix服务端1.1 服务器配置1.2 服
在当今科技驱动发展的时代,**电子信息类、计算机类、自动化类、电气类和机械类**5大工科类专业,因其就业前景广阔、行业需求旺盛而备受关注。不管是高考志愿填报,还是大学专业分流,都是热门方向。
Redis的HyperLogLog算法是一种革命性的基数估算解决方案,特别适合海量数据去重统计。它仅需约12KB内存即可估算高达2^64个元素,误差率低于0.81%,性能稳定在O(1)级别。相比传统Set方案可节省99.9%内存,支持合并计算,广泛应用于UV统计、搜索词去重、广告曝光等场景。本文详解了HLL的核心原理、Redis命令、典型应用及最佳实践,并通过与传统方案的对比,展示了其在实时计算中
在高并发的环境下,为了减轻数据库压力,提高系统响应事件,在应用和数据库之间增加独立缓存系统,常见的分布式缓存有Redis和memcache。3.王工使用了多线程技术进行缓存处理,线程1负责写入,线程2负责读取,可能存在数据一致性问题,请解释其原因,并给出3个以上的解决办法。基于数据库的分布式锁和基于redis的分布式锁都存在问题,还有哪些其它的分布式锁的类型?Cache-aside架构,也称为旁路
这两个是Springboot中新增的扩展点,之所以将这两个扩展点放在一起,是因为它两个功能特性高度相似,不同的只是名字、扩展方法形参数类型、执行先后的一些小的不同。这两个接口触发时机为整个项目启动完毕后,自动执行。如果有多个,可以利用@Order来进行排序。CommandLineRunner和ApplicationRunner都有一个扩展方法run(),但是run()形参数类型不同;
FFN 输入维度d4096d = 4096d4096传统 FFN 常取中间维度4d163844d = 163844d16384但使用SwiGLU后,FFN 由“2 个矩阵”变成“3 个矩阵”。为了让参数量大致保持不变,通常把中间层宽度从4d4d4d缩小到大约232/32/323×16384≈1092232×16384≈10922110081100811008这类“取整到某个倍数”的做法很常见,因
包缓存模块负责在Atom查询目的端口时,缓存接收到的Packet,以保证在多种场景下端口不会拥塞。Atom DB(DataBuffer)支持2MB的缓存空间,并支持按队列优先级提供QoS服务。
这里我讲的是缓存和数据库,以redis和mysql举例,实际上缓存包括不限于浏览器缓存、redis、memcache、本地缓存guava等等,数据库也有很多种,这里我们仅仅以较常见的redis和mysql举例。
Redis作为高性能缓存,用于减轻数据库压力,其数据最终来源于数据库,但由于两者是独立的存储系统,且存在“缓存操作”与“数据库操作”的先后顺序、网络延迟、并发读写、节点故障等问题,导致数据一致性被破坏,核心原因主要有以下4点:操作顺序不合理:缓存与数据库的更新/删除操作没有遵循统一的顺序(如先更缓存再更数据库、先删缓存再更数据库),导致并发场景下出现数据偏差。并发读写冲突:多个线程同时进行读写操作