登录社区云,与社区用户共同成长
邀请您加入社区
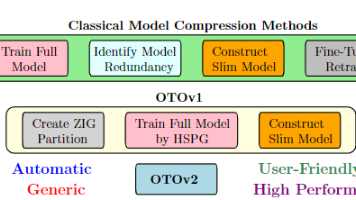
OTOV2提出了一种自动化的DNN训练与压缩框架,通过创新性的图算法自动划分零不变组(ZIG)并采用双半空间投影梯度(DHSPG)优化器实现结构化稀疏。该框架能够一次性完成模型训练与压缩,无需微调即可生成高性能紧凑模型。关键技术包括:1)自动ZIG分区算法(线性时间复杂度)识别最小可剪枝参数组;2)DHSPG优化器通过双半空间投影实现可靠稀疏控制。相比前代,OTOv2具有更好的泛化能力和更少的超参
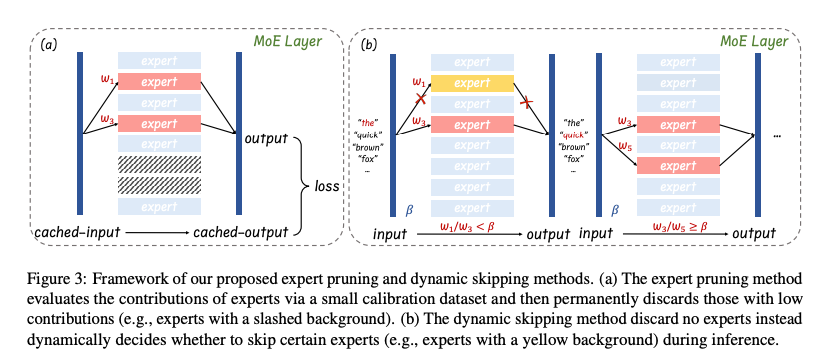
《Not All Experts are Equal: Efficient Expert Pruning and Skipping for Mixture-of-Experts Large Language Models》提出了一种创新的专家级稀疏化方法,通过后训练专家剪枝(Expert Pruning)和动态专家跳跃(Dynamic Expert Skipping),显著降低了 MoE 模型的内
决策树算法可以应用于分类问题与回归问题,李航的书中主要讲解的是分类树,构建决策树分为三个过程,分别是特征选择、决策树生成、决策树剪枝以及CART算法。
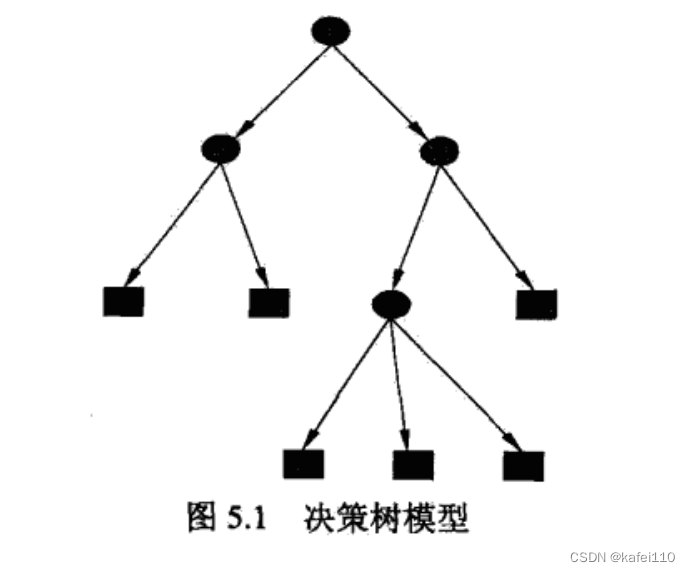
决策树5.1 决策树模型与学习5.2 特征选择5.2.1 信息增益5.1 决策树模型与学习分类决策树模型是一种描述对实例进行分类得树形结构。内部节点表示一个特征或属性,叶子节点表示一个类。路径上内部节点的特征对应着规则的结论,而叶节点的类对应着规则的结论。决策树的路径具有一个重要的性质:互斥并且完备,每一个实例都被一条路径或一条规则所覆盖,且只被一条路径或一条规则所覆盖。决策树与条件概率决策树还可
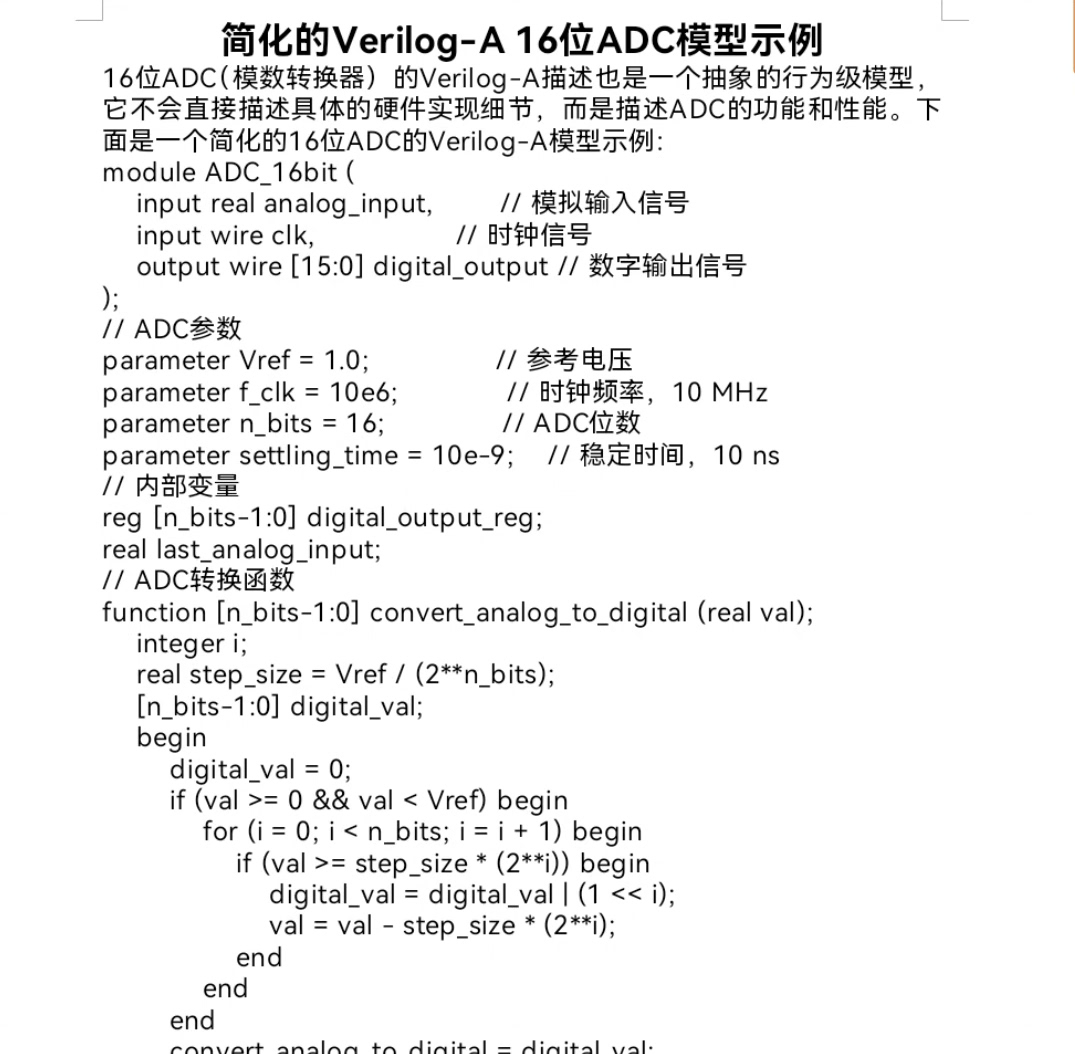
芯片设计里的行为模型验证就像给电路做沙盘推演,最近在折腾16位SAR ADC的建模时发现,VerilogA真是个快速验证架构的神器。比如最初没加时钟分频模块,仿真发现比较器在采样阶段误触发,导致输出码跳变——这个问题在RTL设计里可能要迭代好几次才能发现,用VerilogA模型两天就定位到时钟域混乱的问题。但真要建模16位精度,得注意量化噪声的影响。芯片设计,行为模型,16位ADC,verilog
定义:K 台老虎机,每台奖励分布未知,需在探索与利用之间平衡以最大化总奖励。关键矛盾探索(exploration) vs 利用(exploitation)常用策略贪心算法(Greedy):选择当前估计奖励最大的老虎机上限置信区间算法(UCB1):选择置信上限最大的老虎机Boltzmann 策略:按概率选择,概率与估计奖励相关。
决策树是分类任务中的经典算法,凭借逻辑清晰、可解释性强的优势广泛应用,但无约束生长的决策树容易过度拟合训练数据,导致面对新数据时泛化能力下降。剪枝技术作为解决过拟合的核心手段,主要分为预剪枝和后剪枝两类。本文将基于自定义数据集,从零实现两种剪枝策略,通过精度对比验证效果,并结合可视化直观呈现剪枝对决策树结构的影响,提供可直接复用的代码框架。首先确保安装必要的库(numpy、matplotlib、s
对于深度学习来说,比较复杂的模型往往有着不错的识别效果,但是复杂的模型往往对算力要求也比较高,在一些对于实时性要求比较高或者算力比较小的应用场景中,这时复杂的模型往往不能很好达到预期效果,这时候就要进行模型的剪枝,提高模型的运算速度。剪枝也就是将这个参数置为0,消除这些节点与后面的联系,从而降低运算量,本文主要基于对于模型剪枝的实战展开。
这篇文章介绍了一个用于优化ONNX模型的Python脚本,主要包含两个核心功能:1) 修复Split节点的属性兼容性问题,将旧版ONNX的split属性转换为新版要求的常量输入形式;2) 模型剪枝功能,可以根据指定输出节点反向追踪依赖关系,移除模型中不必要的节点和初始化参数。脚本通过分析计算图结构,智能识别需要保留的节点,并重构模型的计算图,同时处理了初始化和张量信息等元数据。这种优化既解决了版本
【内附代码与数据集】【深大算法设计与分析】实验三 回溯法(地图填色问题)
预剪枝,后剪枝
摘要:本文介绍了度量学习在机器学习中的核心作用,它通过优化距离度量来解决传统欧氏距离"一刀切"的问题。文章详细讲解了加权欧氏距离和马氏距离的原理:加权欧氏距离通过调整特征权重突出关键特征,马氏距离则能消除特征相关性。配合Python代码实践,展示了在"好瓜分类"任务中,改进后的距离度量可使KNN分类精度提升5%-15%。度量学习在图像检索、推荐系统等场景中具
序贯覆盖:在训练集上每学到一条规则,就将改规则覆盖的样例去除,然后以剩下的样例组成训练。冲突消解:顺序规则、缺省规则、元规则。读作:若(文字1且文字2且...),则目标概念成立。集重复上述过程( 分治策略)。命题逻辑 → 命题规则。
人工智能的alpha和beta剪枝策略
当前的AI Agent(智能体)开源软件从自动化研究到“零人工”公司编排,让 AI 在极低成本和极高性能下运行,从“大而全”向“极小、极快、自治”转型。围绕 OpenClaw 协议的各种变体(Nano/Zero/Pico),预示着端侧 AI Agent 爆发的前兆。Garry Tan 亲用的 Claude Code 配置,集成 10 款工具,全方位模拟 CEO 到 QA 的职能角色。Karpath
在代码实现之前,我们先要知道,sklearn里面的tree库中的一些关键模块。
LLC谐振参数计算实例,mathcad格式,列出完整计算公式,自动计算并绘出增益曲线,方便修改设计参数,本实例是实际产品的计算,已验证其正确性。送LLC原理详解和设计步骤文档PDF。
摘要: 模型优化技术通过量化(降低数值精度)、剪枝(移除冗余连接)和知识蒸馏(大模型指导小模型)三大方法,为AI模型“瘦身”和“提速”,使其更适配移动端、嵌入式设备等资源受限场景。优化后的模型体积更小、计算更快、功耗更低,广泛应用于智能手机美颜、语音唤醒、自动驾驶等实时性要求高的领域。然而,优化可能带来精度损失,且依赖特定硬件和框架。未来,随着边缘计算普及,模型优化将成为AI部署的关键环节。
【内附代码与数据集】【深大算法设计与分析】实验五 寻找图的桥边
$W_{int8} = \text{round}\left(\frac{W_{fp32}}{s}\right) + z$$ 其中缩放因子$s=\frac{\max(|W|)}{2^{b-1}-1}$RT-DETR作为实时目标检测的突破性模型,其核心瓶颈在于计算复杂度。此方案在保持检测精度的同时,显著突破实时性瓶颈,适用于自动驾驶、工业质检等场景。:将FP32权重/激活值映射到低比特表示。:移除冗余
核心概念:张量是PyTorch的基础数据结构,通道是特征维度,卷积层负责提取特征,参数是模型需要学习的权重;MobileNetV2实战:核心流程为「数据加载→模型定义(适配任务)→损失/优化器→训练循环→测试→推理」;关键操作:训练时用,推理时用,参数更新依赖反向传播和优化器.step()。通过这份教程,你不仅能跑通完整的MobileNetV2训练推理代码,还能理解深度学习的核心基础概念。
**深度学习模型剪枝: Pcdet-PointPillars 剪枝流程及结果**1.Pcdet-PointPillars原始模型结构 网络部分包含4部分: (1)PillarVFE (2)PointPillarScatter
周志华老师西瓜书《机器学习导论》第4章 决策树部分:主要用信息熵决定划分标准,剪枝防止过拟合,对连续值和缺失值进行处理,对节点划分加上权重。
从零读懂激光雷达:从核心原理到产业落地,一文搞懂智能时代的“三维火眼金睛”当我们谈论自动驾驶、机器人导航、高精度测绘时,总会绕不开一个核心传感器——激光雷达(LiDAR)。它被称作机器的“三维眼睛”,能把现实世界精准复刻成三维点云,让冰冷的机器真正“看清”周围环境的每一处细节。但对很多人来说,激光雷达依然是个“熟悉的陌生人”:只知道它是车顶上那个会转的器件,却不懂它的工作原理,分不清905nm和1