模型优化系列——模型剪枝——剪枝算法框架OTOv2
[2303.06862] OTOV2: Automatic, Generic, User-Friendly (arxiv.org) https://arxiv.org/abs/2303.06862论文👆
代码:https://github.com/tianyic/only_train_once
新版代码:https://github.com/microsoft/only_train_once
OTOV2: AUTOMATIC, GENERIC, USER-FRIENDLY
Only-Train-Oncev2(OTOv2):从头开始自动训练和压缩通用DNNs(Deep Neural Networks)一次,生成更紧凑的模型,具有竞争性的性能,且无需微调。
使用:
from only train once import OTO
# General DNN model
oto = OTO(model)
optimizer = oto.dhspg()
# Train as normal
optimizer.step()
oto.compress()
主要改进:

1.自动利用DNN的依赖关系,将可训练变量划分为零不变组ZIG(最小去除结构,如果它们的参数为零,则可以安全的删除且不影响网络输出),并构建压缩模型;
2.双半空间投影梯度Dual Half-Space Projected Gradient(DHSPG):一种优化器,用于解决结构性稀疏的问题,计算在ZIG上兼具高性能和群稀疏性的解;(用于共同识别冗余的ZIG)
主要贡献:
1.一种图算法:自动ZIG分区和模型压缩算法:自动利用DNN的变量将其划分为ZIG(需要一起修剪的最小参数组),再通过DNN的层次结构自动构建压缩模型,并将其对应的ZIG的结构消除
2.优化算法:双半空间投影梯度(DHSPG):该优化算法应用于自动压缩,DHSPG通过在双半空间的交集内构建一个方向,将约束稀疏优化问题形式化,确保客观收敛和冗余群识别的进展。DHSPG在扩大搜索空间、减少超参数调整和控制稀疏性方面优于OTOv1的HSPG。
具体方法:
自动分区ZIG:
ZIG:当且仅当无法将删除结构进一步分解为多个删除结构时,该删除结构为最小,称为最小删除结构;如果它们的参数为零,则向下产生零输出称为ZIG,可以直接删除且不会影响网络输出。(每个ZIG都由一组需要修剪的最少变量组成,并主导大部分DNN结构)。
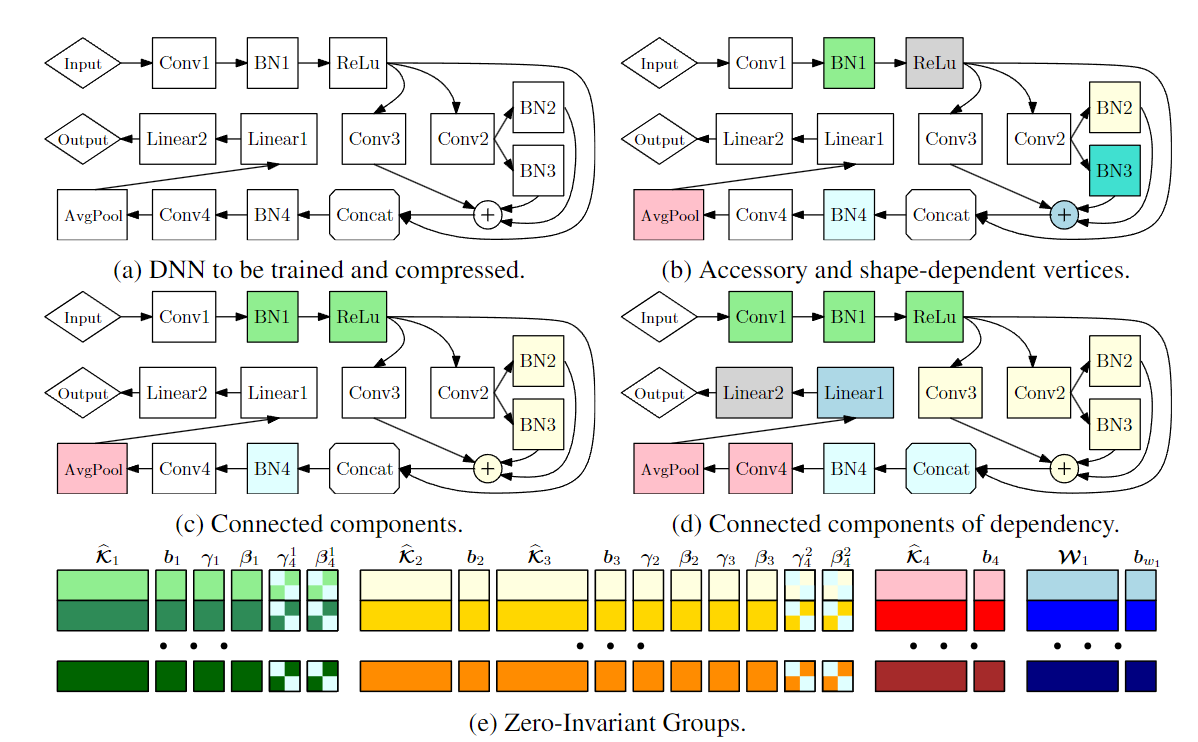
自动利用ZIG流程:
虽然ZIG适用于通用DNN,但由于连接复杂,拓扑机构差异可能很大,构成挑战。上图展示了 OTOv2 中自动 ZIG(Zero-Invariant Group)划分的流程,其中每个子图分别代表的含义是:
- a:展示了需要训练和压缩的 DNN 结构。
- b:标识了辅助和形状依赖顶点。
- c:展示了连通分量。
- d:展示了依赖关系的连通分量。
- e:最终形成的 ZIGs,其中不同颜色表示不同的 ZIG 组(其中:BN4 的参数(γ4 和 β4)依赖于来自 Conv1-BN1-ReLu 和 Conv3+Conv2-BN2|BN3 的连接,因此其参数被分割并分别添加到相应的组中。)
其中e图中的参数含义如下:
K 矩阵:每个卷积层都有一个滤波器矩阵 K,形状为 [out_channels, in_channels, kernel_height, kernel_width]。例如,Conv1 的 K 矩阵表示该层的滤波器参数。
b 向量:每个卷积层的偏置向量 b,形状为 [out_channels],用于对卷积输出进行偏置调整。
γ 和 β 向量:批量归一化(BatchNorm)层的缩放和偏移参数。γ 用于缩放归一化后的输出,β 用于偏移。每个 BN 层的 γ 和 β 向量的形状均为 [num_features]。
W 矩阵:全连接层的权重矩阵,形状为 [out_features, in_features]。例如,Linear1 的 W 矩阵表示该层的输入到输出的权重。
b 向量:全连接层的偏置向量,形状为 [out_features],用于对全连接层的输出进行偏置调整。
以下是对该流程的详细解释:
1. 构建追踪图(Trace Graph):首先构建目标 DNN 的追踪图(ℰ, 𝒱),其中每个顶点(Vertex)表示一个特定的操作符(Operator),边(Edge)表示它们之间的连接关系。
2. 分类顶点:将顶点分为以下几类:
Stem 顶点:具有可训练参数且能够改变输入张量形状的操作,如卷积(Conv)和全连接(Linear)层。
Joint 顶点:聚合多个输入张量的操作,如加法(Add)、乘法(Mul)和拼接(Concat
Accessory 顶点:对单个输入张量进行操作的节点,可能具有可训练参数,如批归一化(BatchNorm)和激活函数(ReLu)。
Unknown 顶点:执行不确定操作的节点。
3. 发现连通分量:将所有辅助(Accessory)、形状依赖(SD)联合(Joint)和未知顶点连接起来,形成一组连通分量(Connected Components, C)。
4. 扩展连通分量:扩展连通分量 C,直到其传入节点为 Stem 或形状无关(SID)联合顶点,并在有交集时合并连通分量。
5. 合并连通分量:根据连通分量之间的依赖关系,合并具有交集的连通分量。
6. 形成 ZIGs:基于连通分量的依赖关系,将同一连通分量内的 Stem 顶点的参数对进行分组,并将相关联的辅助顶点的参数插入到相应的组中,形成 ZIGs(G)。
输出:ZIGs:最终形成的 Zero-Invariant Groups,这些组表示可以一起剪枝的最小组参数集合。
通过上述步骤,OTOv2 能够自动识别 DNN 中的 ZIGs,从而实现自动化的模型剪枝和压缩。
自动ZIG总结:
提出的自动化 ZIG 分区算法 是一系列专门组合在一起的定制图算法。深入地说,每个单独的子算法都是通过深度优先搜索递归遍历 DNN 的跟踪图并执行特定步骤实现的,最坏的情况下:时间复杂度和 𝒪(|𝒱|+|ℰ|) 空间复杂度 𝒪(|𝒱|) 。前者是通过在线性时间遍历一次邻接列表来发现每个顶点的所有邻居来计算的。后者是因为 DNN 的跟踪图是非循环的,因此内存缓存消耗量达到非循环图可能的最长路径长度,如 |𝒱| 。因此,可以在线性时间内高效地完成自动 ZIG 分区。
双半空间投影梯度:Dual Half-Space Projected Gradient (DHSPG):
在给定算法构建出ZIG后,需确定哪些组是多余的,需要删除,并训练剩余的组以实现高性能。
需要:构建了一个结构化稀疏性优化问题,并通过一种新颖的 DHSPG 来解决它。与 HSPG 相比,DHSPG 构建了一个双半空间方向,具有自动选择的正则化系数,以更可靠地控制稀疏性探索,并通过将 ZIG 划分为单独的集合来扩大搜索空间,以避免在原点周围捕获,从而更好地泛化。
结构化稀疏性问题建模:
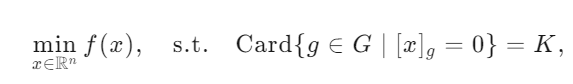
其中,K是目标组稀疏度,表示需要将多少组参数投影为零,G是预先划分好的零不变组(ZIGs)。
优化过程:
1.变量分组:将参数变量分为两组,一组是需要对其施加稀疏性约束的组 Gp,另一组是不受稀疏性约束的组 Gnp。分组依据通常是参数的显著性,如梯度方向与参数方向的余弦相似性,显著性高的组更有可能被保留。
2.梯度更新:
1)对于不受稀疏性约束的组 Gnp,直接使用随机梯度下降(SGD)或其他变体(如Adam)进行更新,公式为: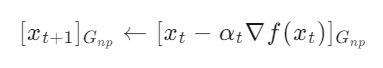
2)对于受稀疏性约束的组 Gp,通过求解一个非约束子问题来逐渐减小参数的模长,但不直接投影到零,直到投影操作能带来目标函数的下降。具体来说,是通过构造一个包含正则化项的代价函数 ψ,并利用次梯度下降法来更新参数: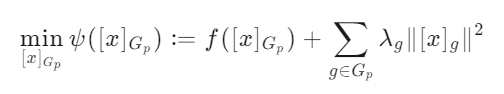
其中,λg是组特定的正则化系数,用于平衡目标函数和参数模长的减小。
3.半空间投影:在更新受稀疏性约束的组 Gp 的参数后,执行半空间投影操作,将参数投影到满足稀疏性约束的可行域内。该投影操作基于参数和梯度的方向关系,确保参数的更新方向既有利于目标函数的下降,也有利于稀疏性的提升。
结构化稀疏要让模型里的参数 “有规律地变少”(区别于 “乱删参数” 的非结构化稀疏)。比如图里的二维参数空间,我们希望通过约束,让参数朝着 “更稀疏” 的区域(比如靠近原点 \(\mathcal{O}\))移动,同时还能保证模型效果。
但直接 “删参数” 会破坏模型,所以需要用数学优化的方式,让参数在训练过程中 “主动变零”,同时不影响模型性能。这就是 DHSPG(双半空间投影梯度)这类方法的作用。
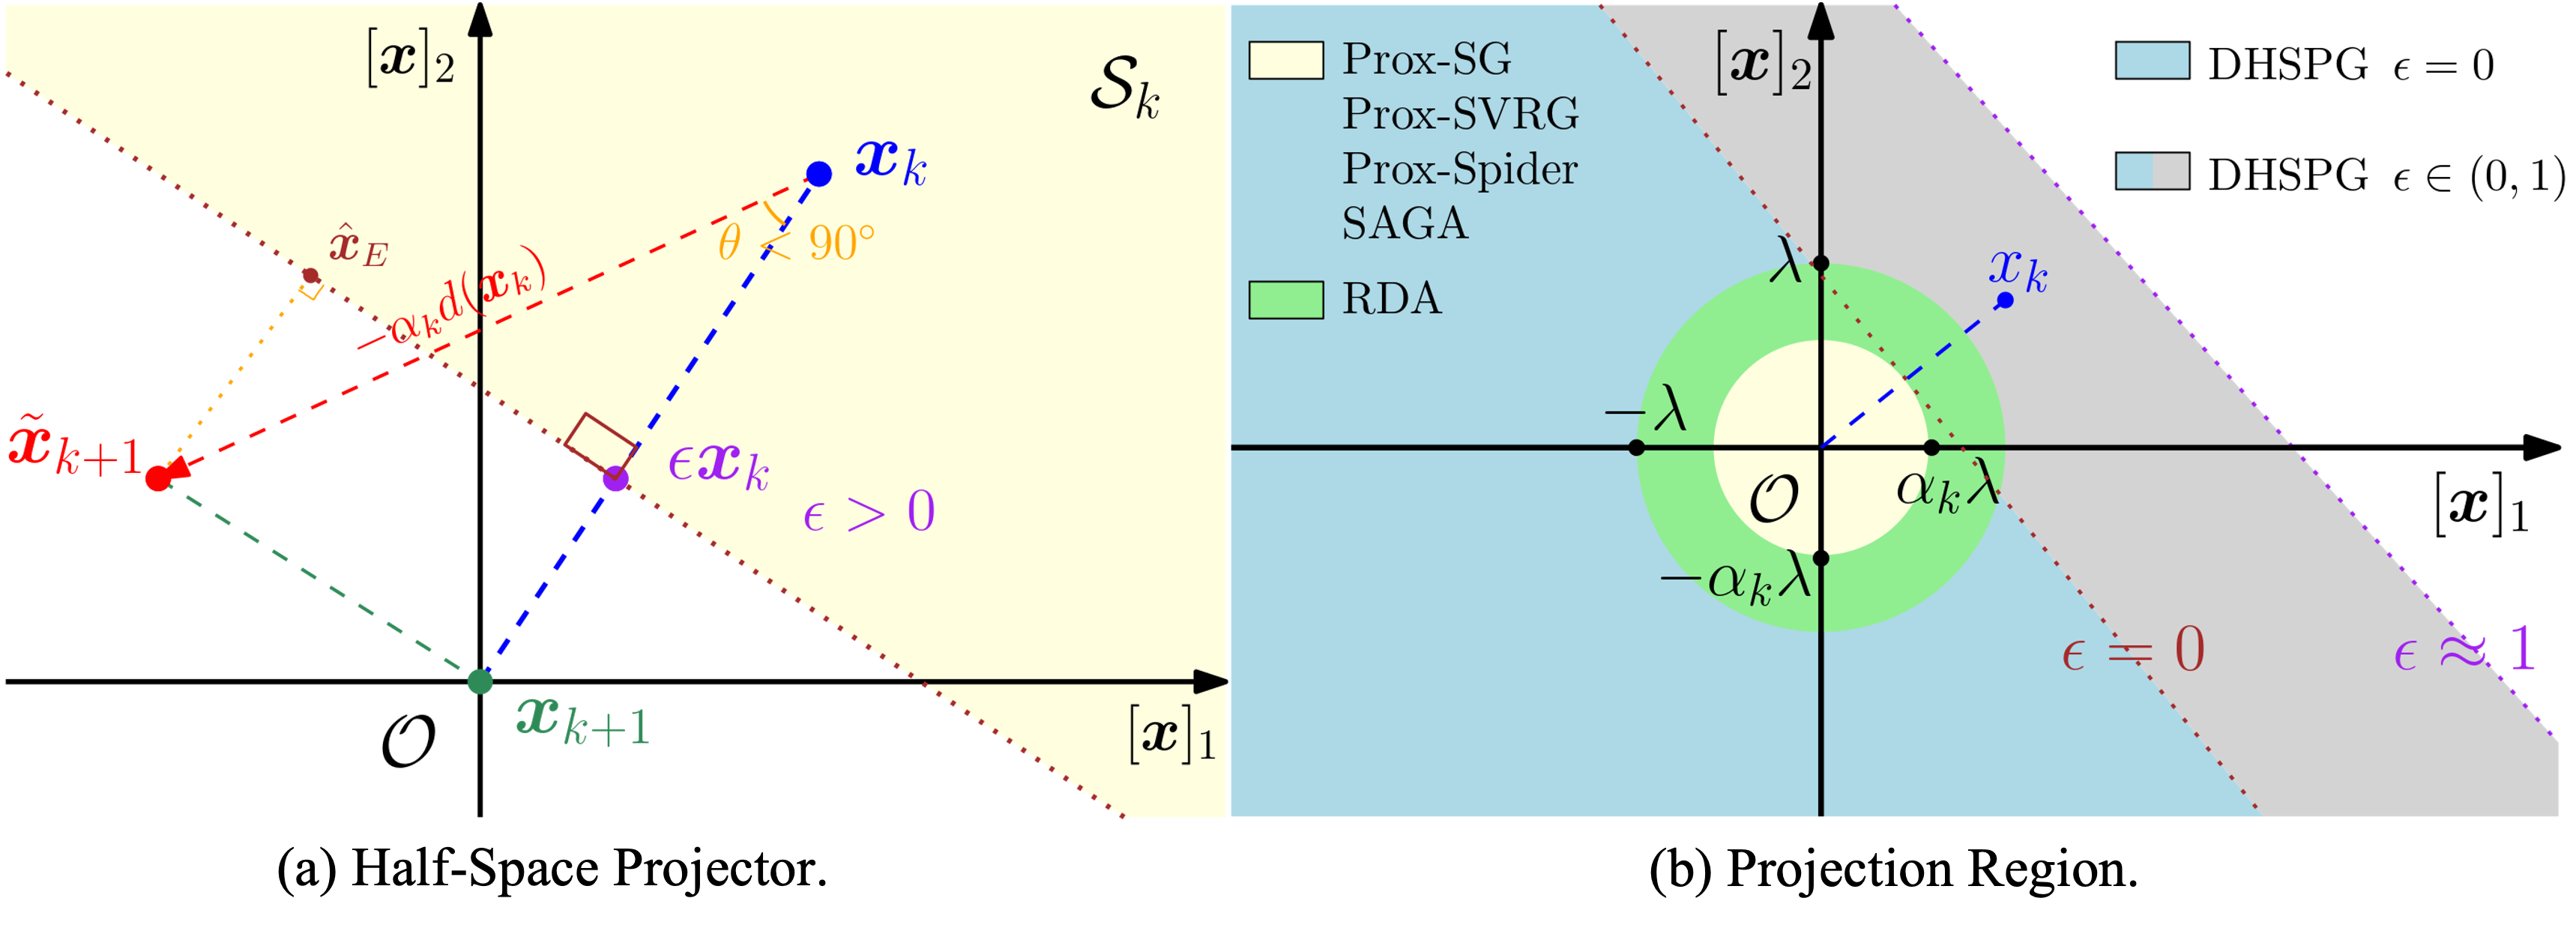
从图 (a) 理解 “半空间投影器”(Half-Space Projector)
这张图展示了 参数更新时如何被 “约束到稀疏区域”,核心看这几个元素:
:当前模型的参数(比如某一层的权重)。
:梯度下降的更新方向(想让参数往这个方向走,降低损失)。
:额外的约束项(让参数 “往零的方向走”,诱导稀疏)。
:更新后的 “试参数”(还没投影)。
:投影后的 “最终参数”(满足稀疏约束)。
“半空间” 是说,参数更新的方向 必须同时满足两个条件(对应图里的阴影区域 :1.跟着梯度走(保证模型效果):更新方向要和 “负梯度” 方向一致(夹角
,这样参数更新才能降低损失函数
。2.朝着零走(诱导稀疏):更新方向还要和 “负参数” 方向一致(比如图里的
项),让参数尽可能变小,甚至变零。
从图 (b) 理解 “投影区域”(Projection Region)
这张图展示了 不同约束下,参数被允许的更新范围,核心看这些区域:
(浅蓝色):当
时,约束更宽松,参数更新范围大一些,但诱导稀疏的能力弱。
(浅灰色):当
取 0~1 之间的值时,约束更严格,参数被 “推” 向原点
的力度更大,稀疏性更强。
- 绿色圆环:表示参数的 “有效范围”,超出这个范围的更新会被投影拉回来。
关键逻辑:用 控制稀疏强度
是一个超参数,控制 “让参数变零的力度”:
实际训练中,会根据任务调整 ,找 “模型效果” 和 “稀疏性” 的平衡。
具体的:在DHSPG中,这个操作用于将参数向量投影到满足稀疏性约束的可行域内。具体来说,是基于参数和梯度的方向关系,将参数更新到一个有利于目标函数下降和稀疏性提升的半空间内。
1).确定半空间:对于受稀疏性约束的组 Gp 中的每个参数组 g,根据参数的当前值 [x]g 和梯度 [∇f(x)]g 的方向关系,确定一个半空间。这个半空间由一个超平面划分空间,超平面的法向量通常与梯度方向相关。例如,超平面可以定义为满足 [x]g⊤[∇f(x)]g=0 的点的集合,这个超平面将空间划分为两个半空间:一个半空间中的点与梯度方向的夹角小于90度,另一个半空间中的点则大于90度。
2)投影到半空间:将更新后的参数 [x]g 投影到上述确定的半空间内。投影的方式通常是将参数沿着梯度方向移动,使其满足一定的条件。具体操作可以是将参数更新为 [x]g−α⋅[∇f(x)]g,其中 α 是学习率,这一步类似于梯度下降,但它是在半空间内进行的。在投影过程中,如果某个参数组的值足够小,可以将其直接投影到零,从而实现稀疏性。这一步类似于硬阈值操作。
优势作用:
更可靠的稀疏度控制:DHSPG通过自动选择正则化系数和将变量分组,能够更可靠地控制最终的稀疏度水平,避免了因正则化系数选择不当导致的稀疏度不足或过度稀疏问题。扩展搜索空间:通过将变量分为不同的组并采用不同的更新策略,DHSPG能够在更广泛的搜索空间中寻找最优解,避免了传统方法容易陷入局部最优的问题。高效性:DHSPG在训练过程中只需进行一次模型训练,无需像其他方法那样进行多次预训练、剪枝和微调,显著减少了计算资源和时间成本。
自动压缩模型:
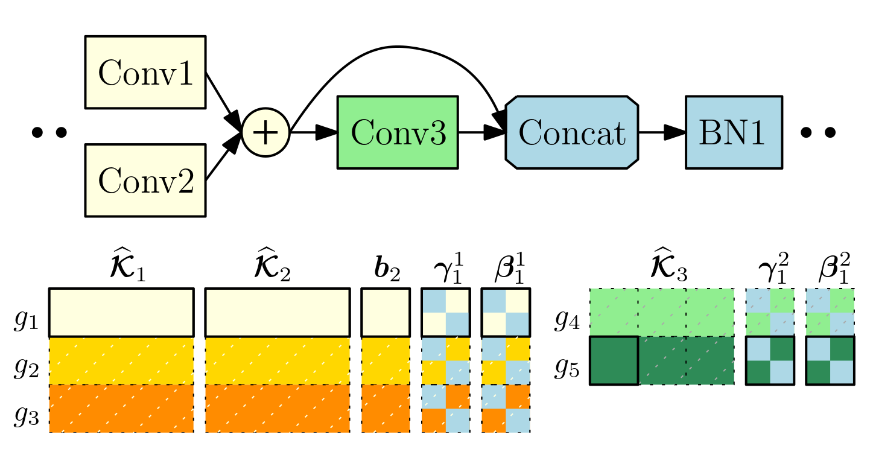 图中展示了如何根据稀疏解 xDHSPG∗ 来移除冗余的模型结构。例如,某些卷积层的滤波器(如 K1、K2、K3 的特定行)和相关的偏置、归一化参数(如 b2、γ1、β1)会被移除。移除这些结构后,模型的图结构被更新,以反映新的、更紧凑的模型架构。
自动压缩模型的算法能够在线性时间内完成,这得益于两次深度优先搜索和参数操作。这使得OTOv2能够高效地生成紧凑模型,而无需用户进行繁琐的手动操作。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 27
 0
- 0


 已为社区贡献1条内容

所有评论(0)