登录社区云,与社区用户共同成长
邀请您加入社区
本文系统阐述了Python工程化进阶核心知识点,涵盖GIL机制对并发的影响、多进程(spawn/fork/forkserver)与异步I/O在机器人开发中的应用,详解多进程通信方式及选型策略。深入解析装饰器原理、生成器内存优化机制、迭代器协议与yield from的使用场景,并介绍内存管理、循环引用解决(weakref)、内存泄漏调试等高级技巧。结合实际案例,如相机数据采集、HDF5大文件读取、算
2024年9月18日Figure公司发布Figure 02,其跳入熔炉动作验证了端到端神经网络的控制精度。本文解析视觉语言动作模型技术细节,剖析端到端架构对传统控制的替代方案,并提供基于OpenVLA与PyTorch的实操代码及环境配置命令,指导开发者在仿真环境中验证推理逻辑,探讨普通技术人员接入具身智能技术栈的具体路径。
这里用已经预训练好的开源模型openvla-7b-finetuned-libero-spatial来做测试,目的仅仅只是看eval脚本能不能运行,数据指标和演示视频能否被记录,从而验证evaluation pipeline能否正常工作。在之前几个训练步的测试中的失败案例在肉眼看来大多都是机械臂完全静止,为区分到底是环境未执行动作还是和模型输出无效动作,从 7.5k 开始,在 eval 中加入了ep
VLA 如何把图像与语言变成机器人动作?本文使用 LeRobot 加载 SmolVLA 预训练策略,在本地 RTX 4080 Laptop GPU 上完成最小离线推理实验:以三路合成桌面图、零状态和语言指令为输入,生成 [1,50,6] 动作片段,检查数值、固定输入重复性及指令变化影响。提供完整代码、模型版本和实测耗时、显存数据,并解释动作片段、归一化与机器人控制的区别。实验不涉及训练和真机抓取,
D4PG (分布式分布深度确定性策略梯度) 从四方面改进 DDPG:用概率分布替代评论家的单一Q值输出、引入n步贝尔曼方程加速收敛、采用优先经验回放提升样本效率,并简化探索机制为高斯噪声。其评论家输出51个原子概率,训练时通过贝尔曼投影与交叉熵损失对齐分布,演员训练则借助分布转Q值。在四足机器人任务上,D4PG平均奖励从 DDPG 的4.5提升至近 18,收敛更快、性能更优。
用Docker部署 Milvus 单机版;实现统一 Embedding 抽象,兼容 OpenAI 与本地模型;完成记忆的分块、写入、索引构建与语义检索;接入大模型,打通RAG 问答;增加记忆回流机制,让私人知识库持续增长;最终封装成一个可直接运行的CLI 私人记忆助手。这套代码稍加扩展就能变成浏览器插件、微信机器人或者本地笔记工具的记忆后端。向量数据库 + 大模型的组合正把「AI 懂你」从口号变成
机械臂完成切割任务需解决工具安装、视觉定位、坐标转换、运动规划与双臂协同等问题。本文以刀具固定安装为起点,探讨如何通过手眼标定实现刀尖精准定位,并构建从视觉感知到动作执行的完整链路,为后续力控与协同操作奠定基础。
本文详细介绍了深度确定性策略梯度 (DDPG) 算法的核心原理与实现细节。与传统的随机策略方法不同,DDPG 通过确定性策略网络直接输出动作值,并借助评论家网络估计Q值,利用链式法则实现端到端的策略优化。为应对确定性策略带来的探索不足问题,我们引入了 Ornstein-Uhlenbeck 过程生成时间相关的探索噪声。实验结果表明,在四足机器人控制任务上,DDPG 显著优于 A2C 方法,这些优势使
获取《PyTorch计算机视觉与深度学习》全套PPT课件2026::https://download.csdn.net/download/m0_54748666/93356453。第09章基于生成式对抗网络的图像生成应用.pptx。第07章基于视觉大数据检索的图搜图应用.pptx。第12章污损遮挡号牌识别与违法行为检测.pptx。第04章 PyTorch的基本应用.pptx。第03章卷积神经网络的
摘要:本文提出了一种基于改进型时序卷积网络(TCN)的变压器振动-电压预测方法。通过多MATLAB文件加载不同电压等级的振动数据,采用9:3:4比例划分训练/验证/测试集,并进行归一化处理。网络采用多尺度因果膨胀卷积架构,包含两层初始卷积层和多个TCN块,通过指数增长的膨胀率捕获不同时间尺度特征。使用AdamW优化器配合动态学习率调整策略训练模型,并采用多种评估指标验证性能。实验结果表明,该方法能
手把手教你用PyTorch在树莓派5上搭建实时人脸追踪系统,涵盖模型部署与优化技巧。结合pytorch和树莓派5的高效性能,实现低延迟目标检测应用,适合初学者快速入门边缘计算场景下的视觉项目。
*
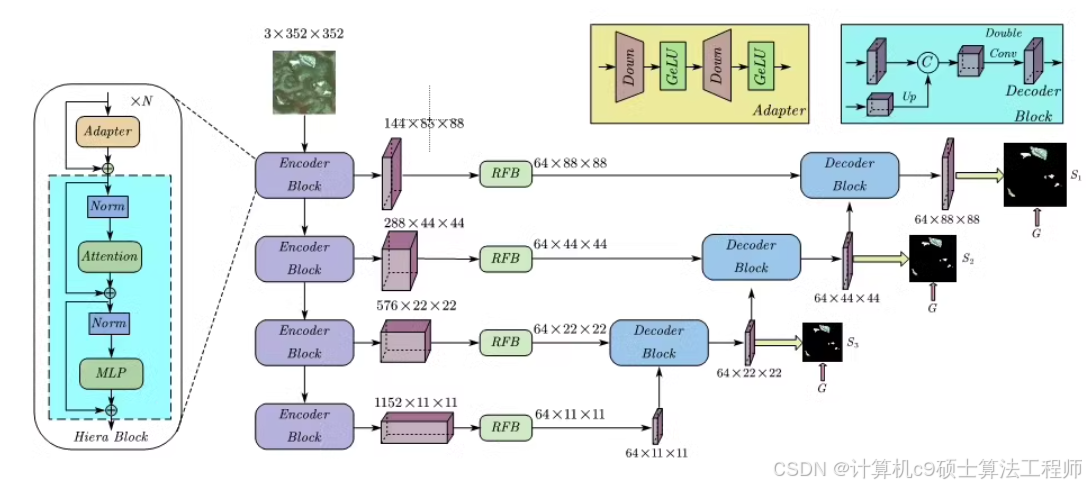
1.现有几个优秀模型结构的演变原理,包括AlexNet,VGG,googleNet,ResNet,DenseNet等模型2.从模型演变中讲解实际训练模型的技巧3.讲解针对数据的优化策略4.讲解针对模型的优化策略5.讲解针对训练过程的优化策略6.讲解针对检测任务的优化策略7.讲解针对分割任务的优化策略8.提供一些常用的检测,分割数据集的标注工具。(1)讲解数据集的准备和处理(2)遥感影像划分成小图像
本文介绍了使用自定义数据集训练SlowFast模型的过程,重点阐述了数据准备的关键步骤。作者通过视频抽帧、VGGImageAnnotator手动标注、VIA格式到AVA格式转换等环节准备训练数据,并详细说明了配置文件生成方法。最终成功运行模型训练,同时解决了视频起始时间不匹配的问题。整个过程突显了自定义数据集准备的重要性和复杂性,为SlowFast模型的个性化应用提供了实践参考。
本文系统探讨了时间序列预测的关键技术与方法,重点分析了监督学习、支持向量机和随机森林在时间序列建模中的应用。通过对比传统统计方法与机器学习方法,文章揭示了机器学习在非线性建模和特征自动提取方面的优势。同时详细介绍了集成学习方法(Bagging、Boosting、Stacking)在时间序列预测中的优化策略与应用场景,并提供了Python实现示例。文章也客观分析了机器学习方法的局限性,包括数据依赖性
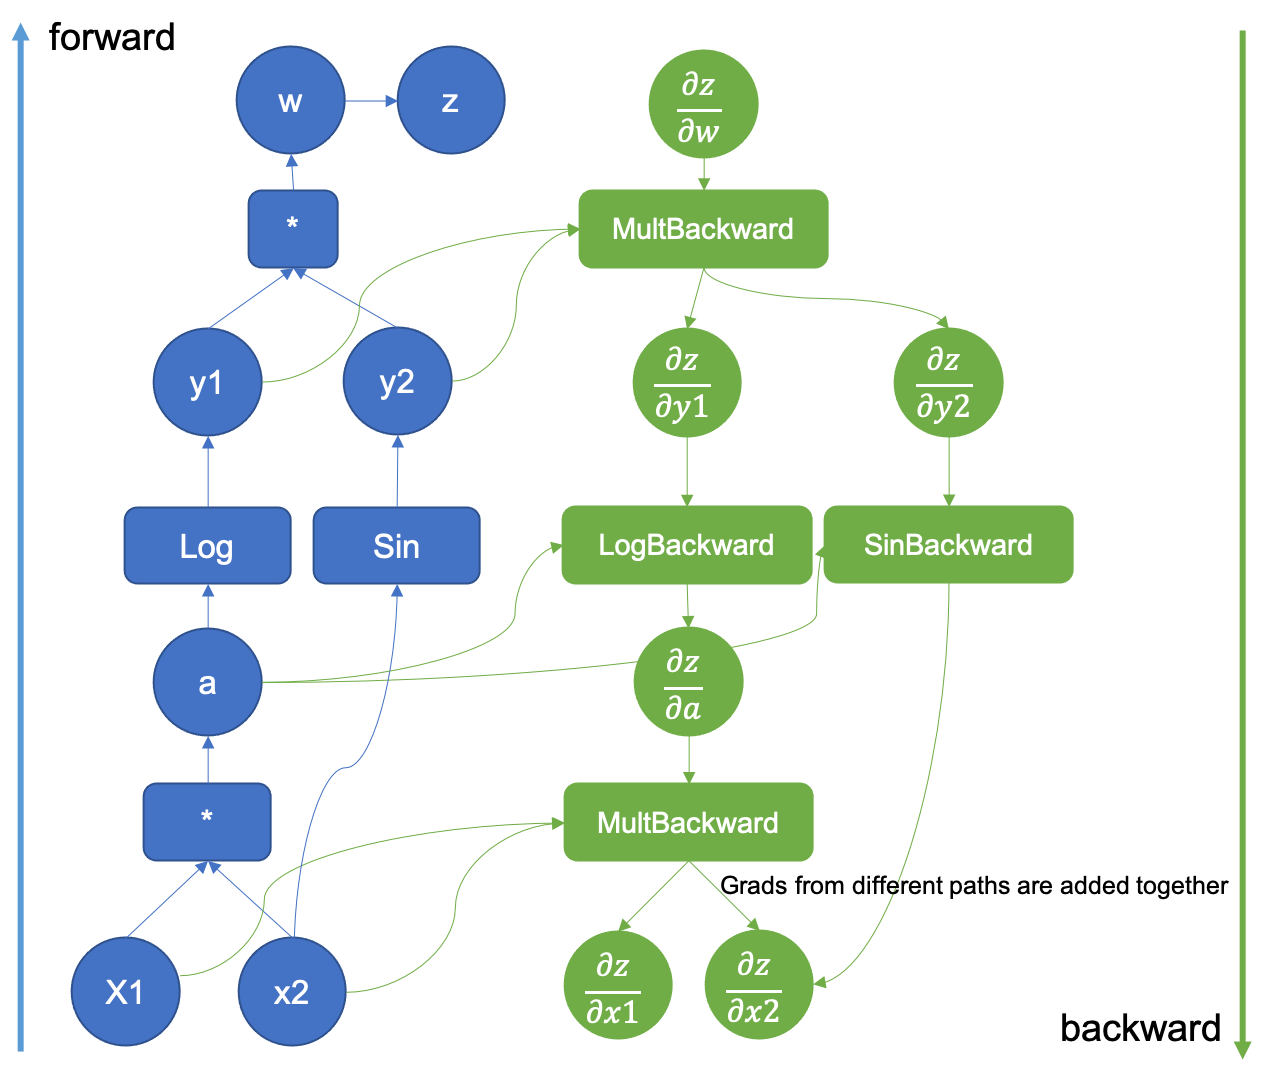
仔细分析PyTorch的代码可以发现,我们定义了x,y需要计算梯度,然后定义了计算的流程。我们只要调用结果z的反向传播方法,PyTorch内部会根据计算图反向传播,计算梯度。最终打印出的x和y在(1,1)点的梯度和我们手动计算的梯度值是完全一致的。再回顾一下上边这个简单的例子,我们需要分析自变量和因变量的关系,保存计算图。下边,我们需要计算梯度,分别对x和y求偏导。利用PyTorch里的自动求梯度
这个实现采用了经典的分类方法进行人脸识别,通过训练一个多类分类器,使得同一个人的特征向量在特征空间中接近,不同人的特征向量远离。在实际应用中,还可以进一步改进,例如使用 Triplet Loss 或 ArcFace 等更先进的损失函数来优化特征空间。人脸识别是模式识别和计算机视觉领域的重要研究方向,其目标是从图像或视频中识别出特定个体的身份。如果需要使用这个程序,只需确保数据集路径正确,然后运行代
导入必要的库# 设置matplotlib以正确显示中文# 加载数据print("--- 原始数据预览 ---")# 绘制时序图plt.title('1959年加州每日女性出生数量')plt.xlabel('日期')plt.ylabel('出生数量')plt.show()从图上看,数据点在一个稳定的水平线(大约40)上下随机波动。没有明显的上升或下降趋势,也没有看到以周或月为单位的固定模式。这给一个
2025年北京智源大会 · PyTorch Day China 论坛上,PyTorch 基金会执行董事 Matt White 宣布高性能通用 AI 算子库 FlagGems 项目获得批准,正式加入 PyTorch 生态项目体系。Pytorch基金会于6月26日在推特上进行了官方宣布。作为唯一支持多种AI芯片架构的算子库,FlagGems 的加入加速了 PyTorch 实现“的技术创新。
乖狗狗是谁?谁喜欢挠耳朵呢?看来那些复杂精密的深度神经网络也并非无所不能。不过,它们或许能解答我们遇到四条腿新朋友时都会问的那个经典问题:这到底是只什么品种的可爱小狗呢?由此,本项目诞生了。在这项目中,我们使用了ImageNet数据集中严格筛选的犬类子集,用以练习细粒度图像分类。面对120个犬种且每个品种训练图像有限的挑战,我们将交出我们的答卷。
环境:PyCharm + python3.8。
中文唇语识别系统构建摘要:基于LRW-1000(CAS-VSR-W1k)数据集开发中文唇语识别系统,该数据集是目前最大的公开中文唇语数据集,可用于数字人和Wav2Lip等应用。系统实现包含数据预处理、模型训练和评估全流程。采用AV-Sync模型架构,通过视频帧提取和音频特征处理实现多模态识别。代码提供完整的数据加载、模型定义及训练配置,支持GPU加速。环境需Python 3.8+和PyTorch等
PyTorch 是目前最流行的深度学习框架之一,以其动态计算图、灵活的模型构建方式和强大的 GPU 加速能力广受研究人员和工程师的青睐。PyTorch 的成功离不开其精心设计的核心类,这些类构成了深度学习模型训练和部署的基础。本文将深入剖析 PyTorch 的关键类,包括 Tensor、Module、Optimizer、Dataset 等,帮助读者掌握 PyTorch 的核心机制,并学会如何高效地
其中train_LPRNet.py里面,因为官方的时间比较久,有一点要改的,还有就是会遇到命令行输入参数格式不对,要在参数输入的地方写一下限制的格式,我修改的贴在下面了。5、输入下面的开始训练,使用tail -f train_log.txt查看实时日志,我随便拿1000张数据跑通训练流程,配置参数可选。3、测试环境是否搭建好,在LPRNet_Pytorch-master目录下输入:python t
本文介绍了YOLOv8目标检测算法的核心架构、创新点及应用。YOLOv8采用单阶段检测器设计,通过Backbone、Neck和Head三部分结构实现高效特征提取和检测,相比YOLOv5计算效率提升15%。其创新点包括Anchor-free机制、动态标签分配策略和改进的损失函数设计,尤其是新增的DistributionFocalLoss有效提升了小目标检测精度。该算法在移动端可实时运行,支持模型压缩
摘要:论文提出CycleNet模型用于增强时序预测中的周期性建模,但其核心假设(所有样本共享相同周期模式)在工业场景中存在严重缺陷。实验显示,由于真实工业负载数据中周期模式不一致且非理想正弦波,模型学习到的周期参数Q基本沦为噪声,导致预测效果远差于对比方法DLinear。这表明CycleNet的严格假设使其难以在真实工业时序数据上实现可靠预测。
。
else:# 初始化模型。
本文介绍的DeepSeek-TS方法利用 GRPO 结合使用 Mamba 风格状态空间更新的扩展 MLA 模块。实验表明,这个 GRPO 启发模型可以实现更好的性能 - 更低的MAPE - 比简单的GRU模型和经典的ARMA方法。由策略分支和状态更新中的非线性激活驱动的增强潜在表示似乎能更有效地捕获销售数据的复杂动态。GRPO 和扩展 MLA 框架在应用于其他领域方面具有巨大潜力。例如,这种方法可
以上就是今天要讲的内容,本文简单介绍了计算机视觉任务以及模型的剪裁、量化、蒸馏。
调整visio studio python运行版本。运行modelscope样例脚本。1.部署model scope。部署transformer。升级pip到最新版本。
张量是PyTorch中的核心数据抽象PyTorch中的张量就是元素为同一种数据类型的多维矩阵,与NumPy数组类似。PyTorch中,张量以"类"的形式封装起来,对张量的一些运算、处理的方法(数值计算、矩阵操作、自动求导)被封装在类中。
VGG-16(Visual Geometry Group-16)是由牛津大学视觉几何组(Visual Geometry Group)提出的一种深度卷积神经网络架构,用于图像分类和对象识别任务。VGG-16在2014年被提出,是VGG系列中的一种。VGG-16之所以备受关注,是因为它在ImageNet图像识别竞赛中取得了很好的成绩,展示了其在大规模图像识别任务中的有效性。
FaceNet通过将人脸图像映射到一个高维空间,使得同一个人的不同图像在这个空间中的距离尽可能小,而不同人的图像距离尽可能大。以下是facenet的python代码,注意需要更改下面的一条程序"cuda" False,因为t527使用的是cpu,芯片到时自带gpu但是cuda用不了,因为cuda是英伟达退出的一种计算机架构。运行程序,提示killed,系统杀死了本程序的运行,经过多方面的测试,最终
在这一节里,会为大家整体介绍2024年的时间序列一些具有突破性进展的领域。后续章节将持续在知识星球中更新,深入解读和串联这些领域的相关工作。
虽然用网页标注导出来的image和TXT文件的名称是一致的,但为了避免在后续格式转换中出现冲突,现在需要将image图片和txt文件重新命名。生成的训练集txt和验证集txt,里面的图片名称(去掉后缀)的分配是随机的。三个修改地方:修改类为Seg552Segmentation,修改类别数、数据集名称。修改–in-path为数据集的测试图片,结果保存在–in-path中。该代码进行得到的文件,就是我
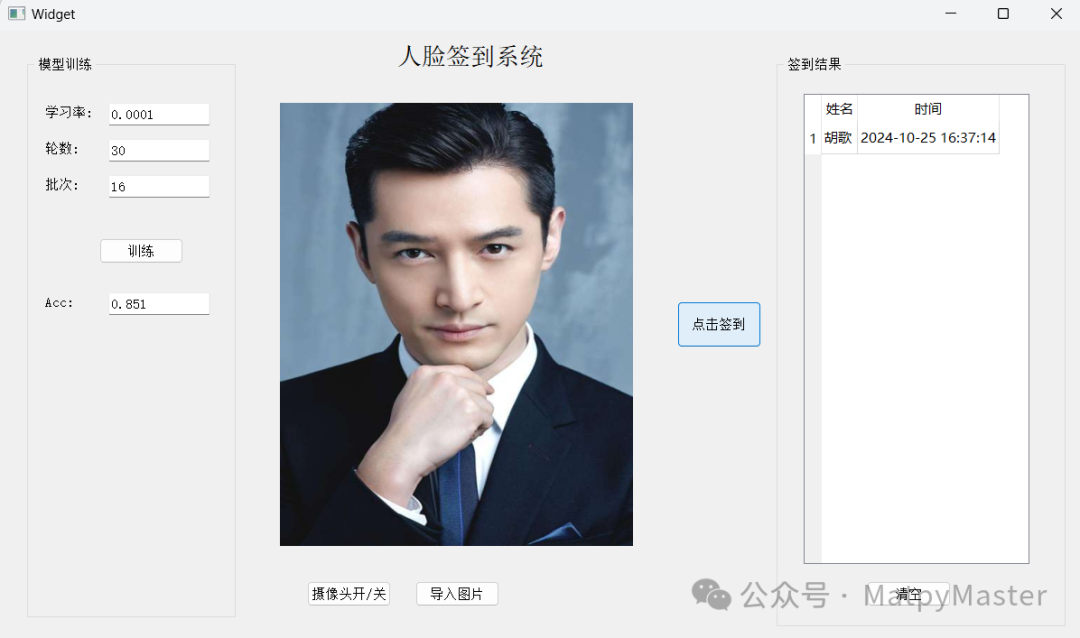
将数据按照8:2分成训练集和验证集,保证模型在训练阶段和验证阶段都能得到合理的评估。选用了ResNet152模型,并根据数据集的类别数量替换了最后的分类层,以确保模型可以识别多个人脸类别。如果人脸被识别,系统将在界面右侧显示签到人的信息和签到时间。本次使用明星做为数据集,首先编写爬虫函数,根据关键字爬取对应的明星,爬取结果保存至data文件夹,并以标签名作为文件名。训练结束后,界面将显示最佳准确度
为了实现Monte Carlo Dropout (MC Dropout),我们需要在模型评估阶段保留Dropout层的功能,而不是像通常那样在评估模式下关闭Dropout。这可以通过在预测过程中多次运行模型,并且每次运行时都启用Dropout来完成。
正如我们在上一节中所讨论的, 机器翻译是序列转换模型的一个核心问题, 其输入和输出都是长度可变的序列。 为了处理这种类型的输入和输出, 我们可以设计一个包含两个主要组件的架构: 第一个组件是一个编码器(encoder): 它接受一个长度可变的序列作为输入, 并将其转换为具有固定形状的编码状态。 第二个组件是解码器(decoder): 它将固定形状的编码状态映射到长度可变的序列。 这被称为编码器-解
在本篇文章,我们基于pytorch框架,构造了LSTM模型进行天气预测,并对数据进行了可视化分析,非常值得入门学习。该数据集提供了2013年1月1日至2017年4月24日在印度德里市的数据。数据集和完整可用的代码可以在后台回复"代码04"获取。
PyTorch 作为一个深度学习框架,经历了多个版本的迭代,带来了许多新特性、改进和优化。以下是 PyTorch 主要版本的发布历程以及关键更新。
口罩检测:使用预训练的 TensorFlow 模型来检测面部是否佩戴口罩。人脸检测:使用MTCNN检测人脸区域。特征提取:使用Facenet模型从人脸图像中提取特征向量。人脸识别:将提取的特征向量与已知人脸的特征向量进行对比,判断身份。模块化设计:该系统将口罩检测和人脸识别分离,确保每个功能模块可以独立运行。多任务神经网络:使用MTCNN和进行人脸检测与特征提取。灵活性:可以轻松扩展到更复杂的口罩
Cora 数据集由 2708 篇科学出版物组成,这些出版物被分为 7 个类别。节点代表论文,边代表引用关系。每个节点有一个 1433 维的特征向量,表示论文的词袋模型(Bag of Words),特征向量中的每个维度表示某个词汇是否出现在论文中。
在实践的过程中,我在其它博客里看到torchvision.datasets.FashionMNIST()的参数download=True代表了“目录下没有文件则自动下载”,但是我以为我指定的dataset目录下有那4个gz文件就已经算作目录下有文件了,所以最初尝试时把download参数指定成False了,但是这个时候程序报错说Dataset not found,然后我就继续把download又改
VGG-16在2014年被提出,是VGG系列中的一种。2. 卷积层的设计:VGG-16的卷积层全部采用3x3的卷积核和步长为1的卷积操作,同时在卷积层之后都接有ReLU激活函数。这种设计的好处在于,通过堆叠多个较小的卷积核,可以提高网络的非线性建模能力,同时减少了参数数量,从而降低了过拟合的风险。4. 全连接层:VGG-16在卷积层之后接有3个全连接层,最后一个全连接层输出与类别数相对应的向量,用
outputs = model(inputs)前向传播,model为实例化后的模型;loss = criterion(outputs, targets)计算损失,criterion为定义的损失函数;Pytorch自动求导机制会将梯度值累加,故要optimizer.zero_grad()清零,去掉以前的梯度值;loss.backward()反向传播,通过自动微分计算损失函数相对于模型参数的梯度;op
图中可以清晰地看到计算过程和梯度传递的可视化,包含了计算图的信息。在初学线性回归模型的时候,同样可以把手写的线性回归模型以计算图的形式可视化表示出来,可便于深入理解代码背后的计算过程。先定义的x是一个叶子节点,将所有Tensor节点的计算连接起来就可以用一个。使用方法:直接在make_dot()中传入待分析的Tensor变量即可,比如上面的例子。可以看到X,y,w,b都是计算图中的叶子节点,l表示
前言:开始处理视频数据,遇到了陌生又熟悉的3D卷积,但对其计算过程有点疑惑,网上也没找到什么可视化动画,所以研究明白并做个记录,方便日后复习。有点简化,但认真琢磨一下图片和代码肯定能看明白:)
DCGAN的实例教程,附完整代码!
🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/0dvHCaOoFnW8SCp3JpzKxg) 中的学习记录博客**🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)说在前面本周学习目标:保存训练过程中的最佳模型权重,调用官方的VGG-16网络框架;拔高——使得测试集准确率达到60%(难度稍微有些大),手动搭建