登录社区云,与社区用户共同成长
邀请您加入社区
ClickHouse是俄罗斯的Yandex于2016年开源的列式存储数据库(DBMS),使用C++语言编写,主要用于在线分析处理查询(OLAP),能够使用SQL查询实时生成分析数据报告。OLAP(On-Line Analytical Processing)翻译为联机分析处理,专注于分析处理,从对数据库操作来看,OLAP是对数据的查询;OLTP(on-line transaction process
ClickHouse 数据迁移与导入导出指南 本文全面介绍 ClickHouse 数据操作的多种方式: 数据导入 INSERT VALUES:仅适合小批量测试 INSERT SELECT:推荐表间迁移 命令行导入:支持 CSV/TSV/JSON 等格式 Kafka 引擎:实现实时流式导入 数据导出 INTO OUTFILE:服务端文件导出 命令行导出:灵活支持多种格式 外部系统导出:如 S3、HD
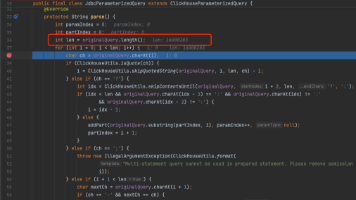
摘要:针对ClickHouse批量插入数据性能低下的问题,通过分析发现JdbcParameterizedQuery.parse方法循环解析SQL导致性能瓶颈。优化方案采用原生JDBC预编译SQL方式,实现高效批量插入。测试结果显示,优化后单次插入10万条数据仅需0.5秒,50万条仅2秒,千万级数据插入时间从几十小时缩短至200-300秒。文章详细介绍了优化过程,包括参数调整和核心代码实现(提供两种
一、背景介绍上一篇文章介绍了CDP中,面对单个标签或群体数十亿的数据如何存储CDP技术系列(一):使用bitmap存储数十亿用户的标签或群体我们都知道数据仓库的概念,它的里边存储了我们所有的数据,其中就包含了标签或群体所依赖的数据,但是这些数据并不能直接拿来使用,想要变成业务需要的标签或群体数据,还需要进行加工。数据工程师将数仓里的原始数据,经过一些列的数据作业加工成业务用户需要的源表,比如性
本文总结了如何使用使用 Clickhouse 保存日志数据,以及如何通过 Flink SQL 将我们的日志实时从 kafka 同步至 clickhouse,然后在结合强大的第三方查询 BI 工具 superset,玩转业务日志,挖掘业务日志的潜在价值。本文设计到的技能知识点比较多,需要熟悉 Clickhouse, Kafka, FlinkSQL, Superset 等,我之前的文章中总结了一些关于
springboot兼容clickhouse数据库多数据源配置(基于mybatis-plus)
ClickHouse安装, 使用与监控部署
作为国内规模最大的 ClickHouse 用户,目前字节跳动内部的 ClickHouse 节点总数超过 1.8W 个。综合来说,字节跳动广泛的业务增长分析很多都建立在 ClickHouse 为基础的查询引擎上。2021年8月,火山引擎基于字节跳动内部最佳实践,正式推出ByteHouse企业版,解决了开源技术上手难、试错成本高等企业数字化转型中遇到的技术痛点。在打造ByteHouse的路程中,我们经
目录1、更新包列表 2、运行安装脚本3、设置密码4、启动服务5、测试连接6、下载官方测试数据1、下载数据集直接执行以下代码2、创建数据库3、创建数据表(1)4、创建数据表(2)5、导入数据7、测试查询 8、远程连接3、设置密码4、启动服务6、下载官方测试数据1、下载数据集直接执行以下代码2、创建数据库3、创建数据
clickhouse的安装部署,简易Java示例,SpringBoot-MyabtisPlus集成,多数据源集成。
clickHouse在单独某几列的查询速度非常快,数据可压缩,索引使用稀疏索引的方式占用空间少。无事务,更新删除效率低。
Clickhouse数据库的特点和优势介绍,包括Clickhouse的结构原理、查询和写入性能、分布式架构、适用场景等的介绍。
指定交易所和股票代码,获取该只股票的日线基本行情(开、高、低、收、量)。默认返回全部历史数据,也可以使用参数start_date和end_date选择特定时间段。此接口可方便地获取全球股票的历史行情,可用于数据初始化。目前,已经覆盖全球30+国家地区,40+交易所,以及30年以上的历史数据,收录的股票数量超100000只
clickhouse有时会报表只读报错(“DB::Exception: Table is in readonly mode(replica path: /clickhouse/tables/xxxxxxxxx)”),需要对表进行修复
clickhouse的物化视图你用对了吗???原始数据量巨大:日志、事件流等数据以极高的速度写入。查询模式固定:分析师或仪表盘(Dashboard)总是对这些原始数据进行固定的聚合查询,例如:每分钟的网站访问量 (PV/UV)每个商品的日销售额每个接口的平均响应时间如果每次查询都直接扫描原始数据表,即使 ClickHouse 性能卓越,当数据量达到千亿甚至万亿级别时,查询延迟也会增加,计算资源消耗
对 tidb、clickhouse、hive 这几个数据库概念的了解
ClickHouse 的 MPP 架构 通过分布式并行计算、列式存储和向量化执行,实现了 “亿级数据秒级响应” 的性能。高性能:适合海量数据的分析型查询。高扩展:通过分片和副本轻松扩展存储和计算能力。易用性:通过 SQL 接口和分布式表透明化分布式计算。在实际应用中,合理设计分片策略、利用分区裁剪和预聚合,可以最大化 MPP 架构的性能优势。对于需要处理 PB 级数据的 OLAP 场景(如日志分析
摘要: Apache Doris与Model Context Protocol(MCP)结合,为AI Agent时代提供实时数据分析解决方案。Doris的高性能引擎(秒级写入、亚秒级查询)与Multi-Catalog功能(跨数据源联邦查询)解决了PB级数据处理的挑战;MCP协议则标准化AI与数据交互,支持动态发现与并行调用。通过智能查询拆分、缓存优化等技术,该组合将跨源查询性能从162秒提升至0.