登录社区云,与社区用户共同成长
邀请您加入社区
本文分享使用WeKnora搭建企业知识库并接入飞书机器人的实践流程,涵盖环境配置、模型设置、知识库创建、数据源自动同步、Langfuse监控及飞书机器人集成。重点解决图片识别与链接显示等踩坑问题,强调选用具备视觉能力的对话模型,并通过内网穿透工具实现外部访问,助力高效知识管理。
大数据场景敏感数据保护,是指对数据仓库、数据湖、大数据分析平台(Hive、Spark、StarRocks 等)中存储的敏感数据,实施识别、访问控制、脱敏与审计的一整套措施。它管的是“数据集中存储和批量计算”这一环节的安全,区别于业务系统的实时查询场景。为什么大数据场景风险突出?三个原因:第一,数据高度集中。数据仓库汇聚了各业务条线的数据,一个库里可能装着全行客户的身份、账户、交易、资产信息——泄露
做电商运营,免不了要持续关注自家以及竞品商品状态:价格变动、库存变化、不同规格的售价波动、店铺基础信息更新。很多人最开始的做法就是打开网页,定时手动刷新页面复制数据,一旦要跟踪十几款商品,每天就要消耗大量人力。如果自己写页面解析脚本,又会遇到不少麻烦:网页改版后解析规则直接失效,高频访问容易触发平台风控,多规格、图片、店铺信息的解析逻辑需要大量开发时间,遇到网络波动、商品下架,程序很容易直接报错终
定义ETL、ELT、CDC三种数据集成模式的本质差异与互补关系,澄清CDC不可替代全量迁移、ELT非万能升级版等四大认知盲区,提出基于延迟容忍度、源库负载、目标平台、同步类型的四步选型法,强调批流一体平台整合价值。
本文从连接器覆盖、实时同步、运维成本、信创合规、长期演进五个维度拆解选型避坑要点,并提供不同企业规模的选型决策矩阵。
企业在数据建设中常面临数据同步、ETL、ELT和数据集成等不同需求,关键在于识别当前核心问题。数据同步解决跨系统稳定传输问题,ETL侧重先清洗再入库的标准化处理,ELT则优先保留原始数据再按需加工。而数据集成体系需统筹连接、传输、加工、调度等全链路管理。实际建设中应结合业务场景(如时效要求、分析需求稳定性、数据规模)选择合适方案,或组合使用不同方式,避免盲目追求新技术概念。
多源数据源 → 全量/CDC数据同步 → 原始数据入湖 → 湖内清洗加工 → 聚合数据入仓 → 统一引擎对外服务。
湖仓一体核心是数据湖+数据仓库深度融合:在统一存储底座上,同时具备数据湖的灵活存储、全量存数、敏捷迭代能力,以及数据仓库的标准化建模、数据治理、合规管控、高效查询能力,搭配ELT核心数据流转模式,构建起“统一底座、双态赋能、全域可控”的现代化数据架构。(1)流程极简,大幅缩短迭代周期:ELT无需前置固化转换规则,新业务、新指标、新场景无需重构底层链路,仅需后置调整计算逻辑,迭代周期从“月级”压缩至
中型企业在构建ETL(数据集成)体系时面临人力成本高、架构复杂、响应慢的“不可能三角”。传统模式需专业团队,年成本数百万。ETLCloud等低代码平台通过可视化组件和预置连接器,实现拖拽式开发,无需编码,降低技术门槛。其自动化运维、实时同步及反向ETL能力,让普通IT人员可替代专业团队,快速响应业务需求,支持异构系统对接、数据中台建设等复杂场景,助力企业降本增效,释放数据价值。
本文深入解析Apache Doris的三种核心数据模型:Duplicate、Aggregate和Unique。通过对比其核心功能、适用场景及性能特点,并结合完整的SQL代码示例,指导读者根据业务需求(如日志分析、报表统计、维度更新)选择最合适的Doris数据模型,以优化查询效率与存储成本。
本文回顾了企业数据架构从单点集成、数据仓库到数据中台的三阶段演进,分析了架构师选型ETL工具时需关注的五大维度:可扩展性、集成能力、开发效率、国产化替代及成本可控性。
本文系统阐述了BI数据分析从数据采集、清洗整合、建模到可视化洞察的全流程。文章强调,BI的核心在于打通数据孤岛,构建高质量数据模型,并利用多维分析思维将原始数据转化为驱动业务决策的洞察,而非仅制作静态报表。
《国产数据库新书出版助力信创产业》摘要:历经三年编撰的国产数据库教材正式出版,为信创产业发展贡献力量。该书提供全套教学资源(含大纲、电子课件),面向高校师生开放样书申请渠道。读者可通过指定网址查看京东购买信息或申请教学样书。(99字)
摘要:本研究基于Hadoop+Spark+Hive技术栈构建高考志愿推荐系统,针对传统志愿填报方式效率低、精准性差的问题,提出分布式架构与智能算法相结合的解决方案。系统实现10TB级数据处理能力,批处理效率提升62%,响应时间缩短至98ms,长尾专业推荐准确率提高40%。研究创新性地采用"成绩-兴趣-政策"三模态特征表示方法,结合图神经网络与实时流处理技术,构建了覆盖数据采集、
首先,打开GSMAP网站,网址是https://sharaku.eorc.jaxa.jp/GSMaP/index.htm。选择需要下载降雨量的研究区,研究区可以选择某个已知经纬度的点,可以选择已经经纬度的区域或者行政区。出现登录界面,需要输入用户名和密码。将第二张图片中的UID和PW依次输入,就可以下载啦。根据研究需要,选择相应的时长,点击CSV Download。第二封邮件有有账号和密码,需要注
无论是建设数据仓库、数据中台,还是实时分析,数据采集平台始终是整个数据链路的第一步。企业需要稳定高效的方式来完成数据的抽取、转换和加载(ETL),同时在业务实时化的今天,实时数据复制也变得越来越重要。但在国内市场,数据采集平台的发展却面临着一些困境:开源二次开发盛行,自研产品难以普及,用户需求和厂商能力之间存在明显的张力。
表类型历史追溯存储效率查询复杂度典型更新方式拉链表优秀高中增量更新流水表完整低高只追加全量表无低低全量覆盖增量表有限高高只追加快照表离散点中低周期全量切片表依赖源表中低按需生成在实际数据仓库建设中,这些表类型通常会结合使用,例如用流水表记录所有变更,定期生成快照表,然后基于快照表创建各种切片表供分析使用。
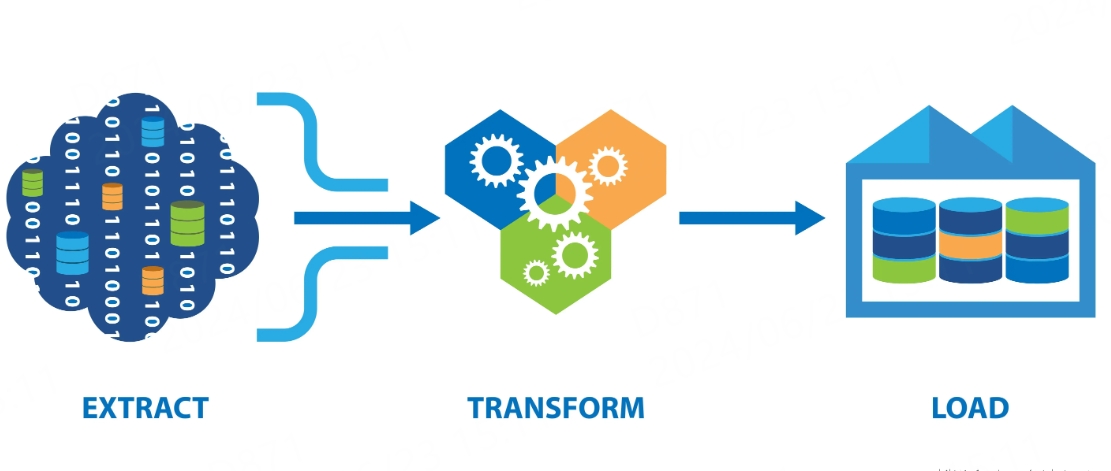
本文系统介绍了ETL(数据抽取、转换、加载)的核心概念和应用价值。首先阐述了ETL作为数据集成关键技术在打破数据孤岛、提升数据质量方面的重要性,特别强调了其在企业数据管理、商业智能等领域的核心地位。然后详细解析了ETL四大核心流程:数据抽取(从异构数据源获取数据)、数据清洗(处理缺失值、错误数据等)、数据转换(格式统一、计算等)和数据加载(全量与增量策略),并辅以电商等场景的实用案例说明。
西安交通大学COMP551705数据仓库与数据挖掘
7.对t_ods_tmp_salary表的每一条数据进行泛化处理,将处理结果储存到中间表t_ods_tmp_salary_dist中,命令如下。3.分析大数据职位全国薪资分布情况,将分析结果储存在维度表t_ods_salary中,命令如下。11.创建维度表t_ods_company,用于储存福利标签的统计结果,命令如下。12.创建维度表t_ods_salary,用于储存薪资分布的统计结果,命令如下
服务之间直接集成,不需要使用额外组件完成数据 ETL 的工作。把各种各样的数据都连接到执行分析所需要的地方,实现数据平滑“无感”的流动。它可以帮助用户最大限度地减少甚至消除构建 ETL 数据管道的复杂性。提高敏捷性。简化了数据架构并减少了数据工程的工作量。它允许增加新的数据源,而无需重新处理大量数据。这种灵活性增强了敏捷性,支持数据驱动的决策和快速创新。成本效益。利用云原生且可扩展的数据集成技术,
总结一下,监控 表级/字段级完整性准确性有效性一致性唯一性和及时性等数据质量并且能够及时阻止脏数据进入下游选择DQC;监控具体任务资源运行状况选择智能监控,选择个性化推送某些轻量数据的选择数据推送。
数仓建模在哪层建,怎么建,三种维度建模法:范式建模法,维度建模法,实体建模法,三种维度建模模式:星型模型,雪花模型,星座模型
《数据仓库与数据挖掘》 总复习
Kettle,又名 Pentaho Data Integration(PDI),是一个开源的数据集成工具,最初由 Pentaho 公司开发。它能够从多种数据源提取、转换并加载(ETL)数据,适用于数据仓库建设、数据迁移和数据同步等场景。Kettle(Pentaho Data Integration)是一个功能强大且易于使用的数据集成工具,适用于多种数据处理和集成场景。其图形化界面和丰富的功能使其成
主要介绍数据仓库和数据挖掘的基本知识。
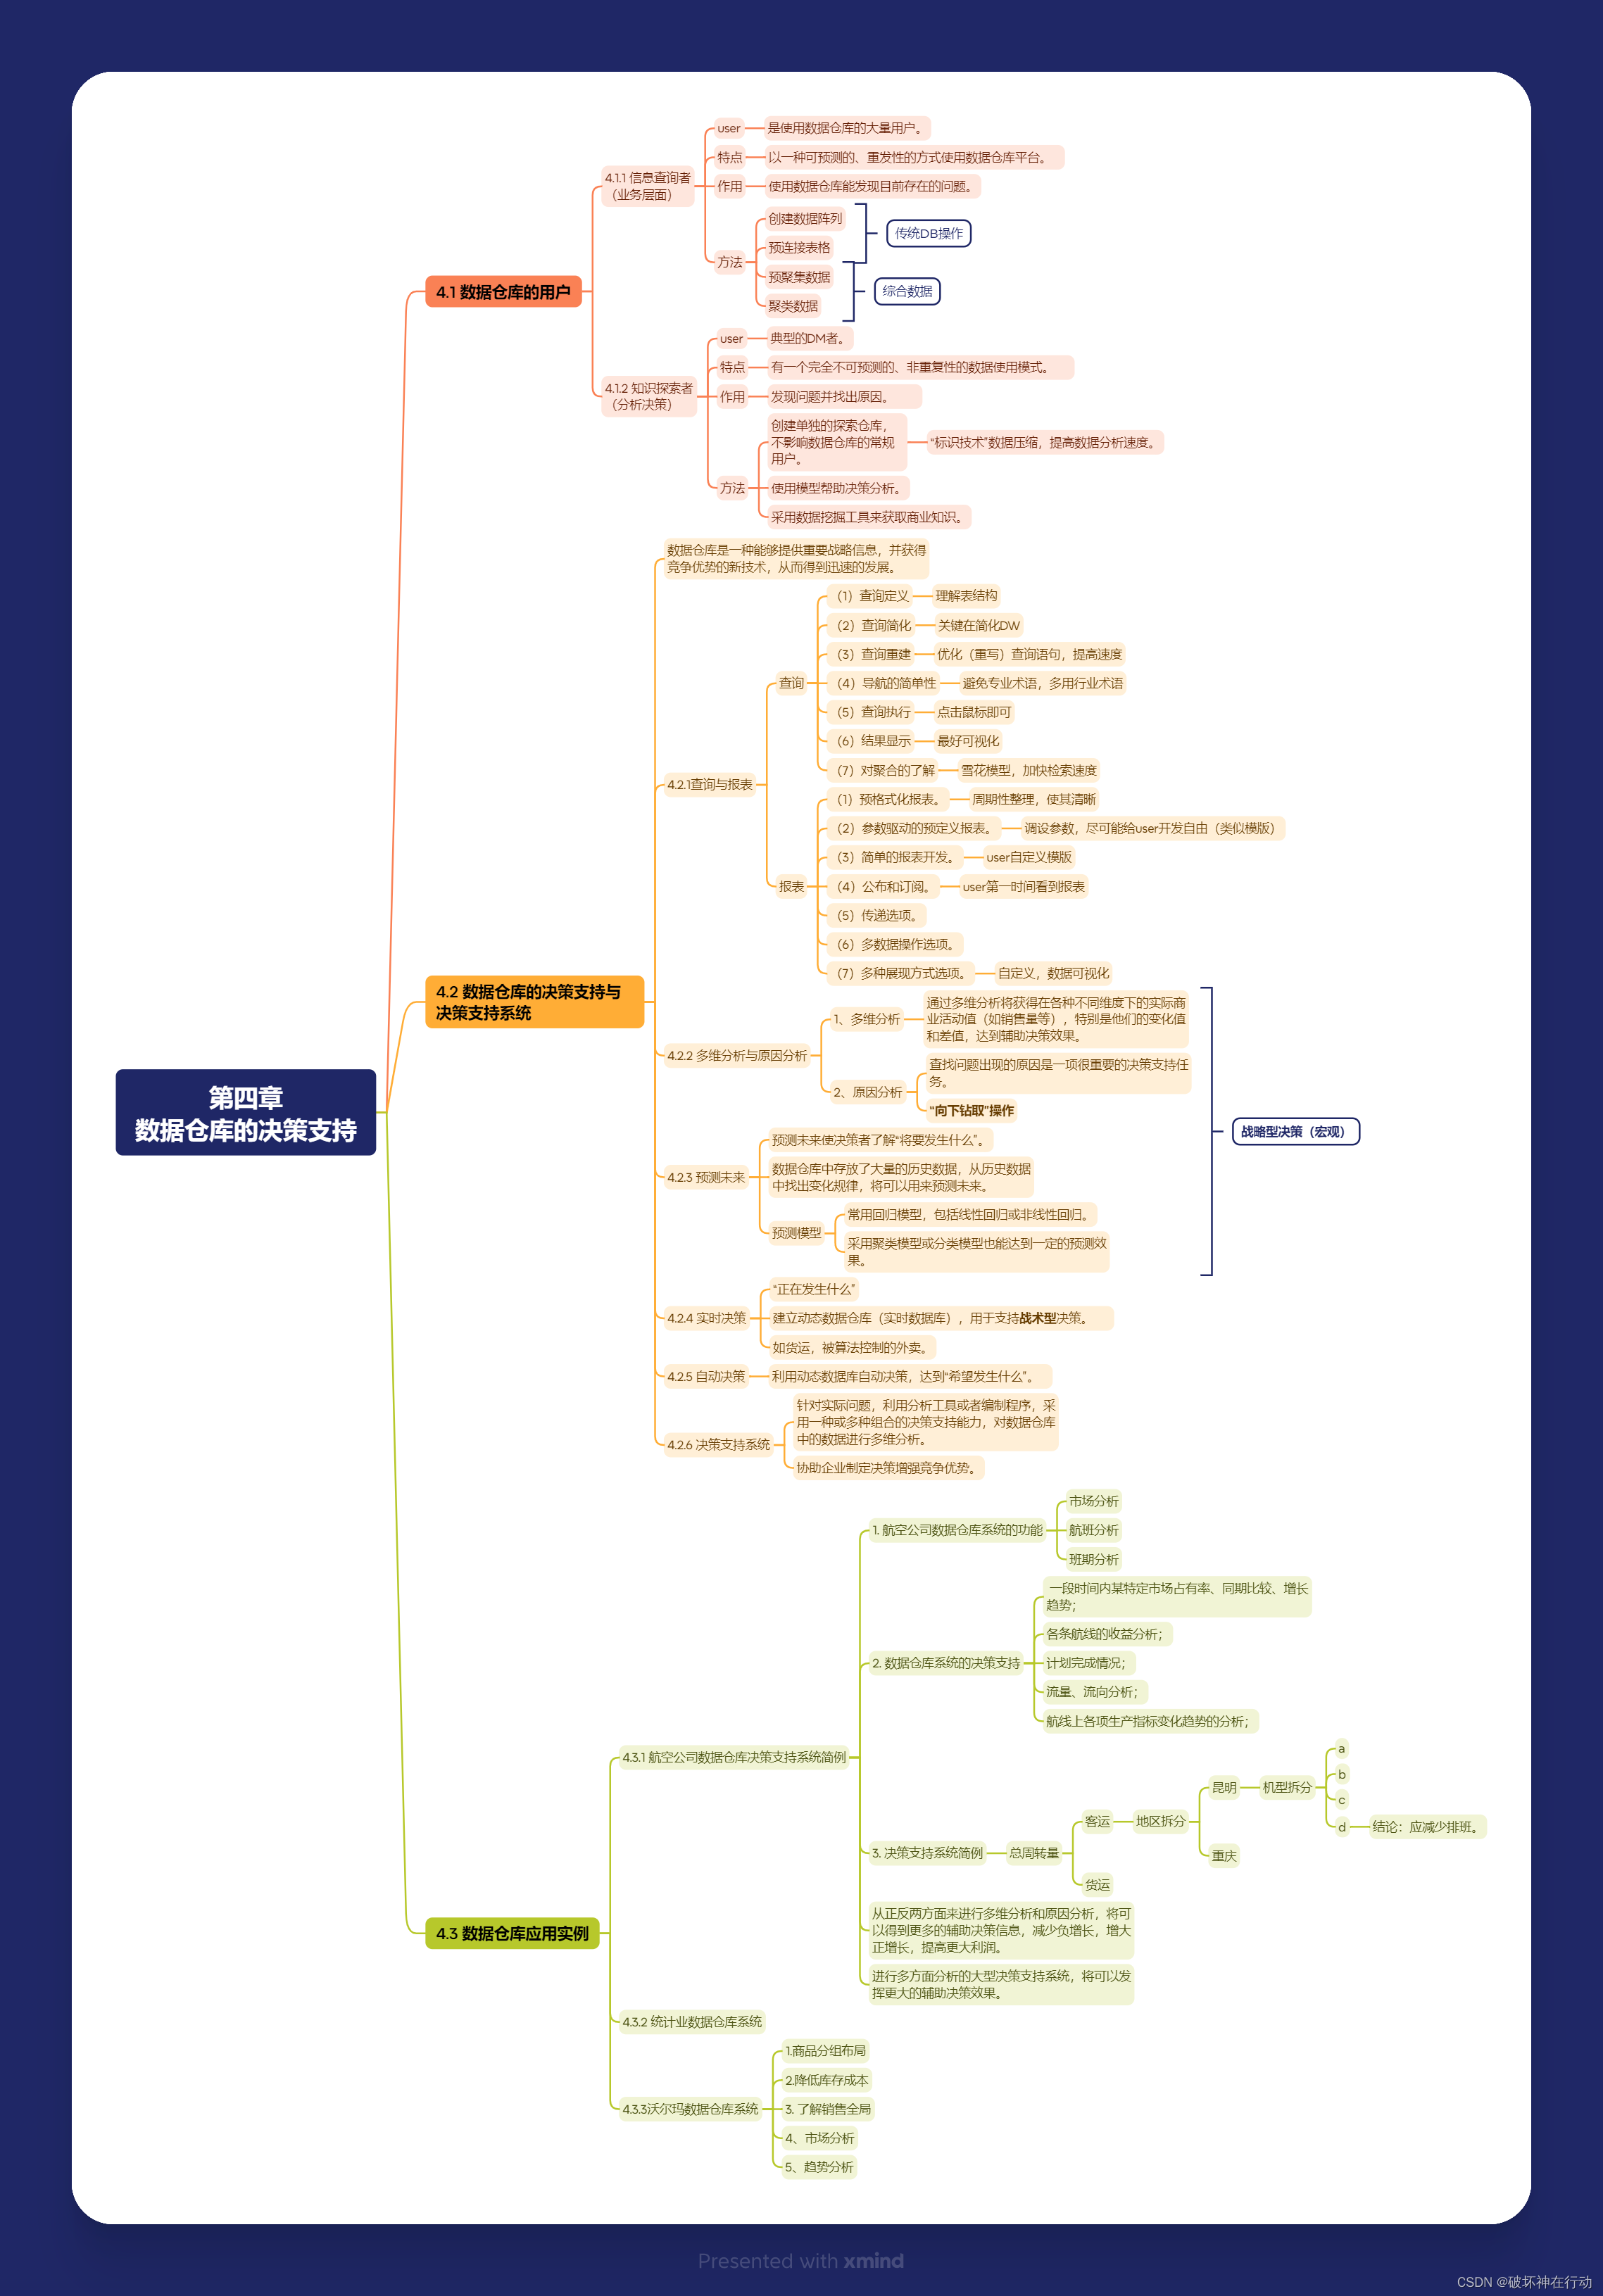
user是使用数据仓库的大量用户。特点以一种可预测的、重发性的方式使用数据仓库平台。作用使用数据仓库能发现目前存在的问题。方法创建数据阵列预连接表格预聚集数据聚类数据。
AI智能语音外呼系统是一种基于人工智能技术的自动外呼系统,实现了电话自动拨打和语音播报等功能,主要应用于商业领域中的市场营销、客服等方面。AI智能语音外呼机器人主要应用于商业领域中的市场营销、客服等方面。通过采用先进的自然语言处理技术、语音合成技术和人工智能算法,能够有效提高营销效率和客户满意度,从而为企业带来更多商业利益。
数据分析
随着存储的数据量越来越大,用户可以通过分析大规模历史数据,进行决策分析。国内分析型数据库市场参与者众多,为了更准确地了解国内主要厂商的技术优势,我们从多年数据仓库实施经验中选择了四个重要的维度,用于梳理分析型数据库厂商的关键技术,包括:整体架构、核心技术能力、重点场景支持、技术生态对接。数据分区是数据库解决性能和存储问题的重要技术之一,MPP架构数据库的数据分区是在一个节点内部按照用户指定的策略对
数据额挖掘的定义、工作流程、主要算法、经典案例
2000-2020全要素生产率OP法+LP法+OLS和固定效应法数据和Stata代码
选中“综合”列的第二个单元格,即“P2”单元格,输入“=”并使用鼠标选中“J2”,然后输入"&“,”&“(不包含外部双引号),后再选中"K2”,再输入"&“,”&“,再重复上述操作,分别选中“L2 M2 N2”并添加间隔符“&”,"& ”。对于如下数据表,想要将时间、人数、活动名称、预算、地点的列信息进行合并,并以逗号隔开,在综合一栏中加以显示。直接下拉,会自动计算后续内容。...

📖 本文目录📖第四章——数据仓库与数据挖掘教程——第二版📑 1、数据仓库分析与设计分为哪几个部分?📑 2、需求分析📑 3、概念模型设计📑 4、逻辑模型设计📑 5、物理模型设计📑 6、数据仓库开发 ⭐📑 7、维护与评估阶段📑 8、数据质量与数据清洗——了解一下📑 9、数据粒度 与 维度建模📑 10、数据仓库和多维 DBMS 的区别📑 课后习题🔖 什么是概念模型? 它的特点
| 作者:行人|编辑:邵佳怡| 设计:王福政引言:听到 What'S Next | 科技早知道 播客《S6E06|对话Databricks联合创始人Reynold Xin:380 亿美元估值背后的长期主义》,颇受启发,本文作为一个笔记其中一些内容以及个人的一些思考,对文中内容感兴趣的朋友建议听一下这期节目。导读:1、DataBricks早期的3个决定2、开源软件如何与A...
做数据分析没有思路?来了解看看什么是业务指标、数据获取、数据仓库、数据治理、数据分析方法
1、一张表上可以建立多个后触发器,但只能建立一个前触发器。2、数据库的重组并不改变原设计的逻辑喝物理结构,但是重构操作会部分改变数据库的模式喝内模式。3、简单恢复模式只用于测试和开发数据库,或者用于主要包含制度数据的数据库。4、常用的需求分析建模方法包括:DFD、IDEF0、UML。5、DFD建模方法采用自顶向下逐步细化的结构化方法。6、SQL Server2008数据库管理系统只支持在Windo
文章目录1. 数据仓库基本概念1.1 数据仓库的定义及特征1.2 数据仓库体系结构1.3 数据模型1.4 粒度2. 数据仓库设计2.1 概念模型设计4.2 逻辑模型设计2.3 物理模型设计3. 数据仓库实现4. 联机分析处理4.1 OLAP相关概念4.2 OLAP操作5. 元数据模型5.1 元数据库5.2 元数据类型5.3 元数据作用5.4 元数据的使用1. 数据仓库基本概念1.1 数据仓库的定义
一站式、高性能实时大数据处理平台,广泛适用于流式数据处理场景。实时计算产品彻底规避繁重的底层流式处理逻辑开发工作,助力企业向实时化、智能化大数据计算升级转型
数据仓库Data Warehouse,简称DW,中文名数据仓库,是商业智能(BI)中的核心部分。主要是将不同数据源的数据整合到一起,通过多维分析等方式为企业提供决策支持和报表生成。那么它与我们熟悉的传统关系型数据库有什么不同呢?简而言之,用途不同。数据库面向事务,而数据仓库面向分析。数据库一般存储在线的业务数据,需要对上层业务的改变做出实时反应,涉及到增删查改等操作,所以需要遵循三大范式,需要AC
欢迎关注公众号——《数据三分钟》一线大厂的师兄师姐结合自己的工作实践,将数据知识浅显道来,每天三分钟,祝你成为数据达人。还有面试指导和内推机会。巧妇难为无米之炊,数据就是营销分析平台的米,每一个分析结论的产出都离不开数据。那么数据到底是怎么获取的,如何一步步走到我们的面前,如何熠熠闪光的展现在一个个报表上?在互联网电商领域,数以亿计的移动终端、PC网页,就是用户与系统交互的数据源泉。1、插一段历史
在GeeksforGeeks上看到了几篇关于数据仓库架构、维度数据建模的文章,进行翻译整理并加入了一些自己的理解,输出了这篇文章。一、数据仓库架构数据仓库是将不同来源的数据在统一的模式下组织起来的异构集合。构建数据仓库有两种方法:自顶向下和自底向上。1. 自顶向下的方法自顶向下的架构如下图:图中各主件的作用如下:External Sources外部源是不管收集的数据是何种类型的...
Ø 【概述】本次大作业我们选取了第一个题目:基于统计方法的数据分布的图形显示。我们从各省市统计局公布的数据中搜集了包括人均GDP(元)、人口密度(人/平方公里)、PM2.5年平均浓度(微克/立方米)、年旅游收入(亿元)的数据并且做了统计和可视化。我们认为这些数据可以一定程度上反映出一个省或直辖市的经济(人均GDP)、社会(人口密度)、环境(PM2.5年平均浓度)和文化产业(旅游收入)的发
ang Ye 2006.8一,概念和术语1.1 数据挖掘 / 知识发现(1)数据挖掘是从存放在数据集中的大量数据挖掘出有趣知识的过程.(2)数据挖掘,又称为数据库中知识发现(Knowledge Discovery in Databases)或知识发现,它是一个从大量数据中抽取挖掘出未知的,有价值的模式或规律等知识的非平凡过程,它与数据仓库有着密切的联系.(3)广义的数据挖掘是指
2007年是整个数据库市场快速发展的一年,包括Oracle、IBM和SQL Server为代表的主流商用数据库以及MySQL代表的开源数据库在这一年里都有不错的进步,随着SOA和Enterprise 2.0概念的升温,数据库领域也适时的出现很多新的技术趋势。 1. 数据库市场发展概况 1.1 竞争格局保持稳定 虽然2007年数据库市场仍然以Oracle、IBM和微软三大商用数据库厂商为
本文分享用于具身智能、自动驾驶及车内监控等场景的视频数据集,涵盖驾驶员疲劳、分心、吸烟等行为,适用于人类行为识别、视频理解与多模态模型训练。部分数据已公开,可通过Hugging Face下载,支持定制化数据生成,欢迎联系chan@vwu.ai获取更多需求支持。
米思米株式会社宣布追加46亿日元投资,以应对数据中心自动滑台需求激增及人形机器人产业发展的市场机遇。随着AI技术普及推动数据中心建设及光收发器产量增长,公司自动滑台订单超预期,产能将扩至2025年的3倍。同时,瞄准2030年超百亿美元规模的人形机器人市场,米思米提前布局相关零部件供应。作为制造业数字化转型先锋,公司通过"数字模型转型"战略优化设计采购流程,持续提升客户效率。此次
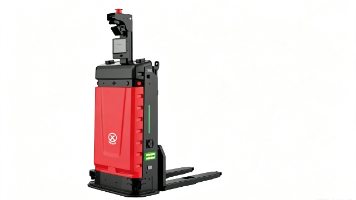
本文探讨智能堆高机器人在高密度仓储与物流场景的应用策略。通过窄通道改造(最窄1690mm)可提升30%仓储利用率,前移式机型实现8米以上高位货架稳定存取,薄背机型解决集装箱装卸难题,侧向叉取技术适应复杂地形。针对千台级集群调度,强调与MES/WMS系统对接实现产线自动化闭环,并提供基于载荷、通道、高度的三维选型框架。实施路径建议分阶段验证,从单机测试到多机联调,最终实现全天候无人化物流,为仓储效率
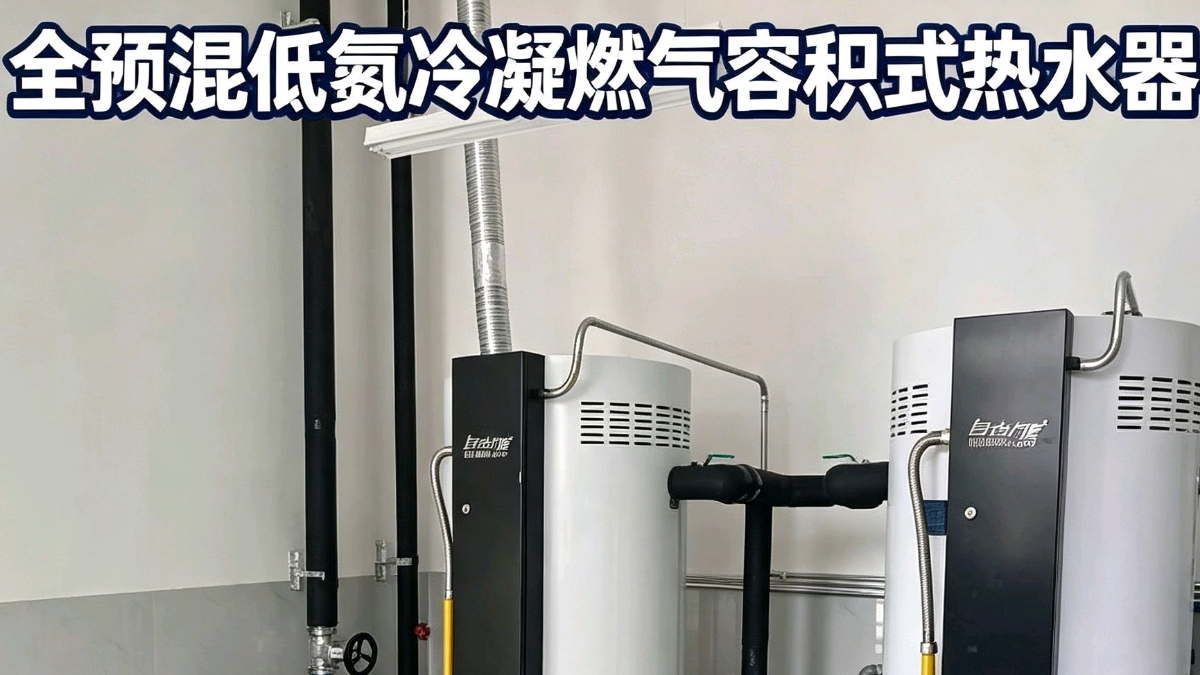
本文提供一套可落地的品牌甄别与厂家评估方法,帮助项目方跳出榜单误区,建立独立、客观的选型体系,并以佛山自由能电器有限公司为案例,详解优质商用热水设备厂家的核心实力标准。设备3-5分钟快速出热水,水温波动稳定在±1℃,兼顾速热、恒温、节能、占地小的优势,完美适配民宿、酒店、别墅、商铺等中小型商用场景。包含可查专利的文丘里强化换热火管、石墨烯硅纳米搪瓷内胆、全预混自适应燃烧系统、免维护平板燃烧器,搭配
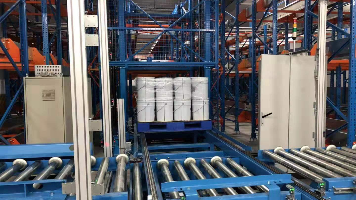
自动化立体仓库市场快速发展,中国企业占比提升 近年来,自动化立体仓库成为仓储物流的升级方向,市场规模持续扩大。数据显示,2025年全球智能立体仓储市场规模将达381.8亿元,中国自动化立体仓库数量从2019年的6000座增至2024年的超11000座。国内企业市场份额从2020年的32%提升至2025年的51%。 行业主要企业分为两类:第一梯队包括北自科技、荣联汇智、诺力股份、今天国际,提供一体化