记录一次Clickhouse千万级甚至亿级别数据批量插入排查优化
·
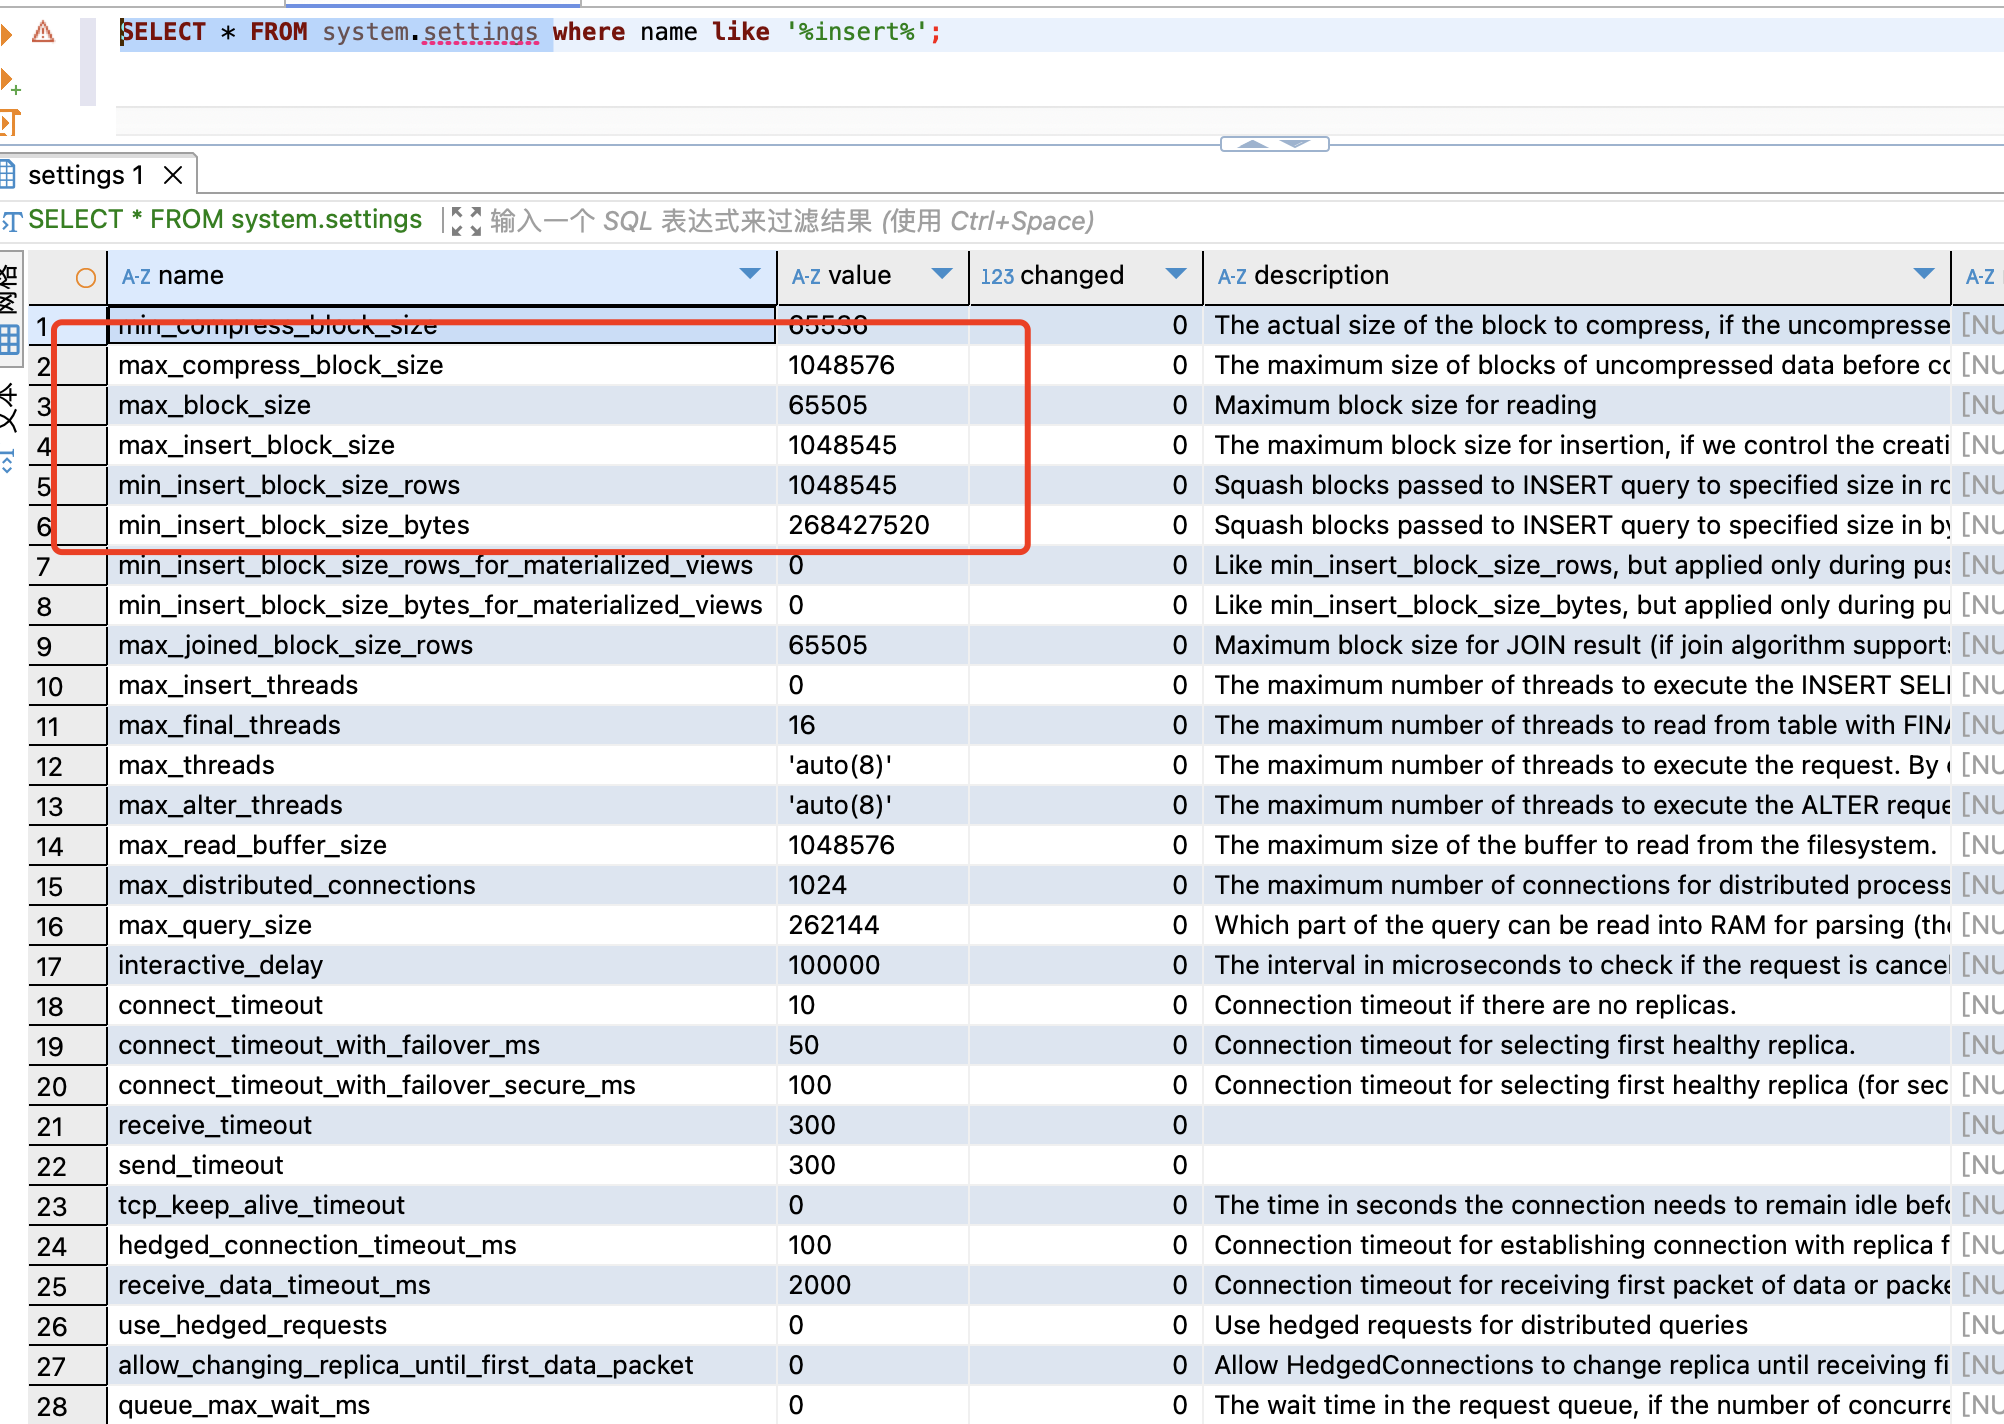
问题描述:每日流量数据过亿,经过数据清洗统计以后需要将上千万甚至上亿级别的数据插入数据库,没有处理之前单次插入数据量就千条,到了一万条就很慢了,十万条就更慢了,经过调查分析,一开始我以为是Clickhouse的配置导致数据分片从而引发耗时,所以调了很多参数,结果都没有用,具体调整参数如下:
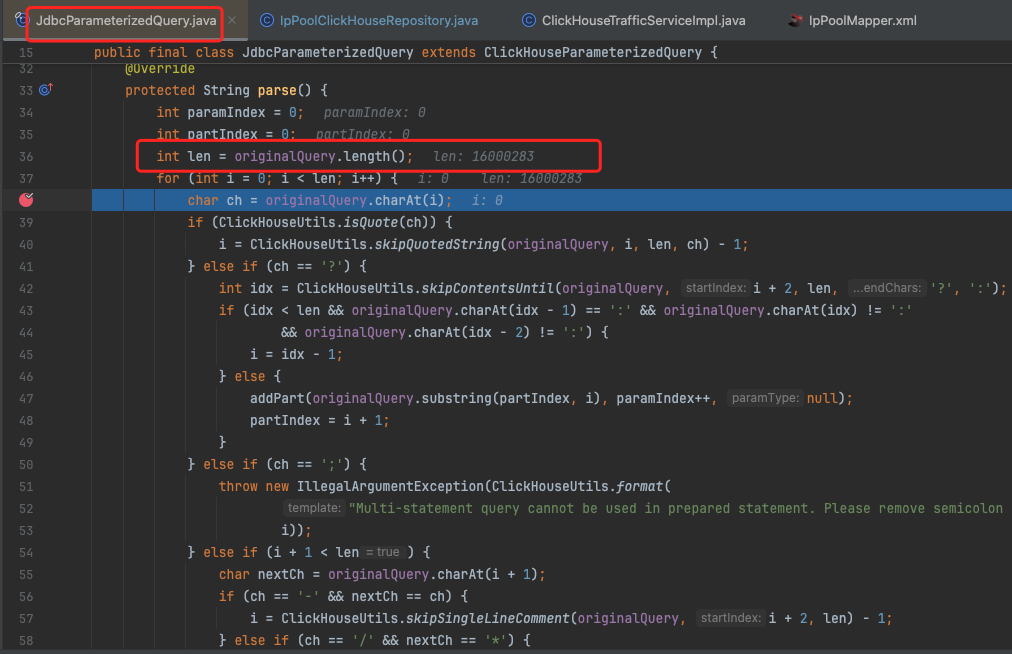
最后跟踪了源码发现了插入慢的原因,com.clickhouse.jdbc下面的JdbcParameterizedQuery的parse方法非常慢,这个方法会根据你的批量插入sql然后去for循环解析处理sql,相当耗时:
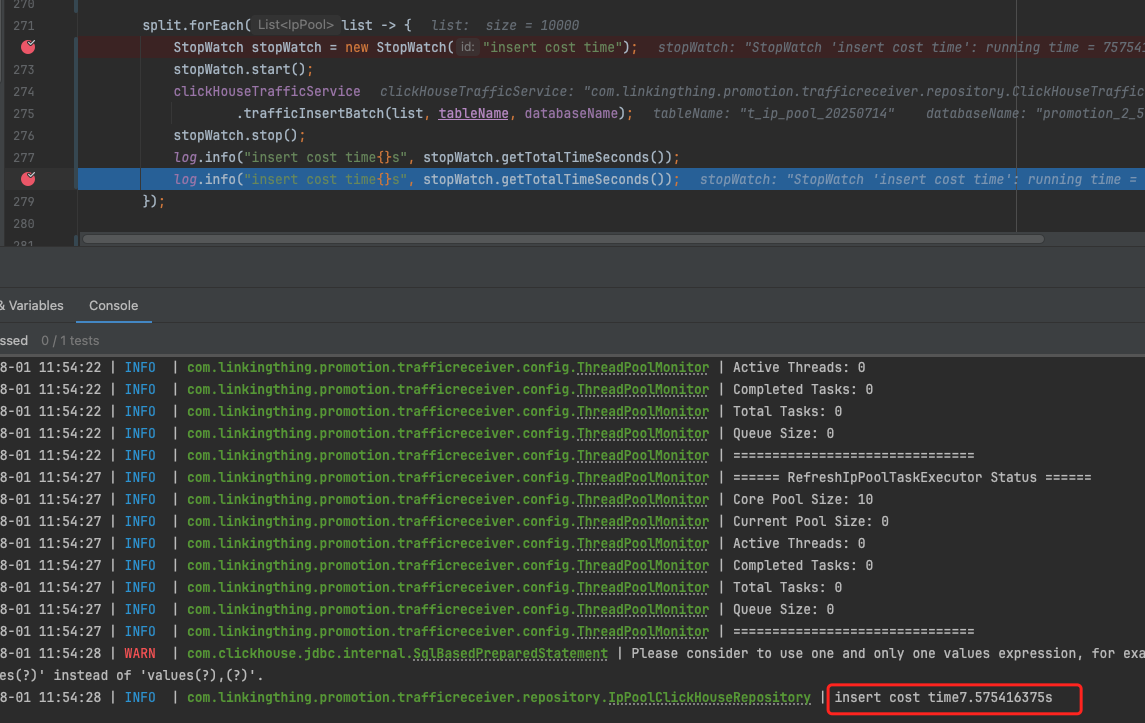
最后采用了新的批量插入方式,经过测试,单次十万级别的插入只需要0.5s,单次插入五十万甚至一百万也仅仅只需要2s多,下面就做一个全面的过程记录,希望对大家有帮助。没优化之前单次插入一万条数据耗时接近八秒:
单次插入十万条数据耗时300多s:
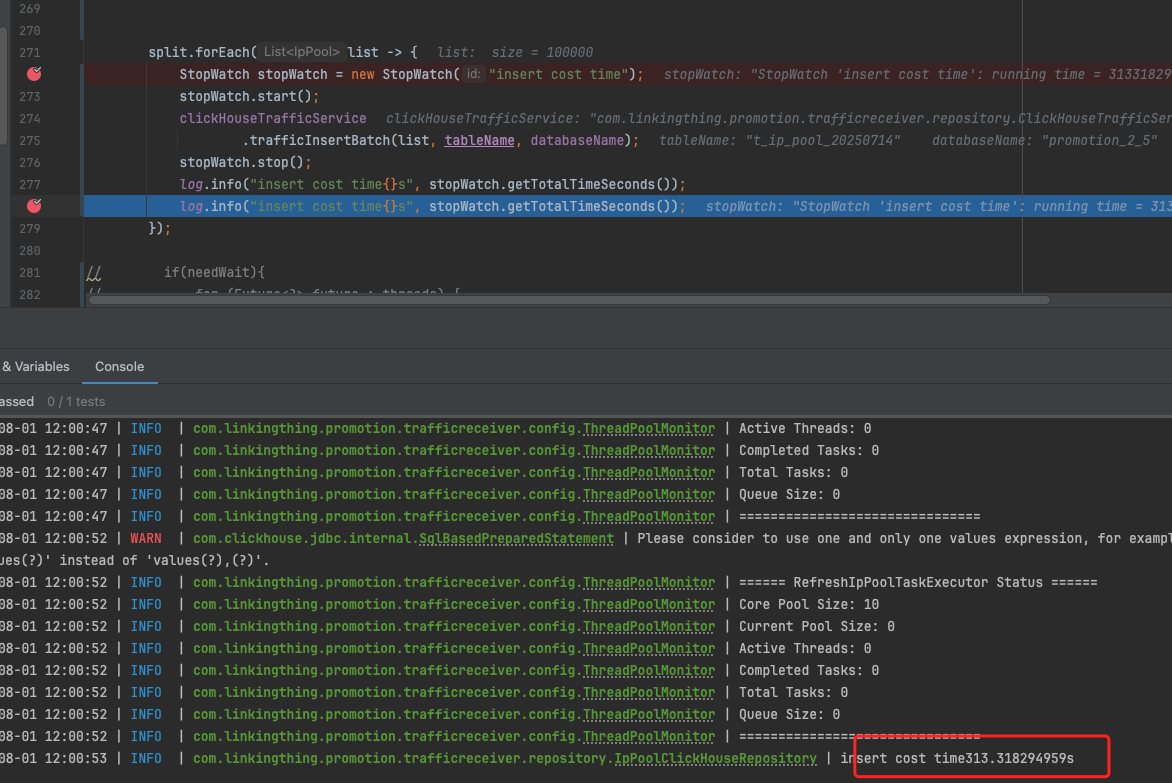
这个插入速度太慢了,这个级别的数据完全插入需要的时间要几十个小时了,完全接受不了,所以肯定需要优化,我优化的方式就是使用原生的jdbc插入方式,走自己的预编译sql方法,然后去插入,具体代码实现方式如下(备注说明,还有一个方式是用RowBinary的方式,可能会更快):
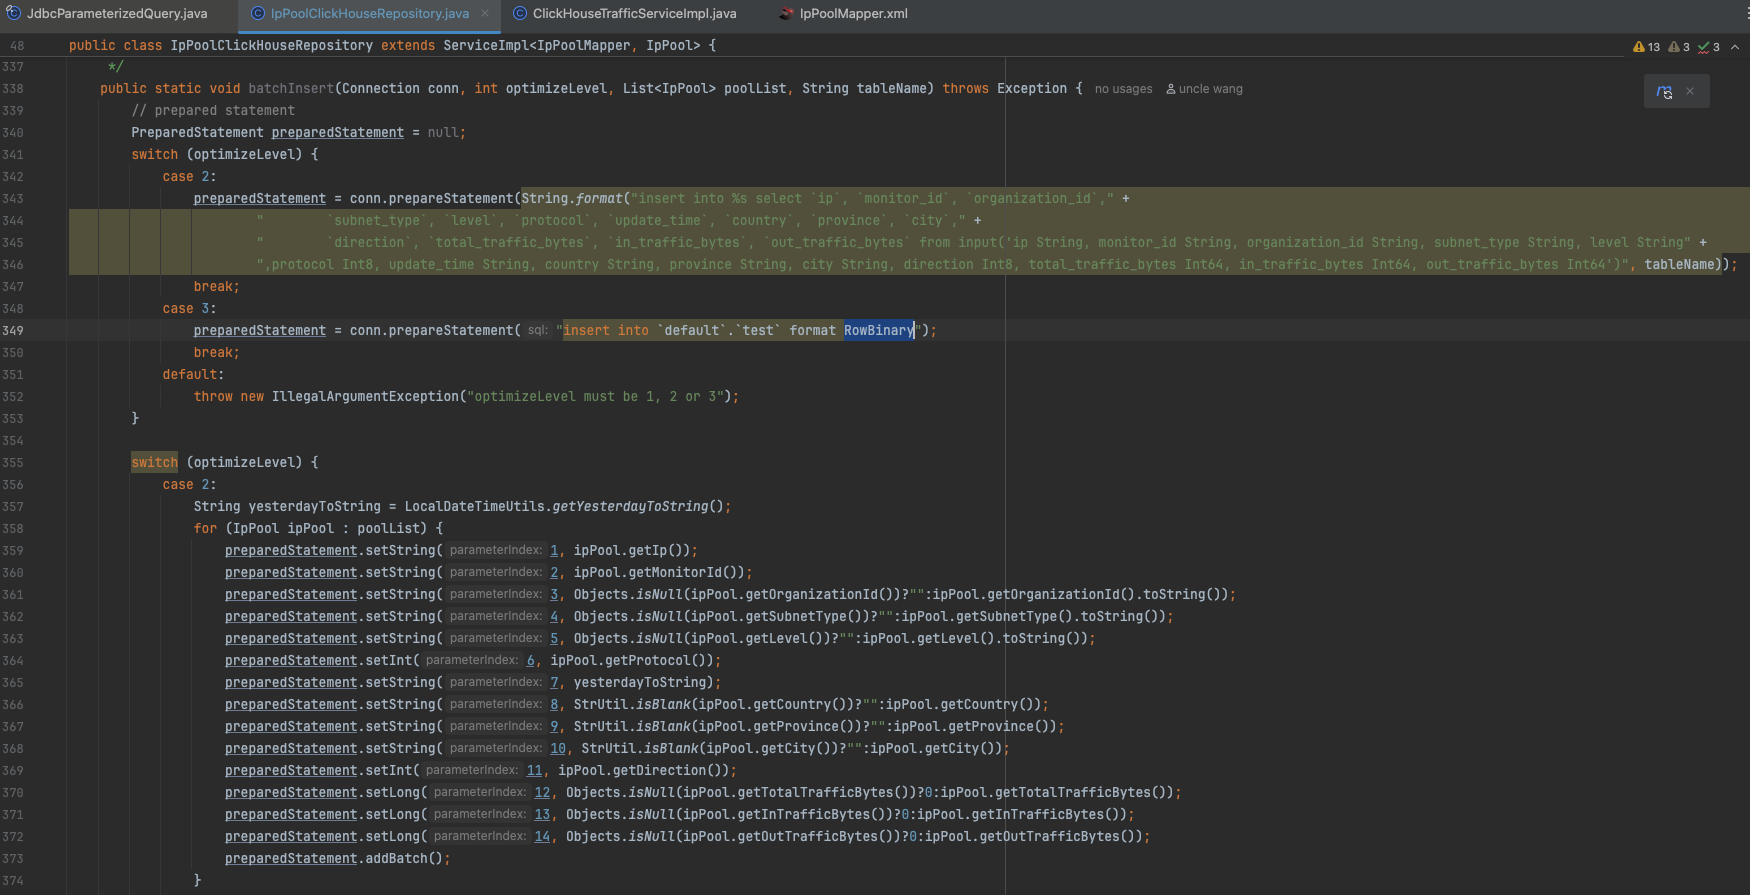
另外附上核心代码块:
public static void batchInsert(Connection conn, int optimizeLevel, List<IpPool> poolList, String tableName) throws Exception {
        // prepared statement
        PreparedStatement preparedStatement = null;
        switch (optimizeLevel) {
            case 2:
                preparedStatement = conn.prepareStatement(String.format("insert into %s select `ip`, `monitor_id`, `organization_id`," +
                        "        `subnet_type`, `level`, `protocol`, `update_time`, `country`, `province`, `city`," +
                        "        `direction`, `total_traffic_bytes`, `in_traffic_bytes`, `out_traffic_bytes` from input('ip String, monitor_id String, organization_id String, subnet_type String, level String" +
                        ",protocol Int8, update_time String, country String, province String, city String, direction Int8, total_traffic_bytes Int64, in_traffic_bytes Int64, out_traffic_bytes Int64')", tableName));
                break;
            case 3:
                preparedStatement = conn.prepareStatement("insert into `default`.`test` format RowBinary");
                break;
            default:
                throw new IllegalArgumentException("optimizeLevel must be 1, 2 or 3");
        }

        switch (optimizeLevel) {
            case 2:
                String yesterdayToString = LocalDateTimeUtils.getYesterdayToString();
                for (IpPool ipPool : poolList) {
                    preparedStatement.setString(1, ipPool.getIp());
                    preparedStatement.setString(2, ipPool.getMonitorId());
                    preparedStatement.setString(3, Objects.isNull(ipPool.getOrganizationId())?"":ipPool.getOrganizationId().toString());
                    preparedStatement.setString(4, Objects.isNull(ipPool.getSubnetType())?"":ipPool.getSubnetType().toString());
                    preparedStatement.setString(5, Objects.isNull(ipPool.getLevel())?"":ipPool.getLevel().toString());
                    preparedStatement.setInt(6, ipPool.getProtocol());
                    preparedStatement.setString(7, yesterdayToString);
                    preparedStatement.setString(8, StrUtil.isBlank(ipPool.getCountry())?"":ipPool.getCountry());
                    preparedStatement.setString(9, StrUtil.isBlank(ipPool.getProvince())?"":ipPool.getProvince());
                    preparedStatement.setString(10, StrUtil.isBlank(ipPool.getCity())?"":ipPool.getCity());
                    preparedStatement.setInt(11, ipPool.getDirection());
                    preparedStatement.setLong(12, Objects.isNull(ipPool.getTotalTrafficBytes())?0:ipPool.getTotalTrafficBytes());
                    preparedStatement.setLong(13, Objects.isNull(ipPool.getInTrafficBytes())?0:ipPool.getInTrafficBytes());
                    preparedStatement.setLong(14, Objects.isNull(ipPool.getOutTrafficBytes())?0:ipPool.getOutTrafficBytes());
                    preparedStatement.addBatch();
                }
                preparedStatement.executeBatch();
                break;
        }
    }
通过优化后,测试单次插入十万条耗时0.5s:

测试单次插入50万条耗时2s:
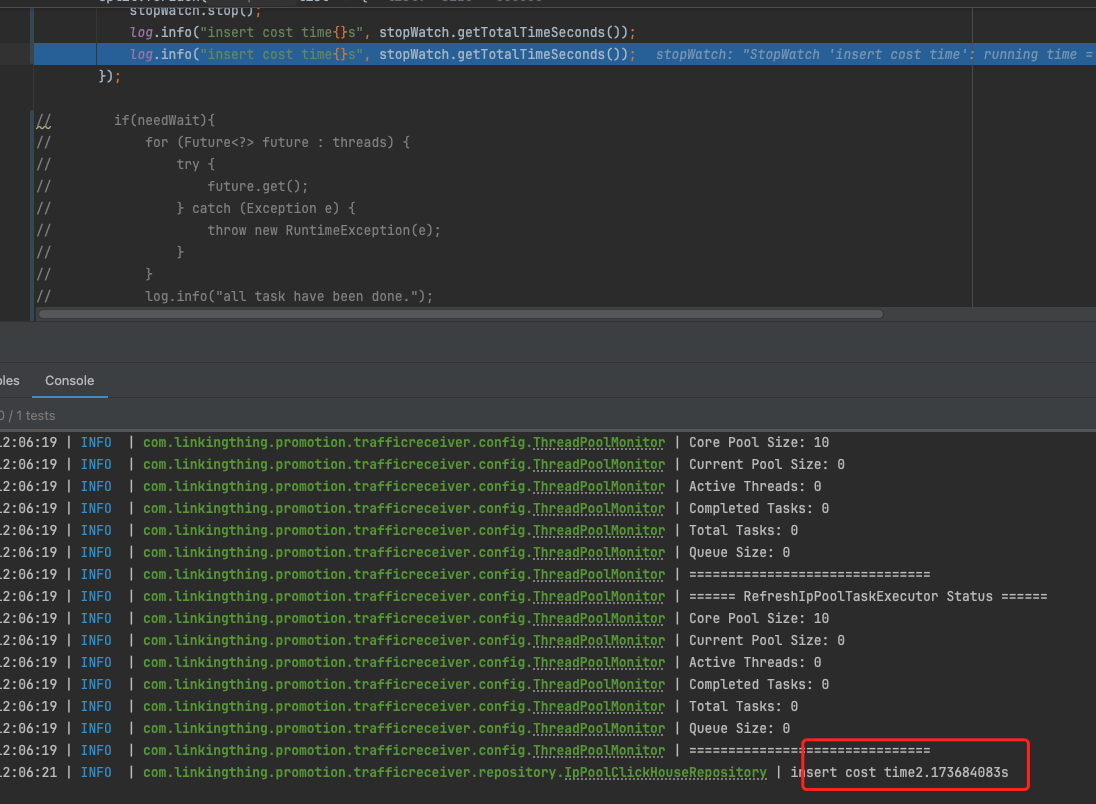
优化后大大提高了批量插入速度,千万级别的数据插入也从几十个小时提升到了200-300s,也达到了预期效果,以上就是整个优化的过程,希望对你们有所帮助。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)