登录社区云,与社区用户共同成长
邀请您加入社区
CDC 是(变更数据获取)的简称。核心思想是,监测并捕获数据库的变动(包括数据或数据表的插入、 更新以及删除等),将这些变更按发生的顺序完整记录下来,写入到消息中间件中以供其他服务进行订阅及消费。/*** 反序列化数据,转为变更JSON对象*/@Override//5.获取操作类型 CREATE UPDATE DELETE2 : 3;//7.输出数据/*** 从元数据获取出变更之前或之后的数据*/
请设计 Flink 作业的数据流(Source → Transformation → Sink),并说明关键算子(如。(每秒请求数),并输出到监控系统(如 Prometheus、Kafka、MySQL 等)。,假设瞬时 QPS 可能达到 10,000,如何保证 Flink 作业的稳定性和低延迟?如何实现 QPS 的滑动窗口(如每 1s 计算一次最近 10s 的 QPS)?如果某些 key 的数据量
本文整理自抖音集团数据工程师陶王飞和羊艺超老师,在 Flink Forward Asia 2024 生产实践(一)专场中的分享主要内容。
Apache Flink是由德国柏林工业大学于2009年启动的研究项目,2014年进入Apache孵化器,现已成为实时计算领域的事实标准。其核心能力可用一句话概括:对无界和有界数据流进行有状态计算。
Flink介绍——实时计算核心论文之MillWheel论文总结
在一个现代化的工厂环境中工作,这里有无数个传感器在不停地监控着各种环境参数,如温度、湿度、压力、重力、可见光强度、红外线强度、气体浓度和烟雾水平等。这些传感器每秒钟都会产生大量的数据点,并通过网络实时发送到一个中心位置进行处理。我们的目标是构建一个系统,能够迅速地分析这些数据,计算出关键指标是否超出了预设的安全阈值,如果确实超过了,则立即发出警报通知相关人员采取行动。
使用 Apache Flink 进行物联网(IoT)实时数据分析是一个非常强大的解决方案,因为它提供了高吞吐量、低延迟以及精确一次处理语义的能力。以下是详细的实现方案,包括如何设置环境、构建数据流管道、定义业务逻辑以及部署和监控整个系统。
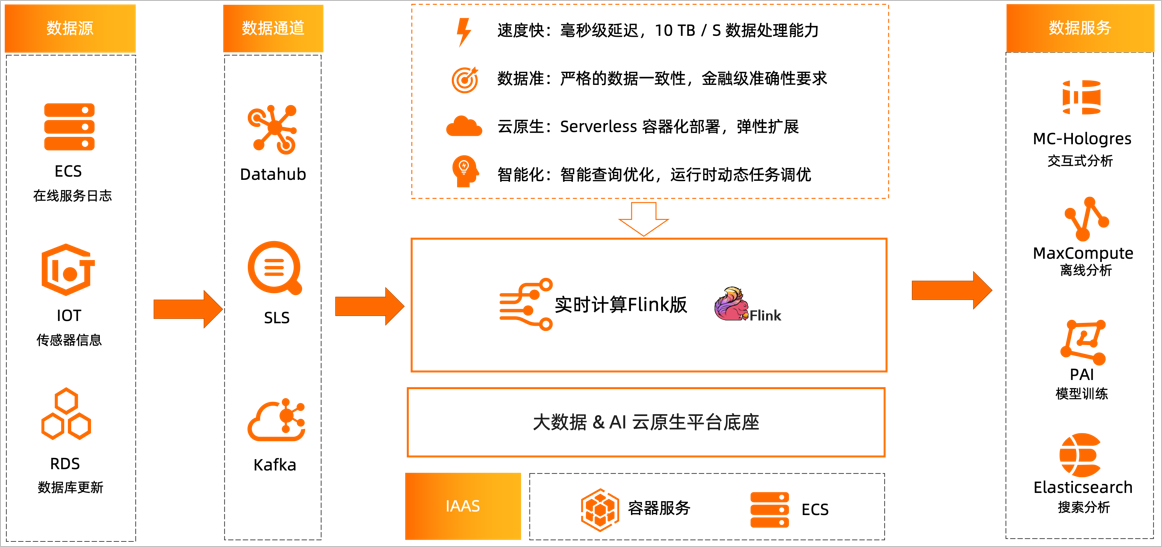
本文将以部门场景和技术领域场景为例,为您介绍实时计算Flink版的大数据是实时化场景。作为流式计算引擎,Flink可以广泛应用于实时数据处理领域,例如ECS在线服务日志,IoT场景下传感器数据等。同时Flink还能订阅云上数据库RDS、PolarDB等关系型数据库中Binlog的更新,并利用DataHub、SLS、Kafka等产品将实时数据收集到实时计算产品中进行分析和处理。
本示例以user分库分表合并同步作为基础,介绍在分库分表合并的过程中,如何进行一些转换计算。
说明VVR 4.x仅支持3.7版本的Python虚拟环境,VVR 6.x及以上的版本无此限制,您可以使用更高版本的Python虚拟环境。Python支持构建虚拟环境,每个Python虚拟环境都有一套完整的Python运行环境,并且可以在这套虚拟环境中安装一系列的Python依赖包。关于Python虚拟环境更详细的介绍,请参见Python文档创建虚拟环境。下文为您介绍如何准备Python的虚拟环境。
Apache Paimon是一种流批统一的湖存储格式,支持高吞吐的写入和低延迟的查询。本文通过Paimon Catalog和MySQL连接器,将云数据库RDS中的订单数据和表结构变更导入Paimon表中,并使用Flink对Paimon表进行简单分析。Apache Paimon是一种流批统一的湖存储格式,支持高吞吐的写入和低延迟的查询。目前阿里云实时计算Flink版,以及开源大数据平台E-MapRe
最近在工作中遇到了Flink处理kafka中的数据,最后写入Doris存储的场景。Apache Doris 是一款基于 MPP 架构的高性能、实时的分析型数据库,以高效、简单、统一的特点被人们所熟知,仅需亚秒级响应时间即可返回海量数据下的查询结果,不仅可以支持高并发的点查询场景,也能支持高吞吐的复杂分析场景。
那么实时计算就是用一根水管接在水龙头的出水处另一端连接的就是生产纯净水的机器,特点是可以源源不断的生产纯净水速度很快但是每次只能生产一瓶。而离线计算就是在水龙头下方,先用个水桶来接水,只有当水桶接满了水之后才对其进行纯净水的生产,特点是隔一段时间才能生产一次,每次生产的时间比较长但是每次能生产一桶水。而离线计算的计算逻辑则相对复杂,虽然每次产生的业务价值较大但是效率低不够及时。不管是实时计算还是离
相比前面介绍maxwell,实时数据采集中最主流技术非Flink CDC莫属,其直接省去中间的消息中间件如kafka,且支持增量采集也支持全量采集;本篇先介绍CDC的技术和分类,进一步了解其特性和支持丰富数据源,最后通过FLink DataStream和SQL两种编程示例解开入门。
flink实时计算机框架简介
以下数据 为某网站的访问日志 现要求通过以下数据 统计出最近10s内最热门的N个页面(即url链接),并且每5s更新一次;即求出页面访问量中的TOP N
Apache StreamPark 2.0.0 正式发布, 这是 StreamPark 加入 Apache 孵化器以来发布的第一个版本,也是一个重大功能更新的版本, 有超过 100 位 Contributor 贡献了超过 700 个 Pull Request,带来了诸多的新特性和改进修复. 欢迎大家下载使用
2 .项目构建(实时计算框架和监控kafka,flink的工具)注意:因为我的是分布式,有些配置和伪分布式稍微有以写不同(千万注意)在我们一个一个启动下面的进程的时候,我们应该时刻关注内存使用情况 top2.1、框架版本hadoop 2.7.6hive 1.2.1zookeeper 3.4.6hbase 1.4.6kafka 1.0.0Flink 1.1...
批量、流式计算和离线、实时计算是按照不同维度划分的两套数据处理方式。批量、流式计算体现在数据计算方式的不同上。离线、实时计算则体现在对数据计算时延的要求上。
以 Flink 和 Spark 为代表的分布式流批计算框架的下层资源管理平台逐渐从 Hadoop 生态的 YARN 转向 Kubernetes 生态的 k8s 原生 scheduler 以及周边资源调度器,比如 Volcano 和 Yunikorn 等。这篇文章简单比较一下两种计算框架在 Native Kubernetes 的支持和实现上的异同,以及对于应用到生产环境我们还需要做些什么。1. 什么
实时计算特征无限数据基本上无限的数据集。这些通常被称为“流数据”,而与之相对的是有限的数据集无限数据处理一种持续的数据处理模式,能够通过处理引擎重复的去处理上面的无限数据,是能够突破有限数据处理引擎的瓶颈的低延迟时效性将是需要持续解决的问题实时计算架构Lambda架构数据从底层的数据源开始,经过Kafka、Flume等数据组件进行收集,然后分成两条线进行计算一条线是进入流式计算平台(例如 Stor
数栈是云原生—站式数据中台PaaS,我们在github和gitee上有一个有趣的开源项目:FlinkX,FlinkX是一个基于Flink的批流统一的数据同步工具,既可以采集静态的数据,也可以采集实时变化的数据,是全域、异构、批流一体的数据同步引擎。大家喜欢的话请给我们点个star!star!star!github开源项目:https://github.com/DTStack/flinkxgitee
1. 自定义序列化接入方案(Protobuf)在实际应用场景中, 会存在各种复杂传输对象,同时要求较高的传输处理性能, 这就需要采用自定义的序列化方式做相应实现, 这里以Protobuf为例做讲解。功能: kafka对同一Topic的生产与消费,采用Protobuf做序列化与反序列化传输, 验证能否正常解析数据。通过protobuf脚本生成JAVA文件syntax = "proto3&q
1. 订单支付状态跟踪统计(CEP运用)功能实现对热销商品的统计, 统计周期为一天, 每3秒刷新一次数据。核心代码主逻辑代码实现:/*** 执行Flink任务处理* @throws Exception*/private void executeFlinkTask() throws Exception {// 1. 创建运行环境StreamExecutionEnvironment env = Str
欢迎关注公众号——《数据三分钟》一线大厂的师兄师姐结合自己的工作实践,将数据知识浅显道来,每天三分钟,祝你成为数据达人。还有面试指导和内推机会。巧妇难为无米之炊,数据就是营销分析平台的米,每一个分析结论的产出都离不开数据。那么数据到底是怎么获取的,如何一步步走到我们的面前,如何熠熠闪光的展现在一个个报表上?在互联网电商领域,数以亿计的移动终端、PC网页,就是用户与系统交互的数据源泉。1、插一段历史
今天我们主要来讲一个很简单但是很常见的需求,实时计算出网站当天的pv值,然后将结果实时更新到mysql数据库,以供前端查询显示。接下来我们看看如何用flinksql来实现这个简单的功能。首先我们还是使用datagen生成测试数据,随机生成一些用户idString sourceSql = "CREATE TABLE datagen (\n" +" userid int,\n" +" proctime
简介最近负责公司基于flink实时计算平台的基本任务监控,包括重启通知,失败监控,一些关于flink 在pushgateway 上exported_job信息上报便于最后删除 pushgateway上的信息避免重复告警等,其实开始想的也是在网上找,没有找到,现在就总结一下自己的做法。第一次写博文不合理之处大家多多理解。修改flink的flink-conf.yaml配置文件具体配置讲解网上很多不赘述
@羲凡——只为了更好的活着Flink 窗口函数处理数据(Watermark和SideOutput)统计过去5分钟内的一些数据是流处理中最常见的一种模式。这就涉及到经典的一个问题——数据延迟或乱序怎么办?Flink,针对数据延迟或乱序有几个重要的解决思路,1.添加水位线Watermark2.推迟关闭窗口时间3.超时数据的side输出下面的例子是,统计10s内的数据,水位线位2s,窗口再延迟4s关闭,
此文选自Google大神Tyler Akidau的另一篇文章:Streaming 102: The world beyond batch 欢迎回来!如果您错过了我以前的帖子,Streaming-大数据的未来,强烈建议您先花时间阅读那篇文章。简要回顾一下,上一篇我们介绍了Streaming,批量与流式计算,正确性与推理时间的工具,数据处理模式,事件事件与处理时间,窗口化。 ...
产品模型API保证次数容错机制状态管理延时吞吐量成熟度StromNative组合式At-least-onceRecord ACKs无Very LowLowHighTridentmirco-batching组合式
在实时数据仓库建设中,Flink 作为流处理引擎的事实标准,Doris 作为 OLAP 数据库的新秀,两者的结合成为企业实时数据平台的常见架构选择。然而,在生产环境中我们遇到了一个普遍的痛点:"使用官方的 doris-flink-connector,其基于 Checkpoint 的二阶段提交(2PC)机制在千万级别数据同步时,吞吐量瓶颈明显,平均延迟从秒级跳升到分钟级。"这篇文章将详细展示我们如何
实时计算的发展历史只有十几年,它与基于数据库的计算模型有本质区别,实时计算是固定的计算任务加上流动的数据,而数据库大多是固定的数据和流动的计算任务,因此实时计算平台对数据抽象、延时性、容错性、数据语义等的要求与数据库明显不同,面向实时计算的数据架构也就发展起来。Transwarp Slipstream是一款通用的实时计算引擎,使用事件驱动和批处理统一的模型,在保证毫秒级别延迟的同时,帮助用户更高效
1.背景介绍1. 背景介绍Apache Flink 是一个流处理框架,用于实时数据处理和分析。它支持大规模数据流处理,具有高吞吐量和低延迟。Flink 可以处理各种类型的数据,如日志、传感器数据、事件数据等。在大数据领域,机器学习和预测分析是非常重要的。Flink 可以与机器学习库集成,实现流式机器学习和预测分析。在本文中,我们将介绍 Flink 的机器学习与预测分析案例。我们将从核心...
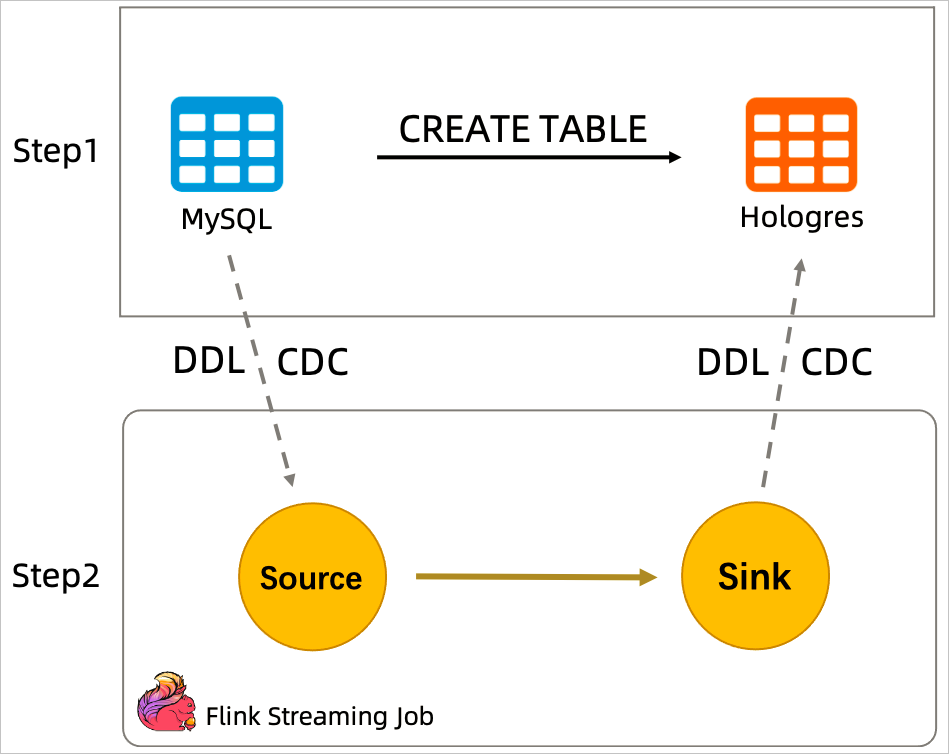
实时计算Flink版基于Flink CDC,通过开发YAML作业的方式有效地实现了将数据从源端同步到目标端的数据摄入工作。本文介绍如何快速构建一个YAML作业将MySQL库中的所有数据同步到StarRocks中。已创建Flink工作空间,详情请参见。上下游存储已创建RDS MySQL实例,详情请参见。已创建StarRocks实例,详情请参见。RDS MySQL和StarRocks需要与Flink工
实时统计pv、uv是再常见不过的大数据统计需求了,前面出过一篇SparkStreaming实时统计pv,uv的案例,这里用Flink实时计算pv,uv。我们需要统计不同数据类型每天的pv,...
Flink实时计算引擎入门教程
springboot集成flink-cdc,采集mysql数据并推送到kafka
对数据的实时性要求越来越高。传统的离线数仓(T+1)已无法满足业务对秒级响应的需求,而实时数仓和数据湖(Data Lake)架构正成为主流。然而,如何将业务数据库中的变更数据(Insert/Update/Delete)低延迟、高可靠、无侵入地同步到下游系统,一直是构建实时链路的关键挑战。
这次 Flink 编译任务,是 Koupleless 在新的实时计算场景中落地的成功探索,以一种新的方式使用类加载框架。在一个大基座上面运行 Job 类模块,流量触发运行,请求完即执行卸载,轻量快捷。欢迎大家碰到相关场景时使用 Koupleless,一起探索 Koupleless 更多的使用场景吧~
实时场景下的机器学习模型实时特征离线特征融合方案(踩坑指南)