实时计算架构选型——自我总结
·
实时计算特征
- 无限数据
- 基本上无限的数据集。这些通常被称为“流数据”,而与之相对的是有限的数据集
- 无限数据处理
- 一种持续的数据处理模式,能够通过处理引擎重复的去处理上面的无限数据,是能够突破有限数据处理引擎的瓶颈的
- 低延迟
- 时效性将是需要持续解决的问题
实时计算架构
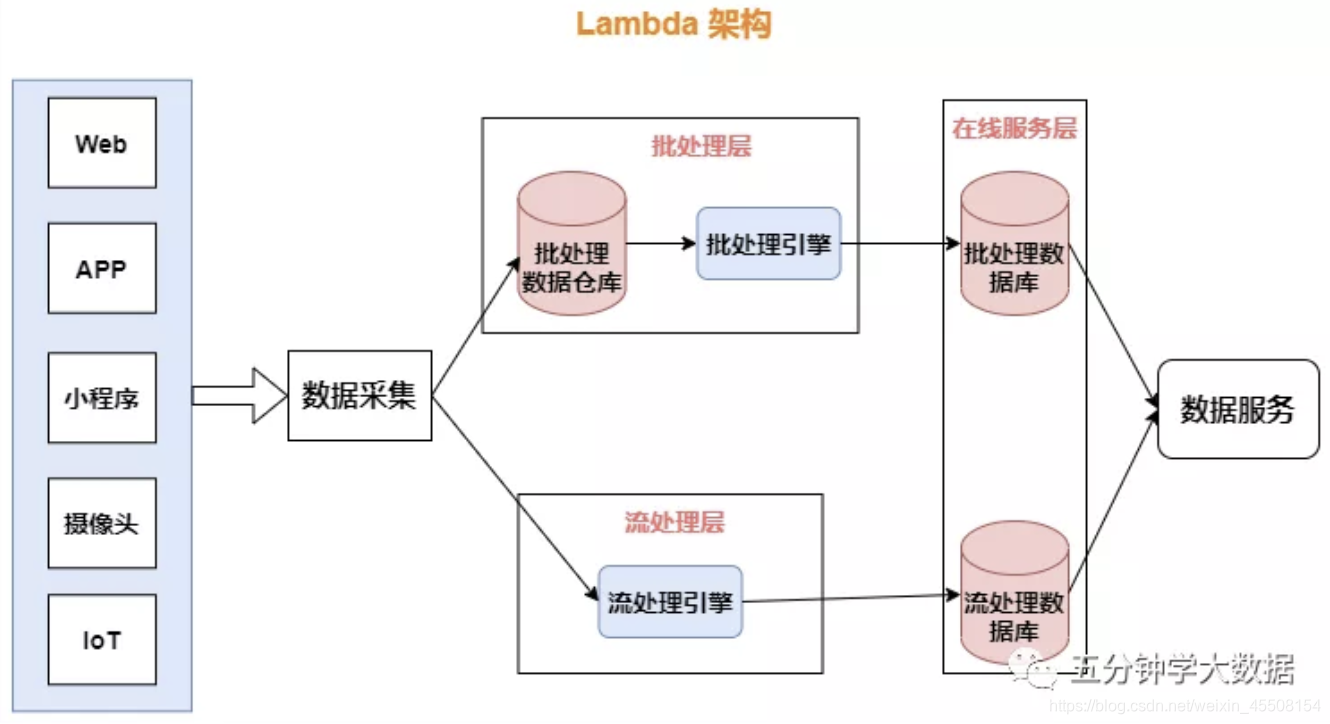
- Lambda架构
-
数据从底层的数据源开始,经过Kafka、Flume等数据组件进行收集,然后分成两条线进行计算
- 一条线是进入流式计算平台(例如 Storm、Flink或者SparkStreaming),去计算实时的一些指标
- 另一条线进入批量数据处理离线计算平台(例如Mapreduce、Hive,Spark SQL),去计算T+1的相关业务指标,这些指标需要隔日才能看见
-
为什么Lambda架构要分成两条线计算
- 批处理层存储管理主数据集(不可变的数据集)和预先批处理计算好的视图
- 批处理层使用可处理大量数据的分布式处理系统预先计算结果。它通过处理所有的已有历史数据来实现数据的准确性。这意味着它是基于完整的数据集来重新计算的,能够修复任何错误,然后更新现有的数据视图。输出通常存储在只读数据库中,更新则完全取代现有的预先计算好的视图
- 流处理层会实时处理新来的大数据
- 流处理层通过提供最新数据的实时视图来最小化延迟。「流处理层所生成的数据视图可能不如批处理层最终生成的视图那样准确或完整,但它们几乎在收到数据后立即可用」。而当同样的数据在批处理层处理完成后,在速度层的数据就可以被替代掉了
- 批处理层存储管理主数据集(不可变的数据集)和预先批处理计算好的视图
-
Lambda架构缺点
- 使用两套大数据处理引擎:
- 维护两个复杂的分布式系统,成本非常高
- 批量计算在计算窗口内无法完成:
- 在IOT时代,数据量级越来越大,经常发现夜间只有4、5个小时的时间窗口,已经无法完成白天20多个小时累计的数据,保证早上上班前准时出数据已成为每个大数据团队头疼的问题
- 数据源变化都要重新开发,开发周期长:
- 每次数据源的格式变化,业务的逻辑变化都需要针对ETL和Streaming做开发修改,整体开发周期很长,业务反应不够迅速
- 总结:导致 Lambda 架构的缺点根本原因:
- 要同时维护两套系统架构:批处理层和速度层。我们已经知道,在架构中加入批处理层是因为从批处理层得到的结果具有高准确性,而加入速度层是因为它在处理大规模数据时具有低延时性
- 使用两套大数据处理引擎:
-
Kappa架构
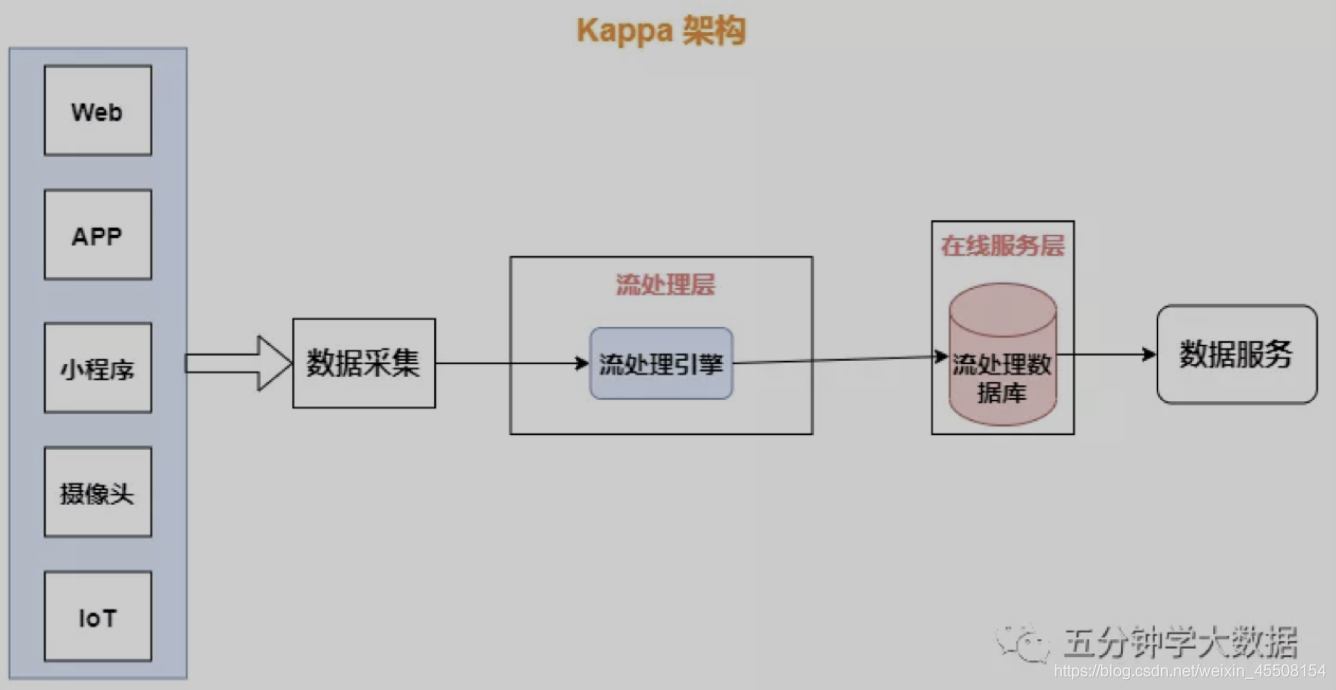
- 这种架构只关注流式计算,数据以流的方式被采集过来,实时计算引擎将计算结果放入数据服务层以供查询。可以认为Kappa架构是Lambda架构的一个简化版本,只是去除掉了Lambda架构中的离线批处理部分
- 「Kafka」不仅起到消息队列的作用,也可以保存更长时间的历史数据,以替代Lambda架构中「批处理层数据仓库」部分。流处理引擎以一个更早的时间作为起点开始消费,起到了批处理的作用
- Flink流处理引擎解决了事件乱序下计算结果的准确性问题
-
Lambda和Kappa架构对比:
- Lambda和kappa架构都有各自的适用领域;例如流处理与批处理分析流程比较统一,且允许一定的容错,用Kappa比较合适,少量关键指标(例如交易金额、业绩统计等)使用Lambda架构进行批量计算,增加一次校对过程
- 还有一些比较复杂的场景,批处理与流处理产生不同的结果(使用不同的机器学习模型,专家系统,或者实时计算难以处理的复杂计算),可能更适合Lambda架构
-
Kappa实时数仓架构:
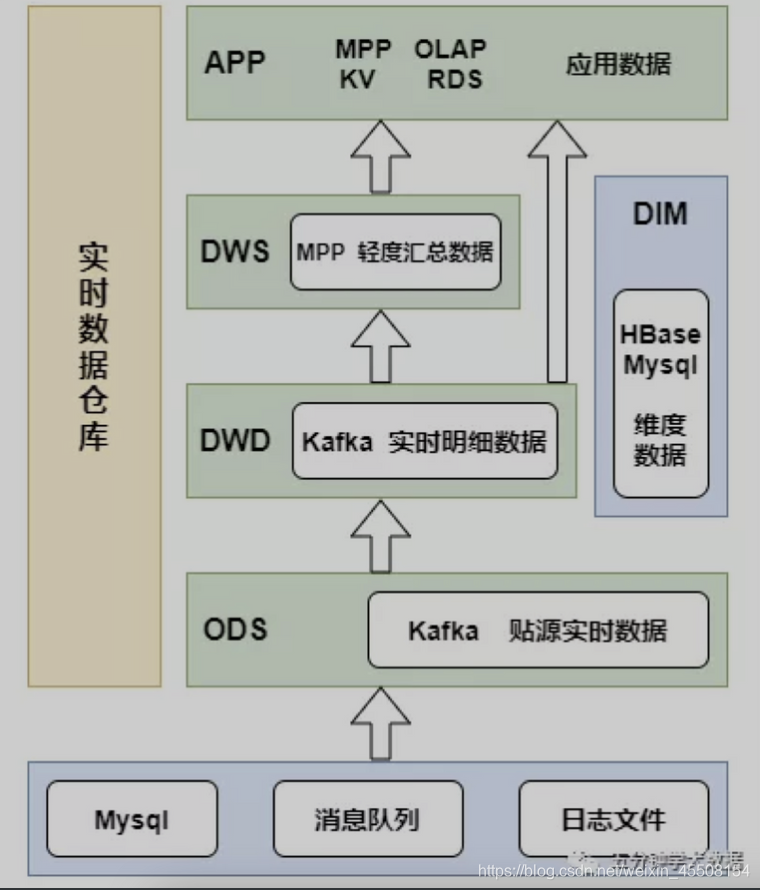
- 基于Flink的实时数仓数据流转过程
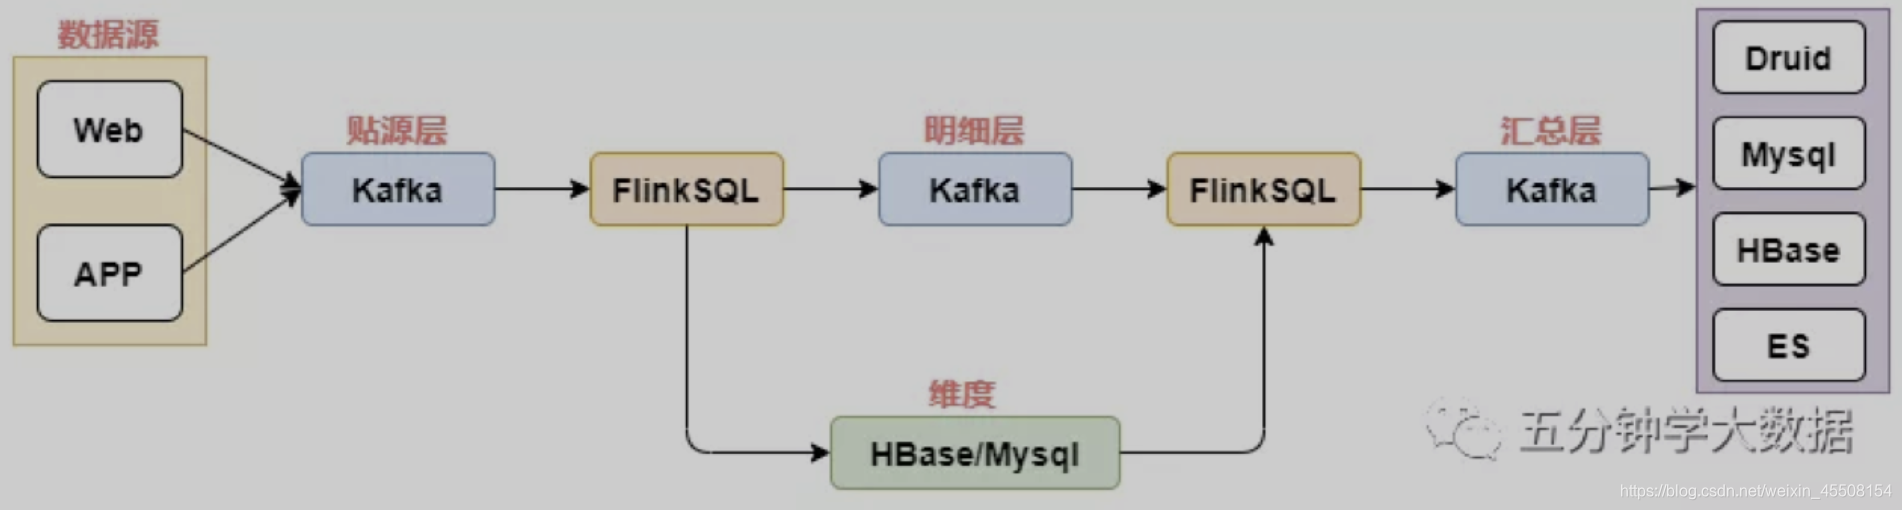
- 数据在实时数仓中的流转过程,实际和离线数仓非常相似,只是由Flink替代Hive作为了计算引擎,把存储由HDFS更换成了Kafka,但是模型的构建思路与流转过程并没有发生变化

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)