登录社区云,与社区用户共同成长
邀请您加入社区
使用NPOI读取EXCEL数据量大超过65535行引起OutOfMemoryException的解决办法之一使用OpenXml
摘要:随着Flink1.5的发布,FlinkSQL 流批一体更加成熟与完善。Flink SQL可以替代Flink DataStream实现窗口计算。1 Flink翻滚窗口适用场景1.1定义将数据依据固定的窗口度对无界数据流进行切片。1.2特点时间对、窗口长度固定、event无重叠。1.3适用场景BI统计(计算各个时间段的指标)2 Flink SQL窗口编程模型Table table = input
Kappa架构解析:实时数仓的轻量级解决方案 随着实时计算框架的成熟,Kappa架构正成为替代传统Lambda架构的新选择。Kappa架构采用全流式设计,通过单一流处理管道实现实时计算和历史数据重算,解决了Lambda架构双轨维护的痛点。其核心组件包括Kafka消息队列、Flink计算引擎和实时存储层,通过流式重放机制实现数据一致性。相比Lambda架构,Kappa具有架构简单、维护成本低、数据一
Flink 批流统一的核心在于将批与流的数据都视为动态表,通过变更日志(Changelog)表示数据的演进(增删改)。查询可能因聚合、Join 等操作显式依赖状态,或受上下游数据特征影响隐式引入状态(如 Changelog 归一化)。DataStream 与 Table API 可通过 StreamTableEnvironment 桥接,支持事件时间、水印传递及状态 TTL 配置(全局或算子级)。
LINQ按多列分组(Group By)并计算总和(Sum)SQL语句:SELECT * FROM <TableName> GROUP BY <Column1>,<Column2>QuantityBreakdown(MaterialID int,ProductID int,Quantity float)INSERT INTO @QuantityBreakdown
ado.net提供了丰富的数据库操作,这些操作可以分为三个步骤:对返回“结果”的操作可以分为两类:两者比较:一张十分出名的ADO.NET结构图:string connectString = "Data Source=.;Initial Catalog=Student;Integrated Security=True";命名空间:System.Data.SqlClient.Sql
安卓7.1-3128搭载正基芯片—蓝牙遥控器二次断开蓝牙无法切换到红外无响应修复
druid.getConncetion
计算机中有符号整数的取值范围
数据库连接池爆掉排查
FOSSID简介:FOSSID总部位于瑞典首都斯德哥尔摩。由一群开源技术专家组成的研发团队,该团队拥有18年的开源研发、管理、测试经验。在Github、Gitkraken等全球知名开源社区的开源代码检测工具排行榜均位列第一。而在中国的开源社区及开源治理白皮书中多次被提名。作为开源治理的标杆,中国赛迪检测认证中心、中国赛宝实验室,中国电子技术标准化研究院塞西实验室,中国信息通信研究院,中国信息安全测
HPL-用于分布式内存计算机的高性能Linpack基准的便携式实现
dbaccess sysmaster -select* from sysdbslocale where dbs_dbsname not like 'sys%';常用的基本上就是如上几种, 需要注意是否开启了GL_USEGLU环境变量。注意:1。 是每个database一个字符集,没有办法做到每张表一个字符集;2。不同的database可以拥有不同的字符集,访问字符集不同的database,连接字符
恰好开发一个winform程序,希望在客户端存储一些信息,在离线状态下也能够同步数据库。本来解决方案是在本地采用xml 文件进行存储数据,也很好实现,但是xml文件操作起来没有数据库那么方便,于是就更改了解决方案,采用SQLLite这个轻量级数据库。 1. 软件工具:visual studio 2008 框架:NET framework 3.5 2. 数据库的部署,
一、创建数据库创建test数据库,字符编码采用utf-8mb4二、创建学生表创建t_student表,包含id,name,gender,age,插入至少5条记录查看t_student表设计在t_student表中,插入至少5条记录三、创建日志表创建t_log表,包含id,time,operation,detail查看t_log表设计四、创建触发器三个触发器:trigger_insert、trigg
以下是一些可能有用的查询:SELECT TRUNC(partnum/16777216) dbspace,COUNT(*) tables, SUM(nrows) tot_rows,SUM(nrows*rowsize) bytesFROM systablesWHERE tabtype = 'T'GROUP BY 1ORDER BY 1;如果将 "dbspaces" 表添加到数据库中,并使用从...
本文摘要提供了一个MySQL到Kafka的CDC(变更数据捕获)pipeline快速配置指南。核心内容包括: 最小可用配置模板:包含MySQL源和Kafka汇的基本参数,支持表名正则匹配 主题路由策略:默认按表名自动生成主题,也支持固定主题或自定义映射 分区策略:支持全写入0分区或按主键哈希分发 消息格式:提供debezium-json和canal-json两种格式选择 Kafka生产者参数:可透
数据库连接LinqPad的时候,可以设置连接语句
移动数据连接首先System Trace 中[AT_RX p36,ch0]AT+EAPNACT=1,"3gnet","default",0,,"dnn=3gnet",,0=> Decode:PDP context activate or deactivate without the cid +EAPNACT<state> : 1(activated)<apn_name>
在时序数据的处理中,经常要对原始数据进行清洗、预处理,再使用时序数据库进行长久的储存,而且经常还需要使用原始的时序数据通过计算生成新的时序数据。在传统的时序数据解决方案中,常常需要部署 Kafka、Flink 等流处理系统,而流处理系统的复杂性,带来了高昂的开发与运维成本。TDengine 的流计算引擎提供了实时处理写入的数据流的能力,使用 SQL 定义实时流变换,当数据被写入流的源表后,数据会被
xml映射文件:<select id="selectImages" resultType="org.jeecg.modules.supervise.device.entity.DataCollector">SELECTt1.*FROMdata_collector t1WHEREt1.collector_id in<foreach item="id" coll
前端导出数据时,开头是0的数据导出不显示问题!
layui组件的导出表格功能
对账模块是支付系统的核心功能之一,不同业务设计的对账模型不同,但是都会遇到以下几个问题:海量的数据,就目前聚合支付的订单量来看,设计的对账系统需要应对千万级的数据量;面对日切、多账、少账等异常差异订单应该如何处理;账单格式、下载账单时间、下载方式等不一致问题。针对以上问题,并结合财经聚合支付系统的特点,本文将设计一套可以应对千万级数据量、分布式和高可用的对账系统,利用消息队列Kafka的解耦性解决
1.使用ResultMap指定Long类型在查询数据的那一块的Resultmap指定为你刚才定义的那个ResultMap<resultMap id="ResultOfLongPersonId" type="java.lang.Long"><result column="person_id" property="personId" javaType="long"/></
SELECT @@IDENTITYSQL Server添加数据后返回ID
为什么要进行子网划分?方便管理方便识别什么是子网划分网络位向主机位借位T1.192.168.1.0/24划分为4个小网段,求每个子网的有效ip地址段、子网掩码、广播地址192.168.1.0默认子网掩码为255.255.255.0,即192.168.1为网络号,子网划分需要从第四个个字节第一个比特开始。划分4个子网需要向主机位借2位{00,01,10,11}子网1网络地址:192.168.1.00
//循环录入五个人的年龄并计算平均年龄//如果录入的数据出现负数,或者大于100的数,立即停止或报错int sum = 0;bool a = true;for (int i = 0; i < 5; i++){try {Console.WriteLine("请输入你的年龄{0}", i + 1);...
Linq实现集合数据的快速转换、筛选、排序、分组!
两行代码去除数据库中富文本标签!!!
///声明数组,用于保存数据库的二进制数据。Result.Message = "成功";Result.Message = "失败";//创建命令对象,con参数是一个连接对象。////读取数组数据成为文件流。////读取数据保存到数组中。////转换成为图片格式。/// 查询商品数据。
1.转载 鼠标移动到Chart控件图表数据点处,显示相关信息_浊酒入清梦的博客-CSDN博客设置序列工具提示和标记属性:series.ToolTip = "X值:#VALX\nY值:#VALY";series.MarkerSize = 5;series.MarkerStyle = MarkerStyle.Circle;#VALX//x轴数据#VALY//y轴数据#PERCENT//百分比#AVG/
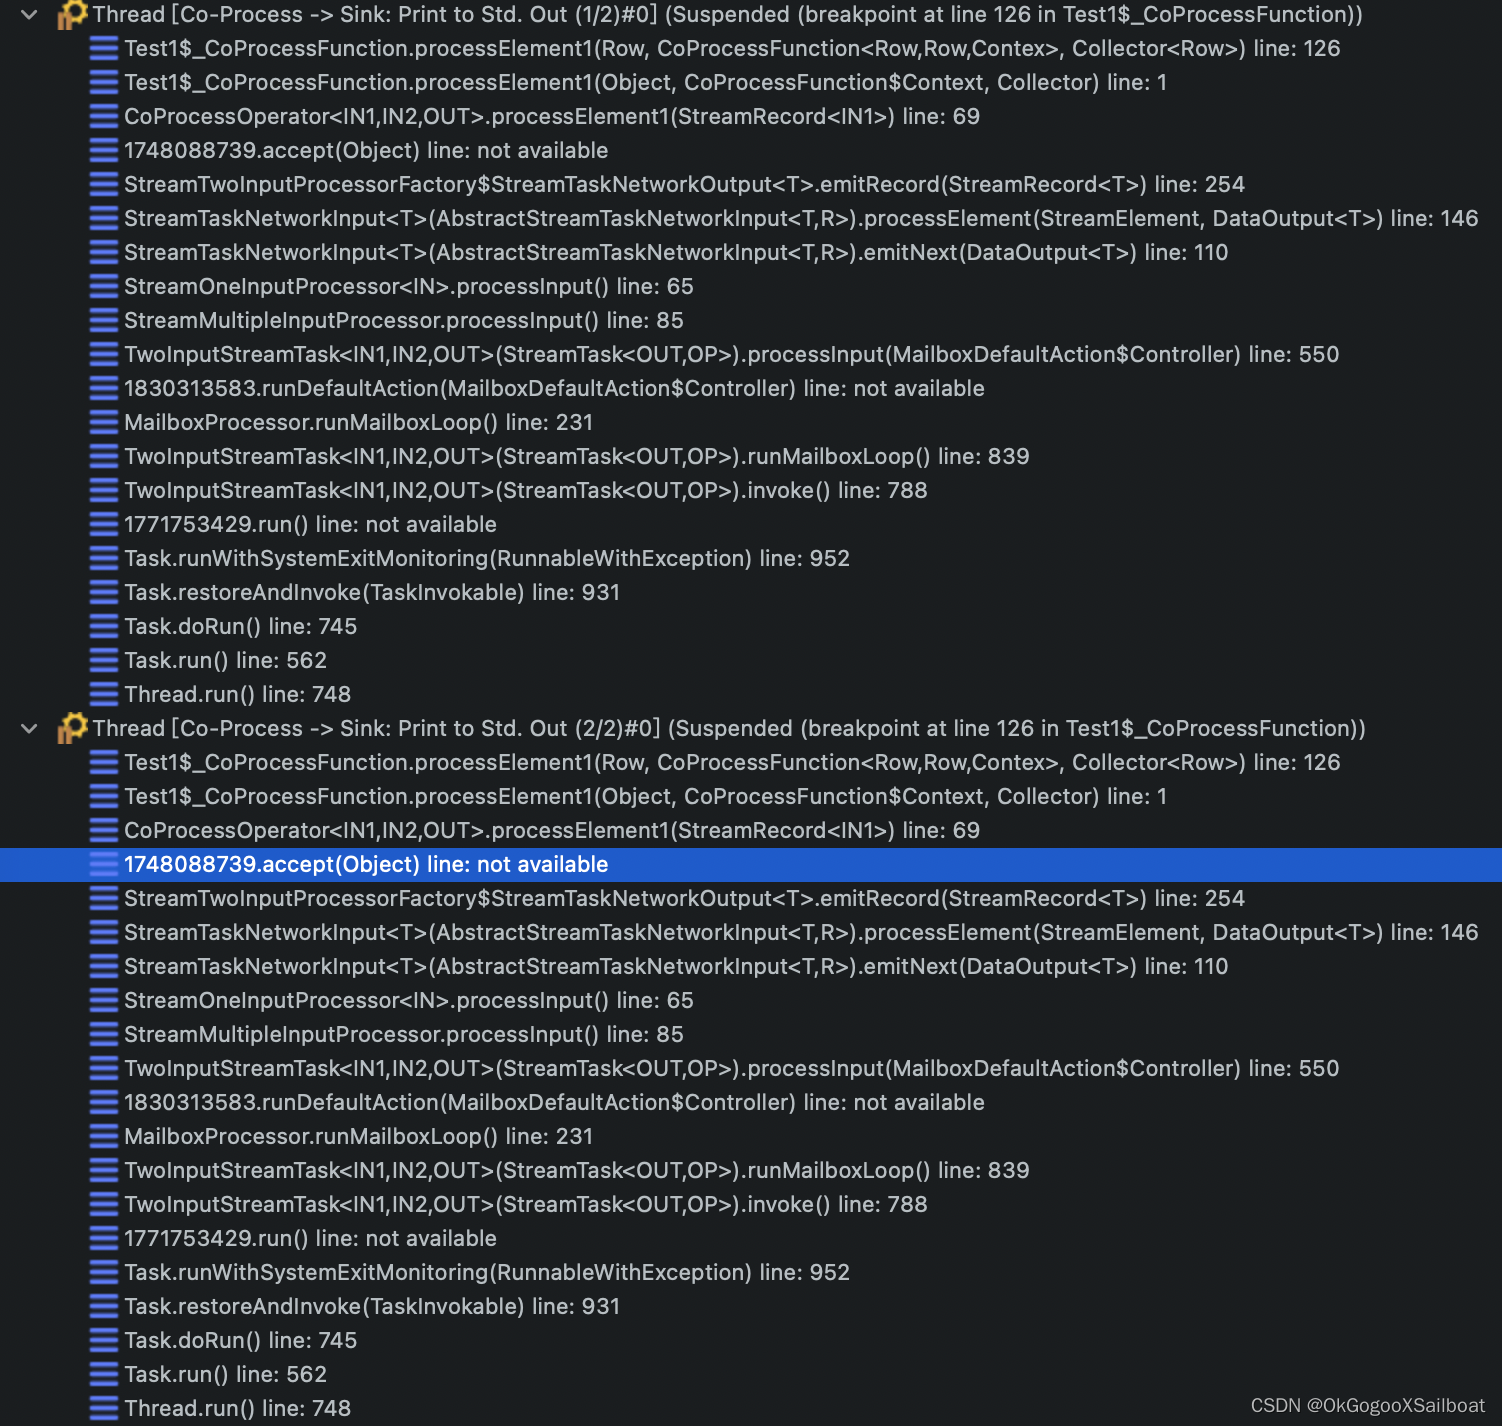
1. 背景笔者带领的团队在自研的大数据平台XSailboat 上进行专家策略规则的计算管道开发时,遇到这样一种情形:计算管道中存在一条配置流和数据流通过广播方式合流的情形。配置流和数据流的输入源都是Kafka主题,但是是两个不同的Kafka主题。配置流的Kafka主题中存储的是规则配置,数据流中存储的是要分析的数据。在开发调试的时候,这两个主题中已有数据,一调试运行,数据流先到达被处理,配置流晚到
转自:微点阅读 https://www.weidianyuedu.com1. For XML 语句1)语法:FOR XML mode [, XMLDATA] [, ELEMENTS][, BINARYBASE64]2)参数:l XML mode指定 XML 模式。XML 模式决定所得到的 XML 的形式。mode 可以是 RAW、AUTO 或 EXPLICIT。l XMLDATA指定应返回 XML
示例from(bucket: "example-bucket")|> range(start: -1h)|> filter(fn: (r) =>r._measurement == "example-measurement" andr._field == "example-field")influxdb2开始可以使用flux语法查询每个 Flux 查询都需要包含以下部分:1.数据源
我们搜索手机的时候 其实可以通过协议返回一些用户的数据微信的数据还是很准确的 很适合做检测其中sex 参数种 0未知 1男 2女V3 v4 数据用于添加好友接口http://{{localhost}}/contact/SearchContact{"code": 0,"MSG": "操作成功!","data": {"msg": "success","result": {"data": {"TX":
实现方式这里选择了两种常用的方式,都是使用List操作;第一种实现思路如下:<1> 原先存放数据的List为recordList,求出共需批量处理的次数;<2> 新建一个List为list,循环后,将recordList的前maxValue条数据放到list里;<3> 调用批量处理方法,调用recordList的removeAll方法将list中的数据从reco