李航老师《统计学习方法》第七章:SVM支持向量机(SMO算法)python代码实现
·
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
import pandas as pd
import numpy as np
import math


class SVM:
    def __init__(self):
        self.train_data = None  # 训练数据
        self.train_label = None  # 训练数据的标签

        self.Num = None  # 训练数据的总个数
        self.num = None  # 样本特征的数目(本数据集为4)

        self.sigma = None  # 高斯核函数中的分母σ
        self.C = None  # 惩罚参数C
        self.toler = None  # 判断是否满足kkt条件引入的松弛变量

        self.k = None  # 核函数对应的gram矩阵
        self.b = None  # 偏置项b
        self.alpha = []  # 真正需要求得的变量α
        self.E = []  # 目前的g(xi,α,b)-yi的误差Ei
        self.supportVector = [] # 存储支持向量,因为最后预测的时候只用到支持向量

    def calcKernal(self, x, z):
        result = np.dot((x - z), (x - z).T)  # X-Z的二范数的平方
        result = np.exp(-result / 2 * (self.sigma ** 2))
        return result

    # 计算高斯核函数对应的gram矩阵
    def calcKernal_gram(self):
        k = np.zeros((self.Num, self.Num))  # 初始化一个N*N的0矩阵

        for i in range(self.Num):
            X = self.train_data[i]
            # 由于对称矩阵的性质,所以内循环只需要从i开始遍历
            for j in range(i, self.Num):
                Z = self.train_data[j]
                result = self.calcKernal(X, Z)
                # 由于gram矩阵是对称矩阵。所以k[i][j] = k[j][i]
                k[i][j] = result
                k[j][i] = result
        # 返回高斯核函数的gram矩阵存储使用
        return k

    # 初始化SVM类中的各个参数
    def init_para(self, train_data, train_label, sigma=10, C=200, toler=0.001):
        self.train_data = train_data
        self.train_label = train_label.T  # 标签变为列向量
        self.Num = train_data.shape[0]
        self.num = train_data.shape[1]
        self.sigma = sigma
        self.C = C
        self.toler = toler
        self.k = self.calcKernal_gram()
        self.b = 0
        self.alpha = [0] * self.Num
        self.E = [-self.train_label[i] for i in range(self.Num)]

    # 计算g(xi,α,b)的值
    def calc_gxi(self, i):
        gxi = 0
        # 取出αi>0的索引index,只有αi>0,对应的(xi,yi)才是支持向量,才纳入g(xi)的运算
        index = [i for i, alpha in enumerate(self.alpha) if alpha > 0]

        for j in index:
            gxi += self.alpha[j] * self.train_label[j] * self.k[j][i]
        gxi += self.b
        return gxi

    # 计算Ei=g(xi) - yi
    def calc_Ei(self, i):
        return self.calc_gxi(i) - self.train_label[i]

    # αi是否满足kkt条件
    def isSatisfyKKT(self, i):
        gxi = self.calc_gxi(i)
        yi = self.train_label[i]
        # 由于满足kkt条件十分的苛刻,所以我们取一个极小的toler=0.001
        # 当|αi|<toler时我们就认为αi=0
        if (math.fabs(self.alpha[i]) < self.toler) and (gxi * yi >= 1):
            return True
        # 当|αi-C|<toler我们就认为αi=C
        elif (math.fabs(self.alpha[i] - self.C) < self.toler) and (gxi * yi <= 1):
            return True
        # αi > 0-toler 看作是 αi>0
        # αi < C+toler 看作是 αi<C
        # |gxi*yi -1| < toler 看作是gxi*yi=1
        elif ((self.alpha[i] > -self.toler) and (self.alpha[i] < self.C + self.toler)) \
                and (math.fabs(gxi * yi - 1) < self.toler):
            return True

        return False

    # 根据α2挑选α1
    def get_second_alpha(self, E2, i):
        E1 = 0
        max_E1subE2 = -1
        max_alpha1_idx = -1

        for j in range(self.Num):
            E1 = self.calc_Ei(j)
            if math.fabs(E1 - E2) > max_E1subE2:
                max_E1subE2 = math.fabs(E1 - E2)
                max_alpha1_idx = j

        # 返回E2的值和对应的索引
        return self.calc_Ei(max_alpha1_idx), max_alpha1_idx

    # 开始训练
    def fit(self, train_data, train_label, max_iter=100):
        self.init_para(train_data, train_label)
        iter_count = 0  # 记录迭代次数
        para_changed = 1  # 记录参数是否发生改变
        # 只有当未到达最大迭代次数,并且上次迭代的参数有改变才会进入下次迭代
        while (iter_count < max_iter) and (para_changed > 0):
            para_changed = 0
            iter_count += 1
            # 遍历每一个alpha
            for i in range(self.Num):
                # 如果αi不满足kkt条件,选择它作为第一个变量
                if not self.isSatisfyKKT(i):
                    E2 = self.calc_Ei(i)
                    alpha2_idx = i
                    E1, alpha1_idx = self.get_second_alpha(E2, i)  # 根据alpha2选择alpha1

                    alpha2_old = self.alpha[alpha2_idx]
                    alpha1_old = self.alpha[alpha1_idx]
                    y1 = self.train_label[alpha1_idx]
                    y2 = self.train_label[alpha2_idx]
                    k11 = self.k[alpha1_idx][alpha1_idx]
                    k22 = self.k[alpha2_idx][alpha2_idx]
                    k12 = self.k[alpha1_idx][alpha2_idx]

                    # z=k11+k22-2k12
                    z = k11 + k22 - 2 * k12
                    # 得到未经剪辑的新alpha2
                    alpha2_new_unc = alpha2_old + ( y2 * (E1 - E2) ) / z

                    # 剪辑工作:
                    L, H = 0, 0  # 新α2需要满足的上下界
                    if self.train_label[alpha1_idx] == self.train_label[alpha2_idx]:
                        L = max(0, alpha2_old + alpha1_old - self.C)
                        H = min(self.C, alpha2_old + alpha1_old)
                    else:
                        L = max(0, alpha2_old - alpha1_old)
                        H = min(self.C, self.C + alpha2_old + alpha1_old)

                    # 对新得到的alpha2进行剪辑
                    alpha2_new = alpha2_new_unc
                    if alpha2_new_unc > H:
                        alpha2_new = H
                    elif alpha2_new_unc < L:
                        alpha2_new = L

                    # 更新α1
                    alpha1_new = alpha1_old + y1 * y2 * (alpha2_old - alpha2_new)
                    # 更新新的b1和b2
                    b1_new = -E1 - y1 * k11 * (alpha1_new - alpha1_old)\
                             - y2 * k12 * (alpha2_new - alpha2_old) + self.b
                    b2_new = -E2 - y1 * k12 * (alpha1_new - alpha1_old)\
                             - y2 * k22 * (alpha2_new - alpha2_old) + self.b

                    # 判断新的α1和α2能否真的用来更新b
                    if (alpha1_new > 0) and (alpha1_new < self.C):
                        bnew = b1_new
                    elif(alpha2_new > 0) and (alpha2_new < self.C):
                        bnew = b2_new
                    else:
                        bnew = (b1_new + b2_new)/2

                    # 把更新之后的新变量彻底写入原本存储的变量中
                    self.b = bnew
                    self.alpha[alpha1_idx] = alpha1_new
                    self.alpha[alpha2_idx] = alpha2_new
                    self.E[alpha1_idx] = self.calc_Ei(alpha1_idx)
                    self.E[alpha2_idx] = self.calc_Ei(alpha2_idx)

                    # 如果新旧的alpha2之间的差别大于0.00001就认为更新有效,允许下一次迭代
                    if math.fabs(alpha2_new - alpha1_new) >= 0.00001:
                        para_changed += 1
        # 迭代全部结束
        for i in range(self.Num):
            # 大于alpha>0代表支持向量
            if self.alpha[i] > 0:
                self.supportVector.append(i)

    # 决策函数sign
    def sign_fun(self, data):
        if data >= 0 :
            return 1
        else :
            return -1

    def predict(self, test_data):
        result = 0
        for i in self.supportVector:
            result += self.alpha[i] * self.train_label[i] * self.calcKernal(test_data, self.train_data[i])
        result += self.b
        return self.sign_fun(result)

    def score(self, test_x, test_y):
        score = 0
        for i in range(test_x.shape[0]):
            if self.predict(test_x[i]) == test_y[i]:
                score += 1
        return score / test_x.shape[0]


def create_data():
    # 加载iris数据集取前一百个数据,每个数据有四个特征(x1,x2,x3,x4)和一个label(0/1)
    iris = load_iris()
    df = pd.DataFrame(iris.data, columns=iris.feature_names)
    df['label'] = iris.target
    data_x = np.array(df.iloc[:100, :4])
    data_y = np.array(df.iloc[:100, -1])
    data_y[data_y == 0] = -1  # 把标签中的0换成-1(负类)
    return data_x, data_y


if __name__ == '__main__':
    X, Y = create_data()
    x_train, x_test, y_train, y_test = train_test_split(X, Y, test_size=0.3)
    clf = SVM()
    clf.fit(train_data=x_train, train_label=y_train, max_iter=100)
    score = clf.score(x_test, y_test)
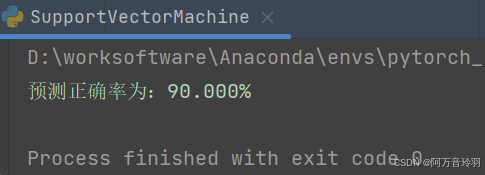
    print("预测正确率为:{:.3f}%".format(score*100))
实际预测成功率并不稳定

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 26
 0
- 0


 已为社区贡献4条内容

所有评论(0)