arXiv 2026 |Earth-OneVision:扩展遥感多模态大语言模型以支持更多传感器模态和任务
1. 论文信息
- 论文题目 Earth-OneVision: Extending Remote Sensing Multimodal Large Language Models to More Sensor Modalities and Tasks*
- 论文作者 Miaoxin Cai 等
- 发表单位 暂未可知
- 发表会议 arXiv 2026
- 代码链接 未公开
2. 论文创新点
- 从单点视觉语言对齐扩展到多层对齐。 不只把视觉编码器最后一层特征投影给语言模型,而是让中间视觉层参与特征融合,并将中间层特征注入语言模型早期层。
- 把空间结果转成语言模型可生成的 Token。 水平框、旋转框和像素掩码都编码为离散 Token 序列,与自然语言共享一个自回归解码器和交叉熵目标。
- 用分阶段训练拆解遥感域差异。 先从自然图像适配到光学遥感,再逐步加入 SAR、红外、多光谱、时序、视频及跨传感器数据。
- 用单一模型覆盖多传感器、多任务。 模型不为每种传感器分别搭建专用编码器,而是通过输入组织方式统一处理单图、多图和序列输入。
3. 论文主要贡献
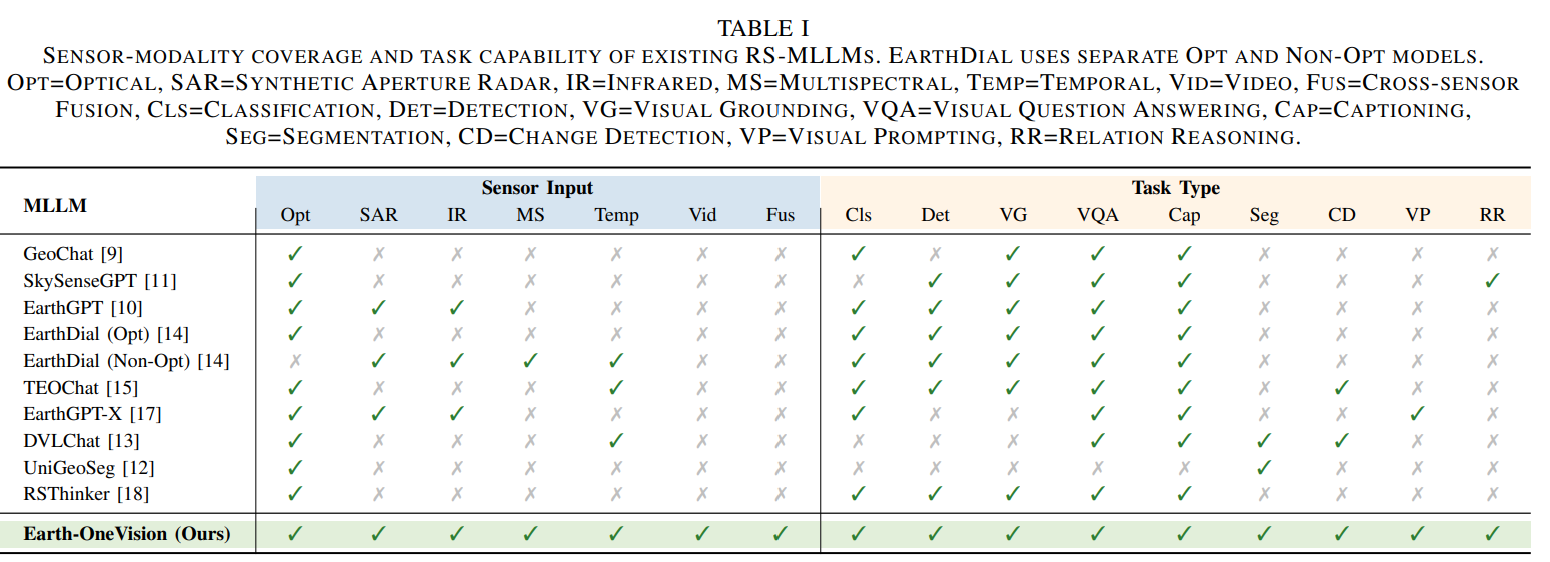
- 提出 Earth-OneVision:一个 2B 参数模型,覆盖 6 种传感器模态及跨传感器融合,支持 9 类主任务、25 个子任务
-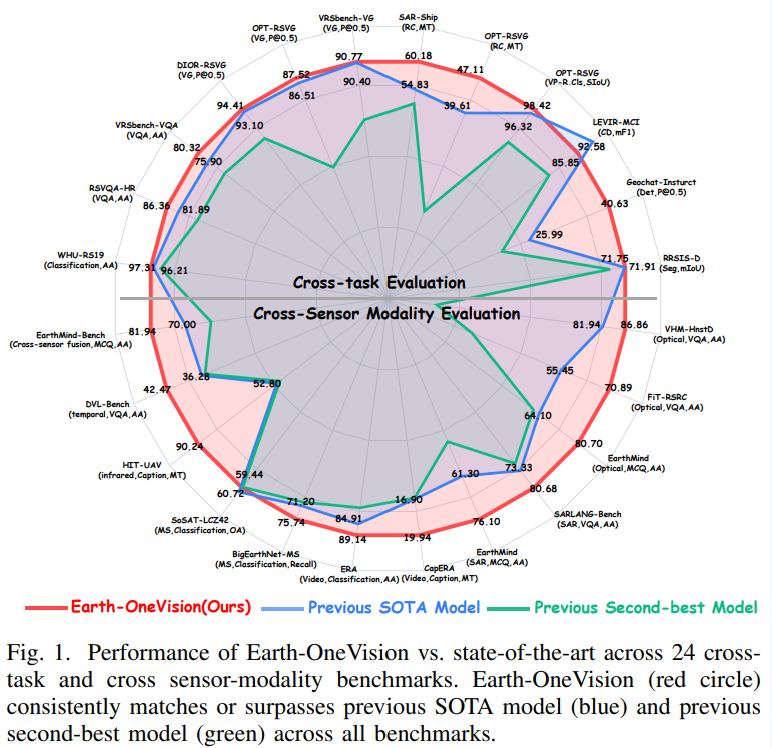
上图所示为Earth-OneVision与最新状态的模型在24个跨任务和跨传感器模态基准测试中的性能表现
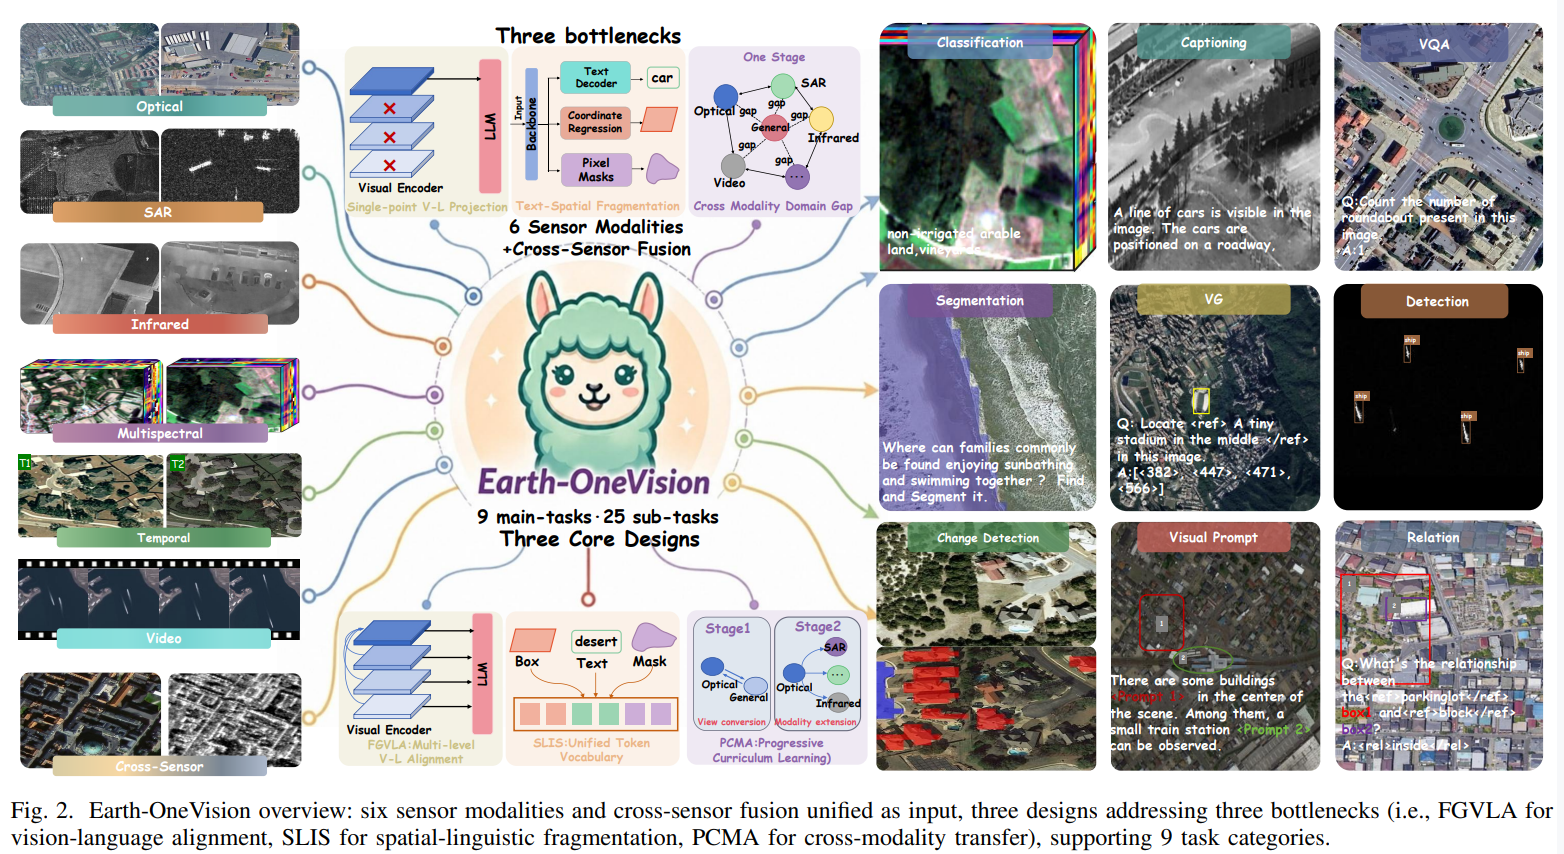
- 提出三项架构设计:FGVLA(全粒度视觉语言对齐)、SLIS(空间语言同构序列化)和 PCMA(渐进式跨模态适配)
- 构建 MMRS-OneVision 指令数据集,包含约 3,400 万 QA 对
论文统计中,VQA 约 9.9M、检测约 6.5M、图像描述约 7.5M,覆盖 6 种传感器模态与跨传感器融合 - 在 24 个遥感基准上进行跨任务、跨模态评估;论文报告 2B 模型整体可与部分 4B–72B 模型竞争或超过
4. 研究方法
4.1 整体模型结构
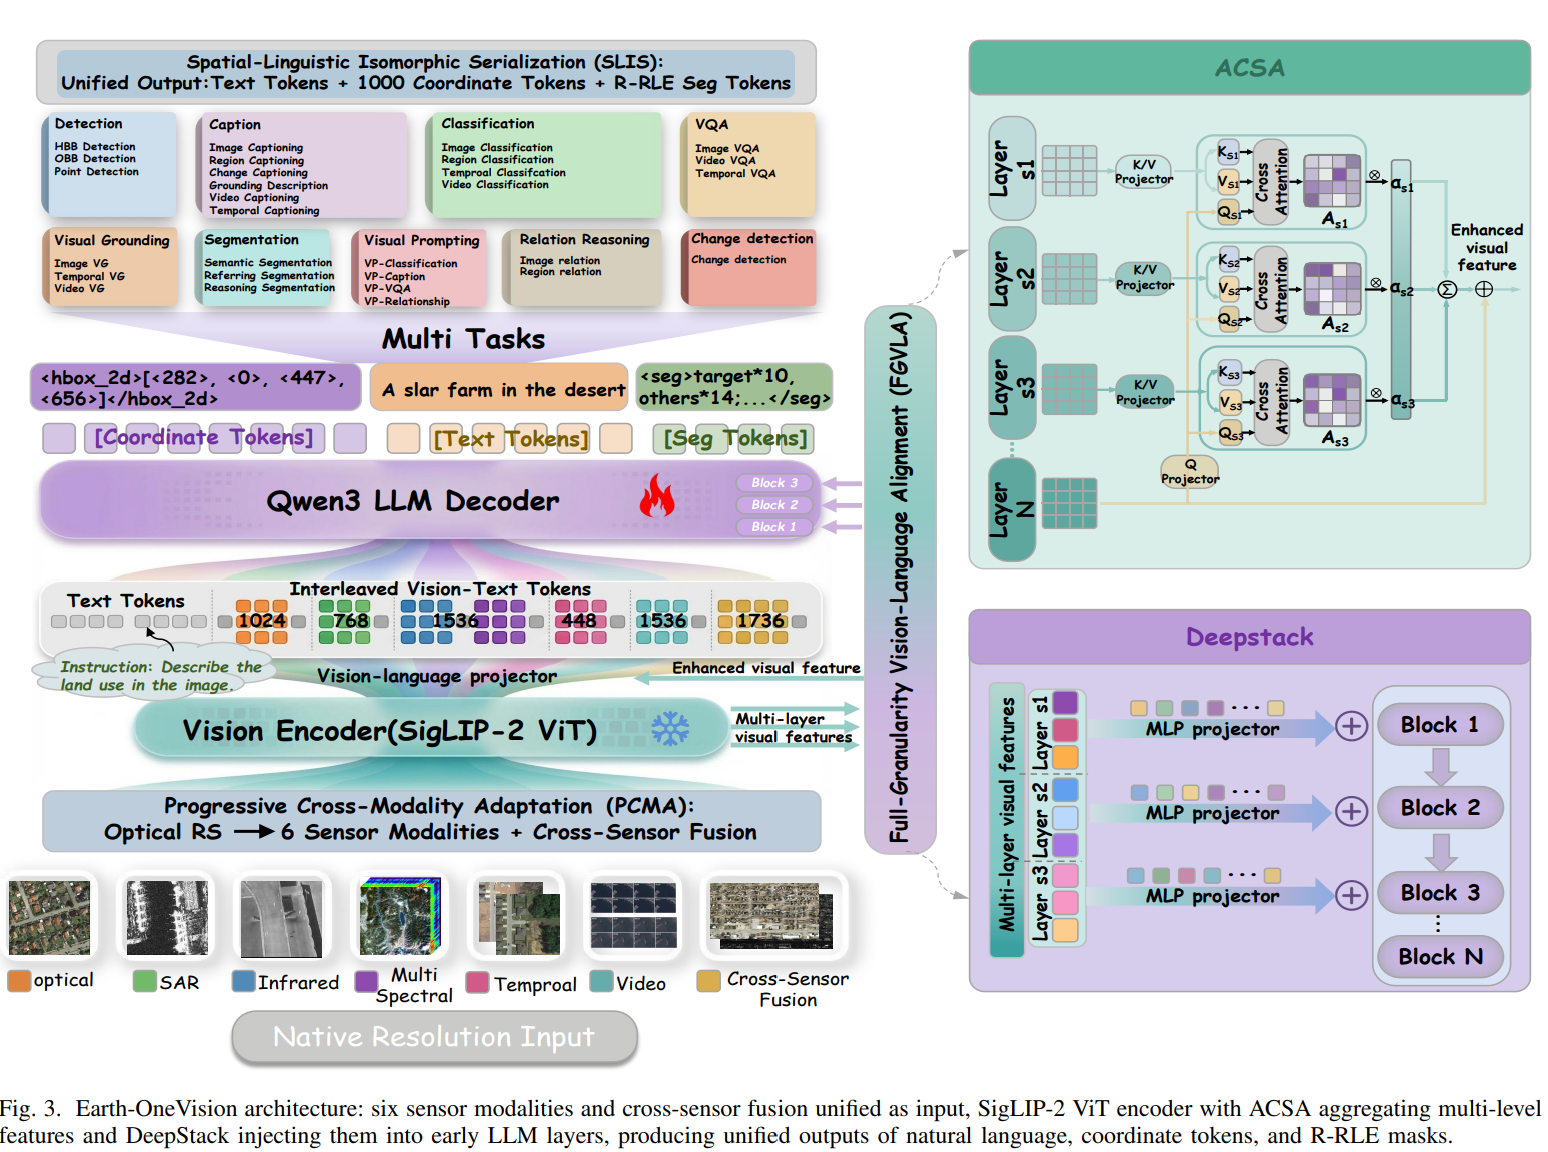
遥感图像+任务指令->输入视觉编码器->提取多层视觉特征->FGVLA中ACSA融合特征+DeepStack分层注入特征->视觉语言投影器->视觉token与文本token一起进入大模型->生成文字/坐标/分割token
4.2 FGVLA:全粒度视觉语言对齐
遥感图像经过视觉编码器后,会产生多个层级的视觉特征。较浅层通常包含边缘、纹理和局部结构,较深层包含更抽象的目标与场景语义。若只把视觉编码器最后一层特征传给语言模型,中间层信息可能无法充分利用;同时,语言模型内部也缺少直接读取不同层级视觉信息的途径。
为此,Earth-OneVision 提出 FGVLA(Full-Granularity Vision-Language Alignment,全粒度视觉语言对齐)。它包含两个互补模块:
- ACSA: 将视觉编码器不同层级的特征融合到最终视觉表示中;
- DeepStack: 将不同层的视觉特征分别注入语言模型的早期层。
4.2.1 ACSA:自适应跨尺度注意力
ACSA 从视觉编码器中取出 S = 3 S=3 S=3 个中间层特征:
{ F l 1 , F l 2 , F l 3 } \{F^{l_1},F^{l_2},F^{l_3}\} {Fl1,Fl2,Fl3}
其中, F l s F^{l_s} Fls 表示第 s s s 个中间层的视觉特征, F N F^N FN 表示视觉编码器最后一层特征。ACSA 使用最后一层特征作为 Query,并从每个中间层特征中提取 Key 和 Value。
第一步:生成 Query、Key 和 Value
对于第 s s s 个中间层:
Q s = F N W Q + Δ q s Q_s=F^N W_Q+\Delta q_s Qs=FNWQ+Δqs
K s = F l s W K , s d W K , s u , V s = F l s W V , s d W V , s u K_s=F^{l_s}W^d_{K,s}W^u_{K,s}, \qquad V_s=F^{l_s}W^d_{V,s}W^u_{V,s} Ks=FlsWK,sdWK,su,Vs=FlsWV,sdWV,su
其中:
- Q s Q_s Qs、 K s K_s Ks、 V s V_s Vs 分别表示第 s s s 个尺度的 Query、Key 和 Value;
- W Q W_Q WQ 是 Query 的线性投影矩阵;
- W K , s d W^d_{K,s} WK,sd、 W V , s d W^d_{V,s} WV,sd 和 W K , s u W^u_{K,s} WK,su、 W V , s u W^u_{V,s} WV,su 是 Key、Value 的低秩投影矩阵;
- Δ q s \Delta q_s Δqs 是第 s s s 个尺度对应的可学习偏置,用于调整 Query 对该层特征的关注方式;
- 低秩投影的秩 r r r 远小于特征维度 d d d,即 r ≪ d r\ll d r≪d,这样可以控制额外参数量。
第二步:从中间层提取相关信息
Query 与 Key 计算相关性,再通过 Softmax 得到注意力权重,并对 Value 加权:
A s = Softmax ( Q s K s ⊤ d h ) V s A_s= \operatorname{Softmax} \left( \frac{Q_sK_s^\top}{\sqrt{d_h}} \right)V_s As=Softmax(dhQsKs⊤)Vs
其中:
- A s A_s As 是从第 s s s 个中间层提取出的注意力特征;
- d h d_h dh 是注意力头的维度;
- 除以 d h \sqrt{d_h} dh 是缩放点积注意力中的缩放操作;
- Softmax 将相关性转换为归一化的注意力权重。
直观地说,最后一层特征会根据当前内容,判断中间层的哪些位置或特征值得参考,再从中提取相应信息。
第三步:融合不同尺度的信息
不同中间层的注意力结果通过可学习权重进行加权融合:
α = Softmax ( w ) \alpha=\operatorname{Softmax}(w) α=Softmax(w)
Z = ∑ s = 1 S α s A s Z=\sum_{s=1}^{S}\alpha_s A_s Z=s=1∑SαsAs
其中, w w w 是可学习参数, α s \alpha_s αs 表示第 s s s 个尺度的融合权重, Z Z Z 是汇总后的多尺度特征。
第四步:残差更新最终视觉特征
融合结果经过输出投影和 LayerNorm 后,与原始最后一层特征相加:
F ~ N = F N + LN ( Z W O ) \widetilde{F}^{N}= F^{N} + \operatorname{LN}(ZW_O) F N=FN+LN(ZWO)
其中:
- W O W_O WO 是输出投影矩阵;
- LN \operatorname{LN} LN 表示 Layer Normalization;
- F ~ N \widetilde{F}^{N} F N 是融合中间层信息后的增强视觉特征。
之后, F ~ N \widetilde{F}^{N} F N 被送入视觉语言投影器,作为主要视觉表示。
ACSA 的整体过程可以概括为:
最后一层特征F → Query
中间层特征f → Key、Value
↓
跨注意力
↓
多尺度注意力结果 A
↓
加权融合得到 Z
↓
与 F残差相加,得到增强特征
4.2.2 DeepStack:中间视觉特征逐层注入
ACSA 融合视觉特征后,DeepStack 把中间层特征直接送入语言模型的早期层
第 s s s 个中间视觉层经过一个独立的 MLP 投影器,再与语言模型对应层的隐藏状态做残差相加:
H s L L M ← H s L L M + ϕ s ( F l s ) H^{\mathrm{LLM}}_s \leftarrow H^{\mathrm{LLM}}_s+\phi_s(F^{l_s}) HsLLM←HsLLM+ϕs(Fls)
其中:
- F l s F^{l_s} Fls 是视觉编码器第 s s s 个中间层的特征;
- ϕ s ( ⋅ ) \phi_s(\cdot) ϕs(⋅) 是该层对应的 MLP 投影器;
- H s L L M H^{\mathrm{LLM}}_s HsLLM 是语言模型中对应早期层的隐藏状态;
- ← \leftarrow ← 表示用相加后的结果更新该层隐藏状态。
论文给出的投影维度为:
ϕ s : R L × d → R L / 4 × d ′ \phi_s: \mathbb{R}^{L\times d} \rightarrow \mathbb{R}^{L/4\times d'} ϕs:RL×d→RL/4×d′
其中,
L
L
L 表示视觉 Token 序列长度,
d
d
d 是视觉特征维度,
d
′
d'
d′ 是语言模型的隐藏维度。该映射同时完成视觉特征维度适配和 Token 数量压缩。
主要解决“怎样让语言模型内部的多个层都能看到视觉信息”的问题。它与 ACSA 的作用不同:ACSA 在视觉侧融合多层特征,DeepStack 在语言模型侧分层注入视觉特征。
4.3 SLIS:空间语言同构序列化
传统多模态模型经常为检测框、旋转框和分割掩码分别使用不同的输出头或解码器。这样会让空间任务和文字任务处于不同的输出机制中。
SLIS(Spatial-Linguistic Isomorphic Serialization,空间语言同构序列化)的核心想法是:把空间位置和像素掩码都编码成离散 Token 序列,使模型可以像生成文字一样生成空间结果。
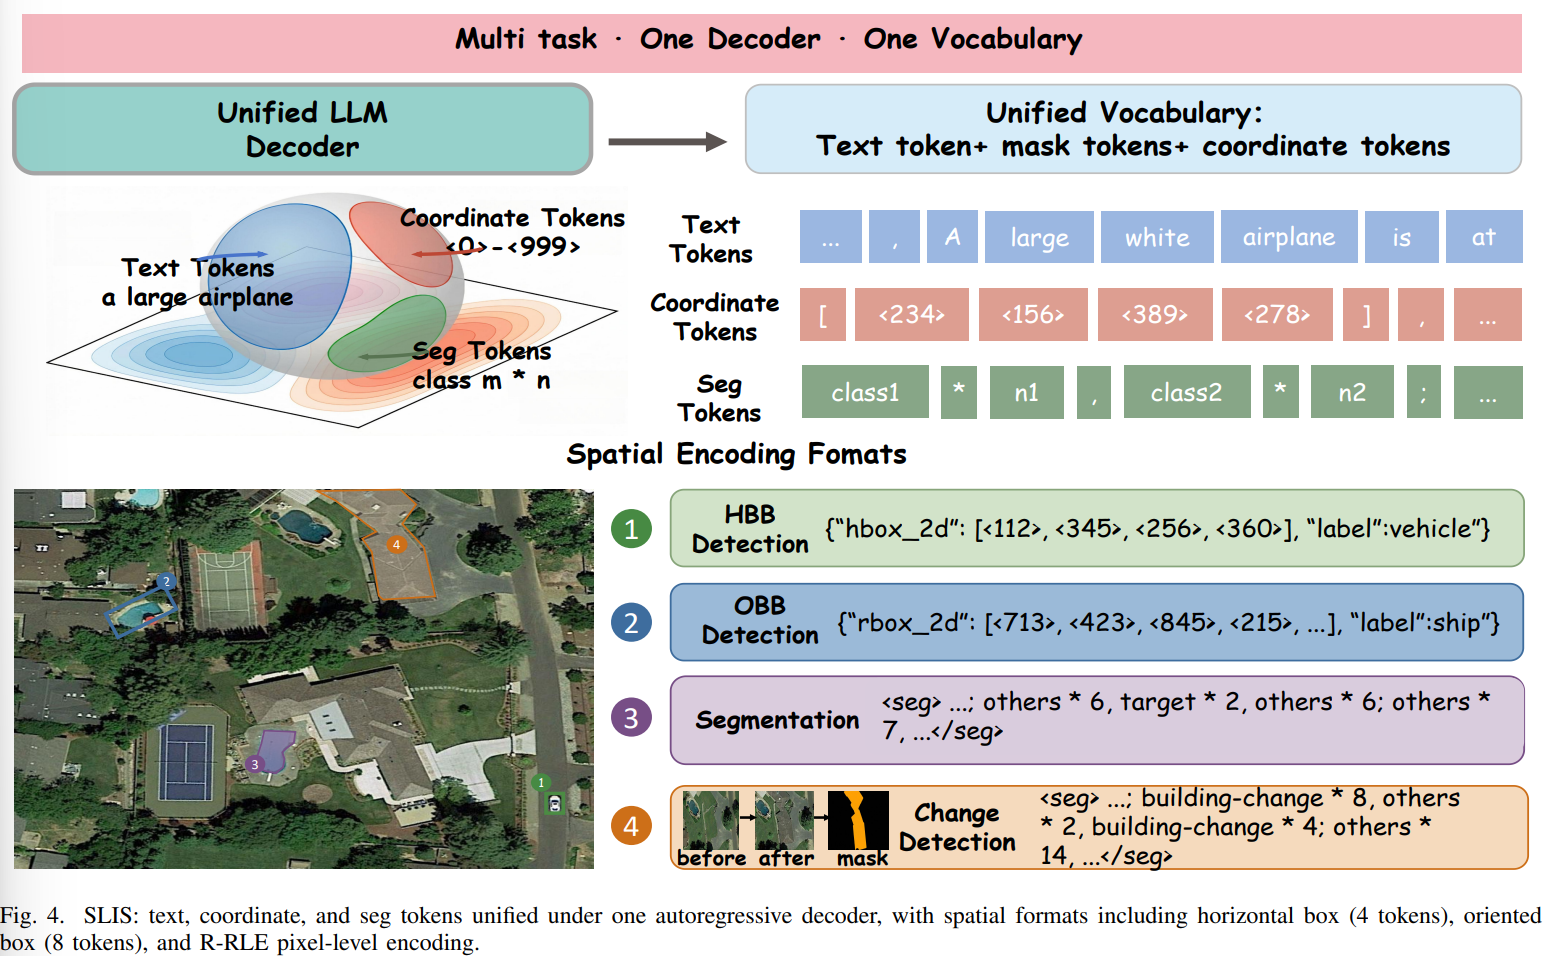
4.3.1 统一词表
模型的输出词表由三部分组成:
V
=
V
text
∪
V
coord
∪
V
seg
V=V_{\text{text}}\cup V_{\text{coord}}\cup V_{\text{seg}}
V=Vtext∪Vcoord∪Vseg
其中:
- V text V_{\text{text}} Vtext:普通自然语言 Token;
- V coord V_{\text{coord}} Vcoord:专用坐标 Token,取值范围为 0 到 999;
- V seg V_{\text{seg}} Vseg:用于表示分割掩码的 R-RLE Token。
三类 Token 共用同一个自回归 Decoder 和交叉熵训练目标。模型只需根据任务指令,逐步生成相应的文字、坐标或掩码 Token。
4.3.2 坐标 Token
模型先将归一化坐标
c
∈
[
0
,
1
]
c\in[0,1]
c∈[0,1] 离散成 1000 个位置区间中的一个:
q
(
c
)
=
⌊
1000
c
⌋
q(c)=\lfloor 1000c\rfloor
q(c)=⌊1000c⌋
其中,
q
(
c
)
q(c)
q(c) 是坐标对应的离散编号,范围为 0 到 999。每个编号对应一个专用坐标 Token,而不是普通文本中的数字字符。
不同空间结果由不同数量的坐标 Token 表示:
-
水平框 HBB: 使用 4 个坐标 Token,表示左上角和右下角:
[ x 1 , y 1 , x 2 , y 2 ] [x_1,y_1,x_2,y_2] [x1,y1,x2,y2]
-
旋转框 OBB: 使用 8 个坐标 Token,表示四个角点:
[ x 1 , y 1 , x 2 , y 2 , x 3 , y 3 , x 4 , y 4 ] [x_1,y_1,x_2,y_2,x_3,y_3,x_4,y_4] [x1,y1,x2,y2,x3,y3,x4,y4]
-
点定位: 使用 2 个坐标 Token,表示点的横、纵坐标:
[ x , y ] [x,y] [x,y]
4.3.3 R-RLE 掩码 Token
分割掩码包含大量像素,如果直接逐像素生成,输出序列会很长。因此,论文使用行程编码压缩掩码。
处理过程为:
M → MaxPool 24 × 24 ( M ) → RowWiseRLE ( M ) → Seg Tokens M \rightarrow \operatorname{MaxPool}_{24\times24}(M) \rightarrow \operatorname{RowWiseRLE}(M) \rightarrow \text{Seg Tokens} M→MaxPool24×24(M)→RowWiseRLE(M)→Seg Tokens
其中:
- M ∈ Z H × W M\in\mathbb{Z}^{H\times W} M∈ZH×W 是原始掩码;
- MaxPool 24 × 24 \operatorname{MaxPool}_{24\times24} MaxPool24×24 将掩码压缩到默认的 24 × 24 24\times24 24×24 网格;
- RowWiseRLE \operatorname{RowWiseRLE} RowWiseRLE 表示逐行进行游程编码;
- 最后得到可以由 Decoder 生成的分割 Token 序列。
4.3.4 统一自回归训练目标
文字、坐标和掩码 Token 都作为响应序列进行自回归训练。对于输入图像 x x x 和目标响应序列 y y y,模型逐个预测后续 Token:
L = − ∑ t ∈ R log P ( y t ∣ y < t , x ) \mathcal{L}= -\sum_{t\in\mathcal{R}} \log P(y_t\mid y_{<t},x) L=−t∈R∑logP(yt∣y<t,x)
其中:
- y t y_t yt 是第 t t t 个目标 Token;
- y < t y_{<t} y<t 是它之前已经生成的 Token;
- x x x 是图像和任务指令;
- R \mathcal{R} R 是参与损失计算的响应 Token 位置集合。
这样,模型可以在同一个生成过程中同时处理“是什么”和“在哪里”,例如先生成目标描述,再生成它的位置或分割掩码。
4.4 PCMA:渐进式跨模态适配
遥感模型迁移需要跨越两类差异:
- 视角差异: 自然图像通常是平视拍摄,光学遥感图像通常是俯视拍摄;
- 成像物理差异: 光学、SAR、红外、多光谱和视频等数据的成像原理和信号特征不同。
用 p nat p_{\text{nat}} pnat、 p opt p_{\text{opt}} popt 和 p all p_{\text{all}} pall 分别表示自然图像、光学遥感图像和全部遥感模态的数据分布。直接从自然图像迁移到所有遥感模态,需要跨越较大的分布差异:
d ( p nat , p opt ) < d ( p nat , p all ) d(p_{\text{nat}},p_{\text{opt}}) < d(p_{\text{nat}},p_{\text{all}}) d(pnat,popt)<d(pnat,pall)
d ( p opt , p all ) < d ( p nat , p all ) d(p_{\text{opt}},p_{\text{all}}) < d(p_{\text{nat}},p_{\text{all}}) d(popt,pall)<d(pnat,pall)
其中, d ( ⋅ , ⋅ ) d(\cdot,\cdot) d(⋅,⋅) 表示两个数据分布之间的差异。论文据此将一次较大的迁移拆分为两个较小的阶段:
p nat → p opt → p all p_{\text{nat}} \rightarrow p_{\text{opt}} \rightarrow p_{\text{all}} pnat→popt→pall
4.4.1 Stage 1:自然图像适配到光学遥感
第一阶段联合使用自然场景指令数据和光学遥感指令数据。
自然图像和光学遥感都基于可见光成像,二者的差异主要体现在拍摄视角和目标形态上。通过这一阶段,模型先学习:
- 俯视视角下的场景理解;
- 遥感目标识别;
- 遥感图像中的空间关系;
- 光学遥感任务对应的文字和空间输出。
4.4.2 Stage 2:从光学遥感扩展到其他模态
第二阶段在光学遥感基础上加入:SAR 红外 多光谱 时序图像 视频 跨传感器融合数据
此时,模型已经具有一定的遥感视角和空间语义基础,第二阶段重点适配不同传感器的成像物理和任务形式。
4.4.3 统一训练目标
两个阶段使用相同的自回归交叉熵损失:
L = − ∑ t ∈ R log P ( y t ∣ y < t , x ) \mathcal{L}= -\sum_{t\in\mathcal{R}} \log P(y_t\mid y_{<t},x) L=−t∈R∑logP(yt∣y<t,x)
其中, x x x 表示输入图像和指令, y t y_t yt 表示目标响应中的第 t t t 个 Token, R \mathcal{R} R 表示参与训练的响应 Token 位置集合。输出可以是自然语言 Token、坐标 Token、分割 Token,或它们的组合。
论文实验设置中,两个阶段各训练 4 个 epoch。FGVLA、MLP Connector 和 LLM 进行全量微调;视觉编码器保持冻结。
4.5 MMRS-OneVision 数据构建
数据由三种来源组合:收集已有遥感指令数据、将公开标注转换成指令格式、以及以已有标注为事实约束进行 GPT-4o 辅助合成。合成结果再经过规则过滤和 InternVL3-72B 语义核查。关键设计是跨任务复用原始标注,例如同一检测框可生成检测、区域描述、区域分类或关系理解样本。
5. 实验验证
5.1 对比实验
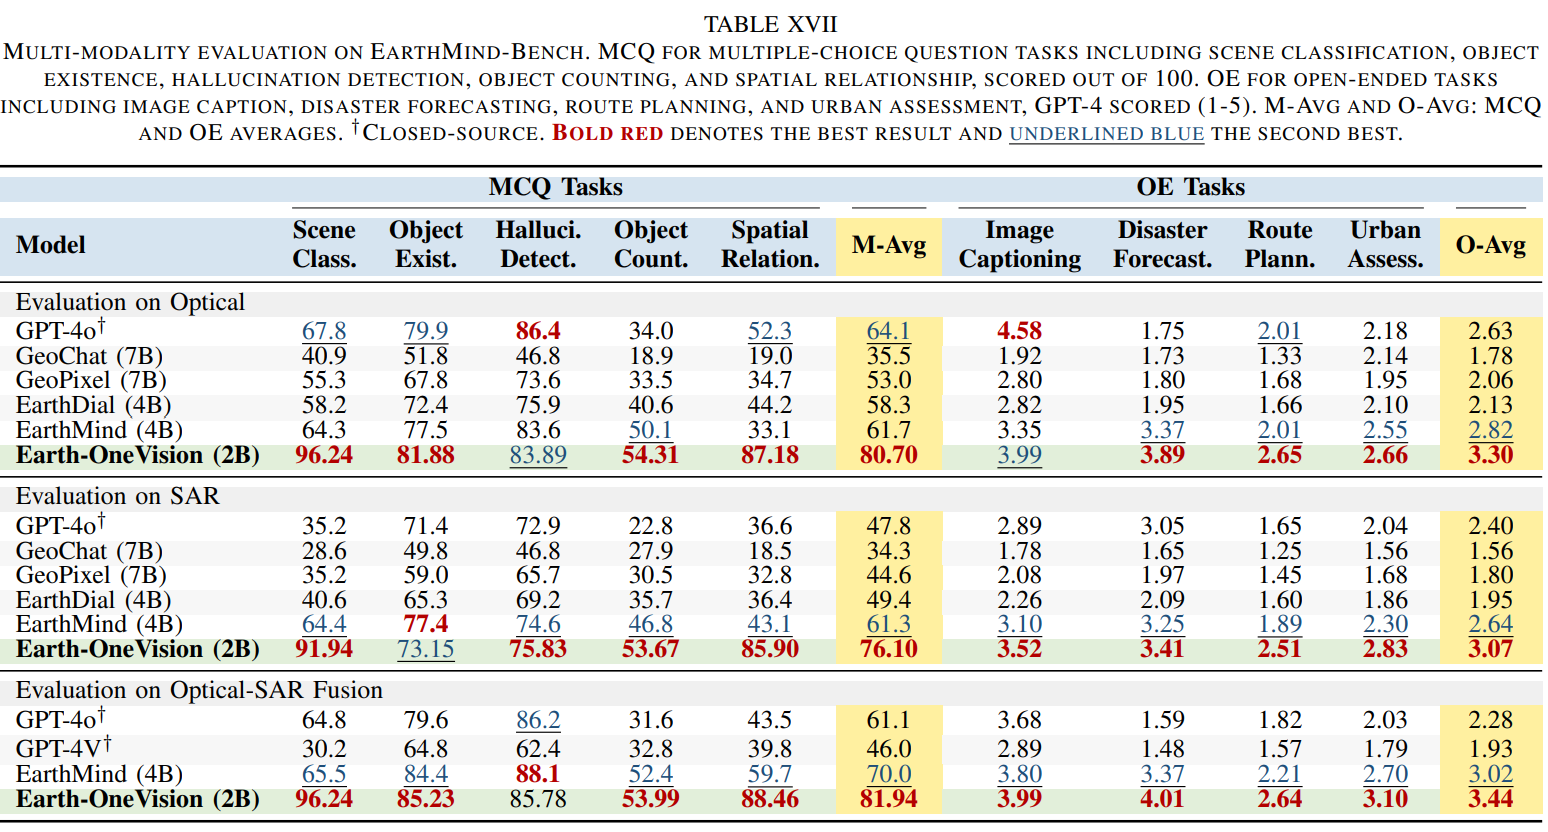
- MCQ Tasks:场景分类、目标存在性、幻觉检测、目标计数和空间关系判断,采用百分制得分
- OE Tasks:图像描述、灾害预测、路径规划和城市评估等开放式任务,由 GPT-4 进行 1–5 分评分
- 跨任务能力强。 模型可以同时完成分类、计数、空间关系判断、图像描述、灾害预测和城市评估等任务,而无需为每个任务单独训练专用头。
- 跨模态泛化能力强。 在光学和 SAR 两种成像机理差异显著的模态下,模型均取得较高结果。
- 跨传感器融合有效。 Optical-SAR Fusion 条件下获得最高的
M-Avg和O-Avg,说明多源传感器信息能够提升模型的综合理解与推理能力。
5.2 消融实验
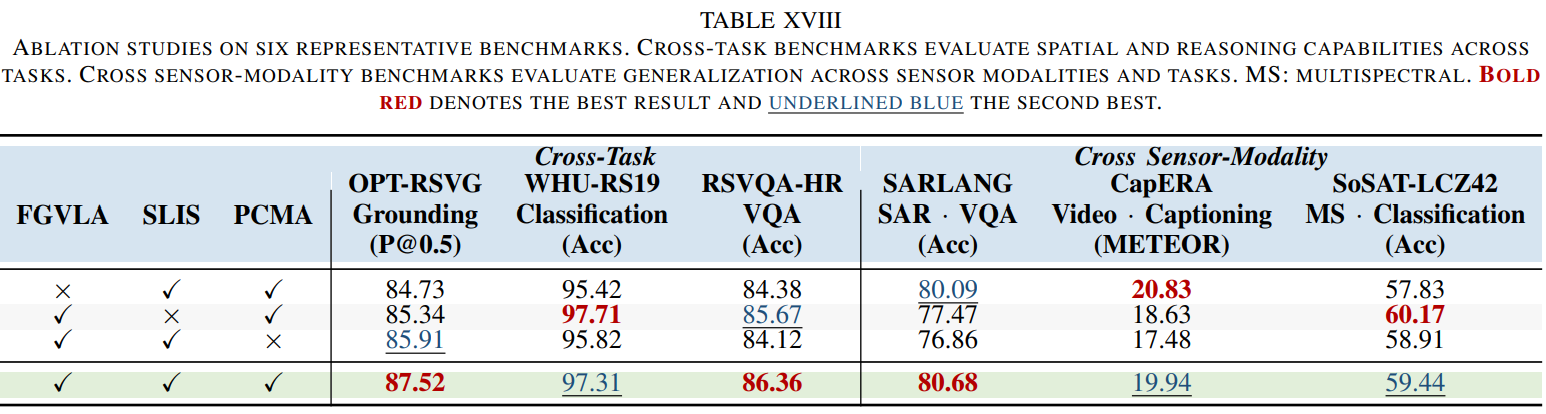
三个模块分别解决不同问题:
- FGVLA:解决多层视觉信息未被充分利用的问题,主要提升空间定位和视觉问答能力;
- SLIS:解决空间位置、边界框和掩码难以被统一生成的问题,主要提升定位与空间推理能力;
- PCMA:解决不同传感器模态之间分布差异大的问题,主要提升 SAR、视频等非光学模态的泛化能力。
完整模型并非在六个单项指标中全部取得最高值
但是在视觉定位、遥感视觉问答和 SAR-VQA 三项关键能力上均达到最优,并且在六种不同任务与模态设置下保持了更均衡的表现。
三者结合后,才能使 Earth-OneVision 获得稳定的统一多模态遥感理解能力
6.个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)