EmbodiedSWE:面向长时程灵巧机器人的编程智能体
26年9月来自字节Seed、耶鲁、普林斯顿、CMU、斯坦福、UCLA和西雅图U Wash的论文“EmbodiedSWE: Coding Agents for Long Horizon Dexterous Robotics”。
这篇论文的主要价值,是展示了一条机器人数据生成路线:让编程智能体在仿真中开发控制程序,再将成功程序扩展成示范数据,用于训练机器人策略。
它为复杂任务的数据生产提供了有说服力的初步证据,但对通用策略、复杂操作的稳定性和真实环境泛化,证据仍有限。
如图 1所示EmbodiedSWE该方法的概述:
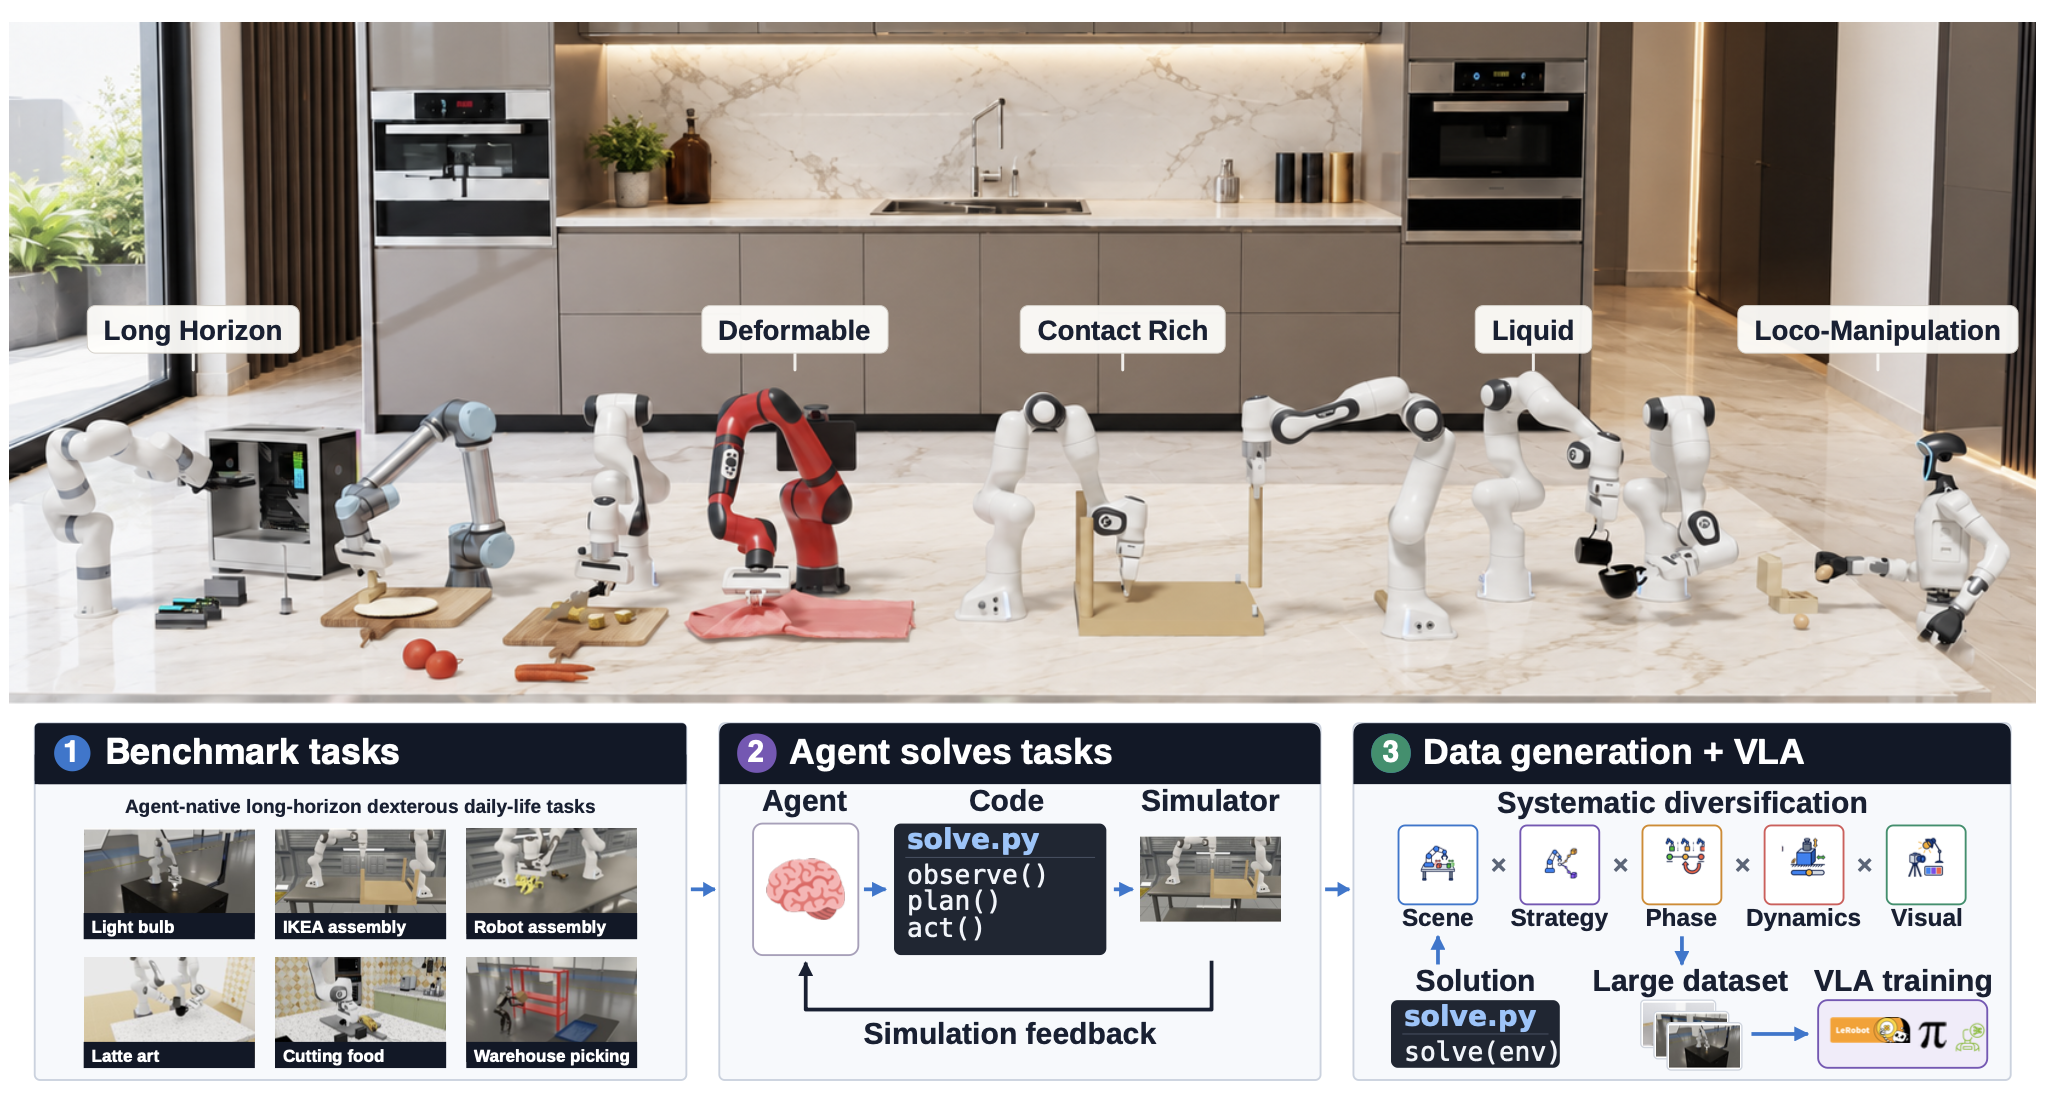
论文围绕三个递进的问题展开:编程智能体能否解决复杂机器人任务?成功程序能否生成多样化数据?这些数据能否训练出有效、甚至能迁移到真机的策略?
核心方法可以概括为:任务 → 编写与调试控制程序 → 仿真验证 → 扩展示范 → 微调 VLA。
首先,作者构建了 EmbodiedSWE-Bench:包含 28 个任务,覆盖装配、收纳、工具操作、柔性物体、液体、切割和移动操作,支持五种机器人形态,部分任务执行时间可达半小时。智能体可以读取完整仿真状态和环境代码,在最长四小时的预算内反复试验,提交 solve(env) 控制程序。
其次,作者引入检查点树、参数搜索、并行方案比较等工具,帮助智能体调试长流程任务。这里的智能体主要承担离线机器人程序开发,实际控制由生成的程序和底层控制器执行。
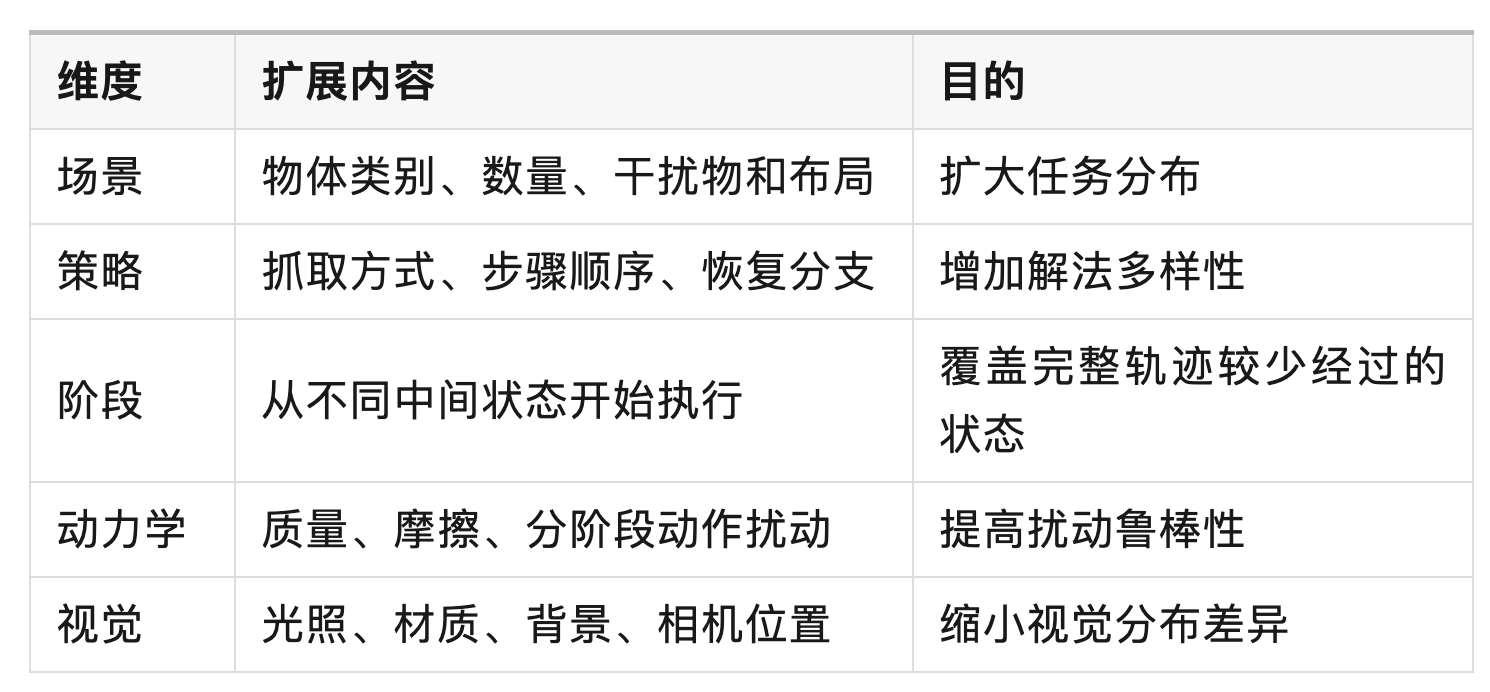
最后,EmbodiedSWE-Gen 从一个验证成功的程序出发,沿五个维度扩展数据:
如图 7所示EmbodiedSWE-Gen 的分层多样化流水线。该流程以一个经由编码智能体(coding-agent)验证的解决方案为起点,通过对场景、策略、阶段、动力学及视觉要素进行多样化处理,将其扩展为涵盖广泛的训练轨迹集合。其中,高层级的变体调整任务结构、解决方案行为及中间状态覆盖范围;而低层级的变体则引入物理、动作及视觉层面的扰动,旨在提升鲁棒性并丰富执行方式的多样性。
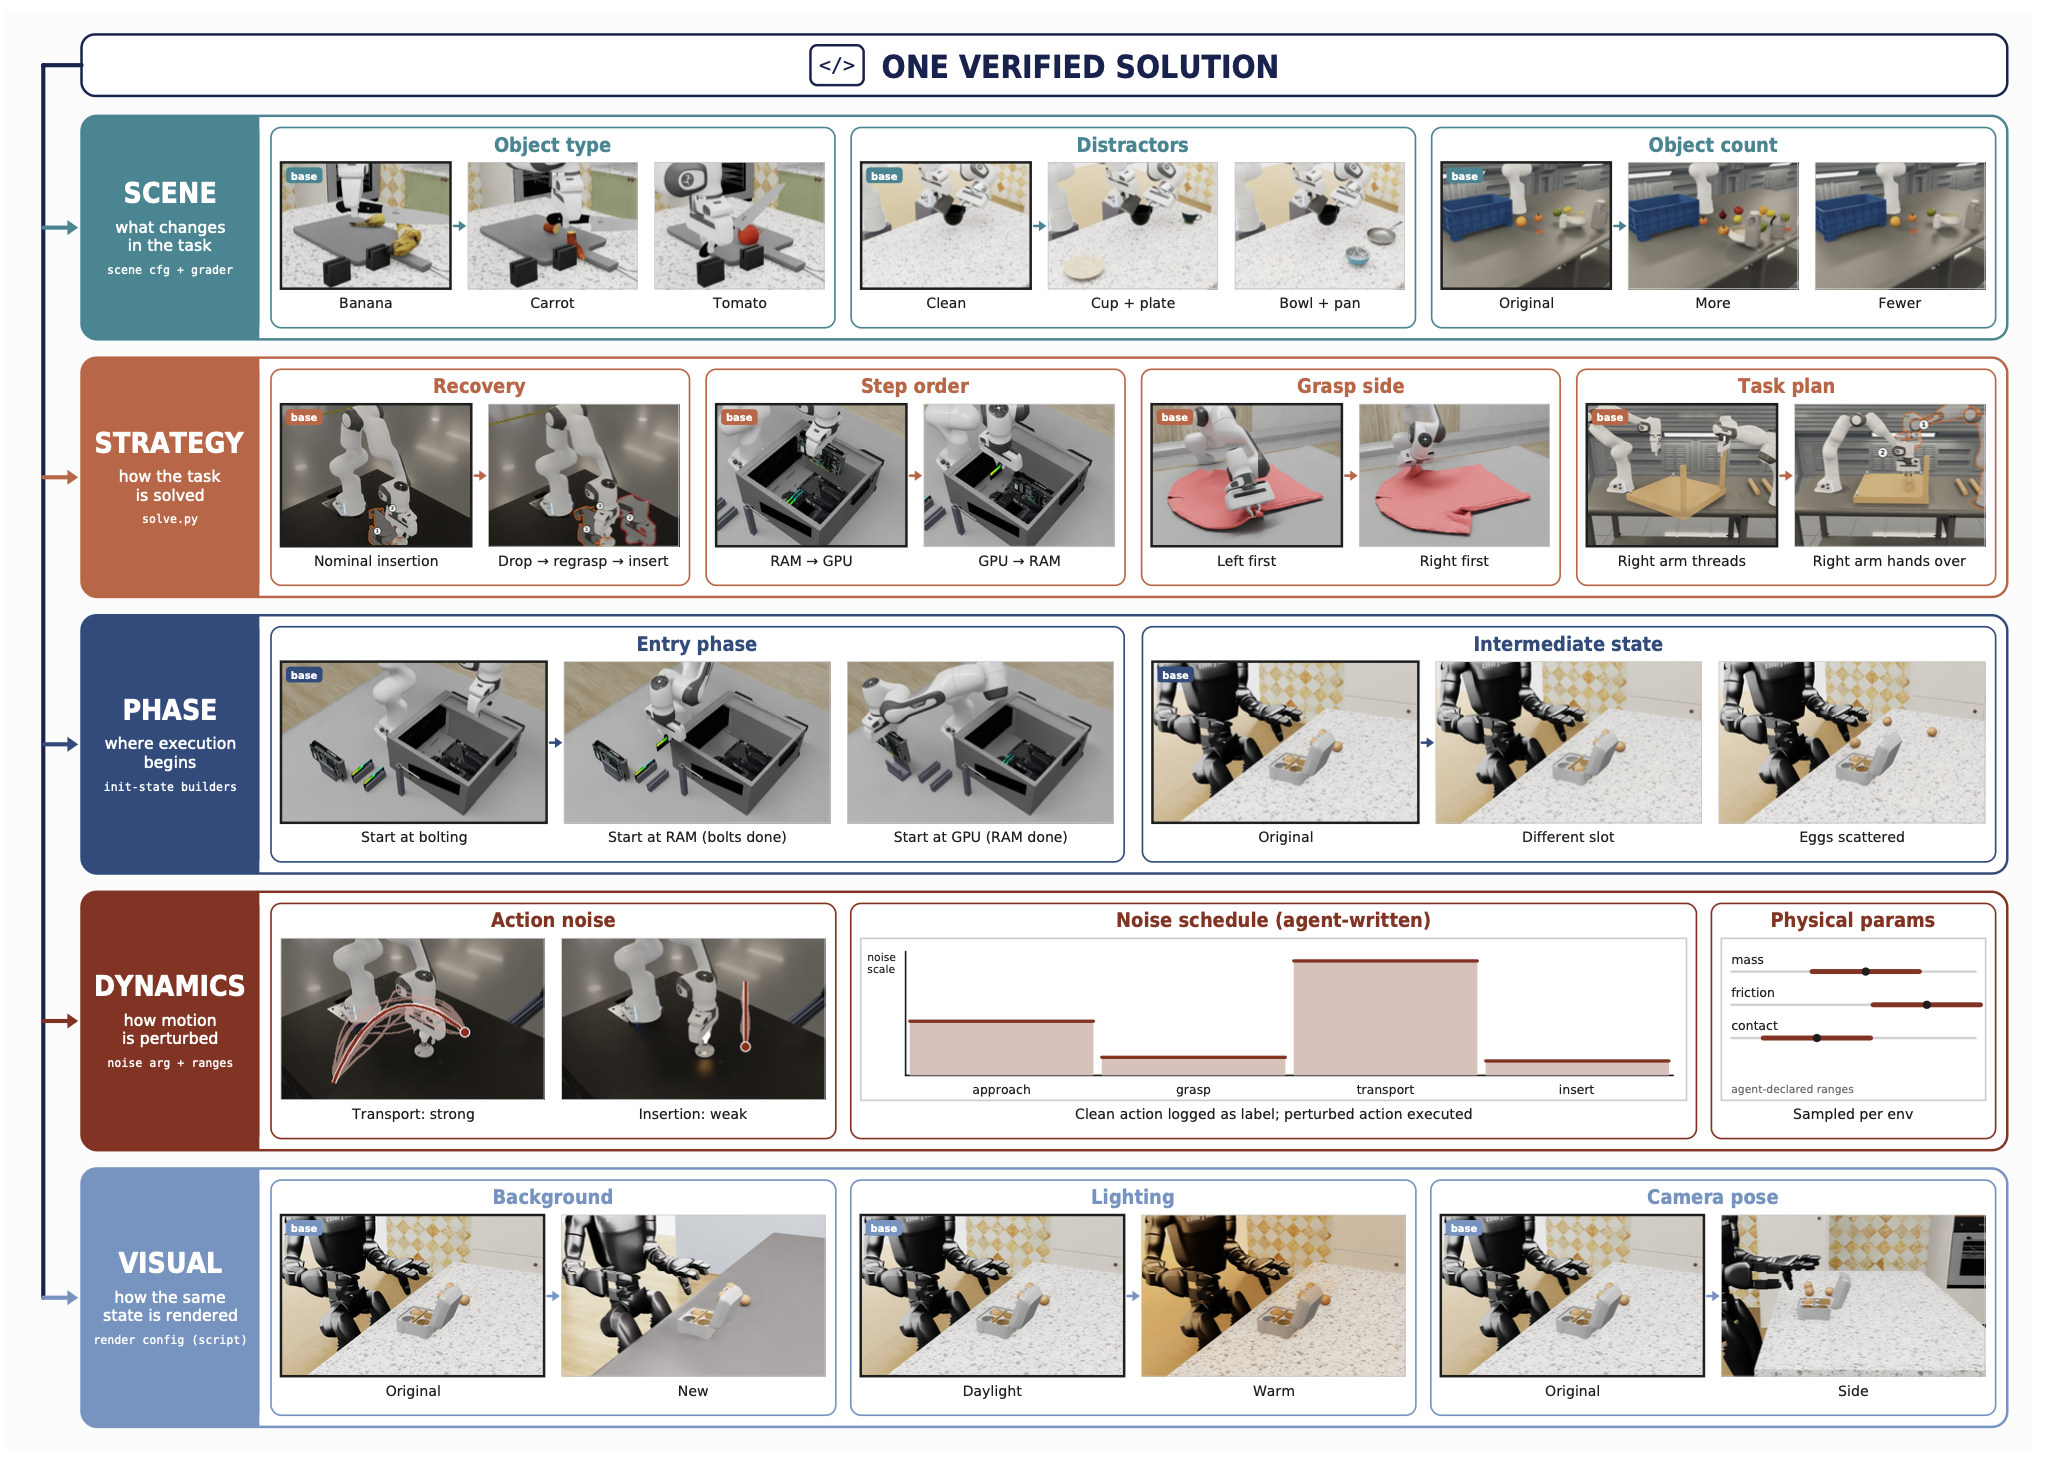
生成的轨迹必须通过任务评分和动作回放检查。一个值得关注的设计是:在运输阶段施加强扰动、精密插入阶段施加弱扰动,并让程序展示恢复行为,比统一加噪更符合任务结构。
论文的贡献主要体现在以下三点。
提供了面向复杂机器人编程的评测平台。
它把评估对象从一次性动作预测,扩展到“理解环境—编程—执行—诊断—修复”的完整过程,能够暴露视觉理解不足、固守错误方案、绕过评分等失败模式。
把成功程序变成可扩展的示范生成器。
程序包含任务阶段、控制参数和恢复逻辑,因此既能执行任务,也能指导数据扩展。尤其是“策略变化”和“中间状态覆盖”,比单纯改变纹理或初始位置更接近行为层面的多样化。
连接了程序求解、策略学习和真机迁移。
作者不仅展示程序能够完成任务,还验证生成数据对 VLA 微调有用,并给出真机概念验证。不过,这些环节目前分别验证,尚未构成大规模、端到端的通用机器人学习闭环。
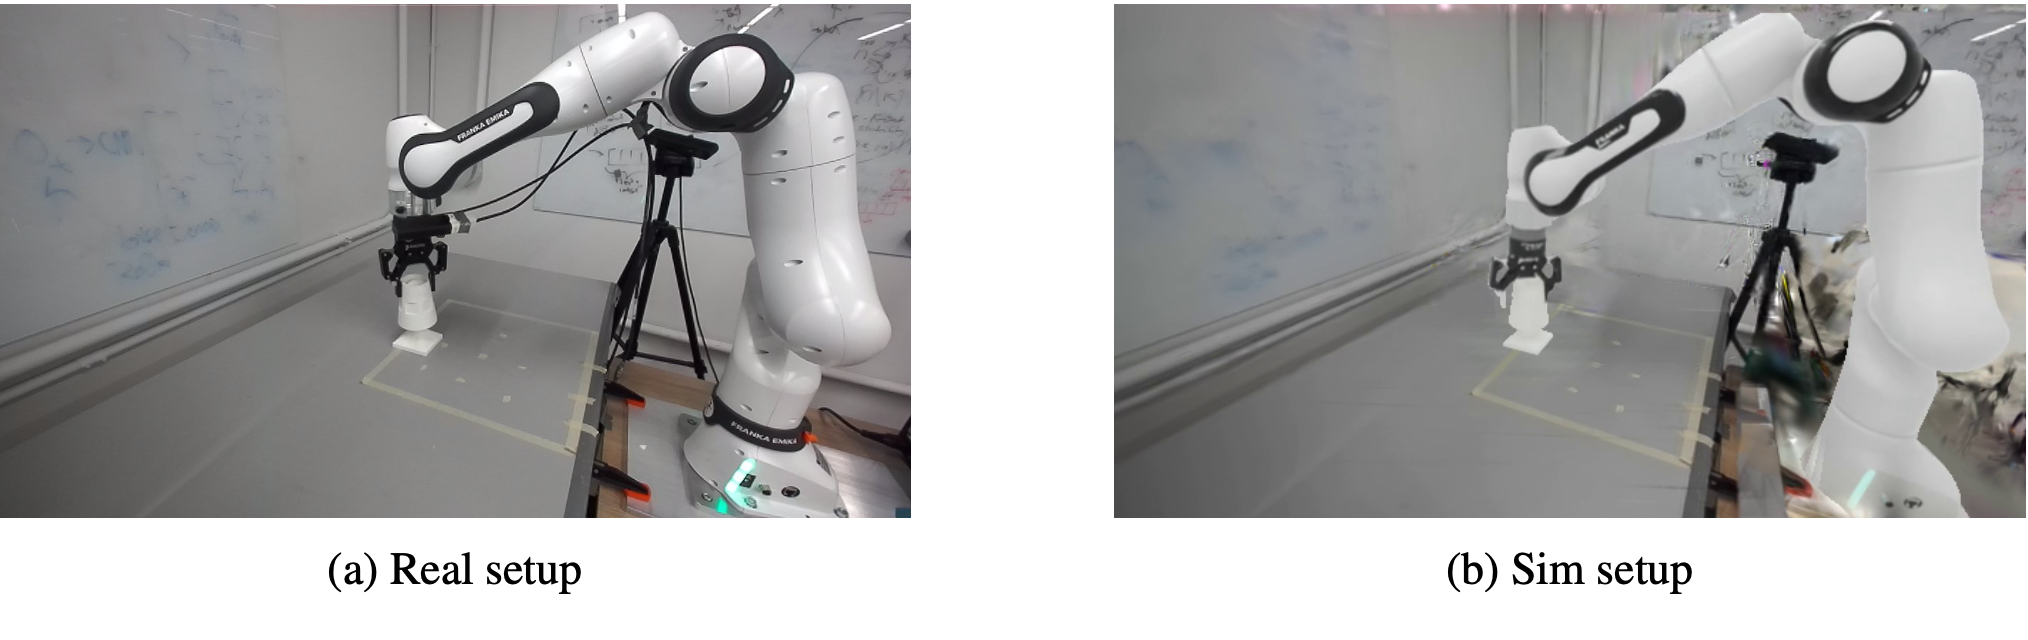
如图 19 所示真实机器人和对应的仿真器配置:
主要实验结果及其合理解释如下:
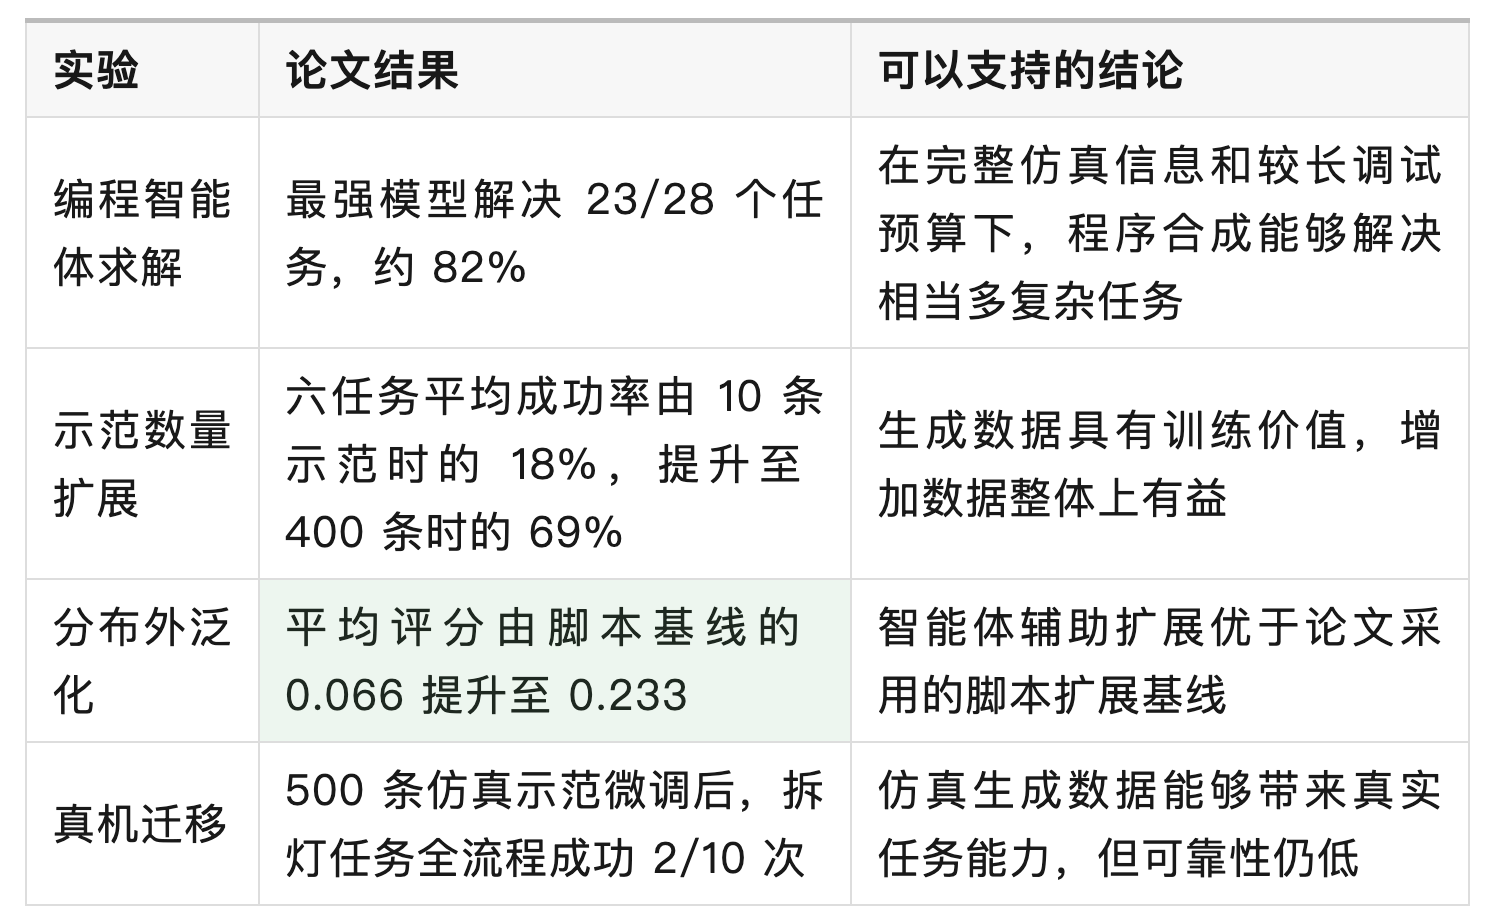
这里必须区分:82% 是编程求解的任务覆盖率;69% 是特定 VLA 评估条件下的成功率;0.233 是分布外平均评分。三者不能直接比较。
影响论文结论强度的主要问题有以下几项。
第一,仿真中的编程能力与真实机器人自主能力之间,仍有较大距离。
求解器可以读取完整物体状态、环境源码及场景常量;真机策略主要依赖图像与本体状态。前者能够精确查询的信息,后者必须通过感知估计。因此,论文较充分地证明了“拥有特权信息的智能体可以开发控制程序”,但尚未证明这种能力能被完整转移给视觉策略。
此外,人形机器人移动使用预训练步行策略,部分桌面任务固定骨盆;跨机械臂迁移实验保留相同 Panda 夹爪。因此,“跨形态”和“灵巧操作”的覆盖范围需要按这些条件理解。(第 3、5、18 页)
第二,VLA 的部分成功标准被放宽,这是解读结果时最重要的细节。
附录表 22 明确规定:
清理物体:放置一个有机物体即可;
收纳笔:插入一支笔即可;
咖啡制作:满足条件后按下启动键即可;
香蕉切片:切成至少三块。
原始基准中的部分任务要求更完整的流程,例如清理全部目标物体、装入全部笔并摆正笔筒。因此,69% 不能解释为 VLA 已经以该成功率完成原始长流程基准。放宽标准可以用于研究学习进展,但应同时报告原始标准下的结果。(第 39 页)
第三,多样化有效,但各个设计的独立作用没有被识别。
作者以相同示范数量比较两种数据管线,这是优点。然而,智能体辅助数据拥有更广的语义和策略覆盖,脚本基线主要围绕原始任务做局部随机化。结果能说明“更丰富的生成管线更有用”,尚不能确定:
提升主要来自场景、策略还是阶段扩展;
智能体生成是否优于覆盖范围相当的人工设计扩展;
在同等总成本下,优势是否仍然存在。
附录也明确承认没有隔离各层扩展的贡献。另外,同一物理轨迹的不同外观版本计为不同 episode,因此示范数量不完全等于独立行为数量。(第 36–38 页)
第四,迁移和工具实验存在对照不足。
跨机器人迁移把“Kinova/xArm7 + Franka 参考代码”与“Franka 无参考代码”比较,缺少目标机械臂自身的无参考代码组,无法排除机器人和控制设置差异带来的影响。(第 31 页)
工具实验则使用两张 RTX 4090,而基线使用一张。更值得注意的是,工具提高了平均部分评分,却没有提高完整成功率:
Opus 5:平均分 0.66 → 0.70,成功率 50% → 43%;
GPT-5.6 Sol:平均分 0.44 → 0.51,成功率维持 18%。
因此,较准确的表述是“工具帮助推进了部分任务”,而不是已经证明其提高完整任务解决率。(第 6、21 页)
第五,统计稳定性和评分有效性还需加强。
主基准每个“模型—任务”只有一次运行;跨任务标准误不能替代重复运行对随机性的估计。不同模型还使用不同原生编程框架,结果反映的是模型与框架的组合能力。
柔性物体类任务的汇总成功率均为 0%,而表注说明其分数未包含最终 VLM 检查关卡。这使得该类任务的部分得分与最终完成之间存在明显距离,需要更清楚解释视觉示例、评分和成功判定之间的关系。(第 20–23 页)
独立评分环境和动作回放是有价值的防护,但回放成功主要证明记录动作可复现;它本身不保证评分标准充分、接触物理准确或行为能迁移到现实。
第六,真机实验是有意义的概念验证,但“零样本迁移”需要限定。
全流程成功只有 2/10 次,且真实场景经过 3D Gaussian Splatting 重建,灯具由仿真资产对应地 3D 打印。附录进一步说明,部署的第 14,000 步检查点是依据真机表现选择的。(第 9、40 页)
因此,准确的说法是:**此次微调没有使用真实机器人示范,但使用了真实场景信息和真机反馈进行选择。**它不能等同于完全没有目标环境反馈的迁移。
从阶段结果看,完成灯罩放置为 8/10,完成灯泡抓取降至 3/10,最终完成为 2/10。就这组小样本而言,灯泡抓取及前后阶段衔接值得优先排查。
第七,更宏大的学习和成本主张,证据还不完整。
与 PPO 的比较说明了预训练编程智能体在给定预算内相对从头训练的优势,但不能据此判断程序策略普遍优于强化学习;示范初始化、分层学习和预训练策略微调仍需比较。
数据成本也应计入失败求解、仿真、渲染、回放、训练和人工建模,而不只是摊薄后的 token 成本。附录中的编程智能体强化学习实验只有训练集改善,尚未完成留出任务评估,不能作为泛化提升的证据。(第 28、35–36、42、55 页)
进一步工作可以按以下优先级推进:
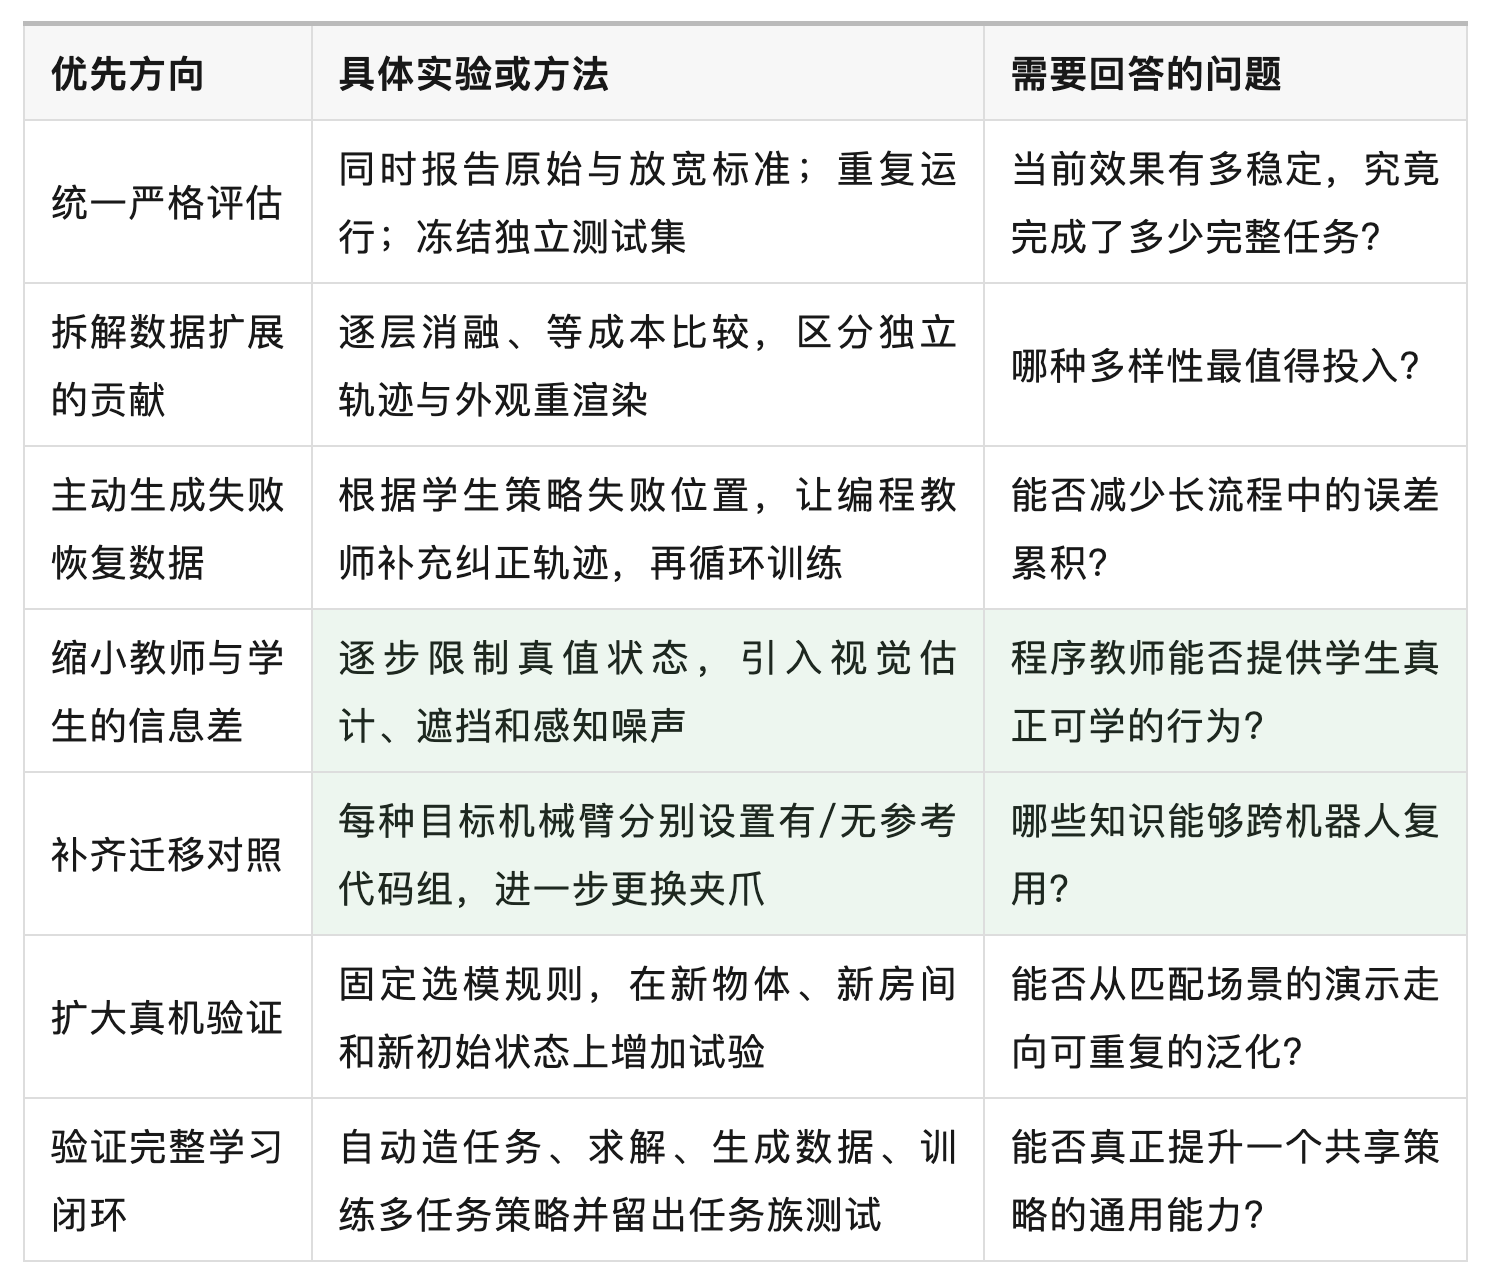
其中“学生失败驱动的程序教师补数”:先让 VLA 实际执行,定位失败状态,再让编程智能体生成针对性的恢复方案和示范。这能直接检验论文最有价值的设想——程序教师是否能够持续补足机器人策略的能力缺口,而不仅是扩大已有成功轨迹的数量。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献447条内容

所有评论(0)