“伟大征程 100”:评估具身智体 的100 项细节-导向任务
26年1月来自上海交大RHOS AI 团队、SII和阿里蚂蚁Robbyant的论文“The Great March 100: 100 Detail-Oriented Tasks for Evaluating Embodied AI Agents”。
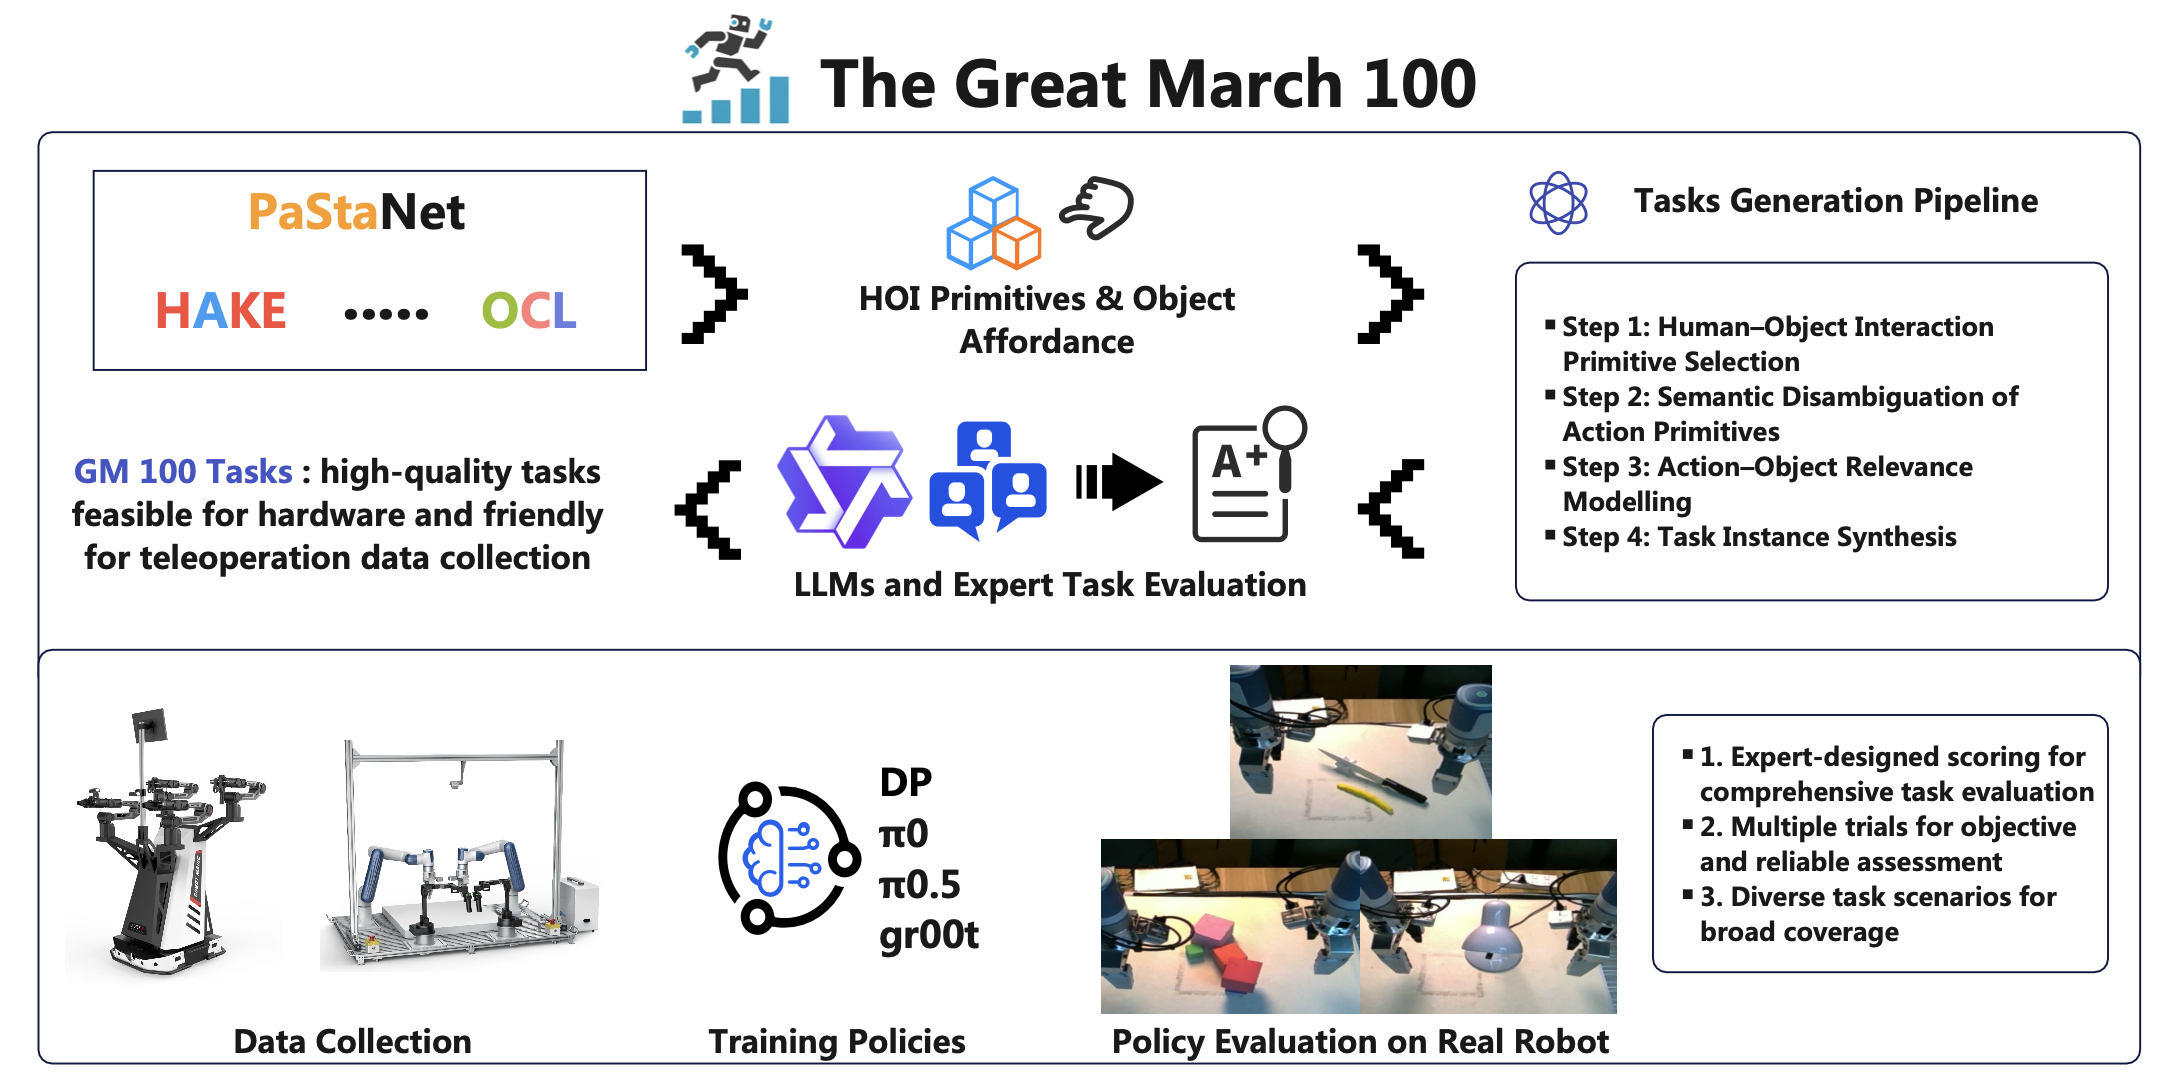
如图 2 所示GM-100基准的构建流程。该过程首先收集现有的机器人任务,随后利用HAKE [27]进行语义扩展,并结合基于大语言模型(LLM)的生成技术,以涵盖长尾交互场景。接着,候选任务需经过LLM与人类专家联合进行的严格筛选,以确保硬件执行的可行性及数据采集的便利性。最后,筛选出100个高优先级任务,并针对每个任务制定详细的交互标准与模板视频,完成任务实例化。
背景动机
作者分析了Open X-Embodiment、Agibot、RoboCOIN等现有数据集的任务描述,发现动词分布严重集中在"pick/hold/place/lift/grasp"等少数几个高频动作(词云+频率图,图1),导致:
训练出的模型对常见任务过拟合,泛化到真实场景能力有限;
各研究团队各测各的少数几个任务,缺乏统一标准,跨方法比较不公平。
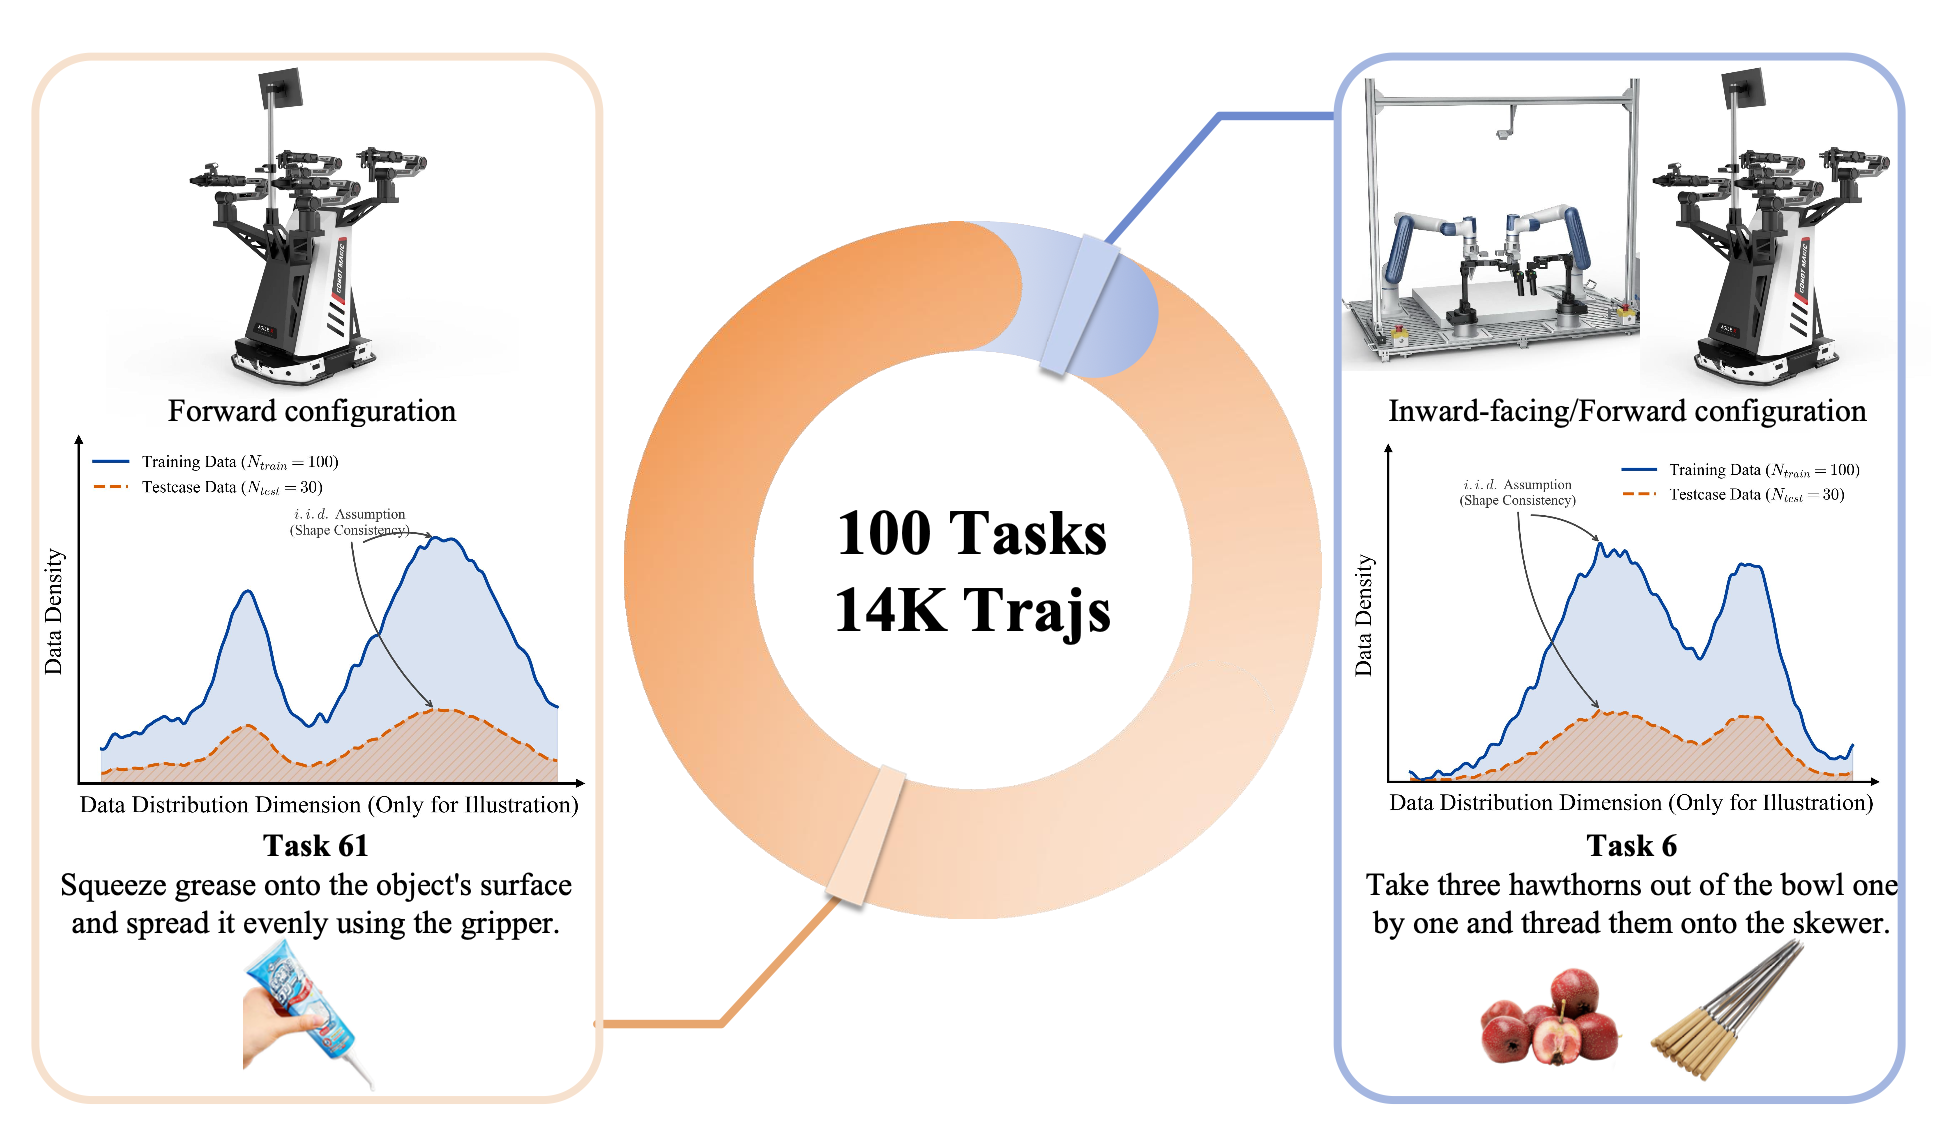
如图 3 所示GM-100数据集。数据采集与评估采用两种不同的机器人平台。对于任务1至10,在两个平台上针对每个任务各采集130条轨迹;而对于任务11至100,数据仅在Cobot Magic平台上采集。为确保100条训练轨迹与30条测试轨迹具有相似的数据分布,在数据采集和评估过程中,力求保持环境与物体配置的一致性。(注:图中包含的数据分布示意图仅供说明之用,并未反映精确的统计分布情况。)
主要方法(任务构建Pipeline)
提出一套系统化的任务生成流程,而非人工拍脑袋设计任务,核心是"人-物交互原语驱动"而非"实用性驱动"(有意避免主观任务价值判断,以规避人类偏见):
1 收集已有任务:汇总Agibot、π0.5等工作中的任务,去重并按语义分类。
2 人-物交互原语扩展:借助作者组自己此前的工作HAKE(Human Activity Knowledge Engine)、PaStaNet、OCL(Object Concept Learning)中的人-物交互原语和物体可供性(affordance)体系,补充长尾、低频但重要的动作类型。
3 LLM自动生成候选任务(基于Qwen3):
对选定动作原语做词义消歧(避免语义歧义);
让LLM枚举与每个动作原语语义/物理相关的物体;
基于"动作-物体"对生成具体任务实例并润色成清晰的文本描述。
4 LLM+人工混合筛选:Qwen3先对任务的机器人可执行性打分,再由5位人类专家做最终把关(gold standard),确保任务在当前硬件条件下可行、且便于遥操作采集数据。
5 任务实例化:对高优先级任务设计具体交互细节、选择实际淘宝物品、录制人类完成任务的模板视频指导数据采集,并制定超越"成功率"的细粒度评分标准。
最终从生成池中选出100个任务,构成GM-100(定位为面向"机器人学习奥林匹克"GM-X系列的第一步)。
数据集与实验
平台:Agilex Cobot Magic(类Mobile-Aloha,前伸臂+头部相机)和 Dobot Xtrainer(类Aloha,内折臂+俯视相机)两种异构双臂平台。
规模:超过13K条遥操作轨迹;100个任务全部在Cobot Magic上采集,10个任务在Xtrainer上同步采集(用于跨平台评测)。
数据划分:每任务100条训练轨迹(含位置/朝向扰动)+ 30条对齐测试轨迹(保证跨模型/跨checkpoint评测一致性)。
评测指标:
SR(成功率); PSR(Partial Success Rate,子任务级别的部分成功率,弥补SR对复杂多阶段任务区分度不足的问题);
动作预测误差(MSE/L1,衡量模型对专家轨迹的拟合度,与在线PSR做相关性分析)。
基线模型: Diffusion Policy(DP)、π0、π0.5、GR00T(GR00T未给出实际数值,论文说明会陆续放出)。
主要发现: π0.5全面优于π0和DP(Xtrainer上平均SR:53.9% vs 32.1% vs 1.6%);动作预测误差(MSE)与PSR呈现明显负相关,即离线损失越低,在线成功率通常越高,π0.5同时在两个指标上占优。
论文贡献总结
指出现有机器人数据集/任务设计的"长尾缺失"问题,并用定量词频分析证明;
提出一套可复现、系统化、减少人类主观偏见的任务生成方法论(HOI原语+LLM生成+专家把关);
构建并开源GM-100任务列表、13K+轨迹数据集,以及基线评测结果和评测平台(https://rhos.ai/research/gm-100),并采用PSR等更细粒度指标。
提出"社区驱动、开放证据共享"而非"绝对公平中心化测试"的评测理念,即模型开发者可自行上传结果+视频证据,通过众包监督和"checked"标签机制(经权重审核认证)来逐步建立长期可信的评测生态。
存在的问题
“避免人类偏见"的说法值得商榷:虽然声称"不依赖任务实用性,只依赖物理常识与可供性”,但整个流程仍然依赖人工专家最终筛选(5位专家作为gold standard)、LLM prompt设计、以及对HAKE/PaStaNet(同一作者组的先前工作)体系的依赖,存在"自我验证"闭环风险,长尾覆盖的客观性证据不够充分。
数据规模和平台覆盖有限:仅两种双臂平台(且只有10个任务有跨平台数据),100个任务大部分只在Cobot Magic单一平台采集,难以评估任务设计本身是否与平台强耦合(即模型表现差可能源于平台/夹爪限制,而非任务本身难度,论文4.2节PSR部分自己也提到"次优的机械臂配置…共同导致GM-100基准整体成功率偏低")。
结果发布不完整:目前只公开了Xtrainer平台10个任务的完整SR/PSR/预测误差表格,Cobot Magic平台100个任务的完整结果只以"热力图"形式展示(图4),GR00T等基线也未给出数值,当前版本更像是一个"预览报告"而非完整评测,可比性和可复现性验证目前较弱。
评测公平性问题被"外包"给社区,而非系统解决:论文承认"测试者能力和环境条件仍显著影响结果",但解决方案是"开放平台+社区自证+免验证结果并存",这与"权重需审核获得checked标签"的机制之间存在张力——未审核结果与已审核结果混在同一榜单,可能造成榜单可信度参差不齐,类似Chatbot Arena式的自证生态在机器人真实环境测试中风险更高(视频/轨迹造假成本相对更低,复现难度更大)。
样本量偏小,统计效力不足:每任务仅30条测试轨迹,10次左右的rollout(具体数量文中未完全明确,以及部分任务如0005出现DP/π0/π0.5三者PSR完全一致的可疑现象,如Table1中task 0005三个模型PSR都在8-12%区间且彼此非常接近,可能提示该任务本身评测存在噪声或标注问题,论文未做讨论)。
缺少长时程/多任务组合评测:虽然任务在"原语"层面追求长尾覆盖,但每个任务仍是相对独立、单一目标的操作(如"敲球入洞"“穿山楂”),未涉及任务间组合、多步骤长程规划或语言指令泛化能力的系统评测。
下一步工作方向建议
补全跨平台/跨机型数据,把100个任务扩展到两个以上平台全覆盖,量化任务难度与平台形态(夹爪、臂展、相机视角)的耦合程度,分离"任务本身难度"与"平台局限性"两个因素。
完善并公开完整评测结果(尤其Cobot Magic 100任务的详细SR/PSR数值而非仅热力图),并补齐GR00T等基线,提升报告的可复现性和透明度。
细化评测公信力机制:考虑对"未审核"和"已审核checked"结果做视觉区分或分榜展示,或引入类似RoboChallenge(同期论文)中的"视觉任务复现"协议来控制人工摆放偏差,而不仅依赖社区自证。
扩展到长程/组合任务:在GM-X下一版本中设计需要多个GM-100原语任务组合完成的长程任务,评估模型的规划与记忆能力,而不仅是单一原子操作。
增加统计显著性和噪声分析:公布每个任务的置信区间/方差,并对异常一致的结果(如上文task 0005)做数据质量审查。
验证"LLM+HAKE驱动"任务生成方法的独立性:引入外部(非本课题组)人-物交互知识库或众包task-diversity审计,增强"减少人类偏见"这一核心卖点的说服力。
探索超越SR/PSR的细粒度诊断指标,例如结合动作预测误差的逐帧归因,定位失败发生在感知、规划还是执行哪个环节,便于研究者针对性改进模型架构而不仅仅是刷榜。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献436条内容

所有评论(0)