CVPR 2025 | 十大即插即用模块开源:像搭积木一样发论文,插上就用、用了就涨点!
发 paper 时是不是总被创新点难倒?改模型改到怀疑人生,调代码调得头皮发麻?别急,今天给你推荐一个省时省力的高效炼丹法——用“即插即用模块”像搭积木一样构建你的模型。只需融入少量自己的想法,就能快速组合出创新方案。
这种方法不仅免去了从零造轮子的痛苦,还能简化模型设计、减少重复劳动。每个模块都自带标准接口,轻松替换不同组件,实验迭代速度飞快!
担心不好上手?放心,我们从 CVPR2025 中精选了10个即插即用模块,原文和代码全都备好——除了官方实现,还为你提炼了更易用的精简版代码,助你迅速上手、早日出成果!
➔➔➔➔点击查看原文,获取即插即用模块集合 https://mp.weixin.qq.com/s/I7HTfCpSxz2HYnK2r5as-g
SCSegamba
论文:SCSegamba: Lightweight Structure-Aware Vision Mamba for Crack Segmentation in Structures
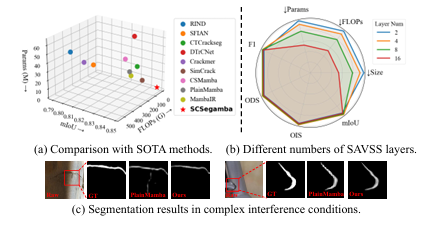
【创新点】为解决现有裂缝分割方法在分割质量与计算资源消耗间的平衡难题,本文提出了一种专为裂缝分割设计的轻量级视觉Mamba网络——ScSegamba。该模型的核心在于其创新的视觉状态空间模块SAVSS,它包含两个关键组件:一是GBC,通过带门控的瓶颈卷积高效建模裂缝形态,并显著减少参数;二是SASS,通过结合平行与对角扫描路径,增强了对不规则、多方向裂缝拓扑和纹理的感知能力。此外,模型还设计了MFS分割头,高效融合多尺度特征,以低复杂度生成高质量分割图。性能测试表明,ScSegamba在取得超越SOTA方法的最高性能时,模型参数仅为2.8M,计算量为18.16G FLOPs,展现了卓越的效率,非常适合部署在资源受限的边缘设备上。
LSNet
论文:LSNet: See Large, Focus Small
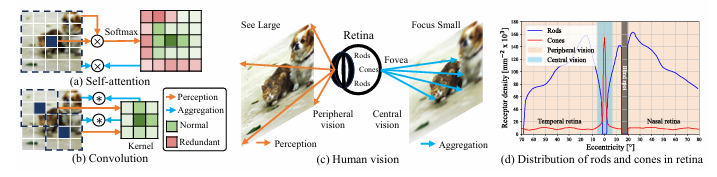
【创新点】本文提出了一种受人类视觉系统启发的轻量级视觉网络LSNet,其核心策略为“先宏观感知,后微观聚焦”(See Large, Focus Small),旨在以极低的计算成本平衡性能与效率。为此,设计了核心的LS(Large-Small)卷积模块:它首先通过大核感知(LKP)高效捕捉大范围的上下文信息,然后利用小核聚合(SKA)在动态权重引导下对局部细节进行精确建模。LSNet作为高效的特征提取骨干网络,可灵活集成到成熟的下游任务框架中。性能上,LSNet在多个尺寸上均实现了SOTA级的性能与效率,例如LSNet-B在ImageNet-1K上以低计算量达到80.3%的Top-1准确率,且推理速度更快,超越了RepViT等模型。
MegaSam
论文:MegaSaM: Accurate, Fast, and Robust Structure and Motion from Casual Dynamic Videos
【创新点】本文提出一种可从动态场景的普通单目视频中准确、快速且稳健估计相机参数和深度图的系统。该系统基于深度视觉SLAM框架,经精心修改训练和推理方案,适用于复杂动态场景的真实世界视频,包括相机视差较小的视频。其关键创新是将单目深度先验和运动概率图整合到可微分SLAM范式,分析视频中结构和相机参数的可观测性,引入不确定性感知的全局BA方案,能高效获取一致的视频深度且无需测试时网络微调。大量实验表明,该系统在相机姿态和深度估计上显著优于先前及同期研究,运行时间更快或相当。 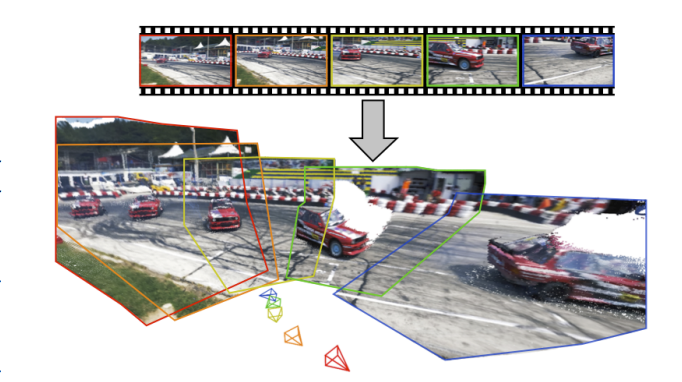
Dyfo
论文:DyFo: A Training-Free Dynamic Focus Visual Search for Enhancing LMMs in Fine-Grained Visual Understanding
【创新点】人类能在杂乱环境中轻松定位目标物体,这依赖于一种被称为视觉搜索的认知机制,该机制可高效过滤无关信息,聚焦于与任务相关的区域。受此过程启发,研究者提出了 DyFo(动态聚焦),这是一种无需训练的动态聚焦视觉搜索方法,旨在增强大型多模态模型(LMMs)的细粒度视觉理解能力。与现有需要额外模块或数据收集的方法不同,DyFo 利用 LMMs 与视觉专家之间的双向交互,通过 蒙特卡洛树搜索(MCTS) 算法模拟类人聚焦调整。这使得 LMMs 能够聚焦于关键视觉区域,同时过滤无关内容,且不会因词汇扩展或整合专门的定位模块而引入额外训练。实验结果表明,DyFo 显著提升了 LMMs 的细粒度视觉理解能力,减少了幻觉问题,在固定分辨率和动态分辨率模型上均取得了优异性能。 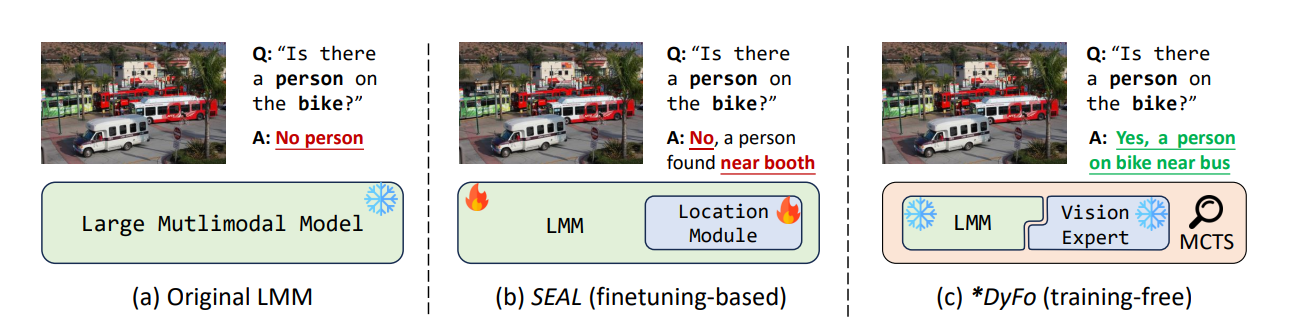
DeCLIP
论文:Generalized Decoupled Learning for Enhancing Open-Vocabulary Dense Perception
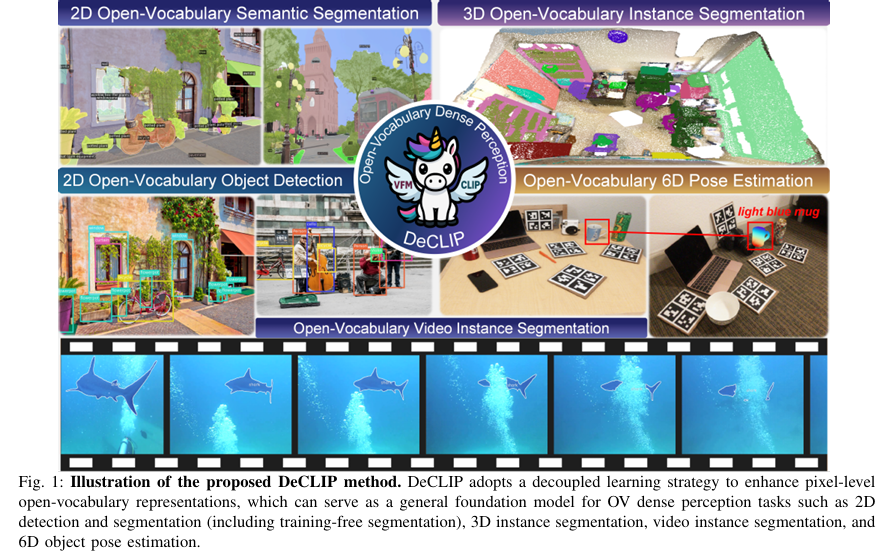
【创新点】本文首先揭示了CLIP模型在密集感知任务中表现不佳的核心瓶颈:其深层图像令牌无法关注语义相关区域,反而过度集中于少数“代理令牌”。为解决此问题,文章创新性地提出了DeCLIP解耦学习框架。该框架将CLIP的自注意力模块解耦为“内容”和“上下文”特征,并利用多模型协同蒸馏进行独立优化:一方面,借助视觉基础模型(VFM)指导上下文特征以学习空间相关性;另一方面,引入稳定扩散模型的注意力图来增强对象的完整性。通过这种无监督微调,DeCLIP有效解决了视觉-语言对齐与空间感知优化的冲突,显著提升了CLIP的局部辨别力和空间一致性,成功将其改造为一个强大的通用密集感知基础模型,并在多种2D/3D/视频的开放词汇分割与检测任务上达到了SOTA水平。
HVI
论文:HVI: A New Color Space for Low-light Image Enhancement
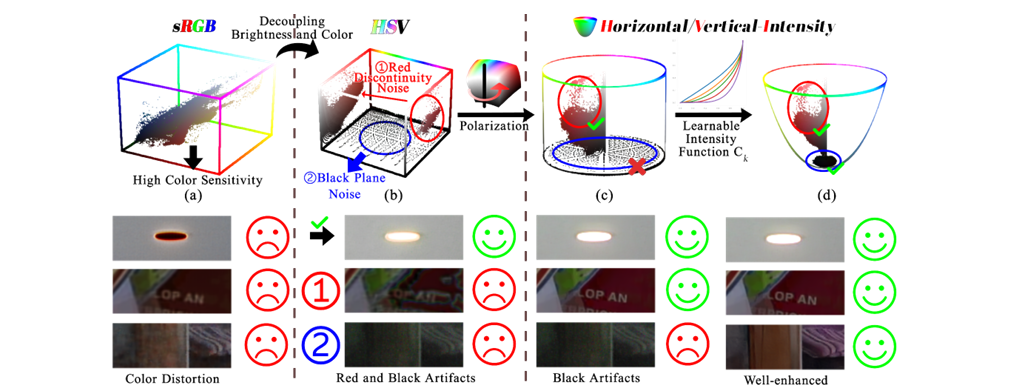
【创新点】为从根本上解决传统HSV空间在低光图像增强中存在的红色不连续和暗区噪声问题,本文提出了专为此任务设计的新型HVI色彩空间。基于此,论文设计了一个高效的颜色与强度解耦网络(CIDNet),其双分支架构在HVI空间中分别对颜色(HV)与亮度(I)进行独立建模,从而实现精准的光度映射与自然的色彩恢复。该方法在10个基准数据集上超越了现有SOTA方法,且模型轻量高效(1.88M参数),在效果与效率间取得了极佳平衡。此外,HVI空间作为即插即用模块能普遍提升多种现有模型的性能,证明了其强大的泛化能力与通用有效性。
DCMPNet
论文:Depth Information Assisted Collaborative Mutual Promotion Network for Single Image Dehazing
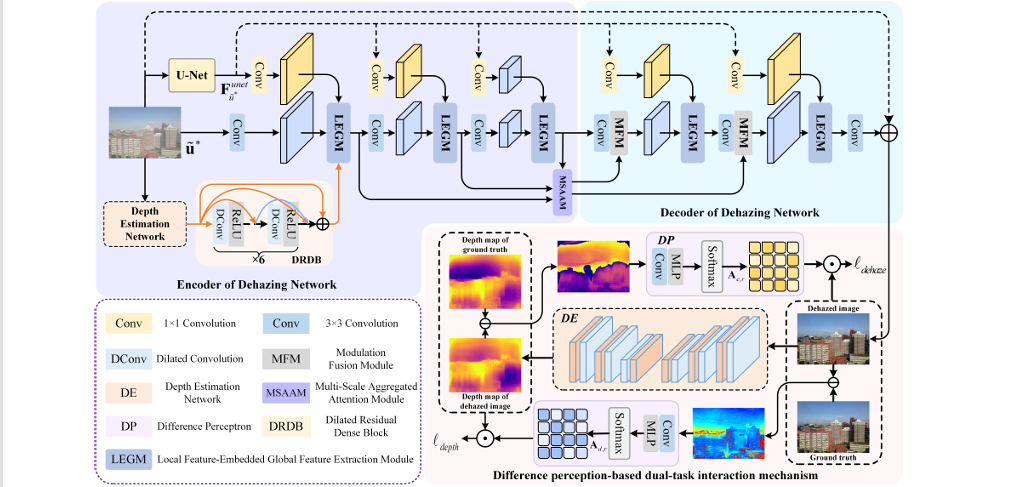
【创新点】本文首次构建了一个统一的端到端学习框架,将单图像去雾与深度估计视为两个独立但可协同的任务,以实现相互促进。其核心是一种创新的“差异感知”交互机制,作为连接并联合优化两个任务的桥梁。具体而言,该机制一方面利用去雾图像与真实清晰图像的差异,来引导深度估计网络关注去雾效果不佳的区域,提升深度预测准确性。反之,它也利用估计深度图与真实深度图的差异,反向指导去雾网络进行优化,并引入深度信息作为辅助输入。通过这种双向协同机制,两个任务得以相互促进,最终实现了性能的共同提升。
CATANet
论文:CATANet: Efficient Content-Aware Token Aggregation for Lightweight Image Super-Resolution
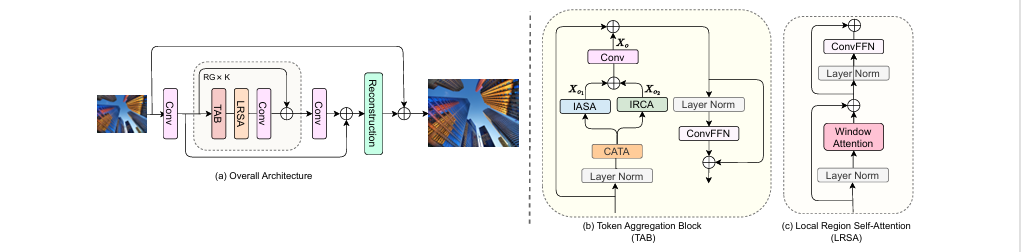
【创新点】本文提出了一种新颖的轻量级图像超分辨率网络CATANet,其核心是高效的内容感知令牌聚合(CATA)模块。该模块通过在训练阶段使用指数移动平均更新、而在推理阶段保持固定的“令牌中心”,巧妙地消除了耗时的聚类过程,从而大幅提升了推理速度。在此基础上,网络进一步结合了创新的组内自注意力(IASA)与组间交叉注意力(IRCA)。IASA在内容相似的令牌组内实现精细化的长距离信息交互,而IRCA则利用全局令牌中心整合全局信息。最终,CATANet在性能和速度上均表现卓越,与先进的SPIN模型相比,其PSNR最多提升0.33dB,推理速度却接近其两倍,展现了优异的部署潜力。
➔➔➔➔点击查看原文,获取即插即用模块集合https://mp.weixin.qq.com/s/I7HTfCpSxz2HYnK2r5as-g
MaIR
论文:MaIR: A Locality- and Continuity-Preserving Mamba for Image Restoration
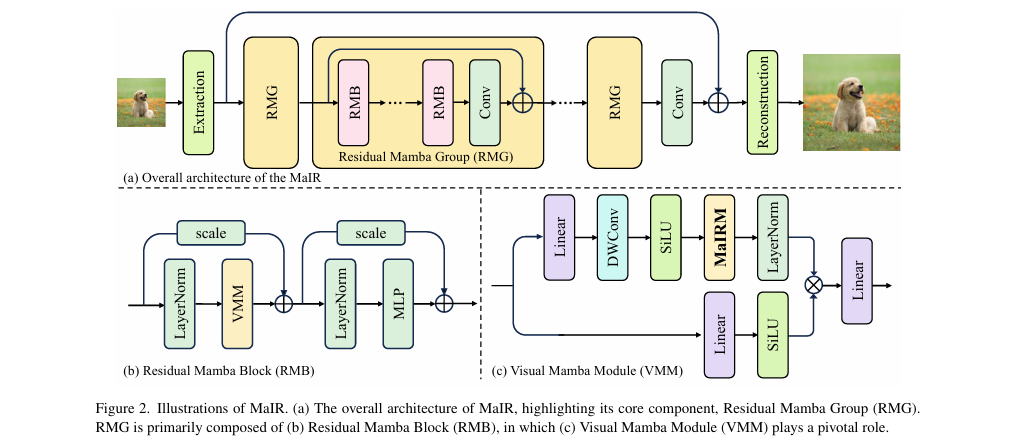
【创新点】为解决Mamba架构在图像处理中因暴力展平(flattening)而破坏空间结构的问题,本文提出了高性能图像恢复模型MaIR。其核心是首创的嵌套S形扫描(NSS)策略,通过在图像条带内部和之间均采用S形路径,首次同时保持了图像的局部性与扫描的连续性。为有效融合多方向扫描产生的互补信息,论文设计了序列混洗注意力(SSA)模块,高效地在序列的对应通道间进行信息聚合。该模型在不引入CNN等额外计算开销的情况下,实现了卓越的恢复性能。在图像超分、去噪、去模糊和去雾四大任务、14个基准数据集上的广泛实验中,MaIR的性能超越了40个基线模型,证明了其强大的有效性与泛化能力。
MambaOut
论文:MambaOut: Do We Really Need Mamba for Vision?
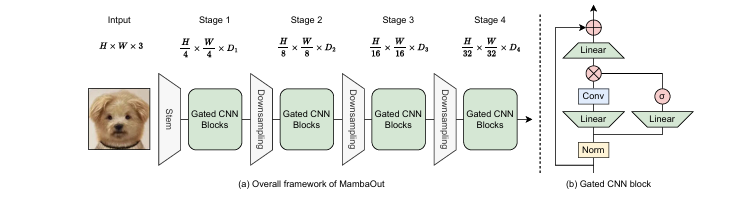
【创新点】本文通过对Mamba底层RNN机制的深入剖析,首次明确指出其核心优势在于处理兼具“长序列”与“自回归”特性的任务。基于此,论文提出了一个核心假说:对于不具备这些特性的图像分类任务,Mamba的核心模块SSM(状态空间模型)并非必需;而对于具备长序列特性的检测与分割任务,SSM则仍有价值。为验证该假说,研究构建了一个名为MambaOut的简化模型,它移除了Mamba中的SSM模块,仅保留Gated CNN结构。实验提供了有力的实证依据:在ImageNet分类任务上,更简单的MambaOut全面超越了现有视觉Mamba模型,但在COCO和ADE20K等下游任务中则表现不及,从而清晰地验证了核心假说。
➔➔➔➔点击查看原文,获取即插即用模块集合https://mp.weixin.qq.com/s/I7HTfCpSxz2HYnK2r5as-g

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 28
 0
- 0


 已为社区贡献9条内容

所有评论(0)