Show-Harness:只需一个 VLM 智能体即可操纵机器人
26年9月来自新加坡国立SHOW实验室的论文“Show-Harness: Just a VLM Agent Can Play Robots”。
一、基本方法
该工作提出Show‑Harness,一套与模型无关的具身化驾驭(harness),核心思路:不改造 VLM 视觉-语言模型主干,设计离散语义动作接口,把机器人控制转化为 VLM 可理解的语义符号输出,再由机器人专用解释器把语义动作确定性映射为底层机器人运动,构建完整的感知‑推理‑动作闭环。整体分为两大控制模式,同时配套 GUMI 数据采集工具。
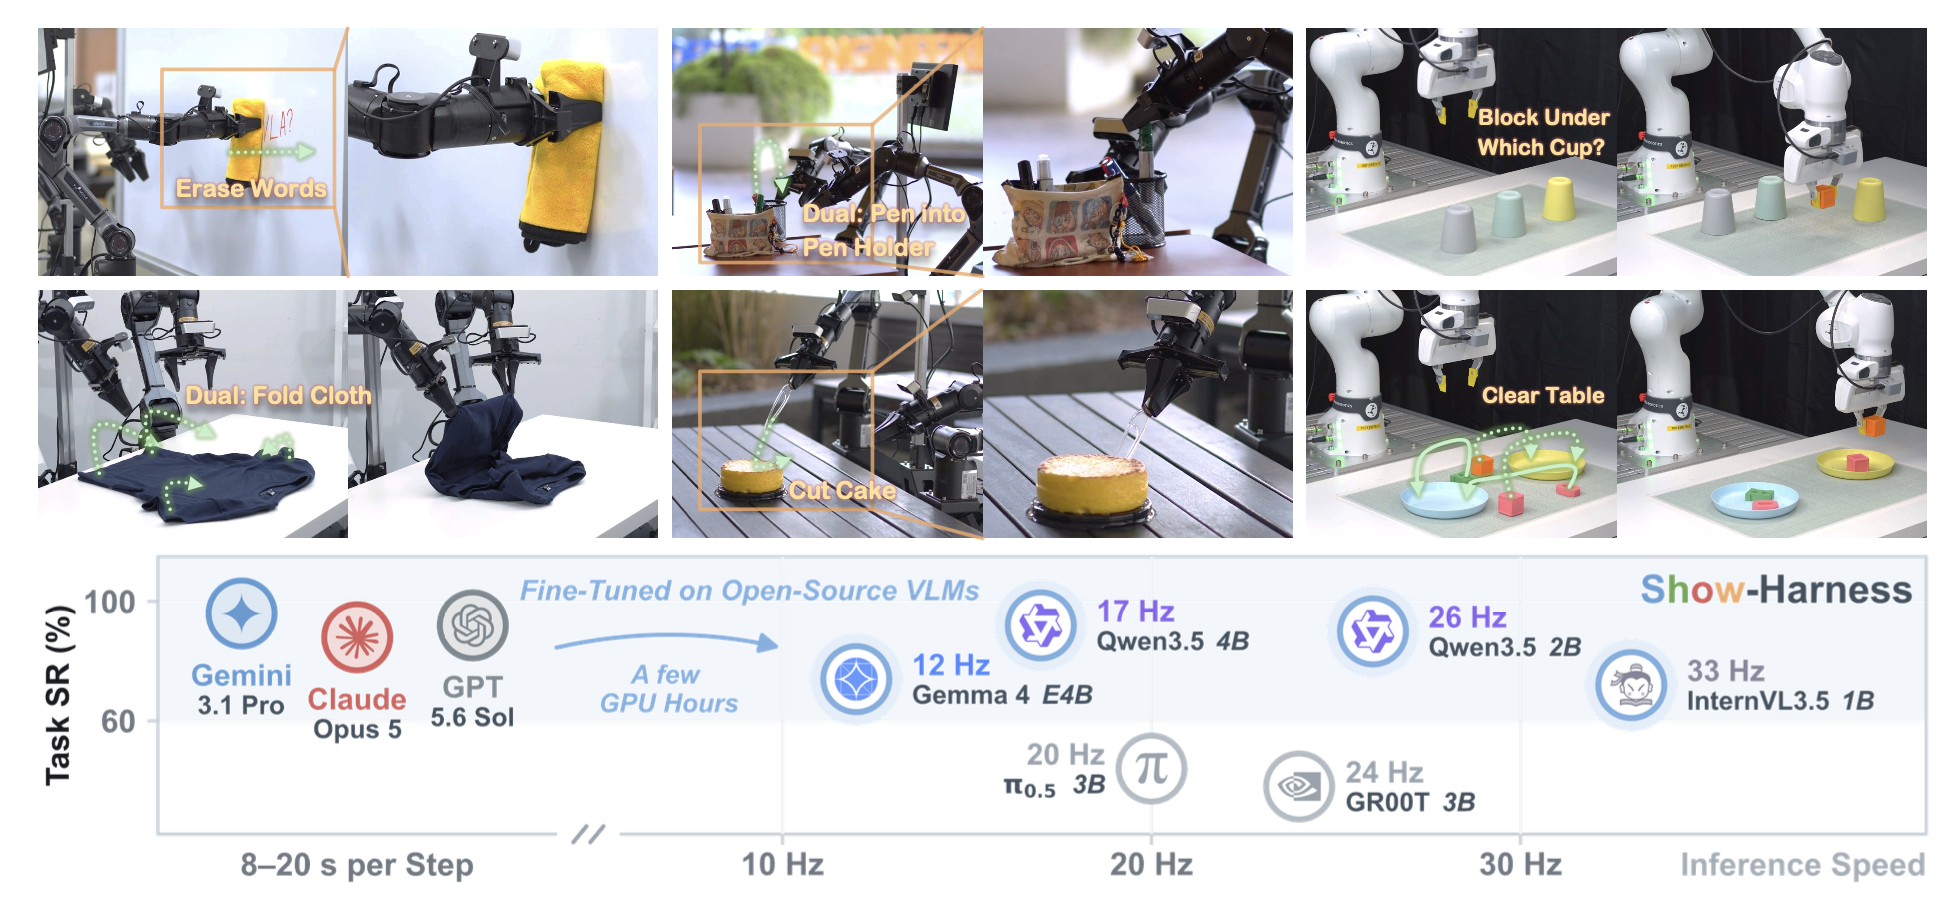
如图 1所示:Show-Harness 解锁在各种任务、场景和机器人实现中与基础 VLM 相关的通用具身操作,从而能够使用前沿模型进行直接零样本部署,并通过对紧凑型开源模型的轻量级适配实现高效控制。
1. 核心:语义动作空间与解释器
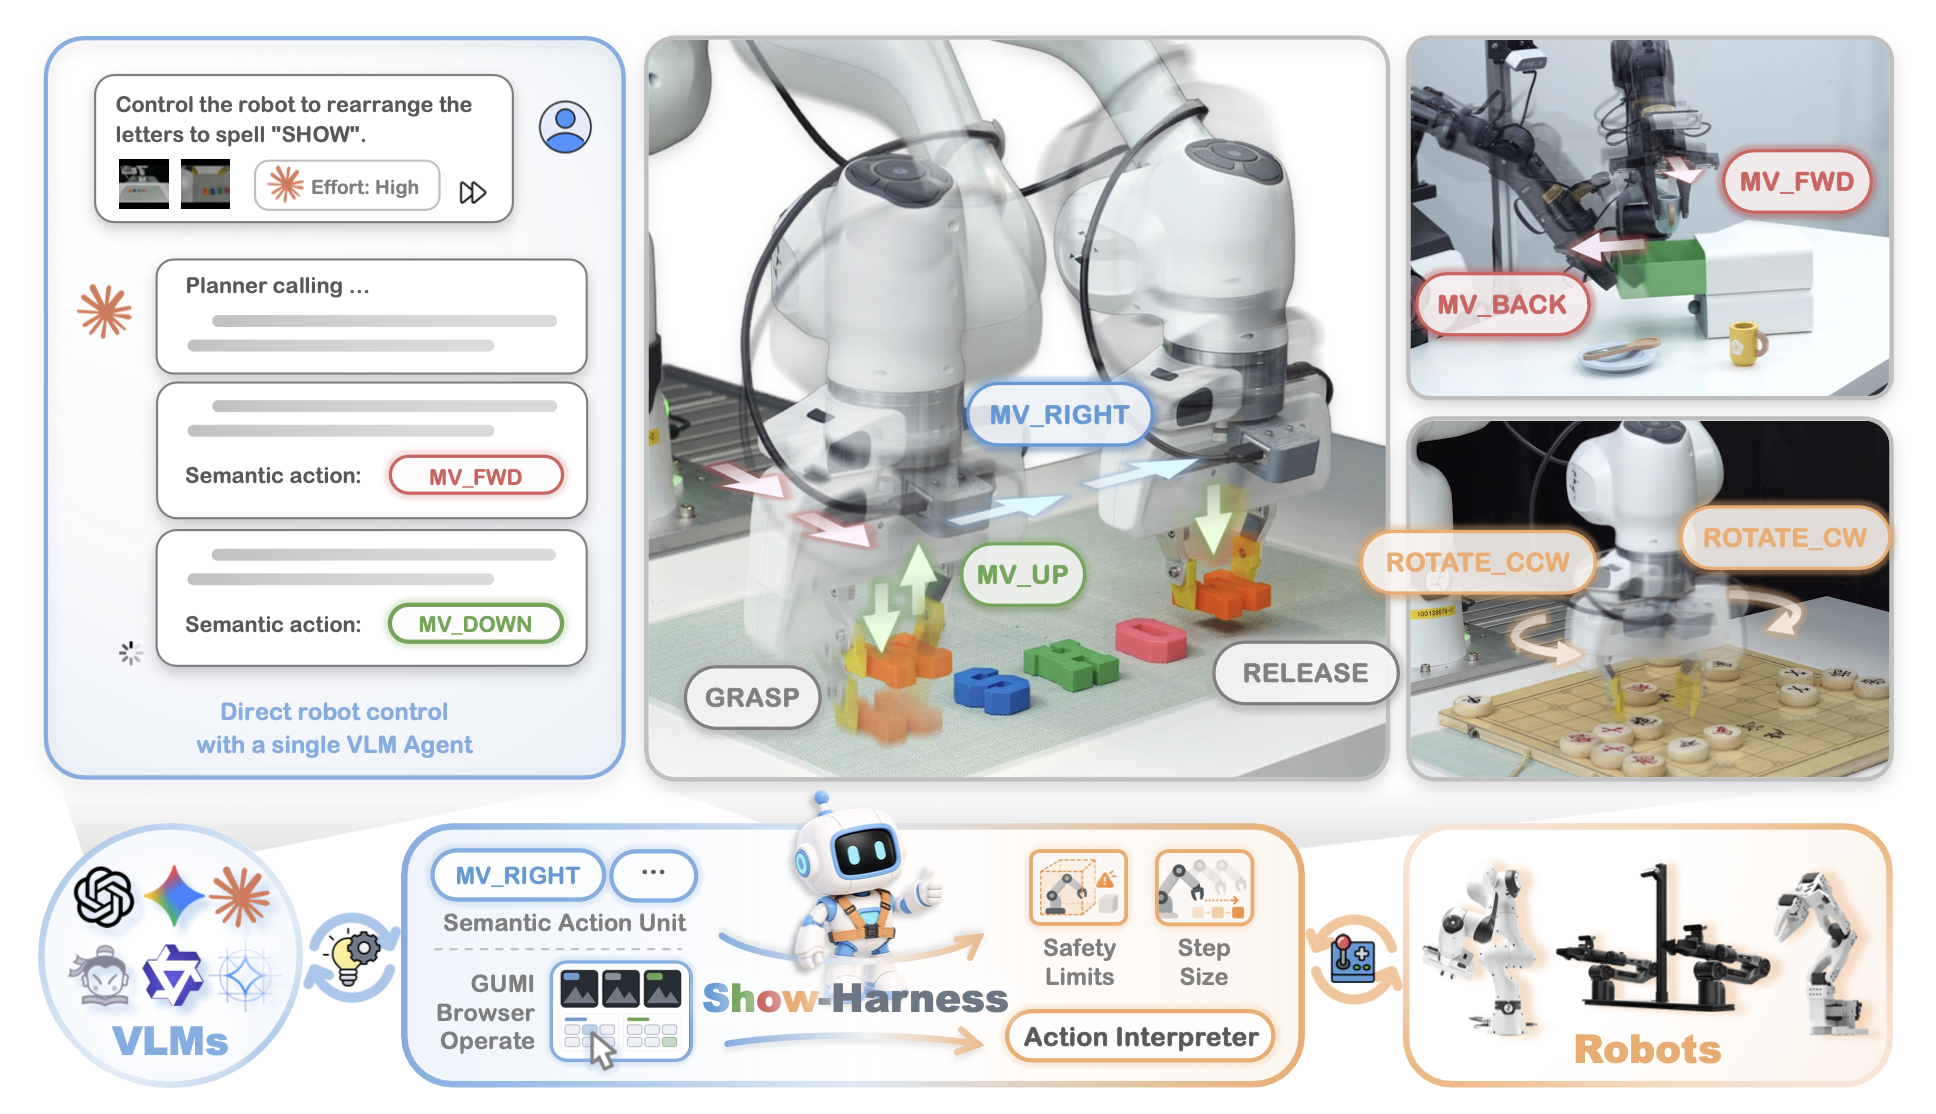
- 语义动作单元:定义一套和机器人硬件无关的离散符号动作:平移(MV_FWD / MV_BACK / MV_LEFT / MV_RIGHT / MV_UP / MV_DOWN)、旋转(ROTATE_CW / ROTATE_CCW)、夹爪(GRASP、RELEASE)、任务结束 DONE。
特点:增量式,每次只产生小幅物理运动,支持迭代修正;硬件无关,模型只输出语义符号;视觉锚定,移动方向相对于相机观测视图定义。 - 硬件专属解释器(g_E):接收 VLM 输出的语义动作,结合机器人自身运动学、工作空间约束,将符号转换为 6 自由度笛卡尔位姿更新、夹爪底层指令,完成真实运动;不同机器人只需要更换解释器,VLM 部分完全复用,同时内置安全边界约束,阻止危险动作。
如图 2 所示Show-Harness 通过一个语义动作接口将基础 VLM 连接到各种机器人实现,从而能够使用前沿模型进行零样本控制,并实现对小型开放模型的轻量级适配。
2. Show‑Harness 三层模块化架构(感知‑推理‑动作)
-
Perception 感知层插件
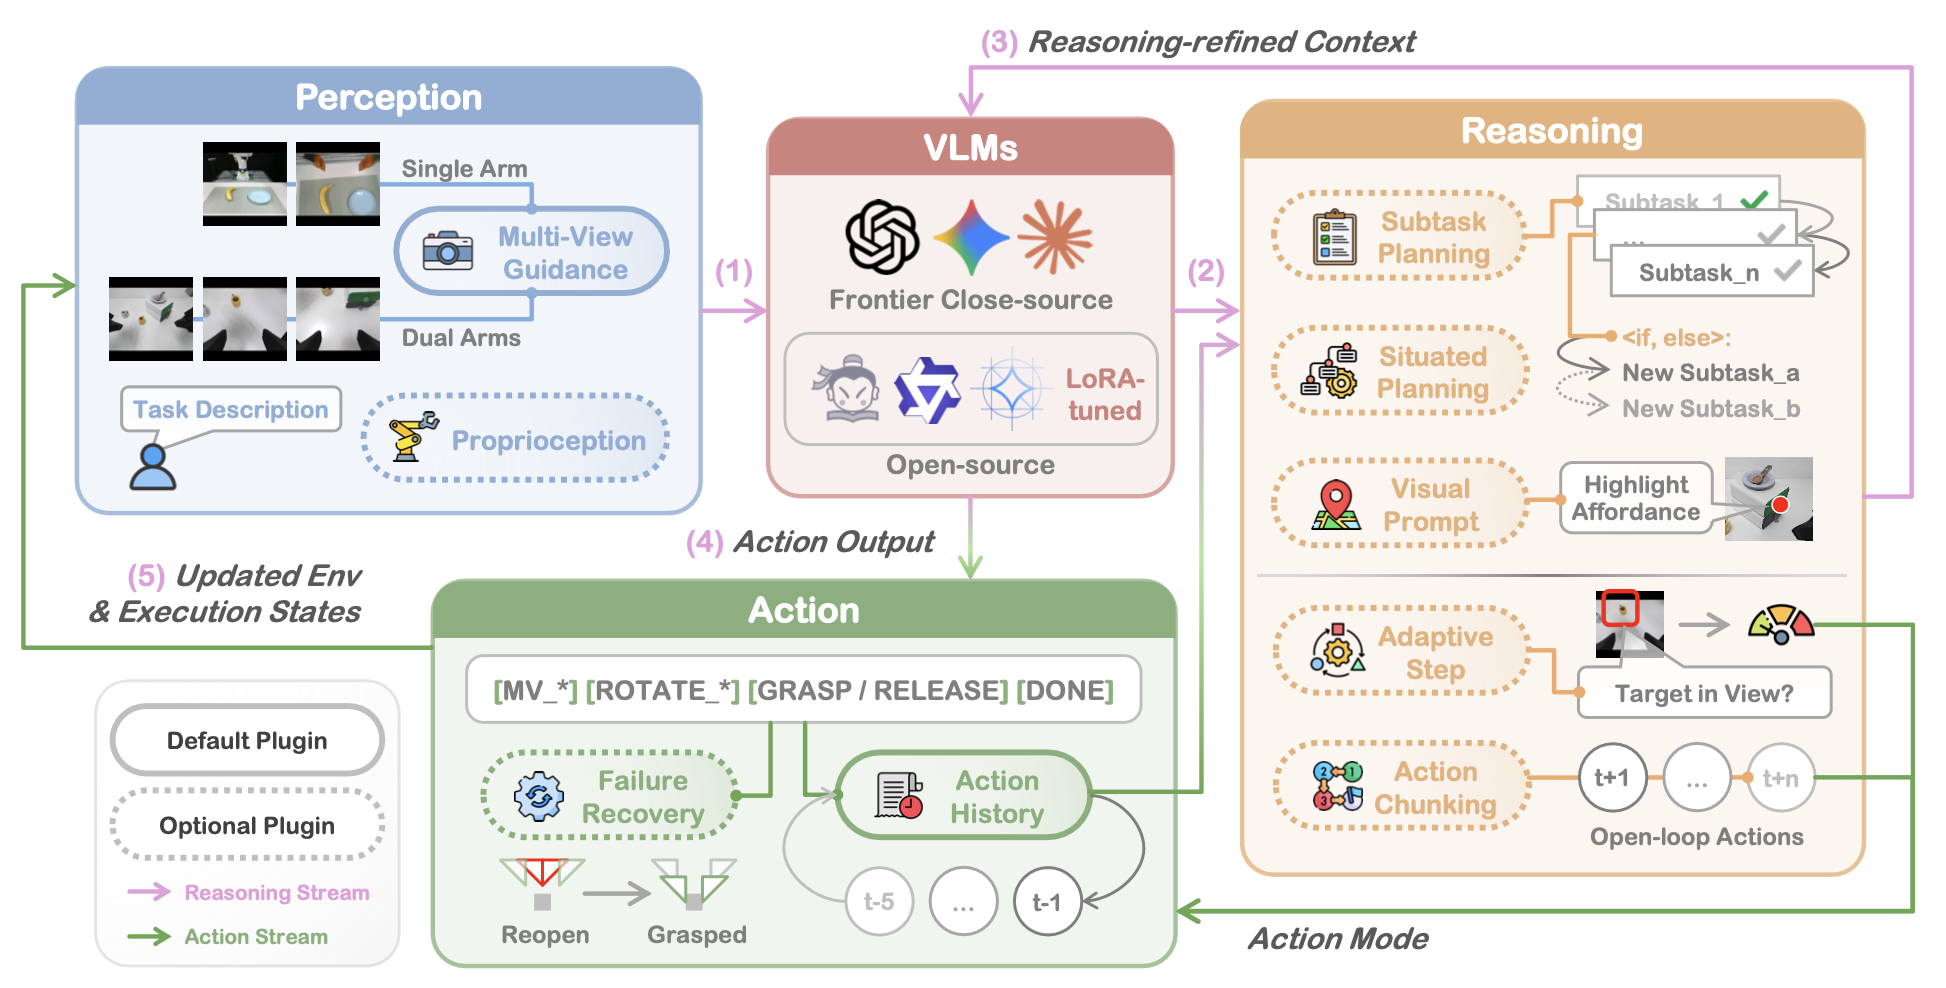
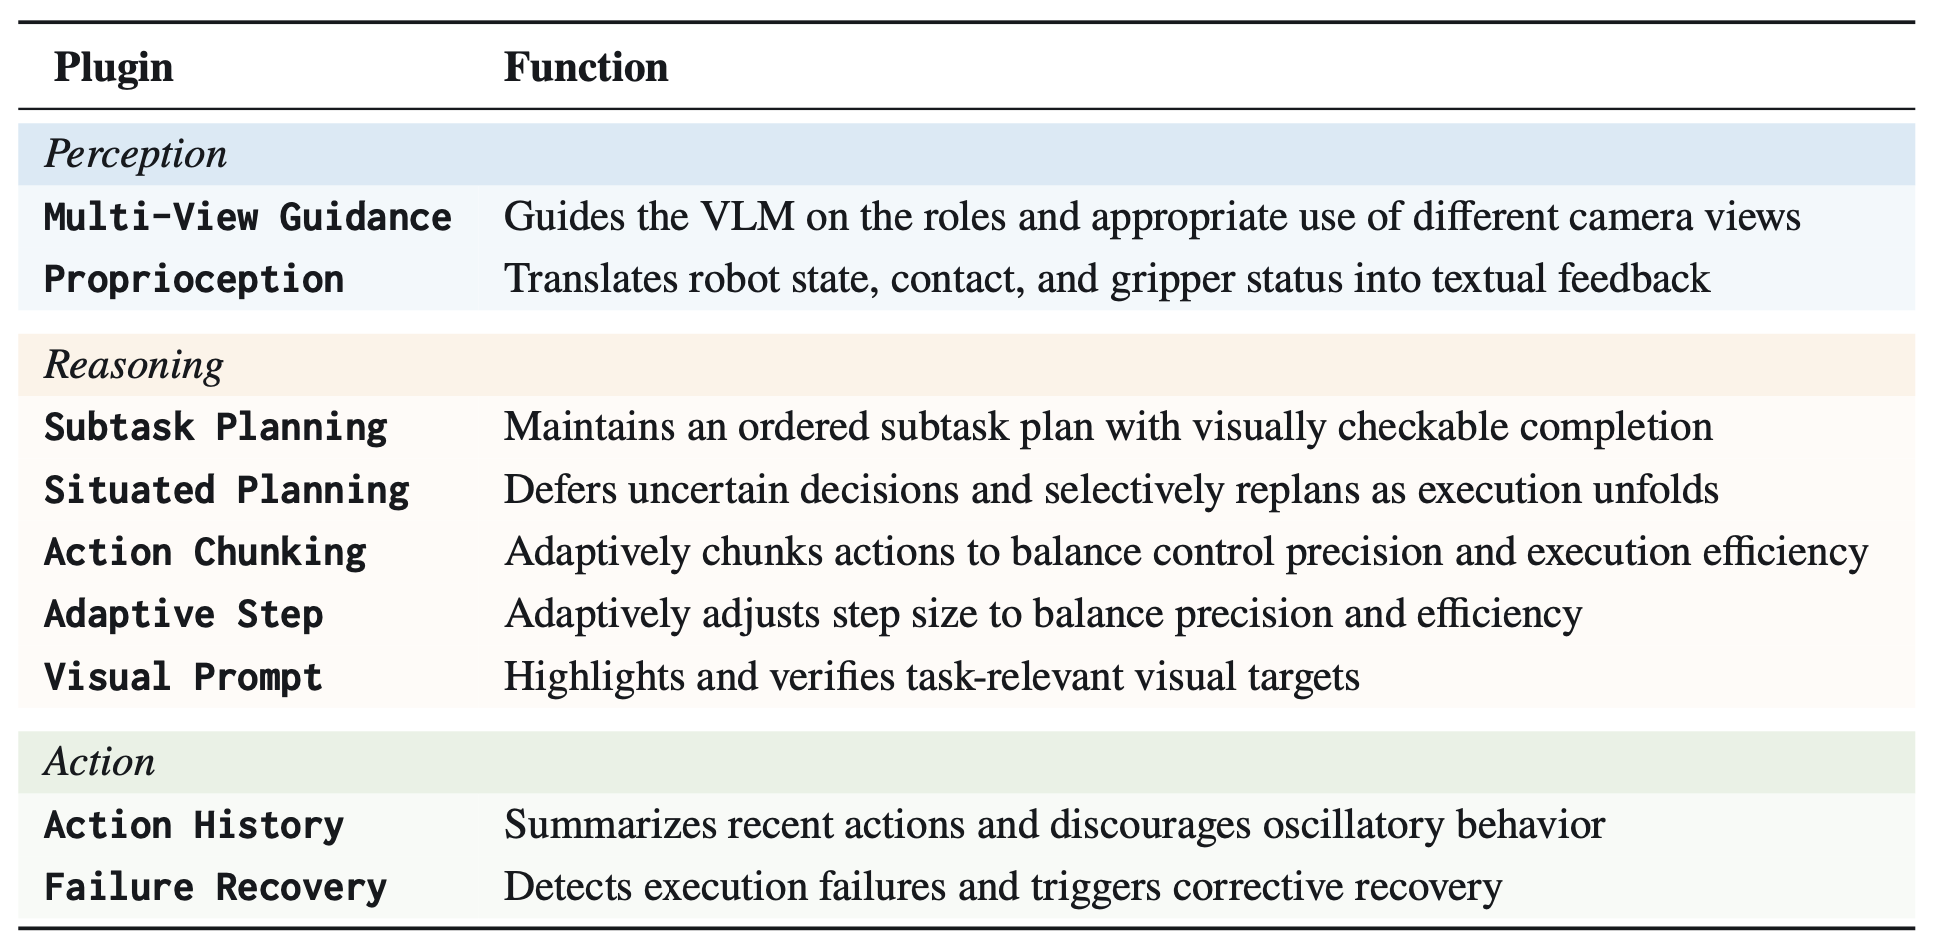
Multi‑View Guidance:引导模型利用全局视角 + 腕部相机多视图信息;
Proprioception:将机器人本体状态(夹爪高度、接触状态、位移)转为文本反馈给 VLM。 -
Reasoning 推理层插件,为 VLM 提供结构化任务决策能力
Subtask Planning:把长任务拆解为带视觉可检验完成条件的子任务;
Situated Planning:延迟不确定决策,观测到关键信息后再重规划;
Action Chunking:远距离时批量输出动作减少模型调用,近距离逐步执行保证精度;
Adaptive Step:自适应调整步长,远目标大步长、靠近目标小步长;
Visual Prompt:高亮任务交互目标,解决语言描述模糊问题。 -
Action 动作层插件,负责执行闭环与鲁棒性
Action History:维护历史动作,避免来回振荡;
Failure Recovery:检测抓取失败,自动重置夹爪、重试抓取子任务。
如图 3 所示Show-Harness架构。模块化的感知-推理-执行回路通过共享的语义动作接口将基础VLM与机器人控制系统连接起来。
3. 两种运行模式
1 零样本 ZS 模式:直接使用闭源前沿 VLM(Gemini‑3.1 Pro 等),不需要微调,通过 prompt 引导输出语义动作,实现机器人零样本操控。
2 微调 FT 模式:对开源小规模 VLM(如 Qwen3.5‑2B)做轻量 LoRA 微调,直接预测语义动作 token;仅需数 GPU 小时,冻结视觉编码器,只微调少量参数,适合低成本部署。损失函数为 token 级交叉熵,无需设计额外专用 action head。
如表 1 所示利用按照感知-推理-行动环组织的驾驭插件。
4. GUMI(GUI Manipulation Interface)工具
基于这套统一语义动作空间实现的图形界面,不需要专用遥操作硬件:
人类通过键盘 / 图形界面输出语义动作控制机器人,也支持 VLM 智能体操作该 GUI;
自动采集观测‑语义动作配对的演示数据;同一份演示数据可跨不同机器人硬件复用;支持人‑智能体协同数据采集,同时产出可用于训练语义策略和连续 VLA 策略的轨迹。
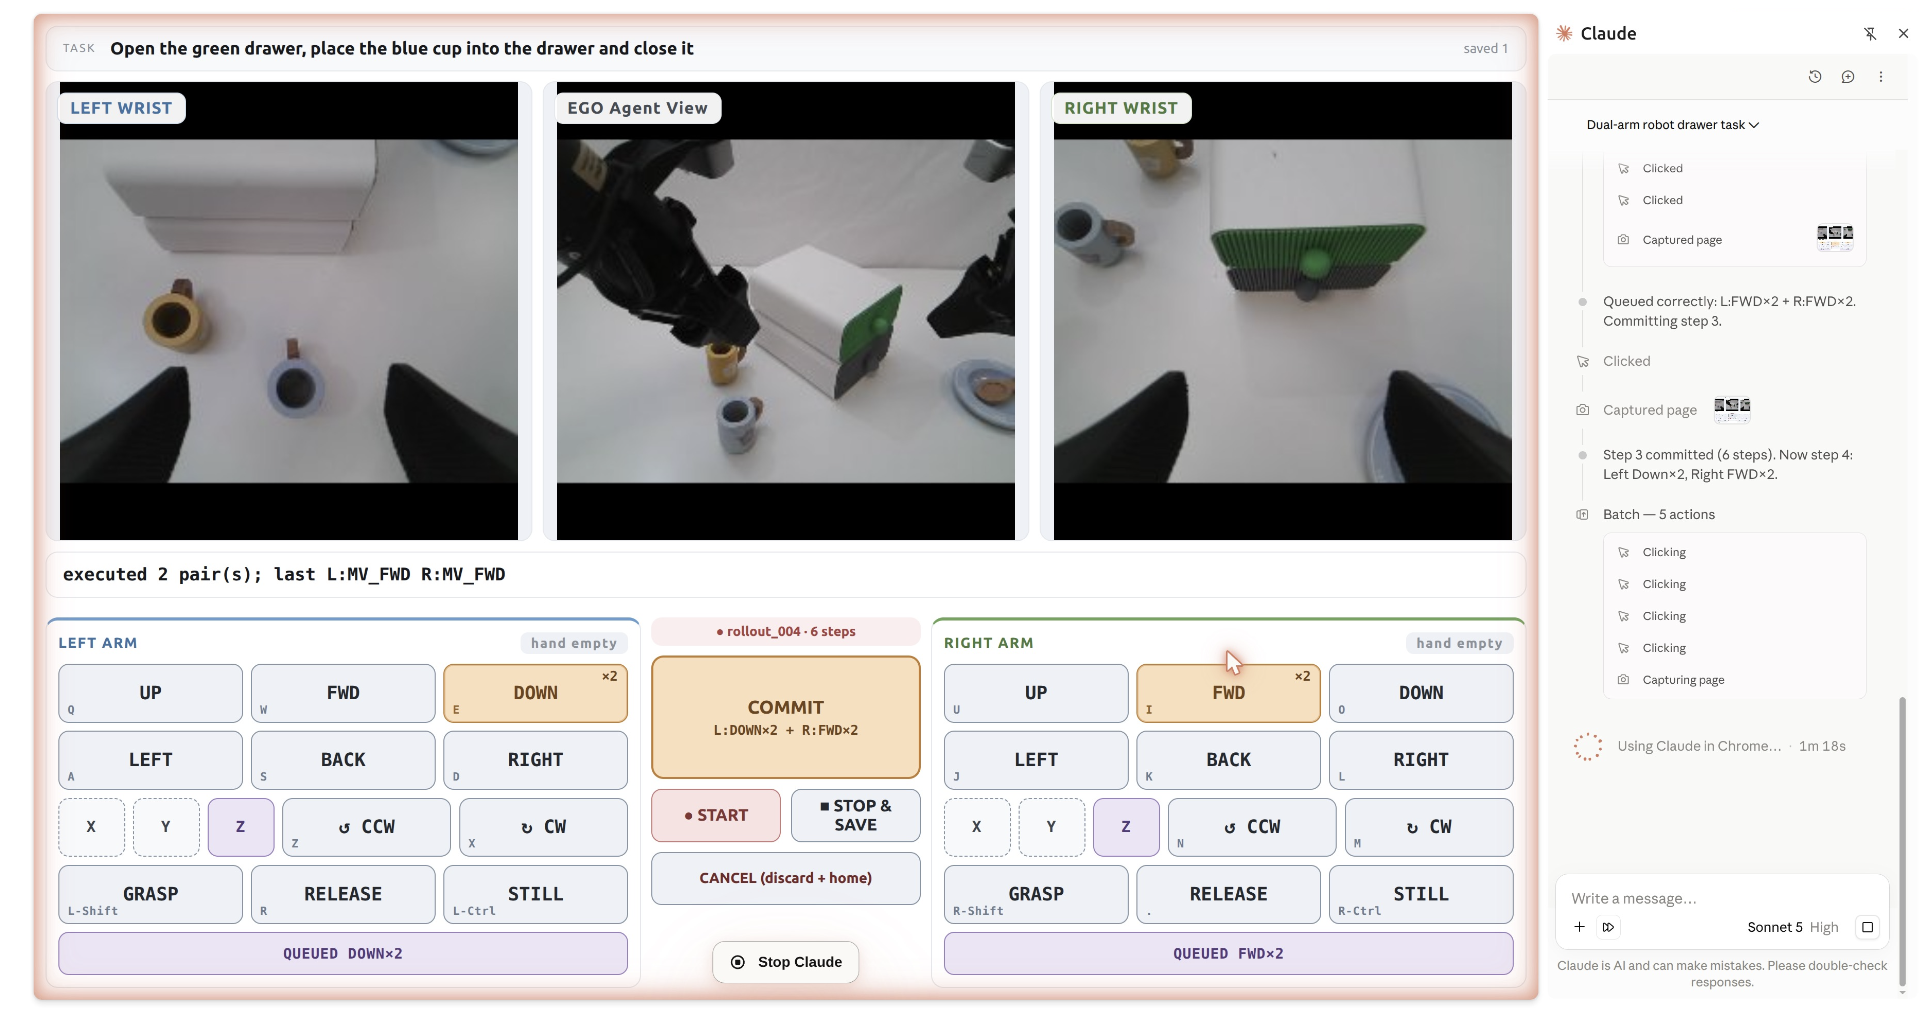
如图 4 所示GUMI界面。GUMI是一个基于图形用户界面(GUI)的操作界面,它使人类和前沿智能体能够通过相同的语义控制自主地收集演示数据。
5. 实验设置
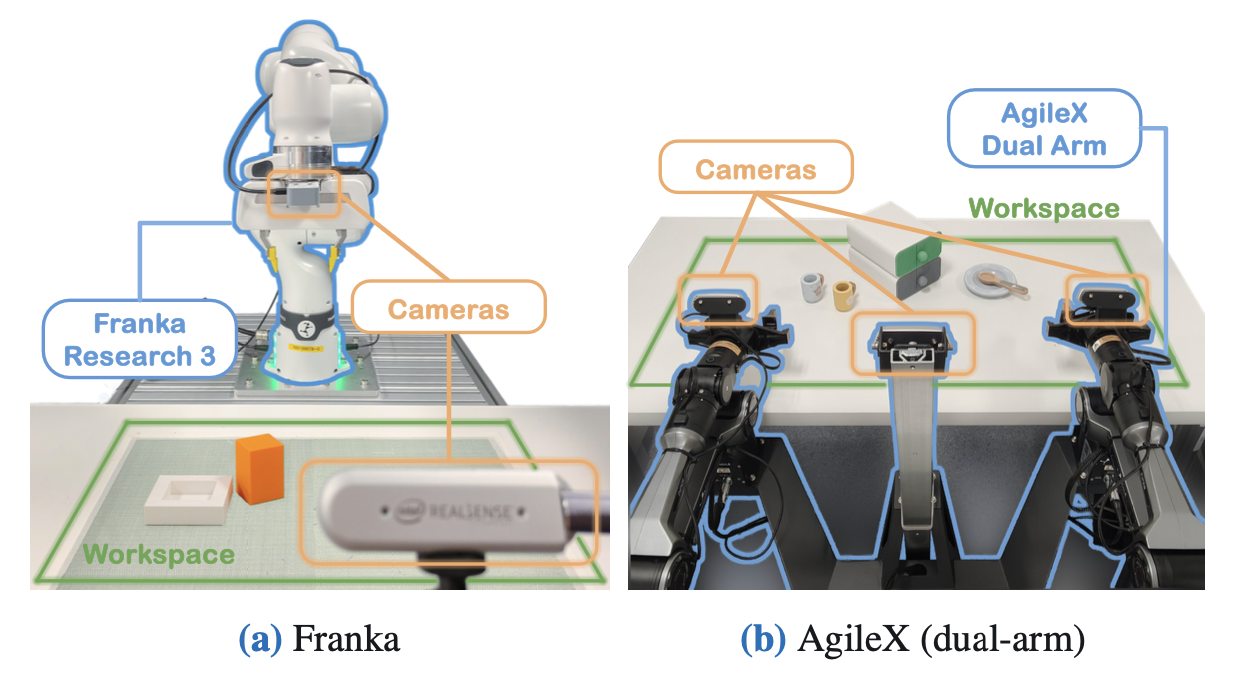
真实硬件:Franka 7 自由度单臂、AgileX 双臂机器人;
对比基线:VLA 模型((\pi_{0.5})、GR00T)、VLA 为执行器的智能体框架(H‑VLA、G‑VLA)、代码策略类机器人智能体(CaP‑X、RATS);
评测维度:跨任务泛化、跨环境(光照、背景、干扰物体、sim‑to‑real)、跨机器人本体泛化;同时做物理适应性、语义适应性、插件消融、动作空间表征消融实验。
如图 5 所示机器人配置:
二、主要贡献
1 提出 Show‑Harness 具身框架:设计一套模型无关、面向 VLM 的紧凑语义动作接口。VLM 负责细粒度物理层面决策,由硬件解释器完成底层执行;不需要对 VLM 做具身预训练。
2 验证两套可行部署范式
闭源大 VLM:直接零样本控制机器人,开箱即用;
小规模开源 VLM:仅少量 GPU 小时轻量 LoRA 微调,即可获得优于主流 VLA 方案的泛化、sim‑to‑real 迁移性能。
-
GUMI 图形采集接口:无需专业遥操作硬件,人类、VLM 智能体可以在统一语义动作空间采集机器人演示,支持跨本体复用演示数据、人机协同采集。
-
充分实验验证:在真实机器人上证明框架在跨任务、跨环境、跨机器人本体具备强泛化;开展大量消融,揭示 VLM‑机器人接口关键设计要素:多视图、本体感知、子任务规划、失败恢复、动作空间显式约定等;同时验证物理适应性(变步长、旋转外推、双臂协同)、语义适应性(复杂推理任务、视频 in‑context learning)。
核心洞察:不需要把 VLM 拟合到机器人底层连续动作空间;合适的高层但细粒度的语义接口,就可以释放基础 VLM 已经具备的具身智能能力。
三、存在的问题与局限性
1. 论文明确指出的局限
a)硬件场景有限:实验只针对平行夹爪的单 / 双臂桌面操纵;尚未验证人形机器人、灵巧手等更复杂本体。
b)感知模态单一:当前主要依靠视觉,缺少触觉、力反馈,对于高接触、精细交互任务能力受限。
2. 从方法与实验引申出潜在问题
i)推理开销问题:零样本模式依赖调用大 VLM API,每一步都需要模型推理;即便 Action Chunking 做批量动作,长任务下调用次数多,推理延迟高,实时性相比端到端 VLA 策略有差距。虽然小模型 FT 模式速度更快,但性能会低于闭源大模型零样本。
ii)任务边界限制:当前实验以桌面拾取放置为主;对于需要长序列、动态物体、高自由度复杂装配任务,子任务规划、 situated planning 插件会成为性能瓶颈。
iii)语义动作粒度权衡:动作是固定离散步;虽然支持 Adaptive Step 调整步长,但极端精细操作需要手动调解释器步长,不能完全自主动态生成任意连续轨迹。
iv)对 Prompt 与插件依赖较重:零样本模式高度依赖精心设计的 prompt 和整套插件;移除部分插件后性能明显下降,系统复杂度上升,插件调参成本高。
v)Sim‑to‑Real 仍然存在缺口:FT 模式 sim‑to‑real 优于 VLA 基线,但零样本模式依然依赖真实世界视觉输入,仿真演示训练的小模型在真实世界仍然存在一定性能衰减。
vi)双臂协同成本:双臂任务需要同时预测两套动作,输出空间扩大;目前仅验证简单协同任务,复杂双手操作还有待验证。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献432条内容

所有评论(0)