GE-Act 2.0:面向机器人操作的“世界-动作”模型预训练与扩展
26年9月来自智元机器人研究组(Agibot)的论文“GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation”。
一、论文概述
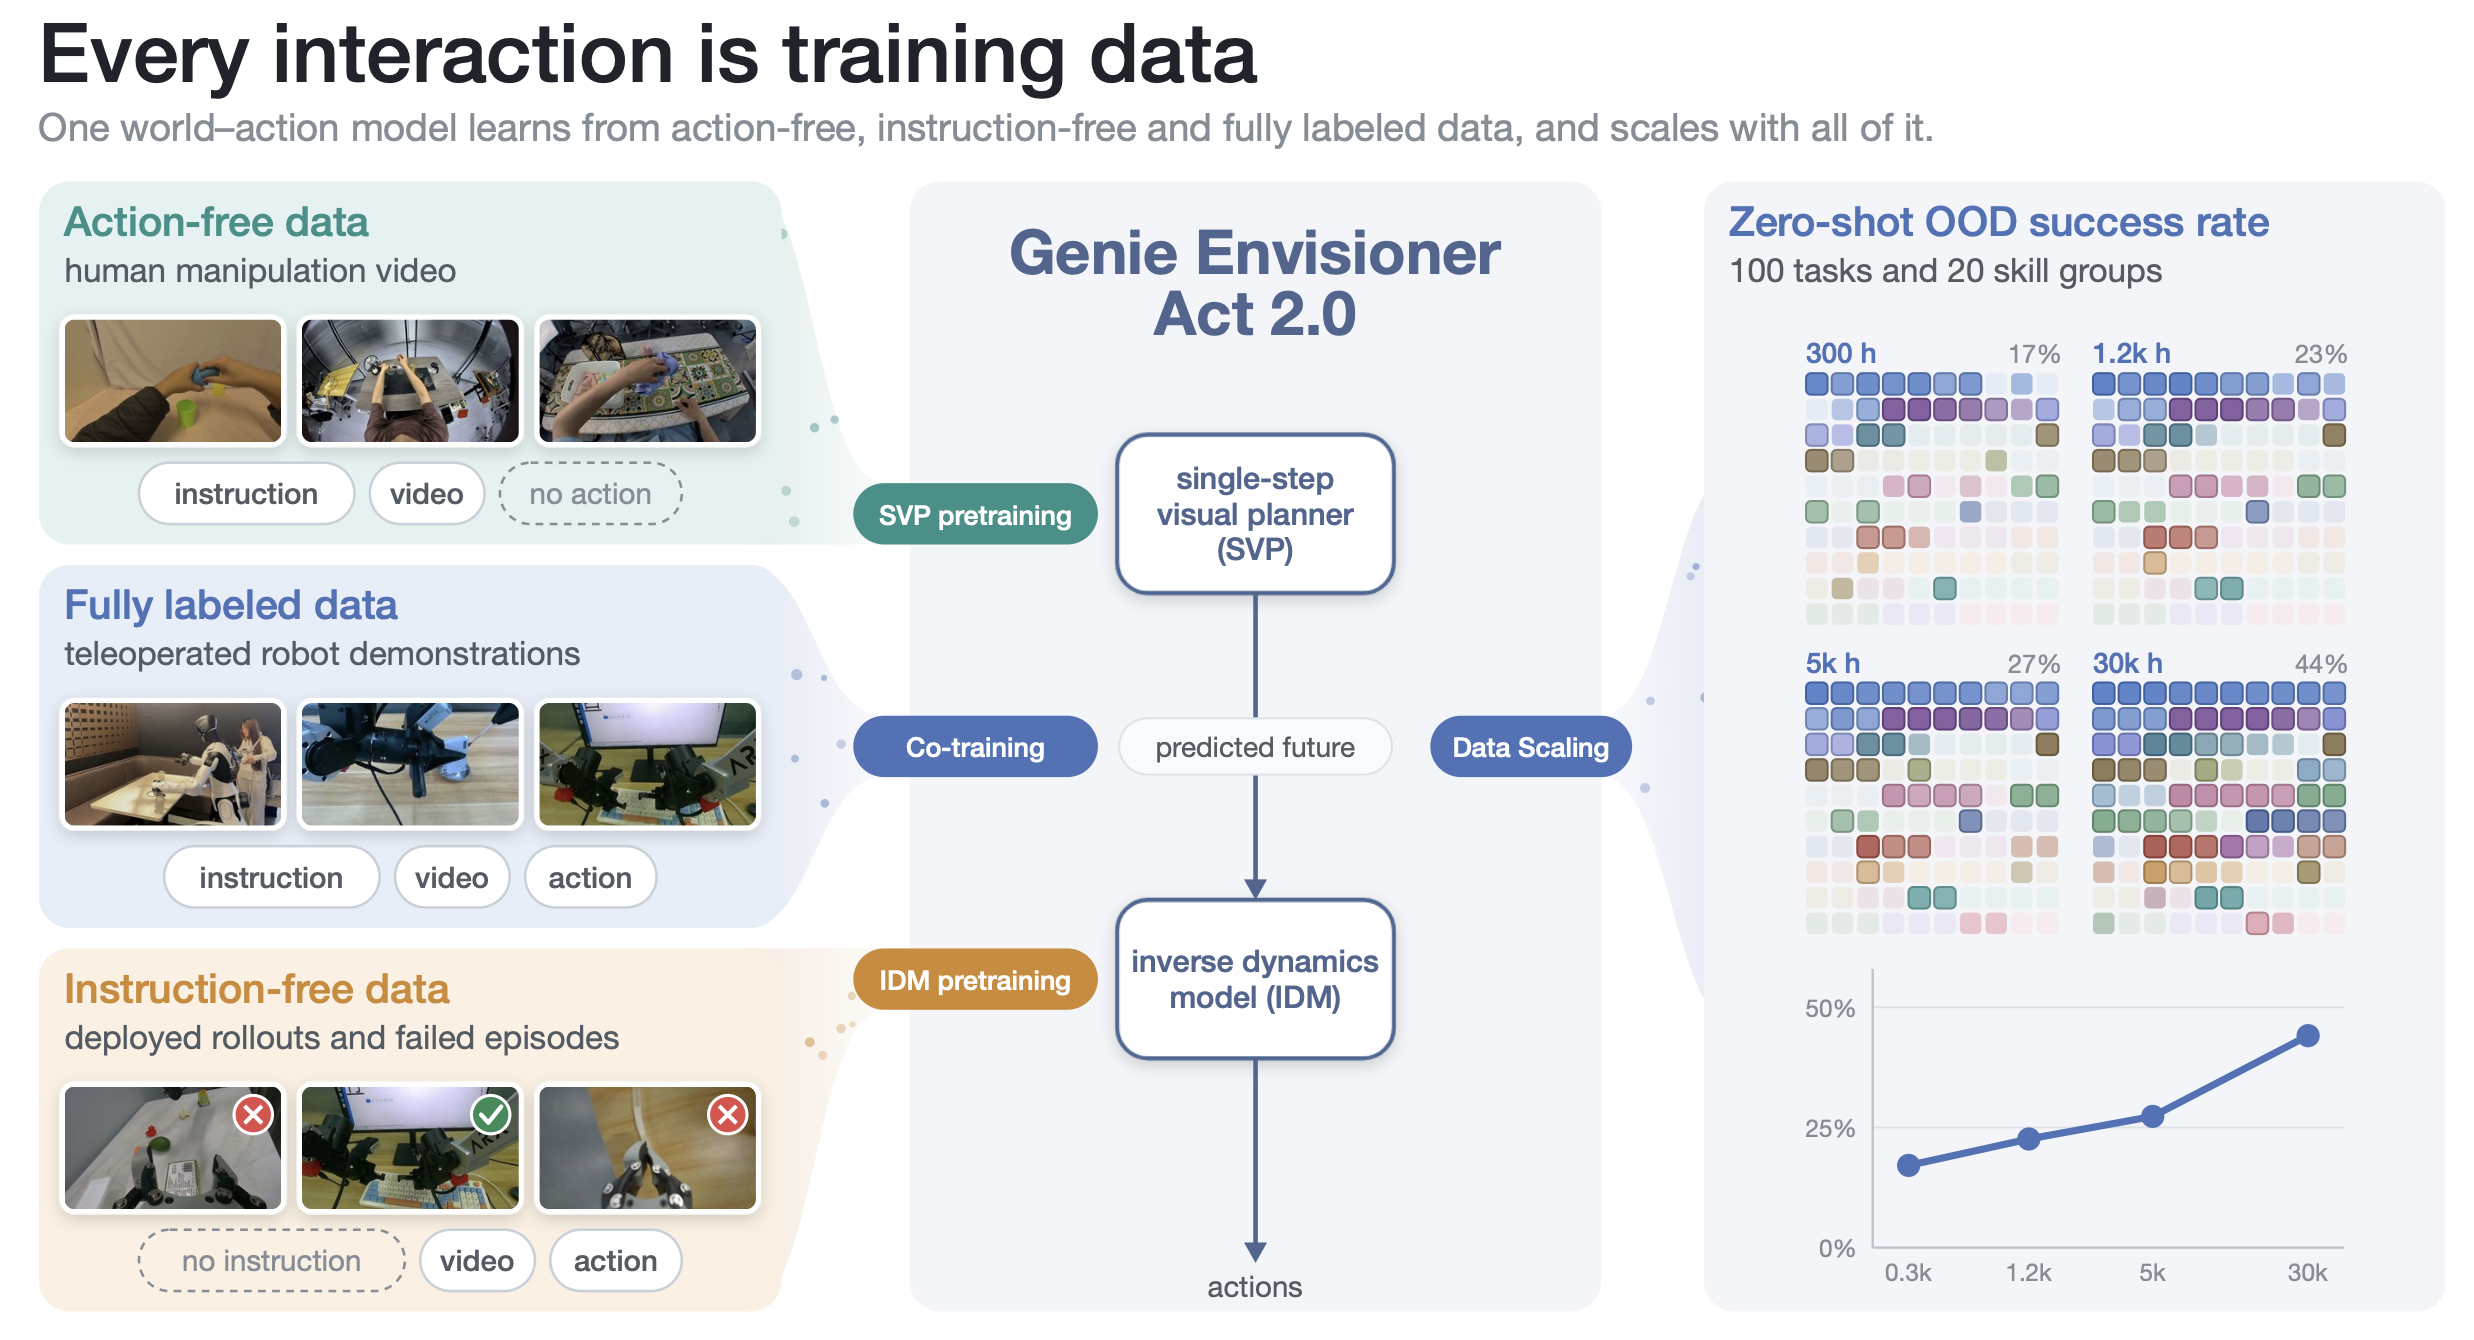
该论文提出 GE-Act 2.0,一个面向机器人操作的世界-动作模型(World-Action Model, WAM)。其核心目标是:从操作数据出发,从头预训练并扩展视觉生成与动作预测的统一系统,而不是像多数已有工作那样继承预训练视频生成器,再外接动作模型。GE-Act 2.0 在 100 个真实机器人原子任务、20 个技能组、两种本体上做零样本 OOD 评估,并展示从 300 到 30,000 小时协同训练数据的系统性扩展收益。
如图1 所示GE-Act 2.0 首先利用无动作标签的视频数据预训练视觉规划器,并利用无语言指令的轨迹数据预训练逆动力学模型,随后在包含完整标注的机器人演示数据上对整个系统进行联合训练。将联合训练数据量从 300 小时扩展至 30,000 小时,显著提升系统在包含 100 项任务的真实机器人测试集上的零样本分布外(OOD)任务成功率。右侧面板中的每个方格代表一项任务,颜色标识技能类别,阴影深浅表示成功率;曲线则展示所有任务的平均成功率。
二、基本方法
如图 2 所示GE-Act 2.0 系统架构。SVP 基于当前观测将指令具体化,并通过单次流生成器(flow-generator)前向传播,对多视角未来视觉潜变量进行完全去噪;IDM 则结合当前及预测的潜变量与本体感知信息,生成稠密与稀疏的动作序列。
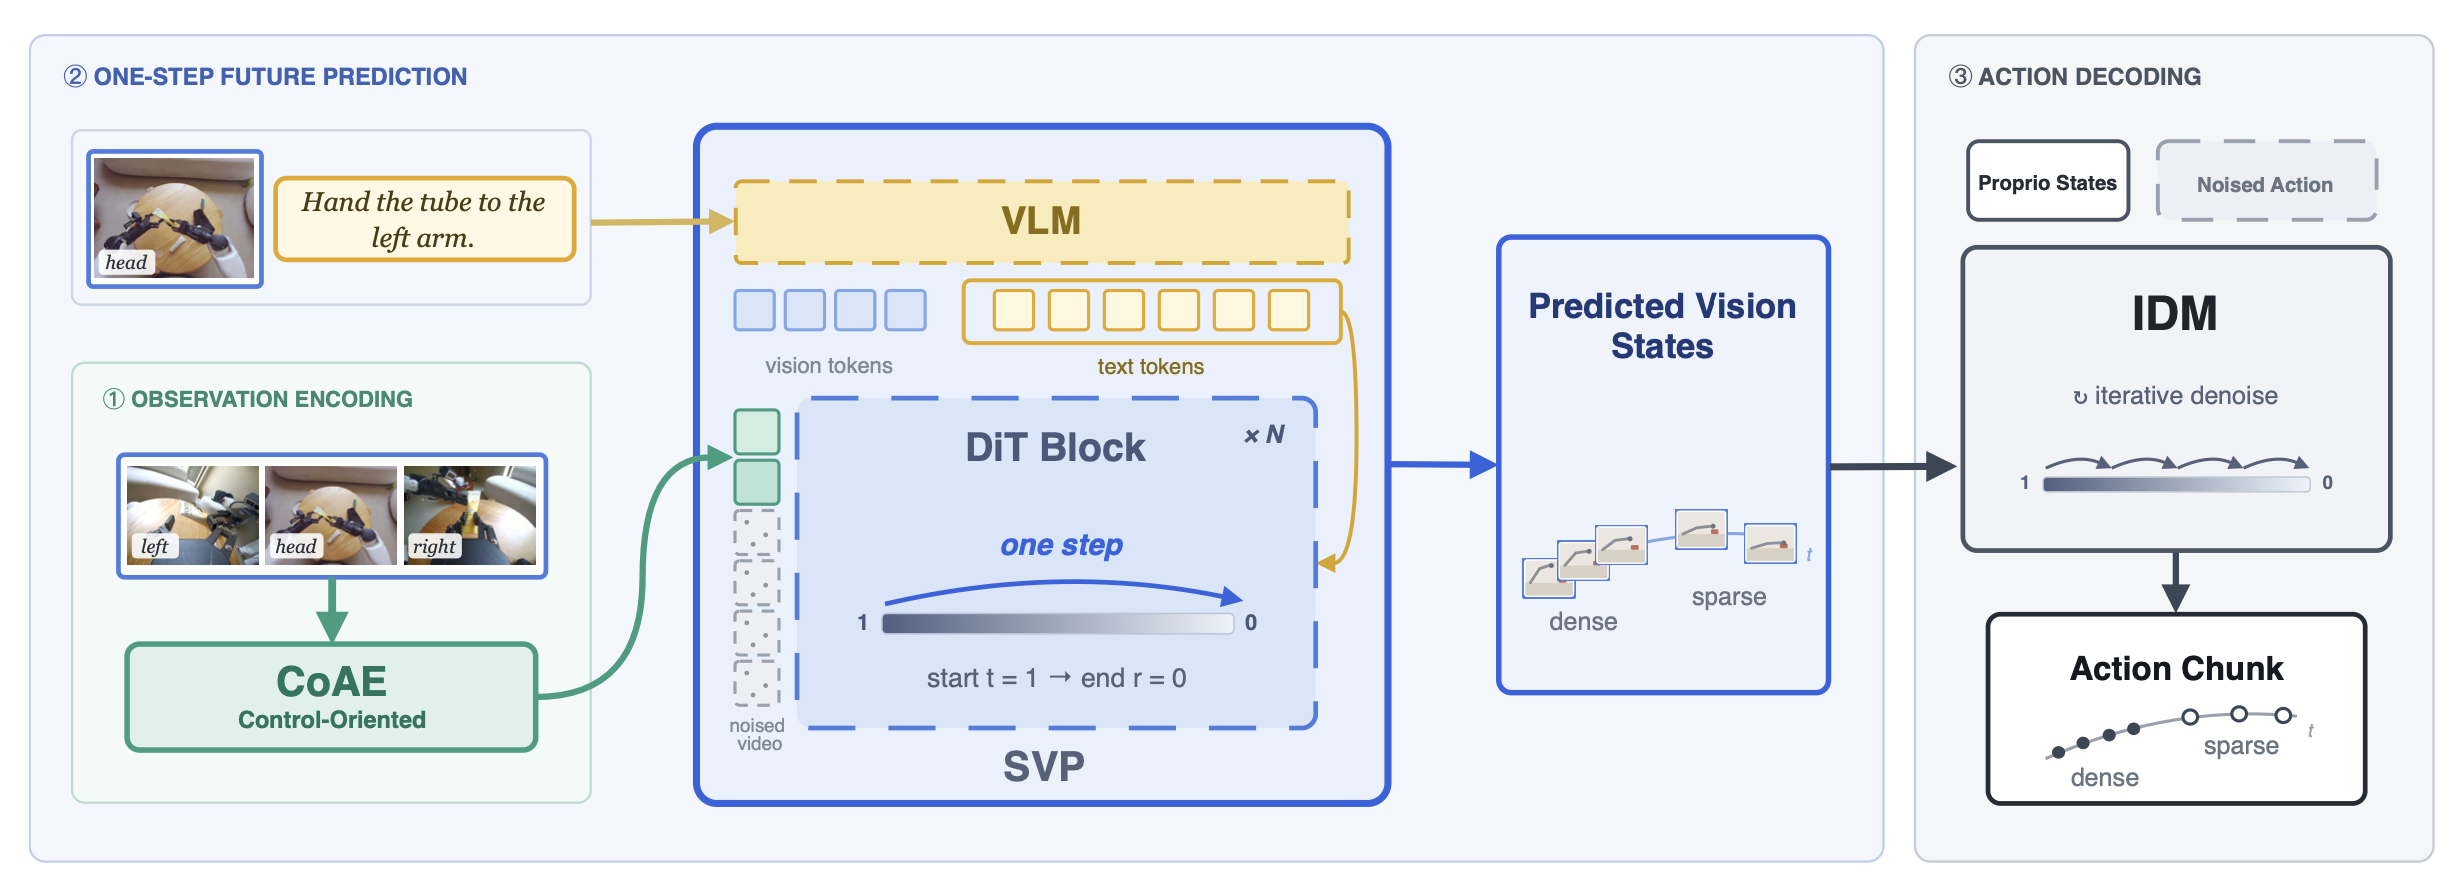
GE-Act 2.0 由三个核心组件构成:
1 控制导向自编码器 CoAE
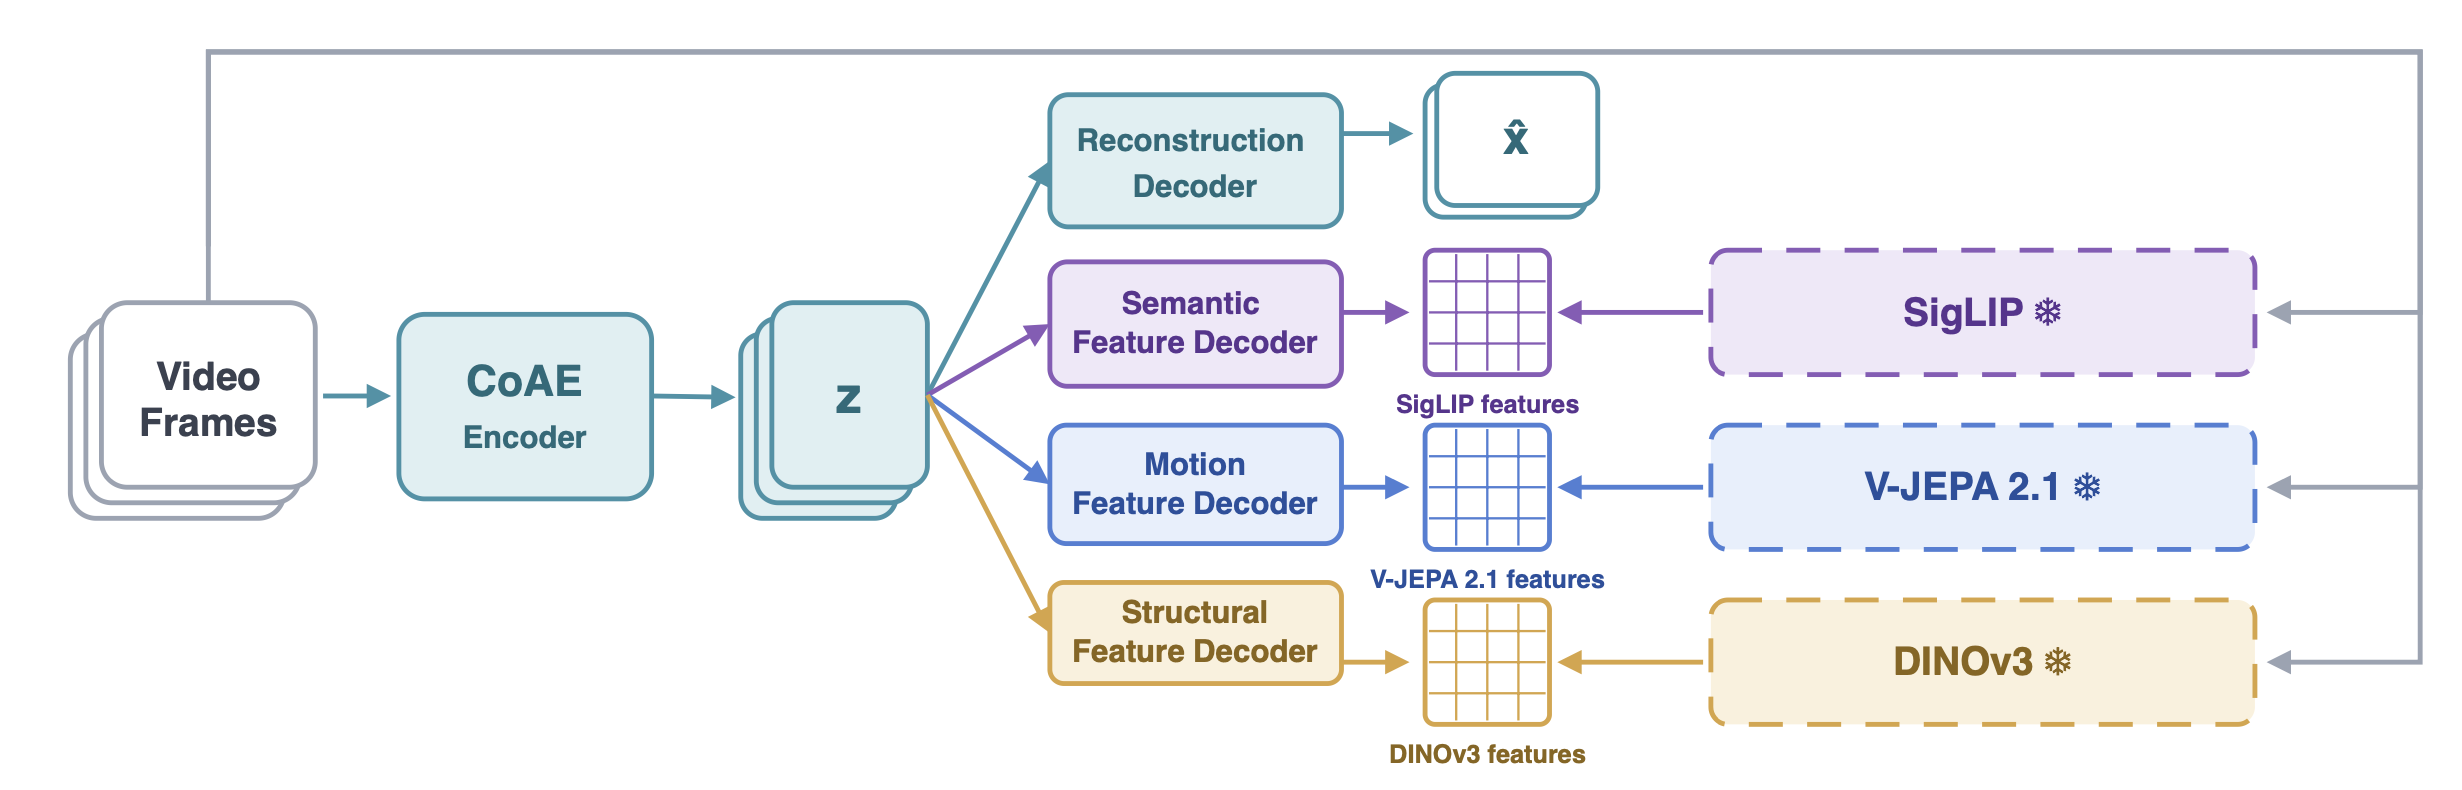
帧级 2D 自编码器,采用 64× 空间下采样,256×384 输入帧被压缩为 4×6 的 512 通道 latent,即每帧 24 个 token。
训练目标包括像素重建、LPIPS、GAN 损失,并对齐三个冻结视觉教师:SigLIP 2、V-JEPA 2.1、DINOv3,以保留语言语义、时空结构和稠密视觉特征。
目标是在极端压缩下仍保留动作恢复和指令 grounding 所需信息。
如图3所示CoAE 架构与训练目标。在 SVP 采用的 256×384 帧分辨率下,编码器将单帧输入映射为 4×6 网格形式的 512 通道潜表征(latents),即每帧包含 24 个 token。重构解码器提供像素级监督,而三个对齐头(alignment heads)则负责匹配来自冻结视觉教师模型的特征——包括语言对齐特征、时空特征以及稠密视觉特征。
2 单步视觉规划器 SVP
使用冻结 VLM(Qwen3.5-2B)理解当前观测和指令,再用条件 MeanFlow 流生成器一次性生成多视角未来视觉 latent。
采用多尺度时序预测:密集近程帧用于控制,稀疏远程帧用于任务意图。
单步可微生成使 SVP 与 IDM 可以先分别预训练,再端到端协同训练。
3 逆动力学模型 IDM
输入当前与预测未来视觉 latent、本体状态,输出密集控制动作块和稀疏远程辅助动作。
单独预训练时使用记录的“未来视觉-动作”配对,协同训练时接入 SVP 生成的未来。
4 KASO 协同训练
论文指出“有效性差距”(validity gap):同一观测和指令下可能有多种正确行为,记录动作只对应其中一种,而独立生成的未来可能对应另一种,导致视觉与动作监督不匹配。
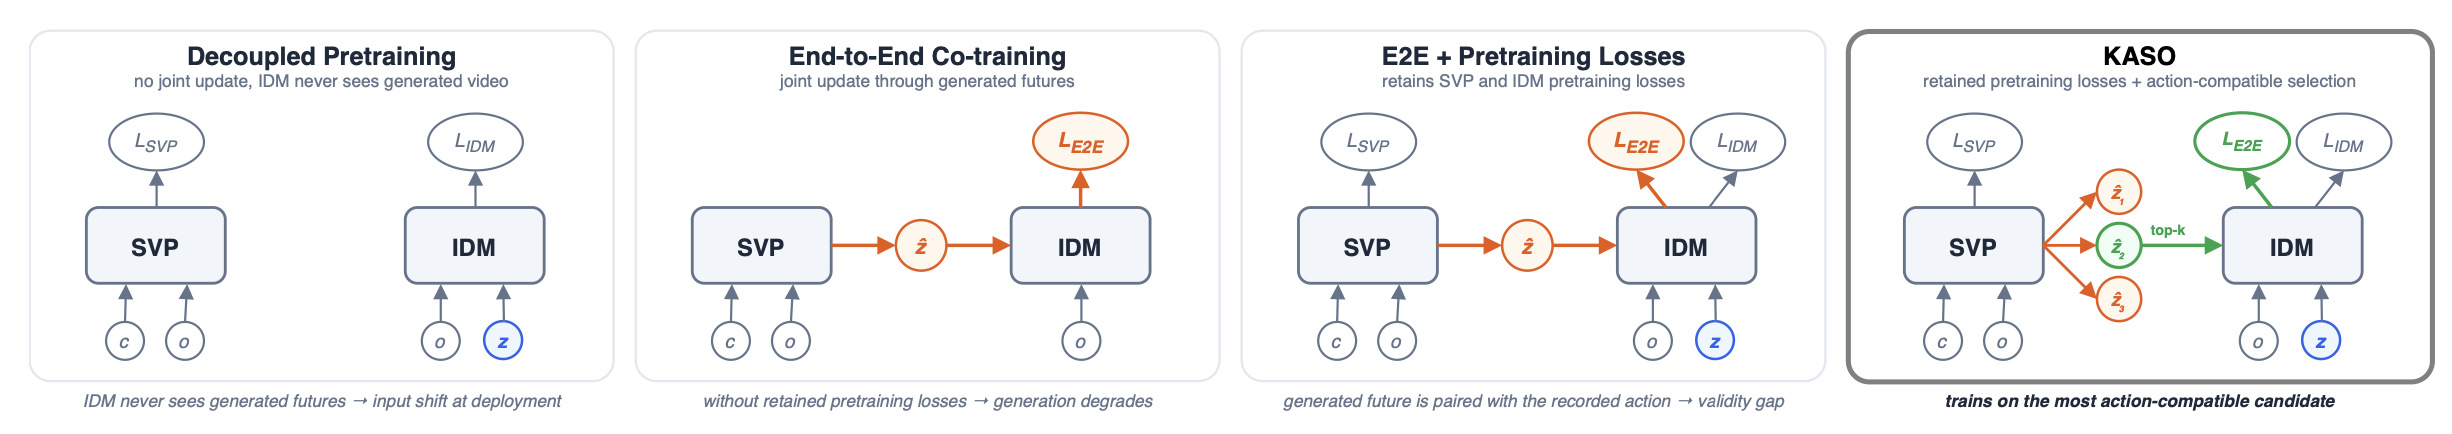
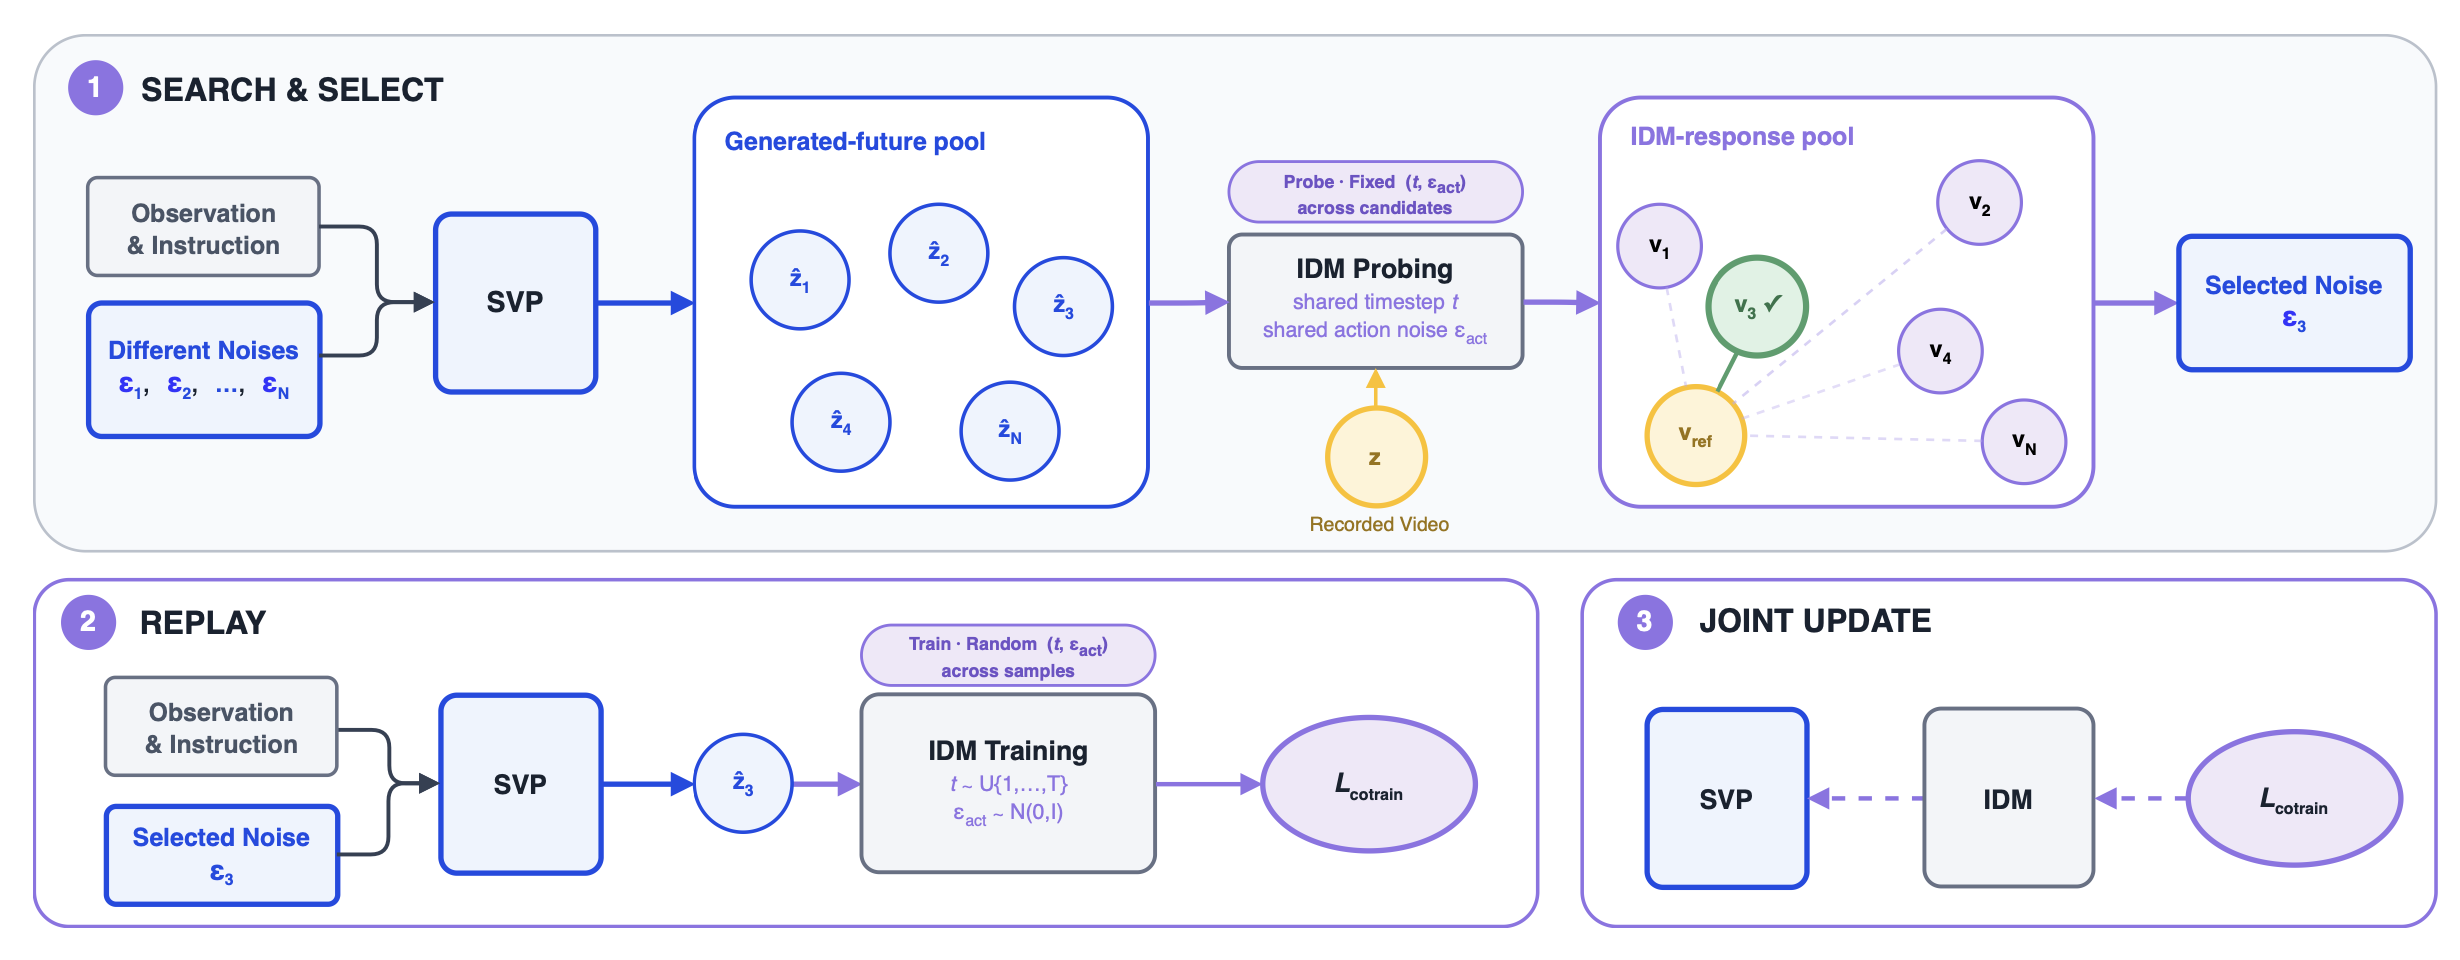
KASO 对每个样本采样多个未来候选,用当前 IDM 在高噪声动作流时间点评估候选与记录未来的动作兼容性,只选 top-k 兼容候选回传动作梯度,同时保留 SVP 和 IDM 的预训练损失。
如图7所示KASO 流水线:从 SVP 中采样候选视觉预测并进行无梯度评分;随后精确重放所选噪声,使得联合动作损失能够同时更新 IDM 和 SVP。
训练分三阶段:SVP 预训练(39,000 小时指令视频)、IDM 预训练(32,000 小时动作轨迹)、KASO 协同训练(30,000 小时指令-视频-动作数据)。
如图 4 所示解耦预训练(Decoupled Pretraining)、端到端联合训练(End-to-End Co-training)、端到端结合预训练损失(E2E + Pretraining Losses)与 KASO 之间的比较。解耦预训练即预训练阶段本身:SVP 和 IDM 分别基于各自的目标进行训练,且从不交换生成的未来状态。这四种策略的区别在于:IDM 是否接收生成的未来视觉状态,SVP 和 IDM 的预训练损失是否保持有效,以及生成的候选动作是否经过动作兼容性筛选。
三、主要创新
从零预训练 WAM:所有可训练生成与动作组件均从随机初始化开始,在操作数据上训练,而非继承自然视频生成器。
CoAE 控制导向 latent 空间:在 64× 压缩下保持动作恢复和指令 grounding,兼顾生成可解码性与控制信息。
单步可微视觉规划器:用条件 MeanFlow 一次前向生成完整未来,使 SVP 和 IDM 可解耦预训练,再通过动作损失端到端连接。
识别并解决 validity gap:提出 KASO,在动作空间而非像素空间选择与记录动作兼容的生成未来,避免多模态动作被平均或抹除。
零样本 OOD 评估协议:不做每任务 SFT,直接评估预训练 checkpoint,衡量预训练本身获得的能力。
系统性数据 scaling 证据:300→30,000 小时使 G1-OP 成功率从 17.1% 升至 44.1%,G2-90D 从 13.4% 升至 31.1%;19/20 和 18/20 技能组提升。技能覆盖与 OOD 成功强相关(Pearson r=0.80,Spearman ρ=0.85)。
四、主要结果
真实机器人 100 任务零样本 OOD:G1-OP 从 17.1% 到 44.1%,G2-90D 从 13.4% 到 31.1%,G2-90D 仅占协同训练数据不到 2%,仍有 17.7 个百分点提升,显示跨本体迁移。
指令跟随:对象、颜色、位置、形状 Follow Score 至少 90%;尺寸较弱(82.5%/65.7%),序数/顺序最弱(13.3%/26.7%),与训练语料长尾分布一致。
行为与语义冲突压力测试:目标切换、手臂切换、反常规放置等任务中,模型可依据显式指令覆盖已承诺行为或场景先验。
仿真:RoboTwin Clean-to-Random 的 Hard 条件 60.52%,高于 π0.5 的 47.90%;GenieSim-Instruction 平均 0.770;LIBERO-Plus 总体 80.4%,但背景和机器人状态扰动仍是弱点。
五、问题与局限
仍是 System-1 低层策略:缺少高层推理、长时规划、任务分解、记忆和自我纠正能力。
ego/human video 未充分扩展:论文认为这是重要数据源,但尚未大规模验证。
KASO 依赖当前 IDM 与在线采样:计算开销较大,选择质量受 IDM 偏差影响;高噪声探针是启发式,理论保证有限。
数据与技能覆盖不均:G2-90D 数据极少,长尾技能和序数/比较语言覆盖不足,导致尺寸、顺序等 grounding 弱。
鲁棒性不均衡:LIBERO-Plus 中背景、机器人状态扰动下性能下降;仿真到现实差距仍大,仿真结果需 SFT 后评估。
动作多模态保持与后训练未充分验证:KASO 声称保留动作多样性以利于 RL,但尚未系统展示 RL 后训练收益。
scaling 未做匹配计算隔离:数据规模扩大同时训练时长/计算也变化,不能完全归因于数据量。
六、下一步工作可能性
扩大 ego/human manipulation video 预训练:研究其规模、多样性、组成对视觉生成和下游操作能力的影响。
耦合 System-2 deliberative 系统:加入长时规划、任务分解、记忆、自校正,形成闭环“规划-行动-改进”。
增强长尾语言 grounding:增加序数、比较、尺寸、形状等稀有指令数据,提升复杂指代和关系理解。
改进 KASO 与后训练:更高效的候选选择、离线+在线混合、理论分析,并与强化学习结合验证动作多样性价值。
提升跨本体与鲁棒性:平衡多本体数据,改进背景、机器人状态、传感器噪声下的稳定性。
统一理解与生成:进一步融合 VLM 与生成器,增强场景 grounded 条件。
更严格的 scaling law 与计算匹配实验:分离数据量、模型规模、计算预算的贡献。
真实部署与安全:在开放环境、多阶段任务、失败恢复中验证,并研究安全约束。
总体而言,GE-Act 2.0 的核心贡献是展示了一条从零预训练世界-动作模型并随操作数据 scaling 的可行路径,同时用 CoAE、单步 SVP 和 KASO 分别解决表示、生成接口和视觉-动作监督错配问题。其局限主要在于高层推理、长尾覆盖、鲁棒性和后训练闭环,这些也构成了后续研究的主要方向。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献432条内容

所有评论(0)