【Spring Ai Alibaba】通义千问模型,如何参数调优?
·
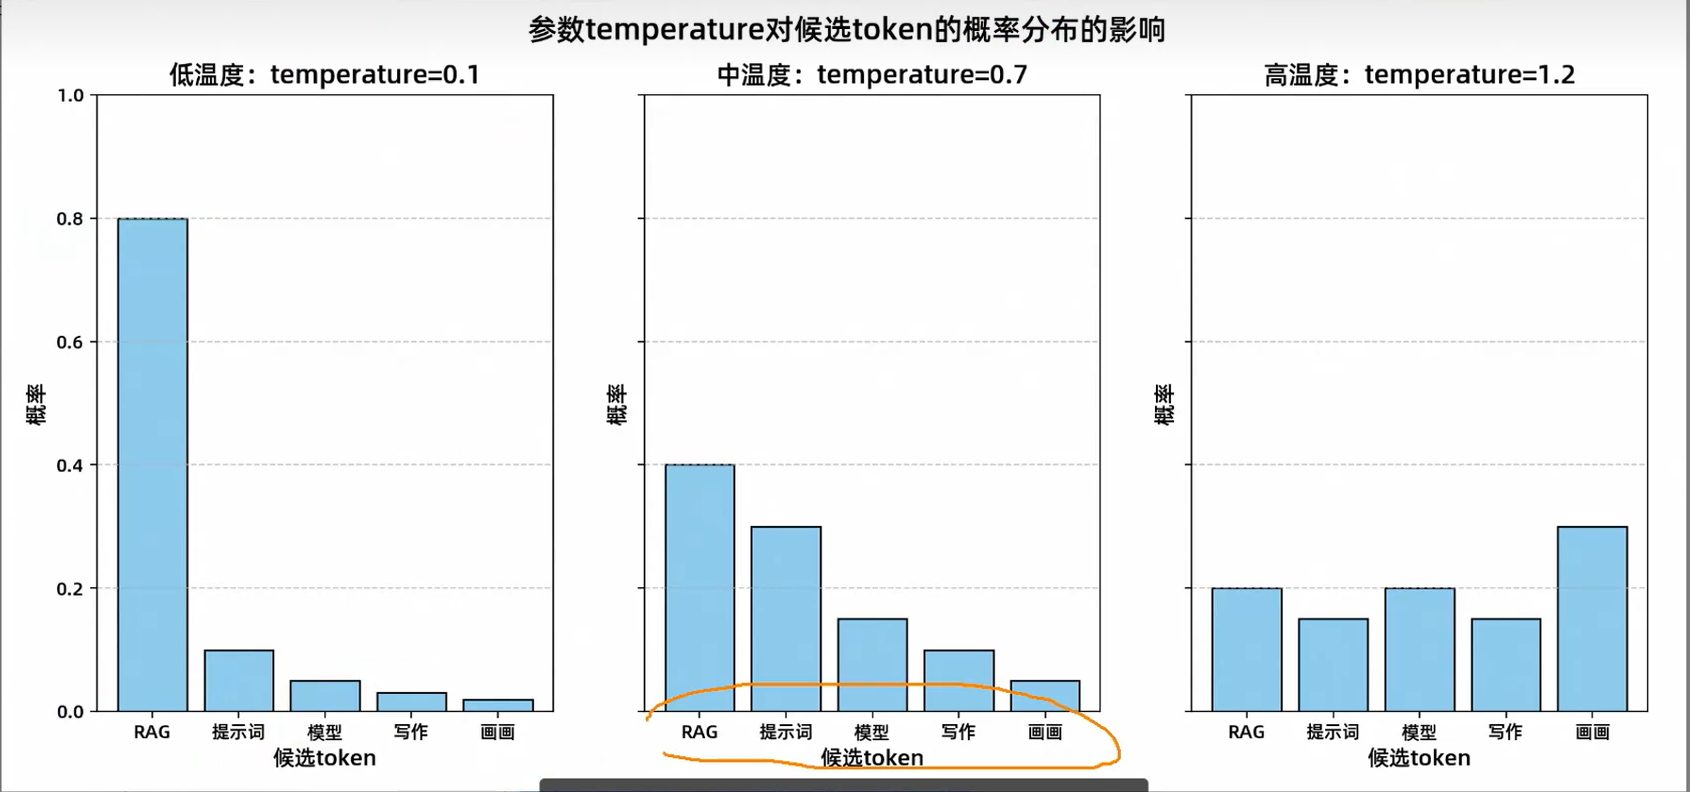
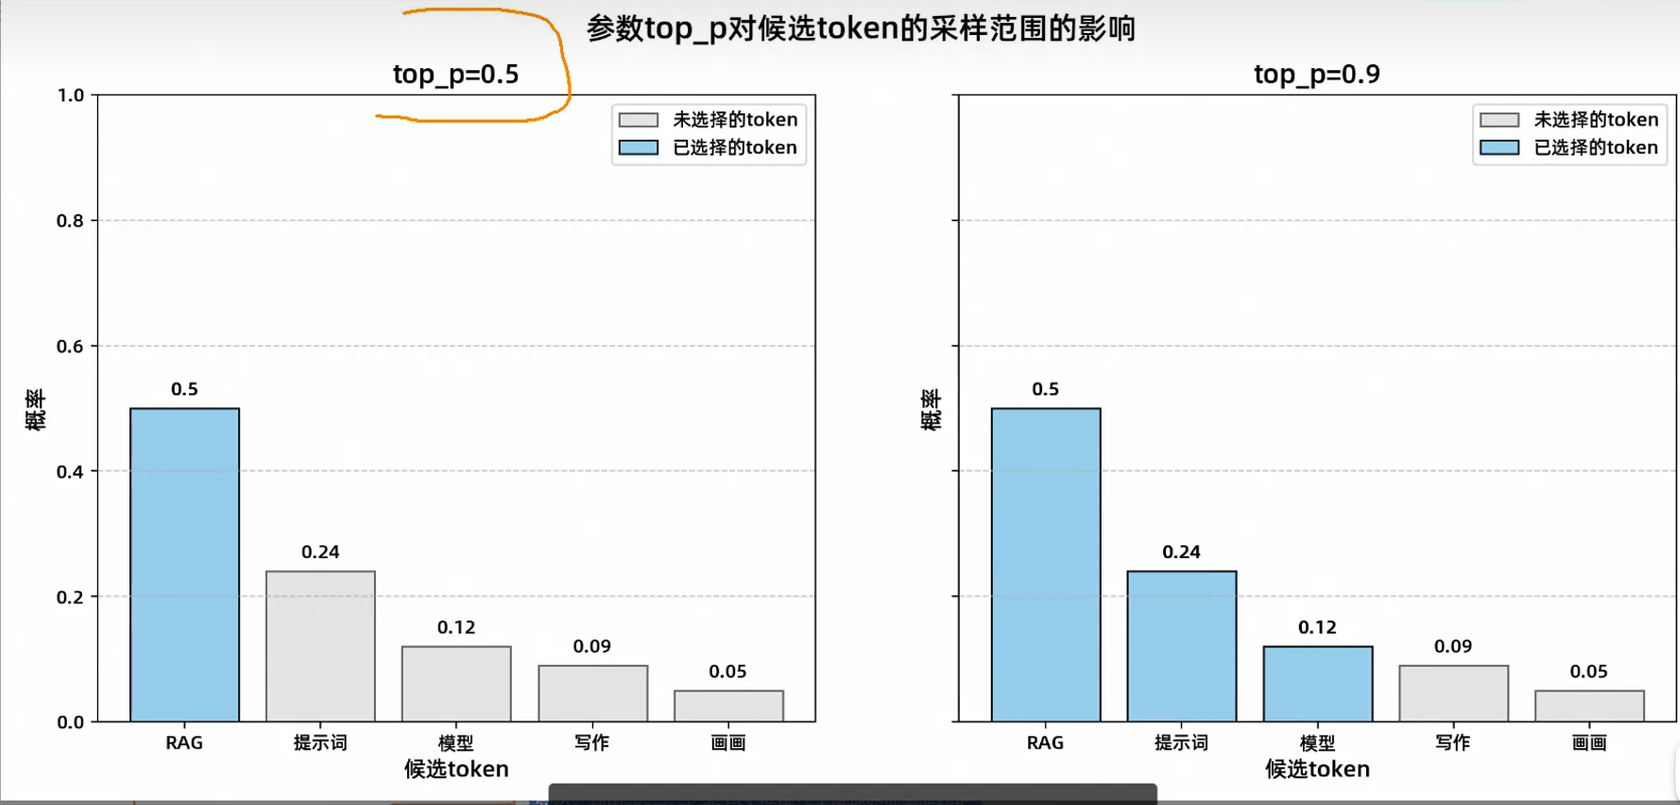
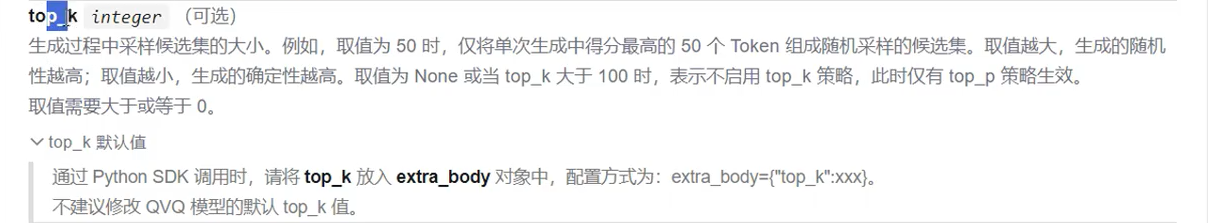
在Spring AI Alibaba中调优通义千问(Qwen)模型的参数,需结合业务场景灵活调整核心参数(如Temperature、Top-P、Top-K等),并利用框架特性实现性能优化。以下从原理到实践的系统指南:
一、核心调优参数解析
| 参数 | 作用机制 | 建议范围 | 适用场景 |
|---|---|---|---|
| Temperature | 缩放输出概率分布的熵值:低值(0.1-0.5) 增强确定性;高值(0.7-1.0) 提升创造性 | 0.3-0.8 | 客服问答(低)、创意文案(高) |
| Top-P | 动态截断候选词:仅保留累积概率达阈值的词(例:Top-P=0.9 保留90%概率质量的词) | 0.7-0.95 | 需平衡多样性与相关性 |
| Top-K | 固定候选词数量:仅考虑概率前K高的词(例:Top-K=50 保留50个最可能词) | 30-100 | 限制生僻词,提升输出稳定性 |
| Max Tokens | 限制生成长度:防止过长响应导致资源浪费 | 100-500 | 根据业务需求动态调整 |
| Frequency Penalty | 惩罚重复词汇:正值降低重复词概率,负值增加重复概率 | -0.5~1.0 | 文案生成(正值)、关键词强调(负值) |
参数协同示例:
客服场景需严谨回答 →Temperature=0.3, Top-P=0.7, Max Tokens=200
广告文案需创意发散 →Temperature=0.8, Top-P=0.9, Frequency Penalty=0.5
二、Spring AI Alibaba 配置实践
1. YAML 参数配置示例
spring:
  ai:
    alibaba:
      qwen:
        api-key: sk-xxx
        chat:
          options:
            model: qwen-max-latest    # 指定模型版本[citation:3]
            temperature: 0.5
            top-p: 0.8
            max-tokens: 300
2. Java 代码动态调参
// 注入参数配置
DashScopeChatOptions options = DashScopeChatOptions.builder()
    .withTemperature(0.7)
    .withTopP(0.9)
    .withMaxTokens(150)
    .build();

// 发起请求
ChatResponse response = chatModel.call(
    new Prompt("生成电商促销文案", options) // 绑定动态参数[citation:8]
);
三、场景化调优策略
1. 智能客服(高准确性需求)
- 参数组合:
Temperature=0.3, Top-P=0.7, Frequency Penalty=0.2 - 效果:减少无关发散,避免重复话术,输出简洁精准
- 代码适配:通过
Function Calling对接订单查询API,严格限制输出格式
2. 内容创作(高多样性需求)
- 参数组合:
Temperature=0.8, Top-K=50, Presence Penalty=-0.3 - 效果:激发新颖表达,允许关键词重复强化(如广告标语)
- 工具集成:结合
ImageModel生成文案配图,实现多模态输出
3. 数据分析报告(结构化输出)
- 参数组合:
Temperature=0.4, Top-P=0.6, Max Tokens=500 - 技术扩展:启用
结构化输出,将文本映射为JSON/XML格式
四、进阶调优技巧
-
RAG 增强检索
- 注入向量化知识库(如商品数据库),提升回答准确性
- 配置
HNSW索引+GPU加速,将检索延迟控制在500ms内
-
动态参数切换
- 基于用户画像实时调整参数:
double temp = user.isVip() ? 0.7 : 0.4; // VIP用户允许更高创造性
options.setTemperature(temp);
- 基于用户画像实时调整参数:
-
流式响应优化
- 启用
stream=true分块输出,结合背压控制降低首字节延迟 - 示例配置:
spring:
  ai:
    alibaba:
      qwen:
        chat:
          options:
            stream: true
- 启用
五、调优避坑指南
| 问题现象 | 根因分析 | 解决方案 |
|---|---|---|
| 输出无关内容(如“火星番茄”) | Temperature过高(>1.0) | 降至0.8以下,配合Top-P=0.9约束 |
| 回答机械重复 | Frequency Penalty过高 | 调整至负值(如-0.2)允许合理重复 |
| 长文本中途截断 | Max Tokens设置过小 | 根据业务需求增量测试(建议步长50) |
| 响应延迟显著 | 未启用流式/缓存 | 开启流式传输,对高频请求结果缓存 |
企业级建议:
- 通过
阿里云AI网关(Higress)实现参数热更新,避免服务重启- 使用
Prometheus+Grafana监控Token消耗与响应延迟
通过上述方法,开发者可精准平衡通义千问模型的可控性与创造性,在电商、客服、内容生成等场景最大化业务价值。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)