OM-1:前沿机器人智能,直接向人类学习
26年9月来自创业公司Reward AI的博客文章“OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans”:https://www.rewardai.com/blog/OM-1/。
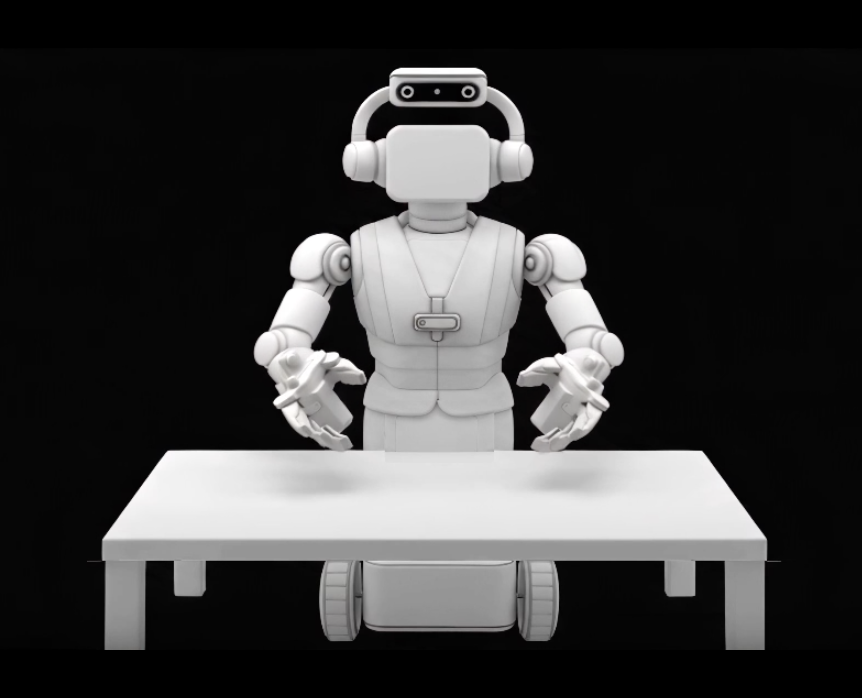
这篇博客介绍了 Reward AI 的机器人系统 Omnibody 和核心模型 OM-1。核心思路是:直接从人类自然操作中学习,再让同一个策略模型控制不同机器人。
主要有四个要点:
用可穿戴设备采集示范。 Omnibody Hand 采用 7 自由度设计,记录人的抓握和操作,尽量保留自然动作,无需人去适应某台机器人的结构。
记录的不只是画面。 系统融合视觉、触觉、接近感知、手部轨迹和力信息;各传感器保持原生采样频率,保留快速接触与动作细节。
一个模型跨机器人使用。 官方称 OM-1 策略仅用人类示范学习,不需要遥操作或机器人实机训练数据,可以用于机械臂和人形机器人。
控制层负责可靠执行。 底层控制器通过仿真强化学习训练,处理负载、扰动和延迟,并在模型推理期间持续运行,让动作保持连贯。
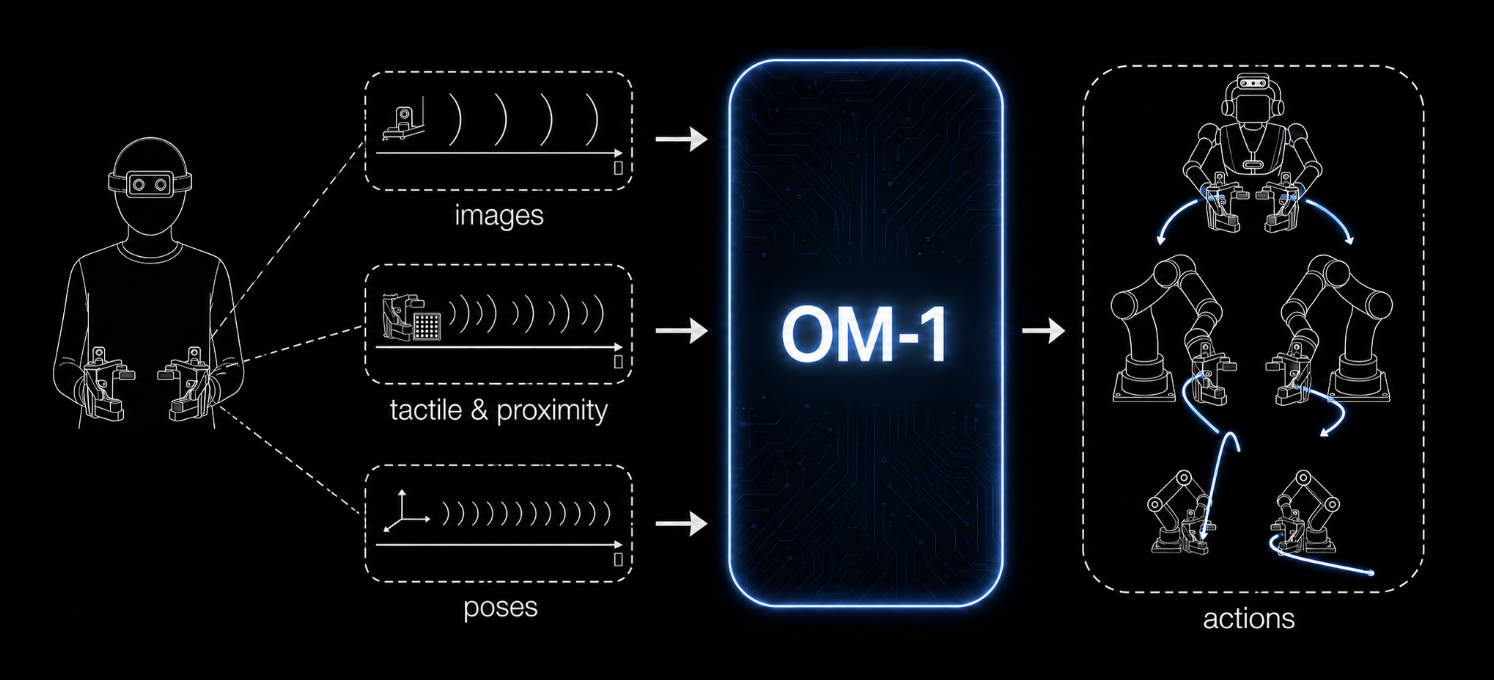
文章给出的关键结果是:加入电磁感知后,高速追踪的平均过冲误差降低约 60%;官方还称,新任务只需 不到 30 分钟的示范数据即可学会。
它的重点在于把数据采集、模型学习和机器人控制一起设计,降低为每种机器人重新采集数据的成本。不过,这篇更偏系统发布介绍,缺少完整基准、成功率和训练规模披露;“跨机器人泛化”等能力的适用范围还需要更多实验验证。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献437条内容

所有评论(0)