【World Model】(Arxiv2601)LingBot-VLA:A Pragmatic VLA Foundation Model
【World Model】(Arxiv2601)LingBot-VLA:A Pragmatic VLA Foundation Model
一、论文简介 🌟
1.1 论文方法一图总结
1.2 基本信息
- 📖 题目:A Pragmatic VLA Foundation Model
- 🏫 单位: ANT Group
- 🌍 主页:https://technology.robbyant.com/lingbot-vla
- 🀄️ 论文摘要:一个具备强大能力的视觉—语言—动作(VLA)基础模型,有望在确保成本效益(例如,适配所需的数据和 GPU 小时数)的同时,可靠地泛化到不同任务和机器人平台。为此,论文开发了 LingBot-VLA,使用来自 9 种常见双臂机器人配置的约 20,000 小时真实世界数据进行训练。通过在 4 种机器人平台上开展系统评估,每个平台完成 100 项任务,且每项任务使用 130 个后训练回合,论文表明,该模型明显优于竞争方法,展现出出色的性能和广泛的泛化能力。论文还构建了高效的代码库,在使用 8 块 GPU 的训练配置下实现每秒 261 个样本的吞吐量;与现有面向 VLA 的代码库相比,速度提升了 1.5 至 2.8 倍(具体取决于所采用的 VLM 基础模型)。上述特点使该模型适用于真实世界部署。为推动机器人学习领域的发展,论文开放提供代码、基础模型和基准数据,旨在支持更具挑战性的任务,并促进可靠的评估标准。
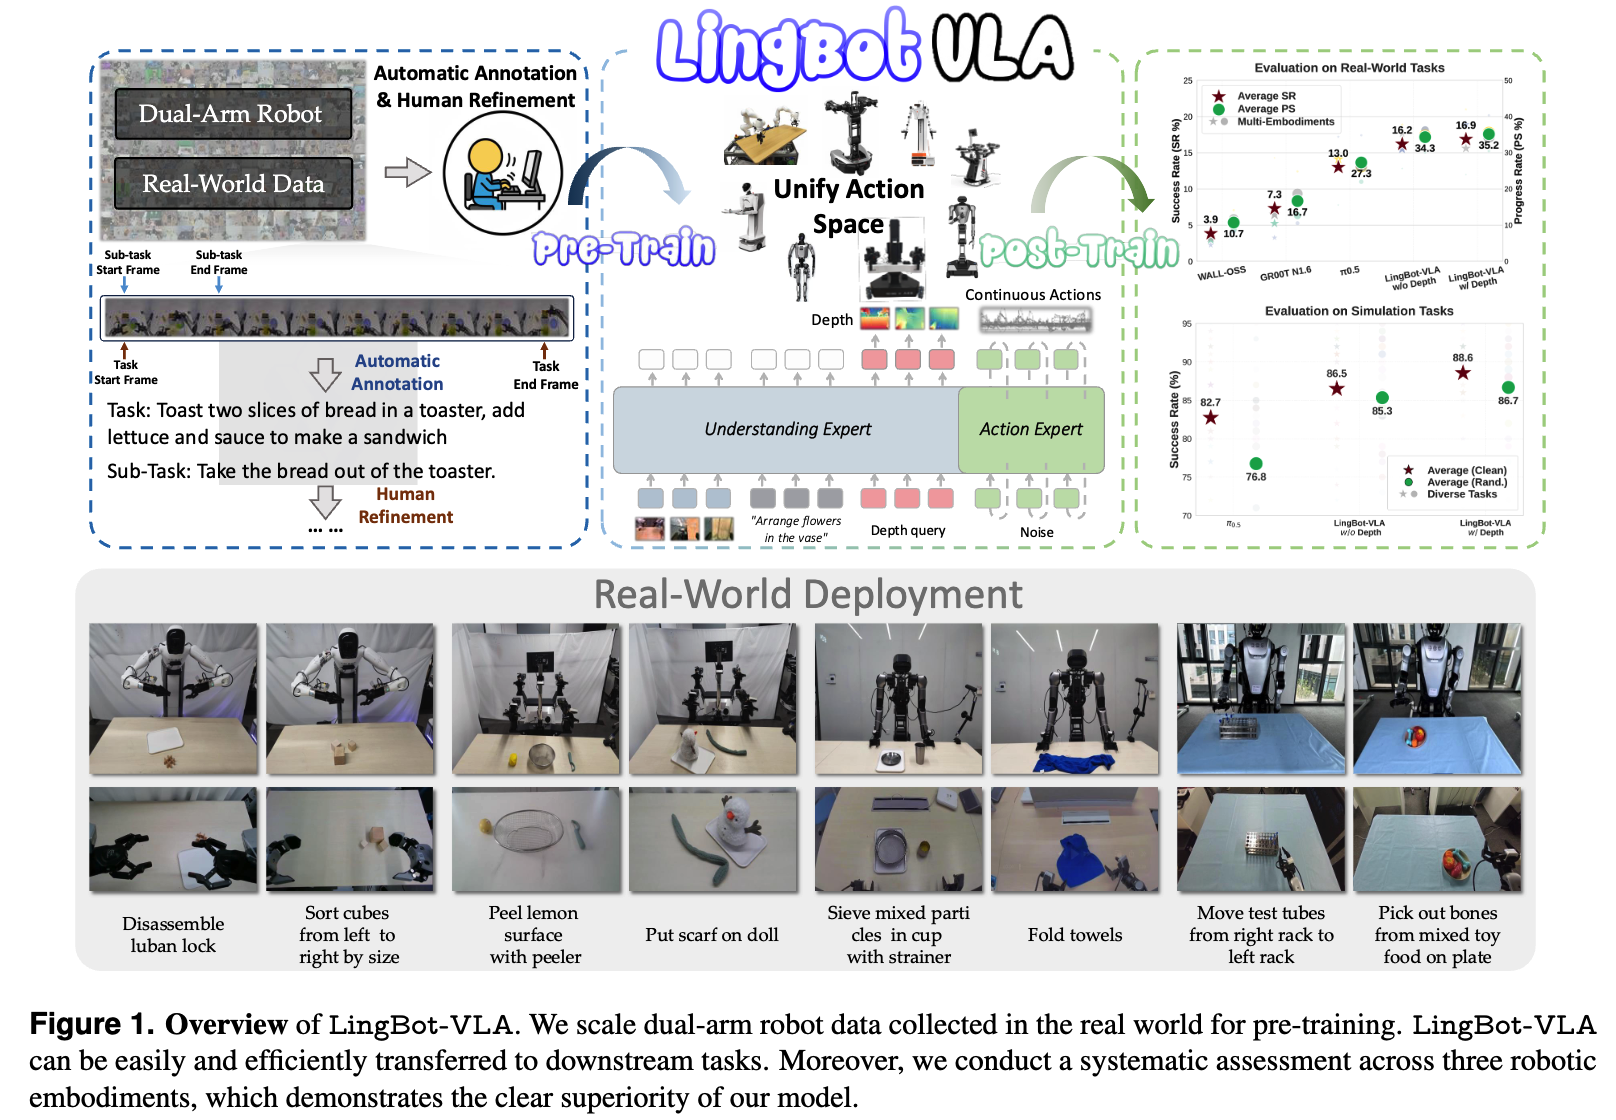
1.3 论文引言 & 主要贡献
视觉—语言—动作(VLA)基础模型已成为一种很有前景的方法,可使机器人根据自然语言指令执行多种操作任务。通过大规模预训练,这些模型能够获得通用技能,并快速适配不同任务和机器人平台。尽管该领域已取得显著进展,但关于真实机器人性能如何随着预训练数据集规模不断扩大而变化,目前仍缺乏全面的实证研究。此外,学界也缺少能够高效处理海量数据、支持大规模扩展评估的训练代码库。因此,在真实场景中,一个亟待研究的根本问题是:VLA 模型在海量真实世界机器人数据上究竟如何扩展?
了解 VLA 模型的扩展规律,对机器人学习至关重要,尤其是在面对规模庞大且多样化的真实世界数据集时。论文对预训练数据量和多样性变化下的 VLA 性能扩展情况进行了系统的实证研究。将预训练数据从 3,000 小时增加到 20,000 小时后,论文发现下游任务成功率持续且显著提升。值得注意的是,即使数据规模达到 20,000 小时,性能提升也未显现饱和迹象,这表明增加数据量仍能持续改善 VLA 性能。这些结果为真实世界机器人学习具有良好的扩展特性提供了首批实证证据,并为未来 VLA 的发展和大规模数据整理提供了重要见解。
扩展分析揭示了性能随规模增长的有利趋势,但要将这些发现转化为可靠且可部署的系统,还需要在真实机器人平台上开展严格的大规模评估。得益于 GM-100 提供的 100 项精心设计的任务,论文在 4 种机器人平台上进行了系统评估;每种机器人构型的每项任务均进行了 130 个回合。通过强调任务多样性和跨平台的一致性,论文的评估框架为可靠的 VLA 基准测试提供了一种新的标准选择。
论文提出了 LingBot-VLA,这是一种实用型 VLA 基础模型,使用来自 9 种机器人平台的约 20,000 小时真实世界操作数据进行训练。论文在这一综合基准上开展系统评估,结果表明,该模型相较于现有方法实现了最先进的性能,并具备出色的泛化能力。除模型能力外,论文还强调,大规模机器人学习需要高计算效率。为此,论文开发了经过优化的代码库,在 8 卡集群上实现每秒 261 个样本的吞吐量。这一效率提升大幅缩短了训练周期并降低计算开销,从而减少总体成本。凭借优异的性能、广泛的泛化能力和高计算效率,LingBot-VLA 适用于真实世界的机器人应用。为推动社区发展,论文开放提供代码、基础模型和基准数据,旨在支持更具挑战性的任务,并促进可靠的评估标准。
1.4 相关工作
1️⃣ 视觉—语言—动作模型(Vision-Language-Action Models)
VLA 基础模型。视觉—语言—动作基础模型通常采用强大的预训练视觉—语言模型作为语义骨干网络,并搭配基于扩散的动作头。近期的 VLA 基础模型在更大规模、更多样化的数据集上进行预训练后,展现出更强的多任务执行能力和多机器人构型适配能力。与此前 VLA 基础模型所使用的数据集不同,论文的模型在一个规模庞大的多机器人构型数据集上进行预训练,该数据集约包含 20,000 小时的数据。该数据集具有丰富的行为多样性,显著增强了模型在各类机器人操作任务中的泛化能力。
空间 VLA。传统 VLA 模型在语义理解方面表现出色,但在复杂空间操作所需的精确几何推理和深度感知方面往往存在困难。为解决这一问题,一些研究将空间表征融入 VLA 框架。部分研究致力于增强视觉—语言模型在具身场景中的空间感知能力,以提升 VLA 在下游任务中的空间操作能力;另一些研究则在 VLA 训练过程中显式或隐式地引入深度信息。Spatial Forcing 采用简洁的对齐策略,促使 VLA 视觉嵌入与空间表征相融合,从而显著提升模型的空间理解能力。
2️⃣ 机器人策略评估(Evaluation on Robot Policy)
当前机器人策略的评估方法主要分为两类:基于仿真的评估和基于真实世界机器人平台的评估。仿真基准能够快速、便捷地评估策略能力,并以较低成本,在大规模并行条件下测试多种多样的交互场景。尽管仿真环境通常采用理想化的物理模型,但其结果往往不能充分反映真实物理世界的复杂性。另一方面,真实世界评估的效率通常受限于对大量并行硬件的需求。因此,此前大多数 VLA 研究仅比较少数几种方法,并且只涉及少量任务。为更全面地评估策略在真实世界中的性能,论文在三个不同的机器人平台上开展评估,每个平台执行 100 项任务。论文还对主流 VLA 模型如何适应真实场景中的多样性进行了全面分析。
3️⃣ 高效 VLA 训练(Efficient VLA Training)
VLA 模型的快速迭代推动了专用训练基础设施的发展。近年来,社区涌现出多个设计完善的开源代码库,分别服务于不同的研究需求。例如,OpenPI 仓库提供了一个通用框架,支持使用 JAX 和 PyTorch 训练 π 系列模型。StarVLA 提供模块化且易于使用的代码库,专门针对 VLA 与 VLM 的协同训练进行了优化,旨在促进语义知识向机器人控制的迁移。此外,Dexbotic 致力于提供统一且高效的解决方案,以简化 VLA 的开发流程,并重点规范从数据导入到模型部署的整个流程。
尽管已有这些进展,在多节点集群上训练大规模 VLA 模型仍面临重大挑战,原因在于数据输入/输出瓶颈和通信开销。为此,论文提出了一个面向大规模 VLA 训练的高性能开源代码库。与现有框架不同,论文的代码库在数据加载、分布式训练策略和算子级加速方面进行了系统性优化。这些改进全面提升了训练吞吐量和可扩展性,为社区探索机器人基础模型的扩展极限提供了更高效的基础。
二、方法论 🍀
2.1 预训练数据集(Pre-training Dataset)
2.1.1 数据采集(Data Collection)
预训练数据集基于使用 9 种常见双臂机器人构型在大规模真实世界中采集的遥操作数据构建,如图 2 所示。以下介绍这些机器人构型。
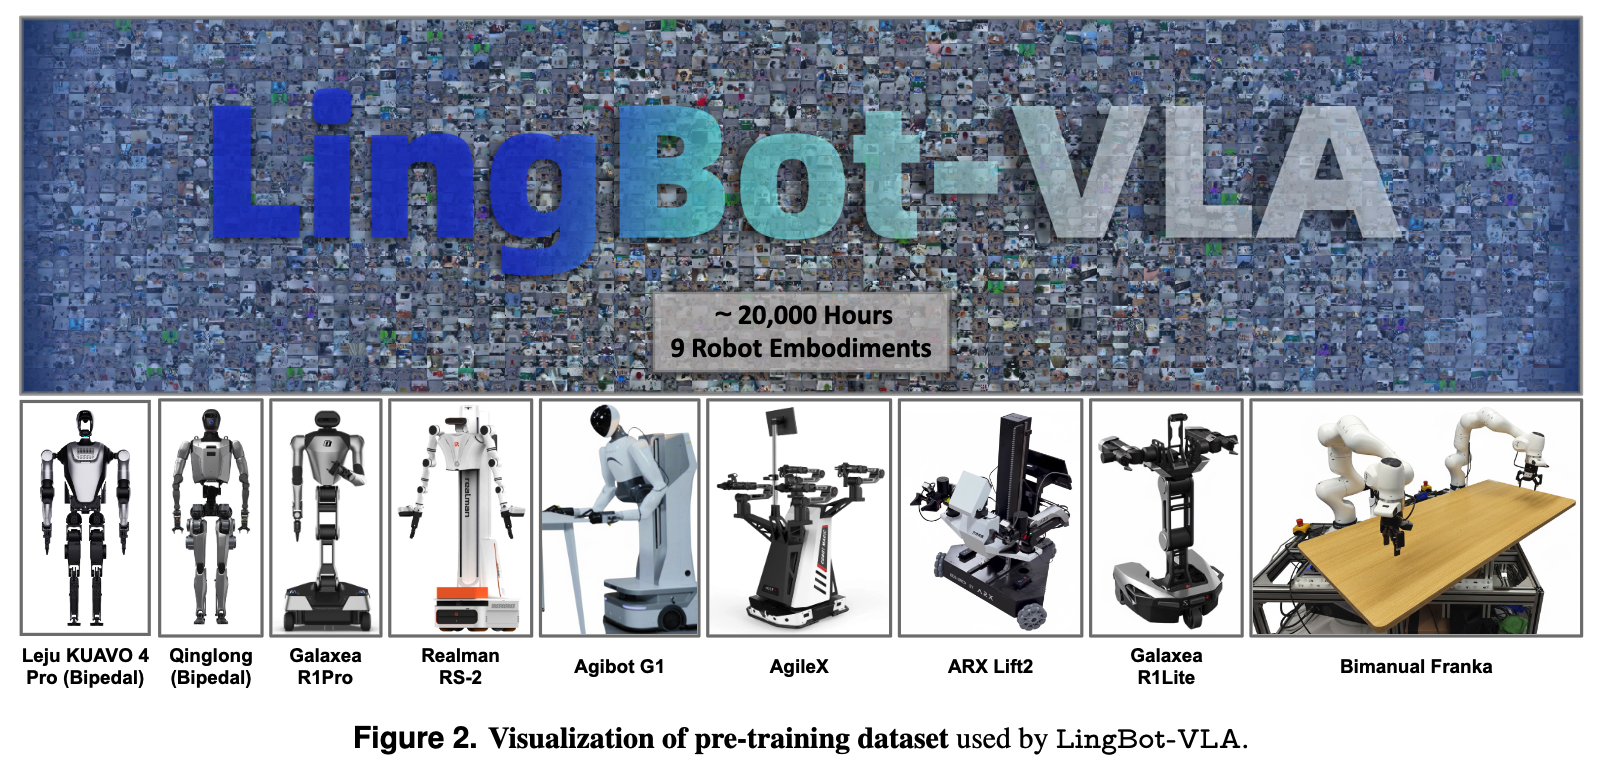
- AgiBot G1。该配置包含两条 7 自由度机械臂和三台 RGB-D 相机。机器人数据通过该配置上的 VR 遥操作采集。
- AgileX。该配置配备三台相机和两条 6 自由度机械臂。数据采集过程中使用同构机械臂进行机器人控制。
- Galaxea R1Lite。该配置包含两条 6 自由度机械臂、一台双目相机和两台腕部相机。
- Galaxea R1Pro。该配置使用两条 7 自由度机械臂、一台双目相机和两台腕部相机。
- Realman RS-02。该配置使用三台相机,具有 16 维配置空间和动作空间:两条 7 自由度机械臂和两个平行夹爪。
- Leju KUAVO 4 Pro。这是一款双足人形机器人,配备两条 7 自由度机械臂、两个平行夹爪、一台头部相机和两台腕部相机。
- 青龙。这是一款人形机器人,配备两条 7 自由度机械臂和三台相机:一台头部相机,以及左右腕部各一台相机。
- ARX Lift2。该配置使用三台相机和两条 6 自由度机械臂。
- 双臂 Franka。该配置使用两条 7 自由度机械臂和两个平行夹爪,构成 16 维动作空间,并配备三台相机。
2.1.2 数据标注(Data Labeling)
为获得准确的语言指令,论文进行了以下标注工作。
-
(1)视频分段。人工标注人员根据预先定义的原子动作,对机器人从多个视角拍摄的视频进行联合分段。为减少视频中的冗余信息,此阶段会移除视频开头和结尾的静止画面。
-
(2)指令标注。获取包含机器人完整运动轨迹的视频,以及对应各个原子动作的视频片段后,论文使用 Qwen3-VL-235B-A22B 对任务和子任务指令进行精确标注,如图 1 所示。
2.2 模型训练(Model Training)
2.2.1 模型架构(Architecture)
为利用经过充分训练的视觉—语言表征,LingBot-VLA 将预训练视觉—语言模型(即 Qwen2.5-VL)与一个初始化的动作生成模块(称为“动作专家”)相结合。这些组件通过 Mixture-of-Transformers(MoT)架构组织,类似于 BAGEL:视觉—语言模态和动作模态分别经由不同的 Transformer 路径处理,并通过共享的自注意力机制进行逐层联合序列建模。MoT 架构使视觉—语言模型中的高维语义先验能够在各层持续提供引导,同时通过保留各模态的专属处理路径,减少跨模态干扰。LingBot-VLA 的架构如图 1 所示。多视角操作图像和相关任务指令由视觉—语言模型统一编码,为后续动作生成提供多模态条件。同时,机器人的本体感知序列,具体包括初始状态和动作块,被输入动作专家,以预测动作。论文采用 Flow Matching 对连续动作进行建模,从而实现流畅、平滑的机器人控制,确保模型能够在复杂任务和多种机器人上实现高精度执行。
在 LingBot-VLA 中,视觉—语言模型与动作专家通过共享的自注意力机制进行交互,实现统一的逐层表征。因此,时间戳 t t t 处的联合建模序列由观测条件 O t O_t Ot 与动作块 A t A_t At 拼接而成。具体而言,观测上下文定义为:
O t = [ I t 1 , I t 2 , I t 3 , T t , s t ] , (1) O_t = [I_t^1, I_t^2, I_t^3, T_t, s_t], \tag{1} Ot=[It1,It2,It3,Tt,st],(1)
其中包含双臂机器人三视角操作图像 I t 1 , 2 , 3 I_t^{1,2,3} It1,2,3 的标记、任务指令 T t T_t Tt 和机器人状态 s t s_t st。相应的动作序列表示为:
A t = [ a t , a t + 1 , … , a t + T − 1 ] , (2) A_t = [a_t, a_{t+1}, \ldots, a_{t+T-1}], \tag{2} At=[at,at+1,…,at+T−1],(2)
其中 T T T 表示动作块的长度,即预测轨迹的时间范围;在预训练阶段,该值设为 50。因此,训练目标是通过条件流匹配来刻画条件分布 p ( A t ∣ O t ) p(A_t \mid O_t) p(At∣Ot)。对于流时间步 s ∈ [ 0 , 1 ] s \in [0,1] s∈[0,1],论文通过在高斯噪声 ϵ ∼ N ( 0 , I ) \epsilon \sim \mathcal{N}(0,I) ϵ∼N(0,I) 与真实动作 A t A_t At 之间进行线性插值,定义概率路径,得到中间动作:
A t , s = s A t + ( 1 − s ) ϵ . A_{t,s} = sA_t + (1-s)\epsilon. At,s=sAt+(1−s)ϵ.
A t , s A_{t,s} At,s 的条件分布定义为:
p ( A t , s ∣ A t ) = N ( s A t , ( 1 − s ) I ) . (3) p(A_{t,s} \mid A_t) = \mathcal{N}(sA_t, (1-s)I). \tag{3} p(At,s∣At)=N(sAt,(1−s)I).(3)
遵循 π 0 \pi_0 π0 的做法,动作专家 v θ v_\theta vθ 通过最小化流匹配目标来学习预测条件向量场:
L F M = E s ∼ U [ 0 , 1 ] , A t , ϵ ∥ v θ ( A t , s , O t , s ) − ( A t − ϵ ) ∥ 2 , (4) \mathcal{L}_{\mathrm{FM}}= \mathbb{E}_{s \sim U[0,1], A_t, \epsilon} \left\| v_\theta(A_{t,s}, O_t, s) - (A_t - \epsilon) \right\|^2, \tag{4} LFM=Es∼U[0,1],At,ϵ∥vθ(At,s,Ot,s)−(At−ϵ)∥2,(4)
其中,目标速度由线性概率路径推导得到,为理想向量场 A t − ϵ A_t - \epsilon At−ϵ。
论文遵循 π 0 \pi_0 π0 的方法,采用分块因果注意力来建模联合序列 [ O t , A t ] [O_t, A_t] [Ot,At]。该序列可划分为三个功能块: [ I t 1 , I t 2 , I t 3 , T t ] [I_t^1, I_t^2, I_t^3, T_t] [It1,It2,It3,Tt]、 [ s t ] [s_t] [st] 和 [ a t , a t + 1 , … , a t + T − 1 ] [a_t, a_{t+1}, \ldots, a_{t+T-1}] [at,at+1,…,at+T−1]。这些块之间应用因果掩码,使每个块中的标记只能关注自身及此前的块。相反,同一块内的所有标记采用双向注意力,可以彼此关注。这种配置使动作专家能够利用所有可用的观测信息,同时防止未来动作标记的信息泄漏到当前观测表征中。为显式捕捉操作环境中的空间信息,并进一步提升机器人执行的稳健性,论文采用受近期研究启发的视觉蒸馏方法。具体而言,论文为三视角操作图像使用可学习查询 [ Q t 1 , Q t 2 , Q t 3 ] [Q_t^1, Q_t^2, Q_t^3] [Qt1,Qt2,Qt3]。为整合深度信息,这些查询由视觉—语言模型处理,随后与 LingBot-Depth 的深度标记 [ D t 1 , D t 2 , D t 3 ] [D_t^1, D_t^2, D_t^3] [Dt1,Dt2,Dt3] 对齐。论文通过最小化蒸馏损失 L d i s t i l l \mathcal{L}_{\mathrm{distill}} Ldistill,对齐视觉—语言模型的可学习查询和 LingBot-Depth 标记:
L d i s t i l l = E Q t ∣ Proj ( Q t ) − D t ∣ , (5) \mathcal{L}_{\mathrm{distill}}= \mathbb{E}_{Q_t} \left| \operatorname{Proj}(Q_t) - D_t \right|, \tag{5} Ldistill=EQt∣Proj(Qt)−Dt∣,(5)
其中, Proj ( ⋅ ) \operatorname{Proj}(\cdot) Proj(⋅) 是一个投影层,通过交叉注意力实现维度对齐。这种整合将几何信息注入 LingBot-VLA,使模型能够精准感知复杂操作任务所需的信息。
2.2.2 训练效率优化(Training Efficiency Optimization)
由于动作数据具有天然的高频特性,建立涵盖分布式训练和算子优化的高效流水线至关重要。论文的优化方法包括以下方面。
分布式策略:尽管 VLA 模型的参数规模通常适中,在 GPU 显存占用与训练吞吐量之间实现最佳权衡仍然十分重要。论文采用全分片数据并行(FSDP),这是一种高效的 PyTorch 零冗余优化器(ZeRO)实现,对优化器状态、模型参数和梯度进行分片,从而最大限度地减少显存占用。受 VeOmni 提出的混合分片数据并行(HSDP)方法启发,论文仅针对动作专家模块构建特定的“分片组”。这一策略有效降低了过度参数分片所带来的通信开销。此外,论文采用混合精度策略:使用 torch.float32 执行归约,以确保数值稳定性;同时使用 torch.bfloat16 进行存储和通信。
算子级优化:模型中的视觉、语言和动作多模态融合,本质上是一个稀疏注意力过程。为此,论文采用 FlexAttention 优化计算。此外,论文还通过 torch.compile 实施算子融合,以减少内核启动开销并最大限度地提高内存带宽利用率。
2.3 结论
论文提出了 LingBot-VLA,这是一种基础模型,借助大规模真实世界数据和经过优化的代码库,实现了出色的泛化能力和训练效率。论文在 100 项任务上开展的全面评估表明,该模型明显优于竞争方法,展现出强大的性能和广泛的泛化能力。为促进开放科学,论文开放发布代码、模型和基准数据。未来研究将着重通过整合单臂机器人和移动机器人数据,进一步拓展模型的多功能性,从而实现更丰富的移动操作能力,并适用于不受约束的环境。
三、论文实验部分 🧪
3.1 实施细节
论文开展了大规模实证评估,以严格考察 LingBot-VLA 的多机器人构型泛化能力和真实世界稳健性。实验框架包括三个核心部分:(1)覆盖 4 种不同商业平台的 25 台实体机器人;(2)GM-100 基准,包含 100 项多样化操作任务和 39,000 条专家演示;(3)在相同训练和测试条件下,对 LingBot-VLA 与三种先进基线模型进行比较,共开展 22,500 次试验。
硬件平台。论文在 4 种不同的机器人平台上开展实验:AgileX、Agibot G1、Galaxea R1Pro 和 Leju KUAVO 4 Pro。这些机器人均采用双臂配置,并配有平行夹爪。为确保可靠的感知能力,每台机器人均配备多台相机:两台腕部相机和一台头部相机,用于捕捉类似人类视角的第一人称画面。所有任务均在桌面环境中进行,机器人底盘和腰部固定不动。
数据采集与处理。对于 GM-100 中的每项任务,论文按照标准化流程通过遥操作采集专家演示,以确保数据质量并覆盖多样化环境。
- 轨迹数量:在三个平台上,每项任务采集 150 条原始轨迹。根据执行质量对轨迹进行排序,评估标准包括任务完成情况、运动平滑度和对操作规范的遵守情况;最终保留排名前 130 的轨迹用于训练。所有轨迹均严格遵循 GM-100 的任务规范。
- 标准化物体:任务物体按照 GM-100 的材料规范进行标准化,并据此采购,以确保不同采集地点之间的可复现性。
- 环境多样性:每条轨迹都会随机改变工作空间内物体的位置和朝向,以避免过拟合特定空间配置,并促进模型学习与任务相关的不变性。
- 遥操作指南(Teleoperation Guidelines):(1)保持末端执行器与工作空间表面之间的间距,避免发生碰撞;(2)在物体接触阶段降低速度,以实现平稳操作;(3)确保每个回合开始和结束时的图像观测清晰且彼此不同,以便可靠地训练策略。
- 自动筛选:通过算法筛查流程自动剔除存在技术异常的回合。人工审核:审核人员使用同步的多视角视频流对筛选后的数据进行验证。若回合中出现无关物体或偏离任务规范,则予以剔除。
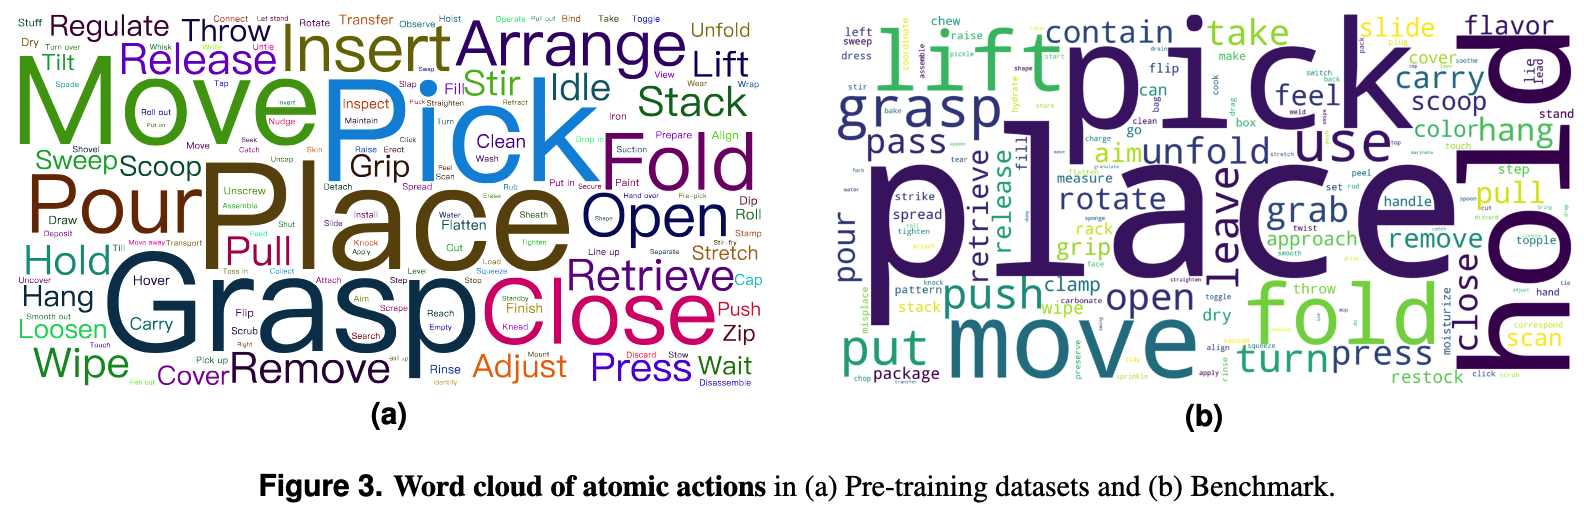
为分析原子动作类别的语义分布和多样性,论文使用词云可视化训练集和测试集中出现频率最高的原子动作,如图 3(a) 和图 3(b) 所示。定量分析表明,测试集中约 50% 的原子动作未出现在训练集中最常见的 100 种动作之列。这一显著差异体现了测试集的多样性,也使模型泛化能力的评估更具挑战性。
基准测试与评估方案。论文在严格的实验控制条件下,将 LingBot-VLA 与三种先进的 VLA 模型进行系统比较:π0.5、GR00T N1.6 和 WALL-OSS,以隔离架构本身带来的性能差异。
- 标准化训练:所有模型均从公开可用的预训练检查点开始,使用相同的后训练流程进行微调。所有模型均使用相同的验证数据集(每项任务 130 条筛选后的轨迹)和一致的超参数(即批大小为 256、训练轮数为 20),以确保比较公平。
- 严格匹配机器人与任务:为消除硬件引起的差异,评估使用数据采集时所用的同一台机器人。所有模型均按照随机顺序,在相同的机器人—任务组合上依次测试。例如,在“堆叠碗”任务中,所有模型均在 AgileX、Agibot G1 和 Galaxea R1Pro 平台上的同一台机器人上进行评估。
- 受控评估设置:测试条件遵循标准化规范,与数据采集流程保持一致;在维持任务要求不变的同时,随机改变物体的位置和朝向。这样可以确保评估的是模型的泛化能力,而非记忆能力。
- 推理与记录:每个模型在每个“任务—机器人”组合上进行 15 次试验,以提高统计稳健性。评估环境保持一致,并以 rosbag 格式记录全面的数据,包括第三人称视角画面、机器人状态和模型预测结果。这些记录将开放发布,以建立可验证的基准测试。
评估指标。论文使用两项指标评估模型性能,分别衡量任务完成情况和部分进展。
- 成功率(SR):在 3 分钟时限内完成任务全部步骤的试验所占比例。该主要指标反映了模型在真实世界部署中的可行性。
- 进度分数(PS):根据顺序子任务检查点的完成情况衡量任务进展。例如,在包含 6 个步骤的“堆叠碗”任务中,若完成前 4 步但在第 5 步失败,则得分为 4 / 6 ≈ 0.67 4/6 \approx 0.67 4/6≈0.67。该诊断性指标有助于识别失败模式,并对部分成功予以奖励。
- 终止条件:出现以下情况之一时,试验即告结束:(1)连续三次子任务失败;(2)发生安全关键事件,例如碰撞。进度分数根据终止前已完成的子任务计算。论文报告了 100 项任务的总体 SR 和 PS,并按机器人类型分平台报告指标,以评估跨机器人构型泛化能力。
论文在仿真环境和真实场景中开展了大量实验,以评估 Motus 的有效性。
论文将 Motus 与若干最先进方法进行比较: π 0.5 \pi^{0.5} π0.5 和 X-VLA。论文在仿真环境中评估所有模型,并进一步在真实任务中评估基线模型 π 0.5 \pi^{0.5} π0.5。论文还将从头训练的模型和仅经过阶段 1 训练的模型与 Motus 进行了比较。
3.2 真实世界基准比较
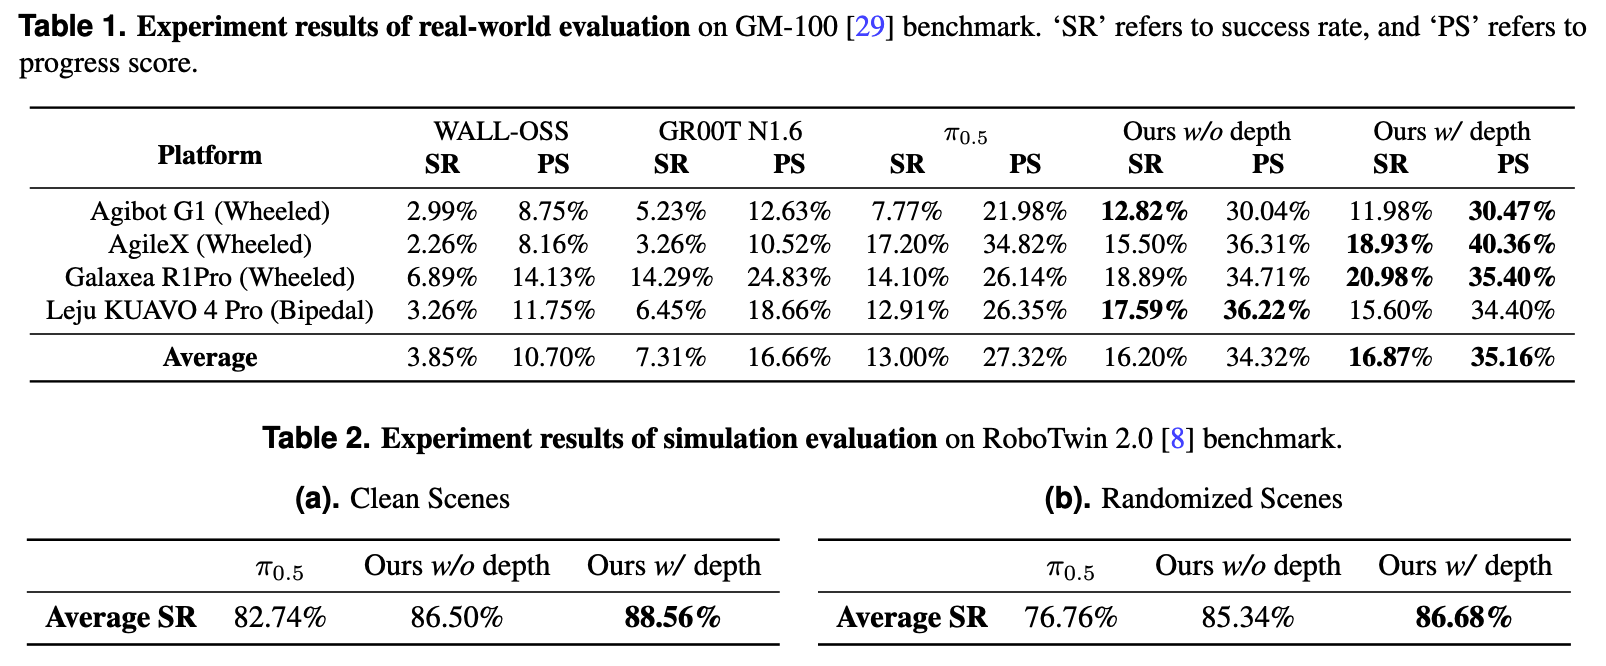
如表 1 所示,论文将两个版本的 LingBot-VLA 与三种强基线模型进行了比较。在所有平台上,无深度信息的 LingBot-VLA 在 SR 和 PS 两项指标上均显著优于 WALL-OSS 和 GR00T N1.6。与 π0.5 相比,整合深度信息后的 LingBot-VLA 在三个机器人构型上的平均 SR 提高了 4.28%,PS 提高了 7.76%。值得注意的是,GR00T N1.6 在 Agibot G1、AgileX 和 Leju KUAVO 4 Pro 平台上的平均表现较好,但在 Galaxea R1Pro 平台上的 SR 和 PS 与 π0.5 相当。这是因为 GR00T N1.6 的预训练数据中包含大量 Galaxea R1Pro 数据,表明当下游任务所用平台与预训练平台在结构上高度相似时,预训练能够显著提升模型性能。完整且详细的测试结果见附录表 S1 至表 S8。
3.3 仿真基准比较
表 2 展示了论文在 RoboTwin 2.0 基准中选取的 50 项代表性操作任务上的仿真评估结果。所有模型均从预训练检查点开始,并在 RoboTwin 数据集上进一步微调。为评估多任务泛化能力,论文在干净场景数据集上使用 2,500 条演示进行训练(每项任务 50 条),并在高度随机化场景数据集上使用 25,000 条演示进行训练(每项任务 500 条)。随机化因素包括背景变化、桌面杂物、桌面高度扰动和不同的光照条件。与 π0.5 基线相比,LingBot-VLA 在 RoboTwin 2.0 多任务设置中取得了显著提升。具体而言,无深度信息的 LingBot-VLA 在干净场景和随机化场景中的成功率分别绝对提高了 3.76% 以上和 8.58%。通过采用基于可学习查询的对齐方法,整合深度信息后的 LingBot-VLA 能够有效提取 LingBot-Depth 模型所提供的丰富空间先验。在干净场景和随机化场景下,该方法相较于基线的成功率分别绝对提高了 5.82% 和 9.92%。各项任务的详细结果见附录表 S9。
3.4 训练吞吐量分析
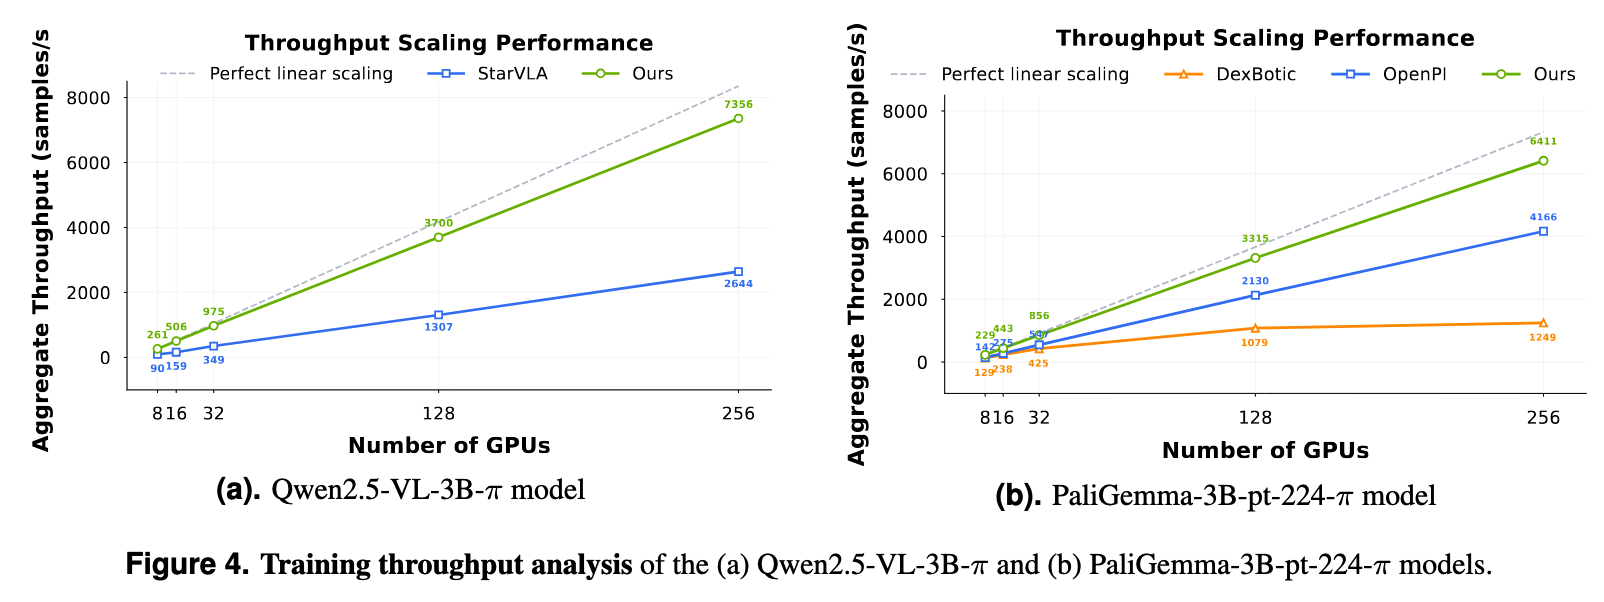
为全面评估不同框架下 VLA 模型的训练效率,论文选取了三个开源代码库作为基线:StarVLA、Dexbotic 和 OpenPI。为确保公平比较,所有实验均在 Libero 数据集上进行,并采用标准化的类 π 模型架构。
鉴于不同代码库中的 VLM 实现存在差异,论文在自身代码库中复现了 Qwen2.5-VL-3B-π 模型和 PaliGemma-3B-pt-224-π 模型,以便与基线进行直接对比。训练配置方面,所有实验的本地批大小均统一设为 32。
需要指出的是,StarVLA 和 Dexbotic 默认采用 ZeRO 进行分布式训练,而论文的代码库采用与之相当的 FSDP2 策略。相比之下,OpenPI 使用 DDP,其通信开销本身较低。论文采用样本吞吐量(样本/秒)作为主要评估指标。
图 4(a) 和图 4(b) 分别展示了 Qwen2.5-VL-3B-π 模型和 PaliGemma-3B-pt-224-π 模型的训练效率比较。结果表明,论文的代码库在两种模型配置下均实现了最快的训练速度。此外,图中还展示了使用 8、16、32、128 和 256 块 GPU 时的训练吞吐量,并与理论线性扩展上限进行了比较。结果显示,论文的方案不仅吞吐量更高,而且扩展效率出色;随着 GPU 数量增加,其性能提升接近理论线性扩展上限。
3.5 消融实验(Ablation Study)
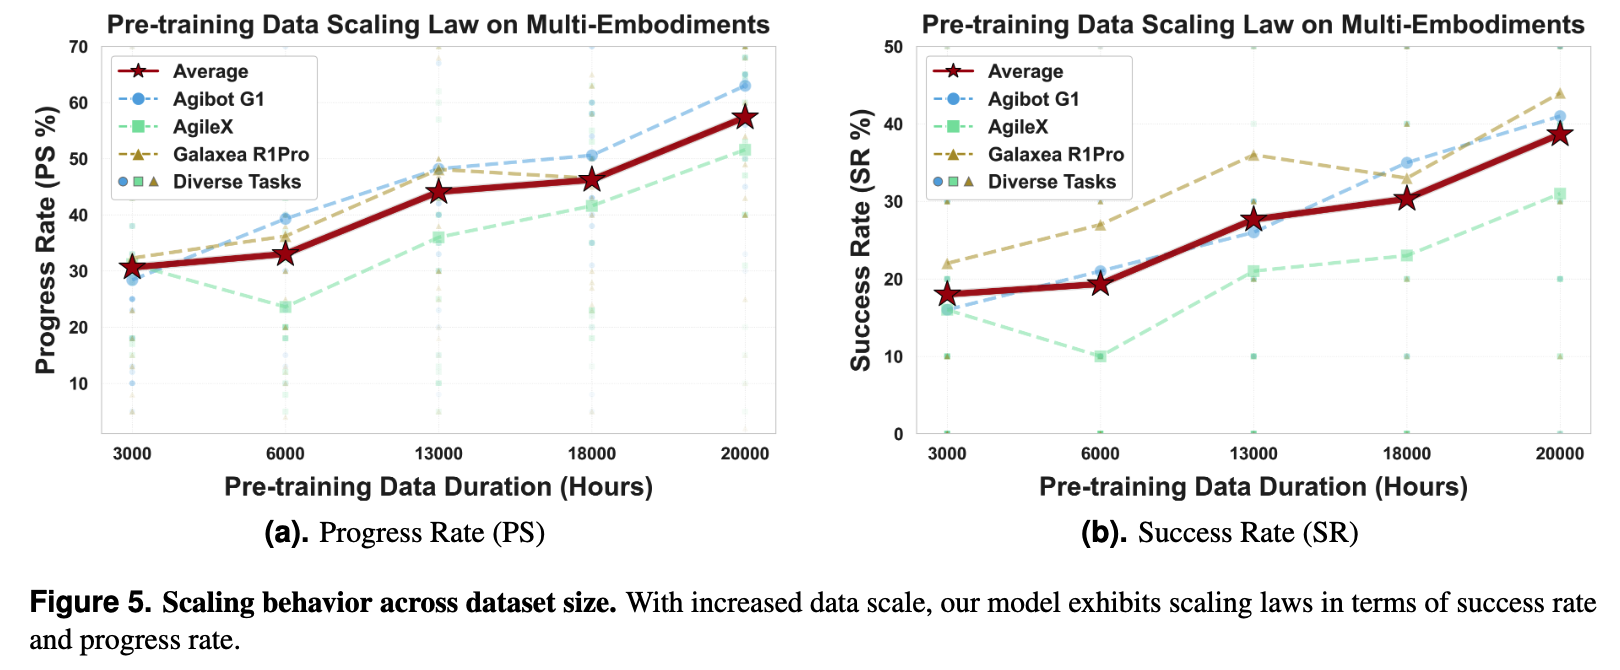
扩展实验。为评估预训练数据的扩展规律,论文从基准测试中选取了 25 项代表性任务进行实验。如图 5(a) 和图 5(b) 所示,随着预训练数据时长从 3,000 小时增加至 20,000 小时,进度率和成功率均呈现持续上升趋势。这表明,扩大真实世界预训练数据规模能够提升模型在不同下游任务和机器人构型上的泛化能力。此外,三个机器人构型(Agibot G1、AgileX 和 Galaxea R1Pro)的单独趋势总体上与整体性能趋势一致,说明观察到的扩展规律具有稳健性,并非特定于单一平台。这些结果验证了扩大真实世界预训练数据规模有助于提升通用策略能力。
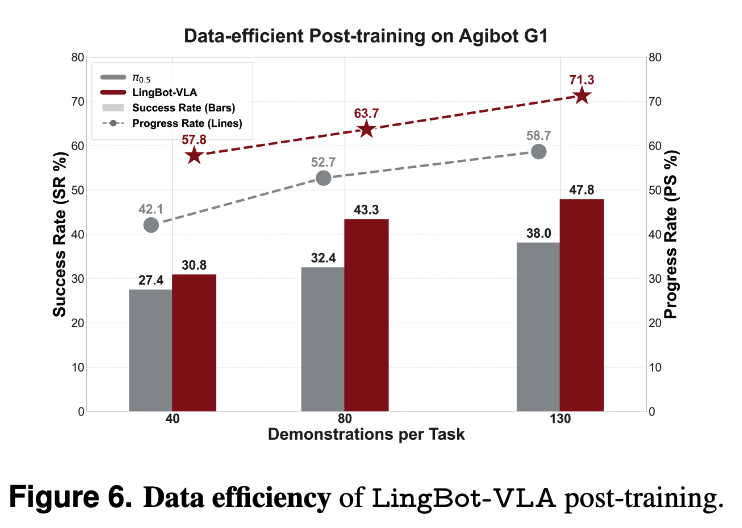
数据效率分析。图 6 展示了 LingBot-VLA 后训练阶段的数据效率。论文遵循大规模真实世界基准测试方案,在 GM-100 数据集中选取 8 项代表性任务,在 Agibot G1 平台上开展数据效率后训练实验。如图 6 所示,每项任务仅使用 80 条演示数据时,LingBot-VLA 在进度分数和成功率两项指标上均优于使用完整 130 条演示数据的 π0.5。值得注意的是,随着后训练数据量增加,LingBot-VLA 与 π0.5 之间的性能差距显著扩大,表明该模型具有更高的数据效率和更强的扩展能力。
四、论文代码解读 💻
待补充。
写在最后
由于笔者🖊️精力有限且本文更多的目的是通过📒博客记录学习过程并分享更多知识,因此文中部分描述不太具体,如有不太理解💫的地方可在评论区👀留言。非特殊赶deadline⏰或假期⛱️期间,笔者会经常上线回复💬。如有不便之处,请海涵~
如果想了解更多关于3DGS的加速⏰压缩⚡️新工作,可以关注笔者的Github仓库:Awesome-3DGS-Compress-Accelerate。
另外,创造不易,转载请注明出处💗💗💗~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)