【ICRA 2026】EPoG:边探索边操作,把「部分已知环境」写进一张可增量修正的场景图|从探索与操作联合规划视角
摘要
本文解读 ICRA 2026 论文《Integrated Exploration and Sequential Manipulation on Scene Graph with LLM-based Situated Replanning》。该论文提出 EPoG,通过融合一张可增量修正的信念图、图编辑距离导出的动作集合与大模型就地重规划,让机器人在部分已知环境里一边探索一边完成长程序贯操作,其特别之处在于探索与操作不再是两个阶段,而是同一张图上的编辑操作。实验表明,在 46 个真实家居场景、5 类长程搬运任务上,EPoG 取得 91.3% 的总成功率,并把探索节点降低 40.0%、移动距离降低 36.1%(相对规则式基线 Exploration+PoG),为部分可观测环境下的移动操作提供了可直接借鉴的规划范式。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Integrated Exploration and Sequential Manipulation on Scene Graph with LLM-based Situated Replanning |
| 标题(中文) | 边探索边操作:把「部分已知环境」写进一张可增量修正的场景图 |
| 作者 | Heqing Yang, Ziyuan Jiao, Shu Wang, Yida Niu, Si Liu, Hangxin Liu |
| 机构 | 北京航空航天大学 · 北京通用人工智能研究院(BIGAI)通用人工智能国家重点实验室 · 加州大学洛杉矶分校 · 北京大学 · ICRA 2026 |
| 会议 | ICRA 2026 |
| arXiv | https://arxiv.org/abs/2602.04419 |
| 项目网站 | https://github.com/buaa-colalab/EPoG |
背景与动机:为什么「部分已知」逼着机器人改变规划方式
真实家庭环境里,机器人对物体位置的了解天然是部分的:房间与大型容器很少移动,小物件却会被人类随手改变位置。论文把这个矛盾写得很直接——序贯操作类方法"often assume a fully known, static environment",而探索类方法"typically involve limited physical interaction with the scene"。真实部署会同时打破这两个前提。
论文把困难拆成三条相互耦合的挑战:一是部分可观测下定位任务相关物体,需要优先探索;二是权衡探索与操作,把总执行代价压下来;三是在不确定性下产出真正可执行的计划。既有缓解手段依赖手工启发式,长程任务里既不够鲁棒也不够可扩展。
四条规划路线的假设差异,决定了它们的成败,这张表说明了 EPoG 的位置:
| 路线 | 环境假设 | 是否需要手工规则 | 代表工作 |
|---|---|---|---|
| 纯大模型规划 | 无显式环境建模 | 否(靠自纠错) | LLM-Planner / ReAct 式规划 |
| 探索 + 大模型 | 先探索、后执行 | 否,但探索策略固定 | 主动探索 + 零样本规划 |
| 探索 + 规则式规划 | 需预定义时空约束 | 是 | Sequential Manipulation Planning on Scene Graph(IROS 2022) |
| 场景图 + 大模型锚定 | 图已建好 | 部分 | SayPlan(CoRL 2023) |
| EPoG(本文) | 信念图随执行生长 | 否 | ICRA 2026 |
从问题链看,动机是这样一步步收敛的:观察到家庭物体位置会被改变,先验图必然过期;诊断出既有工作要么不建模环境、要么假设环境已知;方案是用一张信念图同时承载已知信息与大模型估计的未知;系统化是把规划重述为图上编辑距离加拓扑排序;验证是在 46 个场景、5 类任务上做受控对比,并补两个真机案例。
这条线并非凭空出现。把视野拉长到五年,团队自己的工作轨迹是:2021 年用虚拟运动链把机器人与场景运动学放进同一约束,2022 年在场景图上做规则式序贯操作规划,2024 年让大模型参与运动失败推理(LLM3),到本文,大模型同时承担信念估计与例外重规划,探索第一次被并入规划。
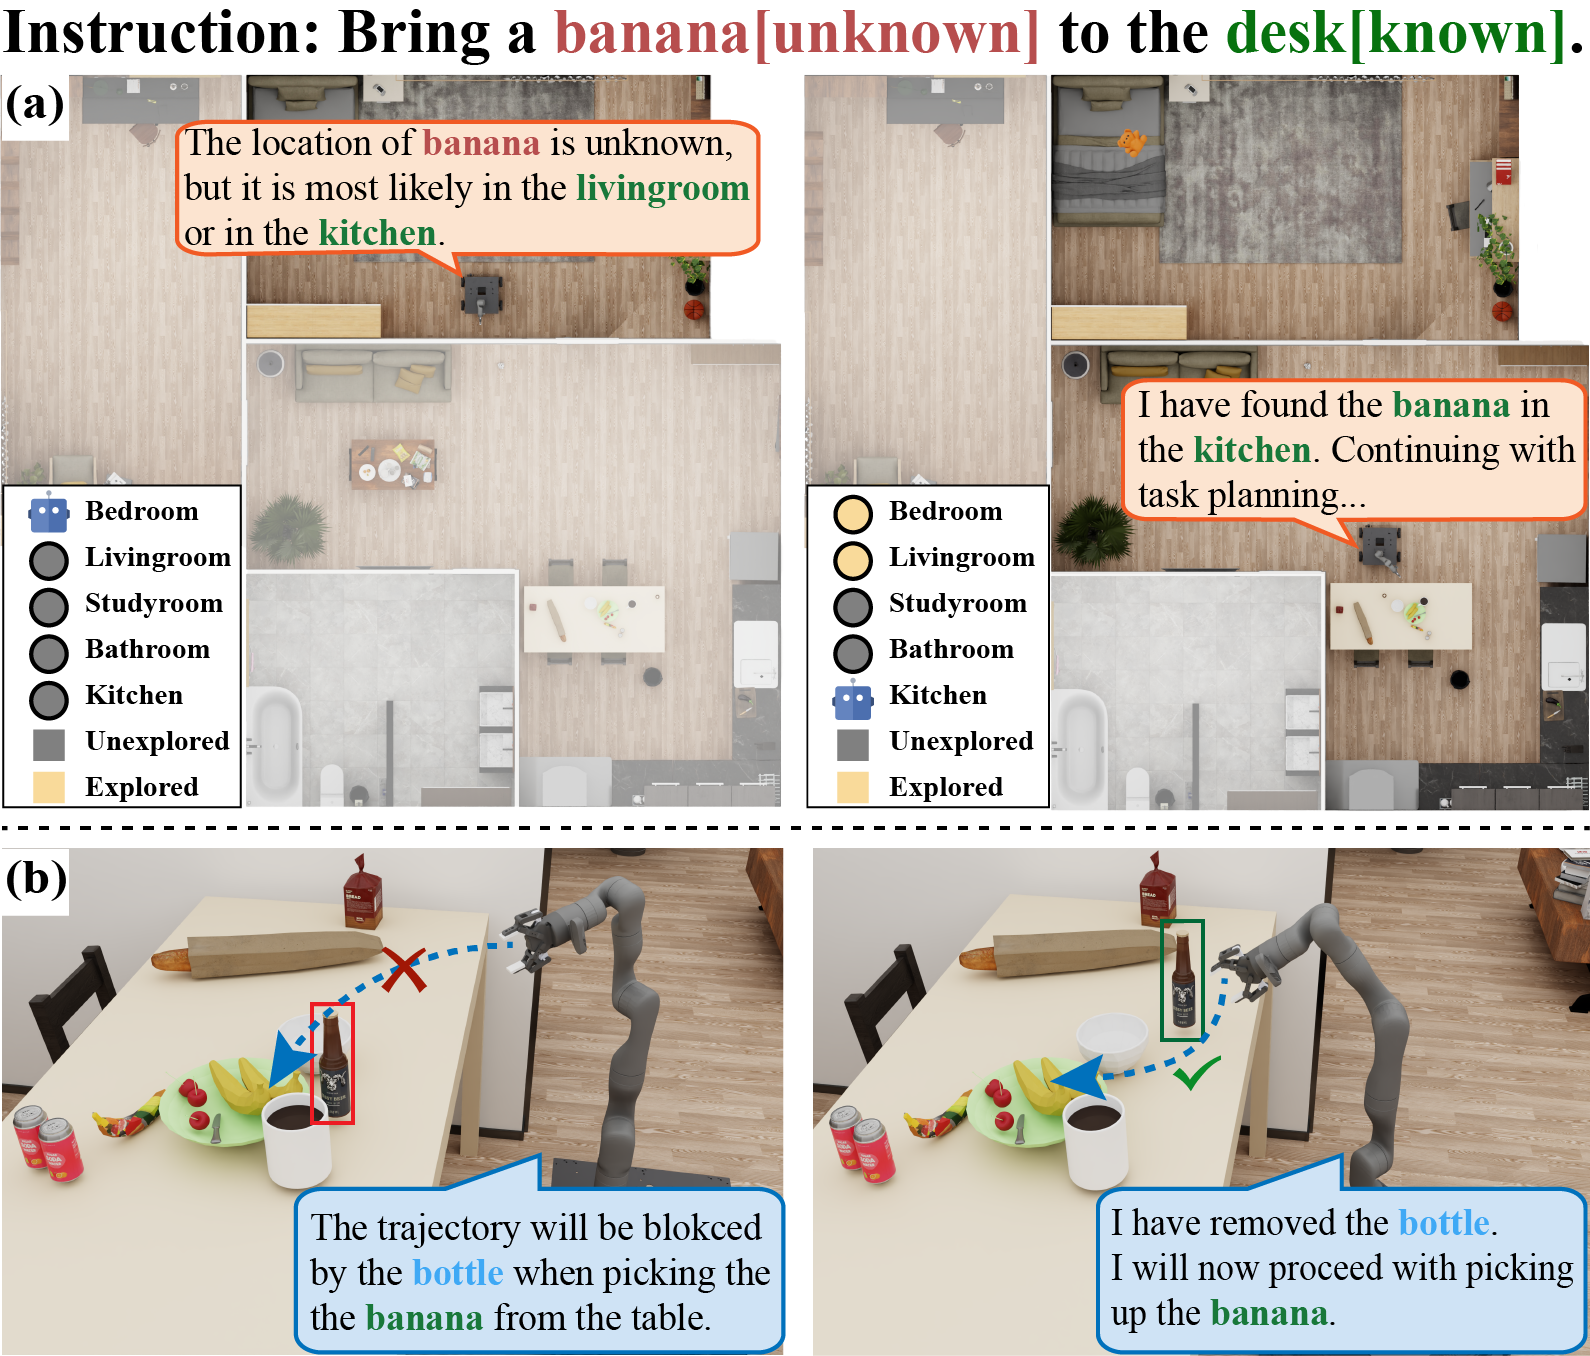
图 1:论文的动机示意——(a) 机器人必须对潜在探索位置排序,并在探索与操作之间取得平衡;(b) 面对执行中的意外情况需要 situated 即时重规划
研究主线:从问题到结论
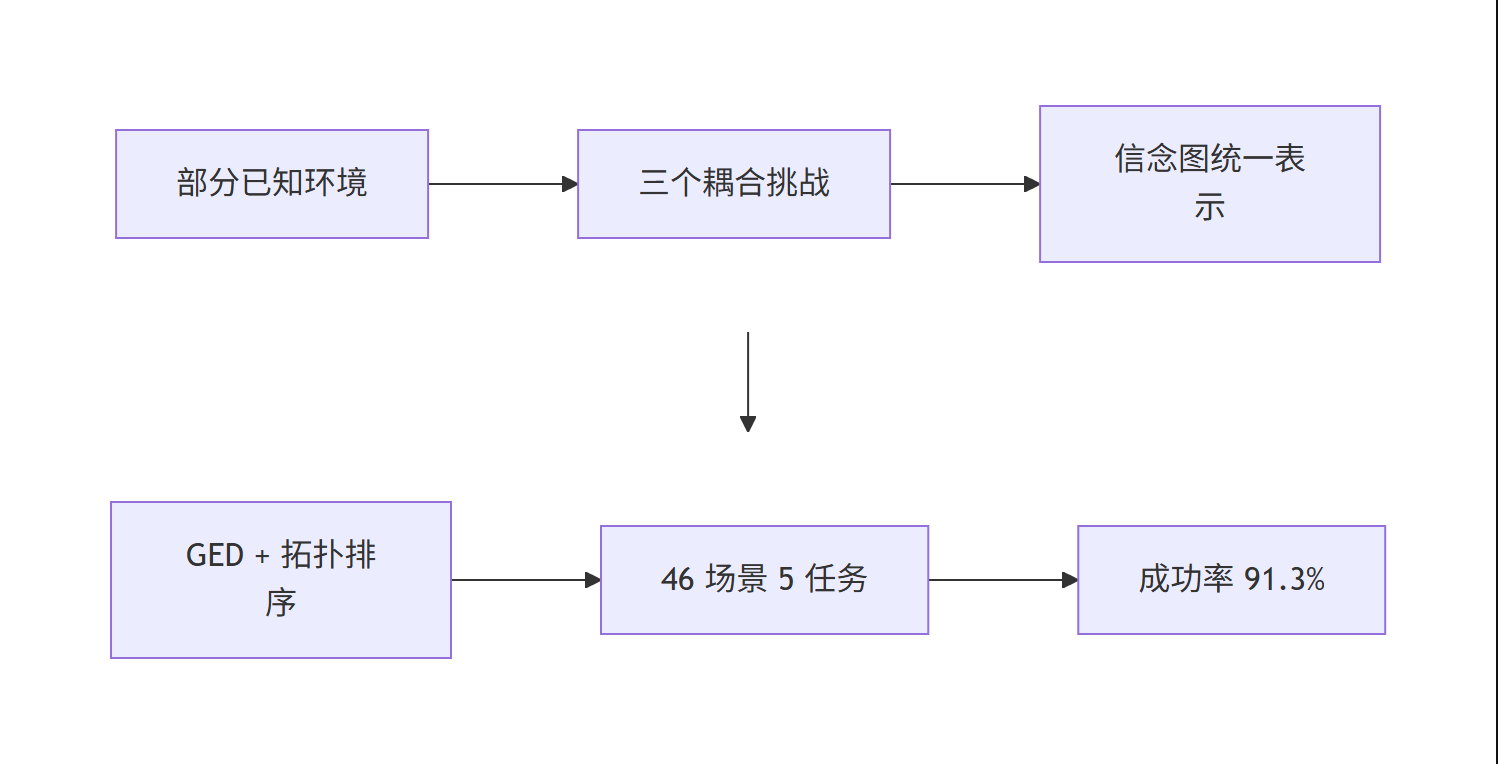
图 7:EPoG 的研究主线——从「部分已知」到「信念图随执行生长」(Mermaid 流程图)
方法设计:信念图 + 图编辑距离
EPoG 的表示沿用图式场景表示:场景图 $G_b=(V,E,A)$ 由场景节点 $V$、支撑关系边 $E$ 与任务相关属性 $A$ 组成,室内场景按 House → Room → Receptacle → Object 四层组织。初始信念图只含房子、房间与容器这些不常移动的节点,缺失的任务相关物体由大模型分两步估计:先估所在房间,再估所在容器。
这里有一处克制得很好的设计:大模型只补结构,不预测几何变换。每个缺失节点只问两个粗粒度问题,几何细节留给底层运动规划器——因为几何是否可行直接决定动作能否执行,不能让语言模型的幻觉介入。
分类全景:双层规划器的分工
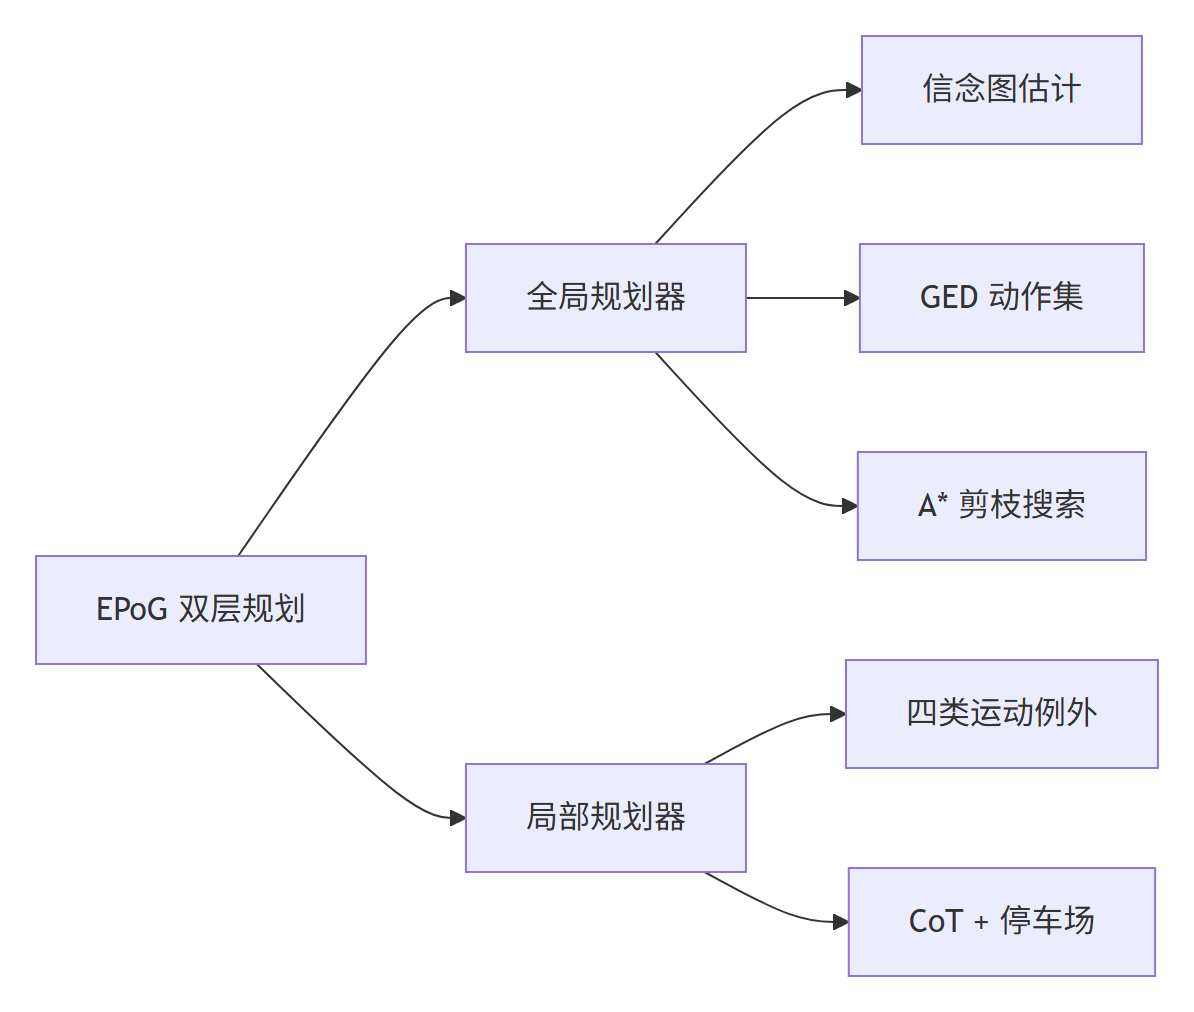
图 8:EPoG 的双层分工——几何与最优性交给图算法,常识与例外交给大模型(Mermaid 分类图)
方法细节:GED、拓扑排序与例外处理
方法的核心可以压成一句话:把「把信念图变成目标图」的最小代价编辑集合,直接当作动作集合。
图编辑距离给出形式化定义:$\mathrm{GED}(G_1,G_2)=\min\sum cost(a_i)$,其中求和遍历把 $G_1$ 变成 $G_2$ 的编辑操作序列。四类编辑操作与机器人动作一一对应:删除边 $e_{i,j}$ 对应抓取 $\texttt{Pick}(v_i,v_j)$;插入边对应放置 $\texttt{Place}(v_i,v_j)$;把容器属性 $A_i^c$ 改成打开或关闭,分别对应开门与关门——开关门在这里的意义是直接改变「被包含物体是否可观测」。
动作之间存在时间依赖,构成偏序约束 $C={(a_i,a_j)\mid i\neq j,\ a_i<a_j}$,例如同一容器上的抓取必须先于放置。于是任务规划被表述成 $(K,C)$ 上的拓扑排序:搜索节点记为剩余动作、剩余约束与当前子序列,深度优先展开无约束的动作,用 $A^\star$ 启发式估计移动距离,一旦当前代价超过已知上界就剪枝,最终得到带移动代价的最优序列 $\pi^\star$。
四个设计要点决定了它的工程可用性:一是估计与观测进同一张图;二是用图编辑距离统一探索与操作——行走动作由启发式插入到父容器附近,所以探索不是独立阶段,而是代价函数的一部分;三是 $A^\star$ 加剪枝保证最优性,给定图时全局规划器完备;四是例外分类驱动大模型,把运动失败归为阻挡、不可达、碰撞与不稳定四类,用思维链提示加临时停车场机制,让大模型只在受限动作空间里产出修正序列。
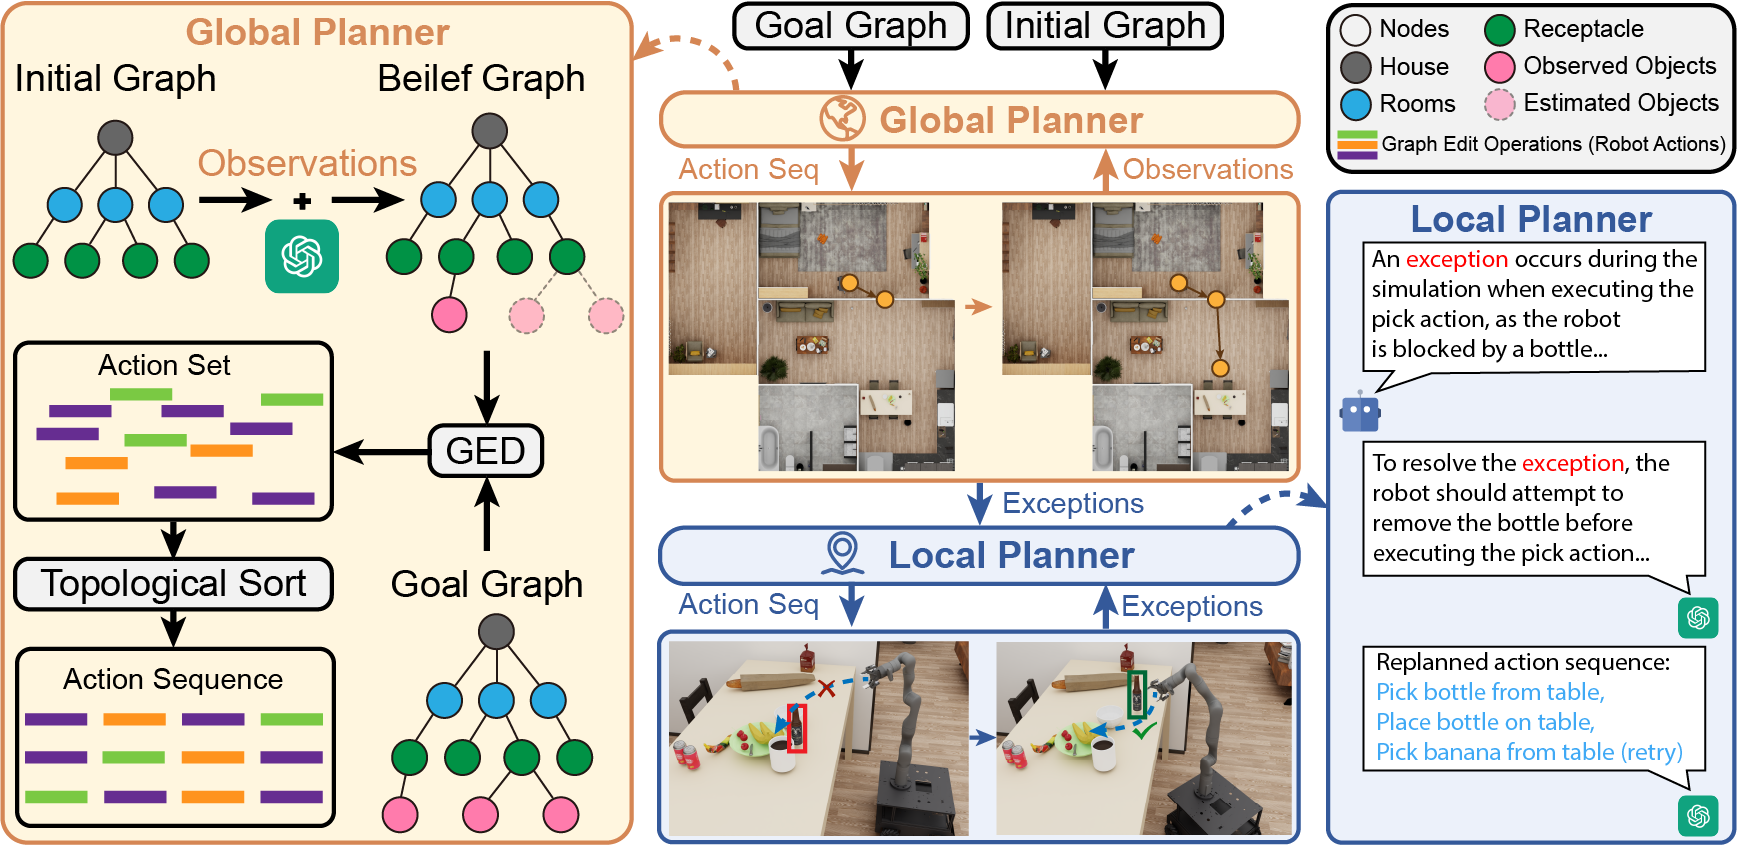
图 2:EPoG 框架总览——全局层在信念图与目标图之间求编辑操作并排序,局部层用大模型处理执行例外
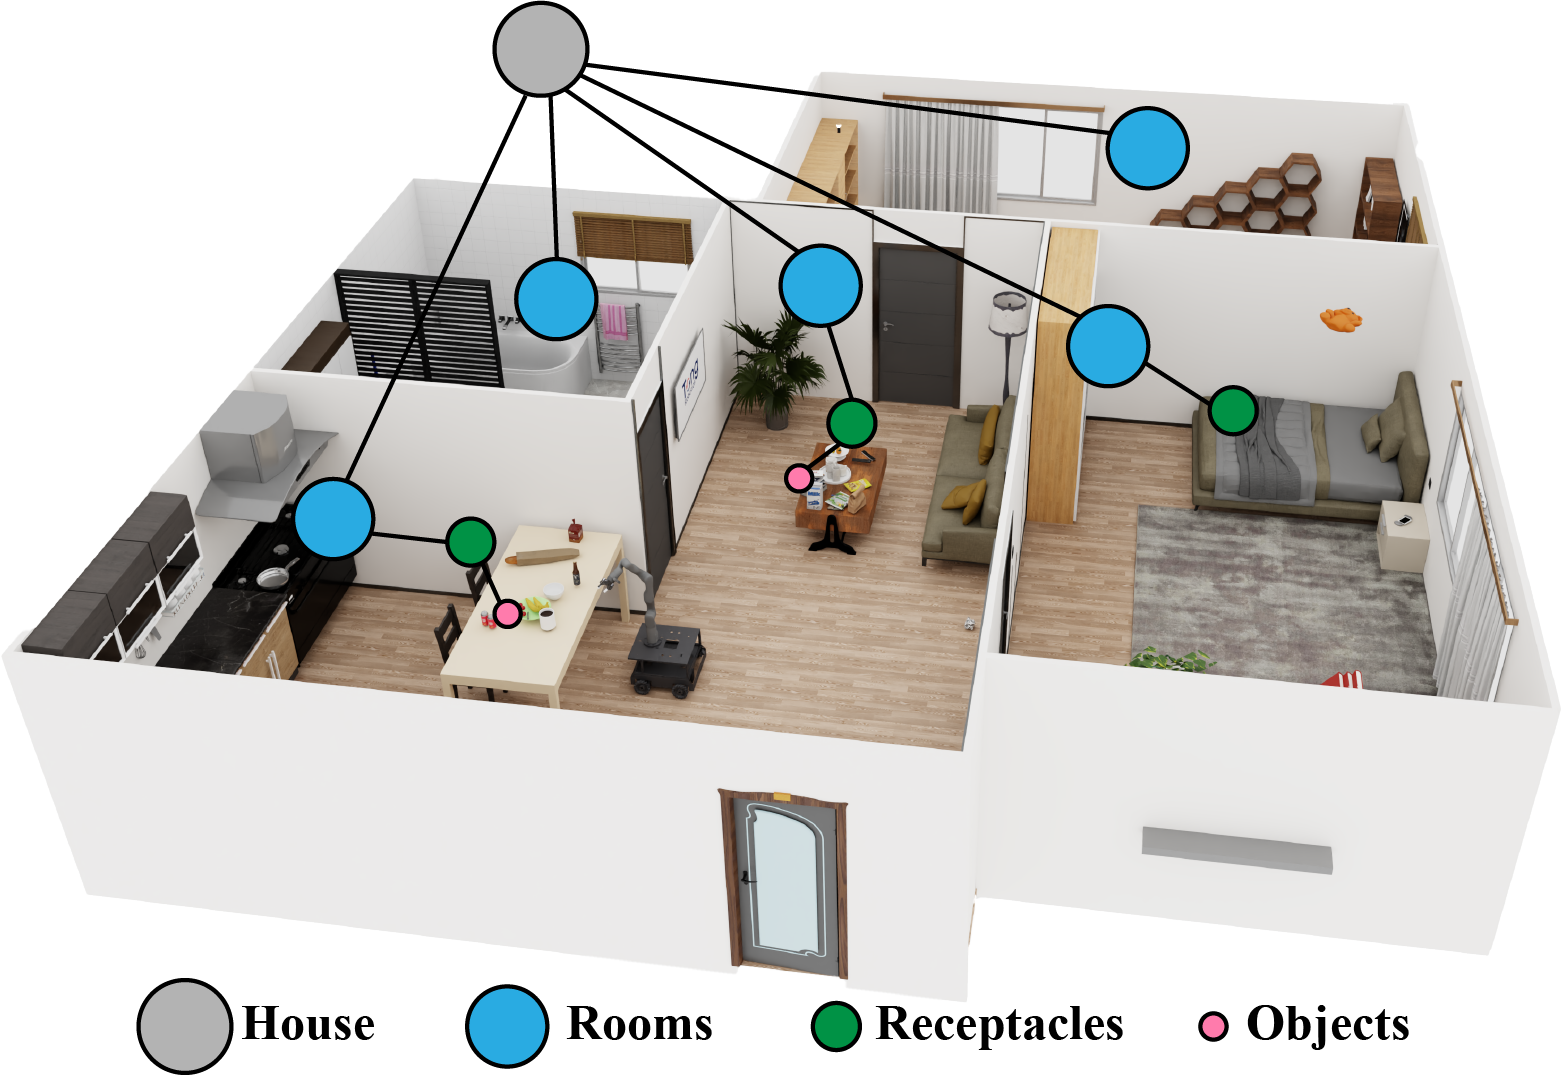
图 3:场景图的分层语义表示——House(Level 0)→ Room(Level 1)→ Receptacle(Level 2)→ Object(Level 3+)
执行层的另一处关键机制是信号补全:如果某个物体的估计位置 $e_{err}$ 没有出现在观测 $\mathcal{O}=(V_{obs},E_{obs})$ 里,规划器用新估计替换旧的位置,而不是直接判定失败——「苹果不在桌上」会触发一次位置重估。
局部规划器要处理的四类例外如下:
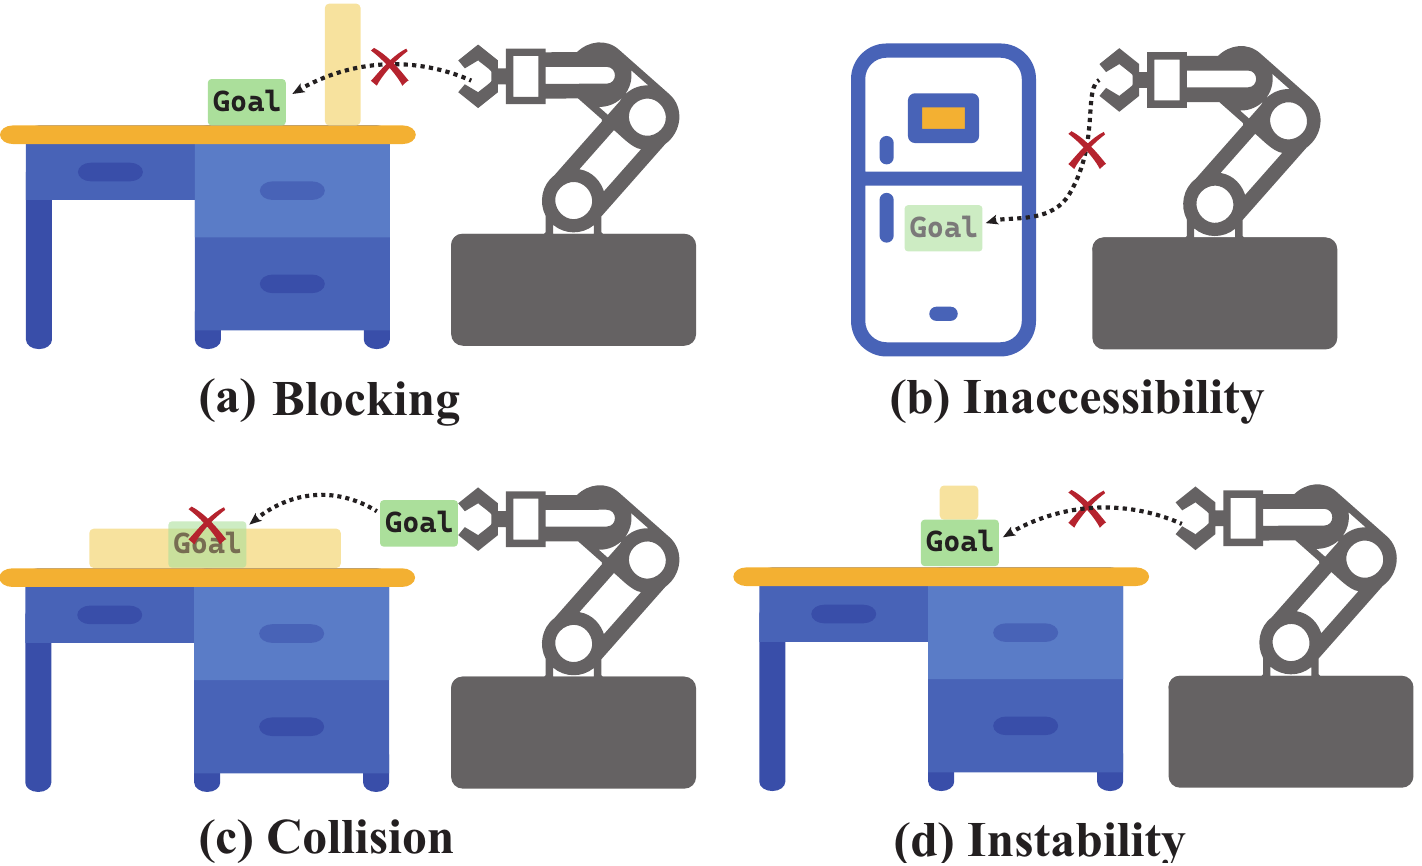
图 4:四类运动规划例外——(a) 遮挡/阻挡;(b) 不可达(需先开门);(c) 碰撞;(d) 不稳定(抽出杯下书本会让堆叠失稳)
实验设计与结果
评测数据来自 ProcTHOR-10k,筛出 46 个含任务相关物体的真实家居场景,设计了 5 类长程日常搬运任务,每个场景在物体附近随机注入 4 类例外中的 2 个。
| No. | 任务 | 场景数 | 目标条件 |
|---|---|---|---|
| 1 | 早餐准备 | 10 | {apple, bread, fork} → plate;plate → diningtable |
| 2 | 卧室办公 | 10 | {alarmclock, CD, laptop, pencil} → desk |
| 3 | 观影零食 | 10 | remote → sofa;bread → plate;plate → diningtable |
| 4 | 泡茶放松 | 10 | kettle → countertop;cup → diningtable;remote → sofa |
| 5 | 洗漱准备 | 6 | {soapbottle, cloth} → faucet |
三个指标:%SR 是成功完成任务的场景占比,%EN 衡量多走了多少不必要的探索,%TD 衡量路径效率(后两者论文原文写作 percentage difference,未写明参照基准)。三条基线分别是:纯大模型规划器(不做显式环境建模,每场景最多重试 20 次)、探索加大模型(用优化的路径主动探索后再规划)、探索加规则式规划器 PoG(预定义时空约束 + 显式例外处理)。
主结果是五类任务各自的成功率:
| 任务(场景数) | 纯 LLM | 探索+LLM | 探索+PoG | EPoG |
|---|---|---|---|---|
| 早餐准备(10) | 10.0 | 40.0 | 100 | 100 |
| 卧室办公(10) | 10.0 | 40.0 | 100 | 100 |
| 观影零食(10) | 10.0 | 40.0 | 100 | 80.0 |
| 泡茶放松(10) | 40.0 | 60.0 | 100 | 90.0 |
| 洗漱准备(6) | 16.7 | 16.7 | 100 | 83.3 |
| 总计 | 17.4 | 41.3 | 100 | 91.3 |
聚合口径下的三项指标更能说明取舍:EPoG 的总成功率 91.3%,探索节点 +51.9%、移动距离 +37.8%;而保住 100% 成功率的规则式基线,两个代价指标分别是 +73.2% 与 +75.6%。论文据此报告探索节点降 40.0%、移动距离降 36.2%(摘要中移动距离写作 36.1%)。
真机部分用移动操作平台,底层是虚拟运动链规划加 cuRobo 生成全身轨迹,论文明确说明刻意抽象掉感知实现,专注验证任务规划层:
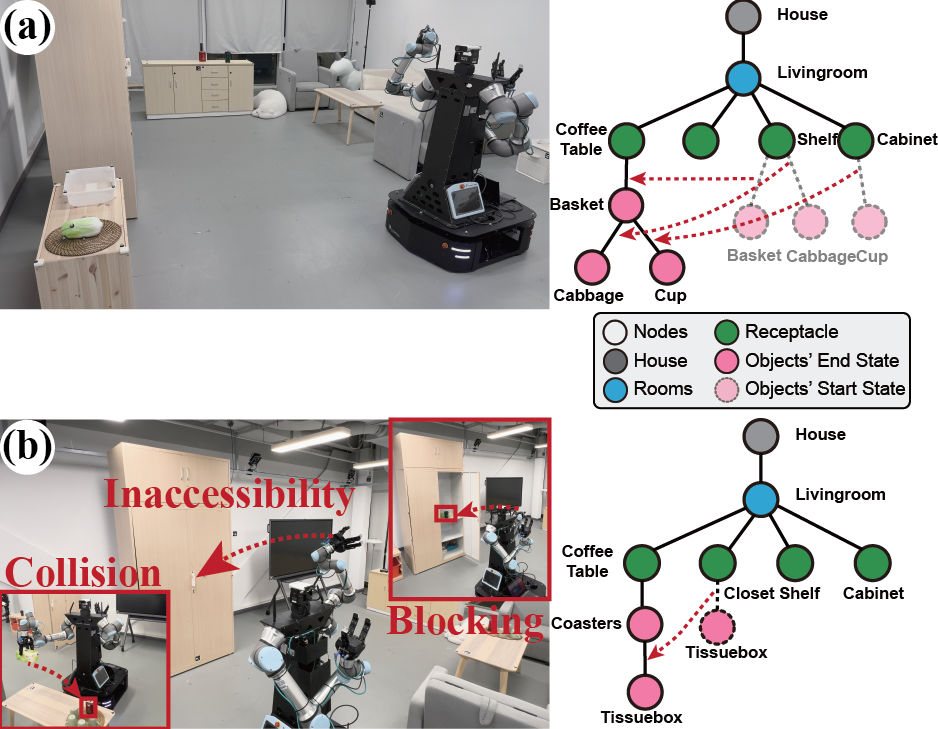
图 5:真机实验设置——(a) 把三个物体(其中一个位置未知)放到咖啡桌上;(b) 从柜中取出纸巾盒放到杯垫上,需先移开挡路的杯子与茶叶罐
两个真机案例的完整链条如下。第一个案例要求把篮子搬到咖啡桌上,并把玩具白菜与杯子放进去,杯子位置初始未知;大模型推理杯子可能在咖啡桌上,桌上没找到时,观测不在可见集合里,于是更新信念图、重新估计位置,最后在别处找到并完成放置。第二个案例里大模型正确估计纸巾盒在关闭的柜子里,开柜后发现杯子挡住纸巾盒,于是临时把它移到架上;茶叶罐挡住杯垫时,先放下纸巾盒、移开茶叶罐、再放回——三个例外(不可达、遮挡、碰撞)被局部规划器逐个化解。
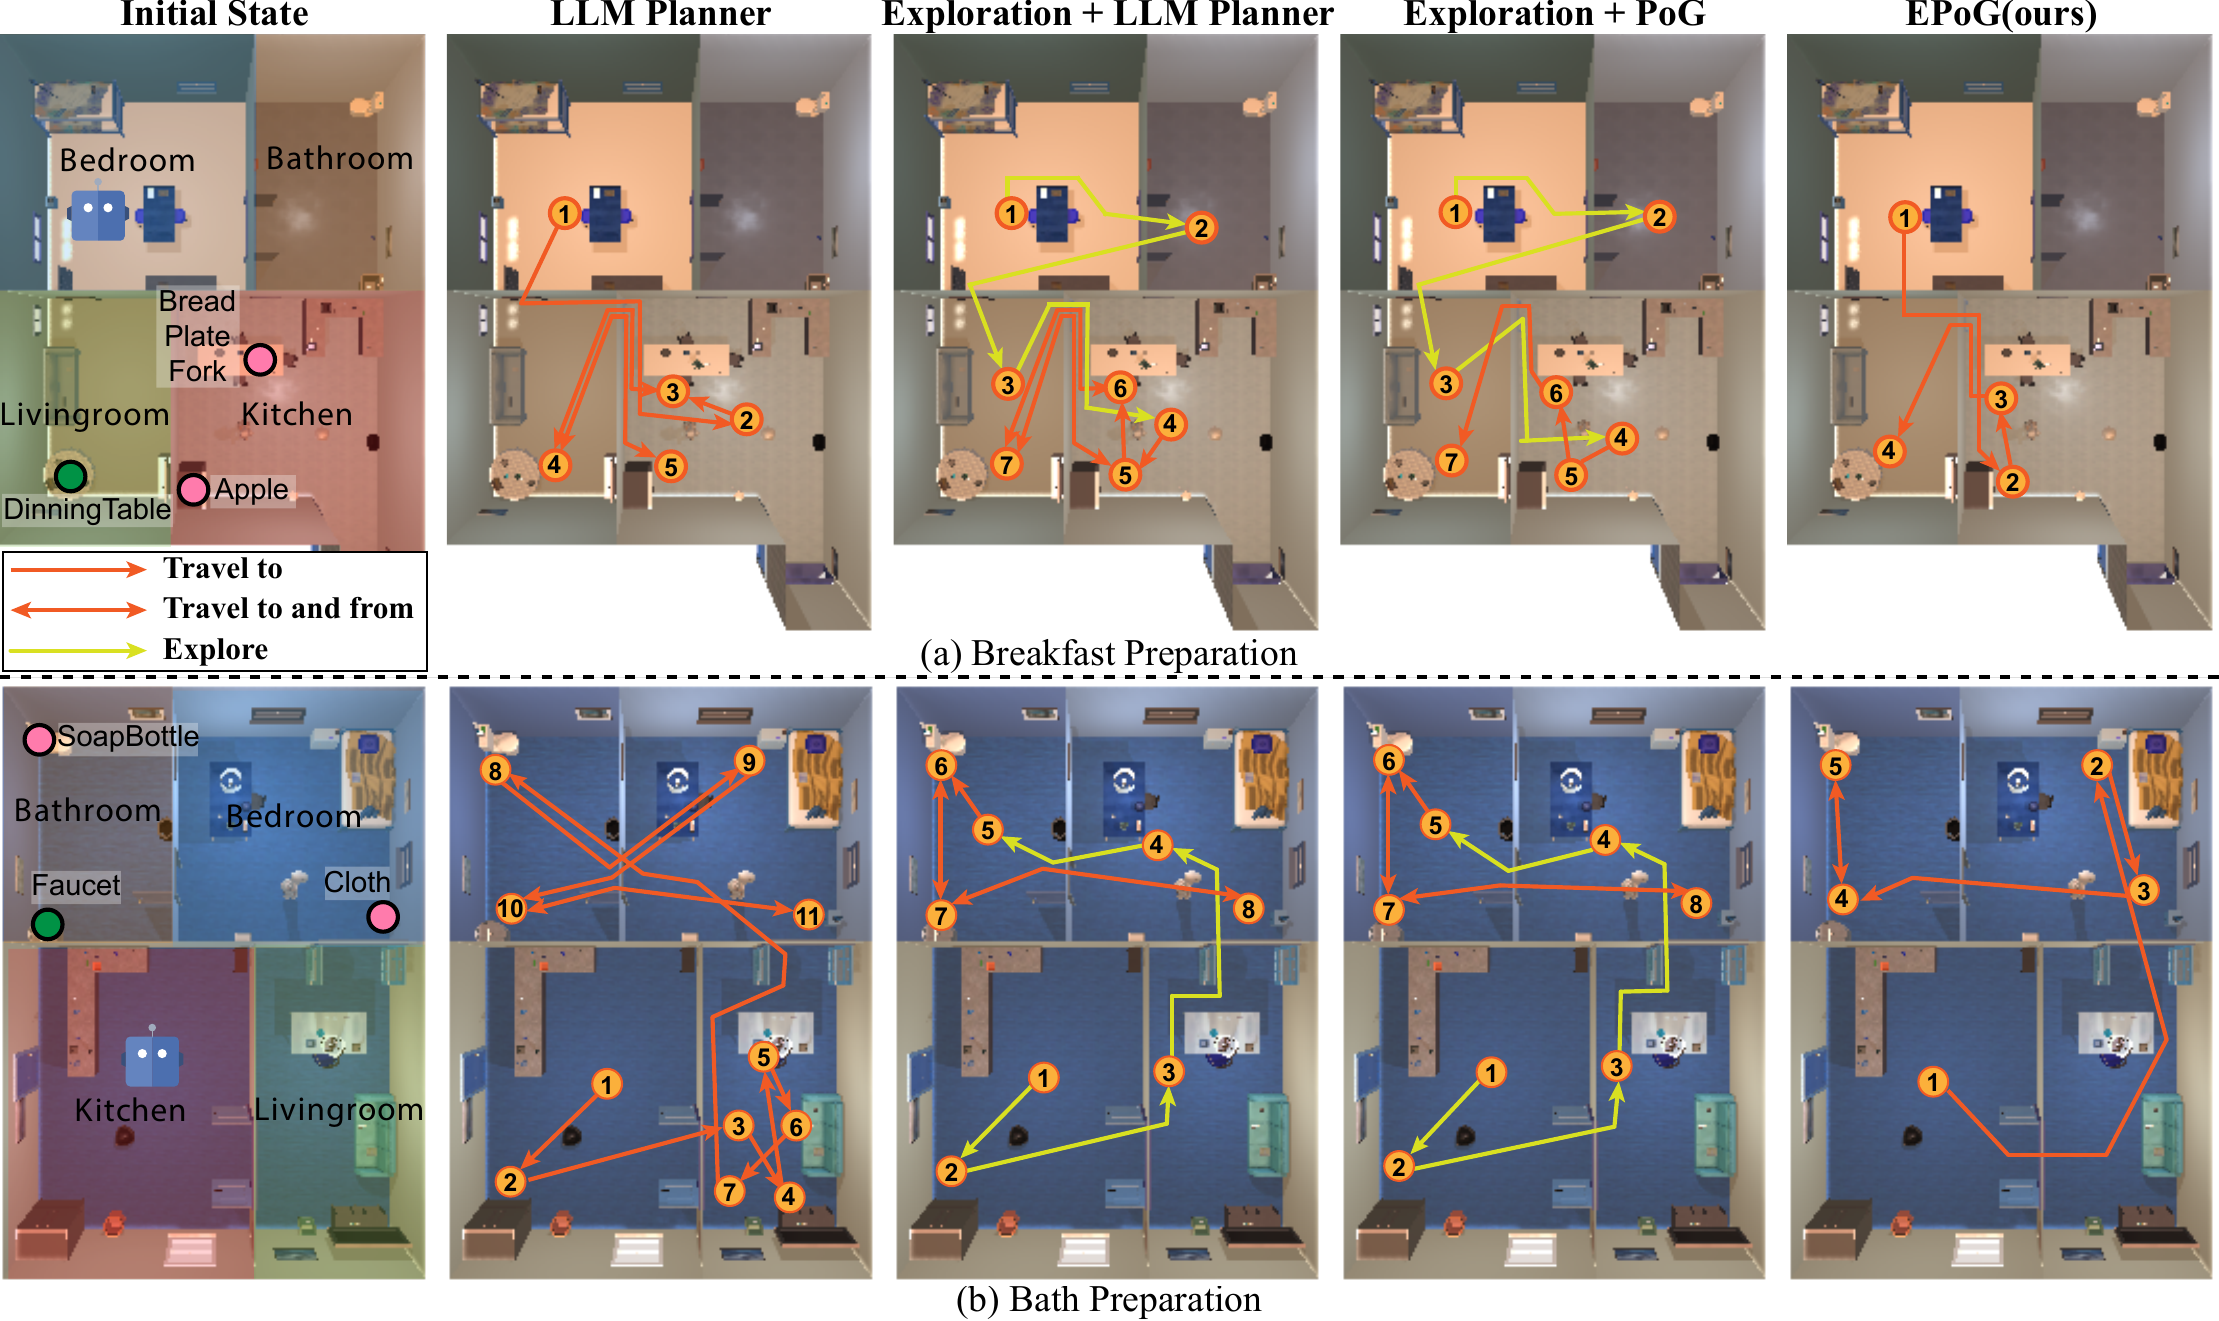
图 6:两个任务的机器人路径(仅显示跨 Room/Receptacle 的移动)——EPoG 把盘子当作搬运工具,先归拢再整体转移;对照的 LLM 方法逐件搬运,动作序列更长
结果对比总结
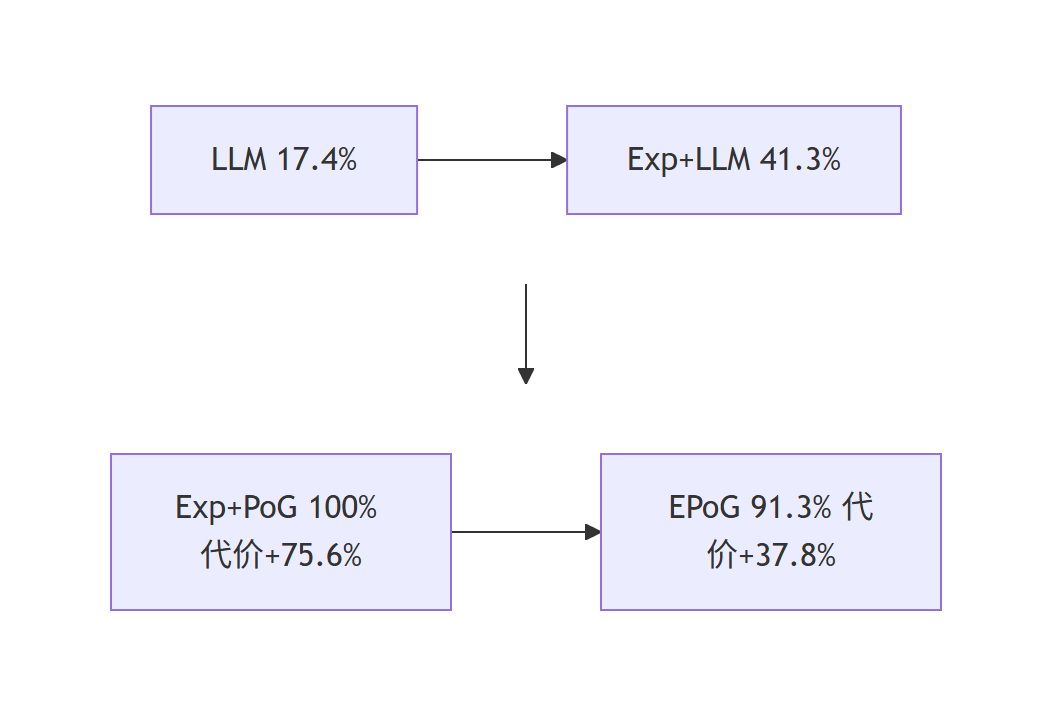
图 9:EPoG 的关键对比——成功率与执行代价之间的取舍(Mermaid 对比图)
关键发现
- 纯大模型规划器几乎不可用。 总成功率只有 17.4%,移动距离超支 +93.9%:它经常走到错误的位置抓取或放置,找不到全部任务相关物体;即便成功,计划也更低效。
- 把探索还给规划器,是用代价换信息。 探索加大模型把成功率抬到 41.3%,代价是探索节点 +89.4%、移动距离 +120%——探索本身没有错,错在它与操作各自独立。
- 效率是 EPoG 的胜负手。 相对规则式基线,探索节点降 40.0%、移动距离降 36.2%,总成功率仍达 91.3%;在早餐准备与卧室办公两类任务上同样是 100%。
- 探索节点最低的数字是个陷阱。 纯大模型规划器的 %EN 只有 +2.05,看似最优,其实是低成功率带来的假优势——它往往根本没走到该去的地方。真正的对照是规则式基线。
- 失败集中在复合例外。 剩余 8.7% 的失败全部出现在复合例外场景:全局规划在图上完备,瓶颈是局部规划器面对组合式物体配置时的认知歧义。
- 创新模式上命中的是结构洞察。 用 15 种创新模式框架审视,这篇论文同时命中「审计并扭转负载假设」(假设是"序贯操作要求环境完全已知且静态")、「重新表述为可解对象」(把探索加操作重述为图编辑距离加拓扑排序)与「分解并委托求解器」(几何交图算法、例外交大模型),属于典型的程序委员会偏好组合。
局限性
- 局部规划器是唯一短板:8.7% 的失败全部来自复合例外,论文没有给出失败模式的量化分类。
- 观测假设偏强:假设机器人进入一个房间即可看到除封闭容器之外的所有物体及其关系;真机又刻意抽象掉感知实现,感知噪声下的退化没有被验证。
- 问题设定受限:假设确定性状态转移、动作集只有抓取/放置/开关门/行走、物体状态被离散化,未覆盖连续空间中的部分可观测。
- 评测规模与口径:46 个场景、每类任务每场景只执行一次,没有报告多种随机子下的方差;而且 %EN 与 %TD 未写明参照基准,正文声称的 40.0% 与 36.2% 无法从表格数字直接复算($51.9/73.2$ 对应 29.1%)。
- 写作层面的小瑕:正文把数据集写成 ProcThor-10k,与官方名称 ProcTHOR 不一致;另有一处介词用法生硬,且全文没有致谢与资助声明段落。
- 作者展望:接入三维场景图感知模块,并结合任务与运动规划方法,把几何可行性的判断从运动规划器前移到任务层。
常见问题(FAQ)
EPoG 一句话是什么?
它把「已知信息」与「大模型估计的未知」放进同一张信念图,于是探索与操作不再是两个阶段,而是同一组图编辑操作;全局层用图编辑距离与拓扑排序求最优序列,局部层用大模型化解执行例外。
它为什么不用大模型直接规划?
因为长程问题上大模型缺乏空间接地。消融里纯大模型规划器的总成功率只有 17.4%,移动距离超支 +93.9%;而几何与代价交给确定性的图算法后,EPoG 达到 91.3%。工程上的分界是:大模型补常识结构、化解例外,几何与最优性交确定性算法。
探索和操作是怎么统一的?
行走动作由 $A^\star$ 启发式插入到父 $\texttt{Receptacle}$ 附近,因此探索不是独立阶段,而是代价函数的一部分。规划器会在"顺路看一眼"与"直接执行"之间做代价权衡,这正是它与"先探索后规划"的根本区别。
成功率是不是被规则式基线反超了?
是的,而且论文如实报告了:规则式的 Exploration+PoG 在五类任务上都保持 100%,EPoG 是 91.3%。EPoG 赢的是效率——探索节点从 +73.2% 降到 +51.9%,移动距离从 +75.6% 降到 +37.8%。这也是本文最容易被误读的一点。
剩下的 8.7% 失败出在哪?
全部出在复合例外场景。全局规划在图上完备,问题在局部大模型规划器面对组合式物体配置时的认知歧义——它需要同时处理多个例外,而论文没有给出失败模式的量化分类。
真机实验验证到了什么程度?
两例真机任务均完成:一例靠信念图更新纠正"桌上没找到杯子"的误估,另一例靠局部规划器移开挡路的杯子与茶叶罐。但底层动力学用虚拟运动链与 cuRobo 生成,感知被刻意抽象——所以它验证的是任务规划层,不是完整系统。
参考链接
- 论文(arXiv 摘要页):https://arxiv.org/abs/2602.04419
- 官方代码仓库(BUAA COLA Lab):https://github.com/buaa-colalab/EPoG
- 场景图 LLM 规划基础工作:Rana et al., SayPlan: Grounding Large Language Models using 3D Scene Graphs for Scalable Robot Task Planning, CoRL 2023
- 规则式基线与方法前身:Jiao et al., Sequential Manipulation Planning on Scene Graph, IROS 2022
- 同一条线的移动操作基础:Jiao et al., Efficient Task Planning for Mobile Manipulation: A Virtual Kinematic Chain Perspective, IROS 2021
- 让大模型参与运动失败推理:Jiao et al., LLM3: Large Language Model-based Task and Motion Planning with Motion Failure Reasoning, IROS 2024
- 家居场景数据集:Deitke et al., ProcTHOR: Large-Scale Embodied AI Using Procedural Generation, NeurIPS 2022
- 真机运动生成:Sundaralingam et al., cuRobo: Parallelized Collision-Free Robot Motion Generation, ICRA 2023
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献79条内容

所有评论(0)