【World Model】(CVPR 2026)Motus: A Unified Latent Action World Model
【World Model】(CVPR 2026)Motus: A Unified Latent Action World Model
一、论文简介 🌟
1.1 论文方法一图总结
1.2 基本信息
- 📖 题目: π 0.5 \pi_{0.5} π0.5: a Vision-Language-Action Model with Open-World Generalization
- 🏫 单位: THBI Lab;Tsinghua University;Peking University;Horizon Robotics
- 🌍 主页:https://motus-robotics.github.io/motus
- 🀄️ 论文摘要:尽管通用具身智能体必须作为一个统一系统运行,当前方法却建立在彼此孤立的理解、世界建模和控制模型之上。这种割裂阻碍了多模态生成能力的统一,也妨碍了从大规模异构数据中学习。论文提出 Motus,一种统一的潜在动作世界模型,利用现有的通用预训练模型和丰富、可共享的运动信息。Motus 引入混合 Transformer(Mixture-of-Transformer,MoT)架构,以整合三个专家模型,即理解、视频生成和动作专家;并采用 UniDiffuser 风格的调度器,使模型能够在不同建模模式之间灵活切换,包括世界模型、视觉-语言-动作模型、逆动力学模型、视频生成模型,以及视频-动作联合预测模型。论文进一步利用光流学习潜在动作,并采用包含三阶段训练流程和六层数据金字塔的训练方案,从而提取像素级的“增量动作”,实现大规模动作预训练。实验表明,Motus 在仿真和真实场景中均优于现有最先进方法:在仿真中,相较于 X-VLA 提升了 + 15 % +15\% +15%,相较于 π 0.5 \pi^{0.5} π0.5 提升了 + 45 % +45\% +45%;在真实场景中提升了 + 11 ∼ 48 % +11\sim48\% +11∼48%。这些结果表明,将所有功能与先验统一建模,能够显著改善下游机器人任务的表现。
1.3 论文引言 & 主要贡献
对于具身智能体而言,统一模型至关重要:它能够将一系列认知功能整合为一个整体,从理解场景、想象可能的未来,到预测结果和生成动作。然而,现有方法将这些能力分开建模:有些方法依赖视觉-语言-动作模型(VLA),从视觉和语言中学习静态策略;另一些方法则使用基于预测未来的世界模型或生成方法;F1 将 VLA 与逆动力学模型(IDM)结合起来,通过显式想象未来视觉观测来生成动作,但它没有纳入世界模型或视频生成模型(VGM),因此并未实现完整的统一。这些方法将本应统一的系统割裂为五项独立的建模任务:
- VLA: p ( a t + 1 : t + k ∣ o t , ℓ ) p(a_{t+1:t+k} \mid o_t, \ell) p(at+1:t+k∣ot,ℓ);
- 世界模型(WM): p ( o t + 1 : t + k ∣ o t , a t + 1 : t + k ) p(o_{t+1:t+k} \mid o_t, a_{t+1:t+k}) p(ot+1:t+k∣ot,at+1:t+k);
- IDM: p ( a t + 1 : t + k ∣ o t : t + k ) p(a_{t+1:t+k} \mid o_{t:t+k}) p(at+1:t+k∣ot:t+k);
- VGM: p ( o t + 1 : t + k ∣ o t , ℓ ) p(o_{t+1:t+k} \mid o_t, \ell) p(ot+1:t+k∣ot,ℓ);
- 视频-动作联合预测模型: p ( o t + 1 : t + k , a t + 1 : t + k ∣ o t , ℓ ) p(o_{t+1:t+k}, a_{t+1:t+k} \mid o_t, \ell) p(ot+1:t+k,at+1:t+k∣ot,ℓ)。
两个根本性挑战阻碍了这些能力的整合(详见第 3 节)。首先,在一个框架中统一多模态生成能力并非易事。尽管统一世界模型(UWM)提供了一个理论上的原型,但这类模型通常从头训练,或仅利用有限的先验;它们缺乏视觉-语言模型(VLM)所具备的稳健视觉-语言理解能力,或视频生成模型所蕴含的丰富物理交互知识。其次,具身智能要求模型能够从大规模异构数据中学习,包括互联网视频、第一人称人类演示和多机器人轨迹;然而,不同具身体的动作空间差异很大,而且大多数视频数据没有动作标注,因此难以利用通用运动和交互先验预训练动作专家。
为应对这些挑战,论文提出 Motus,一种统一的潜在动作世界模型。Motus 利用混合 Transformer(MoT)架构,将预训练专家整合在一起。该方法通过共享多头自注意力层,将三个专家连接起来:视频生成专家、动作专家和视觉-语言理解专家。论文将这一设计称为三模型联合注意力(Tri-model Joint Attention)。这种设计在保留各专家专门功能的同时,能够实现跨模态知识融合。为进一步协调多模态生成,Motus 采用类似 UniDiffuser 的调度器,为不同模态(例如视频和动作)分配不同的时间步和噪声尺度。这样便能以统一方式对边缘分布、条件分布和联合分布建模,并在不同推理模式之间灵活切换,例如 VLA、WM、IDM、VGM 和视频-动作联合预测模型。
此外,为了大规模利用异构数据,论文引入潜在动作,从光流中编码运动模式,形成像素级的“增量动作”。这种表示连接了视觉动态与控制信号,使动作专家能够在多样的无标注视频和机器人轨迹上进行预训练。具体而言,论文使用一个预训练的深度压缩自编码器(DC-AE)及额外的轻量级下采样模块来重建光流,并利用编码得到的低维潜在表示接受少量动作标签监督,其中包括任务相关和任务无关的动作标签,以引导模型关注与机器人活动相关的模式。
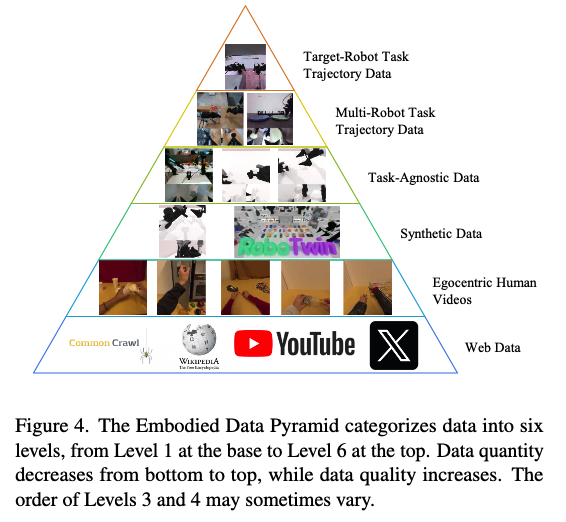
随后,Motus 采用三阶段预训练与微调流程,以及覆盖六个层级的数据金字塔进行训练。该数据金字塔涵盖网络数据、第一人称人类数据、仿真数据、任务无关数据、多机器人数据和目标机器人数据。通过这一训练方案,模型能够在光流所表征的运动空间中对齐不同具身体的行为,并将交互知识迁移到目标具身体,从而提升下游任务中的泛化能力;这一方案也为动作专家提供了类似其他专家所拥有的预训练。
论文的贡献概括如下:
-
论文提出了一种统一的具身基础模型,在不牺牲通用多模态先验的前提下,整合了五种主流范式,即世界模型、逆动力学模型、视觉-语言-动作模型、视频生成模型和视频-动作联合预测模型。
-
论文还提出了一种可扩展的机器人训练方案,包含三阶段训练流程和六层数据金字塔,并利用基于光流的潜在动作学习可跨具身体迁移的运动知识。
-
大量实验表明,Motus 在仿真和真实场景中均显著优于现有最先进方法:在仿真中,相较于 X-VLA 提升了 + 15 % +15\% +15%,相较于 π 0.5 \pi^{0.5} π0.5 提升了 + 45 % +45\% +45%;在真实场景中提升了 + 11 ∼ 48 % +11\sim48\% +11∼48%。实验结果表明,大规模通用先验与特定领域先验能够有效融合,从而提升策略学习的泛化能力。
二、方法论 🍀
2.1 问题定义与挑战(Problem Formulation and Challenges)
具身策略。论文考虑语言条件下的机器人操作任务。对于每种具身体,任务定义动作 a ∈ A a \in A a∈A、观测 o ∈ O o \in O o∈O(视觉输入)、语言指令 ℓ ∈ L \ell \in L ℓ∈L,以及机器人的本体感知 p p p;其中 A A A、 O O O 和 L L L 分别表示动作空间、观测空间和语言指令空间。任务通常提供专家数据集: D e x p e r t = { { ℓ , p 1 , o 1 , a 1 , … , p N , o N , a N } } D^{expert}=\{\{\ell,p^1,o^1,a^1,\ldots,p^N,o^N,a^N\}\} Dexpert={{ℓ,p1,o1,a1,…,pN,oN,aN}},该数据集包含专家在 N N N 个时间步采集的机器人本体感知、视觉观测和动作,以及与相应轨迹配套的语言标注。论文在 D e x p e r t D^{expert} Dexpert 上训练由 θ \theta θ 参数化的策略。在每个时间步 t t t,策略根据当前观测和本体感知预测接下来的 k k k 个动作(动作分块),对分布 p θ ( a t + 1 : t + k ∣ o t , p t , ℓ ) p_{\theta}(a_{t+1:t+k}\mid o_t,p_t,\ell) pθ(at+1:t+k∣ot,pt,ℓ) 或 p θ ( a t + 1 : t + k ∣ o t , ℓ ) p_{\theta}(a_{t+1:t+k}\mid o_t,\ell) pθ(at+1:t+k∣ot,ℓ) 建模。策略 p θ p_{\theta} pθ 的训练目标是最大化以下似然目标:
max θ E ( o t , p t , a t + 1 : t + k , ℓ ) ∼ D e x p e r t log p θ ( a t + 1 : t + k ∣ o t , p t , ℓ ) . ( 1 ) \max_{\theta}\ \mathbb{E}_{(o_t,p_t,a_{t+1:t+k},\ell)\sim D^{expert}} \log p_{\theta}(a_{t+1:t+k}\mid o_t,p_t,\ell). \quad{(1)} θmax E(ot,pt,at+1:t+k,ℓ)∼Dexpertlogpθ(at+1:t+k∣ot,pt,ℓ).(1)
此外,根据上述符号定义,可以推导出具身智能五种建模类型所对应的概率分布,这些分布可以整合到单一模型中进行训练:
- 视觉-语言-动作模型(VLA): p ( a t + 1 : t + k ∣ o t , ℓ ) p(a_{t+1:t+k}\mid o_t,\ell) p(at+1:t+k∣ot,ℓ)。
- 世界模型(WM): p ( o t + 1 : t + k ∣ o t , a t + 1 : t + k ) p(o_{t+1:t+k}\mid o_t,a_{t+1:t+k}) p(ot+1:t+k∣ot,at+1:t+k)。
- 逆动力学模型(IDM): p ( a t + 1 : t + k ∣ o t : t + k ) p(a_{t+1:t+k}\mid o_{t:t+k}) p(at+1:t+k∣ot:t+k)。
- 视频生成模型(VGM): p ( o t + 1 : t + k ∣ o t , ℓ ) p(o_{t+1:t+k}\mid o_t,\ell) p(ot+1:t+k∣ot,ℓ)。
- 视频-动作联合预测模型: p ( o t + 1 : t + k , a t + 1 : t + k ∣ o t , ℓ ) p(o_{t+1:t+k},a_{t+1:t+k}\mid o_t,\ell) p(ot+1:t+k,at+1:t+k∣ot,ℓ)。
挑战 1:统一多模态生成能力。一个有效的具身智能体必须将一系列认知功能整合为一个整体,从理解场景和指令,到想象可能的未来、预测结果和生成动作,从而具备类似人类的能力。然而,当前模型彼此割裂,无法在一个系统中涵盖所需的全部能力。这带来了一个挑战:如何在单一框架内统一对五种关键分布进行建模,即视觉-语言-动作模型、世界模型、逆动力学模型、视频生成模型和视频-动作联合预测模型。尽管此前的工作(例如统一世界模型)已取得一些进展,但仍存在一个关键局限:这些方法要么从头训练,要么建立在较小的基础模型之上;即使融入了一些先验,也始终缺少完整的知识谱系,缺失来自视觉-语言模型的视觉理解先验或来自视频生成模型的物理交互先验。因此,在一个统一框架内联合建模视觉、语言和动作的各种分布,以获得全面的世界知识,从而实现稳健且可泛化的具身智能,这一非易解决挑战仍未得到解决,而这正是论文工作所要弥补的空白。
挑战 2:异构数据的利用。具身智能的一项核心挑战,是如何有效利用大规模异构数据。不同具身体的动作空间在维度、范围和语义上差异很大;机器人在形态、驱动方式和传感方式上也各不相同。因此,控制信号无法直接复用,策略也难以学习能够跨具身体迁移的通用先验。现有方法尝试通过使用通用骨干网络并注入具身体专属信息,或构建高维动作向量来强行统一不同具身体,以应对这一问题;然而,这些方法仍主要依赖带标注的机器人轨迹,无法将这些数据与缺少动作标注、却蕴含丰富运动和物理交互线索的大规模互联网视频或第一人称人类视频整合起来。这一局限阻碍了对动作专家进行大规模预训练,并削弱了模型学习通用运动先验的能力。
2.2 Motus(Motus)
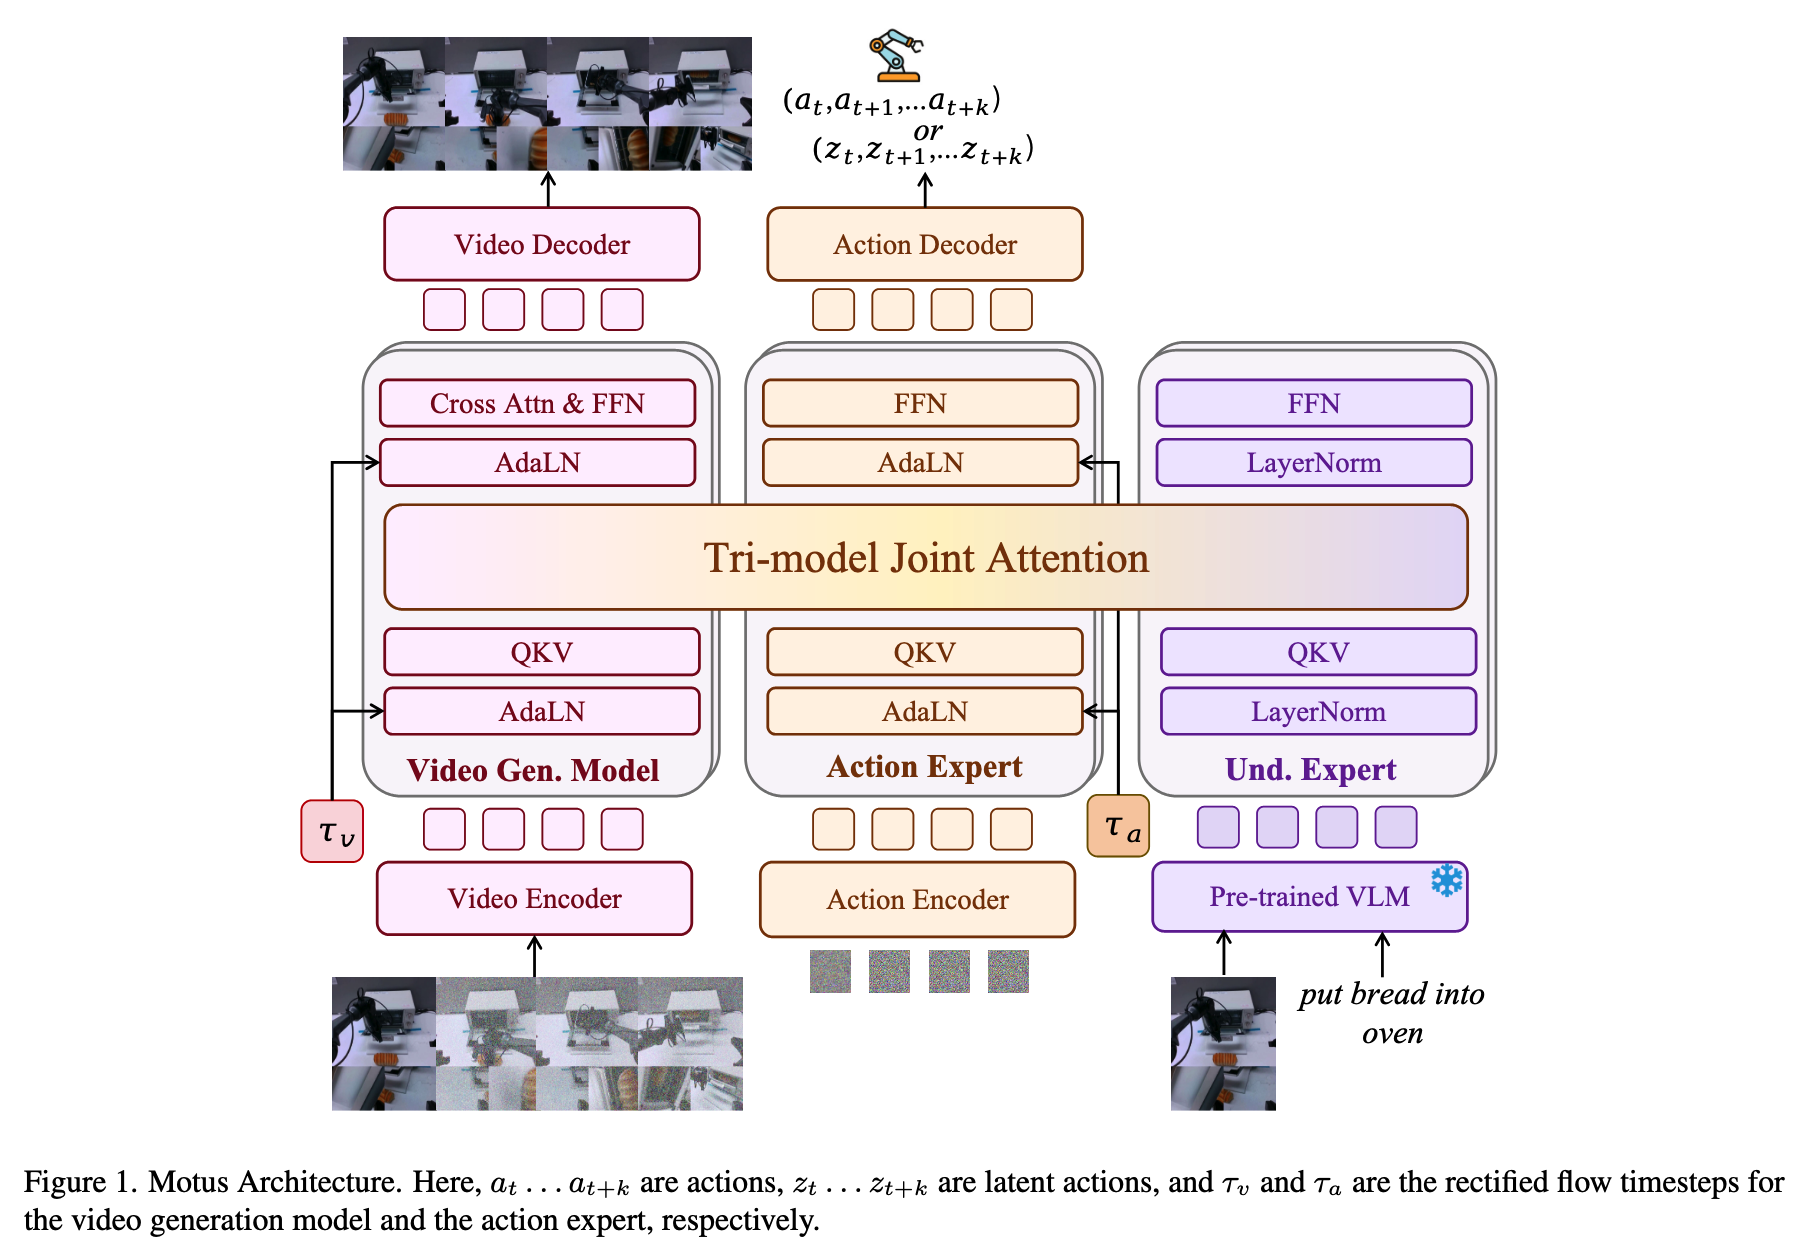
模型架构。为应对前文所述的统一多模态生成能力这一挑战,论文提出 Motus,一种统一的潜在动作世界模型。首先,Motus 被设计为一种通用生成模型,能够在异构多模态数据上联合学习,从而在单个网络中整合通用系统的多种能力,例如对五种分布进行建模。其次,为避免依赖不切实际规模的对齐多模态数据,Motus 利用现有基础模型所蕴含的丰富预训练先验。它采用混合 Transformer(MoT)架构,整合预训练的视频生成模型(生成专家)、配备预训练视觉-语言模型(VLM)的理解专家,以及动作专家(如图 1 所示),从而有效融合各自的优势,包括场景理解、指令解释、结果预测、未来视频想象和动作规划,而不需要从头进行完整的端到端训练。不同于统一世界模型(UWM)将观测 token 和动作 token 简单拼接,并通过一系列包含自注意力层和前馈网络(FFN)层的 UWM 模块处理,论文采用混合 Transformer 结构利用预训练的 VLM 和视频生成模型。在论文模型中,每个专家都保留独立的 Transformer 模块,同时将多头自注意力层进行拼接,这种设计称为三模型联合注意力(Tri-model Joint Attention)。这种设计不仅保留了各专家不同的功能,避免任务间干扰,还能有效融合跨模态特征,促使不同的预训练知识互相补充。
训练期间,Motus 通过基于修正流的目标函数联合预测视频块和动作块:
l θ a c t i o n = E ( o t : t + k , a t + 1 : t + k , ℓ ) ∼ D E τ a ∼ U ( 0 , T τ ) E ϵ a ∼ N ( 0 , I ) ∥ v θ a − ( ϵ a − a t + 1 : t + k ) ∥ 2 2 , l_{\theta}^{action} = \mathbb{E}_{(o_{t:t+k},a_{t+1:t+k},\ell)\sim D} \mathbb{E}_{\tau_a\sim U(0,T_{\tau})} \mathbb{E}_{\epsilon_a\sim N(0,I)} \left\|v_{\theta}^{a}-(\epsilon_a-a_{t+1:t+k})\right\|_2^2, lθaction=E(ot:t+k,at+1:t+k,ℓ)∼DEτa∼U(0,Tτ)Eϵa∼N(0,I)∥vθa−(ϵa−at+1:t+k)∥22,
l θ o b s = E ( o t : t + k , a t + 1 : t + k , ℓ ) ∼ D E τ o ∼ U ( 0 , T τ ) E ϵ o ∼ N ( 0 , I ) ∥ v θ o − ( ϵ o − o t + 1 : t + k ) ∥ 2 2 , l_{\theta}^{obs} = \mathbb{E}_{(o_{t:t+k},a_{t+1:t+k},\ell)\sim D} \mathbb{E}_{\tau_o\sim U(0,T_{\tau})} \mathbb{E}_{\epsilon_o\sim N(0,I)} \left\|v_{\theta}^{o}-(\epsilon_o-o_{t+1:t+k})\right\|_2^2, lθobs=E(ot:t+k,at+1:t+k,ℓ)∼DEτo∼U(0,Tτ)Eϵo∼N(0,I)∥vθo−(ϵo−ot+1:t+k)∥22,
l θ = l θ a c t i o n + l θ o b s . l_{\theta}=l_{\theta}^{action}+l_{\theta}^{obs}. lθ=lθaction+lθobs.
其中, o t o_t ot 是条件帧, o t + 1 : t + k o_{t+1:t+k} ot+1:t+k 和 a t + 1 : t + k a_{t+1:t+k} at+1:t+k 分别是后续观测和动作; τ a \tau_a τa 和 τ o \tau_o τo 分别是分配给动作和观测的时间步; ϵ a \epsilon_a ϵa 和 ϵ o \epsilon_o ϵo 是采样得到的高斯噪声; v θ a v_{\theta}^{a} vθa 和 v θ o v_{\theta}^{o} vθo 是模型预测的速度场; l θ a c t i o n l_{\theta}^{action} lθaction 和 l θ o b s l_{\theta}^{obs} lθobs 分别是动作和观测的损失。通过为视频和动作分别分配不同的时间步和噪声尺度,Motus 建立了类似 UniDiffuser 的调度器,以捕捉异构数据分布,并在推理时自适应地切换不同的具身基础模型模式,例如视觉-语言-动作模型、世界模型、逆动力学模型、视频生成模型和联合预测模型。由此得到的模型能够在统一的多模态架构中理解场景、遵循指令、预测结果、想象未来并输出动作。
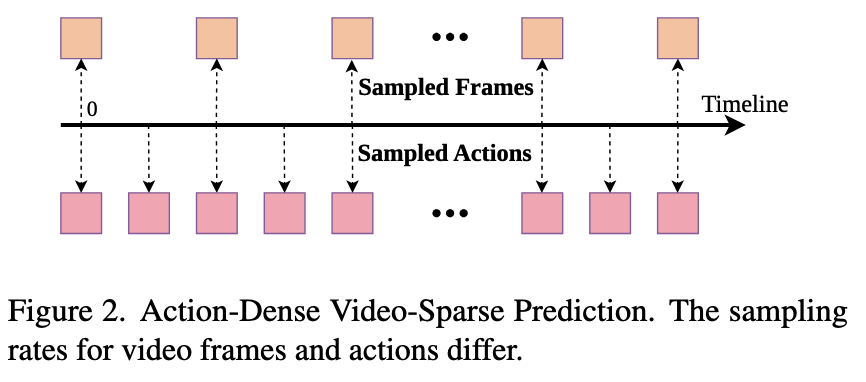
动作密集、视频稀疏的预测(Action-Dense Video-Sparse Prediction.) 如图 2 所示,由于论文模型采用了广泛使用的动作分块技术,Motus 需要预测未来的视频序列和动作序列块 o t + 1 : t + k o_{t+1:t+k} ot+1:t+k、 a t + 1 : t + k a_{t+1:t+k} at+1:t+k。这会带来几个问题:(1)训练和推理效率较低;(2)视频帧预测冗余;(3)三模态联合注意力机制不平衡——视频 token 的数量远多于动作 token。此种不平衡会使模型过拟合视频预测,从而削弱其动作预测能力。为解决这些问题,论文提出“动作密集、视频稀疏预测”策略,如图 2 所示。在训练和推理期间,论文对视频帧进行下采样,使视频 token 与动作 token 的数量保持平衡;例如,将视频帧率设为动作帧率的六分之一。
专家细节(Experts Details.)。对于生成专家,论文采用 Wan 2.2 5B 作为视频基础模型,因为该模型易于获取和使用。论文扩展其自注意力上下文,以构建跨模态三模型联合注意力机制。对于动作专家,论文构建了一个与 Wan 深度相同的 Transformer 模块。每个模块包含用于注入整流流时间步的 AdaLN、一个前馈网络(FFN)以及用于跨专家交互的三模型联合注意力。论文选择 Qwen3-VL-2B 作为理解专家,因为它具备 3D 定位、空间理解和精确物体定位等能力,这些能力对于机器人操作至关重要。输入该专家的是视觉-语言模型最后一层对应的 token。理解专家本身由若干 Transformer 模块构成,每个模块包含层归一化、一个前馈网络和三模型联合注意力。
2.3 潜在动作(Latent Actions)
为应对挑战 2,即利用大规模异构数据,论文进一步提出直接从视觉动态中学习通用动作模式。具体而言,论文引入潜在动作,以编码直接从像素中学习到的运动信息。这些潜在动作使模型能够从多种数据源中吸收运动知识,例如互联网视频、第一人称人类演示和多机器人轨迹,从而即使在没有明确动作标签的数据上,也能加强对动作专家的预训练。
基于光流的表示。论文采用光流作为自然的运动表示,它能够捕捉连续帧之间像素级的位移。具体而言,论文使用 DPFlow 计算光流,并将其转换为 RGB 图像。为将这种高维表示压缩到控制级空间,论文采用深度卷积变分自编码器(DC-AE)重建光流,并将其编码为四个 512 维 token。随后,一个轻量级编码器将这四个 512 维特征拼接后投影为一个 14 维向量,其维度大致与常见机器人动作空间相当。整体架构如图 3 所示。这种维度对应关系确保潜在表示能够自然地与真实机器人控制对齐,并作为连接感知与动作的桥梁。
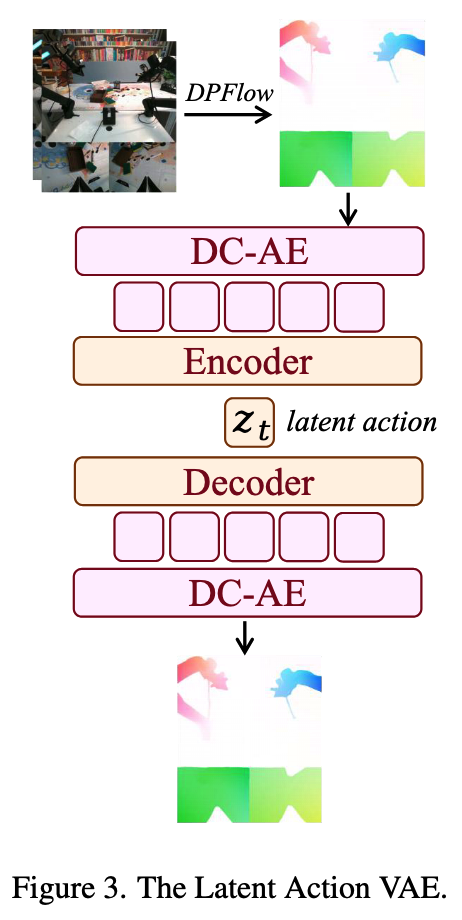
训练与分布对齐。为使潜在空间与真实动作空间对齐,论文按照 AnyPos 的方法引入任务无关数据。具体而言,任务无关数据使用 Curobo,以任务无关的方式随机采样目标机器人的动作空间,收集图像-动作对。这些数据提供了额外的真实动作监督,帮助变分自编码器学习能够反映可行运动行为的嵌入,并使潜在动作锚定于真实控制分布。
训练期间,论文混合使用 90% 的无标注数据进行自监督重建,以及 10% 的带标注轨迹进行弱动作监督;带标注数据包括任务无关数据和标准机器人演示。维度对应关系与弱动作监督共同促使潜在动作分布与真实动作分布对齐,使从视频中学习到的运动先验能够自然映射到可执行控制。
总损失由重建、对齐和 KL 正则化三部分组成:
L = L r e c o n + λ a ∥ a r e a l − a p r e d ∥ 2 + β L K L , ( 2 ) L=L^{recon}+\lambda_a\left\|a^{real}-a^{pred}\right\|^2+\beta L_{KL}, \quad(2) L=Lrecon+λa areal−apred 2+βLKL,(2)
其中, L r e c o n L^{recon} Lrecon 用于最小化光流重建误差,第二项用于对齐潜在动作与真实动作, L K L L_{KL} LKL 用于正则化潜在空间; λ a \lambda_a λa 和 β \beta β 是超参数。
2.4 模型训练与数据(Model Training and Data)
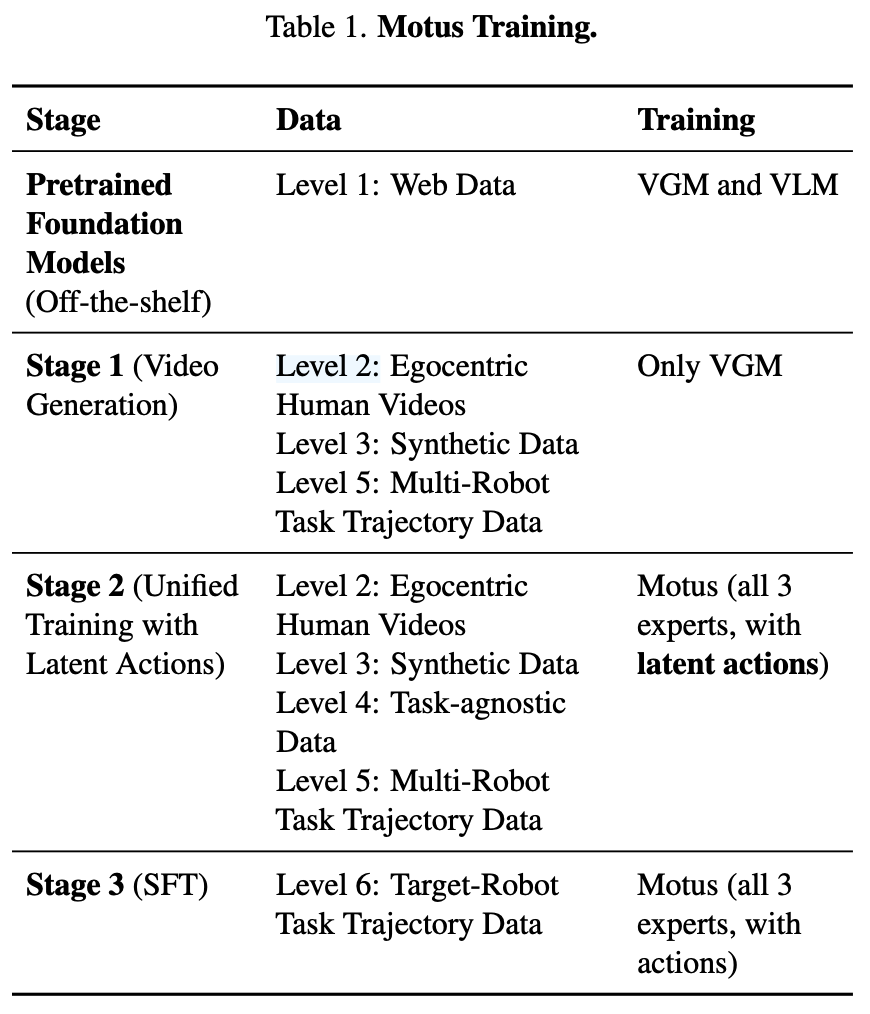
Motus 训练。Motus 通过三个阶段进行训练(表 1),逐步将来自多样化数据集的物理交互先验融入能够迁移到目标机器人的策略中。每个阶段分别应对一项关键挑战:
阶段 1:学习视觉动态。为使模型掌握真实物理交互的特点,论文首先使用多机器人轨迹和人类视频对视频生成模型(VGM)进行适配。这样能够使视频生成模型根据语言指令和初始图像,生成合理的任务未来视频序列。
阶段 2:学习动作表示。为连接视觉预测与控制,论文在视频、语言和潜在动作上对整个 Motus 模型进行预训练,其中 VLM 保持冻结。该阶段通过在潜在动作空间中嵌入运动和交互知识,为动作专家提供初始化。
阶段 3:针对目标机器人进行专门化。最后,论文使用目标机器人的数据对模型进行微调,确保先前获得的先验能够充分适配特定具身体的动力学和运动学特性。
数据。为使机器人具备通用操作技能,论文利用大规模多模态数据,这些数据包含丰富的先验知识,涵盖语义理解、物理推理、时空动态和决策等方面。如前文所述,具身数据天然包含多种模态:语言 ℓ \ell ℓ、图像 o o o 和动作 a a a。根据这些模态是否存在,论文系统地识别出所有有意义的数据类型:
- 语言、图像和动作:机器人轨迹,例如视觉-语言-动作模型所使用的轨迹, { ℓ , o 1 , a 1 , … , o N , a N } \{\ell,o_1,a_1,\ldots,o_N,a_N\} {ℓ,o1,a1,…,oN,aN}。
- 语言和图像:视频序列 { ℓ , o 1 , … , o N } \{\ell,o_1,\ldots,o_N\} {ℓ,o1,…,oN} 或图像-文本对 { ( o , ℓ ) } \{(o,\ell)\} {(o,ℓ)}。
- 图像和动作:任务无关的交互数据 { ( o 1 , a 1 , … , o i , a i ) } \{(o_1,a_1,\ldots,o_i,a_i)\} {(o1,a1,…,oi,ai)}。
- 仅含语言:文本语料 { ℓ } \{\ell\} {ℓ}。
论文排除缺少视觉模态的数据,例如语言与动作数据,因为这类数据不适用于视觉运动策略学习。其余数据类型构成了具身策略学习可用数据来源的完整范围。为组织这些数据,论文提出具身数据金字塔(图 4),按照数据丰富程度和策略相关性对数据类型进行分层。论文框架通过针对不同训练阶段设计的方案,有效整合并对齐全部六层数据,从规模庞大但间接的网络数据,到针对性强的机器人演示数据(表 1),并将异构数据集统一到单一、连贯的模型架构中。
2.5 结论
论文提出了 Motus,一种统一的潜在动作世界模型,将具身基础模型的主流能力整合进单一生成框架,包括视觉-语言理解、视频生成、逆动力学、世界建模和视频-动作联合预测。通过 MoT 连接预训练专家、采用类似 UniDiffuser 的调度器协调多模态建模,并引入作为像素级“增量动作”和运动表示的潜在动作,Motus 能够有效利用大规模异构数据进行学习,并继承通用多模态先验和丰富的物理交互知识。在仿真和真实环境中开展的大量实验表明,Motus 始终优于现有最先进的具身模型:在仿真中提升了 + 15 ∼ 45 % +15\sim45\% +15∼45%,在真实场景中提升了 + 11 ∼ 48 % +11\sim48\% +11∼48%。这些结果验证了统一多模态生成能力和共享运动先验的重要性。论文希望 Motus 能够启发未来在统一架构、以运动为中心的表示学习以及大规模具身预训练方面的研究。未来,论文将继续探索更先进的统一模型架构,寻求更通用的运动先验,并从互联网规模的通用视频中学习潜在动作,以服务于具身智能。
三、论文实验部分 🧪
3.1 实施细节
论文在仿真环境和真实场景中开展了大量实验,以评估 Motus 的有效性。
论文将 Motus 与若干最先进方法进行比较: π 0.5 \pi^{0.5} π0.5 和 X-VLA。论文在仿真环境中评估所有模型,并进一步在真实任务中评估基线模型 π 0.5 \pi^{0.5} π0.5。论文还将从头训练的模型和仅经过阶段 1 训练的模型与 Motus 进行了比较。
3.2 仿真环境评估
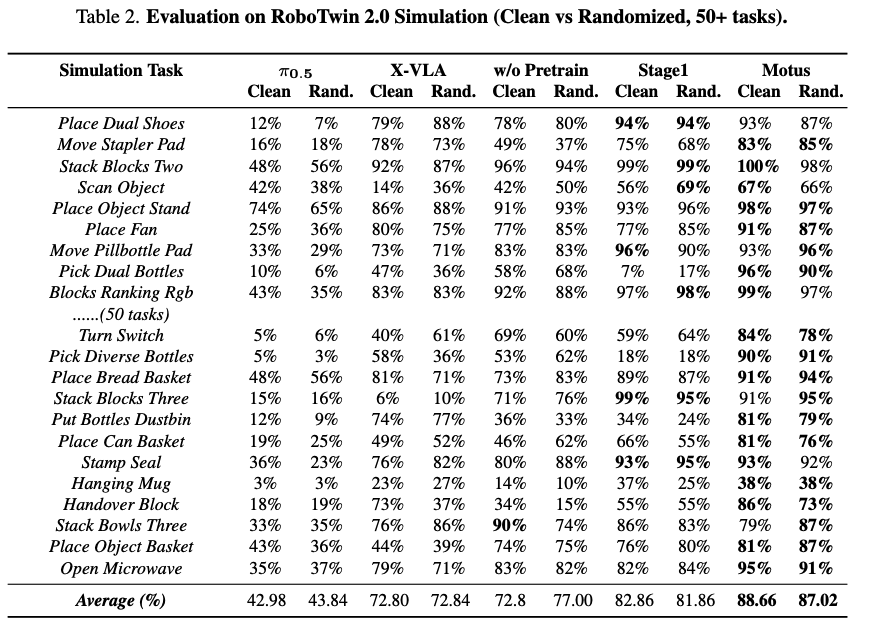
论文在 RoboTwin 2.0 的 50 个具有代表性的操作任务上评估单任务表现,并在随机化场景中进行测试。为探查方法的通用能力,论文采用多任务训练:Motus 和所有基线模型都在 2,500 条于干净场景中采集的演示数据(每个任务 50 条),以及 25,000 条于高度随机化场景中采集的演示数据(每个任务 500 条)上训练。随机化因素包括随机背景、杂乱的桌面、桌面高度扰动以及随机光照。所有模型均从各自的预训练检查点开始,在 RoboTwin 数据集上微调 40,000 步,并通过每项任务 100 次执行试验的成功率来评估表现。
这一基准测试具有较高难度,也能有效评估方法,因为它包含丰富多样的任务场景和随机化指令,可检验模型在多种操作环境中的应对能力。场景和环境具有较强的变化性,也能进一步评估模型在分布偏移下的泛化能力。此外,所有模型在各自预训练检查点的基础上都只能进行 40,000 步微调,因此能够严格且公平地评估不同预训练策略的有效性。
如表 2 所示,在 RoboTwin 2.0 随机化多任务设置中,Motus 达到了最先进的表现,相较于 π 0.5 \pi^{0.5} π0.5 模型取得了超过 45% 的绝对提升。通过采用统一的 MoT 模型,Motus 成功整合了视觉、语言和动作生成,从而应对挑战 1。针对挑战 2,引入潜在动作使 Motus 能够有效利用带标注和大规模无标注数据,提升跨具身体的泛化能力,并捕捉丰富的运动先验。这些技术的结合使 Motus 克服了以往方法的局限,并取得了更优的表现。
3.3 真实场景实验
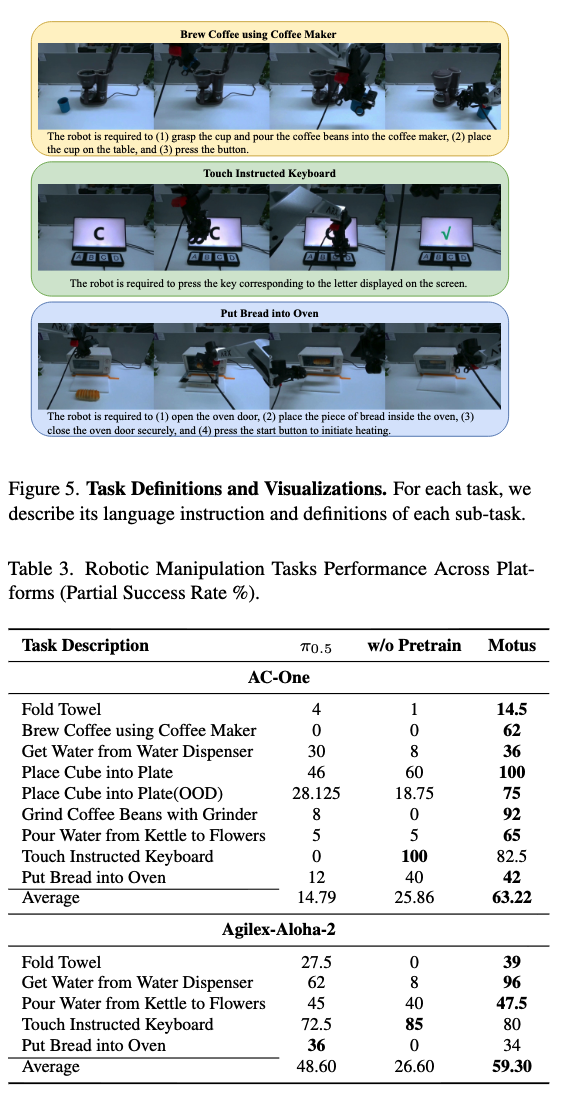
论文在两种不同的真实世界双臂机器人平台 AC-One 和 Agilex-Aloha-2 上评估 Motus。实验任务具有较高难度,涵盖策略能力的多个方面,包括空间理解、可变形物体操作、精细流体控制、视觉理解和长时序规划,例如折叠毛巾、使用滴滤式咖啡机冲煮咖啡,以及使用研磨机研磨咖啡豆。
每项任务均使用 100 条轨迹进行训练。与仿真实验一致,论文采用多任务联合训练方案:每个平台上的所有任务都在同一个模型中联合训练,随后使用该模型逐项评估任务。这种方法能够全面、严格地评估模型的鲁棒性和泛化能力。
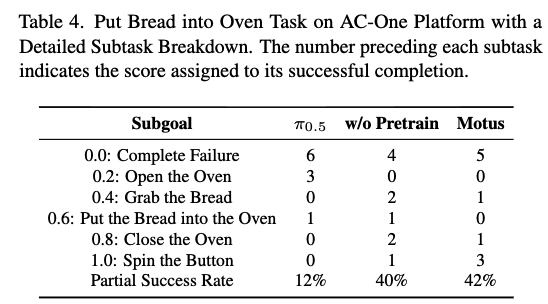
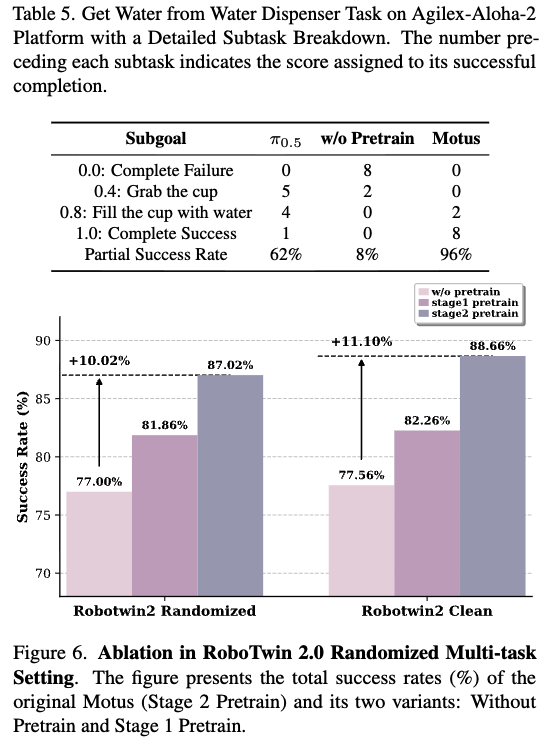
论文选择 π 0.5 \pi^{0.5} π0.5 作为基线。由于大多数任务涉及长时序推理,且可以分解为多个子任务,论文采用部分成功率进行评估。该指标将任务分解为若干子任务:模型完成特定子目标即可获得部分分数,只有完成整个任务才能获得满分,因此能够更有说服力地展示模型的能力。相关示例见表 6 和表 5。
实验结果见表 3。结果表明,Motus 在两个机器人平台的所有任务上均显著优于基线 π 0.5 \pi^{0.5} π0.5。图 5 展示了部分结果。
3.4 消融实验( Ablation Study)
论文开展了消融研究,以验证各训练阶段的贡献。研究对未经过预训练的模型和仅经过阶段 1 预训练的模型进行了基准评估。在仿真环境中,论文通过 RoboTwin 2.0 测量准确率;在真实场景部署中,则将 Motus 与从头训练的对应模型进行比较。仿真结果总结于图 6,真实场景实验结果见表 3。
B. 泛化能力如何随场景数量变化?
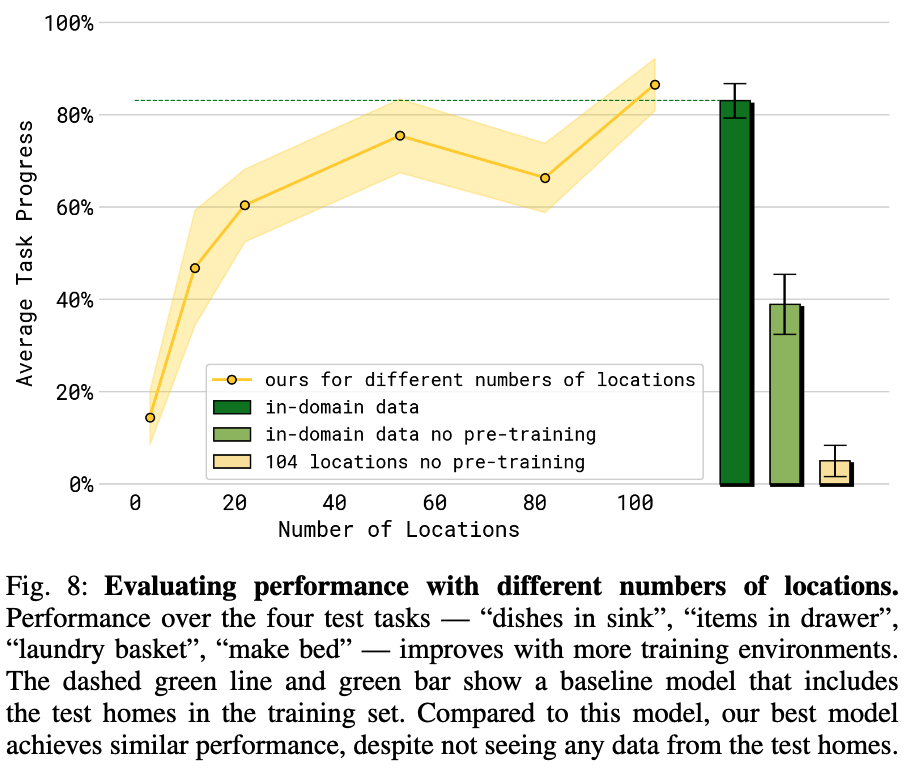
在下一组实验中,本文旨在测量泛化能力如何随训练数据中环境数量的变化而改变。本文改变移动操作数据中的环境数量,并通过分别使用来自3、12、22、53、82和104个地点的数据进行训练,测量其对泛化能力的影响。由于对每个数据集完整应用预训练和后训练方案的计算成本过高,这些实验先在不含移动操作数据的机器人动作预测数据混合集上进行预训练,再比较使用不同数量环境中的移动操作数据进行后训练所得的模型。原则上,按地点划分的数据集规模并不相同;但实际上,训练步数设为40k,使每个模型都能看到相同数量的独立数据样本,从而在改变训练地点数量时控制数据集规模。
每个模型都在图6所示的模拟环境中接受评估,这些环境未出现在训练数据中。本文进行了两类评估。第一,为评估模型在多阶段任务上的总体表现,使用附录B中的标准评分标准和模拟测试家庭,对每个模型执行端到端评估,任务包括将餐具放入水槽、将物品放入抽屉、收拾衣物和整理床铺。第二,对每个模型遵循语言指令和与新物体互动的能力进行更细致的评估:机器人需要根据语言指令,从厨房台面上拿起指定物体。这些实验既使用训练数据中包含的相近类别物体(但具体物体实例是新的),也使用训练中未见过类别的分布外物体。后一种评估要求模型具备广泛的语义泛化能力。
第一项实验的结果见图8。各项任务的平均表现总体上随训练地点数量增加而提高。为量化最终模型(使用104个地点训练)弥合了多少泛化差距,本文还加入一个对照模型(图中以绿色显示),其训练数据直接包含测试家庭。该对照模型的表现与最终的104地点模型相近,这表明本文的协同训练方案能够有效实现广泛泛化,使模型达到与使用测试环境数据训练的模型相近的表现。为确认这种泛化表现确实依赖完整的协同训练方案,本文还加入两个基线模型:它们在预训练阶段不使用任何其他协同训练任务,而是分别仅使用测试环境数据或104个训练地点的移动操作数据进行直接训练。两个基线模型的表现都显著较差,这表明即使策略接触过来自测试家庭的机器人数据,要实现良好泛化,本文所利用的其他数据源仍然至关重要。在训练中不使用测试家庭数据时,从图8中绿色柱与浅黄色柱之间的显著差距可以看出,按照本文方案进行预训练尤为重要。
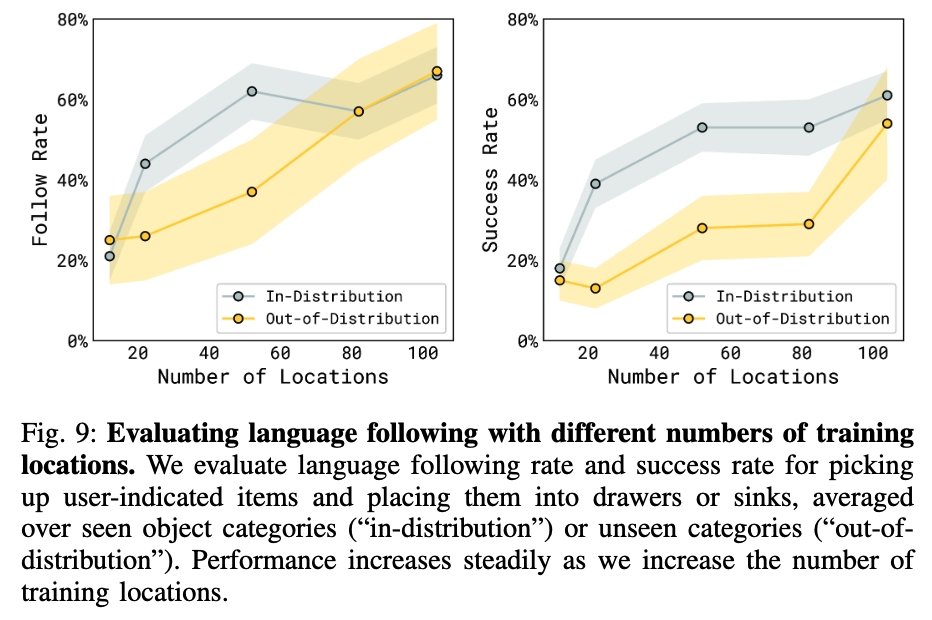
第二项实验(语言指令遵循)的结果见图9。本文报告语言指令遵循率和成功率:前者衡量机器人选择指令指定物体的频率,后者衡量机器人成功将该物体放到正确位置的频率;正确位置为抽屉或水槽,具体取决于测试场景。本文分别报告训练中出现过的物体类别(分布内,但物体实例是新的)和未出现过的物体类别(分布外)上的表现。该实验的详情见附录C。图9显示,随着训练数据中的地点数量增加,语言指令遵循表现和成功率均有所提高。正如预期,分布内物体上的表现提升速度快于分布外物体。每个新环境都会引入新的家居物品,因此随着训练环境增加,模型变得更加稳健,并开始泛化到训练数据中未出现过的任务类别。
C. 协同训练方案的各个部分有多重要?
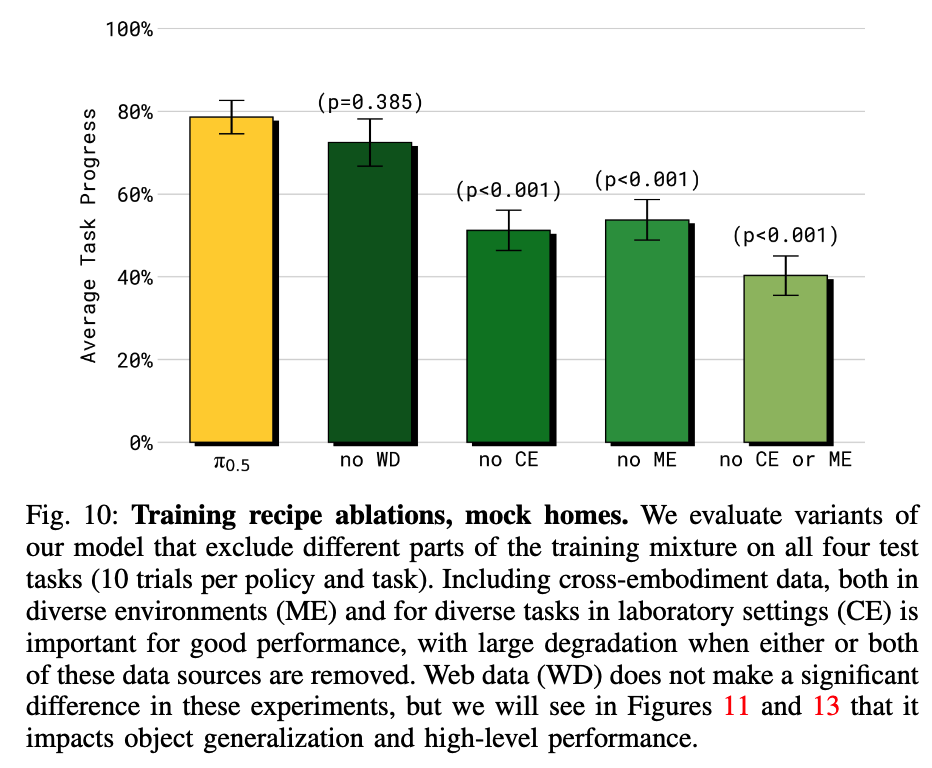
为研究问题(3),本文将完整的 π 0.5 \pi_{0.5} π0.5 模型与其他训练数据组合进行比较,并使用模拟家庭任务的端到端表现,以及第V-B节所述的语言指令遵循评估。回顾一下,完整方案使用来自多个环境中移动操作机器人(MM)、多个环境中固定式机械臂(ME)和实验室环境中多种具身平台(CE)的数据。方案还包括高层语言指令预测数据(HL),以及用于图像描述、视觉问答和物体定位的网络数据(WD)。后训练阶段还使用口头指令数据(VI),其作用将在第V-E节分析。本文进行了以下数据混合消融实验:
- 1)不使用 WD:不包含网络数据;
- 2)不使用 ME:不包含多环境非移动机器人数据;
- 3)不使用 CE:不包含实验室跨具身数据;
- 4)不使用 ME 或 CE:不包含来自其他机器人的数据,模型仅使用目标移动操作平台的数据和网络数据进行训练。
完整模拟家庭任务的结果见图10(各任务表现的详细分解见附录D)。首先,结果表明,去除任一跨具身数据来源(ME 或 CE)都会显著降低表现,说明 π 0.5 \pi_{0.5} π0.5 能从跨具身迁移中显著受益,包括从其他环境中的机器人数据,以及从其他任务中的数据进行迁移。若同时去除这两类数据,表现会进一步下降。有趣的是,在这项实验中,不使用网络数据(不使用 WD)的模型与完整模型之间的表现差异没有达到统计显著;不过,后文将看到,网络数据会影响物体泛化能力和高层表现。图11所示的语言指令遵循实验结果呈现出与图10类似的趋势:去除 ME 和/或 CE 数据会导致表现显著下降。不同之处在于,去除网络数据(不使用 WD)会显著降低模型在分布外物体上的表现。本文推测,网络数据涵盖了关于各类实体物体的广泛知识,因此通过网络数据训练,模型能够理解并遵循涉及训练中未见物体类别的语言指令。
D. π 0.5 \pi_{0.5} π0.5 与其他 VLA 相比表现如何?
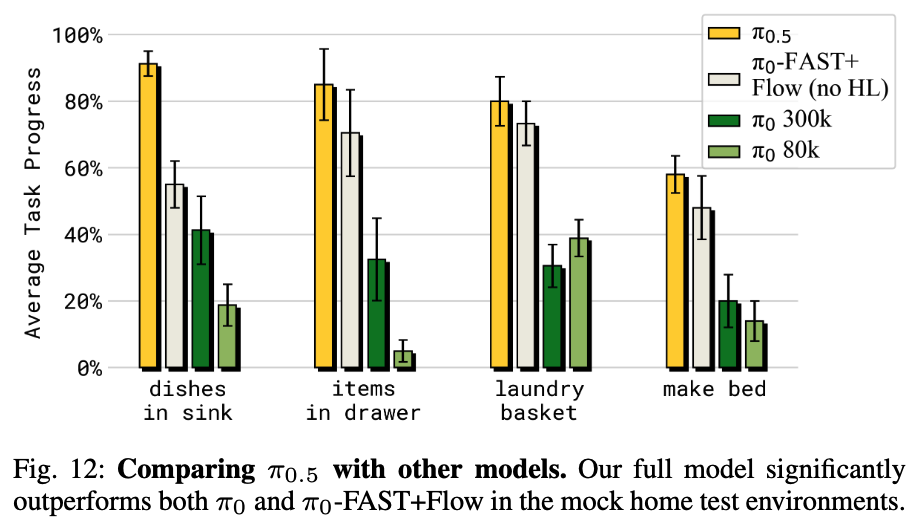
本文将 π 0.5 \pi_{0.5} π0.5 与原始 π 0 \pi_0 π0 VLA,以及一个改进版 π 0 \pi_0 π0 模型进行比较,后者记为 π 0 \pi_0 π0-FAST+Flow。该版本采用式(1)中的联合扩散和 FAST 动作预测方案进行训练,但仅使用动作数据,不使用 HL 或 WD 数据。这些模型提供了有力的比较基准,因为已有研究表明 π 0 \pi_0 π0 在复杂灵巧的移动操作任务上表现出色,而 π 0 \pi_0 π0-FAST+Flow 则通过改进,使其训练方案尽可能接近 π 0.5 \pi_{0.5} π0.5。本文在这些模型的基础上,通过组合多种协同训练任务构建 π 0.5 \pi_{0.5} π0.5。为确保公平比较,所有模型都使用相同的跨具身机器人训练集,训练步数也大致相当。因此,模型之间的差异在于:(1) π 0.5 \pi_{0.5} π0.5 额外使用 HL 和 WD 数据;(2) π 0.5 \pi_{0.5} π0.5 采用混合训练方案,预训练阶段使用离散标记,后训练阶段只使用流匹配动作专家;而 π 0 \pi_0 π0 始终使用动作专家;(3) π 0 \pi_0 π0-FAST+Flow 遵循混合训练方案,但只使用包含机器人动作的数据,因此不具备高层推理能力。图12的结果表明, π 0.5 \pi_{0.5} π0.5 显著优于 π 0 \pi_0 π0 和本文改进的模型。即使允许 π 0 \pi_0 π0 延长训练时间,最多训练300k步,结果仍然如此。这进一步证实,与已有研究的发现一致,使用 FAST 标记进行训练,在计算效率方面优于纯扩散训练。
E. 高层推理有多重要?
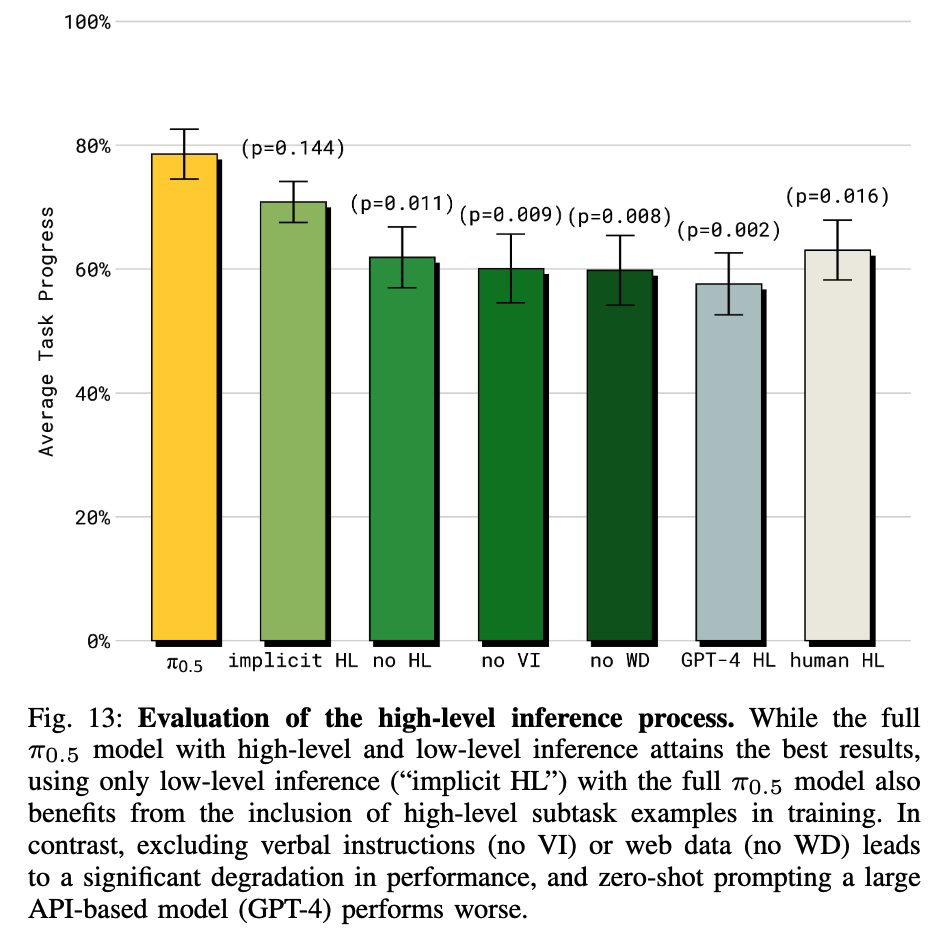
最后,本文评估高层推理的重要性,并比较多种替代的高层推理方法。 π 0.5 \pi_{0.5} π0.5 的高层推理机制接收高层指令(例如“整理卧室”),并输出要完成的子任务(例如“拿起枕头”),随后将该子任务作为低层动作推理的上下文,与思维链推理类似。虽然 π 0.5 \pi_{0.5} π0.5 使用统一架构,由同一个模型执行高层和低层推理,但也可以构建基线方法:一种方法取消高层推理,直接将任务提示输入低层系统,这与标准 VLA 模型的常见做法相同;另一种方法则使用不同模型进行高层推理,以消融分析不同数据集成分对高层策略的影响。本文考虑以下方法和消融设置,所有方法均使用完整的 π 0.5 \pi_{0.5} π0.5 低层推理流程,但高层策略有所不同:
- 1)使用 π 0.5 \pi_{0.5} π0.5 模型进行高层和低层推理;
- 2)不使用 WD: π 0.5 \pi_{0.5} π0.5 的消融版本,不包含网络数据;
- 3)不使用 VI: π 0.5 \pi_{0.5} π0.5 的消融版本,不包含口头指令数据;
- 4)隐式 HL:运行时不进行高层推理,但训练时包含高层数据;这些数据可能使模型隐式地习得子任务知识;
- 5)不使用 HL:不进行高层推理,训练时也不包含任何高层数据;
- 6)GPT-4:使用 GPT-4 作为高层策略,为使其适应本文的领域,向 GPT-4 提供任务描述和最常用标签列表,并要求其从中选择;
- 7)人工 HL:由专家人工充当“预言机”高层策略,以提供性能上界。
这些实验的结果见图13。完整的 π 0.5 \pi_{0.5} π0.5 模型表现最好,甚至优于人工 HL“预言机”基线。或许令人意外的是,表现第二好的模型是隐式 HL 消融版本:它在运行时不执行任何高层推理,但训练中包含完整的数据组合,也包括子任务预测数据。这有力表明了本文协同训练方案的重要性:显式推断高层子任务确实有益,但只需将子任务预测数据纳入训练组合,就已经能够获得其中相当一部分收益。不使用 HL 的消融版本在训练中也排除了 HL 任务,表现显著较差。实验还表明,规模相对较小的口头指令数据至关重要;它只占移动操作高层样例的约11%,但不使用 VI 的模型表现显著较弱。不使用 WD 的模型表现也显著较差,这表明网络数据的许多益处(或许并不令人意外)体现在提升高层策略上。最后,零样本提示 GPT-4 的消融版本表现最差,这说明使用机器人数据对视觉—语言模型进行适配至关重要。各任务表现的详细分解见附录D、图17。
四、论文代码解读 💻
待补充。
写在最后
由于笔者🖊️精力有限且本文更多的目的是通过📒博客记录学习过程并分享更多知识,因此文中部分描述不太具体,如有不太理解💫的地方可在评论区👀留言。非特殊赶deadline⏰或假期⛱️期间,笔者会经常上线回复💬。如有不便之处,请海涵~
如果想了解更多关于3DGS的加速⏰压缩⚡️新工作,可以关注笔者的Github仓库:Awesome-3DGS-Compress-Accelerate。
另外,创造不易,转载请注明出处💗💗💗~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献7条内容

所有评论(0)