HuRo:将人类视频转化为机器人数据,实现可扩展的 VLA 预训练
26年8月来自韩国rlwrld.ai公司和延世大学的论文“HuRo: Robotizing Human Videos for Scalable VLA Pretraining”。
本文研究如何将人类操作视频转换成机器人训练数据。它的重要贡献是建立并验证了一条大规模数据生产路线;实验支持其预训练价值,但尚不能说明生成的数据具有可靠的物理可执行性。
一、论文概述
机器人训练面临一个现实问题:真实机器人示范昂贵,人类操作视频却很丰富。但人类与机器人在外观、身体结构、关节和动作空间上存在差异,不能直接把人类视频当作机器人示范。
HuRo 的做法是对视频进行“机器人化”:
画面转换:擦除人的手臂,再叠加渲染的机器人。
动作转换:恢复人手的三维运动,映射为机器人的手腕与手指运动。
语言标注:生成描述操作内容的指令。
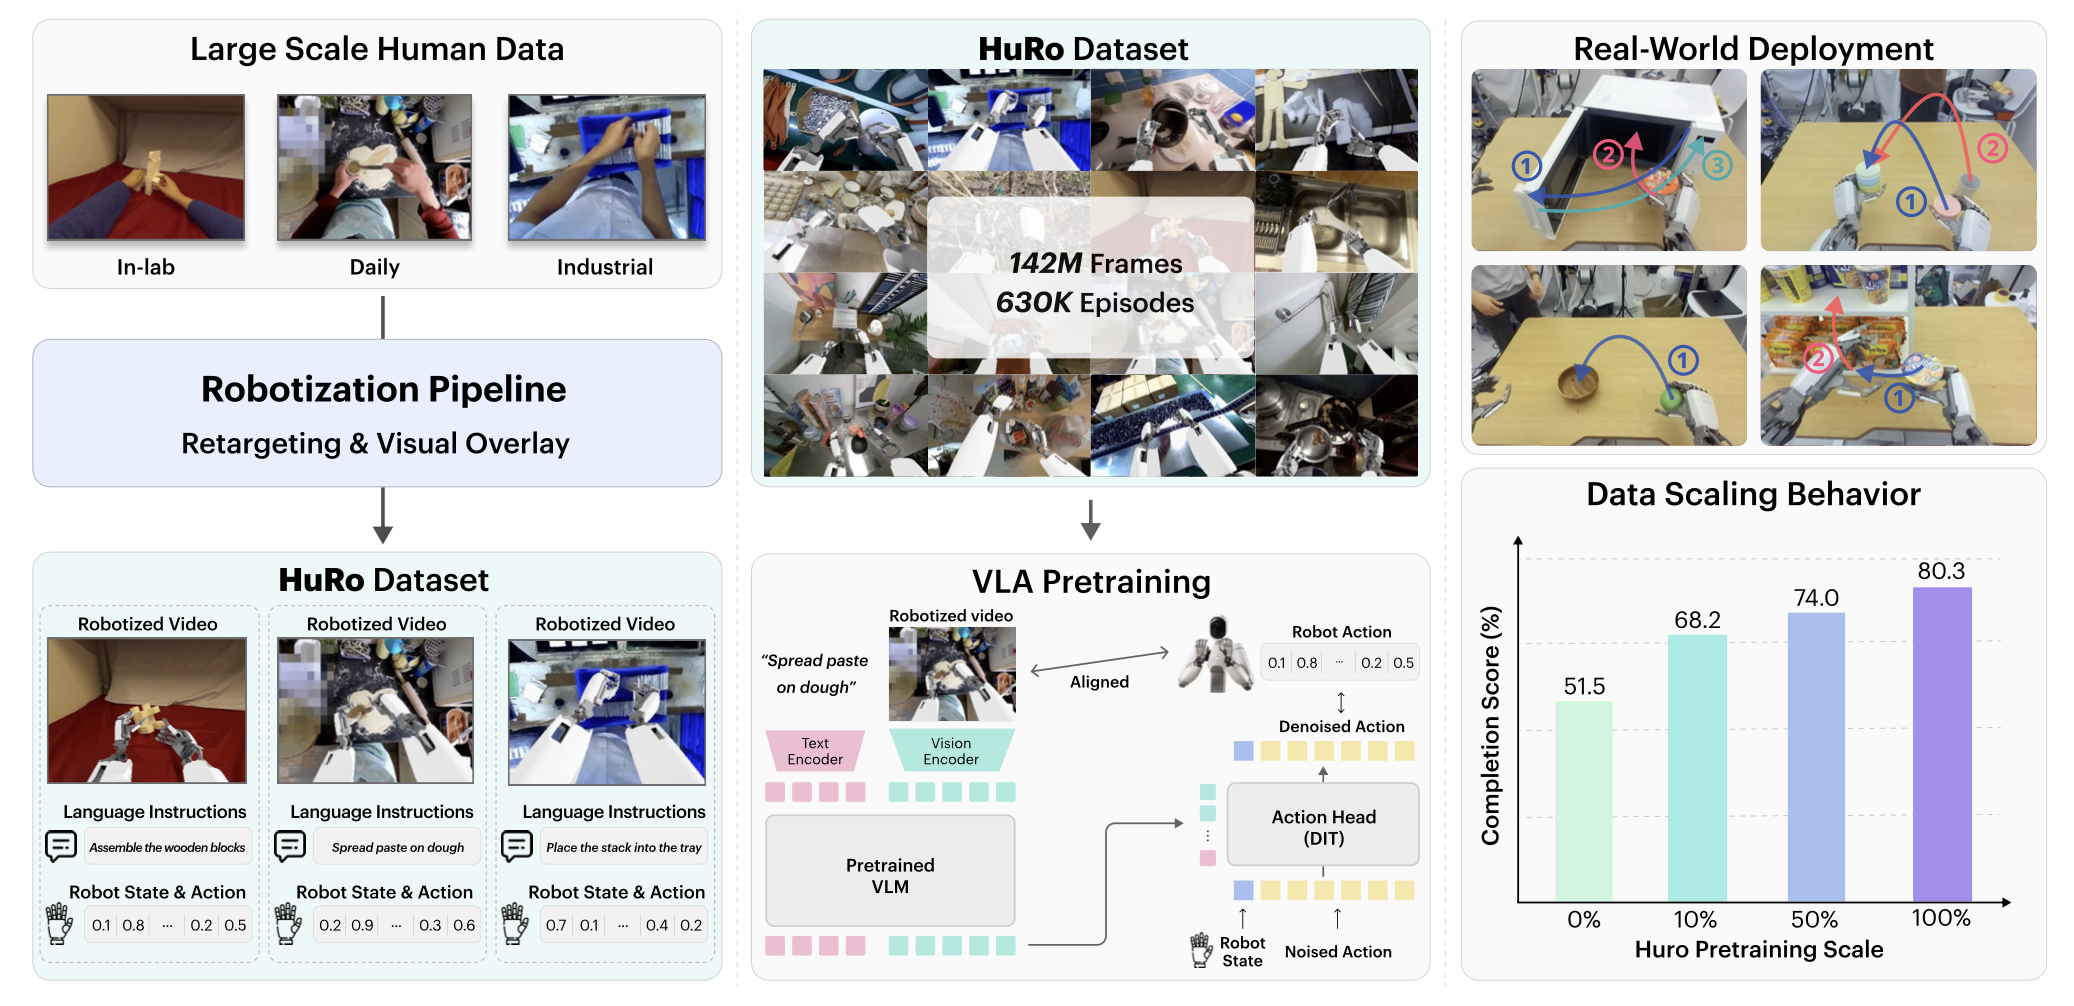
最终得到“图像—语言—机器人状态—动作”配对数据,用于视觉—语言—动作模型(VLA)预训练,再用少量真实机器人示范微调。作者整合五个人类视频数据源,构建了约 63 万条片段、1.422 亿帧、1,317 小时的数据集。
如图 1 所示面向现实世界操作任务的 HuRo 预训练概览。利用“视觉机器人叠加”(visual robot overlay)和“动作重定向”(motion retargeting)技术,将海量人类活动视频转化为机器人操作片段。由此生成的片段包含语言指令、机器人状态及动作数据,可用于 VLA 策略的预训练。在经过下游微调后,基于更大规模 HuRo 子集预训练的策略在现实世界操作任务中展现出了更优的性能。
二、主要想法:同时对齐“看到的身体”和“要执行的动作”
论文认为,仅从人类视频中学习视觉知识,或者只提取动作而保留人类画面,都没有充分解决人机差异。
其方法可以概括为:
人类视频 → 恢复相机与手部运动 → 映射机器人动作 → 生成对应机器人画面 → VLA 预训练。
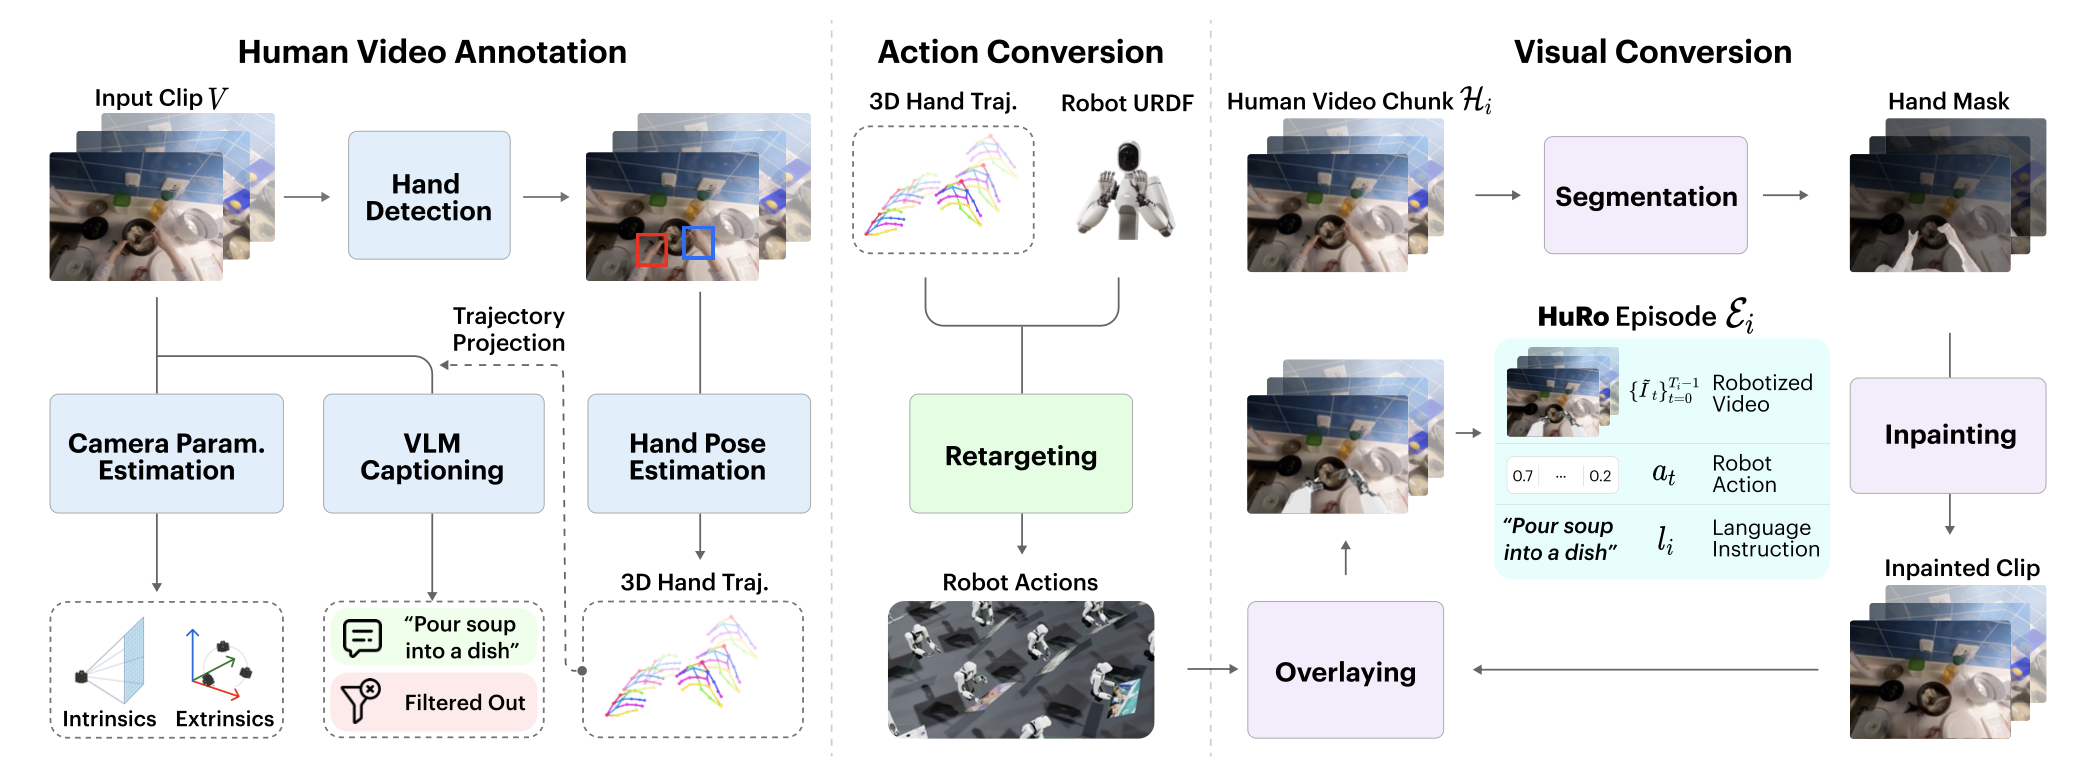
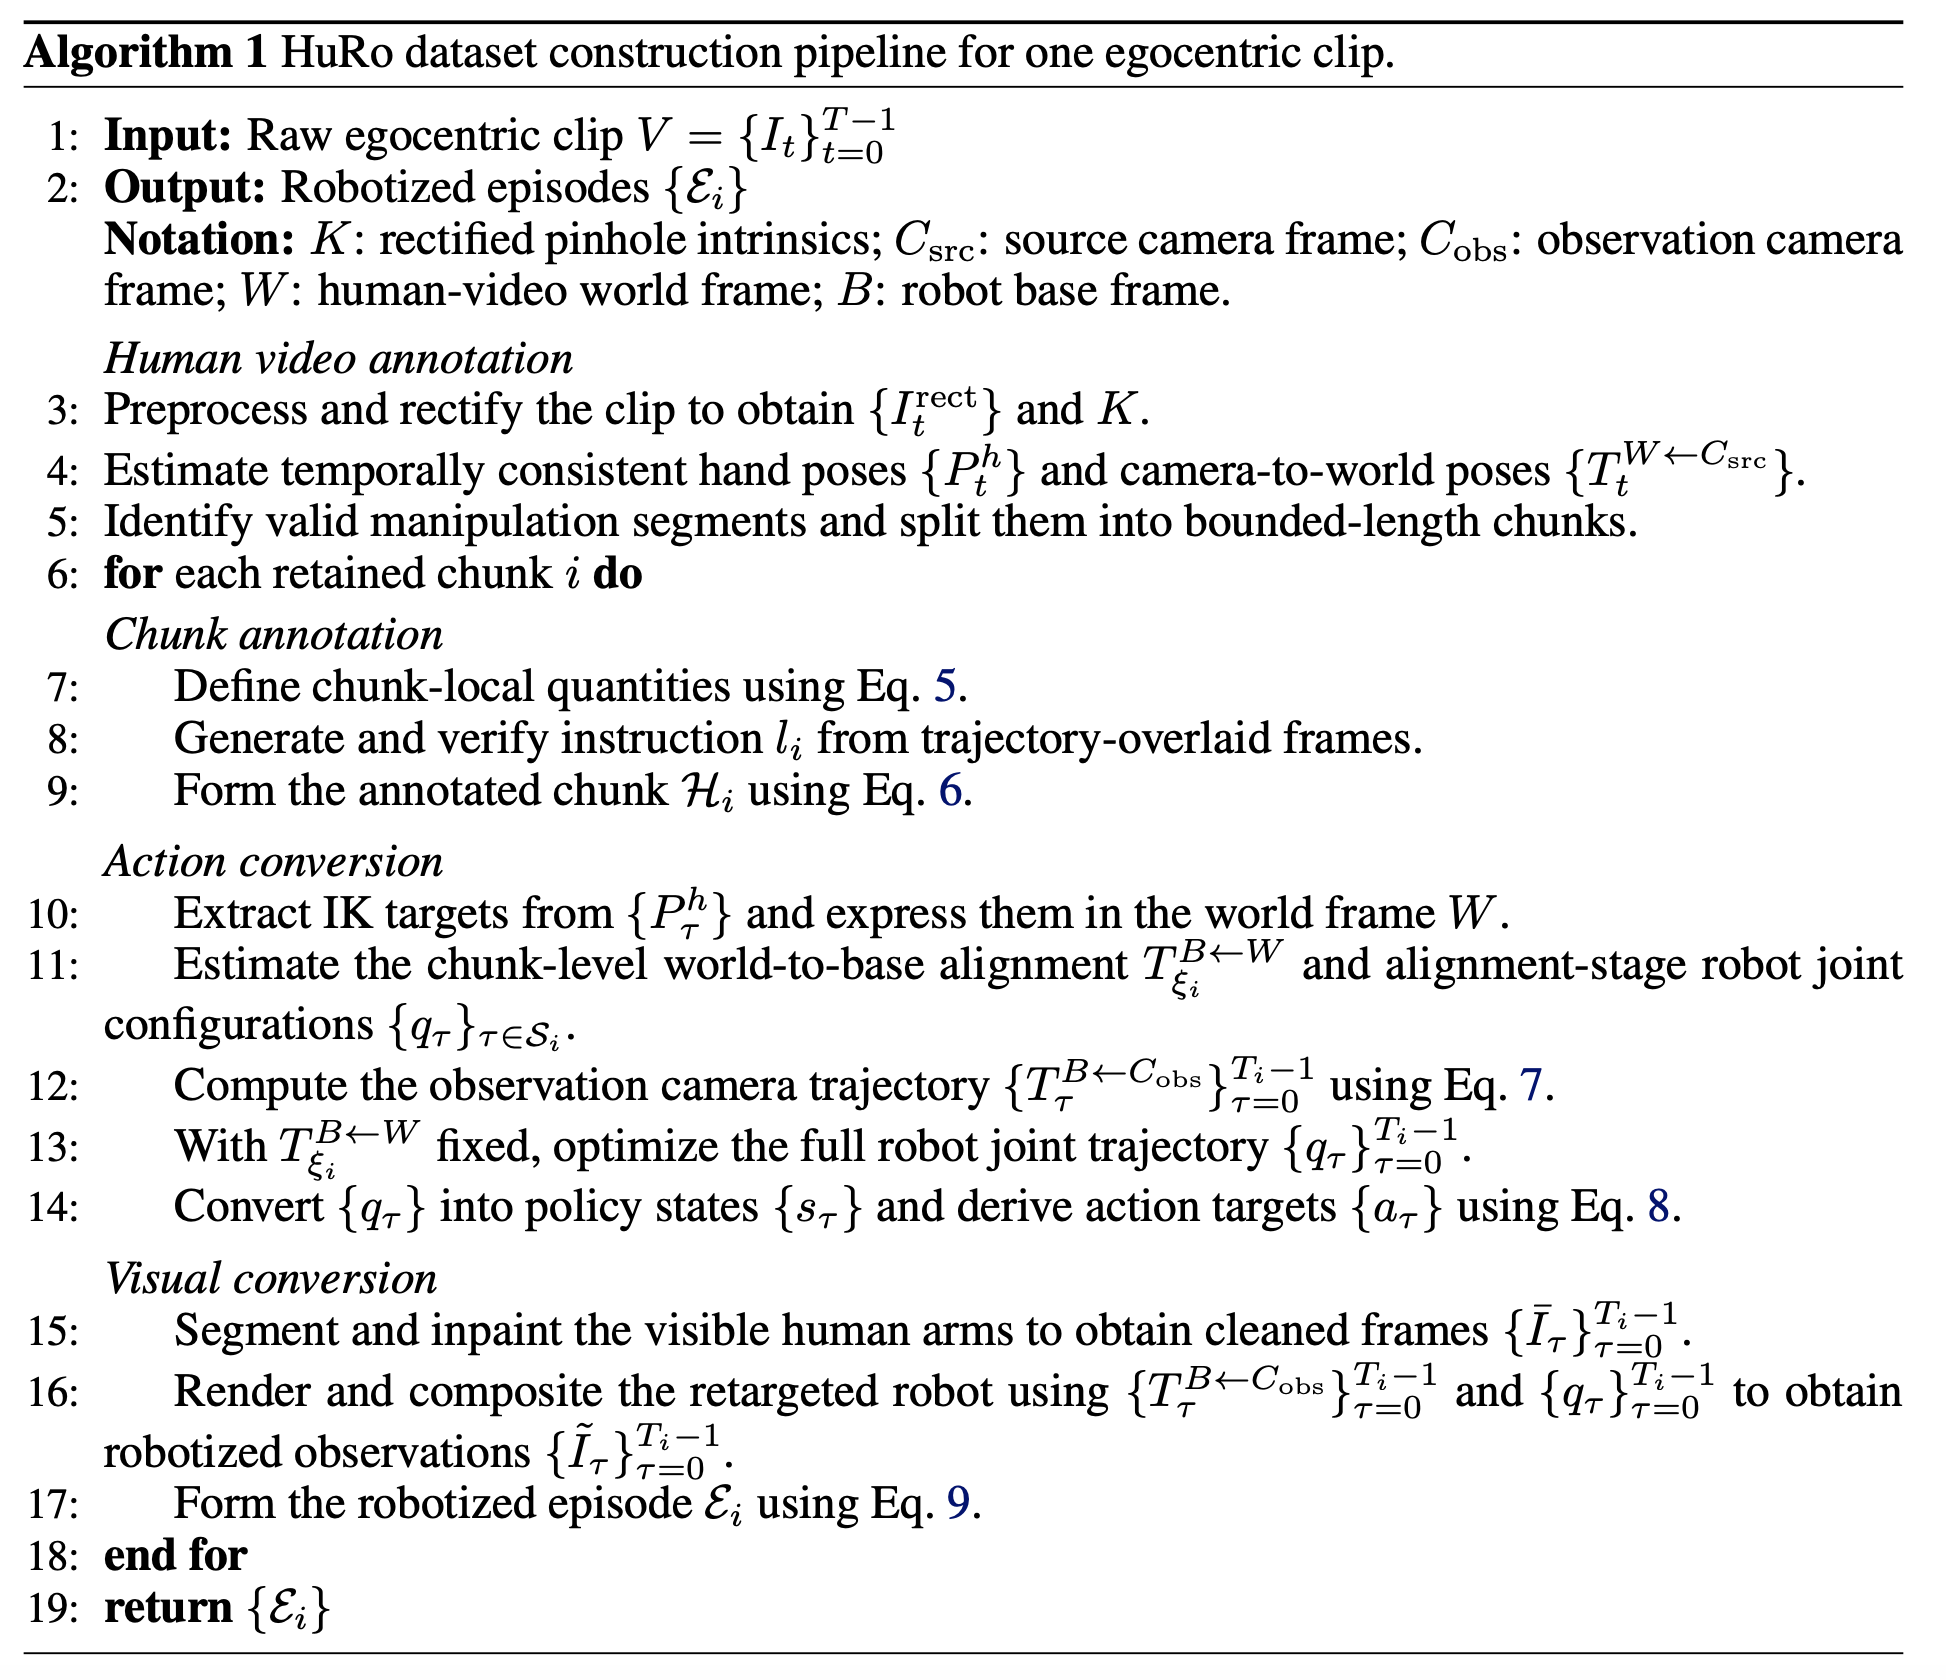
如图 2 所示HuRo 数据集构建流程概览。该流程对人类视频进行标注,将其重定向为机器人动作,并从视觉上转换为机器人视角的观测数据,从而构成 HuRo 交互片段(episodes)。
这里有三个值得理解的技术点。
- 区分相机运动和手部运动。
第一人称视频中,拍摄者移动头部会让整个画面变化。如果直接把画面中的手部位移当作操作动作,容易产生错误。因此,系统估计相机轨迹、尺度和重力方向,将人手运动放到统一三维坐标系中。
- 动作与图像使用同一套几何变换。
作者先优化人类视频世界坐标系到机器人基座坐标系的对齐,再求解机器人的关节轨迹;渲染机器人时也使用相同的对齐关系。这使生成画面与动作标签在几何上对应。
不过,几何对应不等于接触和动力学正确,这是后文局限的关键。
- 用恢复的未来状态充当动作监督。
人类视频没有真正的机器人控制指令,论文以重定向后的下一时刻状态构造动作目标,即基本形式为 (a_t=s_t+1)。模型学习预测未来一段手腕和手指目标,而非力矩或接触力。
因此,这些数据更适合帮助模型学习操作先验,部署仍依赖真实示范微调。
三、创新点及其实验证据
主要集中在以下四方面。
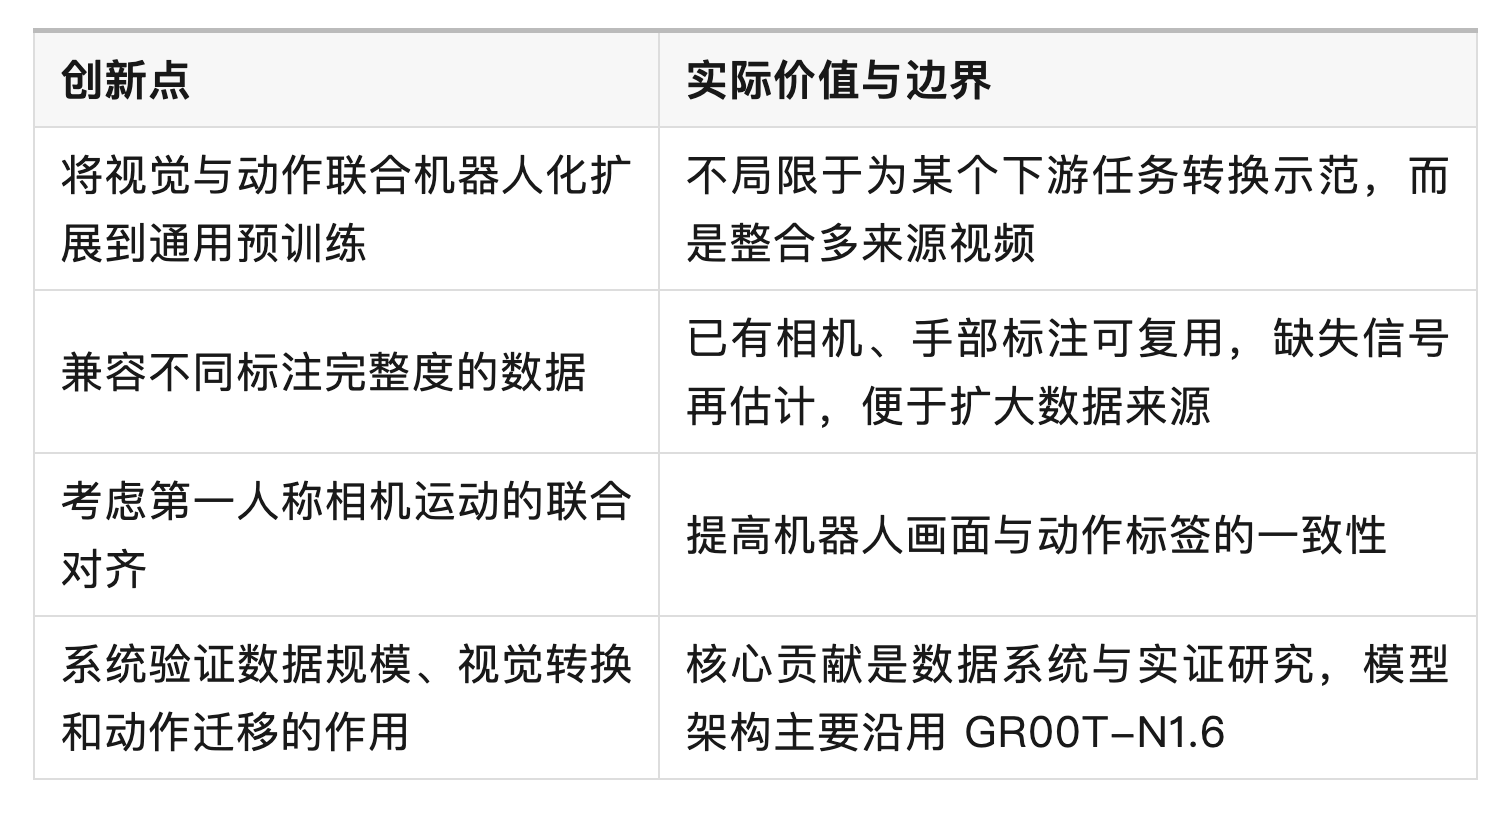
关键结果如下:
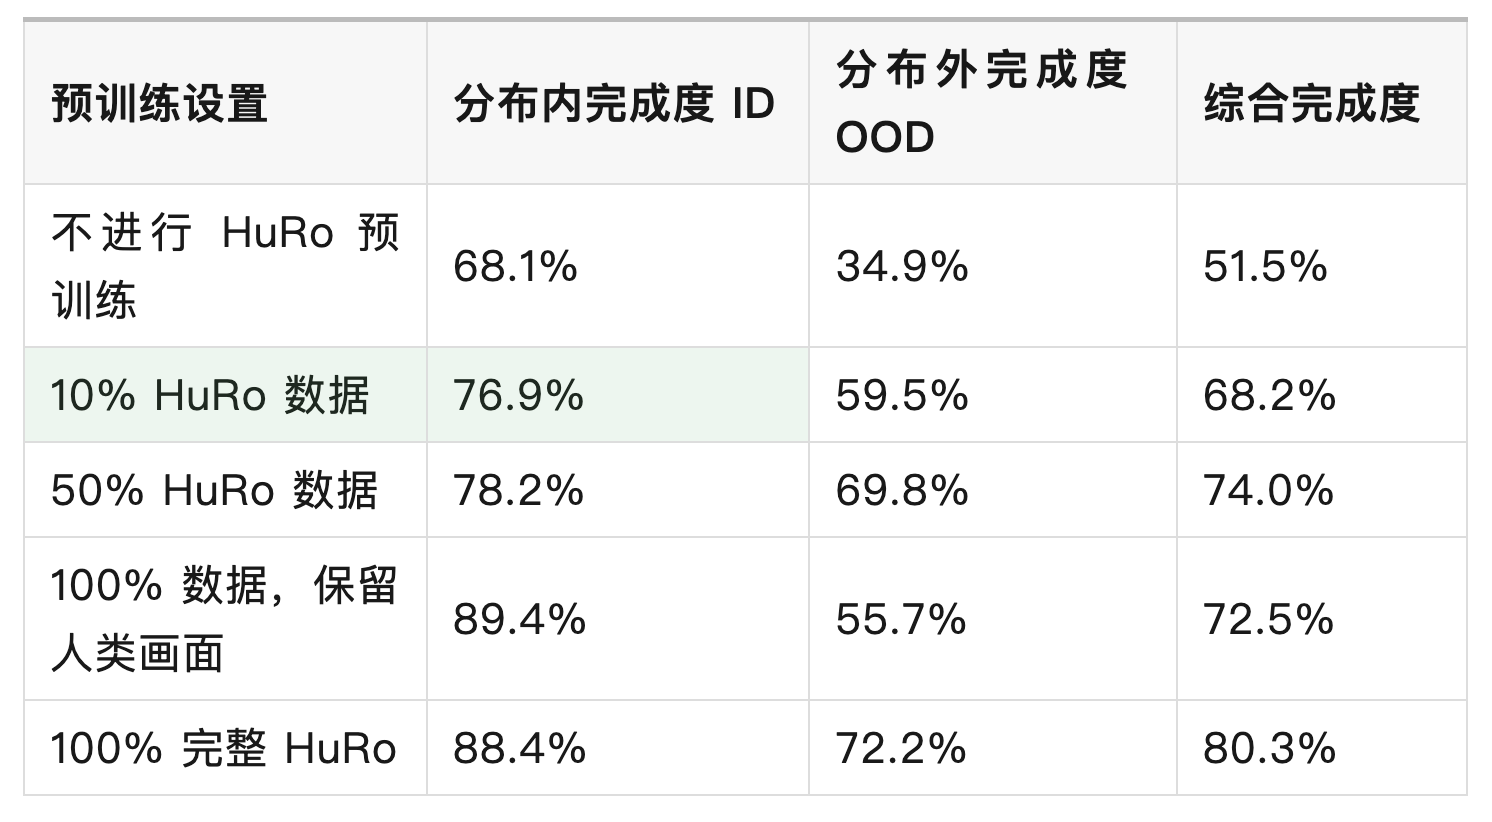
这组结果支持三个判断:
增加数据总体有效:综合完成度增加 28.8 个百分点,OOD 增加 37.3 个百分点。非零预训练设置保持训练步数和批量大小一致,增强了数据规模对照的说服力。
视觉转换的收益主要体现在泛化:保留人类画面时,ID 表现相当,但 OOD 比完整 HuRo 低 16.5 个百分点。
动作模块的迁移很重要:单独的多物体抓放实验中,完整模型的 ID/OOD 完成度达到 61.1%/50.0%,明显好于只迁移视觉部分。
跨机器人证据:ALLEX 数据预训练后迁移到 OpenArm,综合完成度由无预训练的 49.0% 提升至 72.9%。但这只覆盖一个水果抓放任务,仍属于初步验证。
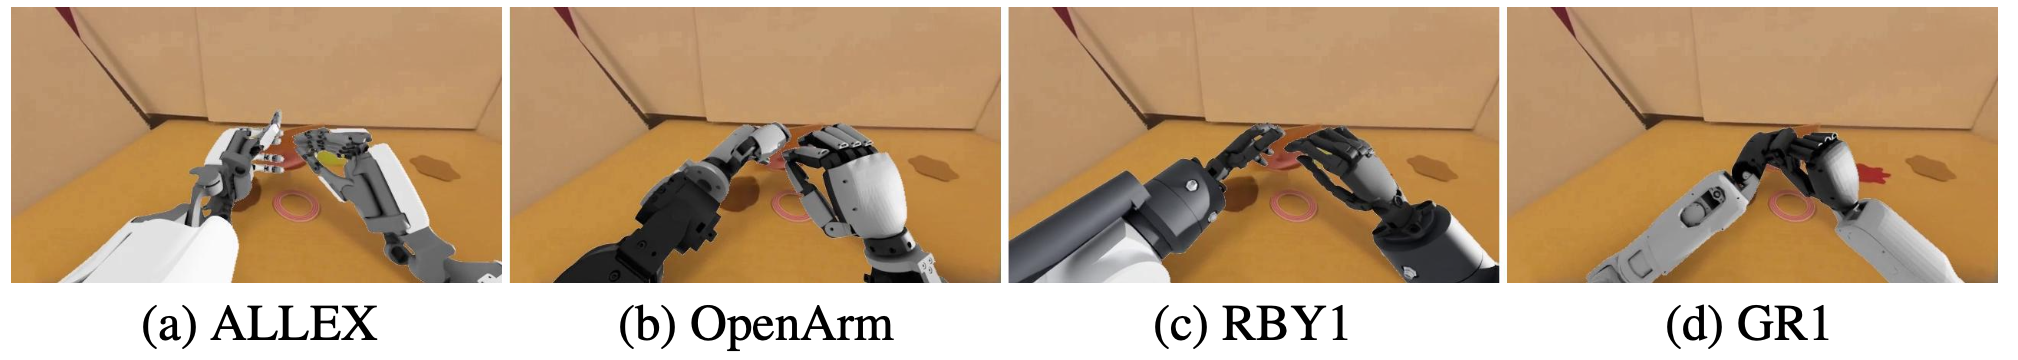
如图 9所示针对不同目标形态的机器人化实现。同一源真人视频被转化为适用于四种形态与运动学特性各异的目标机器人的动作:(a) ALLEX,(b) 配备 XHand1 手部的 OpenArm,© 配备 Wuji2 手部的 RBY1,以及 (d) GR1。
HuRo 数据集构建流程包含三个阶段:人类视频标注、动作转换和视觉转换。这三个阶段协同工作,将以第一人称视角拍摄的人类视频转化为包含语言、观测、状态及动作目标的机器人任务片段,以用于 VLA 预训练。算法 1 总结从 RGB 视频出发的完整构建路径。对于提供中间标注的源数据,直接使用现有标注,仅估算缺失的信号。
四、主要问题与需要谨慎解读的地方
1. 轨迹的物理可靠性不足——作者明确承认。
在 288 条轨迹的抽样审计中:
只有 62.5% 的轨迹在所有受检关节和帧上,没有超过 1° 的关节限位违规。
只有 55.2% 的轨迹在抽样帧中没有检测到非抓握自接触。
重定向后的指尖位置残差中位数约 21.2 毫米。
关节限位可以通过投影修正,且多数指尖位移很小;但自碰撞、物体接触和动力学并没有因此解决。对于精细插入、稳定握持等任务,厘米级误差也可能很重要。
2. 视觉转换没有充分保证交互真实性——作者明确承认。
机器人与场景之间没有显式建模遮挡关系,擦除人手后的背景也由模型补全。可能出现手指与物体遮挡错误、接触区域失真等问题。
模型可能学到有用的外观和运动规律,却未必学到正确的“动作如何改变物体状态”的关系。
3. “80.3%”不能理解为完整任务成功率。
除苹果抓放外,其他主任务采用分阶段计分。例如完成三个子目标中的两个,也会获得部分分数。
综合分数还是 ID 与 OOD 平均分的等权平均;两者覆盖的任务集合不同,因为微波炉任务只有 OOD 测试。因此,80.3% 应读作该评估协议下的平均完成度。
4. 泛化范围和统计证据仍有限——我的评价。
主实验主要考察物体位置、桌布和场景变化,多数条件只有 10–24 次 rollout;文中未报告多随机种子结果或置信区间。
所以,大幅提升具有参考价值,小幅差距则不宜过度解读。论文也没有充分证明对全新任务、复杂长程规划或广泛机器人形态的泛化能力。
5. 消融实验的结论需要收窄。
“Visual Only”是在联合预训练之后重置动作头,并不是独立训练一个纯视觉预训练模型。因此,它更直接证明的是:保留已预训练的动作模块,比丢弃该模块更有利。
它不能单独证明动作监督优于所有视觉预训练方案。同样,文中的部分相关工作基线是适配版本,而非原方法完整复现。
6. 可扩展性仍有成本与数据质量问题。
单张 RTX 5090 处理无完整标注视频,耗时约为视频时长的 8–10 倍,且不包含模型加载和文件读写。
此外,约 82% 的最终帧来自已提供相机与手部标注的 EgoDex 和 EgoVerse。因此,论文对“异构数据整合”的证据较强,对“任意原始网络视频都能经济地转成高质量数据”的证明仍有限。
数据规模实验也同时改变了样本数量和覆盖范围,目前不足以分离数量、多样性和质量各自的贡献,更不能据此认定已建立普适的 scaling law。
五、今后改进方向
优先围绕“数据是否可信、可信数据是否更有效”开展,而不仅是继续增加视频数量。
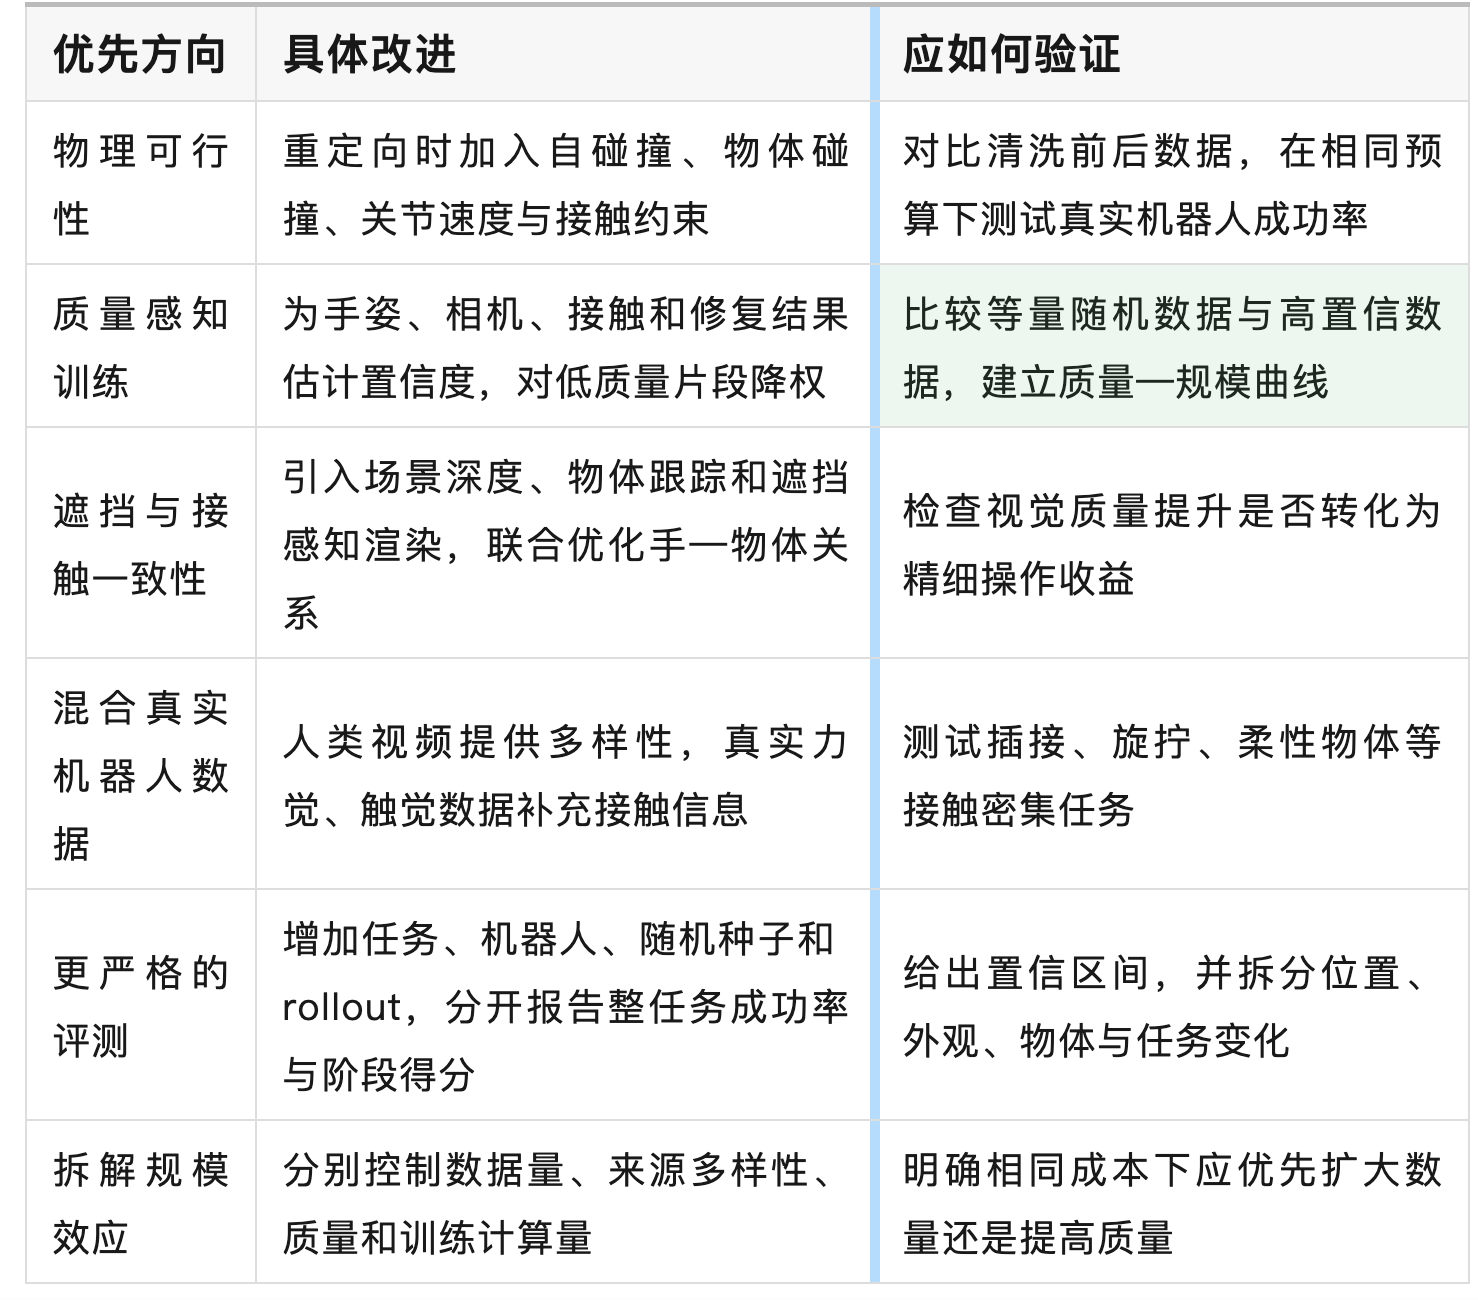
其中,研究切入点是“接触约束重定向 + 置信度加权预训练”。它直接针对本文最薄弱的环节,也可以提出一个清晰、可验证的问题:在相同训练成本下,更少但物理关系更可信的数据,能否超过更大规模的粗糙机器人化数据?
逐步讲解方法与公式
整理为组会汇报
设计后续研究方案

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献441条内容

所有评论(0)