RoboEdit:将人类操作视频转化为可扩展的机器人经验
26年8月来自UCLA、MIT和Utah大学的论文“RoboEdit: Turning Human Manipulation Videos into Scalable Robot Experience”。
该文在机器人数据构建与视频编辑方面有较强的系统价值,但对“生成数据能否规模化提升机器人实际能力”的证明仍比较初步。 最有说服力的是成对数据管线和编辑效果,最需要补强的是物理可执行性、三维状态精度和下游策略收益。
一、论文做了什么
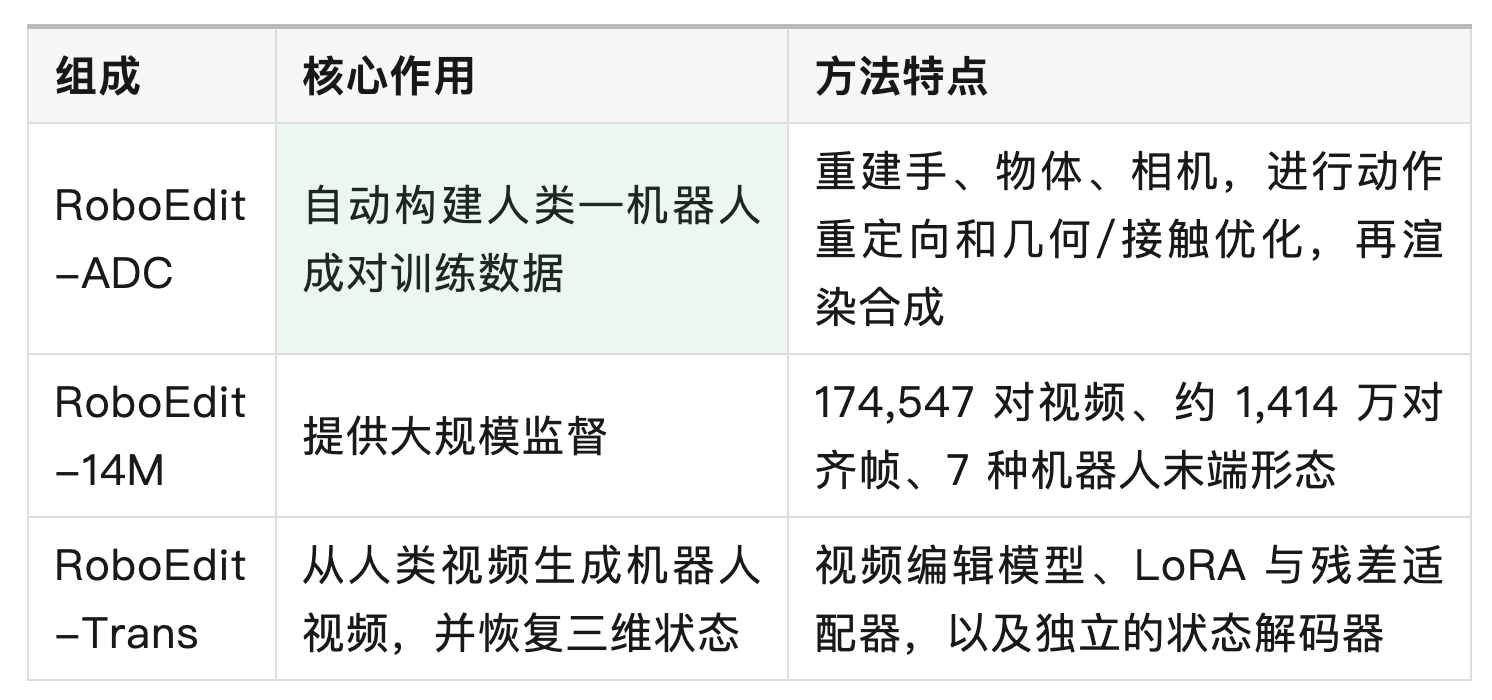
论文试图把人类操作视频转成机器人可以利用的两类数据:机器人操作视频,以及与视频对应的三维手部轨迹。整体包括三个部分:
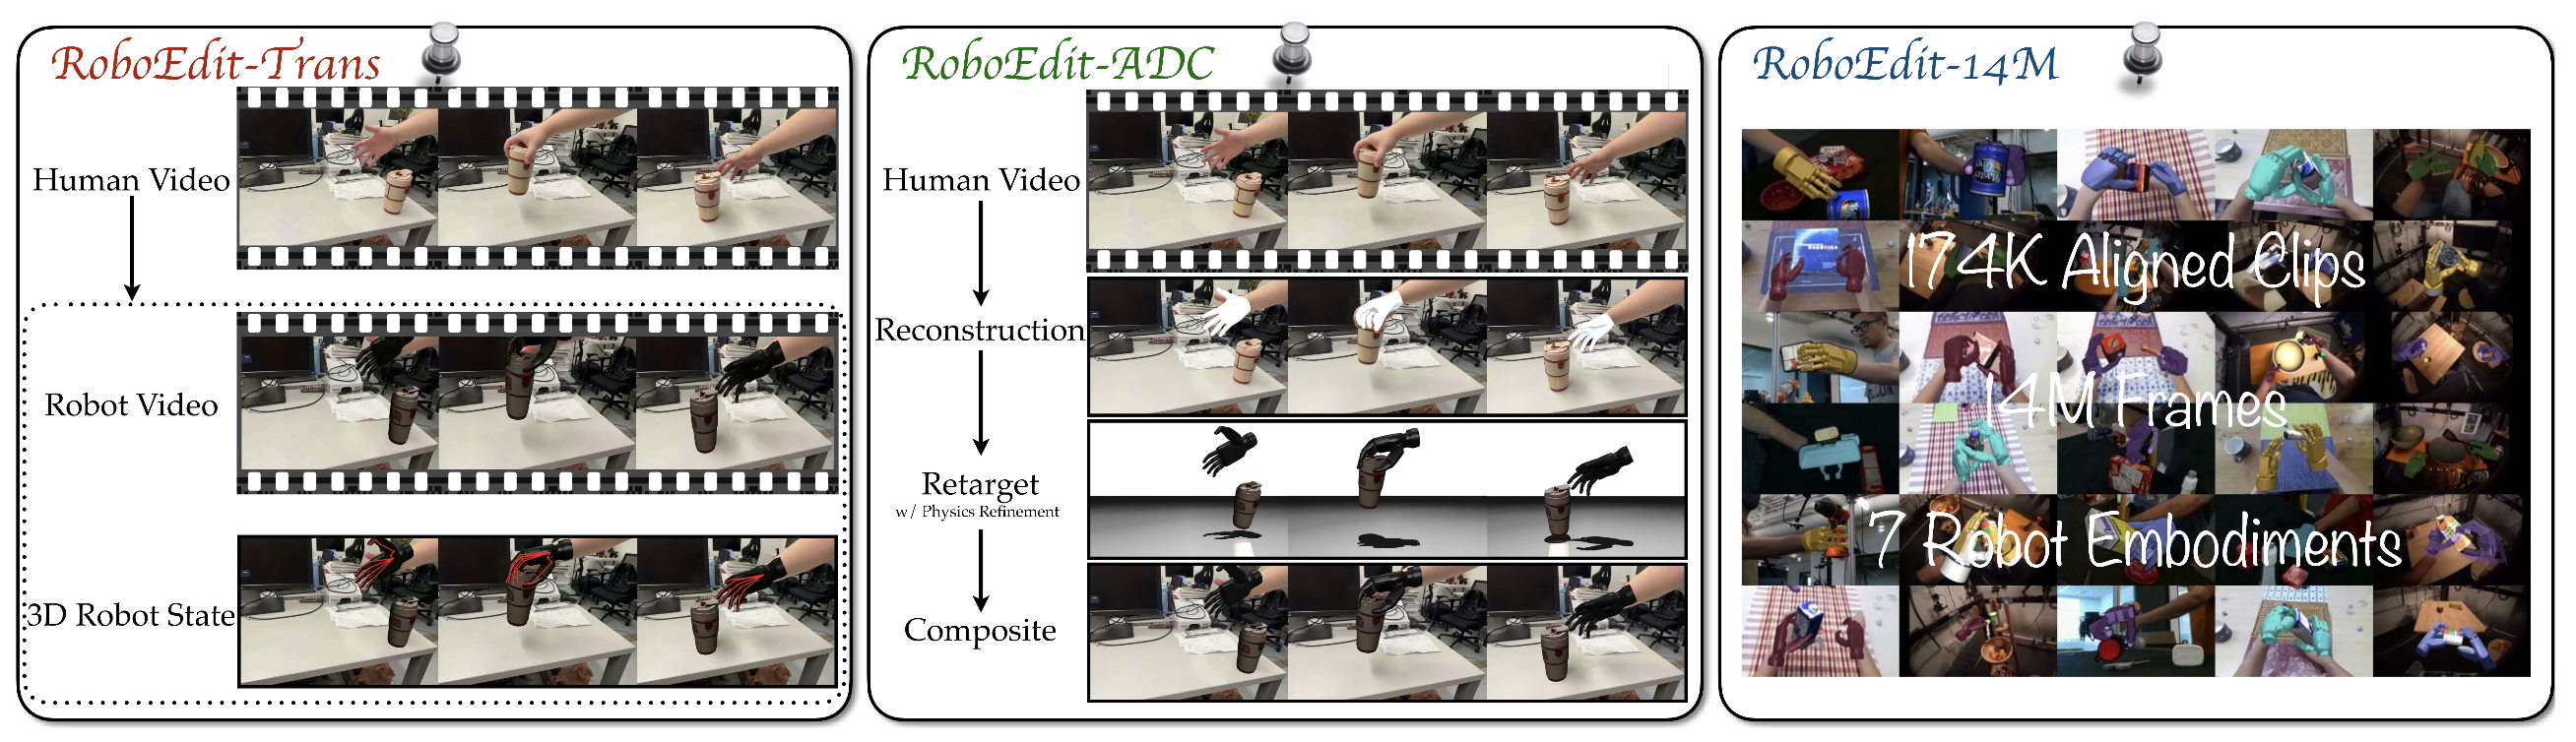
如图1 所示RoboEdit 概述:该框架采用 RGB 人类视频和目标机器人,生成物理上合理的机器人交互视频和 3D 机器人手状态 (RoboEdit-Trans)。这些状态支持下游机器人控制的运动监督,而 RoboEdit-ADC 管道生成训练所需的大规模配对数据集 (RoboEdit-14M)。
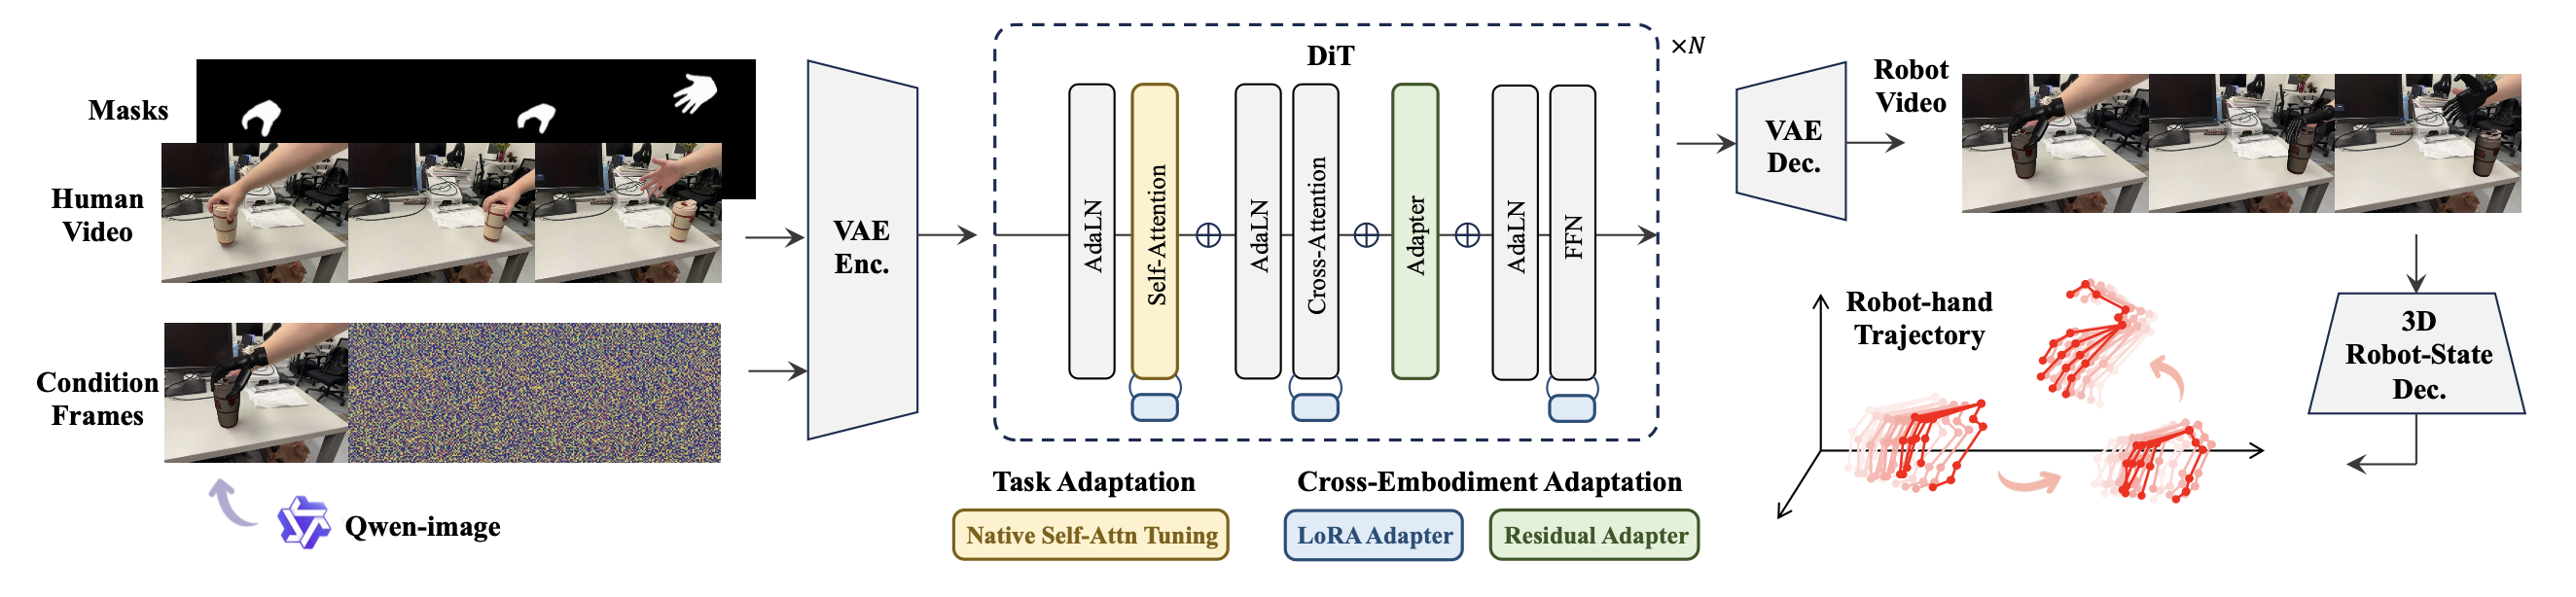
如图 2所示RoboEdit-Trans 利用 LoRA 和残差适配器进行编辑,并使用 3D 机器人状态解码器进行状态恢复。
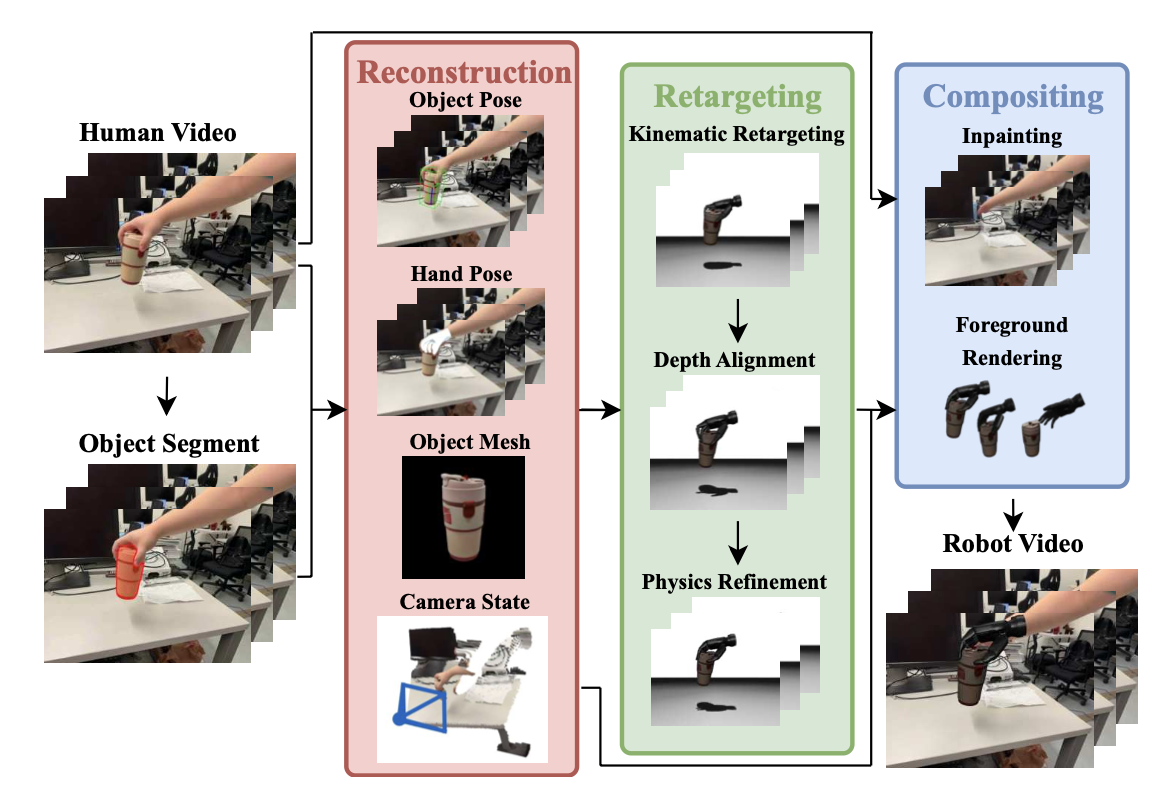
如图 3 所示RoboEdit-ADC 从 RGB 视频中重建 3D 交互,执行经深度与物理特性优化的重定向,并将前景合成到已进行图像补全的场景中。
如图 4所示RoboEdit-14M 涵盖多种机器人形态下的各类日常操作任务。
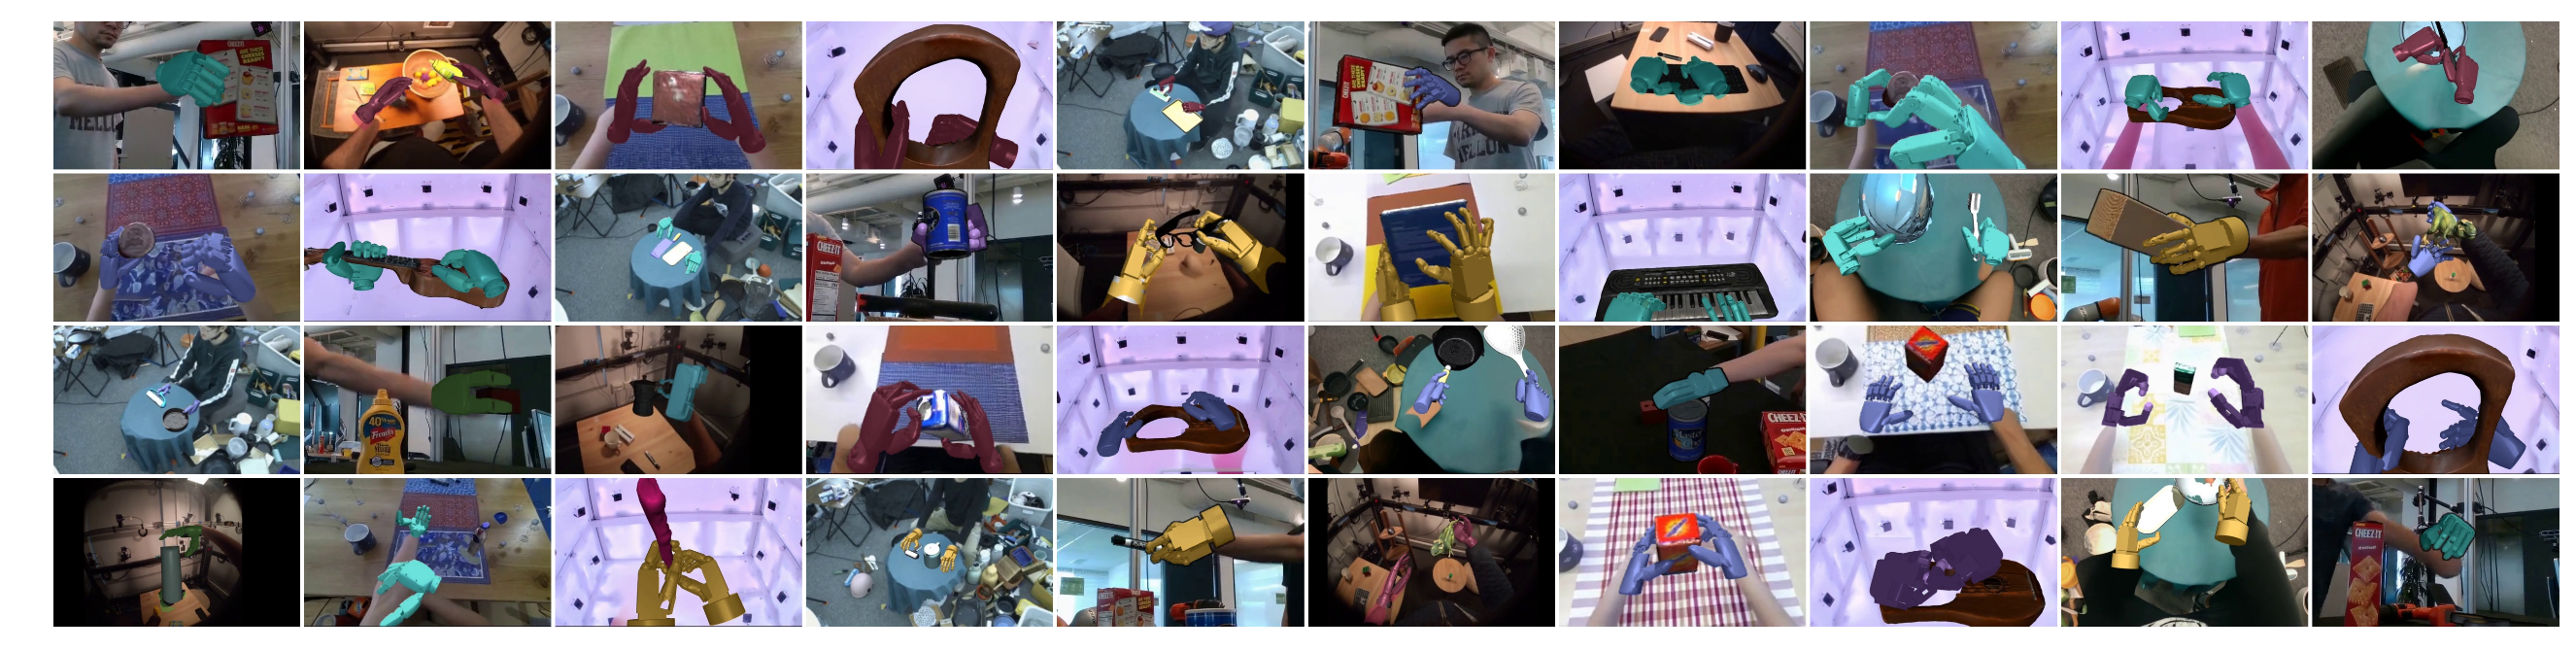
需要注意,它在推理时还依赖微调后的 Qwen-Image-Edit 生成关键帧:每段 81 帧视频使用 9 个机器人关键帧作为条件。因此,这实际是一条分阶段系统,而不是一个模型直接完成从原始视频到机器人控制的全部过程。
二、主要贡献与特点
- 把视觉监督和运动监督放进同一套数据体系。
机器人视频适合训练视觉表征、视频预测或策略模型,三维轨迹则可以用于动作监督和控制参考。论文将两者对齐提供,比单独生成“看起来像机器人”的视频更有使用价值。
其贡献重点在于建立完整的数据接口和处理流程。手部重建、物体跟踪、视频编辑、LoRA、PnP 等基础组件大多来自既有方法,因此更适合将其理解为系统与数据贡献,而非基础算法上的重大突破。
- 保留原视频的场景与交互过程,降低生成难度。
相比从头生成整个机器人场景,它尽量保留背景、相机运动和物体轨迹,只改变执行操作的主体。这能利用人类视频中已有的任务信息,也使源视频和目标视频更容易对齐。
不过,ADC 实际会擦除并重新渲染手和物体,因此“保留物体动态”主要指保留重建出的轨迹,不代表原始物体像素或细节完全不变。
- 针对不同机器人形态进行处理。
论文覆盖五指手、三指手和两指夹爪,并对不同形态使用不同重定向策略。这比仅处理一种机器人更有意义,因为形态变化不仅影响外观,也会改变可实现的接触方式。
但这里证明的是一个系统能覆盖多个已知形态,尚不能据此推断它能直接泛化到未见过的机器人。
- 在配对重建与局部编辑指标上,实验结果较强。
与同为多关键帧输入的 VACE 相比:
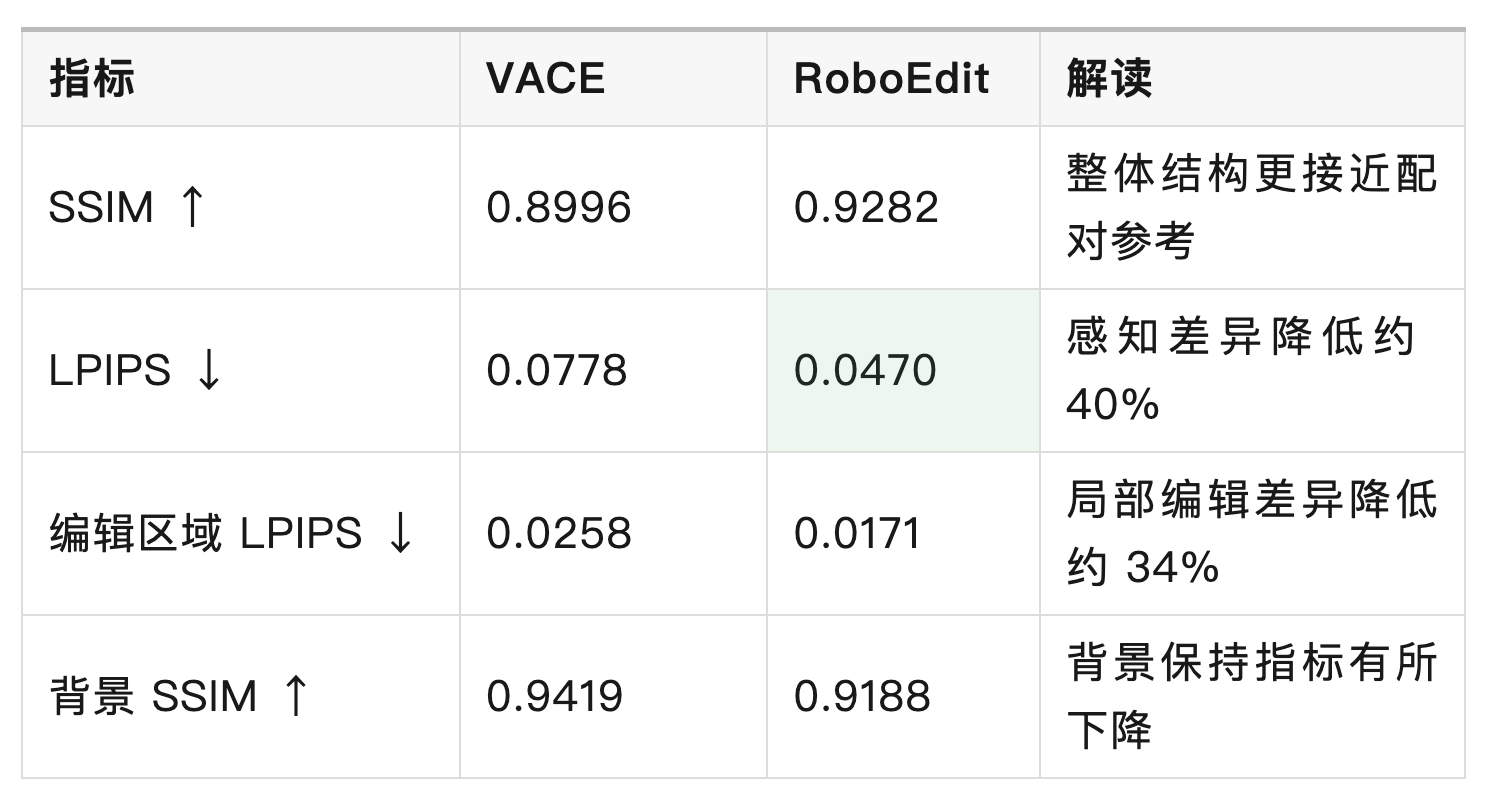
所以,比较准确的表述是:重建和局部编辑表现突出,但并非所有指标都最好。 例如,OpenVE 综合评分最高的是 VINO,而不是 RoboEdit。
三、主要不足:哪些结论还没有被充分证明
1. “物理上看起来合理”与“真实可执行”之间仍有距离。
重定向优化主要约束轨迹跟踪、穿透、接触距离和时间平滑。这些约束能够改善悬空、穿模等问题,但没有显式证明:
接触力和摩擦足以支撑物体运动;
关节力矩、速度和加速度满足硬件限制;
手部轨迹对应的整条机械臂运动可达且无碰撞。
尤其是系统尽量保持人类演示中的物体轨迹,但不同机器人可能需要不同抓法、不同路径,甚至中途重新抓取。物体轨迹固定,并不意味着目标机器人一定能实现该轨迹。
补充材料中接触识别阈值为 2–6 厘米,并过滤不足 10 帧的接触片段。这可能有利于抵抗重建噪声,但其对短暂接触、快速操作和精细装配的适用性还需要验证。
2. 最关键的三维状态输出缺少定量精度评估。
论文展示了状态预测的可视化叠加,但没有给出系统的腕部位姿误差、关节角误差、指尖位置误差、接触误差等结果。
这使得读者难以判断:轨迹究竟精确到足以用于哪一类操作?能用于抓取,不代表能用于插接、旋拧或手内操作。
单目尺度也存在说明不足:附录通过相似变换对齐 VGGT 与渲染坐标系,但对任意输入视频,尺度参照和相机对应关系如何可靠获得,没有解释得足够完整。这影响“从任意 RGB 视频恢复可执行米制轨迹”的适用范围。
3. 下游实验展示了可行性,但没有隔离各模块的实际收益。
论文报告的 Panda 71%、XHand 62% 是仿真成功率。实机部分有成功执行案例,但没有报告系统性的尝试次数、成功率、置信区间和对照实验。
同时,下游控制器额外使用了 PPO、物体任务状态,以及抓取保持、物体运动一致性和抬升奖励。因此,最终成功不能全部归因于视频生成或状态解码。
最关键的缺失对照是:
ADC 已经能输出机器人轨迹,那么“生成机器人视频,再从视频恢复轨迹”相比直接使用 ADC 轨迹,到底带来多少额外收益?
如果这一点不明确,视频编辑对机器人控制的必要性就还没有被充分建立。
4. 数据规模很大,但独立行为多样性需要区别看待。
174,547 对视频来自 24,197 段人类交互视频,规模扩展部分来自多机器人重定向和合成场景增强。每段 81 帧,按附录使用的 30 FPS 计算,约为 2.7 秒。
这类扩展确实有价值,但“1,414 万帧”不能直接等同于同等规模的独立任务经验,也不足以证明长时程操作能力。
此外,正文与补充材料未清楚交代 300 个评测样例如何与训练数据隔离。由于同一人类片段可以衍生多个机器人版本,应当按原始视频或采集序列划分,而不能仅按生成后的样本划分。这里是评估信息不足,不能直接断言存在数据泄漏。
5. 模型创新的独立贡献相对有限,比较公平性仍可加强。
表 3 中,不使用两种适配器时,SSIM 已达到 0.9255;两者加入后为 0.9282。LPIPS 从 0.0494 降到 0.0470。
这说明适配器有增益,但绝对幅度较小,且没有误差条或多随机种子结果。较大的总体优势可能还来自专用数据、任务微调和关键帧条件,需要进一步拆解。
现有比较也混合了单参考帧、多关键帧和文本条件。论文没有充分证明所有基线都获得了等量领域训练。因此,其结果更能支持“完整系统有效”,较难单独证明“新架构显著优于替代架构”。
6. “可规模化”的成本证据不足。
整条管线涉及多个视觉模型、三维重建、优化、渲染与视频生成。论文给出了训练硬件,但没有报告每段视频处理时间、GPU 小时、自动构建失败率或有效样本产出成本。
这些信息对于判断它是否比其他数据采集方式更经济,非常关键。
四、下一步值得做什么
最好优先补齐“生成数据如何转化成机器人能力”的证据,再扩展模型规模。
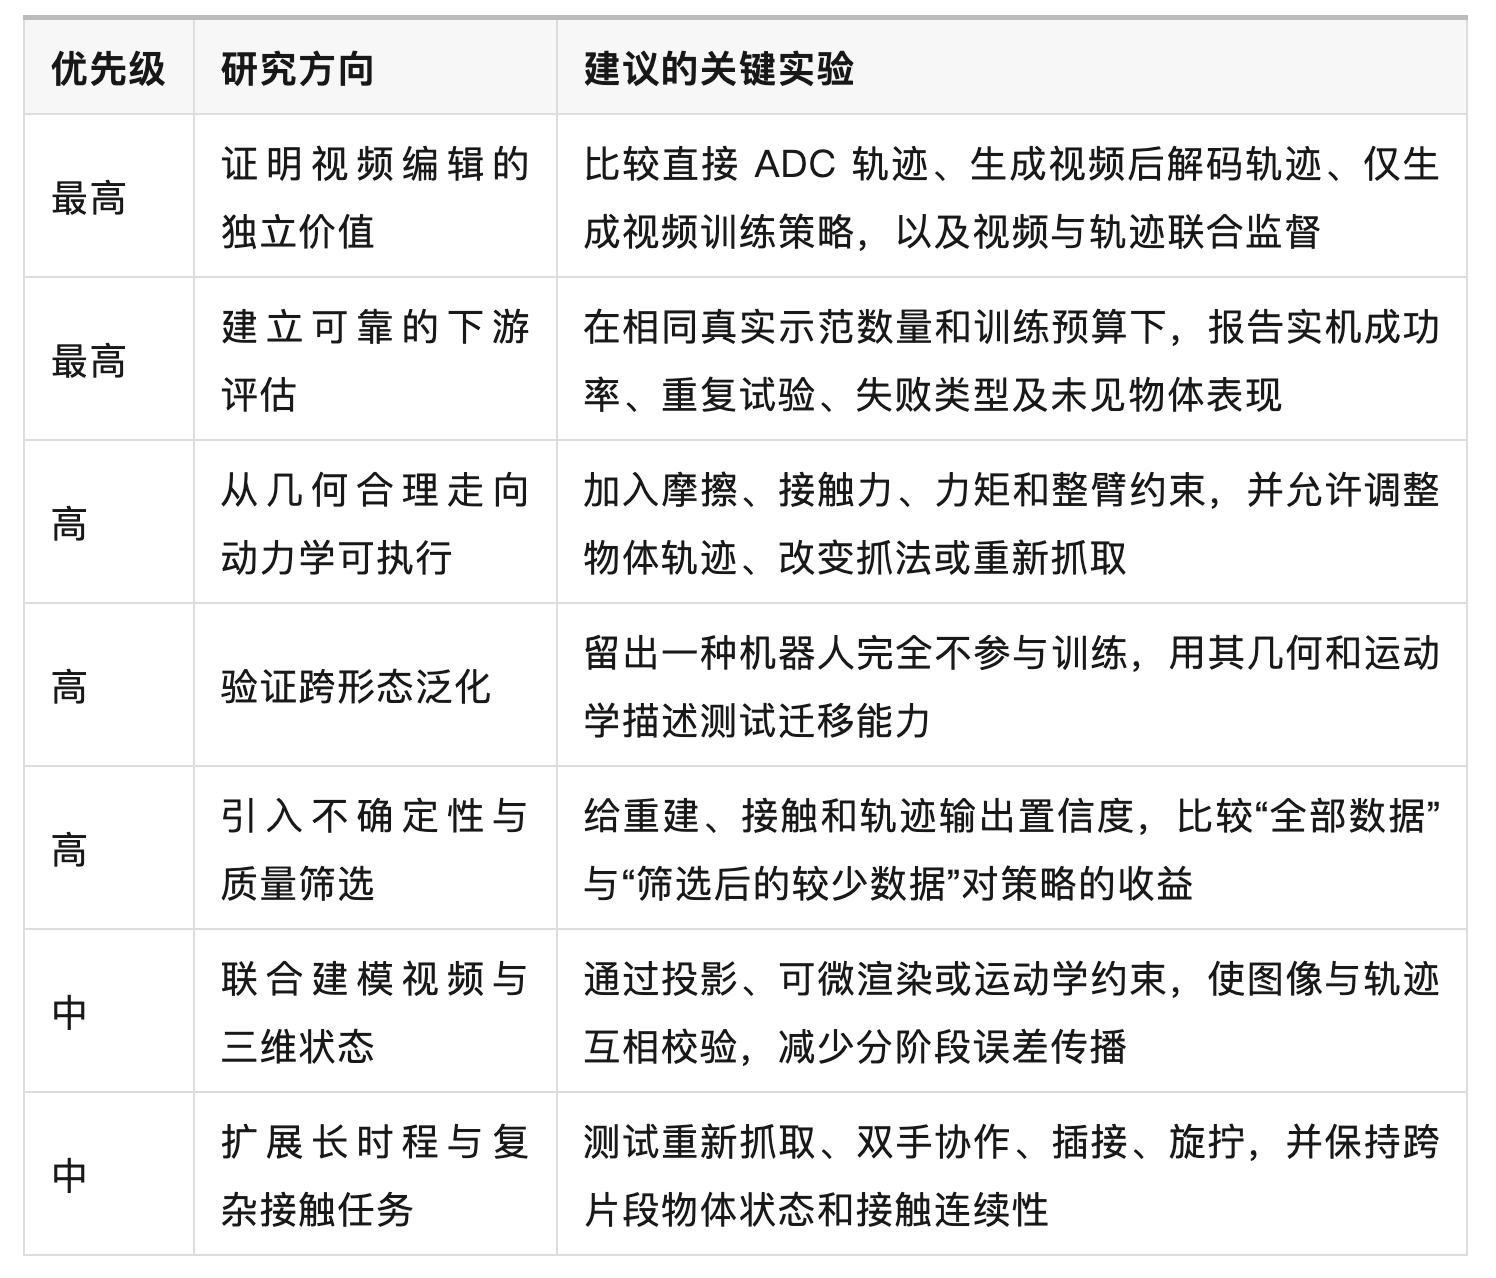
研究的下一步:生成视频在什么条件下,比直接三维重定向更有利于策略学习?
这个问题可以通过清晰的对照实验回答,也可能得到很有价值的结论:例如,视频生成主要提升视觉泛化,三维轨迹主要提供动作监督,而物理筛选决定哪些生成样本真正有用。这样的结果会比继续提升少量视频相似度指标,更直接推进机器人学习。
整理为审稿意见
设计后续研究方案
逐项解析方法

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献441条内容

所有评论(0)