第一篇:Jetson Orin NX如何让EA250Pro成为“端侧算力天花板”?
系列定位:EA250Pro产品深度系列第一篇。写给正在选型的技术人员和项目决策者。
阅读收益:读完这篇,你能搞清楚157 TOPS到底意味着什么,Jetson Orin NX凭什么成为高端边缘AI的“甜点位”,以及EA250Pro如何把这颗芯片的性能榨干。
核心结论:
-
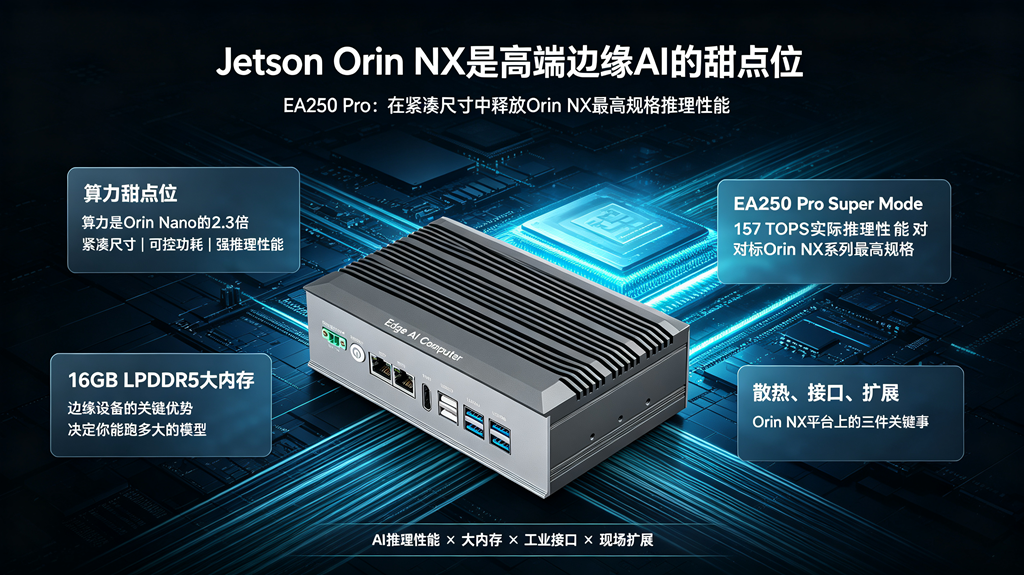
Jetson Orin NX是高端边缘AI的“甜点位”——算力是Orin Nano的2.3倍,但保持紧凑尺寸和可控功耗。
-
157 TOPS不是理论峰值——EA250Pro 支持Super Mode,实际推理性能可对标Orin NX系列的最高规格。
-
16GB LPDDR5大内存在边缘设备中极为关键——它决定了你能跑多大的模型。
-
钡铼技术EA250 Pro在Orin NX平台上做了三件关键的事:散热、接口、扩展。
一、Orin NX:Jetson家族的“甜点位”
NVIDIA Jetson Orin系列目前有四款核心模块:
| 模块 | 算力(INT8) | CPU | 内存 | 典型功耗 | 定位 |
|---|---|---|---|---|---|
| Orin Nano 4GB | 34 TOPS | 6核A78AE | 4GB | 7-10W | 入门 |
| Orin Nano 8GB | 67 TOPS | 6核A78AE | 8GB | 7-15W | 中端均衡 |
| Orin NX 16GB | 157 TOPS | 8核A78AE | 16GB | 10-25W | 高端甜点 |
| AGX Orin 64GB | 275 TOPS | 12核A78AE | 64GB | 15-60W | 旗舰 |
Orin NX 16GB的157 TOPS,是Orin Nano 8GB(67 TOPS)的2.3倍,是初代Xavier NX的7.5倍。
但更关键的是功耗比。157 TOPS的算力跑在10-25W的功耗区间内,这意味着它可以做到无风扇或小风扇散热,塞进紧凑的工业机箱里,部署在产线旁边。AGX Orin的275 TOPS当然更强,但15-60W的功耗意味着更大的散热系统和更高的部署成本。
行业分析也印证了这一点:Orin NX是很多工业产品的“甜点位”——比Nano高出一大截算力,但保持70mm×45mm的紧凑尺寸,适合AMR、机器人和多路视频分析场景。
一句话总结:Orin Nano看预算,Orin NX求平衡,AGX Orin拼性能。EA250Pro选的,就是那个“平衡点”。
二、157 TOPS到底能干什么?
TOPS这个数字容易让人麻木。157 TOPS到底意味着什么?用场景说话:
场景一:多路视频实时分析
4路1080P@30fps视频同时跑YOLOv8目标检测,每路保持25+ FPS的推理帧率。这是EA250 Pro的基准能力。如果是4K视频,可以支持2路4K@30fps并行推理。视频解码方面,EA250Pro支持1路8K30 / 2路4K60 / 4路4K30 / 9路1080p60(H.265)。
场景二:多模态模型推理
16GB LPDDR5内存是跑大模型的关键。在Orin NX 16GB上,可以流畅运行7B参数的轻量级大语言模型(LLM),或者部署视觉语言模型(VLM)进行“看图说话”式的工业巡检。内存不够,模型再小也跑不起来——这是很多边缘设备翻车的地方。
场景三:多模型并行
具身智能机器人需要同时运行视觉SLAM、目标检测、运动规划、力控算法。157 TOPS的算力余量,让EA250Pro可以同时跑3-4个中等规模的AI模型,而不需要为每个任务单独配一台计算设备。
场景四:模型微调与开发
EA250Pro不仅是推理设备,还可以作为边缘AI开发平台。在设备端进行小规模模型微调(Fine-tuning),然后用更新后的模型继续推理,形成“边训练边推理”的闭环。这就是NVIDIA推广的“云边协同”理念的落地方式。
三、Super Mode:把Orin NX的性能“榨干”
NVIDIA在JetPack 6.2中引入的Super Mode,是Orin NX性能释放的关键。
Super Mode的本质是动态功耗分配。传统模式下,CPU和GPU共享固定的功耗预算。Super Mode允许系统根据实际工作负载,动态调整CPU和GPU的功耗配比——当AI推理任务繁重时,把更多功耗分配给GPU;当需要处理复杂逻辑时,把功耗分配给CPU。
AAEON的BOXER-865xAI-PLUS系列就是基于Orin NX + Super Mode,实现了157 TOPS的AI性能。Aetina的Mini Series同样支持Super Mode,在紧凑无风扇系统中实现157 TOPS。
EA250Pro完整支持Super Mode。这意味着在相同的硬件功耗预算下,EA250Pro可以比不支持Super Mode的竞品多跑20%-30%的推理吞吐量。
但Super Mode有一个前提:散热必须跟得上。 如果散热设计不行,芯片降频,Super Mode就变成了“Super 降频”。这就是为什么EA250Pro采用全铝合金外壳+高效散热鳍片设计——散热效率直接决定了持续算力输出。
四、EA250 Pro在Orin NX平台上做了什么?
拿到一颗Orin NX模块不难。难的是把它做成一台工业级、可部署、开箱即用的边缘AI计算机。EA250Pro在三个维度上做了关键工作:
4.1 散热:决定持续算力的“隐形战场”
EA250Pro采用全铝合金外壳,机身侧面多层堆叠结构形成书本翻开般的“台阶感”——这不仅是工业设计语言,更是高效散热鳍片。157×130mm的紧凑尺寸配合被动/主动散热设计,在-20°C至+75°C宽温范围内稳定运行。
为什么散热这么重要?因为工业现场7×24小时运行,芯片如果不能持续满血输出,标称的157 TOPS就只是个数字。EA250Pro的散热设计确保芯片在长时间高负载下不会因为过热而降频。
4.2 接口:4种相机输入方案,自由切换
EA250Pro支持4路USB 3.0、4路GMSL2工业相机、4路千兆网口相机或4路MIPI CSI-2摄像头的灵活选择。这意味着一台设备可以适配不同项目的相机类型——不需要为了换相机而换整机。
GMSL2接口尤其值得一说。GMSL2用同轴电缆传输视频,支持15米长距离传输和同轴供电(PoC),一根线搞定数据+供电。在移动机器人和产线改造场景中,这比MIPI CSI-2的30厘米线缆限制和USB的5米限制实用得多。
4.3 扩展:Y系列IO板 + OOB远程运维
通过Y系列IO板,EA250Pro可扩展最多2路CAN FD、4路RS485、16路DI、8路DO、2路GPI和2路GPO。什么概念?一台设备能同时跟底盘控制器、伺服驱动器、传感器阵列、执行机构“聊天”。
可选配的OOB带外管理模块支持远程通过以太网/WiFi/4G开关机、重启设备,无需到现场。对于部署在偏远地区或高空设备上的边缘AI计算机,这个功能是“救命稻草”。
五、一张表看懂EA250Pro的核心规格
| 项目 | 规格 |
|---|---|
| 核心平台 | NVIDIA Jetson Orin NX 16GB |
| CPU | 8核 Arm Cortex-A78AE @2.0 GHz |
| GPU | 1024 CUDA核心 + 32 Tensor Core(第四代) |
| AI算力 | 最高157 TOPS (INT8) |
| 内存 | 16GB LPDDR5 |
| 视频编码 | 1x 4K60 / 3x 4K30 / 6x 1080p60 (H.265) |
| 视频解码 | 1x 8K30 / 2x 4K60 / 4x 4K30 / 9x 1080p60 (H.265) |
| 以太网 | 1x 1GbE + 1x 2.5GbE |
| USB | 2x USB 2.0 + 4x USB 3.1 Gen 1 |
| 存储 | M.2 Key-M (2280) PCIe Gen 3 x1 NVMe SSD |
| 无线扩展 | M.2 Key-E (Wi-Fi 6/蓝牙) + Mini PCIe (LTE/5G) |
| 相机输入 | 4路USB/4路GMSL2/4路网口/4路MIPI(可选) |
| IO扩展 | Y系列IO板(最多2 CAN FD、4 RS485、16 DI、8 DO) |
| 工作温度 | -20°C ~ +75°C |
| 电源 | 12V-24V宽压直流输入 |
| 外壳 | 全铝合金,钛金色阳极氧化,黄金分割比例 |
六、FAQ:Orin NX选型常见问题
Q1:EA250Pro和EA230Pro差一倍算力,什么时候该选EA250 Pro?
A:如果你的项目需要同时跑3个以上AI模型,或者需要处理4路以上高清视频流,或者需要跑7B级别的大模型,选EA250Pro。如果只是单路视觉检测或数据网关,EA230Pro足够。
Q2:16GB内存真的用得上吗?
A:跑大模型时非常关键。7B参数的LLM在INT8量化下需要约7-8GB内存,加上操作系统和推理框架的开销,16GB是“能跑大模型”的底线。
Q3:Super Mode需要额外配置吗?
A:EA250Pro预装JetPack 6.2.2,Super Mode已集成在系统中。开发者可以通过NVIDIA的jetson_clocks工具或power mode切换来启用。
Q4:EA250 Pro和EA250标准版有什么区别?
A:EA250标准版仅支持USB相机和板载IO;EA250Pro支持4种相机输入方案(USB/GMSL2/网口/MIPI)和Y系列IO板扩展。如果你的项目需要多路工业相机或丰富的IO控制,选Pro版。
系列预告
下一篇:《具身智能篇:EA250Pro如何撑起人形机器人的“大脑+小脑”》。我们将聊清楚:具身智能对控制器到底有哪些真实需求?大小脑一体化为什么成为主流?EA250Pro在双足人形机器人、复合机器人场景中如何与Jetson Thor方案竞争?
欢迎转发给团队里正在做边缘AI平台选型的技术负责人。
关于钡铼技术
钡铼技术是一家立足于AIoT(人工智能物联网)解决方案的中国公司,专注于为工业自动化、智能机器人、智慧交通及边缘AI等领域提供高可靠、高性能的计算平台与系统方案。依托自主研发的EA系列AI工业计算机产品线,钡铼技术致力于将前沿AI算力与工业级硬件设计深度融合,助力全球客户加速物理AI的规模化落地。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献20条内容

所有评论(0)