RSS 2026 Robot World Models Workshop 5-Sherry Yang World Gym
Talk 4: Evaluating and Improving Physical Agents in a World Model – World Gym:在世界模型中评估和优化物理智能体
Sherry Yang from NYU & Google DeepMind
首先介绍一项研究:学习一个机器人世界模型 World Gym,讲解如何利用该模型评估机器人策略,毕竟评估是实现优化的第一步。第二部分,讲解如何在世界模型内部训练物理智能体。
一 World Gym
1 World Model背景
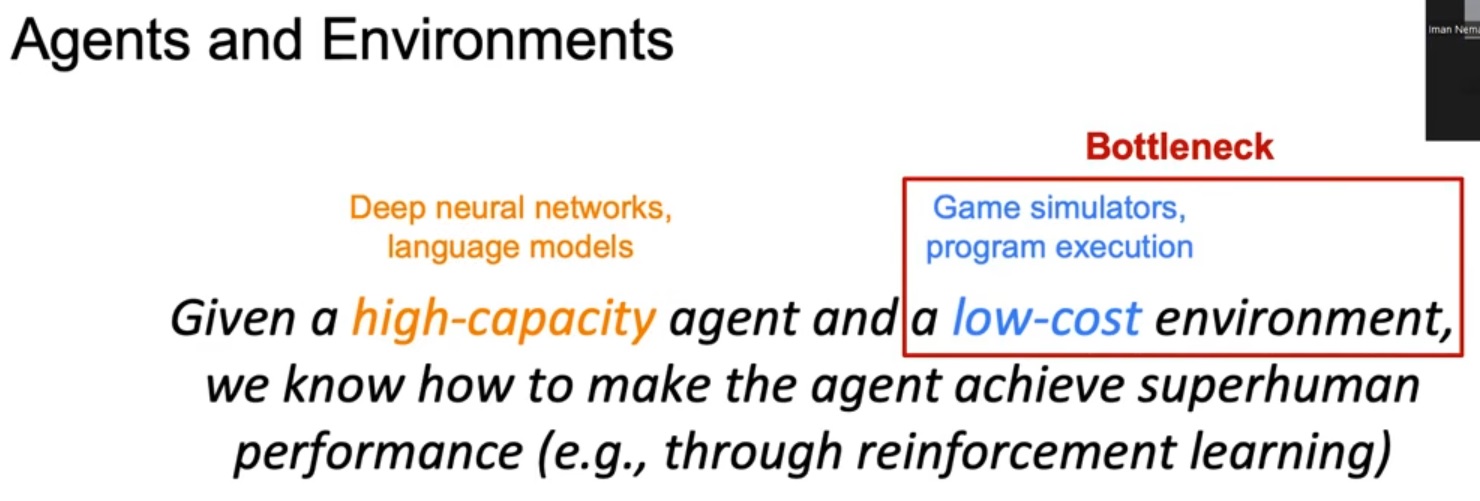
科研界几乎已经摸清楚,满足下面两个条件就可以实现超越人类的性能:第一,拥有高能力智能体,也就是深度神经网络大语言模型;第二,低成本交互,也是当下很多环境面临的真正瓶颈。我举的游戏和代码这两个例子,运行成本很低,因为它们都属于虚拟场景。
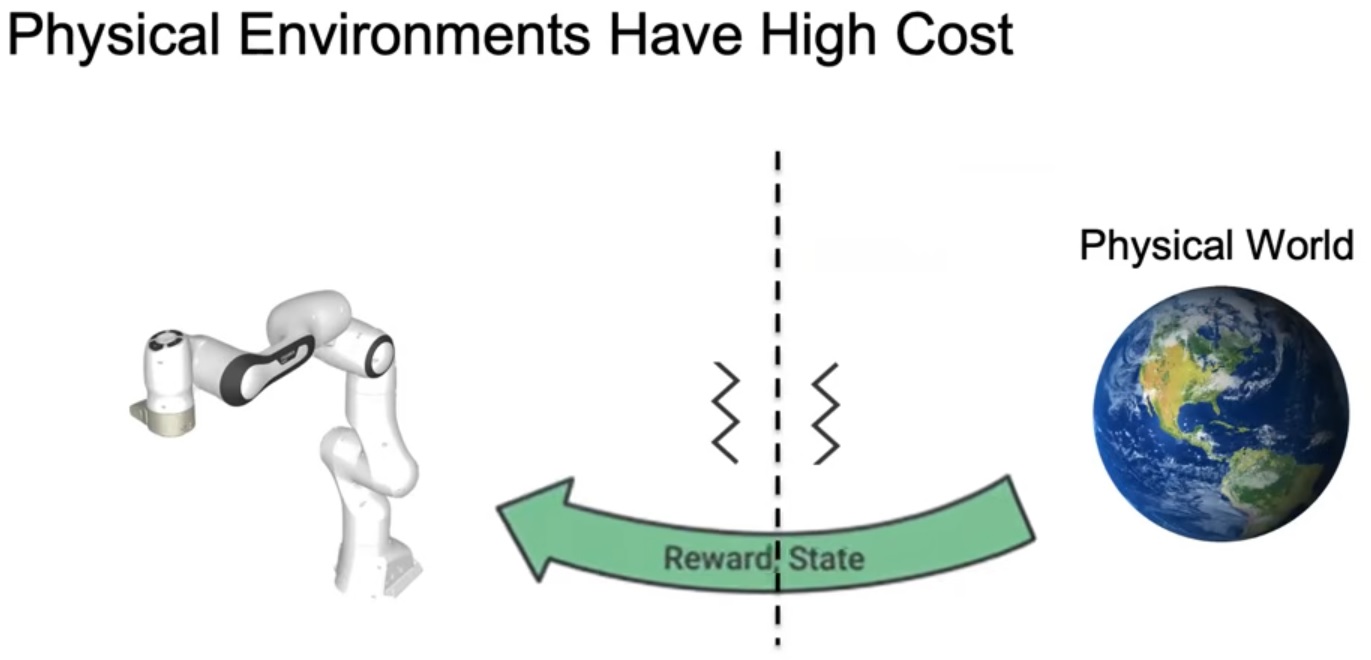
但物理人工智能这类场景,并不具备低成本交互这个条件。物理环境的运行成本极高,因为我们必须在现实世界中实际执行动作,才能判断动作效果。现在有大量研究工作利用机器人数据学习机器人世界模型。如果我们可以训练一个模型来替代真实世界,那我们就回到了阿尔法狗、代码生成大模型的那套范式。因为现在我们可以在云端完成全部仿真,借助强化学习不断优化智能体,直到它达到超人类水平。
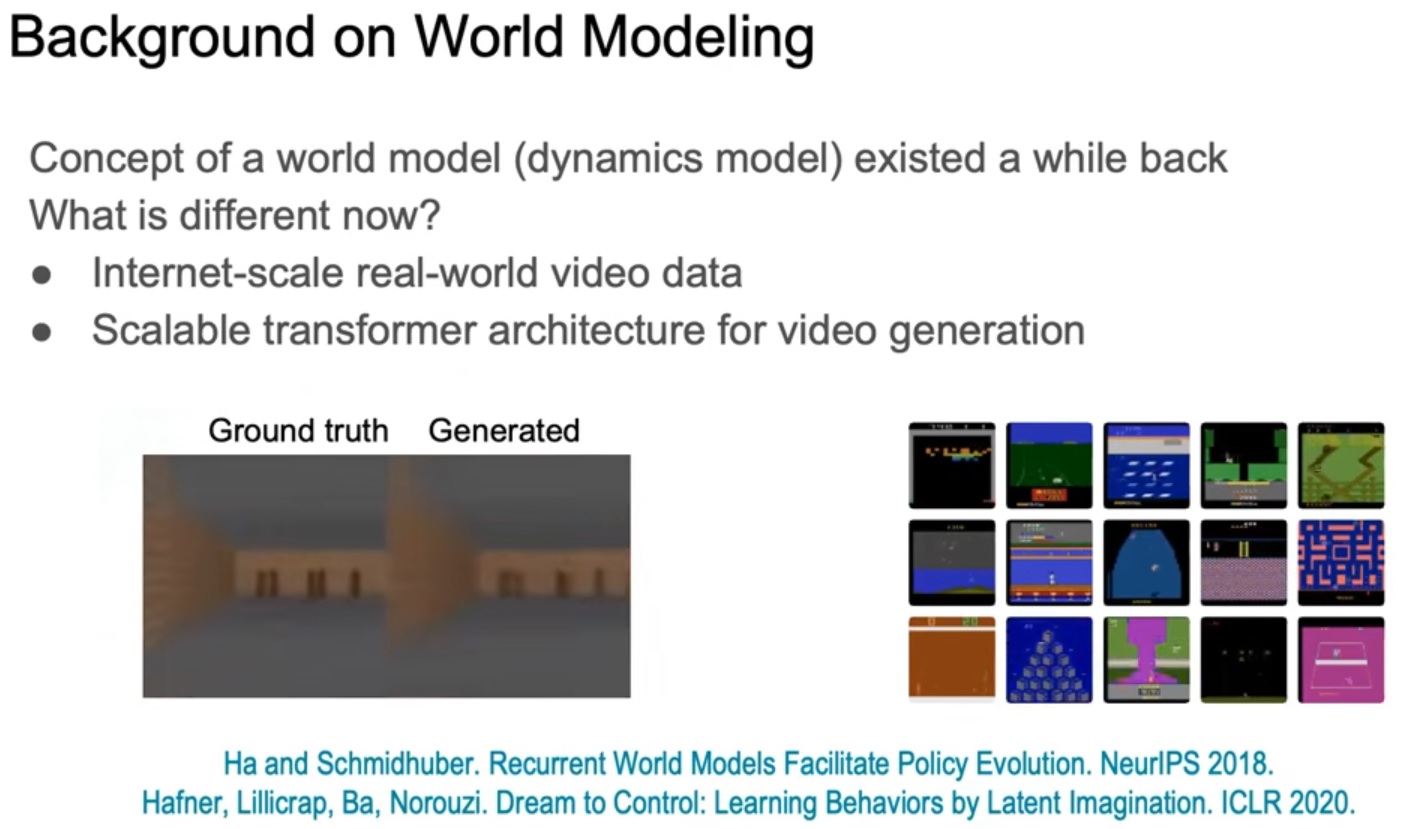
为什么世界建模如今突然备受关注?我认为有两点关键因素:第一是互联网规模的真实世界视频数据。过去我们无法获取这类互联网数据,而现在我们拥有大量大规模数据集;第二自然就是可扩展的 Transformer 架构,它可以完成视频生成等任务。这就是世界模型领域两个主要的进展。
2 数据+模型架构
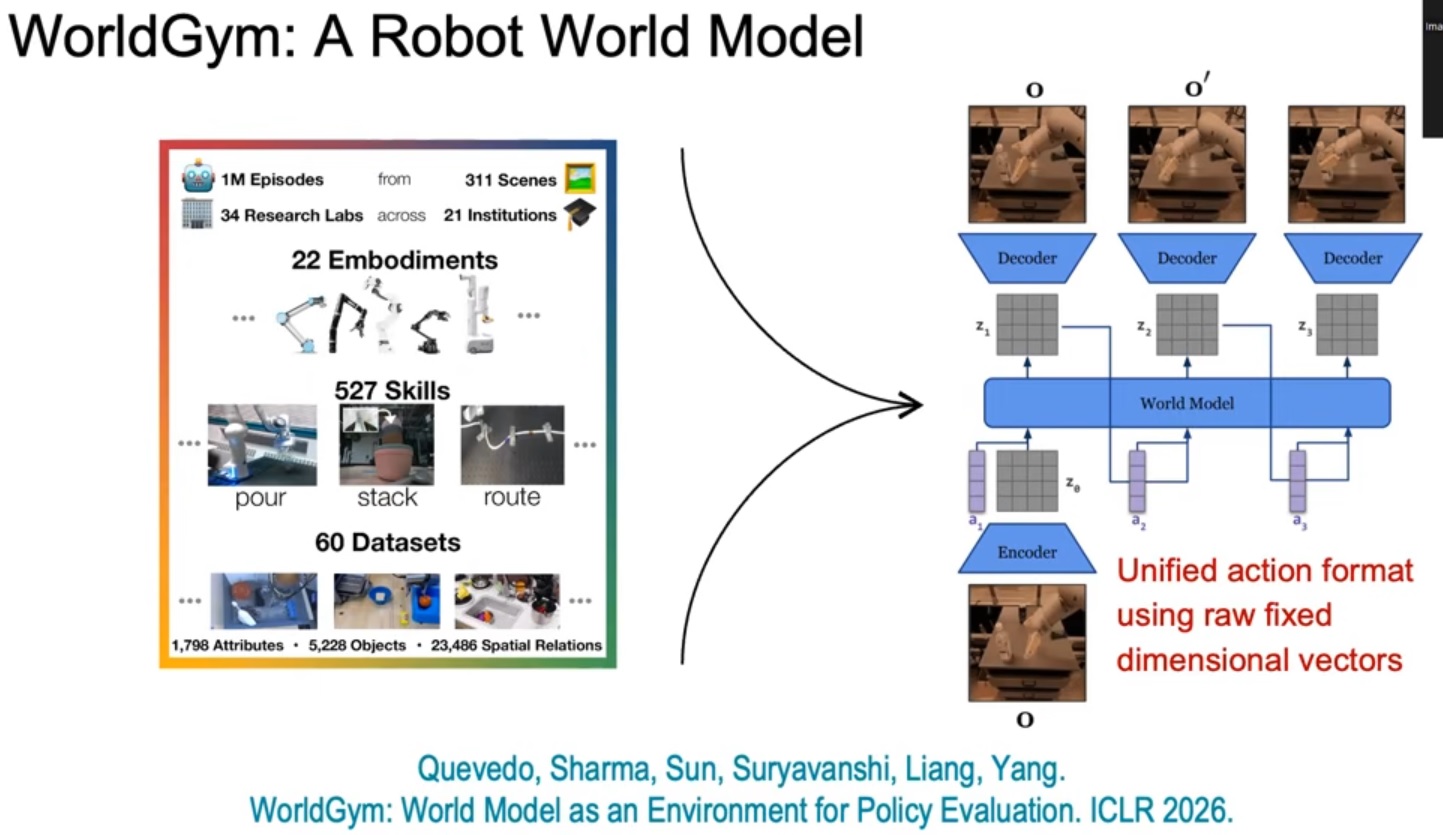
我们没有机器人领域的互联网级数据集,但我们拥有 Open X‑Embodiment 这类大规模汇总数据集。World Gym 架构层面,我们采用可扩展 Transformer架构,具体是 DiT 架构:把图像编码到隐空间,使用 Transformer 对隐变量建模,再通过扩散步骤生成连续隐变量,最后解码还原出图像。这套架构并没有特别新奇的地方,World Gym 的贡献并不是提出全新架构,而是充分利用现有技术,验证可以实现的能力。
3 World Gym 评估
将基于机器人动作条件的视频生成作为机器人世界模型,有一个很大优势:世界模型评估方式十分清晰。我们预留一部分测试集,里面包含真值动作,以及真实机器人执行这些动作后录制的真实视频。评估时,只需要取测试集的初始画面帧,输入真实数据里的动作序列,得到模型生成视频,再和真实发生情况的参考视频做对比。这就是我们采用的评估手段,并且在多种机器人上做了对比。总体来看,模型可以很好地响应机器人输入的控制动作,这里使用的动作是常见的末端执行器位姿控制。
另一种评估世界模型的方式:编写固定的硬编码动作,查看机械臂是否能够响应程序指令。我们清楚每个动作维度对应的含义,于是尝试让机械臂沿着不同轴运动。我们向世界模型输入动作指令,让机械臂左右、上下移动。可以看到,这套控制方式对多种机器人都具备泛化能力,至少视觉层面上效果是成立的。
4 World Gym 应用
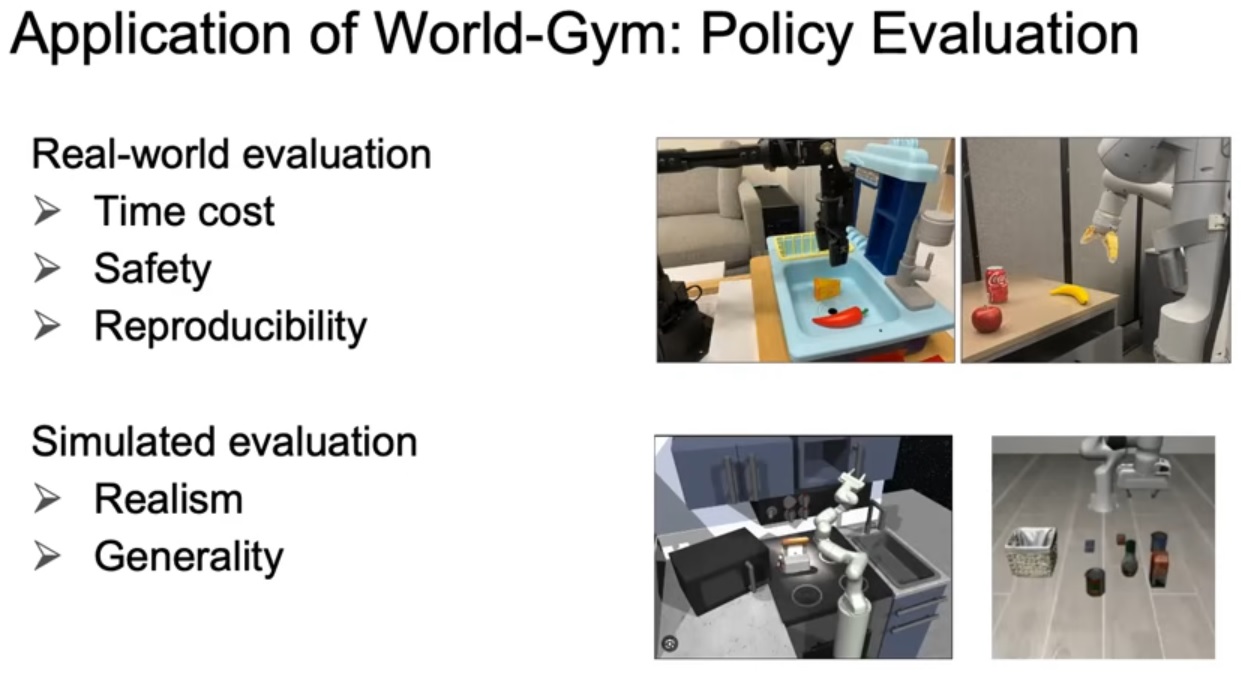
最直接的应用场景就是机器人策略评估。现实环境下做评估,需要耗费大量人力时间等待机器人完成测试,还存在机器人发生损坏导致的安全风险;同时复现难度很高,每一篇机器人相关论文都有专属硬件环境与机器人平台,很难和其他论文的结果做横向对比。以上都是真实机器人评估存在的难点。于是研究者转向仿真评估。但仿真器本身也存在缺陷:真实度不足,物体交互场景下问题尤为突出;泛化能力有限,只能模拟少量任务,很难支撑上万项任务的评估。这就是机器人评估领域的现状。
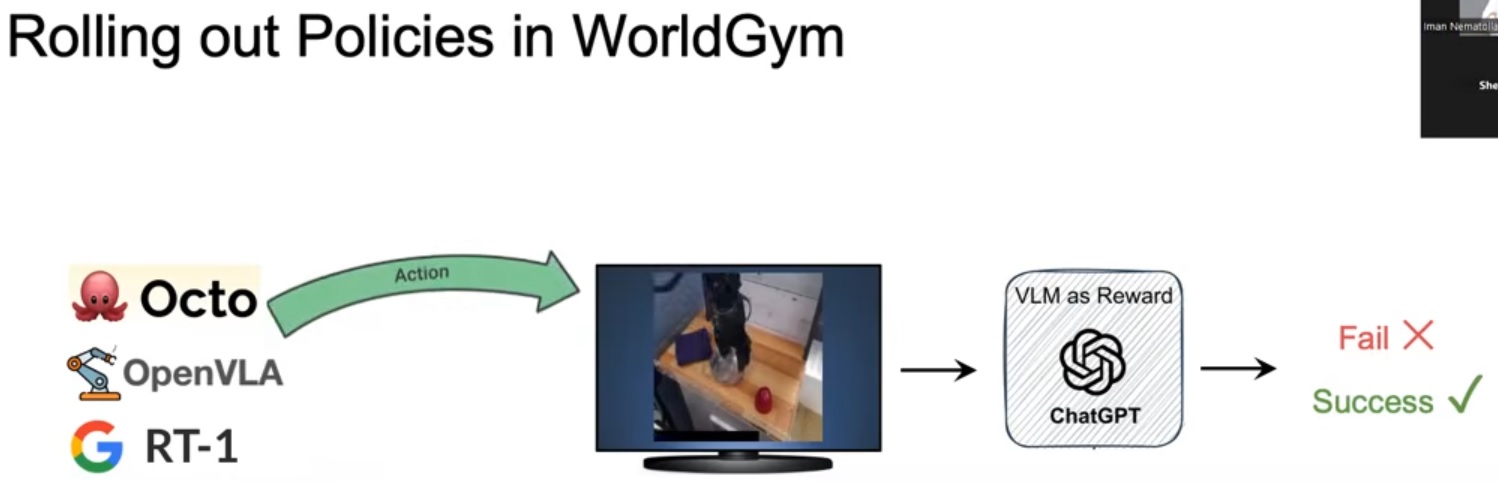
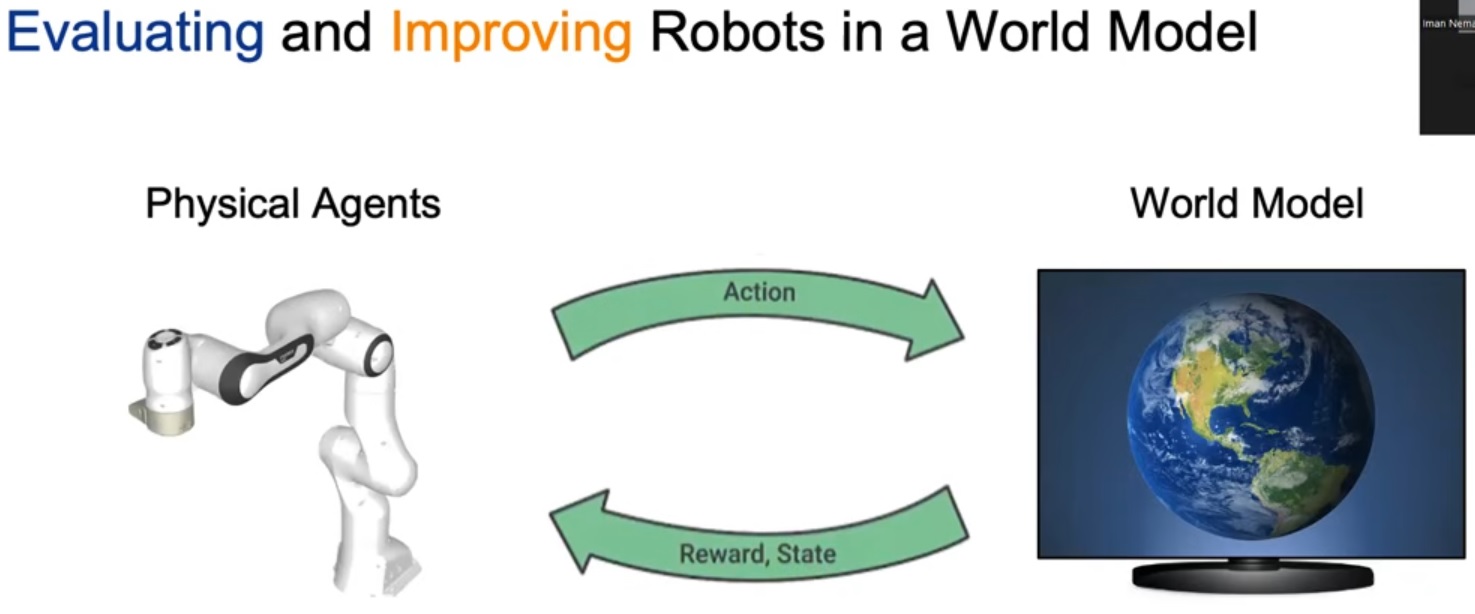
直接在World Gym世界模型中运行机器人策略,得到生成视频,再借助奖励机制分析视频,判断任务是否完成。我们测试了多种策略,包括 Octo、OpenVLA 以及 RT1。策略接收图像输入,输出 x、y 方向偏移量的控制动作;世界模型生成视频,把最新画面传回策略模型;所以策略可以继续输出后续动作序列,最终生成完整的任务执行视频。之后把视频交给视觉语言模型,由它判断任务执行成功还是失败。
4.1 定性评估
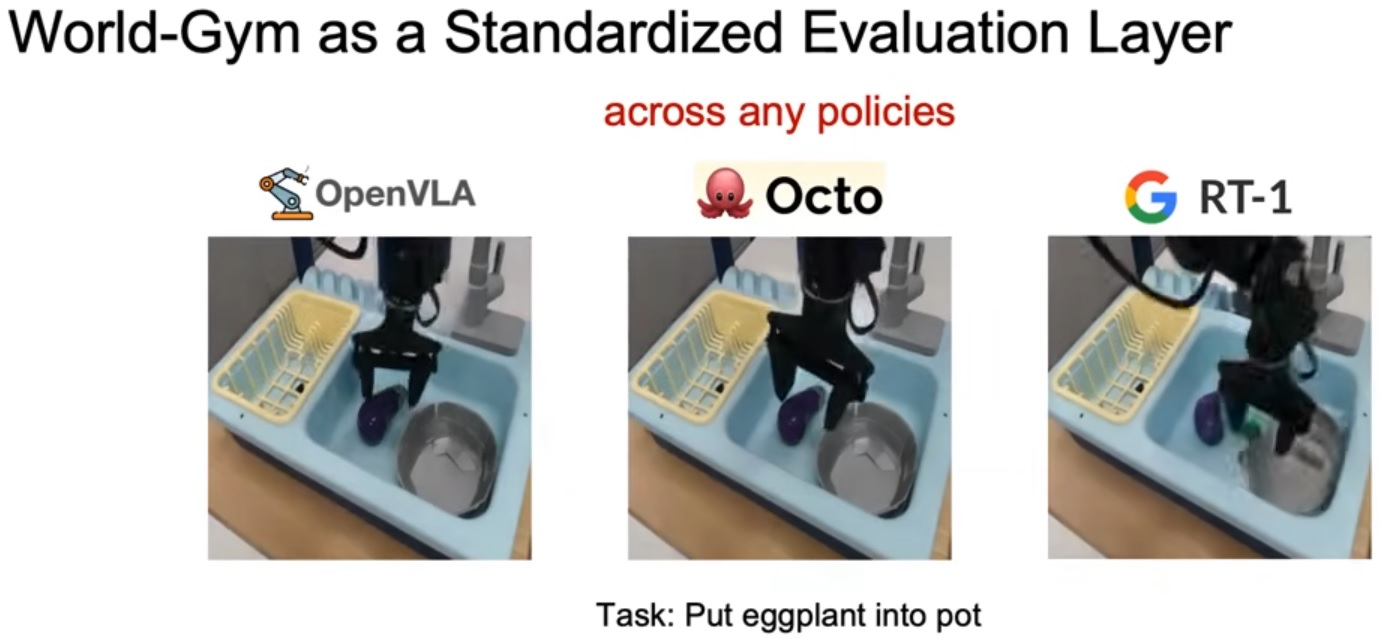
我们发现这套方案效果很不错,可以观察不同策略在世界模型中的执行表现。实验:把茄子放进锅里。三种策略表现差异十分明显:OpenVLA 的表现很好,可以抓起茄子并放进锅里;Octo 能够抓起茄子,但无法完成完整任务;RT1 是三四年前提出的策略,本身性能偏弱,我们用它来观察劣质策略会出现什么状况。结果显示,它输出的动作分布偏移过于严重,甚至让世界模型出现异常。这也警示我们,这类动作不能放到真实机器人上运行,否则机器人同样会损坏。从某种意义上来说,世界模型充当了标准化评估层,各类机器人策略都可以在其中运行,实现横向对比。
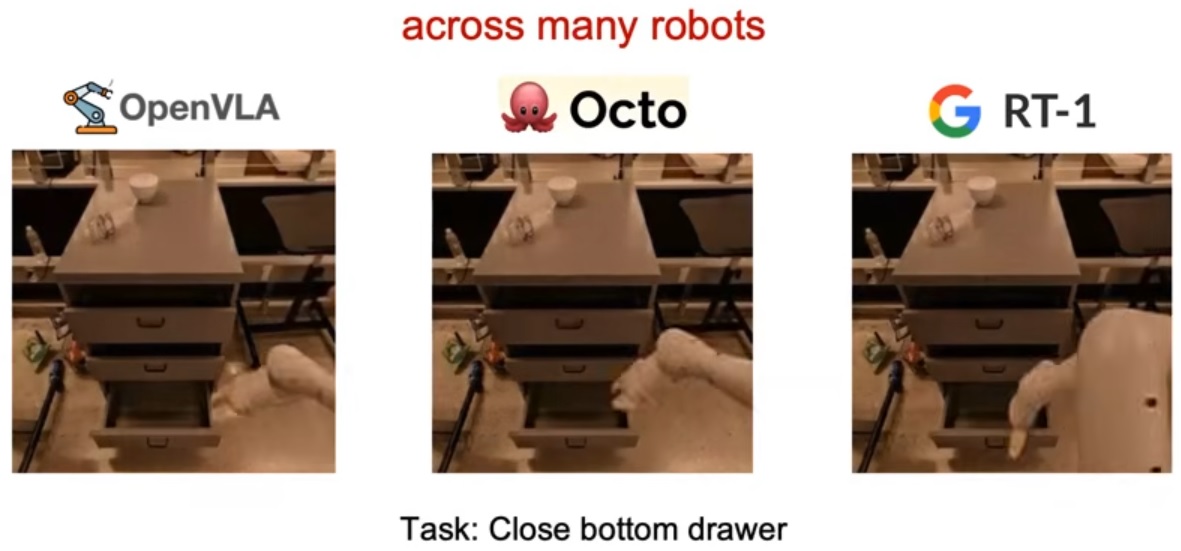
此外,世界模型可以面向多种机器人提供统一评估标准。我们换另一台机器人,测试任务为关闭底部抽屉。可以看到,基于策略输出的动作,世界模型渲染出执行画面;三种策略,包括多年前开发的旧策略,都可以较好完成这项任务。
4.2 定量评估世界模型本身的质量
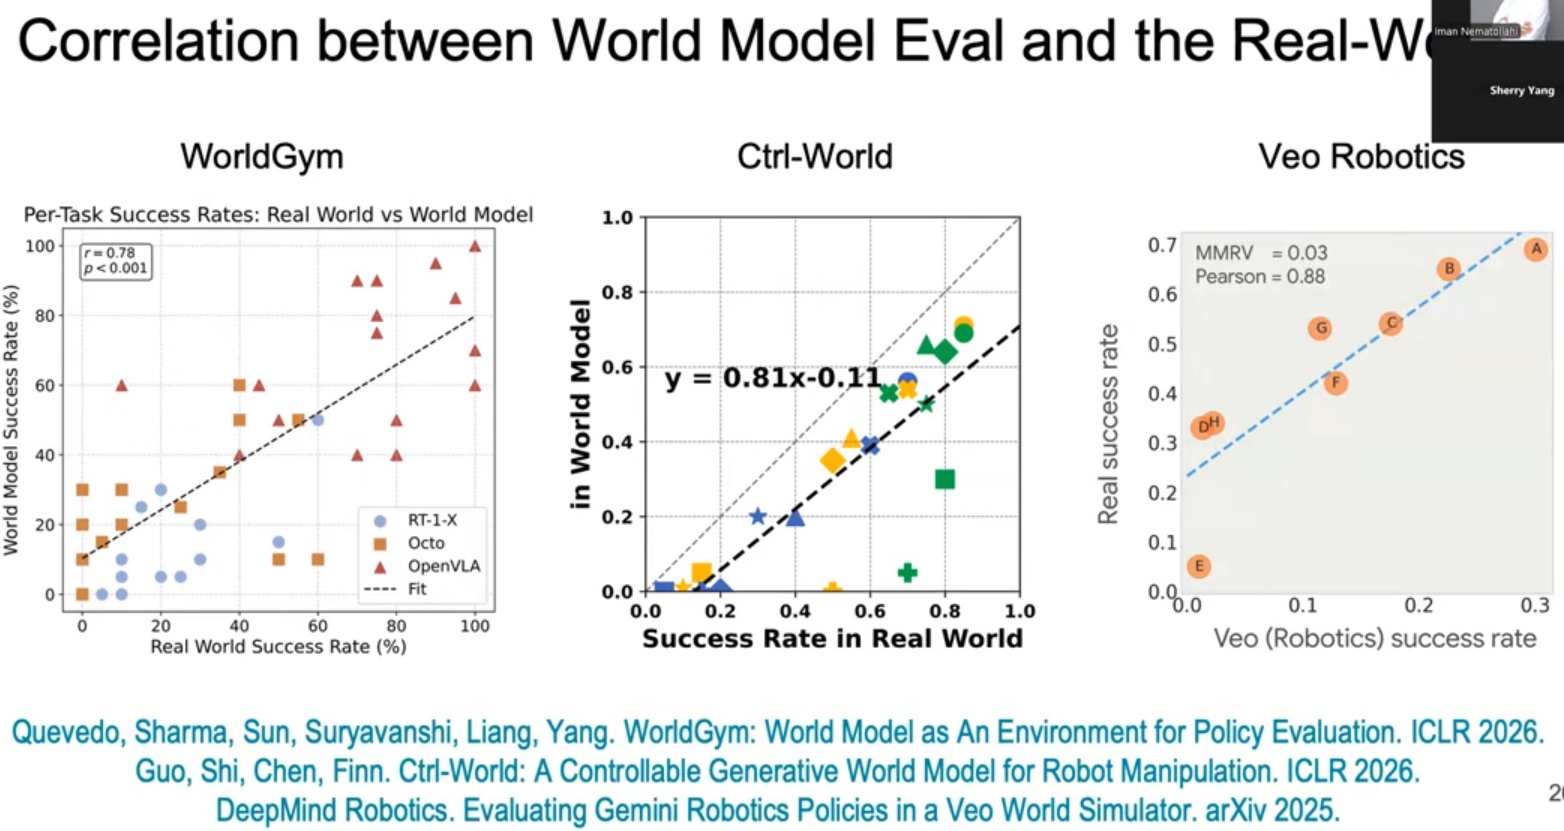
我们还可以依据世界模型评估结果与真实世界评估结果的吻合程度,量化衡量世界模型本身的质量。实验:横轴记录不同策略在各个任务上的真实环境成功率,纵轴记录世界模型给出的对应策略和任务的成功率。理想情况下,所有数据点都落在对角线上,相关系数为 1,但现实达不到这个效果。实验发现:真实环境评估结果和世界模型评估结果存在显著正相关。不过世界模型依旧会高估或者低估策略性能。但即便如此,这依旧是迈向云端机器人评估的重要一步,我们无需动用真实机器人硬件。在我们开展 World Gym 研究的同一时期,Ctl-World、Google Veo Robotics 等多项工作也得到相似结论:真实环境成功率与世界模型评估成功率之间存在正相关关系。
4.3 各种场景评估
1)构建任意分布外评估场景
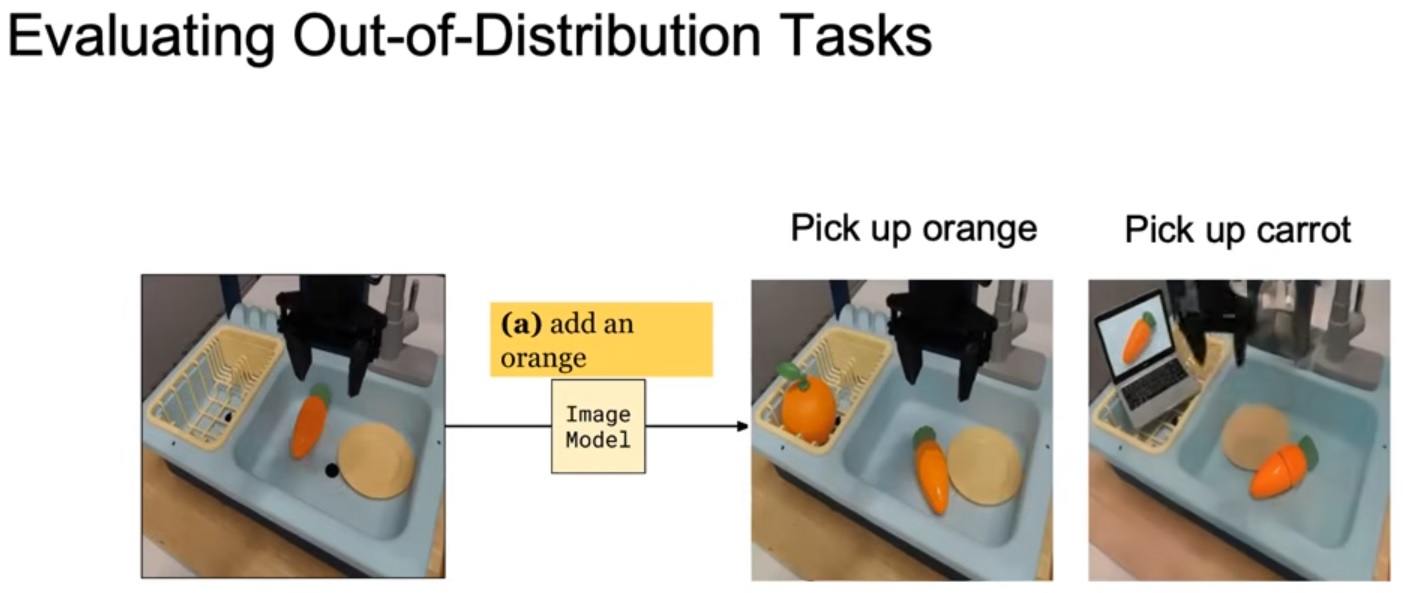
但更重要的是,世界模型不仅仅可以复现真实场景,还能够构建任意分布外评估场景,不需要人为布置实体环境进行评估。左侧原图对应的原始任务是拿起胡萝卜。借助世界模型,我们只需要做图像编辑就可以修改场景。我们借助 Nano‑Banana 工具加入一个橙子,把任务改成拿起橙子。运行策略之后发现,策略依旧会优先去操作胡萝卜。这说明至少我们测试的 OpenVLA 这类视觉语言策略,对全新任务的泛化能力并不理想。
下面这个例子有点滑稽,但它展示了我们可以在高风险、安全关键场景下完成策略评估。场景里,胡萝卜显示在电脑屏幕中,现实中我们肯定不希望机器人撞坏电脑,但是我们只是想看看如果我们下达指令让机器人拿起胡萝卜会发生什么。画面是模型生成的,我们可以看到在世界模型中机器人反复抉择目标,最后竟然朝着屏幕里的胡萝卜伸过去。这个行为显然不可取。但这充分拓展了思路,告诉我们该如何在世界模型中完成各类策略评估。
2)构建有干扰物场景
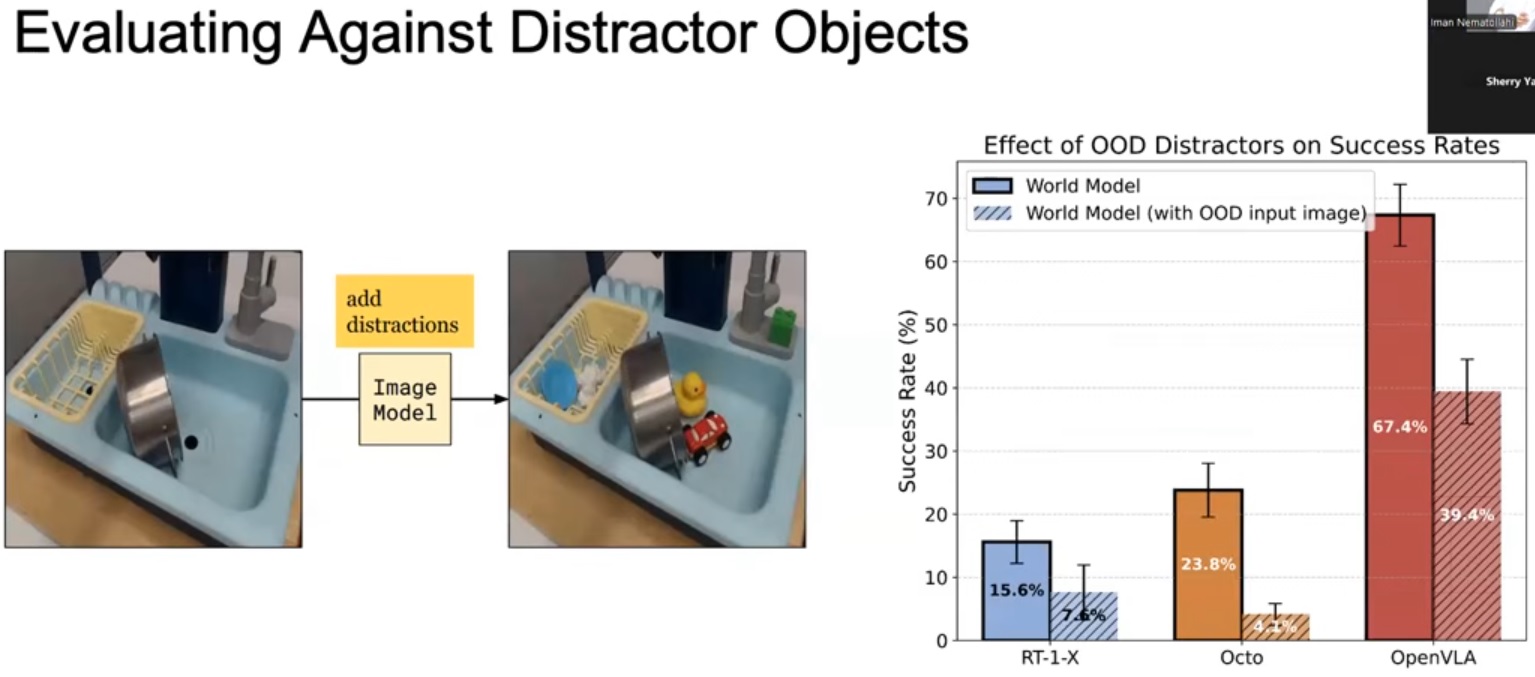
原始任务是拿起罐子,策略原本可以达到 67.4% 左右的成功率。我们结合图像编辑工具,往场景中加入橡皮鸭、玩具小汽车等干扰物体,任务依旧是拿起罐子。测试的三套策略性能都出现大幅下滑。这说明这些策略面对干扰物体时鲁棒性很差。而这类测试,依托世界模型就可以轻松实现。
4.4 调试策略
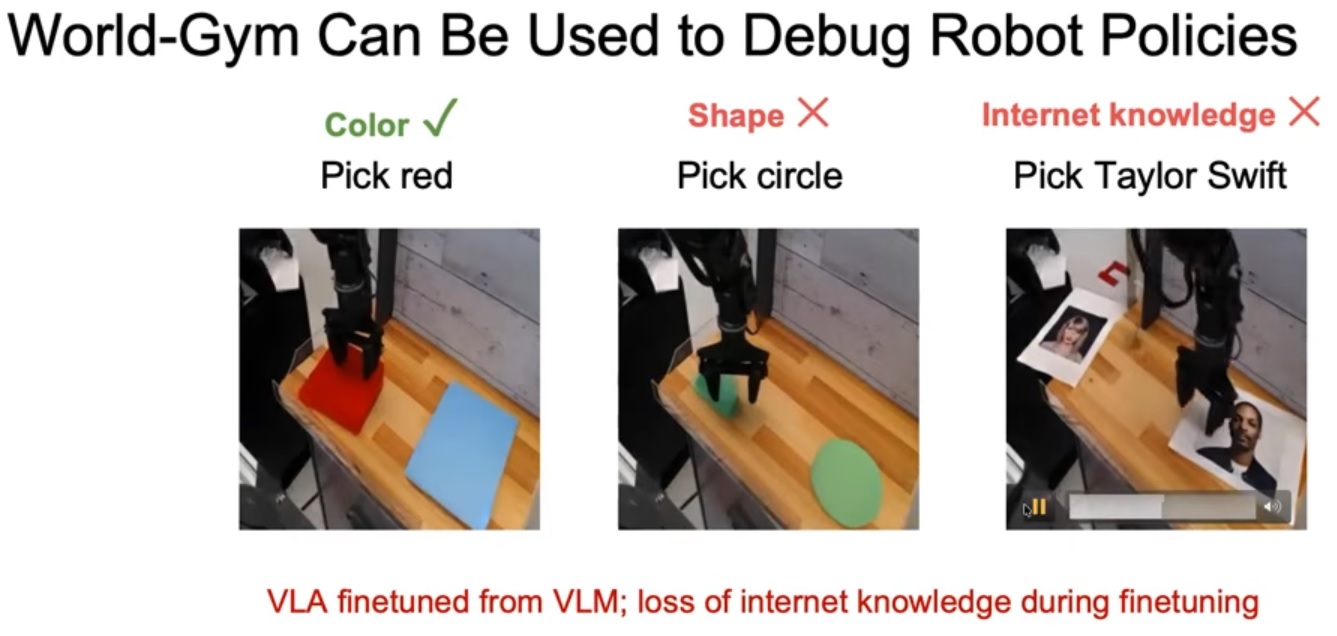
利用世界模型调试策略。策略执行失败时,我们想要定位失败根源:是无法理解语言指令,分不清颜色,看不懂形状,还是缺少互联网通识知识?我们可以自由搭建测试环境,针对特定维度开展评估,例如颜色识别能力。我们在环境中放置不同颜色纸片,指令要求拿取红色纸片。策略对颜色识别表现良好,指令红色就找红色,指令蓝色就找蓝色。但形状识别表现截然不同。下达拿取圆形物体的指令,机器人选对选错的概率各占一半。我们推测原因在于VLA训练数据集存在颜色偏向:样本里经常出现 “拿起黄色香蕉” 这类描述颜色的标注,但很少出现 “拿起圆形苹果” 这类描述形状的标注。所以策略对颜色的理解能力整体优于形状,这个结论就是我们在世界模型中调试得到的。
最后一个例子同样很有意思。场景摆放多张名人海报,指令让机器人去找泰勒・斯威夫特,机器人选对目标的概率依旧只有一半。有趣的一点是,即便机器人策略基于VLM视觉语言模型微调而来,却丢失了VLM视觉语言模型原本具备的互联网通识知识。VLM视觉语言模型本身完全可以识别泰勒・斯威夫特的海报。但是经过机器人数据集微调之后,生成的策略却无法定位对应的海报。借助世界模型,我们可以直观复现该错误行为。这恰恰是反馈强化学习的典型适用场景:相比于专门采集真人遥操控海报分类的数据集,我们可以很方便地判断策略行为对错。
5 第一部分内容总结
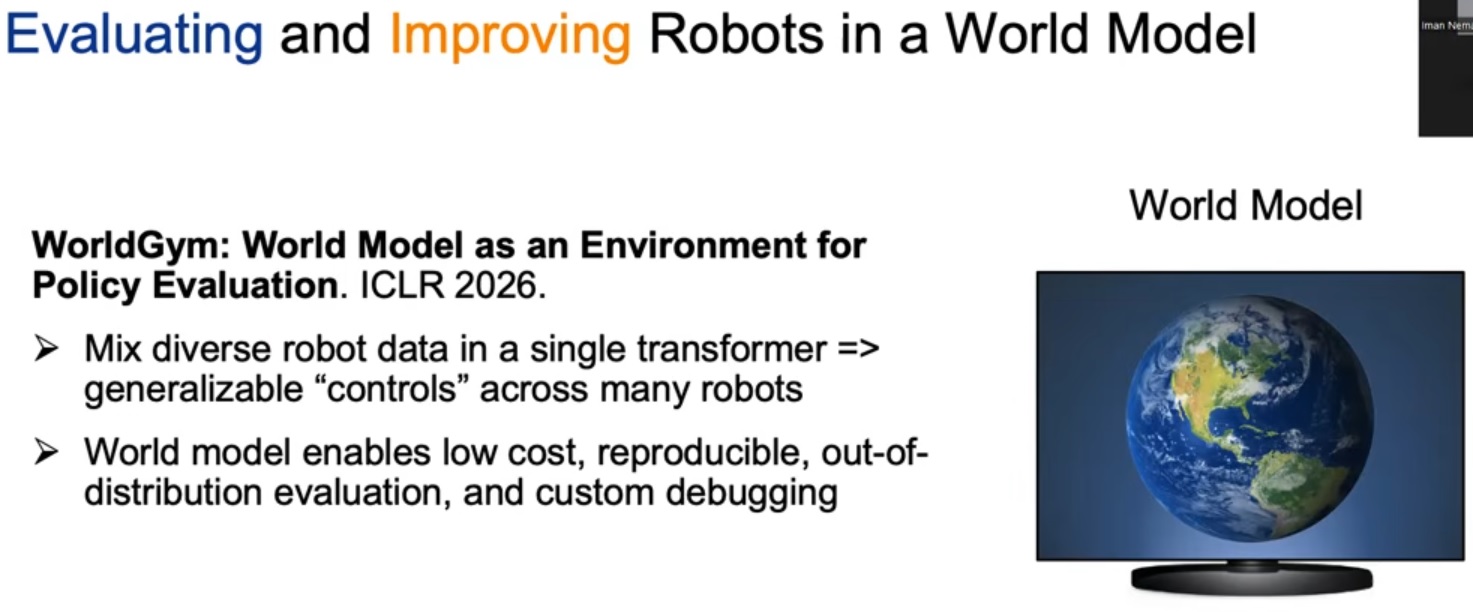
介绍了 World Gym。核心收获是:我们可以融合多源异构机器人数据,因为不同机器人前向运动学模型、动作格式各不相同,但动作控制信号最终都会转化为观测空间的变化。由此我们得到一个支持多种机器人、具备通用性的可控仿真环境。该环境成本低廉、实验可复现。你可以运行多种不同策略;同一个模型可以评估多款机器人的性能;还支持分布外场景测试以及自定义调试。
二 在 World Gym 中强化学习训练策略
1 为什么选择强化学习
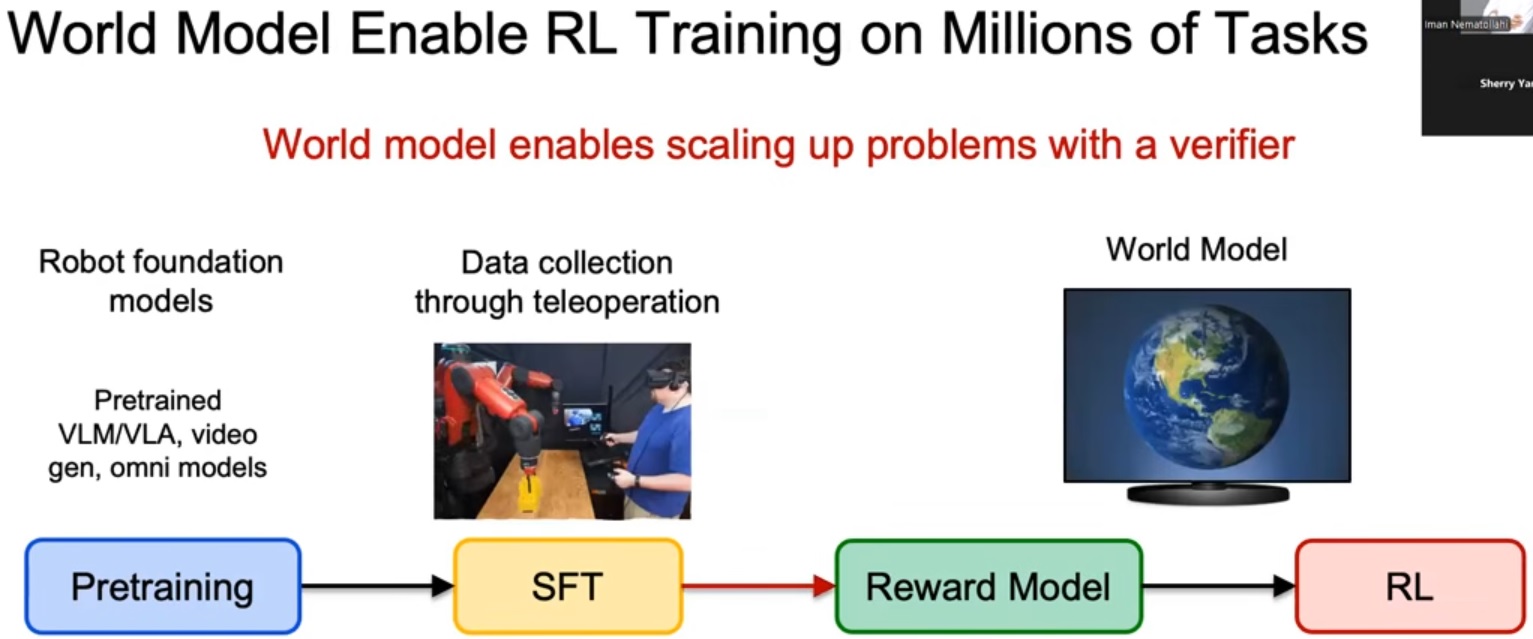
大语言模型领域GPT‑3 发展到 ChatGPT,关键就在于规模化强化学习,因为强化学习使用验证器 可以大规模扩充训练任务数量。机器人领域通用奖励模型可以告诉我们:无论任务是什么、机器人型号是什么,都可以评判执行效果好坏。正是缺少这类奖励模型,我们无法使用验证器像语言模型那样大规模扩充训练任务数量,例如用数百万个厨房场景开展数百万个机器人的训练。而世界模型有望解决这个痛点,它可以构建可扩展仿真环境,模拟数百万个厨房场景,支持模型RL训练并且泛化到全新厨房环境。这就是尽管存在其他技术路线,我们依旧选择在世界模型中开展强化学习的原因。
2 整套训练设置
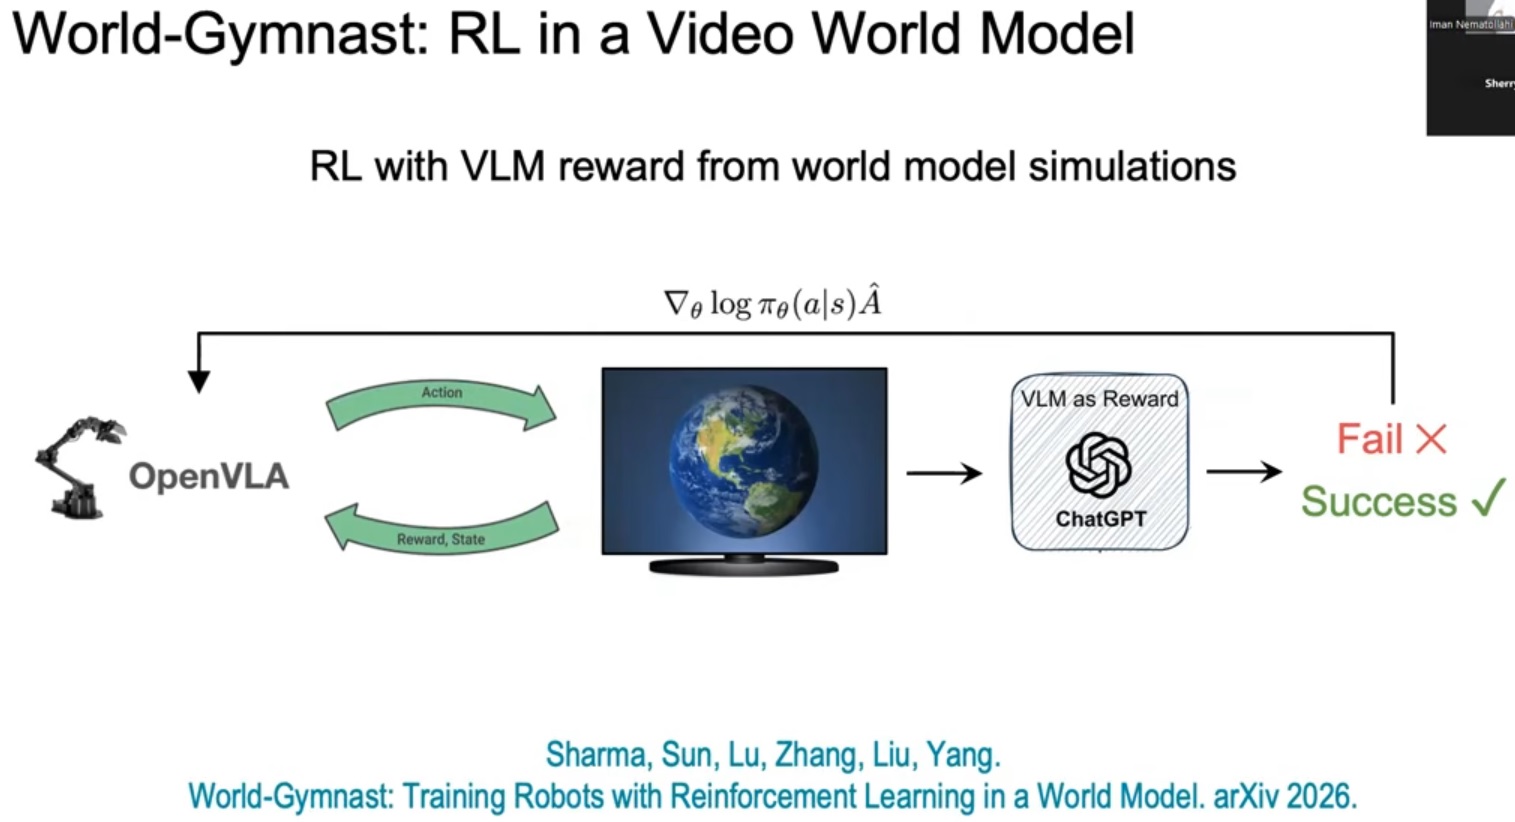
World Gymnast 整套实现逻辑复用了前面介绍的评估流程:生成视频,由VLM视觉语言模型对视频打分。我们把任务成功、失败的反馈,通过策略梯度回传给策略模型。简单来说:优势值或者奖励高的动作,提升其采样概率;反之降低概率。我们的目标与历史上聚焦单任务场景的相关工作不一样:我们拥有多样化环境,可以基于任意图像创建各类任务,研究如何借此提升模型泛化能力,而不只是提升单一任务的性能。
2.1 设计训练任务
真正的重点是训练任务的设计:选用什么样的提示词,给模型输入什么样的图像作为待解决场景,如何设计奖励函数。
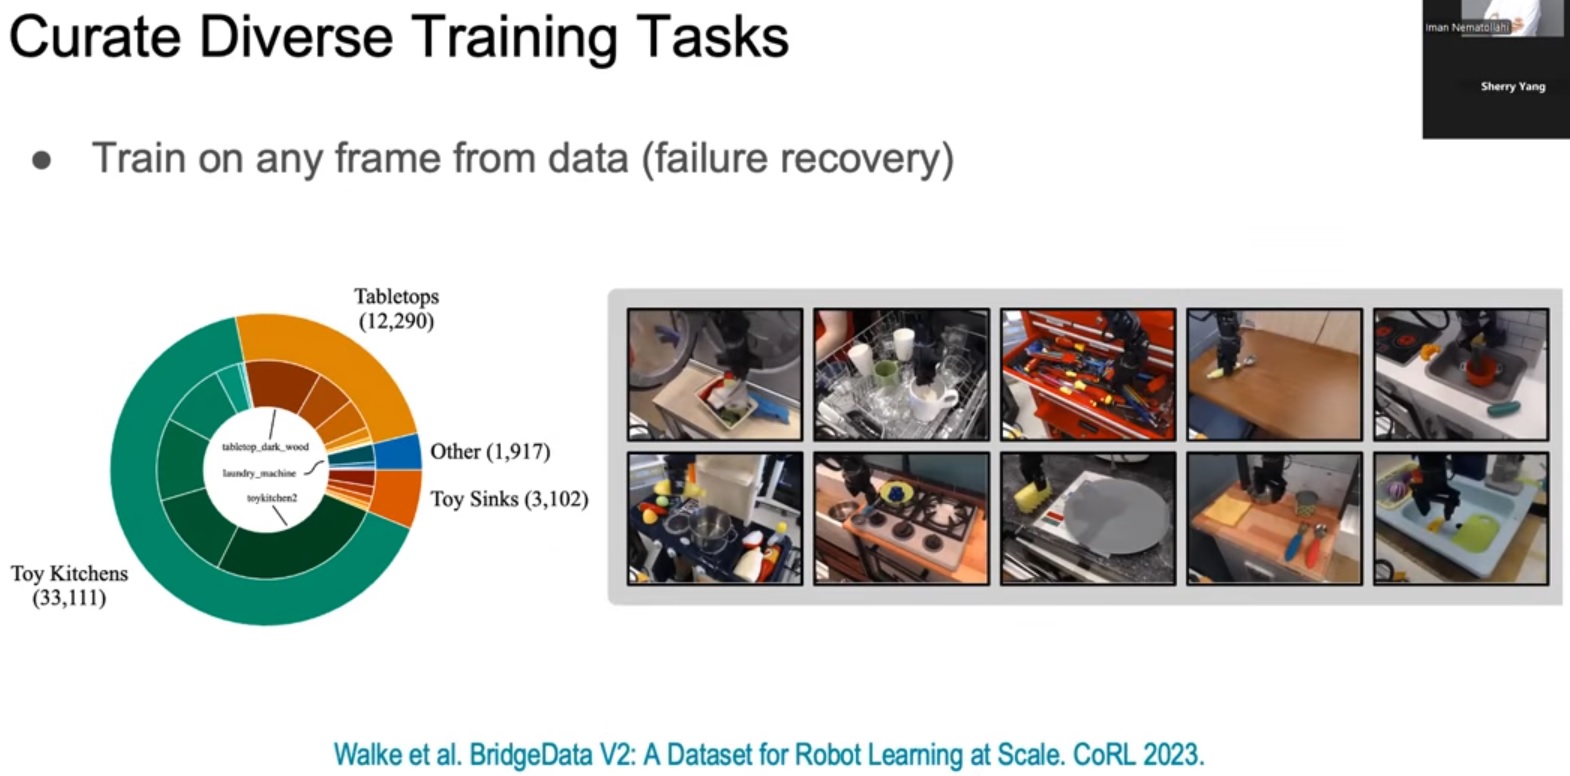
世界模型有一个巨大优势:任意图像都可以充当训练数据。现有遥操作数据集已经包含数百万帧画面,每一帧画面都可以作为策略的起始状态。哪怕画面记录的是机器人任务失败的状态,我们可以从失败帧启动强化学习,训练策略学会故障恢复。使用数据集全部帧开展训练,可以促使模型习得失败之后的恢复行为。
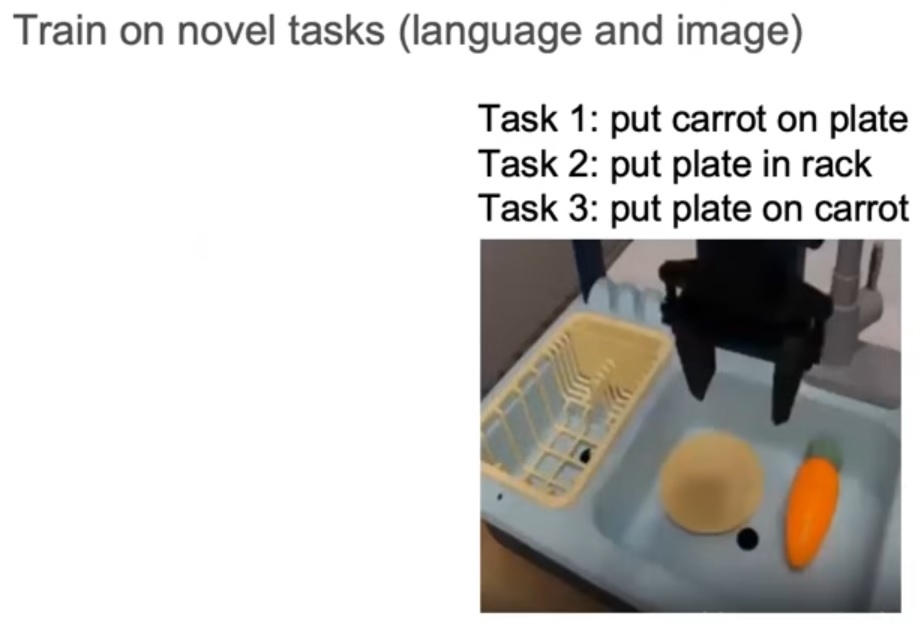
给定任意一张初始图像,我们还可以生成多种多样的任务。可以下达语言指令:把胡萝卜放到盘子上、把盘子放进架子、把盘子放到胡萝卜上。很多机器人学习实验环境配置无法做到在同一个初始画面下生成多样化任务。
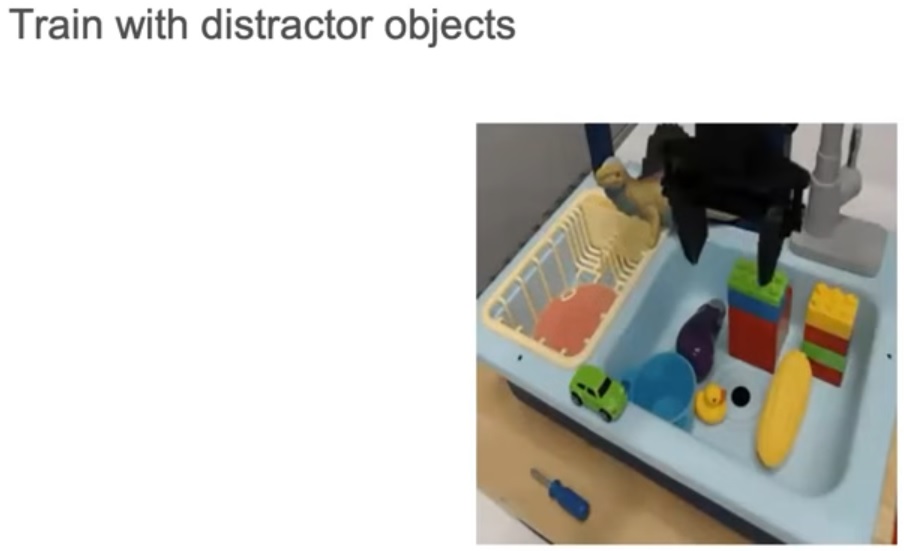
除了构造全新任务,我们还可以添加干扰物体,以此提升策略鲁棒性。
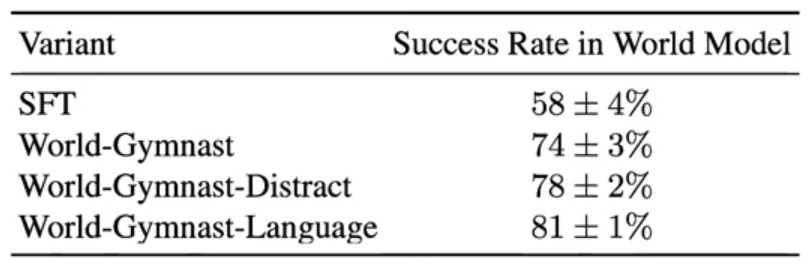
我们观察到:完全不做监督微调,机器人无法正常工作。经过监督微调之后,模型具备一定成功率;再经过强化学习训练,成功率进一步提升。如果强化学习阶段使用更多任务样本,包括加入干扰物体、全新语言指令,在预留测试集上,成功率还能继续上涨。
2.2 设计奖励模型
World Gymnast 选择通用奖励,因为我们希望使用一套通用模板:向VLM视觉语言模型输入任务描述与执行视频。最坏情况下,我们可以雇佣标注人员,把VLM视觉语言模型微调成专门的奖励模型。但本次工作方案很简洁:输入语言指令和评判标准,VLM视觉语言模型就可以判断基于动作生成的视频对应的任务是否成功。
3 评估
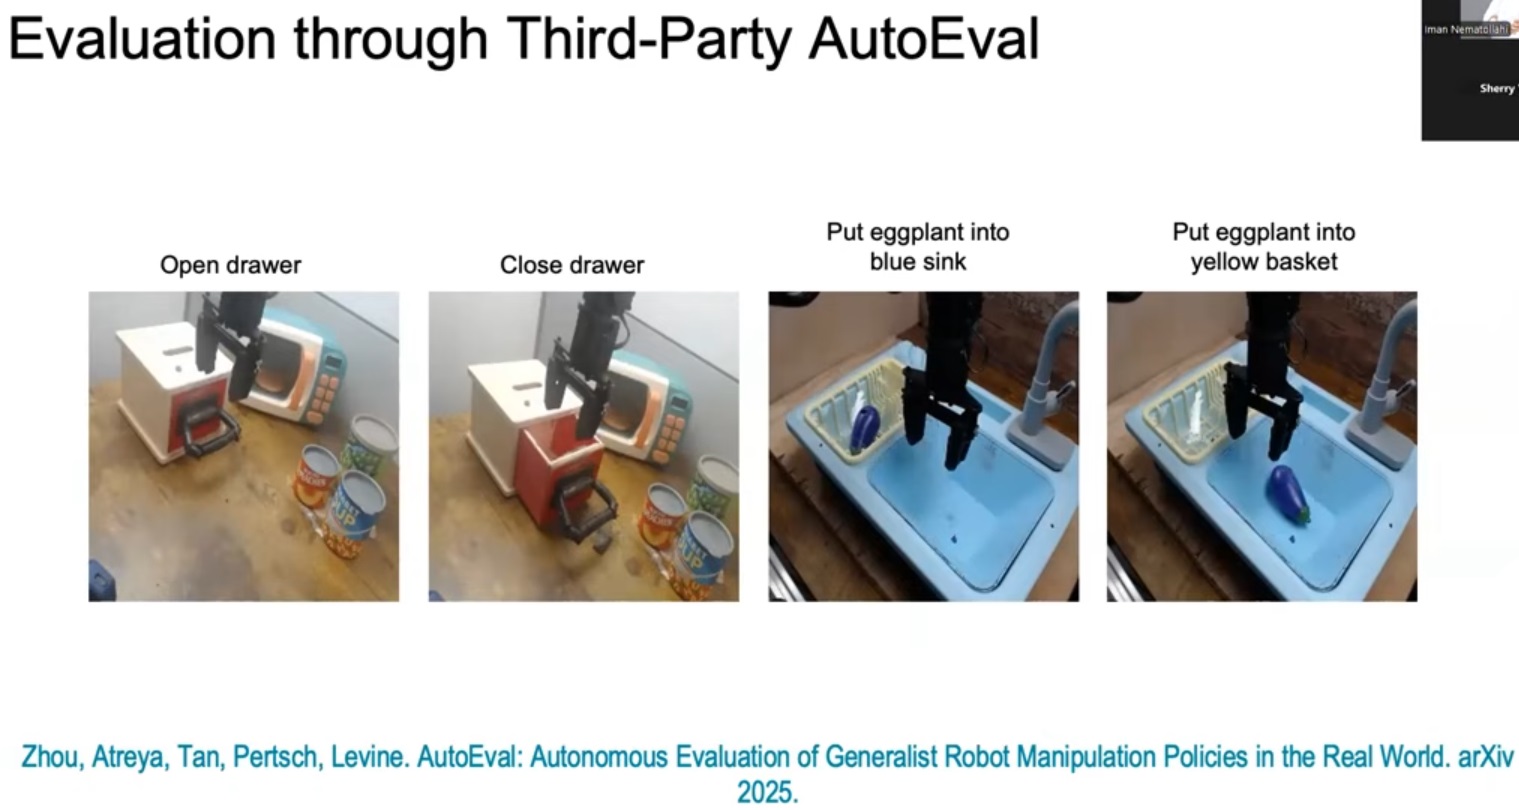
在评估环节,避免陷入机器人领域老生常谈的噩梦:实验结果无法复现。为此我们选用第三方评估平台 AutoEval保证评估的客观性。真实机器人由平台自动控制,环境自动重置。我们只需要提交策略,甚至可以开展 A/B 测试来对比不同策略的成功率。AutoEval 支持四项简单任务:拉开抽屉、关上抽屉、把茄子放进篮子、把茄子取出来。
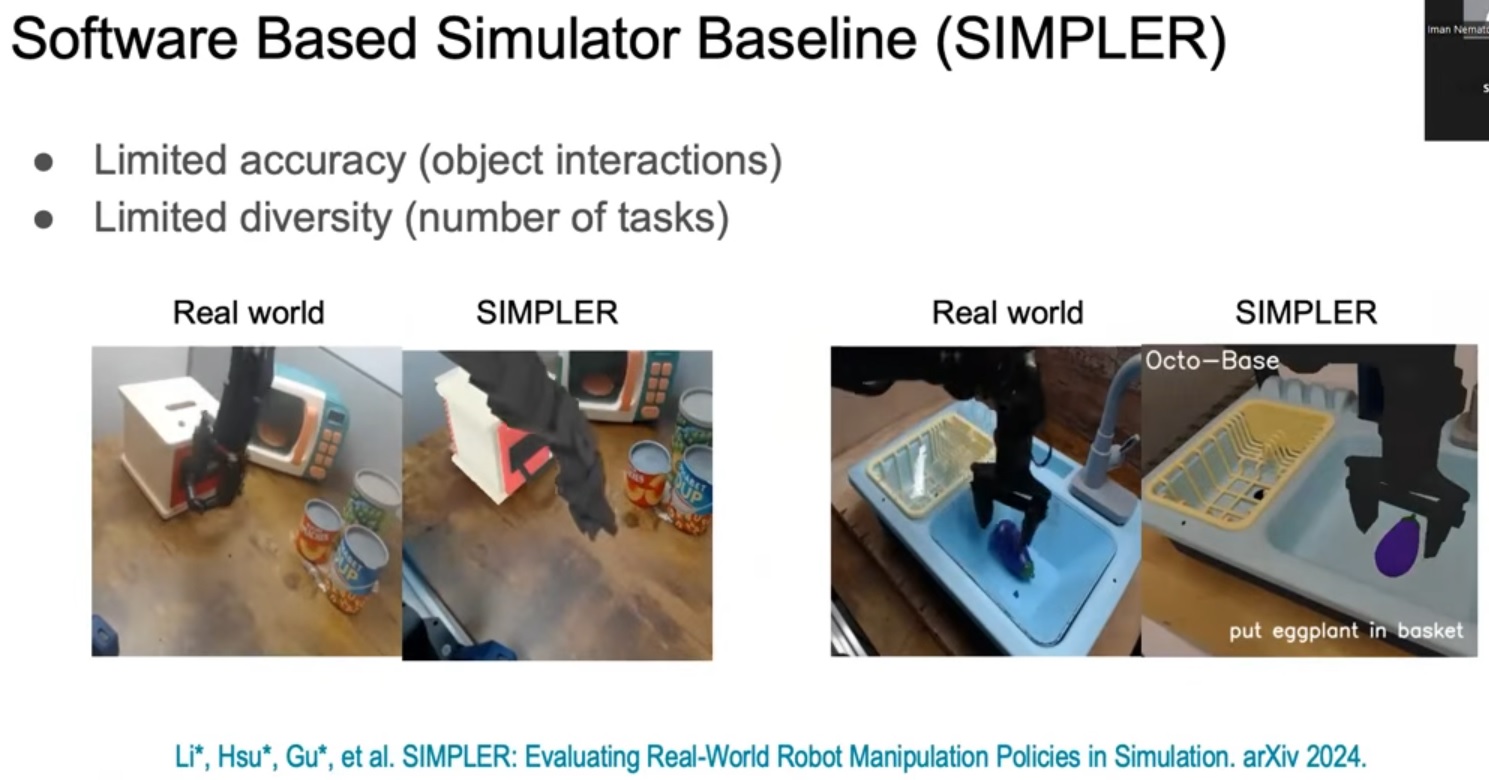
我们选用SIMPLER软件仿真器作为基线。我们把同一套动作序列分别在真实环境和 SIMPLER 仿真器中复现,这是真实到仿真的迁移方式。即便输入动作完全一致,两者的执行结果却差异巨大。软件仿真器普遍存在物体交互仿真精度不足的问题,支持的任务种类也有限。Simpler 只能处理少量任务。
实验结果显示,大部分任务上,在世界模型内做强化学习的效果优于仿真器内强化学习,只有关闭抽屉这个简单任务除外,仿真器在该任务上表现尚可。但这里有个需要注意的点:Simpler 仿真器缺少足够任务样本,无法把这四项任务当作未见过的测试任务。而世界模型依托 Bridge 数据集的数百万帧数据,可以把这四项任务设置为预留测试集,用来测试泛化性能。所以 World Gymnast 报告的性能,是模型在全新任务上的泛化能力。而 Simpler 基线是直接在测试任务上完成仿真训练。
除此之外,实验证明强化学习效果优于监督微调以及过滤版监督微调。强化学习可以在世界模型中运行策略,既利用成功样本,也可以从失败样本中学习。
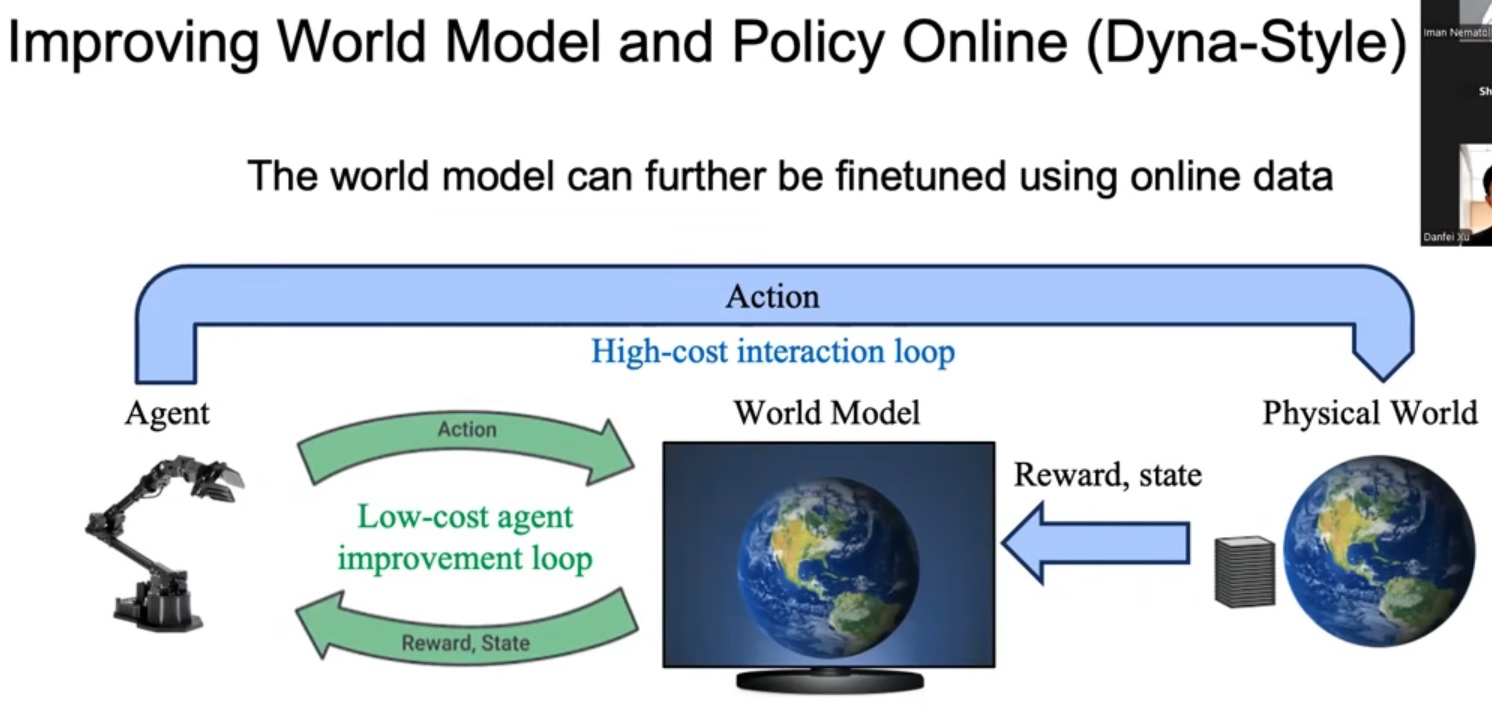
我们还实现了持续学习机制:评估过程收集真实世界数据,反过来优化世界模型。由此形成双循环架构,内层循环低成本完成策略迭代优化。这套思路源自经典 Dyna 算法,算法本身年代久远,但视频世界模型的出现,让 Dyna 算法重新发挥价值。偶尔我们运行评估或高成本交互循环,采集真实数据迭代世界模型。
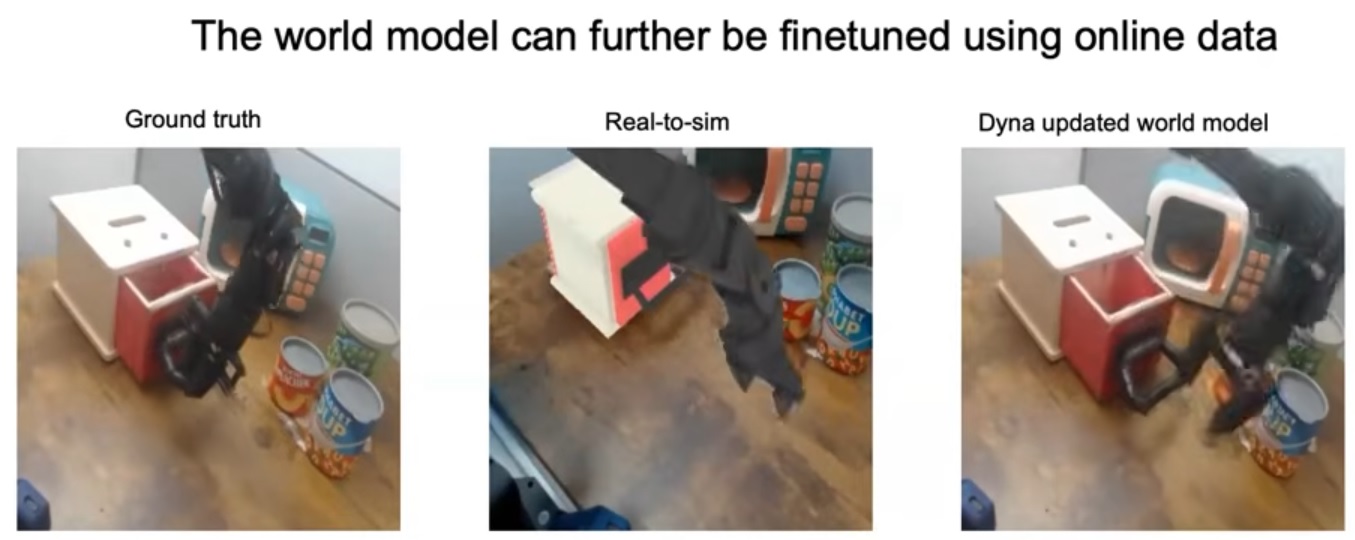
举个例子,左侧是真实世界执行同一套动作的画面;中间是普通软件仿真器,即便新增数据也很难提升仿真效果;右侧是经过 Dyna 微调的世界模型,可以看到它的仿真结果和真实世界高度吻合。
利用在线采集的数据优化世界模型之后,再训练 World Gymnast,关闭抽屉任务的成功率几乎达到百分之百。这是世界模型另一大优势:作为参数化模型,只要有数据,通过梯度更新就可以很容易地完成迭代优化。
4 第二部分内容总结
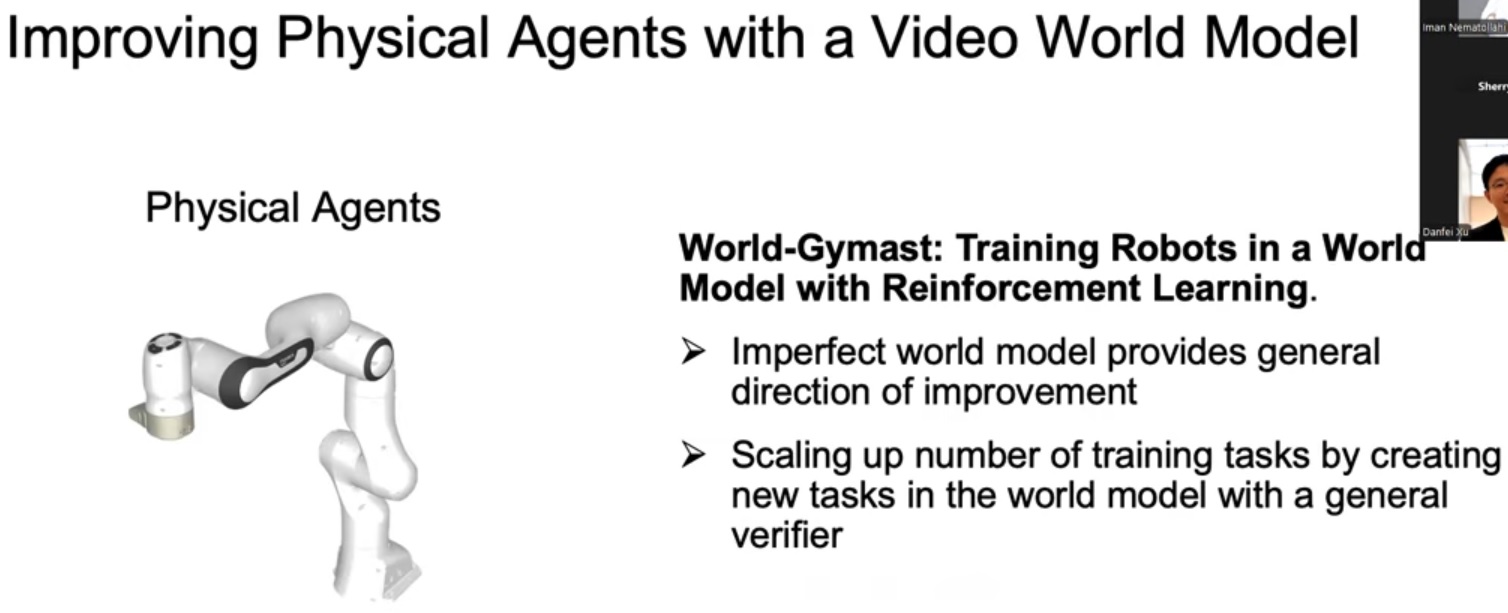 我们介绍了如何在世界模型内部训练机器人策略。第一点,世界模型并非完美:经常会出现生成幻觉,偶尔物体颜色会发生错乱。但即便世界模型存在缺陷,依旧可以输出充足信号,实现策略性能提升。第二点,世界模型让我们可以在百万级任务上训练机器人,训练起点可以是任意初始画面帧。
三 展望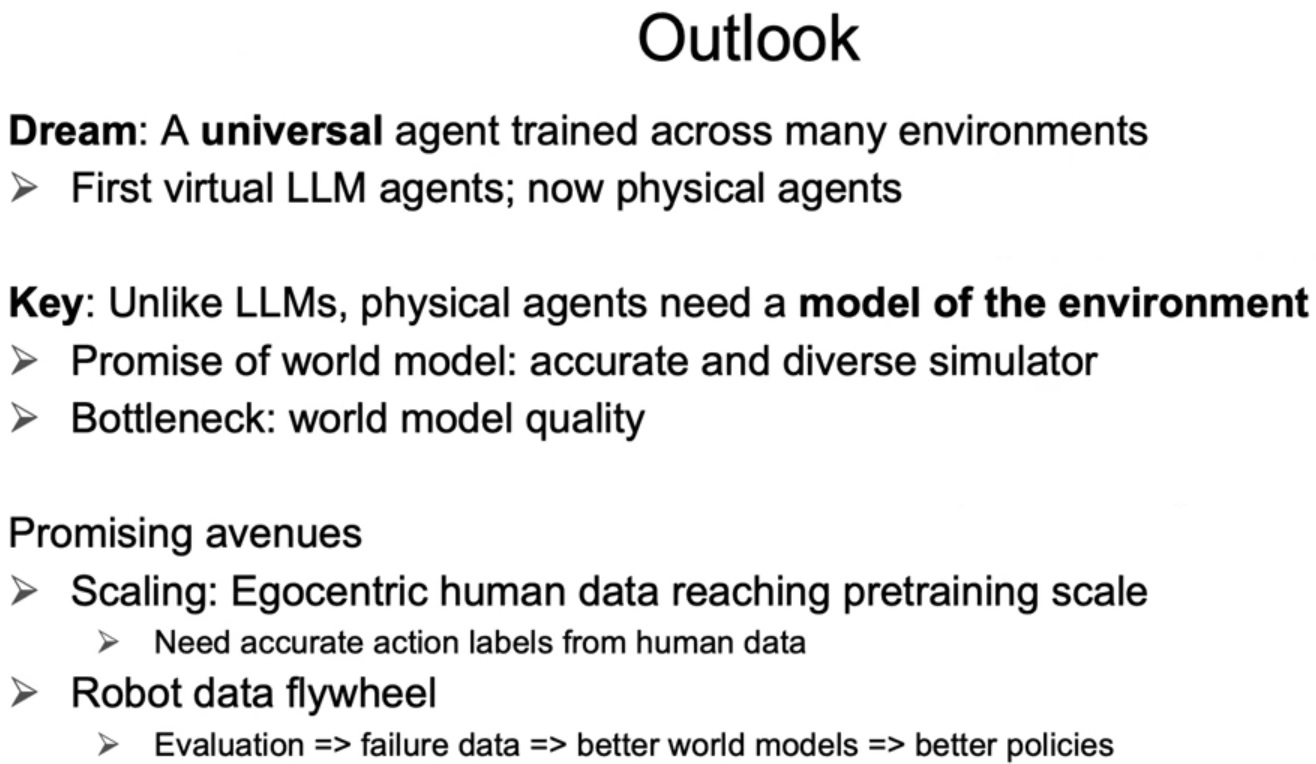
未来展望:利用世界模型评估、优化物理智能体。通用人工智能一直是我们的理想,打造可以适配多种环境的通用智能体。大语言模型已经向我们展现了这种可能性,而这也是物理智能领域的追求。但和大语言模型不一样,物理智能体必须掌握环境模型,这正是世界模型想要实现的目标。世界模型本质上就是兼顾精度与多样性的仿真器。世界模型基于极大似然从数据中学习,所以它应该是准确的;如果有无穷多训练数据,理论上世界模型可以得到近乎完美的仿真效果,同时拥有丰富多样的场景能力。但瓶颈依旧在于世界模型本身的质量,它还远远做不到对物理世界的精准复刻。
不过有几个很有前景的改进方向。第一是扩大世界模型规模。如今已经采集到大量第一人称视频数据,里面包含各类物体交互画面。依托这些数据,我们有希望学习与任意物体交互的模型。但目前存在一个短板:如何从人类视频中获取精准的动作标注,这是未来亟待解决的关键问题。
机器人本身是自主智能体,可以自行采集数据。所以另一个重要方向:整个科研社区共建机器人数据飞轮。运行各类策略开展评估,收集任务失败样本。机器人策略经常执行失败,但失败数据恰恰是优化世界模型、进而优化策略的优质素材。
四 Q & A
报告前半部分讲世界模型评估的时候,你提到 RT1 策略会让世界模型崩溃。这会不会陷入先有鸡还是先有蛋的困局:策略本身效果差,同时世界模型对分布外场景泛化不足。面对这类世界模型无法泛化的失败案例,我们该如何处理?
确实存在完全分布外、没有对应真实数据的场景。正如你所说,这种情况下很难打破鸡与蛋的死循环。把机器人看作自主智能体,机器人应该可以自主运行,由此产生失败样本。我们先用失败样本优化世界模型,再用优化后的世界模型改进策略。这就是我对该问题的简要回答。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)