普通程序员要不要学 Agent 开发?3 个实战带你从零到生产级
摘要:AI Agent 已经从论文概念变成了平台级能力,很多普通程序员都在纠结“要不要学、值不值得投入”。本文先给结论,再拆解 Agent 的“思考、行动、观察”循环,最后通过三个逐步进阶的 Python 实战,带你从零手写最小 Agent、接入 Function Calling、再到用 LangGraph 构建带状态的生产级 Agent,并附上学习路径和避坑建议。
1. 先给结论:有必要,但别一上来就陷进框架里
我的结论很直接:普通程序员有必要学习 Agent 开发,而且是现在这个时间窗口最值得投入的方向之一。理由有三点:
- 就业和业务价值正在快速放大,越来越多团队需要能把大模型接入工具、流程和业务系统的人,而不是只会调用一次 API 的“套壳工程师”。
- Agent 开发的本质仍然是工程能力:循环控制、状态管理、工具设计、错误处理、评估和部署,这些恰恰是普通程序员熟悉的领域。
- 学习成本没有想象中高,你不需要先成为算法研究员。理解一个循环、掌握一次工具调用,就能跑通最小可用版本。
但是要注意学习路径:不要一上来就啃 LangChain、AutoGen 这类框架的源码,也不要把 Agent 等同于“调一下 GPT”。合理的方式是先理解原理,再手写最小循环,最后用框架解决复杂问题。下面按这个思路展开。
2. 什么是 AI Agent:从“聊天机器人”到“会干活的助手”
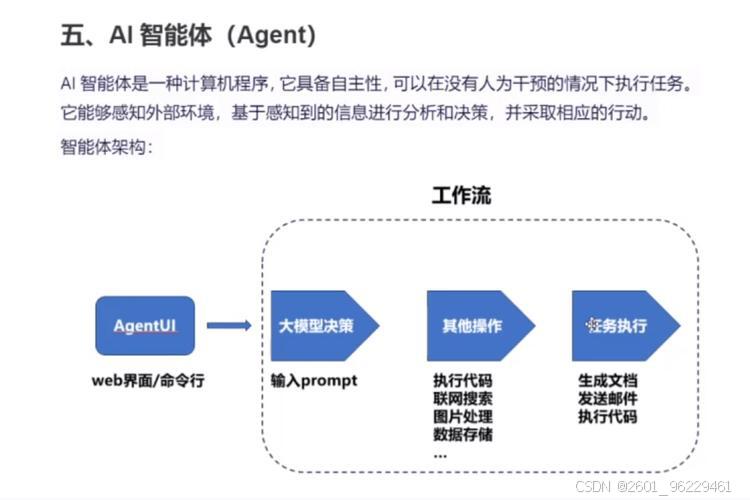
普通大模型聊天机器人通常是单轮或简单多轮对话:你问一句,它答一句,模型本身不会主动操作外部世界。Agent 与它的核心区别是:Agent 能够根据目标做决策,主动调用工具,观察工具返回的结果,并根据结果继续下一步,直到任务完成或达到终止条件。
一个比较实用的公式是:
Agent = 大模型 + 记忆 + 工具 + 规划循环
其中:
- 大模型:负责理解任务、生成决策和总结表达。
- 记忆:保存上下文、中间结果和长期知识。
- 工具:搜索引擎、计算器、数据库、代码执行器、API 调用等外部能力。
- 规划循环:让模型一步步执行“思考、行动、观察”的能力。
例如,“帮我查一下明天深圳的天气,如果下雨就提醒我带伞”,传统聊天机器人只能生成一段建议,而 Agent 可以真正调用天气 API、判断是否下雨、再生成带结论的回复。这个能力差距正是 Agent 开发的价值所在。
3. Agent 的核心原理:思考、行动、观察循环
目前主流的单 Agent 实现大多围绕 ReAct 思想展开,即 Reasoning + Acting。模型在每一步经历三个阶段:
- Thought(思考):分析当前任务和已有信息,决定下一步做什么。
- Action(行动):调用一个具体工具,并传入参数。
- Observation(观察):拿到工具返回结果,把它记下来,进入下一轮思考。
整个流程可以表示如下:
flowchart LR
    A[用户输入] --> B[模型思考 Thought]
    B --> C{需要调用工具?}
    C -->|是| D[执行工具 Action]
    D --> E[得到结果 Observation]
    E --> B
    C -->|否| F[输出最终答案]
这个循环会一直进行,直到模型认为已经得到足够信息、直接输出最终答案,或者达到最大步数保护。理解这个循环,是后面所有实战的基础。
4. 实战一:从零手写一个最小 Agent 循环
第一个实战不依赖任何 Agent 框架,也不调用真实的大模型,而是用一个模拟模型把 ReAct 循环跑通。这样你可以清楚看到:Agent 的核心不是神秘算法,而是一个“模型决策、执行工具、写回结果、继续循环”的普通程序。
import json
class MockLLM:
"""模拟一个大模型:根据当前上下文决定下一步动作。"""
def init(self):
self.called = False
def decide(self, messages):
    last_msg = messages[-1]["content"]
    # 第一次看到计算需求时,决定调用计算器
    if not self.called and "计算" in last_msg:
        self.called = True
        return {
            "thought": "用户要计算,我需要调用计算器",
            "action": "calculator",
            "action_input": "21 * 2",
        }
    # 第二次拿到工具结果后,直接给出最终答案
    return {
        "thought": "已经得到工具结果,可以给出最终答案",
        "action": "finish",
        "action_input": "21 * 2 = 42",
    }
def search(query: str) -> str:
"""模拟搜索工具。"""
return f"已找到关于「{query}」的 3 条资料。"
def calculator(expression: str) -> str:
"""模拟计算工具。生产环境请换成安全的表达式解析。"""
result = eval(expression, {"builtins": {}}, {})
return f"{expression} = {result}"
TOOLS = {"search": search, "calculator": calculator}
def agent_loop(task: str, max_steps: int = 6):
messages = [{"role": "user", "content": task}]
llm = MockLLM()
for step in range(1, max_steps + 1):
    decision = llm.decide(messages)
    action = decision["action"]
if action == "finish":
    print(f"第 {step} 步:回答 -> {decision['action_input']}")
    return decision["action_input"]
tool = TOOLS[action]
result = tool(decision["action_input"])
print(f"第 {step} 步:调用 {action} -> {result}")
把模型决策和工具结果都写回上下文,进入下一轮
messages.append({"role": "assistant", "content": json.dumps(decision, ensure_ascii=False)})
messages.append({"role": "tool", "content": result})
return "达到最大步数,未完成任务。"
if name == "main":
agent_loop("请计算 21 * 2")
运行后输出会类似:
第 1 步:调用 calculator -> 21 * 2 = 42
第 2 步:回答 -> 21 * 2 = 42
这段代码只有几十行,但已经完整包含 Agent 的关键结构:一个决策者、一组工具、一段消息历史、一个带最大步数保护的循环。真实项目就是把 MockLLM 换成真实 API,把模拟工具换成真实业务接口。
5. 实战二:用 Function Calling 让 Agent 真正调用工具
实战一里的 MockLLM 是写死的规则。真实场景中,决策者是大模型,工具调用通过 Function Calling 实现。下面以 OpenAI 兼容接口为例,写一个真正可以运行的 Agent。
先安装依赖:
pip install openai
完整代码如下:
import json
from openai import OpenAI
client = OpenAI(
api_key="sk-xxxx",
base_url="https://api.openai.com/v1",
)
def search(query: str) -> str:
"""模拟搜索工具,实际项目可替换为数据库查询或搜索引擎。"""
return f"已找到关于「{query}」的 3 条结果。"
def calculator(expression: str) -> str:
"""模拟计算工具。"""
result = eval(expression, {"builtins": {}}, {})
return f"{expression} = {result}"
TOOL_SCHEMA = [
{
"type": "function",
"function": {
"name": "search",
"description": "搜索指定关键词的资料",
"parameters": {
"type": "object",
"properties": {
"query": {"type": "string", "description": "搜索关键词"}
},
"required": ["query"],
},
},
},
{
"type": "function",
"function": {
"name": "calculator",
"description": "计算数学表达式",
"parameters": {
"type": "object",
"properties": {
"expression": {"type": "string", "description": "要计算的表达式"}
},
"required": ["expression"],
},
},
},
]
TOOL_MAP = {"search": search, "calculator": calculator}
def run_agent(user_input: str, max_steps: int = 6):
messages = [
{
"role": "system",
"content": "你是一个可以调用工具的助手。需要查询资料时调用 search,需要计算时调用 calculator。",
},
{"role": "user", "content": user_input},
]
for _ in range(max_steps):
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=messages,
        tools=TOOL_SCHEMA,
    )
    message = response.choices[0].message
# 情况一:模型直接给出最终文本回复,结束循环
if message.content:
    print(f"[最终回复] {message.content}")
    return
情况二:模型要求调用工具,执行并把结果写回上下文
if message.tool_calls:
messages.append(message)
for tool_call in message.tool_calls:
name = tool_call.function.name
args = json.loads(tool_call.function.arguments)
result = TOOL_MAPname
print(f"[调用工具] {name}({args}) -> {result}")
messages.append(
{
"role": "tool",
"tool_call_id": tool_call.id,
"content": result,
}
)
else:
break
if name == "main":
run_agent("请先搜索 Agent 开发入门资料,然后计算 21 * 2")
这段代码的要点:
TOOL_SCHEMA用 JSON Schema 描述每个工具的名称、说明和参数,模型据此判断何时该调用哪个工具。message.tool_calls是模型要求执行工具的信号,你需要解析参数、执行真实函数,再把结果以role=tool的消息写回。- 循环继续时,模型能看到之前的工具结果,从而决定继续调用工具还是输出最终答案。
注意示例里的 calculator 使用受限 eval 只是为了演示完整链路,生产环境务必替换为安全的表达式解析,或只支持白名单内的简单四则运算。
6. 实战三:用 LangGraph 构建带状态的生产级 Agent
手写循环适合理解原理,但真实业务中还要处理复杂状态、并发分支、断点恢复和多步依赖。此时可以借助 LangGraph。它把 Agent 抽象成“图”:节点是处理逻辑,边是流转条件,状态在节点之间传递。
先安装依赖:
pip install langgraph langchain-openai
完整代码如下:
from langgraph.graph import StateGraph, MessagesState, START, END
from langgraph.prebuilt import ToolNode
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool
@tool
def search(query: str) -> str:
"""搜索指定关键词的资料。"""
return f"已找到关于「{query}」的 3 条结果。"
@tool
def calculator(expression: str) -> str:
"""计算数学表达式。"""
return str(eval(expression, {"builtins": {}}, {}))
tools = [search, calculator]
model = ChatOpenAI(model="gpt-4o").bind_tools(tools)
def call_model(state: MessagesState) -> dict:
"""模型节点:根据当前消息状态生成下一步。"""
response = model.invoke(state["messages"])
return {"messages": [response]}
def should_continue(state: MessagesState) -> str:
"""路由节点:判断继续调用工具还是直接结束。"""
last_message = state["messages"][-1]
if last_message.tool_calls:
return "tools"
return END
graph = StateGraph(MessagesState)
graph.add_node("model", call_model)
graph.add_node("tools", ToolNode(tools))
graph.add_edge(START, "model")
graph.add_conditional_edges("model", should_continue, {"tools": "tools", END: END})
graph.add_edge("tools", "model")
app = graph.compile()
for event in app.stream(
{"messages": [("user", "搜索 Agent 开发资料并计算 21 * 2")]}
):
print(event)
这段代码用图的形式复现了同样的循环:
- model 节点:调用大模型,生成文本回复或工具调用请求。
- should_continue:检查最后一条消息是否包含工具调用,决定去
tools节点还是直接结束。 - tools 节点:执行工具,然后把结果写回消息状态,再回到
model节点。
LangGraph 的优势在复杂场景会更明显:你可以方便地加入持久化状态、人工审批节点、并行分支和多 Agent 协作。但一定要先有实战一和实战二的基础,否则很容易迷失在框架细节里。
7. 普通程序员的 4 个学习阶段
结合上面的实战,我建议按以下顺序学习:
- 第 1 阶段:会用基础 API。理解
messages、role、tool_calls这些核心概念,能独立完成一次函数调用闭环。 - 第 2 阶段:手写单 Agent 循环。不依赖框架实现 ReAct,理清上下文、工具执行和最大步数保护的关系。
- 第 3 阶段:掌握一个主流框架。学习 LangGraph 或同类框架,重点掌握状态管理、条件路由和多步骤流程。
- 第 4 阶段:走向工程化。补充评估体系、工具权限控制、日志追踪、错误兜底、成本控制和部署上线能力。
每个阶段都可以用一个小项目来检验。比如第 1 阶段做“自然语言查报表”,第 2 阶段做“搜索加计算的问答机器人”,第 3 阶段做“带审批流程的自动化助手”,第 4 阶段把助手接入真实业务并加上监控和评估。
8. 常见的 5 个误区
- 误区一:以为 Agent 就是套壳 GPT。真正的 Agent 价值在工具设计、流程编排和稳定交付,模型只是其中一环。
- 误区二:一上来就学最复杂的框架。不了解底层循环,遇到报错就只能复制粘贴,很难排障和扩展。
- 误区三:忽视工具设计质量。工具描述不清楚、参数不规范、返回结果不可靠,模型再强也发挥不出效果。
- 误区四:把 Agent 当成万能方案。复杂任务必须拆解、评估和兜底,否则容易得到看似合理但不可控的结果。
- 误区五:只看 Python,不补工程能力。Agent 开发最终会落到接口设计、并发、缓存、权限、可观测性和部署,这些才是拉开差距的地方。
9. 总结
普通程序员要不要学 Agent 开发?答案是:要学,而且要当作一个系统性的工程能力来学,而不是只学会调 API。建议从 ReAct 循环这个最小内核出发,先手写一个能跑通的 Agent,再逐步接入真实 Function Calling,最后根据业务复杂度选择合适的框架。
你不需要成为算法专家,但需要把大模型当成一个“会理解、会决策但需要约束”的组件,用工程手段把它接入真实业务。这个能力在接下来几年会越来越值钱。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)