100 万小时之后,Dyna 的瓶颈已经不在 GPU 上了
八月份 Dyna Robotics 连着发了三篇文章:一篇讲模型,一篇讲基础设施,一篇讲产品与部署。
本来以为最值得看的是第一篇。100 万小时人类第一人称视频做预训练,第一次验证跨本体迁移的 scaling law,这些放在标题里最好看。但三篇读下来,印象最深的是第二篇里一句近乎大白话的话——GPU 节点出厂就带着好几 TB 的 NVMe,那笔钱已经算在机器价格里了,用不用它都在那儿。
第二篇标题里没有"模型",也没有"100 万小时",只有一个词:repeatably。我猜它是三篇里点开率最低的一篇,也是最该读的一篇。
那句话,做过大模型训练的人看了大概会说:废话。
但 Dyna 后面做的事说明,他们是真把它当回事了。而且他们在这件事上花的篇幅,比我预期的多得多。
为什么这件事在具身智能这里被放大
LLM 的预训练语料是文本,一条样本几 KB 到几十 KB,顺序读随机读都好办。机器人数据不是这个形状。
一条 episode 里同时装着多路相机视频、高频关节状态、动作指令,可能还有触觉和力传感器,频率、结构、体量都差好几个数量级。这些模态还挤在同一段时间轴上,读的时候往往是整段捋过去,而不是随机抽一小片。Dyna-2 要同时预测视频和动作,一个训练样本只需几帧解码后的画面,却需要很长一段本体感受序列去对齐 action chunk。
用他们自己的说法,读取模式本身变成了一个随模态变化的训练超参。
这句话挺重的:不存在一套"通用最优"的存储配置。今天这个模型读视频多,明天那个读状态多,同一份数据、同一套参数,性能能差一倍。
后面所有的改造,其实都是这句话的展开。
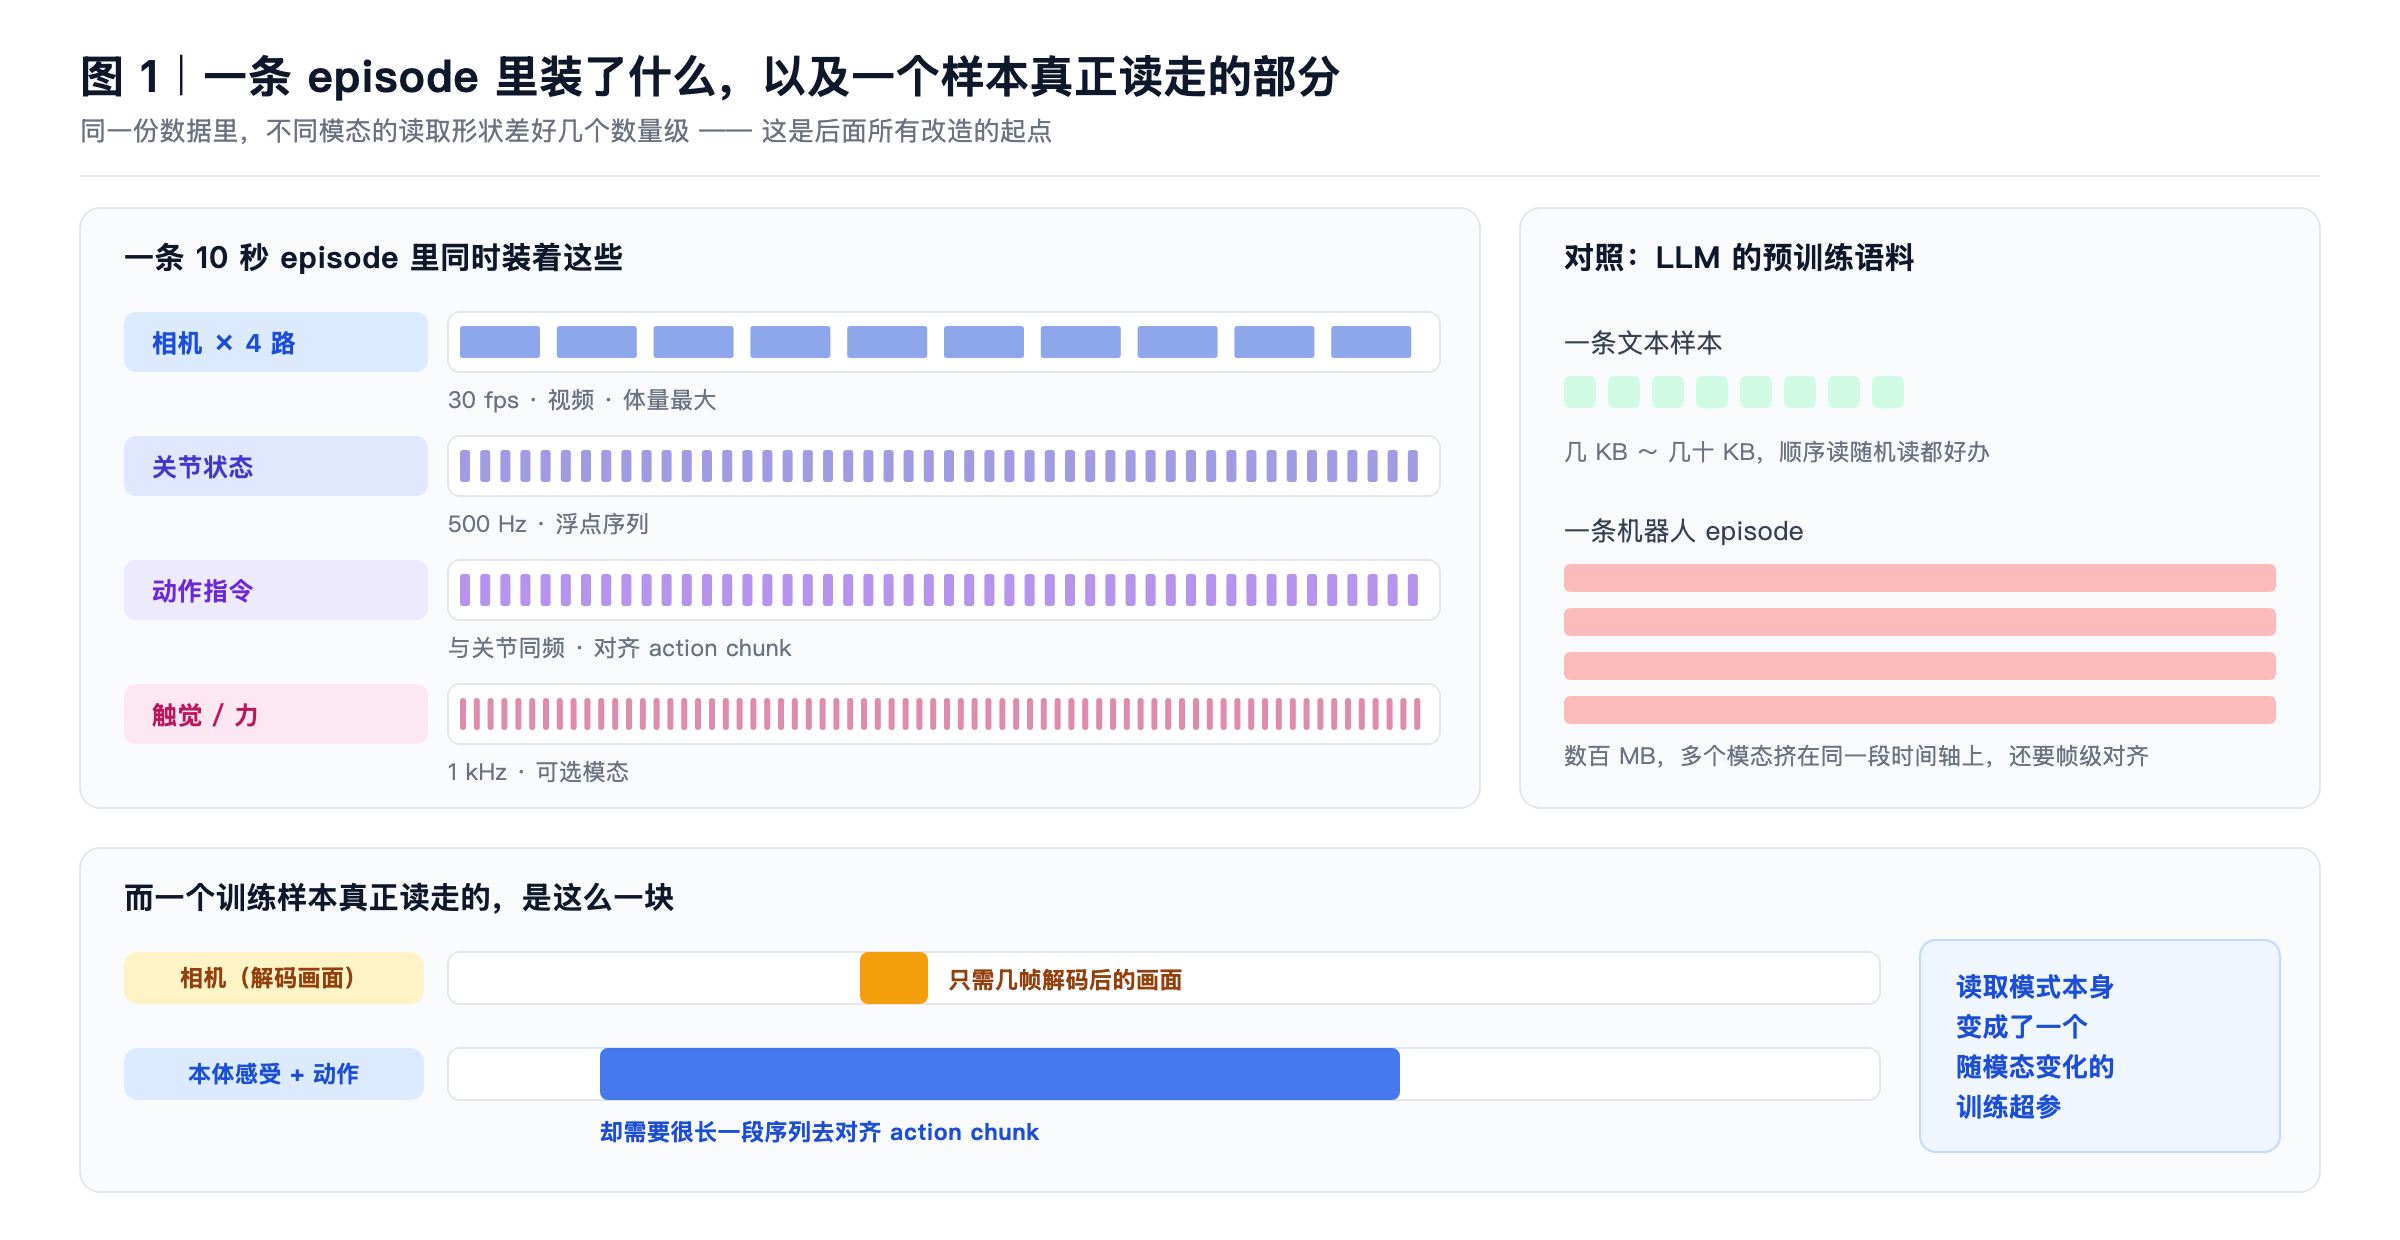
图 1|同一份数据里,不同模态的读取形状差好几个数量级——这是后面所有改造的起点。
最先崩掉的三个地方
先看清整条链路长什么样,后面再一段一段拆。
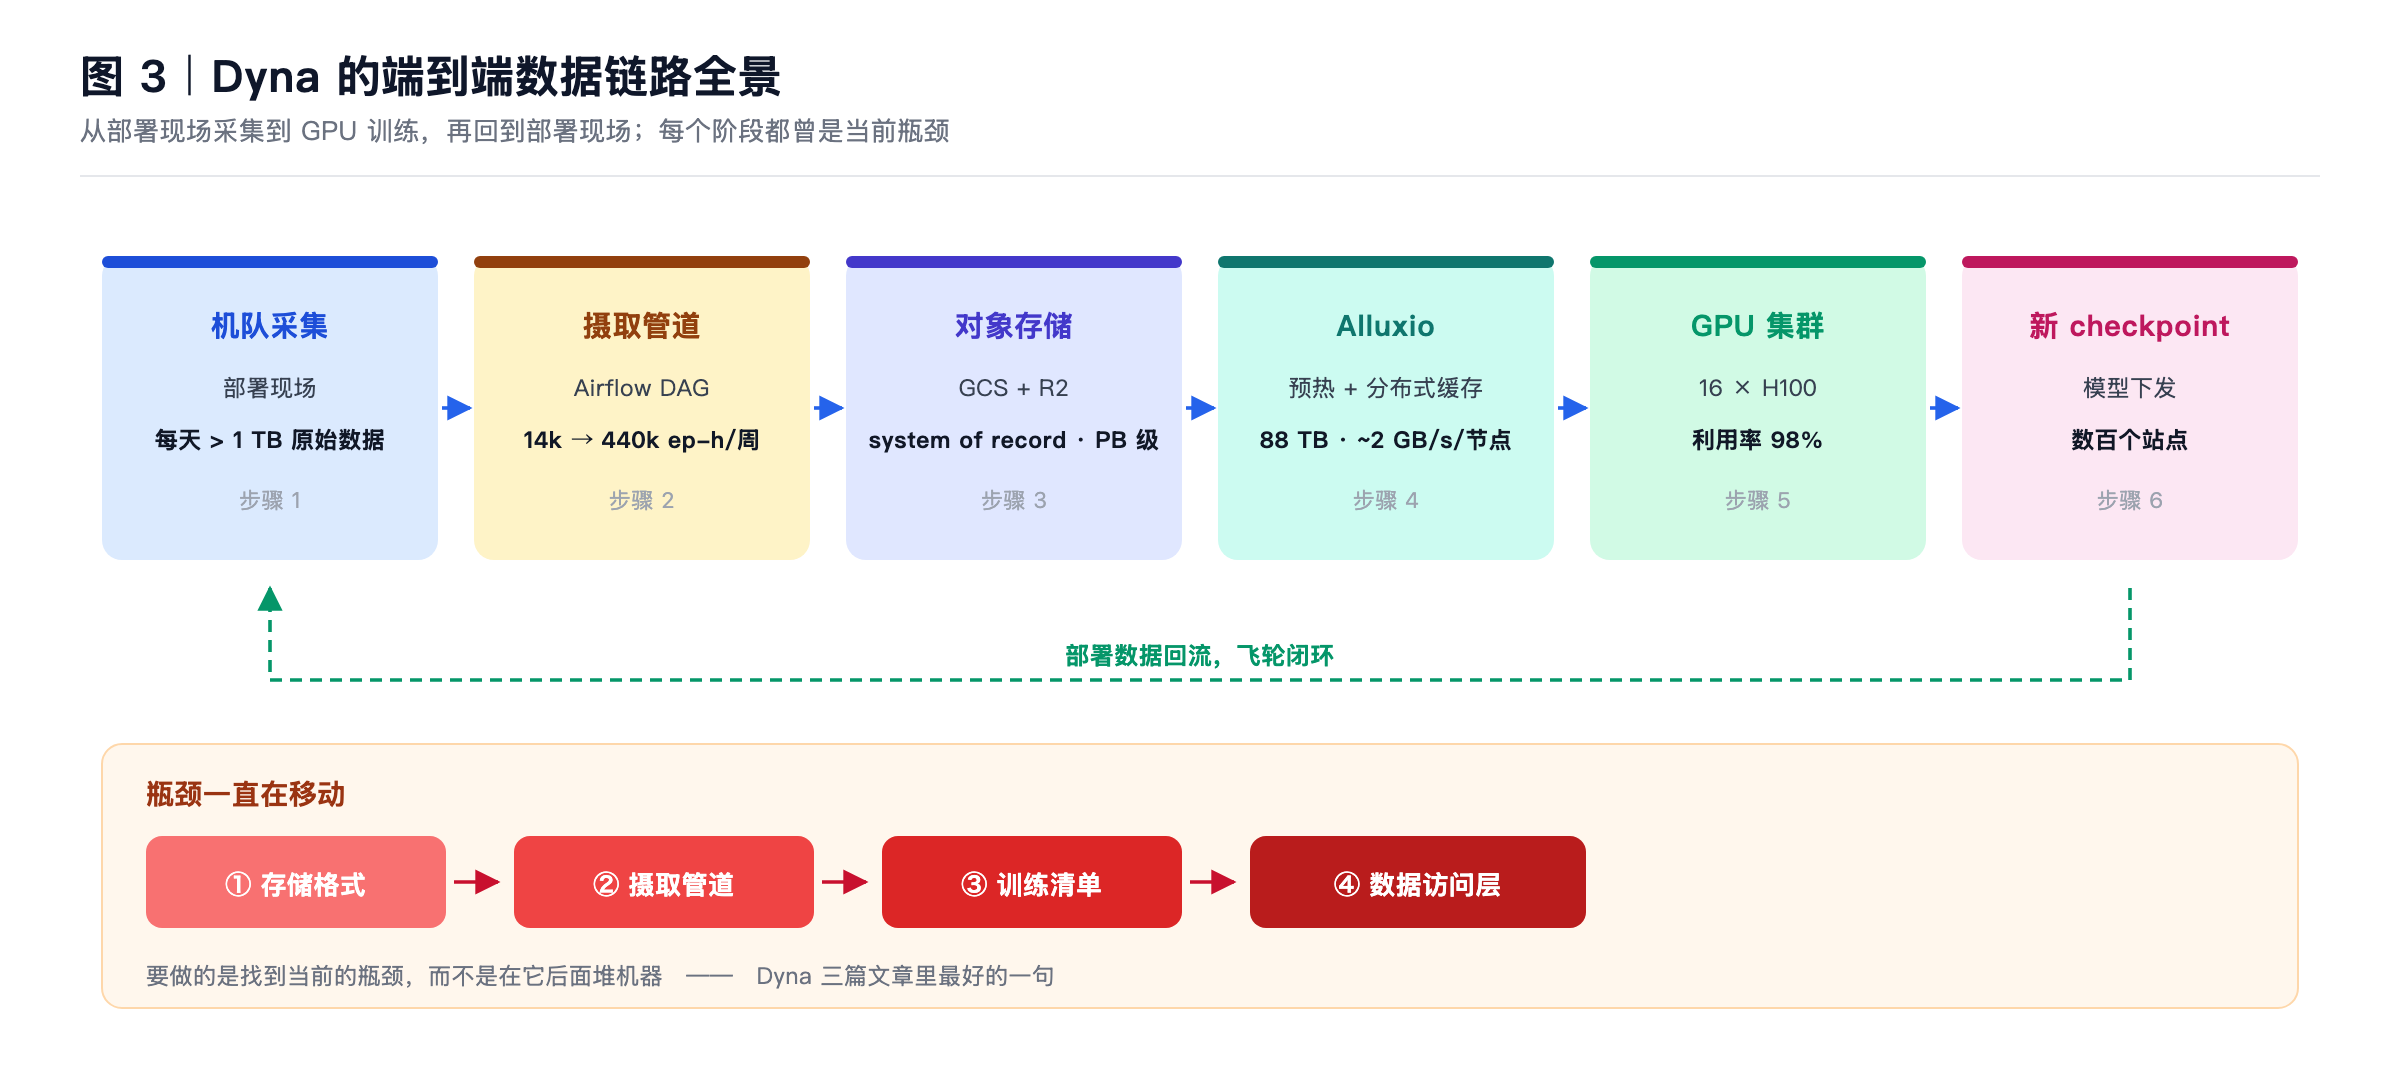
图 3|从部署现场采集到 GPU 训练,再回到部署现场。瓶颈一直在移动,每个阶段都曾是当前瓶颈。
最先崩掉的三个地方
第一个是容器格式。 早期用 H5 存逐帧 JPEG,没有帧间压缩,一相机分钟上百 MB。改成 H.264 之后,随机访问任意时间戳必须从关键帧开始解——但世界动作模型读的是长连续序列,一个关键帧能摊到很多帧上,所以他们敢把 GOP 开大。压缩后省了约 68% 存储。
还有一招叫 topic-group chunking:相机归一组、本体感受和动作归一组,两组永不共享 chunk。一个样本很少同时需要这两类的全部内容,分组后每个样本碰到的 chunk 变少——chunk 拉取少约 3.4 倍,读快约 2.9 倍。
(这里有个前提容易被忽略:这些改动之所以成立,是因为他们清楚自己的读取模式。同样的 H.264 加超大 GOP,换成一个需要频繁随机抽帧的任务,大概率是负优化。知道自己怎么读数据,比选哪个格式更靠前。)
这个优化看着不起眼,先记一下,它后面还会再出现一次。
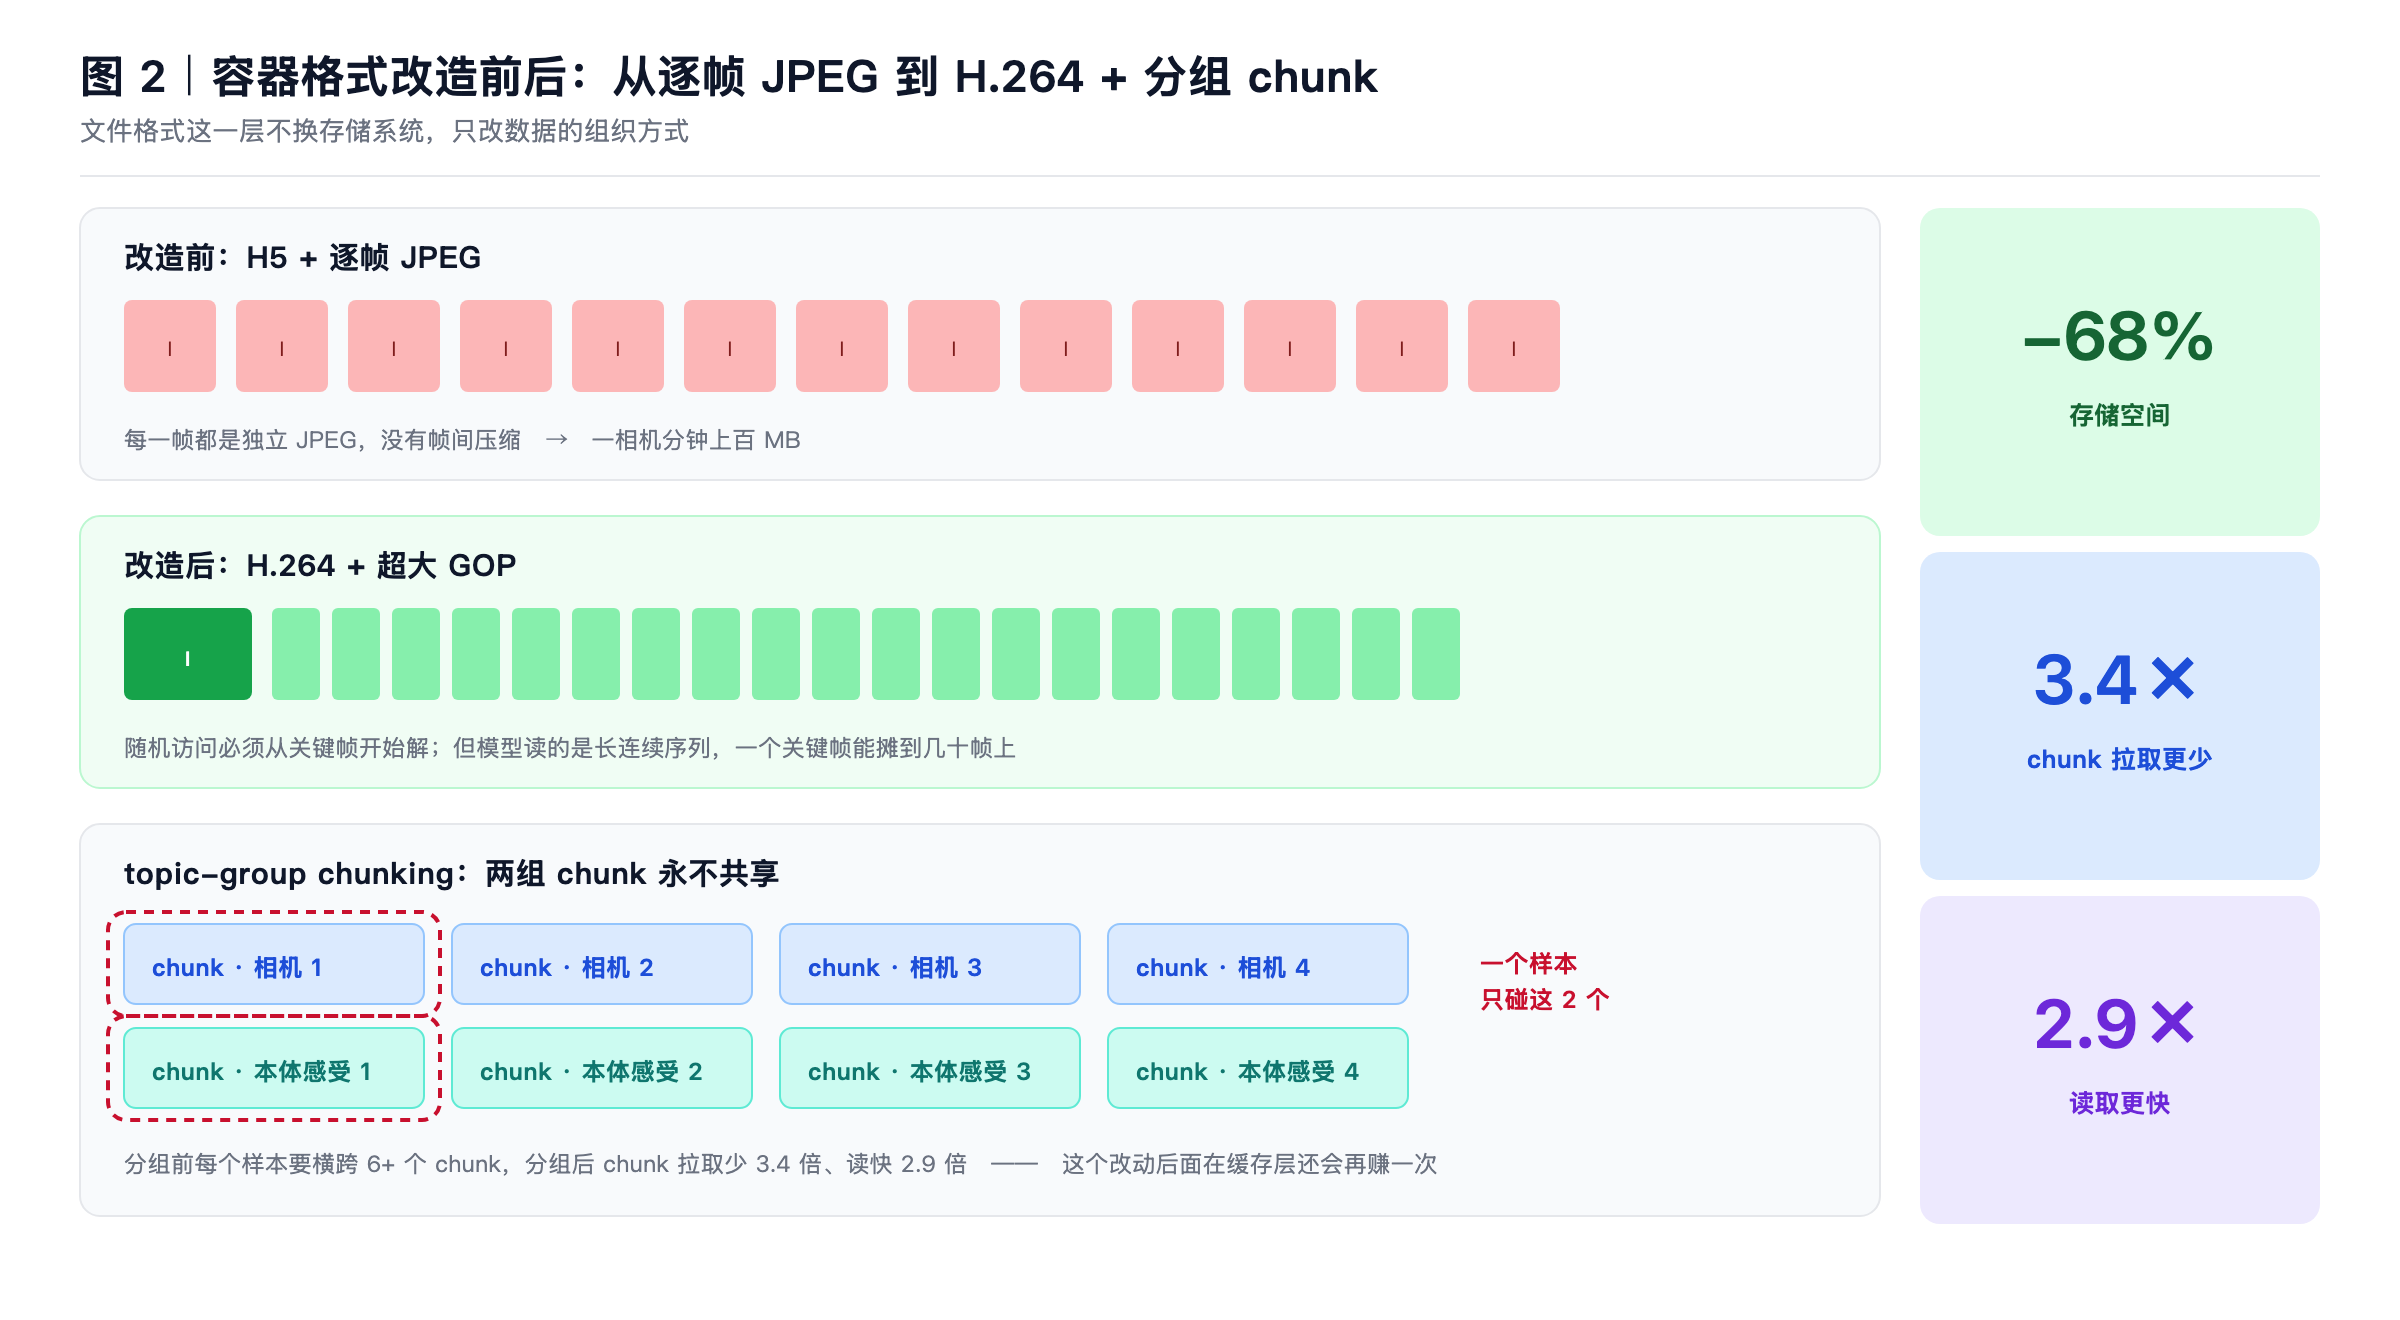
图 2|文件格式这一层不换存储系统,只改数据的组织方式:存储省 68%、chunk 拉取少 3.4 倍、读取快 2.9 倍。
第二个是摄取管道。 原来的吞吐卡在每周 14,000 episode-hours。按这个速度,攒够 100 万小时要一年多。
问题不出在某个算子上,出在结构上——整个 pipeline 是一个 Kubernetes 单体作业。改成 Airflow DAG 后拿到三样东西:每步按自己需要分配资源(有的吃 CPU 有的吃 GPU);非关键步骤失败不再拖垮整条 run;状态持久化到外部存储,失败可以从断点续,不用从头重跑。
但光拆成 DAG 还没到 31 倍。中途踩的坑很有画面感:所有批次同时启动、同时结束,写入突发把调度器数据库打爆了。解法是错峰启动,再加一个用 bin-packing 切分输入批次的优化器。最后是每周 440,000 episode-hours,100 万小时从 16 个月压到 3 周以内。
第三个是训练清单。 100 万小时的语料有 4300 万条 episode,构建一次 curation 要按文件逐个走一遍,每集约 4 次存储往返,总共 48 小时——也就是说,你决定了这一轮用哪些数据,得等两天才能看到第一个 batch。
这里最伤的不是那两天本身,是它改变了实验的行为方式:等一次要两天,人就会倾向于少试几种数据组合,而"试几种组合"恰恰是这类工作最该做的事。一个基础设施约束,最后长成了研究习惯。
解法分两半。
构建侧:把事务库和分析库拆开、CDC 同步,curation 变成一条 SQL 查询,输出列式文件。48 小时到 1 分钟以内。
加载侧更有意思。GPU 节点大概 2TB 内存,清单全量读进去超上限了;而且清单挂在网盘上,列式格式"先读 footer 再四处 seek"的访问方式在网络挂载上接近最坏情况。他们做了三件事:一个 rank 用对象存储 API 并行拉到本地盘,绕开网络挂载;所有 rank 用 mmap 把本地副本映射成列式表;每个 rank 零拷贝切走自己那 1/N 行。加载 737 秒到 12.4 秒,单节点内存 2151 GB 到 218 GB。
这三件事只能成套生效,拆开任何一件都没用:不先拉到本地盘,清单还是得走网络挂载;不均给用户态页,2TB 还是装不下;不做 zero-copy 切片,每个 rank 还是全量读。这类优化在大规模训练里特别常见,也特别容易被低估——小规模上你根本感觉不到它的存在。
值得注意的是,这三处改造没有一处是靠换存储系统解决的。它们改的是文件格式、管道结构和查询方式。但数据终究还是得从某个地方、经过某条路,读到 GPU 里。真正到了这一层,问题变成了另一个——也是我这行天天在处理的那类问题。
数据不动,算力动
这一段讲的是多云。LLM 那波之后 GPU 一直稀缺,Dyna 的策略很务实:哪家能拿到算力就去哪家,通常是好几家供应商同时跑。最早是两朵云,后来为了凑够百万小时训练需要的算力,一路扩到了四朵。
这多出来的两朵云,不是加法。 数据在 GCS 一处,算力散在四个地方、横跨不同地域,于是有了四种"数据离算力有多远"。同一个脚本在离数据近的那朵云上跑得好好的,换到要跨域拉的集群上,吞吐就可能因链路延迟和丢包掉一截。短任务扛得住偶发卡顿,要连续跑几周的任务扛不住——卡顿会累积成实打实的时间损失,而且越往后越难归因:你分不清某一轮掉速是模型的问题、数据的问题,还是那条链路当时抖了一下。
麻烦还在于语料是 PB 级,而且不是静态的——摄取管道每天在往里加东西,事后的修正还会回填。复制到每个集群?三笔账要算:每份副本自己的存储费、灌进去的出网费,再乘以集群数量。两朵云的时候你可能咬咬牙忍了,四朵云就是四份 PB 级副本。而且不是每家供应商都卖对象存储,多数给的是 Weka、VAST 这类并行文件系统,是另一个价位上的东西。
(一个可参考的数字:跨云边界从 GCS 读训练数据,出网费大约每 TB 88 美元。这个量级下,"复制一份"就不再是随手做的决定了。)
于是数据留在一处,算力围着它转,两边靠网络连着。而网络这一环,恰恰是整个链条里最不可控的。
他们的解法听起来很朴素:训练时别去读云,把这一轮的工作集留在集群本地。这一点几乎所有跑过大规模训练的人都想得到,真正有意思的是下面这部分。
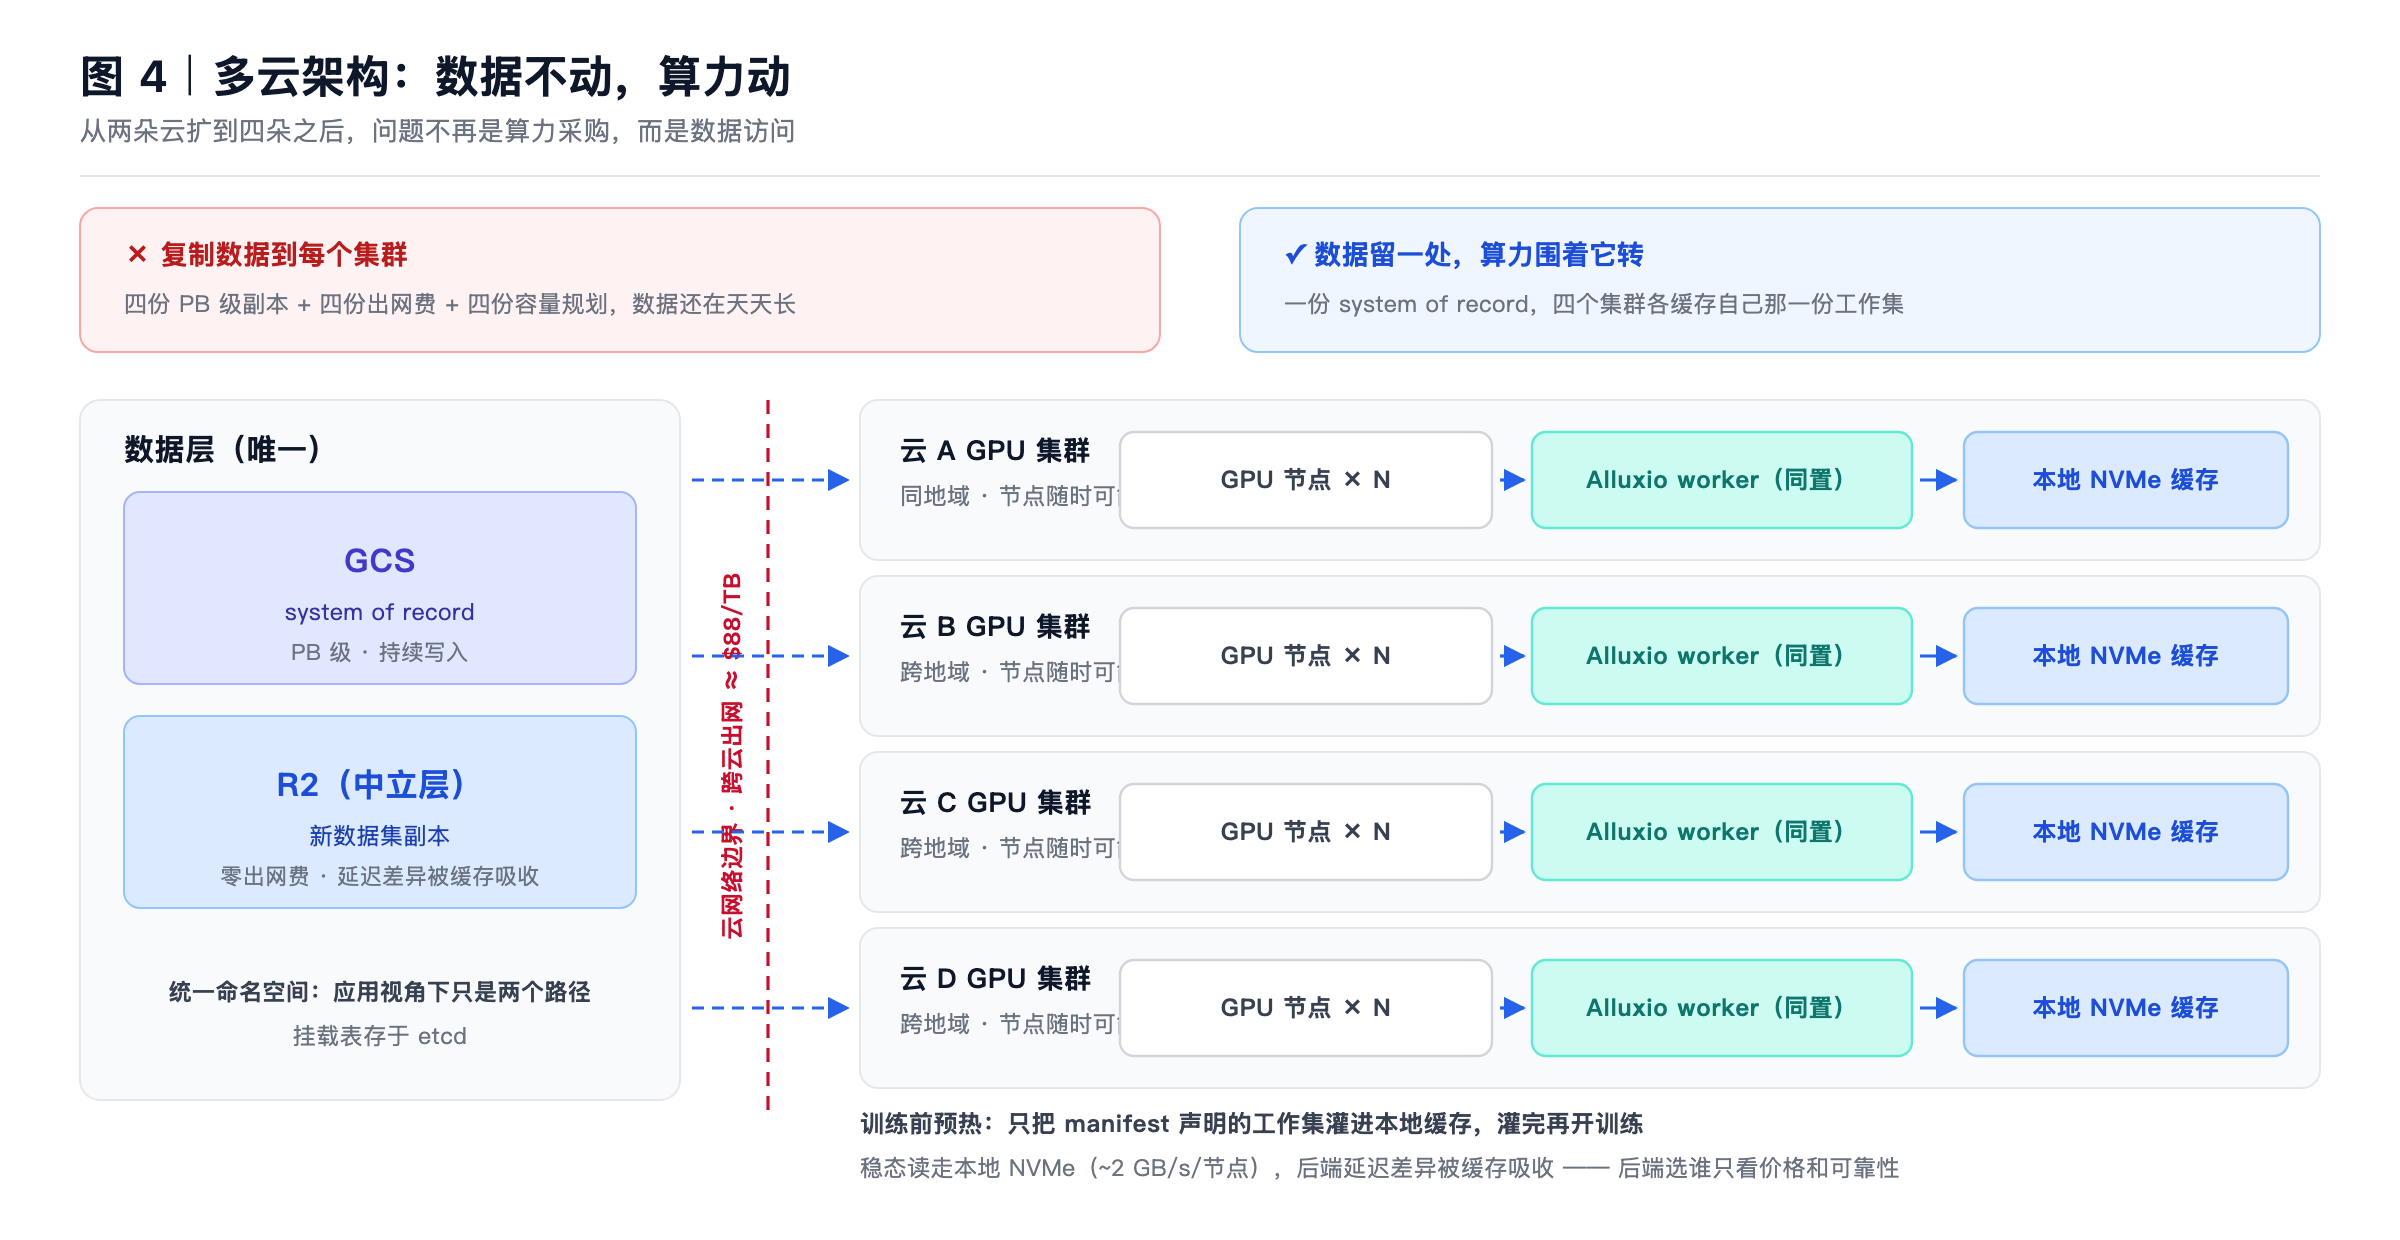
图 4|数据留一处,算力围着它转;四个集群各缓存自己那一份工作集。
"加个缓存"这四个字,中间隔着三个坑
Dyna 也不是一开始就上 Alluxio 这类分布式缓存的,他们先自己试了两轮。
第一轮,自己写每节点 SSD 缓存。做完发现每台机器当孤立缓存用,命中率低、数据在节点间重复——同一个 episode 在八台机器上各存一份,集群的"有效容量"远小于磁盘总和。
第二轮,上自管 NFS。从 GCS 拷到 NFS 改善局部性,读是快了,但换来三个新问题:每块盘 64TB 上限、数据要手动分片、并发一高就周期性掉速,重度并发时接近 30%。手动分片这一点尤其难受,它意味着扩集群的时候得有人记得去重新分一次。
第三轮评估过 Lustre 一类的集群文件系统,最后没选——它要求数据全量迁移进去,运维风险太大。
这三个坑其实是同一个坑的不同侧面:你一旦让数据"搬进去",就得负责它的一致性、生命周期和容量规划。 而 GPU 集群最不缺的就是随时可能被回收的节点——Dyna 的场景里,GCP 上被抢占还会提前通知,其他供应商有时连招呼都不打。任何把数据可用性和单个 GPU 实例绑在一起的设计,在这个前提下都是负债。
所以他们最终要的东西很明确:利用 GPU 节点上那部分已经付过钱的本地 NVMe、纯软件方案不引入新的存储基础设施、能容忍节点频繁进出、并且数据可用性不能绑死在某台机器上。
这四条加起来,与其说是需求清单,不如说是给 Alluxio 这类分布式缓存层写的设计说明书。下面逐条看它们分别对应什么机制。
分布式缓存要回答的几个问题
满足了这些约束之后,剩下的就是缓存层本身怎么设计。Dyna 在文章里直接点了名字——他们说从去年开始用 Alluxio 做集群内的缓存层,给了三条理由。既然他们自己写了,我照原文摆着,再补一点机制上的解释:
- 原生分布式。 相比传统分布式缓存,控制面没有单点故障,适合多节点大规模训练。这一条在几十个节点跑几周的场景下不是锦上添花——控制面挂一次,整个训练就断一次。
- 按页缓存,不是按整文件。 一个 worker 只持有实际被读过的那部分 episode,同一块 NVMe 能覆盖更多不同 episode;淘汰也是一页一页来,而不是丢掉一个几 GB 的大文件。
- 归属按哈希分散。 每个文件的页落在由路径一致性哈希选出的一个 worker 上,几千万个文件的读流量能均匀铺开,而不是全压在某个"热门 episode"恰好所在的节点上。
- 接口不变,可回退。 Alluxio 对外是标准 POSIX(也支持 S3 兼容接口和 Python FSSpec),训练代码一行不用改,研究员看到的读取路径跟以前完全一样。这一条我认为比性能数字更重要:它把一次性能改造变成了架构上可回退的决策——随时可以绕开 Alluxio 直接读对象存储,而不是把整个训练流程绑死在一套新系统上。
第二条值得多说一句,因为它是全文我最喜欢的一处呼应。前面讲的 topic-group chunking,把相机和本体感受拆成不共享的 chunk,让每个样本碰到的 chunk 数变少了——这个在格式层做的决定,到了 Alluxio 的缓存层又赚了一次:样本碰到的 chunk 越少,需要驻留的页就越少,同一块盘能装下的不同 episode 就越多。一个为了省存储做的改动,最后变成了缓存命中率的增益。 这种跨层的连带效应,只有在你真的把整条链路当成一个系统来调的时候才会出现。
第三条解决的是另一类问题。机器人数据里存在明显的热点——某些 episode 会被反复采样。如果热点数据的归属是按文件随机落、或者按"谁先读谁缓存",流量就会堆到少数几个节点上,那几块盘的带宽先打满,其他节点的盘还空着。Alluxio 的一致性哈希把这件事摊平了。
(补充一点他们没写在文章里、但官网案例页提到的东西:训练作业初始化时经常要检查 10,000 到 100,000 个文件,元数据查询和大量并发小对象读会放大延迟。他们在代码里加过预取逻辑,也压不下去。Alluxio 在这里解决的其实是元数据路径,不只是带宽。)
从"缓存"到"编排"
光在 Alluxio 上盖一层缓存还不够。他们在这之上自己做了一个 on-cluster data orchestration service:训练启动前先解析 manifest,把这一轮的工作集精确预热到集群本地存储,预热完再开训练;训练期间命中就本地读,miss 回源云存储。
这个顺序很关键。如果让训练边跑边填 Alluxio,前几十分钟就是在给对象存储打白工,GPU 空转等数据爬过来,而且攒到每个 epoch 开始都要重来一次。把预热提到启动前,等于把不可控的冷启动换成了一次可控、可观测的加载过程。
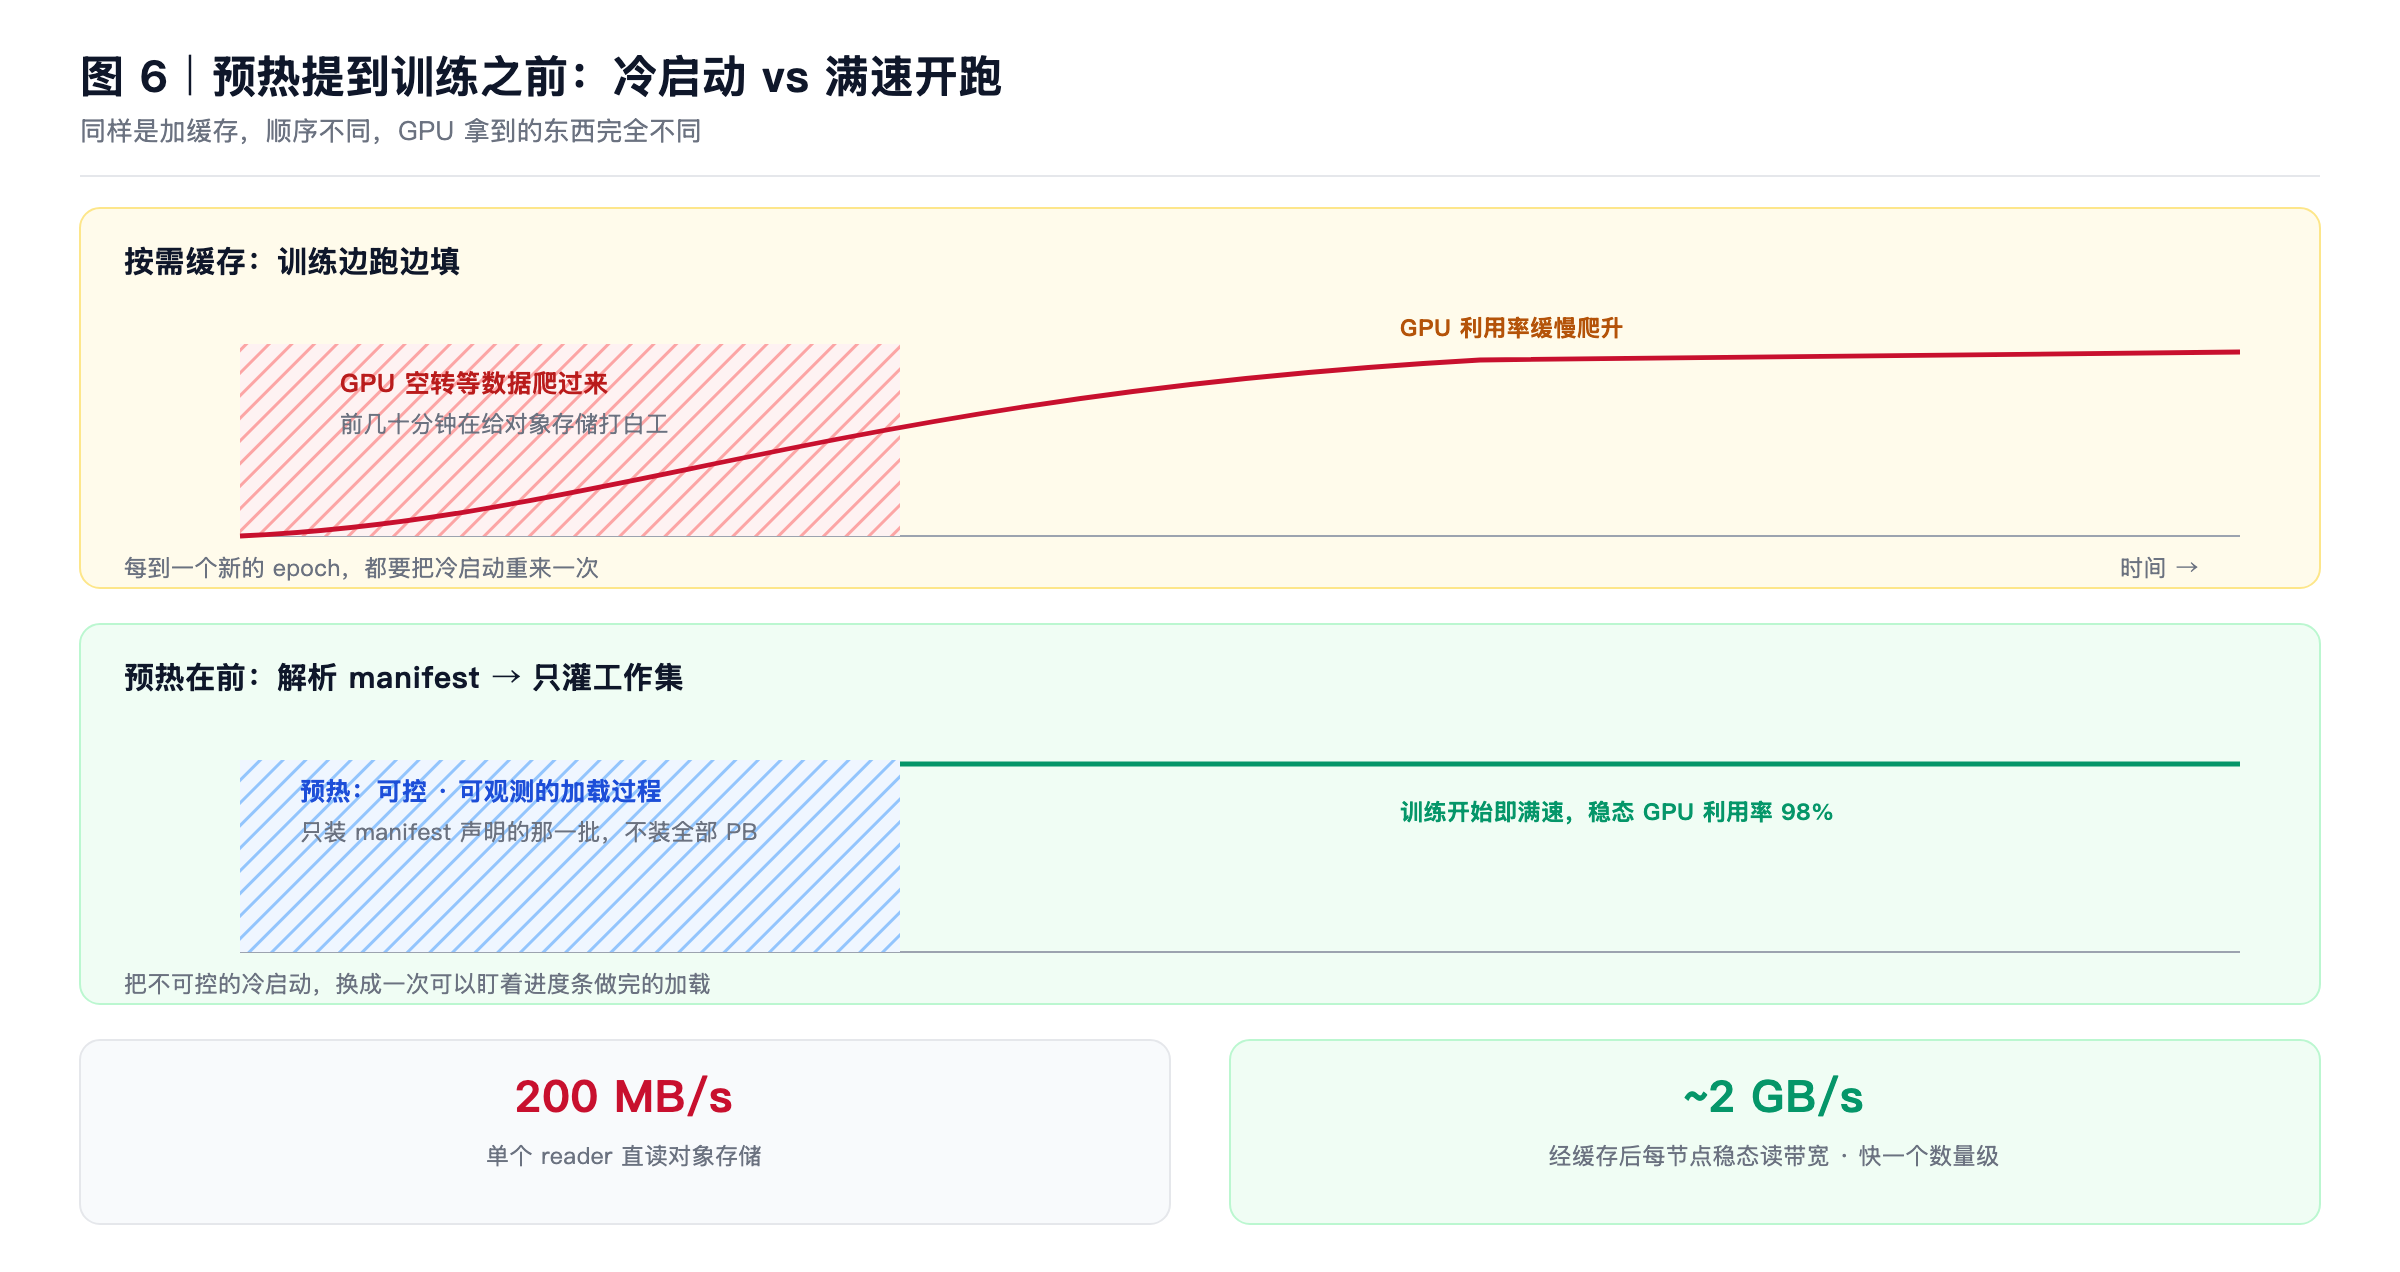
图 6|同样是加缓存,顺序不同,GPU 拿到的东西完全不同。
还有个副产品:预热是"精确"的——只预热 manifest 里声明的那一批。100 万小时是 PB 级,但某一轮实验真正要用的可能只有其中一小部分。Alluxio 的缓存池不用装下全部数据,只要装下当前的工作集。
数字是这样的:单个 reader 直读对象存储大约 200 MB/s,经过 Alluxio 缓存之后是每节点约 2 GB/s,快一个数量级,而下面垫的 NVMe 还更快,所以天花板在读路径不在盘。单线程过一遍 1 PB,云存储 57.9 天,集群本地缓存 5.8 天。warm 之后的多节点训练,GPU 利用率 98%。
(一个典型部署的规模:16 台 H100,每台带 6TB 本地 SSD,划 5.5TB 给 Alluxio,凑出 88TB 的分布式缓存池。GCS 依然是 system of record,四朵云上的集群都是这个模式。)
不过他们真正强调的其实是另一半——可预期性和速度一样重要。四朵云、四种网络条件、四套挂载方式,加载表现却是一致的:能稳定撑几周,集群之间的差异被藏在下面,训练配置是集群无关的。我个人觉得这一条比 2 GB/s 本身更值钱——快 10 倍解决的是"能不能跑",可预期解决的是"四朵云上跑出来的结果能不能横向对比",后者才决定你敢不敢把实验铺开。
最后补上多云那半个闭环。四朵云之后,跨云读出网费约 $88/TB 是持续成本,而且每多一朵云就多一份。他们的做法是引入一个中立的对象存储层(Cloudflare R2):处理好的数据照旧写 GCS,新数据集往 R2 复制一份,四个 GPU 集群统一通过 Alluxio 读。R2 的延迟其实比同在一个云内的 GCS 更高,但数据在预热之后这个差异被 Alluxio 吸收掉了,稳态吞吐不受影响;R2 零出网费的定价则把重复传输成本去掉了。
这里有个取舍值得单独说:他们主动接受了一个更慢的后端,换成本和一致性。 因为 Alluxio 抹平了后端延迟差异,后端选谁只看价格和可靠性,不用再看"哪个离我的 GPU 近"。这个自由度在两朵云时不明显,到四朵云成了刚需。
到这里,"哪家有卡去哪家"才真正成立——不是嘴上的多云,是训练脚本不用改、数据不用重导、新集群进来不用重新调参的多云。回头看,从两朵云扩到四朵这件事,表面上是算力采购问题,实际上逼出来的是一整套数据访问架构。
把这一层摊开看:数据到底怎么流过来的
前面一直说“缓存层”,说得像个黑盒。这一节把这层缓存拆开——只有拆开,你才能判断它适不适合自己。
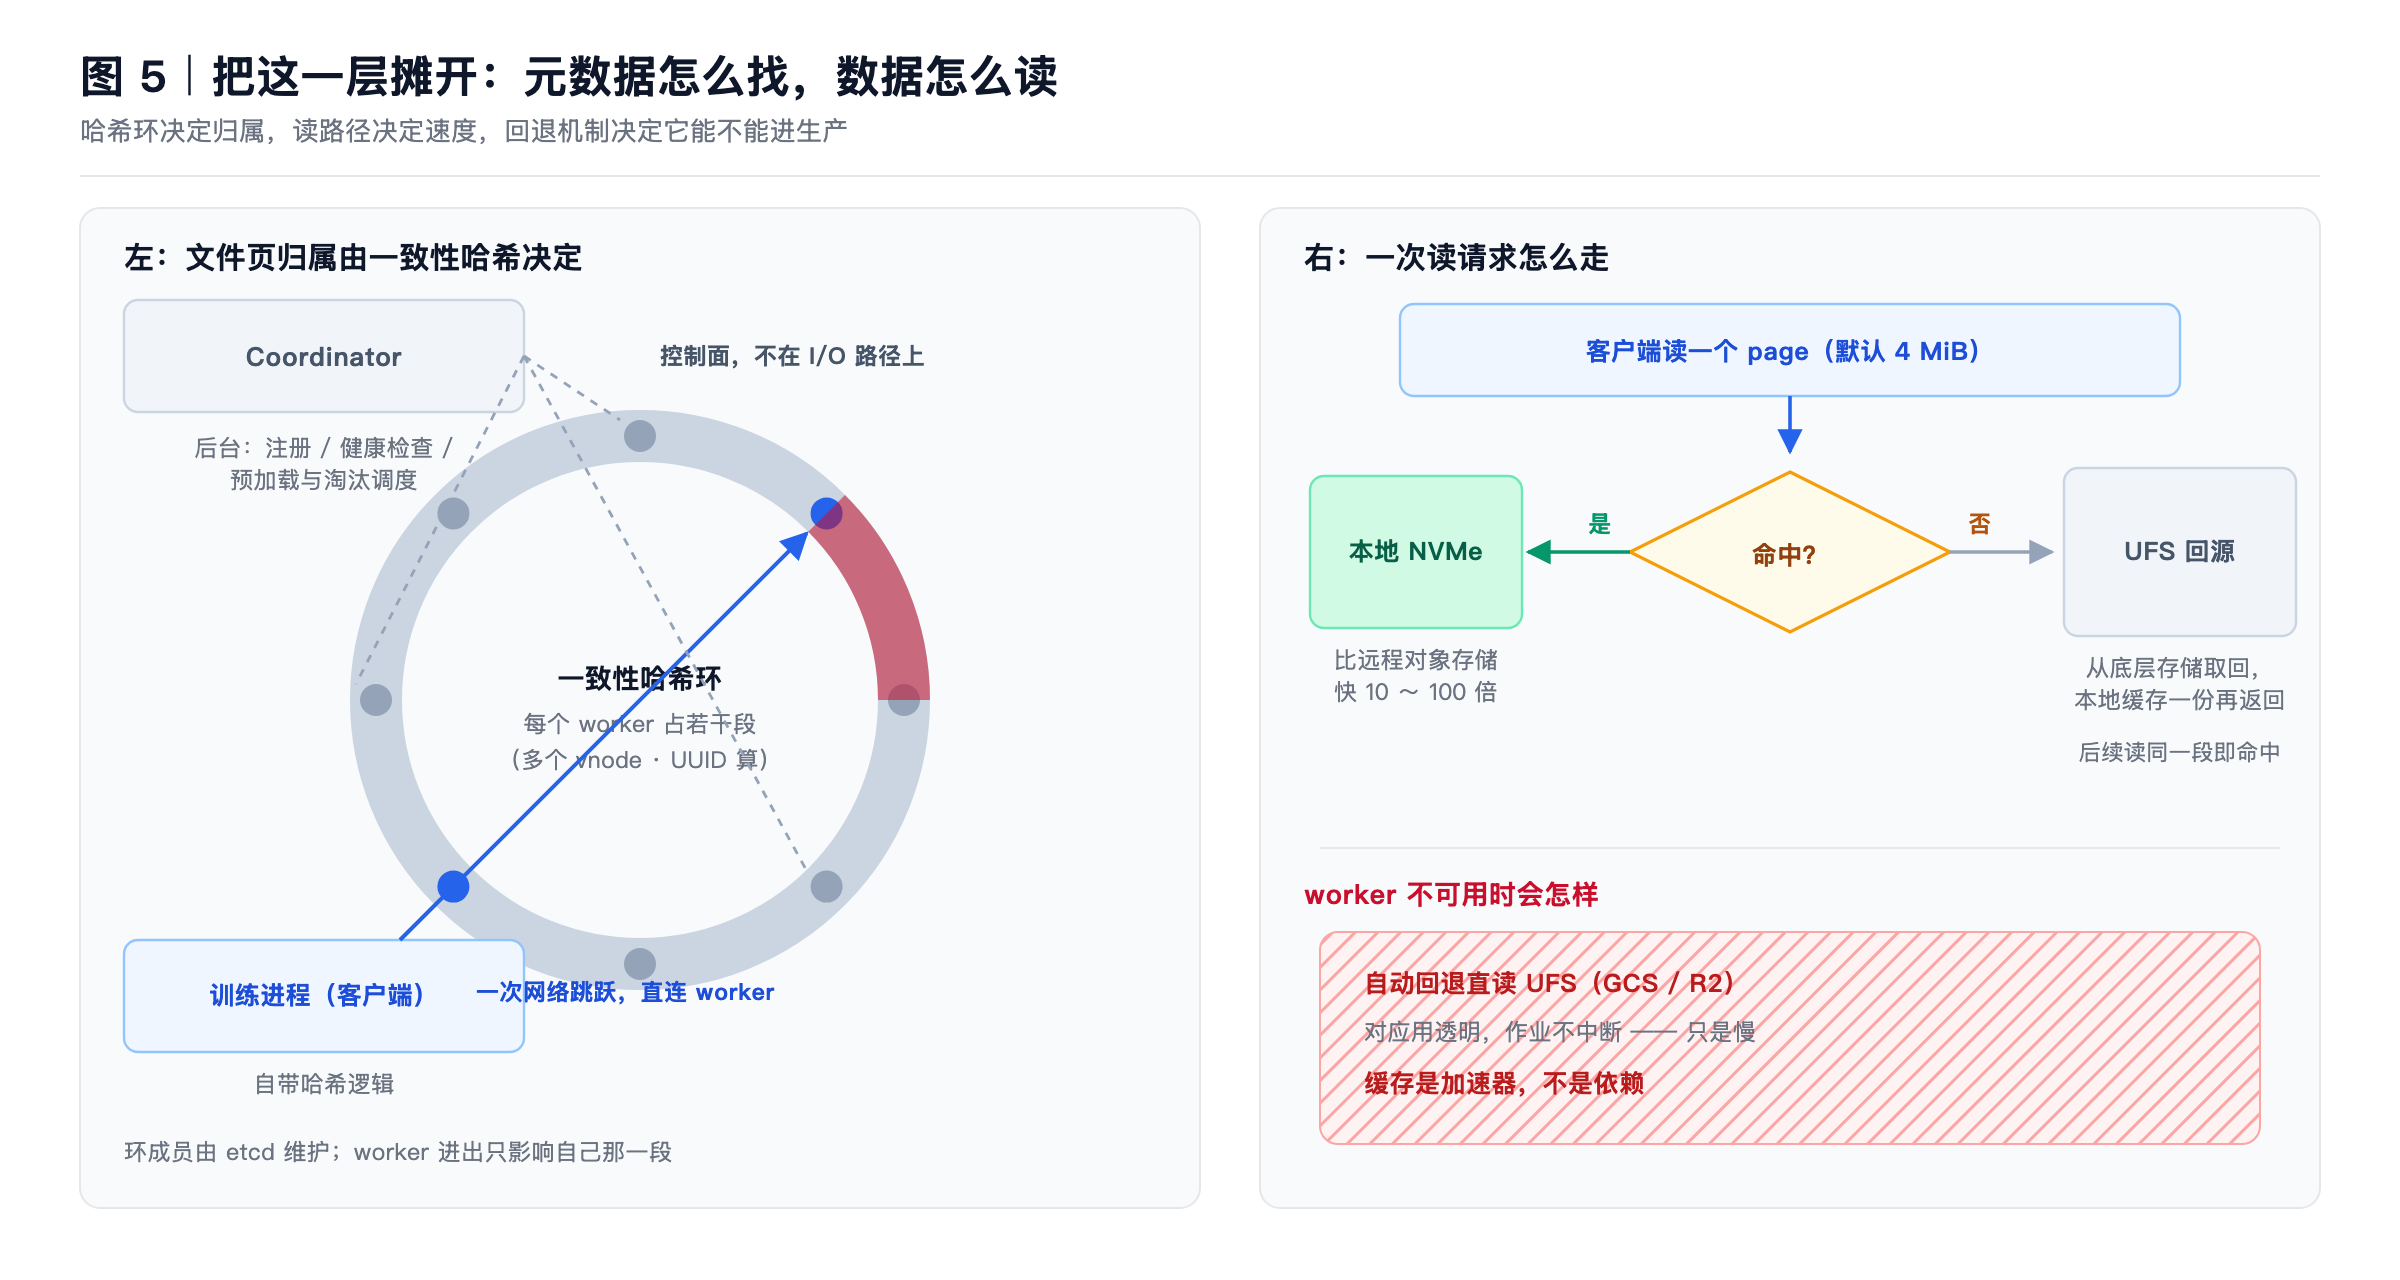
图 5|哈希环决定归属,读路径决定速度,回退机制决定它能不能进生产。
先说它长在哪儿。Worker 跟计算节点同置部署,一个 GPU 节点跑一个,用本机 NVMe 当缓存介质;客户端以库的形式嵌在计算框架里,或以 FUSE 挂成一个本地目录。没有独立的存储集群,也没有独立的数据节点——缓存容量跟着 GPU 节点走,加机器缓存池跟着长。这也解释了前面那个约束为什么能满足:数据始终在 GCS 或 R2 里,缓存里只是副本,不存在全量迁移这回事。
元数据不在中心。这一点跟很多人的直觉相反。传统分布式缓存或文件系统通常有个 master 管元数据,所有读写先去问它一次。Alluxio 企业版把元数据所有权按一致性哈希分散到所有 worker 上:每个 worker 在哈希环上占着几段,负责落在自己区间内的文件。客户端自己带着哈希逻辑,算完直接找对应的 worker,一次网络跳跃。
所以 Dyna 说的"文件归属由路径一致性哈希决定",其实顺手解决了两件事——他们提了流量分散,没提元数据瓶颈。几千万个文件如果都要去问一个中心节点,中心先扛不住。
(哈希环上每个 worker 有多个虚拟节点,由启动时分配的 UUID 算出,分布更均匀、扩缩容时迁移量也更小。环成员由 etcd 维护。)
Alluxio 的 Coordinator 也不在 I/O 路径上。它管的是 worker 注册与健康检查、预加载和淘汰任务的调度、集群配置这些后台活。所有数据和元数据操作都绕过它,直接从客户端打到 worker。所以 coordinator 重启一次,训练不会被打断——这跟前面说的"控制面无单点"是同一件事的两种说法。
Alluxio 的统一命名空间也值得一提。GCS、R2 是挂载进来的底层存储(UFS),挂载表存在 etcd 里。挂完之后,应用看到的是一个逻辑文件系统,不用为不同后端配不同的凭据和 SDK。Dyna 能做到"四个集群读同一份数据、训练脚本不用改",靠的就是这个——GCS 和 R2 在应用视角下只是两个路径。
再说读路径。命中走本地 NVMe,官方口径是比远程对象存储快 10 到 100 倍;未命中则由 worker 从 UFS 取回来、在本地缓存一份再返回,后面读同一段就命中了。缓存粒度是 page,默认 4 MiB——这就是"按页缓存"的实际含义:一个文件是否被完整缓存取决于你怎么访问它,通常只留真正被读过的那部分。
最要紧的一条是 Alluxio 的 UFS 回退。 Worker 不可用时,客户端自动回退到直读底层存储,对应用透明,作业不中断。前面讲过 GPU 节点随时可能被抢占,这一条就是那个约束的答案——缓存是加速器,不是依赖。Alluxio 挂了训练照样能跑,只是慢。
(Alluxio 的扩缩容也是同一套机制:新 worker 加入就接管哈希环上的一段,范围内的请求立刻成功,数据在首次访问时从 UFS 加载;worker 掉线,它那一段的读回退到 UFS,等集群重新均衡。哈希环可以跑动态模式——只含在线 worker,也可以跑静态模式——短期维护时保留离线 worker 的位置,维护完回来缓存还是热的。)
预热有两条路:一条是按需,应用第一次读时被动加载,默认行为;一条是主动预加载。Dyna 那个 orchestration service 走的是第二条——解析 manifest 拿到本轮的文件清单,提交预加载作业,把工作集灌进缓存池,灌完再启动训练。预加载任务的调度由 coordinator 负责。
缓存满了怎么办?自动按 LRU 淘汰,也可以手动释放指定路径。另外能配缓存规则、按数据集或租户设配额、给数据设 TTL 自动清掉过期的。这几项在多团队共用一个集群时是刚需——不然一组人跑个大实验就能把整个缓存池吃干净。
接入方式有三种:POSIX(FUSE 挂载)、S3 兼容 API、Python FSSpec,由同一组 worker 服务、共享同一份缓存,性能上没有差别,选哪个纯粹看代码习惯。Dyna 用的是 FUSE,所以对训练代码完全透明,研究员甚至不需要知道中间多了一层。
训练之外,还有两个地方在读同一份数据
前面都在讲训练。但同一套机制在训练之外还有两处用得上,我觉得值得单独说,因为很多人第一次上缓存时只想着训练读加速,很容易漏掉这两块。
一个是 checkpoint 写入。 Dyna 没细说 checkpoint 怎么落盘,只讲了作业挂了要从最近的 checkpoint 恢复、诊断 trace 按 attempt 编号留存。但这里有个容易忽略的对称性:恢复越依赖 checkpoint,它就会写得越频繁;而写入若走对象存储,一次几十上百 GB 会把训练循环卡住——你为了减少中断而多存,结果存 checkpoint 本身成了新的中断。
Alluxio 的做法是写回缓存:先把 checkpoint 按本地 NVMe 的速度写下去,异步再刷到对象存储。训练循环不等远程写入完成,阻塞就被拿掉了。需要说明的是,Dyna 的文章里没有提这一层,这是我读到他们讲 job resilience 的时候想到的问题——如果你正在设计自己的恢复策略,这一环值得提前算进预算。
另一个是模型分发。 训练侧的读加速和推理侧的模型加载,本质是同一件事的两个方向:一个把数据搬到 GPU 旁边,一个把权重搬到 GPU 旁边。推理副本冷启动时,要先从对象存储拉几十到几百 GB 的权重才能处理第一个请求。
Fireworks AI 的公开数据是:跨 10 多个 GPU 云做推理,模型加载从 20 多分钟降到每副本 2 到 3 分钟,出口成本降约 50%,每天服务约 2 PB。关键不在单次多快,而在于权重只拉一次,就能以线速喂给跨云的多个并发副本,不用每个副本、每个云各下一遍。
做机器人的人迟早会撞上这条:Dyna 的机队要往几百台机器上走,每出一次新 checkpoint 就要下发到所有站点,而站点的网络条件参差不齐。模型分发和训练加速,用的是同一套 Alluxio。
(顺带一提,Alluxio 同一层还能当低延迟 feature store。Blackout Power Trading 的公开数据是实时电力交易推理查询提速 37 到 83 倍,3727ms 到 45ms,让他们在同一个 15 分钟交易窗口内把模型规模从 5000 扩到 10 万以上。场景跟具身智能无关,逻辑却是一样的:热数据在本地,接口不变。)
部署那一端会把账算回来
第三篇讲产品,一般技术人容易跳过。我建议别跳。
Dyna-1 上线时每小时折约 35 条餐巾、75% 达到上桌标准,一个班次 480 条;Dyna-2 是每小时 95 条、93% 合格、每天 1590 条达标。鼎泰丰的店需要的是 18 小时 1500 条。这些数字当然好看,但我想说的不是这个。
我想说的是:他们的已部署机队现在每天产出超过 1TB 原始数据,而且还在往几百台机器上走。
这 1TB/天 的意义在于,训练侧的每个基础设施决策都会在部署侧被放大。他们给每个 episode 自动打标,切成 SOP 步骤的"阶梯图"——每一步是一级台阶,台阶宽度是耗时,下面标着结果和失败模式。于是问题从"怎么收集更多数据"变成了"怎么挑对的几个小时"。
他们在文章里写过一句很实在的话:用对的几个小时训练,胜过用更多错的数据训练。
而这个飞轮要转起来有个前提——数据能被快速、反复地取用。curation 是一次查询、预热是精确的、读取是可预期的。反过来,如果每换一次数据组合就要重新导一遍数据,飞轮当场就卡死了。
他们给的一个数字:现在一个新部署从进场到达到生产 ROI 线,最短 3 天。
3 天这个数字,本质上衡量的不是部署团队的效率,是数据管线的效率。
几个可以拿回去问自己的问题
读完这三篇,我觉得有几句话是可以直接搬回自己公司问的:
- 从"决定这一轮用哪些数据"到第一个 batch 跑起来要多久?如果是小时级,这个成本已经算在团队迭代速度里了,只是没人把它单列出来。
- GPU 节点上有多少 NVMe 是空着的?那笔钱已经付过了。
- 如果下个月要在另一家云上起一个集群,需要重做哪些事?如果答案是"把数据导过去",那多云目前还只是个说法——Dyna 从两朵云走到四朵云,真正难的从来不是拿到卡,是卡拿到之后数据怎么跟过去。
- 上一代模型调好的存储配置,换一代模型还成立吗?Dyna 的答案是不成立——在一万小时规模上成立的大部分东西,到一百万小时都撑不住了。
- 缓存是整文件淘汰还是分页淘汰的?一个 episode 动辄几 GB,淘汰一个文件意味着什么,算过吗?
- 数据热点是怎么分布的?有没有哪个"热门"文件把你某个节点的带宽打满过?
- 预热是在训练启动前做完的,还是让训练边跑边填?
- checkpoint 多久写一次,一次写多久,写入期间训练停不停?
前四条是方向,后四条可以直接查日志。列完会发现一件尴尬的事:没有一个能靠"再买一批 GPU"回答——你花在弄清楚"到底卡在哪"上的时间,比扩容更有回报。
最后
Dyna 在第二篇的结尾写了三篇里最好的一句:随着数据长大,瓶颈一直在移动——先是存储格式,然后是摄取管道,然后是训练清单。要做的是找到当前的瓶颈,而不是在它后面堆机器。
这两年见过太多"训练慢了就加卡"。加卡当然有用,但如果你不知道卡在哪一层,加卡只是把压力推到下一个最薄弱的环节,然后你再花三周时间去找新的问题。
Dyna 这套东西值得读的地方,其实不是那 100 万小时。是他们在每个阶段都老老实实回答了"现在到底卡在哪",然后只改那一处——包括那件他们明明能自己写、但选择不自己写的事。
顺带说一句,那件他们选择不自己写的事,后来成了别人可以直接拿去用的东西。Alluxio 这套架构最初不是为机器人训练设计的,但它恰好长在了这个位置上:不管你的数据存在哪个云、什么格式、多少个集群在读,它只负责一件事——在训练开始之前把工作集搬到算力旁边,并在接下来几周里维持住。
如果你的训练也开始有"GPU 在等数据"的迹象,建议先量三个数,再决定要不要上这一层:缓存命中率、单节点稳态读带宽、从提交作业到第一个 batch 出来的时间。这三个数花不了一天功夫,但能告诉你瓶颈到底在哪一层。加卡之前,总得先搞清楚卡该加在哪儿。
原文出处
- 模型:《Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models》 — dyna.co/dyna-2
- 基础设施:《Training Dyna-2 at million-hour scale, repeatably》 — dyna.co/research/dyna-2-infrastructure
- 产品与部署:《Not Just a Model, But a Product》 — dyna.co/research/scaling-customer-deployments

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)