【SenseNova U1.5 Lite实战】单卡4090D+32G内存家用设备也可高质量运行,多个国产芯片已验证,SenseNova多案例部署与踩坑
SenseNova-U1.5 部署实战
相关链接
- 官方GitHub仓库:https://github.com/OpenSenseNova/SenseNova-U1
- Gitcode:SenseNova-U1:基于 NEO-Unify 架构的统一多模态理解与生成项目 - AtomGit
- 模型官网:日日新 - 商汤科技大模型平台 | SenseNova
- huggingface:https://huggingface.co/collections/sensenova/sensenova-u15
- 魔搭社区:SenseNova-U1.5-8B-MoT
关联GitHub Issues
系列目录
| 章节 | 内容 | 状态 |
|---|---|---|
| 第一章 | SenseNova 介绍:原生统一范式、NEO-unify 与 MoT、U1.5 能力全景 | ✅ 本篇 |
| 第二章 | 单卡 NVIDIA RTX 4090D 部署与踩坑:驱动泥潭、显存腾挪、8 步蒸馏、服务化 | ✅ 本篇 |
| 第三章 | AMD ROCm 部署实战 | ✅ 本篇 |
| 第四章 | 国产GPU摩尔线程MTT S4000部署实战 | ✅ 本篇 |
| 第五章 | SenseNova-U1 在低资源本机(8GB 显存 + 16GB 内存)上的部署与运行指南 | ✅ 本篇 |
| 第六章 | 华为Ascend部署案例,单卡910B部署与踩坑 | ✅ 本篇 |
| 第七章 | RTX Pro 6000(Blackwell)部署实战 | 🚧 待补 |
| 第八章 | 寒武纪MLU部署SenseNova | 🚧 待补 |
| 第九章 | 海光信息DCU K100部署SenseNova | 🚧 待补 |
| 第十章 | 壁仞科技BR100部署SenseNova | 🚧 待补 |
| 第十一章 | 沐曦C500部署SenseNova | 🚧 待补 |
| 第十二章 | 华为Ascend950DT部署SenseNova | 🚧 待补 |
| 第十三章 | 上古老卡部署SenseNova测试验证(NVIDIA V100 / AMD MI50) | 🚧 待补 |
Ascend910B视频演示:
9月4日
这篇文章记录我把 SenseNova-U1.5-8B-MoT 装进一张 4090 D 以及AMD,Moorethreads,Ascend-NPU等案例的完整过程:在4090D,驱动内核 7.0 上的编译泥潭、35.1 GB 权重与 24 GB 显存之间的腾挪、官方 8 步蒸馏 LoRA 的加速实测,以及 FastAPI 服务化封装。
-
结论先行:SenseNova-U1.5-8B-MoT 的 BF16 权重实际是 17.53B 参数 / 35.1 GB(理解 8.12B + 生成 8.17B + 共享 1.25B),24 GB 显存装不下全量权重。官方
--vram_mode卸载会把全部权重钉进锁页内存,32 GB 内存主机必 OOM;改用--device_map分片加载路线(第 2.9 节)把权重切到 GPU+CPU,峰值显存压到 ~20.5 GiB,单卡 4090 D 稳定出图——这也是本文全部实测数据的口径。 -
8 步蒸馏 LoRA 真香:加载 814 MB 的
SenseNova-U1.5-8B-MoT-LoRA-8step,采样从 50 步降到 8 步、CFG 从 4.0 降到 1.0,同 Prompt 同 Seed 下 2048×2048 端到端从 178.0 s 降到 26.7 s,画质损失可控(对比图见第 2.7 节)。 -
附可复用模板:一份 FastAPI + systemd 的 API 封装(第 2.10 节)、部署机防休眠配置(第 2.1 节)、低显存档位速查表(第 2.9 节),可直接抄作业。
第一章 SenseNova 介绍
1.1 从「模态拼装」到「原生统一」
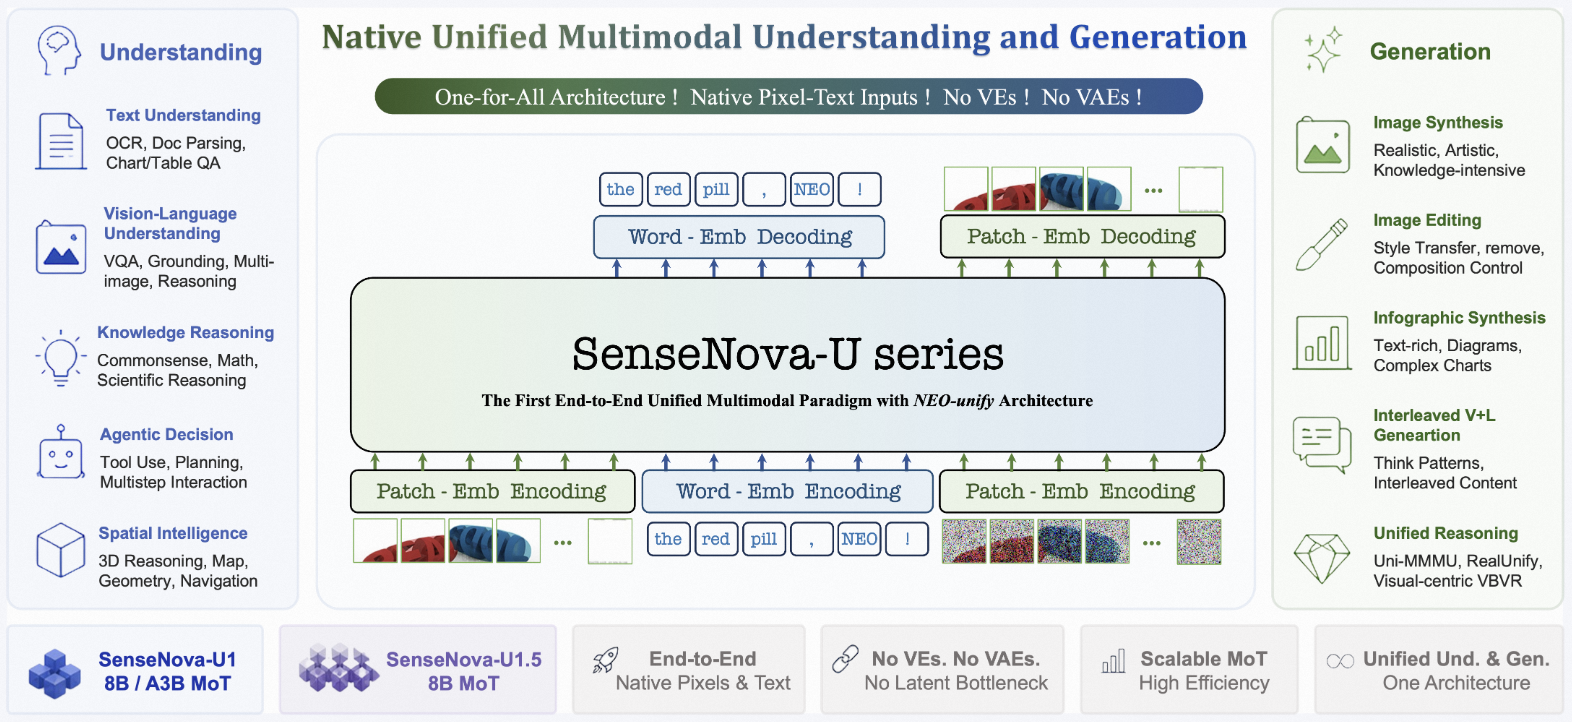
近两年主流的多模态方案是「拼装」路线:大语言模型外挂视觉编码器(VE)做理解、再外接 VAE + 扩散模块做生成,模块之间靠适配器翻译彼此的表示。SenseNova-U 系列走的是另一条路——原生统一:商汤提出的 NEO-unify 架构从第一性原理出发,彻底摒弃视觉编码器与 VAE,让像素与文字在同一架构内端到端建模,理解、推理、生成由一个模型原生完成。用官方 README 的话说,这代表着多模态 AI 的范式转变:从模态集成走向真正的统一——不再依赖适配器在模态之间翻译,而是以原生方式跨语言与视觉进行思考与行动。
1.2 NEO-unify 的三个核心支柱
-
🔗 端到端统一建模语言与视觉信息,打通从像素到文字的理解与生成;
-
🖼️ 兼顾语义表达与像素级保真,既不丢语义、也不丢细节;
-
🧠 原生 MoT(Mixture-of-Transformers) 高效完成跨模态推理,减少模态冲突。
MoT 是理解后文一切部署问题的钥匙,这里先交代结构:U1.5 不是「一个 LLM 外挂一个扩散头」,而是把理解与生成做成两条专家通路——视觉编码器、注意力与 FFN 权重各自成对(理解侧不带后缀、生成侧带 _mot_gen 后缀),只有词表的 embed_tokens 与 lm_head(合计 1.25B)是两条通路共享的。这个结构对部署有两个直接推论(第 1.4 节展开):任意单任务时刻只有一半左右的权重是热的;文生图里混有自回归阶段(如 --think 先吐思考文本),所以推理日志里既会出现扩散采样步数,也会出现 LLM 式的 token 吞吐指标。
1.3 SenseNova-U1.5:六项用户可感知的升级
SenseNova-U1 于 2026-04-27 首发,2026-07-31 放出 U1.5-Preview,2026-08-20 正式发布 U1.5 正式版(SenseNova-U1.5-8B-MoT),并同步发布 8 步蒸馏权重 SenseNova-U1.5-8B-MoT-LoRA-8step。正式版在 NEO-unify 基础上进一步强化了 patchify 层、数据质量与分布、任务定义、Prompt 增强和后训练流程,重点提升六项能力:
-
更高质量的图像生成:构图、色彩和谐度、材质渲染、光照、真实感与细粒度细节全面提升;
-
更好的文字渲染与信息图生成:中英文文字可读性更强,海报、信息图、品牌素材等信息层级更清晰;
-
更高效的原生 4K 生成:全局结构连贯性、高分辨率输出稳定性与生成效率提升;
-
更可靠的原生图像编辑:局部编辑、文字编辑、多参考图编辑中更好地保持主体身份与非编辑内容;
-
更强的复杂指令遵循:对象数量、空间关系、版式、风格及多约束请求执行更稳定;
-
更精确的视觉控制:通过边界框、视觉标记、单图/多图参考实现区域级与对象级控制。
加上 U1 时代就树立的原生图文交错生成(绘本、教程、多页 PPT 一次连贯产出)与高密度信息呈现(知识图解、海报、简历等信息密集场景),以及理解与生成双线的开源 SoTA 评测成绩,U1.5 是「原生统一」路线里目前工程完成度最高的开源权重之一。
1.4 名叫「8B」,实则 17.5B:部署前必须认清的参数账
部署之前,我先用仓库自带的 scripts/inspect_model_params.py 把参数构成摸清楚:
python scripts/inspect_model_params.py --model_path /path/to/SenseNova-U1.5-8B-MoT
Total params: 17.533B
Total memory: 35.066GB (bfloat16)
---------------------------------------------------------------------
group                              params memory (bfloat16)      ratio
---------------------------------------------------------------------
generation_transformer             8.167B         16.334GB     46.58%
understanding_transformer          8.121B         16.243GB     46.32%
shared                             1.245B          2.489GB      7.10%
---------------------------------------------------------------------
Pathway breakdown (shared counted in both):
---------------------------------------------------------------------
pathway                            params memory (bfloat16)      ratio
---------------------------------------------------------------------
understanding pathway              9.366B         18.732GB     53.42%
generation pathway                 9.412B         18.823GB     53.68%
注意这个数字:名字叫「8B」,实际总参数 17.53B、BF16 权重 35.1 GB——「8B」指的是单侧通路参数量。这是后文一切显存问题的根源,也是本次部署最大的认知坑:别按「8B 模型 16 GB 显存随便跑」来预估资源。跑文生图时前向实际经过「生成通路 + 共享层」约 9.41B 参数,跑图像理解时经过「理解通路 + 共享层」约 9.37B 参数——任意时刻只有一条通路是热的,这正是分层卸载 / 分片加载能把 24 GB 卡跑起来的结构性前提。
1.5 为什么选它做部署实战:低显存路径是官方一等公民
选 U1.5 正式版作为部署对象,理由有三:
-
能力全面:原生 2K/4K 生成、中英文文字渲染、信息图、图像编辑、图文交错生成,还有出图前先推理的
--think模式,一个模型覆盖后续章节想玩的所有案例; -
对消费级显卡友好:官方提供
--vram_mode四档分层卸载(最低 ~5 GiB 显存即可跑)、--max_memory显存预算约束、社区维护的 GGUF Q8 量化(19.9 GB),低显存路径不是社区补丁而是官方一等公民; -
蒸馏加速官方化:官方直接放出 8 步蒸馏 LoRA,配套文档给出与 50 步基线的完整对比,「消费级单卡 + 8 步蒸馏」就能把 2K 出图压进半分钟,非常适合做部署调优选题。
SenseNova-U1.5 是一个「理解与生成原生统一、总参数 17.5B、官方把低显存与加速都做成一等公民」的模型——能力强、坑也明确,接下来就是把它塞进一张 24 GB 显卡的实战。
第二章 单卡 NVIDIA RTX 4090D 部署与踩坑
2.0 环境速查表
| 项目 | 值 |
|---|---|
| 系统 | Ubuntu 24.04.4 LTS,内核 7.0.0-28-generic x86_64 |
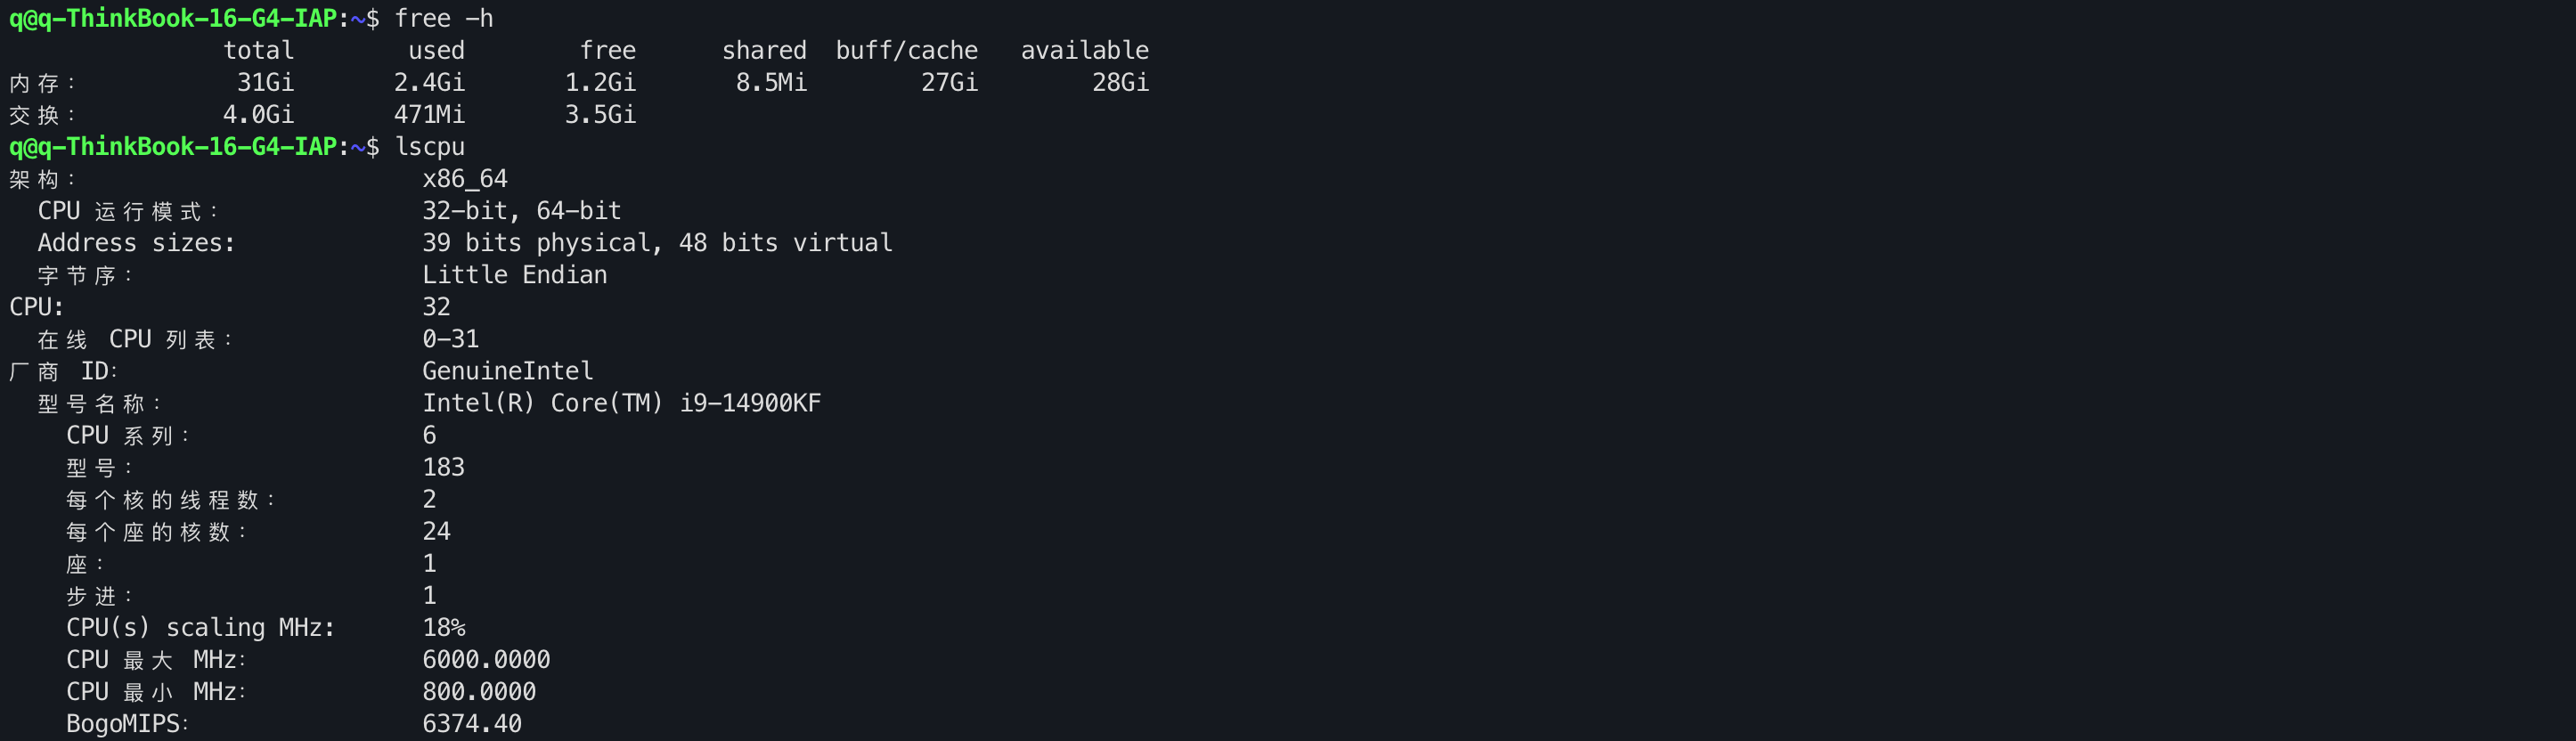
| CPU / 内存 | Intel Core i9-14900KF / 32 GB |
| GPU | NVIDIA GeForce RTX 4090 D,24GB 显存 |
| 驱动 / CUDA | 595.45.04 / CUDA Toolkit 12.8(nvcc V12.8.61) |
| Python 环境 | Python 3.11.15(uv 管理) |
| 关键依赖 | torch 2.8.0+cu128、torchvision 0.23.0+cu128、transformers 5.15.0、accelerate 1.14.0、safetensors 0.8.0、huggingface_hub 1.27.0、sentencepiece、numpy 2.2.0、pillow 12.0.0 |
| 模型 | sensenova/SenseNova-U1.5-8B-MoT(BF16,33 GB / 8 个 safetensors 分片) |
| 蒸馏权重 | SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors(814 MB) |
| 仓库 | GitHub OpenSenseNova/SenseNova-U1 |
2.1 部署机准备
部署机是一台i9-14900KF + 4090 D。正式安装前先做三件事,否则中途必踩坑:
第一,禁用自动休眠。 系统默认空闲一段时间就挂起——跑到一半的 50 步采样直接腰斩;更麻烦的是休眠唤醒后 GPU 状态可能异常,轻则推理进程段错误,重则整机死机。我在部署过程中被它打断了好几次,最后的处理是彻底屏蔽休眠:
sudo systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target
sudo sed -i 's/#HandleLidSwitch=.*/HandleLidSwitch=ignore/' /etc/systemd/logind.conf
sudo systemctl restart systemd-logind
第二,长任务一律放 tmux 或 nohup。 33 GB 模型加载、50 步采样都是分钟级任务,终端一断前功尽弃。本文所有长跑命令都形如 nohup bash bench.sh > bench.log 2>&1 &,回来用 tail -f 接上现场。
第三,固化验证命令。 nvidia-smi、nvcc --version、uv pip list | grep torch、du -sh 模型目录 这四条在每次重启/更新后跑一遍,十秒钟确认环境没有悄悄坏掉——部署机最怕的就是「上次还好好的,这次不知道哪里坏了」。
2.2 驱动与 CUDA
2.2.1 先清场:屏蔽 nouveau
Ubuntu 24.04 默认带 nouveau,不屏蔽装 NVIDIA 驱动必翻车:
echo -e "blacklist nouveau\noptions nouveau modeset=0" | sudo tee /etc/modprobe.d/blacklist-nouveau.conf
sudo update-initramfs -u
sudo reboot
2.2.2 编译依赖不能少
.run 安装器需要现场编译内核模块,新内核尤其容易缺头文件:
sudo apt update
sudo apt install -y gcc make linux-headers-$(uname -r)
gcc -v   # 确认工具链可用
本机内核是 7.0.0-28-generic(24.04 的 HWE 新内核),这一点直接导致了下面的版本试错。
2.2.3 CUDA 版本试错:12.8 → 12.9 → 13.2
我按时间顺序踩了三个版本(都是官方 .run 安装包)。先说一个贯穿全程的关键认知:.run 安装包里「驱动」和「toolkit」是两个可以分开装的组件,理解了这一点,后面的操作就不奇怪了:
# 第一次:CUDA 12.8 整包(捆绑驱动 570.86.10)—— 驱动在 7.0 内核上编译内核模块失败
wget https://developer.download.nvidia.com/compute/cuda/12.8.0/local_installers/cuda_12.8.0_570.86.10_linux.run
# 第二次:CUDA 12.9 整包(捆绑驱动 575.51.03)—— 仍然失败,翻安装日志排查
cat /var/log/cuda-installer.log
cat /var/log/nvidia-installer.log | grep -i error
# 第三次:CUDA 13.2(捆绑驱动 595.45.04)—— 驱动终于编译通过,只装 Driver 组件
wget https://developer.download.nvidia.com/compute/cuda/13.2.0/local_installers/cuda_13.2.0_595.45.04_linux.run
sudo chmod +x cuda_13.2.0_595.45.04_linux.run
sudo ./cuda_13.2.0_595.45.04_linux.run
# 驱动通过后,toolkit 不必追 13.2:torch 官方 wheel 是 cu128,nvcc 只用于编译少量自定义扩展,
# 于是单独装 CUDA 12.8 的 toolkit,跳过它捆绑的老驱动组件:
sudo ./cuda_12.8.0_570.86.10_linux.run --toolkit --silent --override
验证(真机输出):
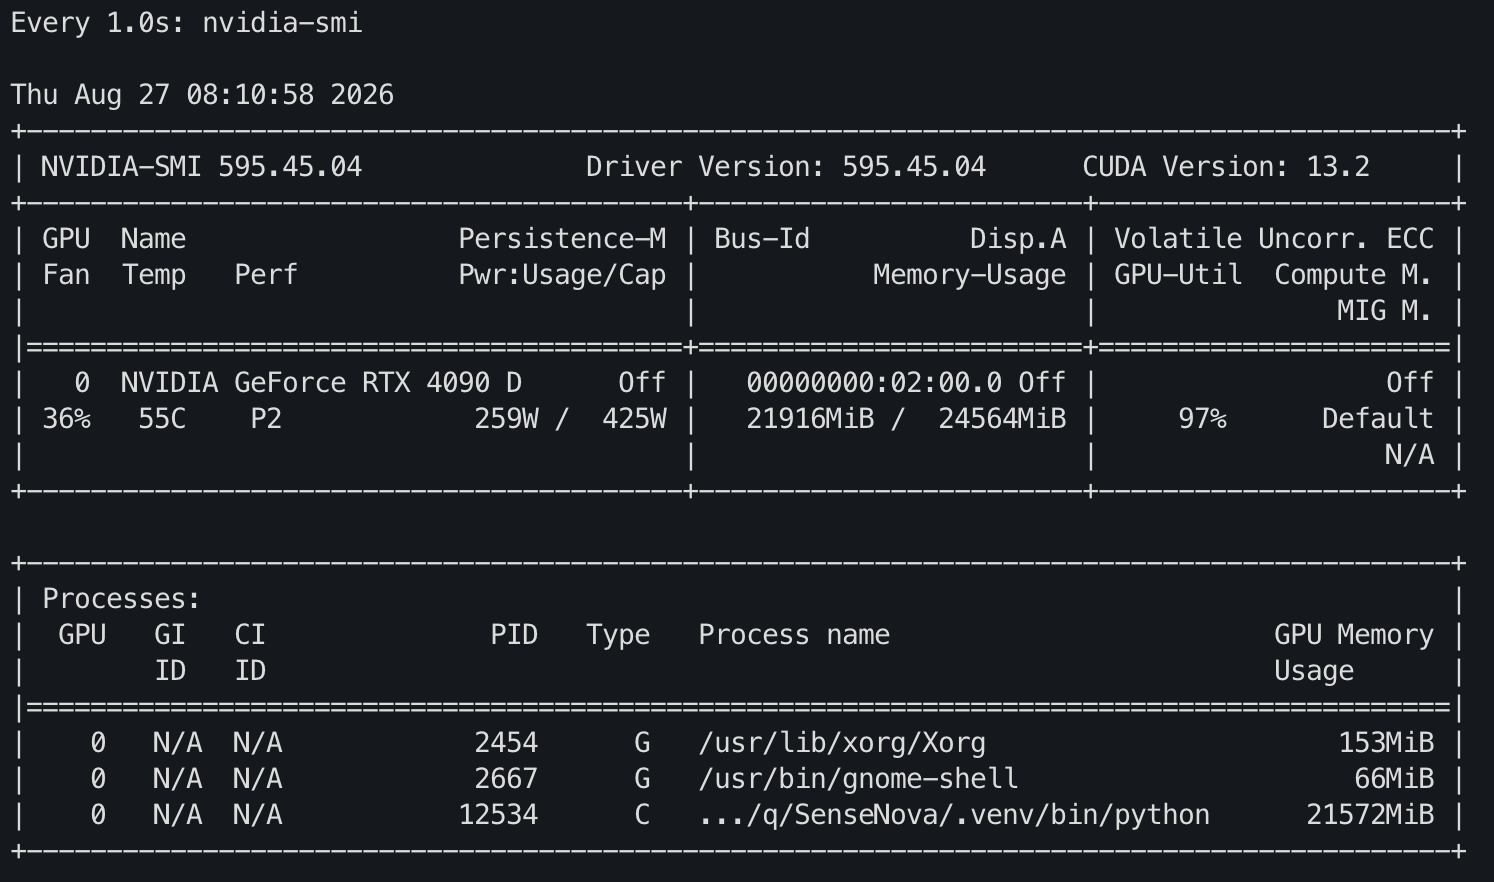
nvidia-smi    # NVIDIA-SMI 595.45.04 / Driver 595.45.04 / CUDA Version: 13.2
nvcc --version
# Cuda compilation tools, release 12.8, V12.8.61
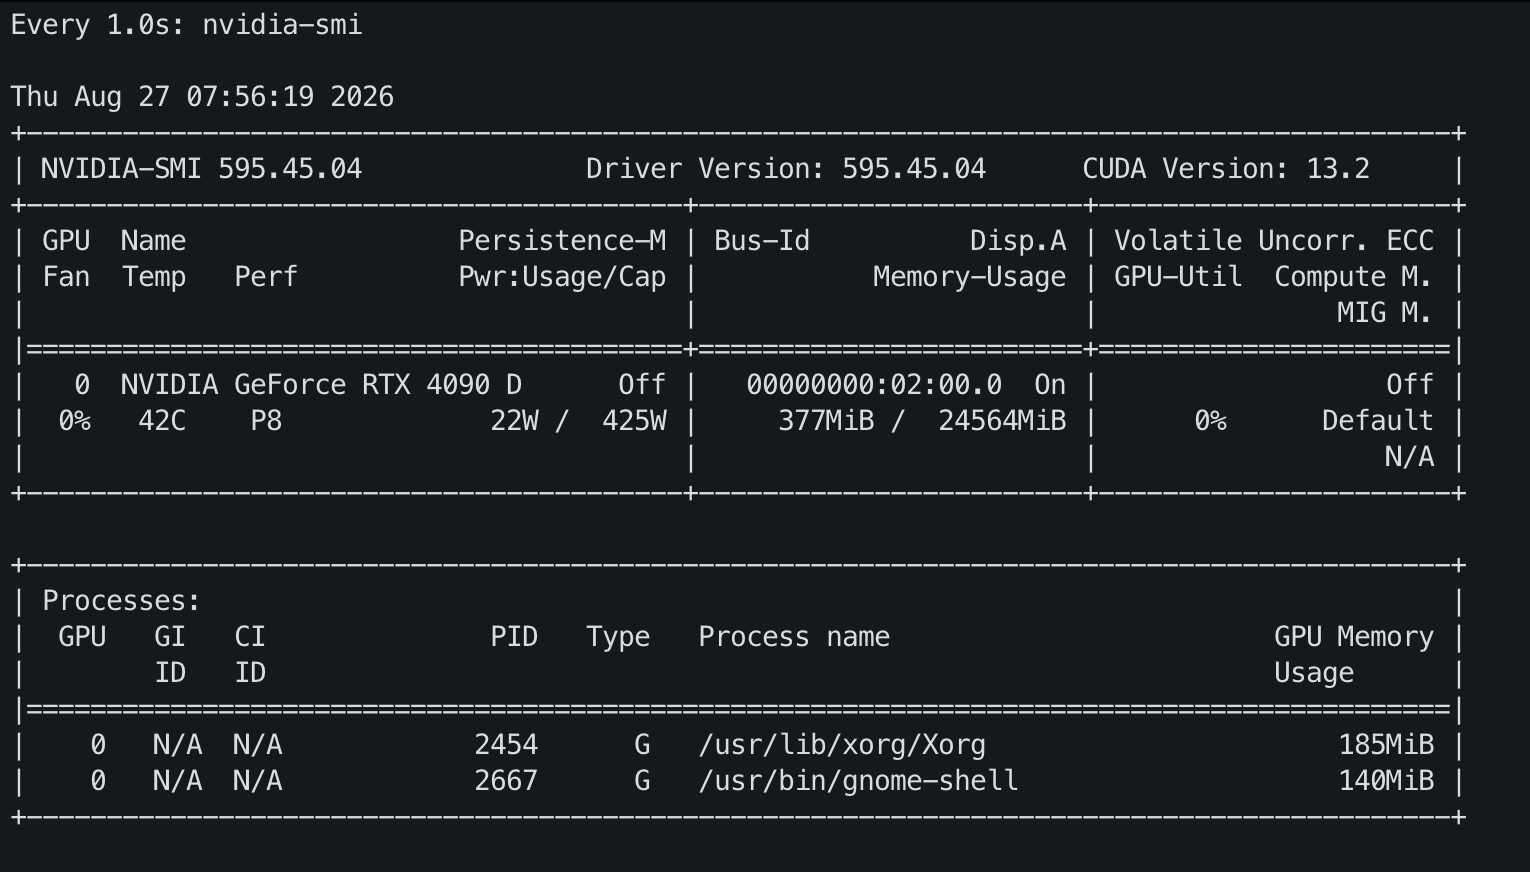
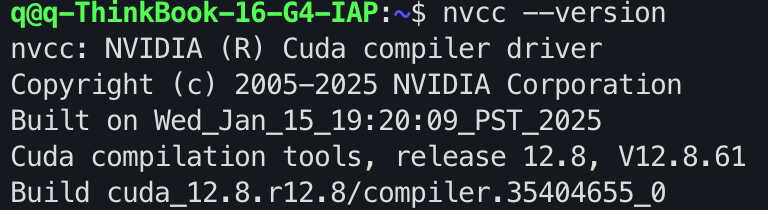
这里有个极易误读的点:nvidia-smi 显示的 CUDA Version: 13.2 是「驱动支持的最高 CUDA 版本」,不是已安装的 toolkit 版本——本机实际 toolkit 以 nvcc --version 为准,是 12.8。说实话我最初整理环境信息时也把它误写成了「CUDA 13.2」,后来复核 /var/log/cuda-installer.log(里面清楚地写着 Installing: CUDA Toolkit 12.8)才纠正过来。这个误判新手几乎人人会犯,单独拿出来说一句。
根因分析,给遇到同类问题的同学一个判断框架:.run 安装器会现场编译内核模块,失败几乎都发生在「内核太新 × 驱动太老」的组合上——7.0 内核改动了不少内核态 API(内存管理、符号导出),老驱动的 nvidia.ko 源码根本编译不过去,症状是安装器报 Failed to build kernel module,或者装完 nvidia-smi 提示 Driver/library version mismatch。排查路径固定为三步:先 cat /var/log/nvidia-installer.log | grep -i error 看编译错误,再 dmesg | grep -i nvidia 看加载期报错,最后决定升驱动而不是降内核。我这次的选择是跟着内核走:24.04 的 HWE 内核会持续升级,与其钉死旧内核不如直接上最新驱动分支(595 系对 6.x/7.x 内核支持最完整),一次装好后续内核小版本升级也省心。
最后把 nvcc 加进 PATH(.run 安装不会自动写):
echo 'export PATH=/usr/local/cuda/bin:$PATH' >> ~/.bashrc
echo 'export LD_LIBRARY_PATH=/usr/local/cuda/lib64:$LD_LIBRARY_PATH' >> ~/.bashrc
source ~/.bashrc
✅ 检查点:
nvidia-smi能显示 595.45.04 与 RTX 4090 D、nvcc --version输出 12.8,驱动这一层才算过关。
2.2.4 关键结论:驱动、工具链、运行时三层解耦
PyTorch 官方 wheel 目前主流仍是 cu128(CUDA 12.8 运行时)。NVIDIA 驱动向下兼容:595 驱动跑 cu128 的 torch 完全没问题,不需要为了 torch 去降级驱动,也不需要等 cu13x 的 wheel。三层各自独立选型,最终组合:
-
驱动层:595.45.04(新分支,对 7.0 内核支持完整,最高可支持 CUDA 13.2);
-
工具链层:CUDA Toolkit 12.8(nvcc V12.8.61,编译扩展用,跟着 torch 生态走);
-
应用层:
torch 2.8.0+cu128(pip wheel 自带 CUDA 12.8 运行时)。
2.3 Python 环境:uv 一条龙
传统 conda 太重,这次全程用 uv,从装 Python 到装依赖一条命令:
# 1) 安装 uv curl -LsSf https://astral.sh/uv/install.sh | sh source ~/.bashrc && uv --version # 2) 创建 Python 3.11 虚拟环境(仓库要求 >=3.10,<3.14) cd ~/SenseNova uv venv --python=3.11 source .venv/bin/activate # 3) 安装 PyTorch(cu128 wheel) uv pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128 # 4) 克隆仓库并以可编辑模式安装(自动注册模型到 transformers) sudo apt install -y git # 最小化装的 24.04 可能没有 git,先补上 git clone https://github.com/OpenSenseNova/SenseNova-U1.git SenseNova-U1-GitHub cd SenseNova-U1-GitHub uv pip install -e .
小坑一个:我这台机器最初没装 git,是直接在 GitHub 页面下载源码 zip 解压的(目录里没有 .git,git log 用不了)。功能上没影响,但后续想 git pull 更新仓库就得整个重新下载,建议按上面命令装好 git 再 clone。
最终锁定版本(uv pip list 节选):
torch                2.8.0+cu128
torchvision          0.23.0+cu128
transformers         5.15.0
accelerate           1.14.0
safetensors          0.8.0
huggingface_hub      1.27.0
numpy                2.2.0
pillow               12.0.0
sentencepiece        0.2.1
sensenova-u1         0.1.0 (editable)
踩坑点:
-
transformers 需要 5.7+(仓库要求),直接装最新 5.15.0 即可,4.x 会报模型类不存在;
-
没装 flash-attn 时,推理脚本的
--attn_backend auto会自动回退到 SDPA,日志里会打印effective='sdpa'便于确认,不折腾也能跑;追求极限速度再考虑编译 flash-attn。
✅ 检查点:
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0))"输出True NVIDIA GeForce RTX 4090 D,Python 环境才算就绪。
2.4 模型下载:33 GB,8 个分片
国内环境直接用 ModelScope(仓库同名空间),速度稳定;有代理的话 Hugging Face 也可以。
# ModelScope 方式(本次实测使用) pip install modelscope modelscope download --model SenseNova/SenseNova-U1.5-8B-MoT --local_dir ~/SenseNova/SenseNova-U1.5-8B-MoT # Hugging Face 方式(备选) hf download sensenova/SenseNova-U1.5-8B-MoT --local-dir ~/SenseNova/SenseNova-U1.5-8B-MoT
实测:8 个分片(7×约 4.9 GB + 1×369 MB)共 33 GB,约 14 分钟下完,平均 ~40 MB/s。国内环境 Hugging Face 直连经常断流,能直连就优先 ModelScope,基本能跑满带宽,不需要任何代理配置。下载前先 df -h 确认空间:权重 33 GB + uv/pip 缓存 + 输出图片,至少预留 50 GB;本次部署结束时 233 GB 的盘已用 93 GB,其中 uv 缓存就占了 12 GB,可用 uv cache clean 在装完后安全回收。
du -sh ~/SenseNova/SenseNova-U1.5-8B-MoT
# 33G   /home/q/SenseNova/SenseNova-U1.5-8B-MoT
顺手把 8 步蒸馏 LoRA 也下了(只有 814 MB):
hf download sensenova/SenseNova-U1.5-8B-MoT-LoRAs \
    SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \
    --local-dir ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs
⚠️ 官方特别提醒:U1.5 的 8 步 LoRA 只适配
SenseNova-U1.5-8B-MoT正式版,不要用在 U1.5-Preview 或老版 U1 权重上。
2.5 首跑:50 步基线
官方文生图脚本是 examples/t2i/inference.py。先跑 50 步完整基线(官方推荐超参):
cd ~/SenseNova/SenseNova-U1-GitHub python examples/t2i/inference.py \ --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \ --prompt 'A wooden greeting card lying on a desk, with readable Chinese text "生日快乐" written on it, a small bouquet of flowers beside it, soft morning sunlight through the window, photorealistic, high detail.' \ --output outputs/base_50step_2048.png \ --width 2048 --height 2048 \ --cfg_scale 4.0 --cfg_norm none --timestep_shift 3.0 --num_steps 50 \ --seed 42 --attn_backend sdpa --profile \ --device_map auto --max_memory "0=20GiB,cpu=16GiB"
几个要点:
-
分片加载是 24 GB 显存 + 32 GB 内存能跑起来的关键:
--device_map auto --max_memory "0=20GiB,cpu=16GiB"(第 2.9 节路线二)让 Accelerate 按层把权重分片派发到 GPU(约 18.4 GiB)+ CPU(可换页,约 15 GiB),生成峰值 ~20.5 GiB; -
为什么不照抄官方
--vram_mode fast:卸载模式会把language_model.model.layers全部 30.19 GiB 权重pin_memory()成不可换页的锁页内存,32 GB 内存装不下,直接 OOM/死机——本机真实踩过(fast 尝试卡死在 pinning 阶段、回退脚本被 OOM kill)。主机内存 ≥40 GB 才能用fast(原理见第 2.9 节); -
--profile会打印模型加载耗时、单图生成耗时、峰值显存、token 吞吐,调优必备; -
分辨率不是任意的:模型按固定分辨率桶训练,2048×2048 属于官方
1:1桶,乱填尺寸脚本会告警且质量下降:
| 比例 | 分辨率 | 比例 | 分辨率 |
|---|---|---|---|
| 1:1 | 2048×2048 | 16:9 | 2720×1536 |
| 3:2 | 2496×1664 | 4:3 | 2368×1760 |
| 2:3 | 1664×2496 | 3:4 | 1760×2368 |
| 1:2 | 1440×2880 | 2:1 | 2880×1440 |
--profile 的输出怎么读,这里交代一下,后面所有对比数据都出自它:它会依次打印模型加载耗时(含从磁盘读 8 个分片 + 反序列化)、生成阶段的平均单图耗时、峰值显存的 allocated / reserved 双值(前者是张量实际占用,后者是 caching allocator 向驱动申请的池子大小,OOM 排查看 reserved)、以及按图像 token 归一化的吞吐(tok/s,此处的 token 是潜空间 patch 序列长度,2048×2048 对应上万 token,不是文本 token)。第二次运行起权重已在页缓存里,加载耗时会明显变短,做对比时建议取热启动数据并注明。
50 步基线出图(2048×2048,seed=42):
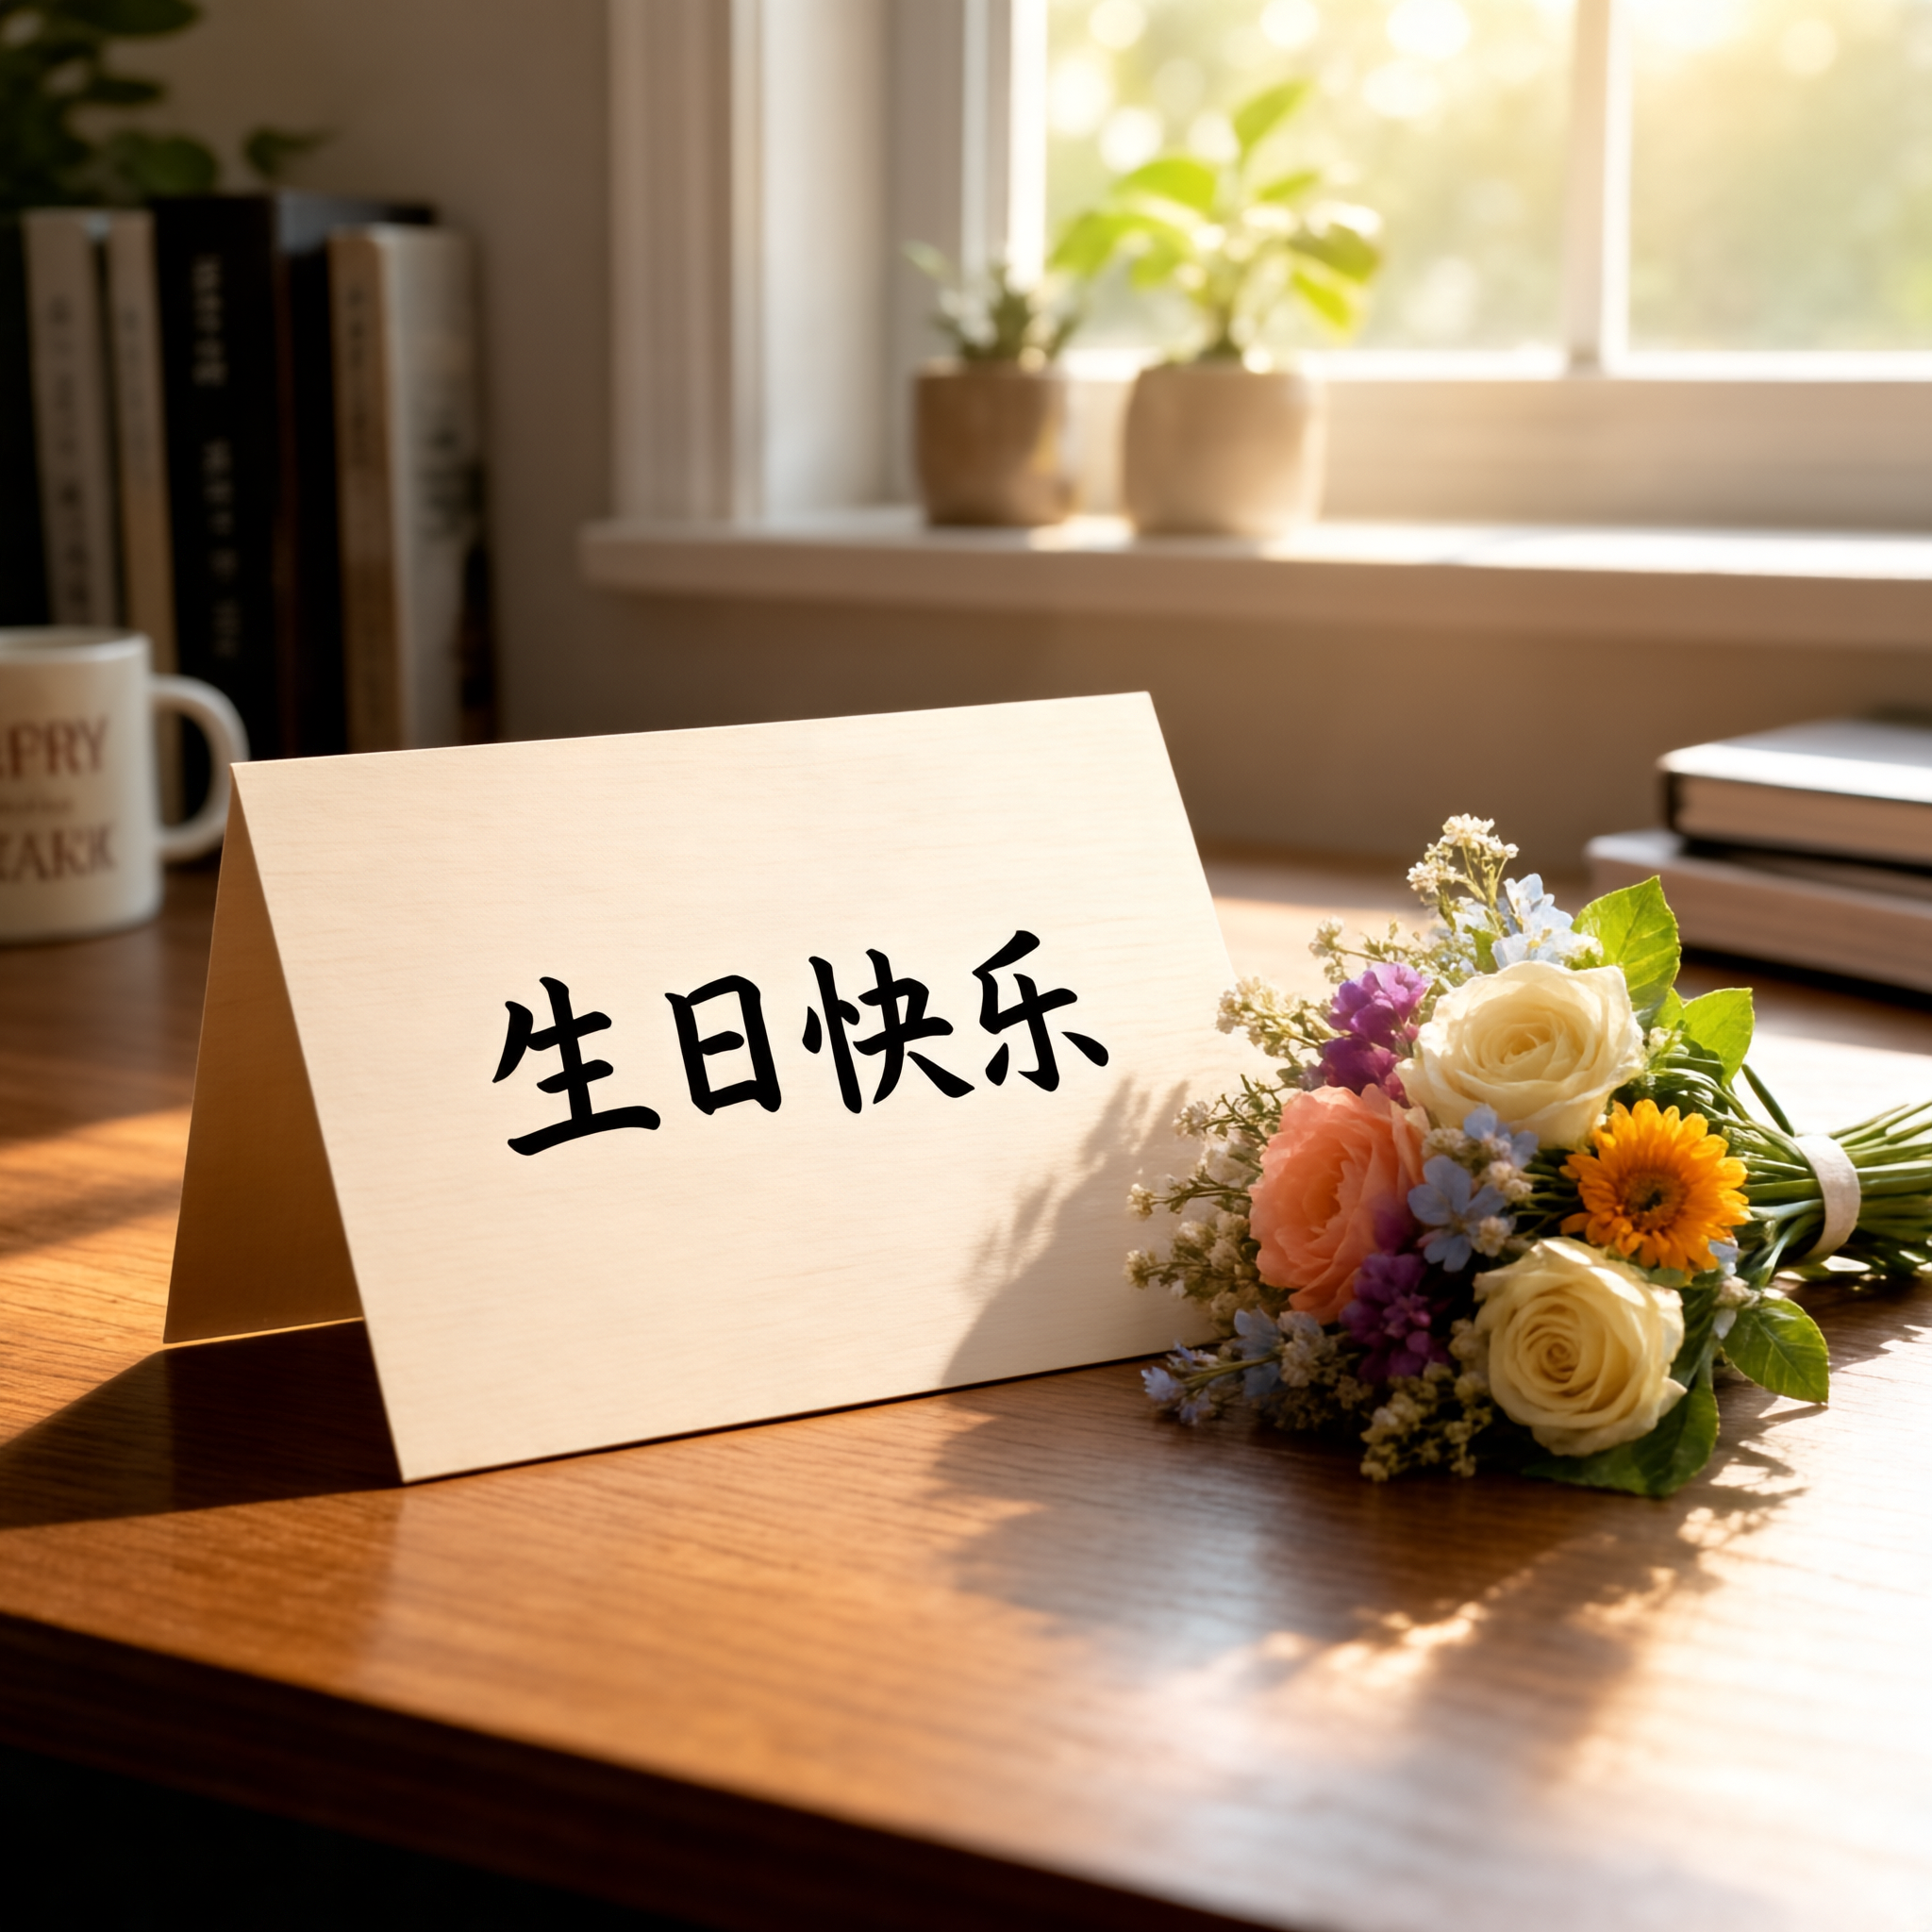
⏱️ 实测数据(分片路线):50 步 2048×2048 模型加载 20.2 s、生成 178.0 s,峰值显存 20.51 GiB(reserved 21.07 GiB),CPU RSS 峰值 19.29 GiB,吞吐 23.0 tok/s;全程可用内存未低于 ~27.5 GiB,swap 几乎未用,32 GB 内存主机安全。
2.6 官方 README 四大示例,在 24 GB 卡上逐条实测
仓库 README「使用 Transformers 快速开始」给了四条命令:文生图、图像编辑、图文交错生成、视觉理解。我把它们逐条在这台 4090 D 上跑了一遍,先说结论:四条都能跑通,但原样照抄跑不了,要改两个地方:
-
所有脚本的默认
--vram_mode full需要 ~35 GB 显存,24 GB 卡必须显式换卸载/分片路线(本机 32 GB 内存用--device_map分片,见 2.5 节); -
默认分辨率就是最大的 2048×2048 桶,首次验证可以换小桶提速,正式出图再用默认。
① 文生图(examples/t2i/inference.py):即上一节的命令(分片路线),顺利出图。
② 图像编辑(examples/editing/inference.py):输入官方样例图 1.webp,把画面中左侧人物的夹克改成亮黄色:
python examples/editing/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --image examples/editing/data/images/1.webp \
    --prompt "Change the jacket of the person on the left to bright yellow." \
    --output outputs/edited.png --vram_mode fast
这个示例第一次跑直接 OOM 了:理解通路(编码原图 + 指令)的注意力峰值把显存顶到 20.58 GiB,还差最后 2.2 GiB 没处放。编辑任务比纯文生图多一段「读原图」的理解前向,激活峰值更高,这是 24 GB 卡跑编辑的共性问题;修正方式是降低 GPU 预算档位或回退 balanced(见 2.9 节)。
③ 图文交错生成(examples/interleave/inference.py):给一个主题,模型自动规划「文字 + 多张配图」,适合做教程、绘本类内容:
python examples/interleave/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --prompt "I want to learn how to cook tomato and egg stir-fry. Please give me a beginner-friendly illustrated tutorial." \
    --resolution "16:9" \
    --output_dir outputs/interleave/ \
    --stem demo \
    --vram_mode fast --profile
④ 视觉理解(examples/vqa/inference.py):拍一张菜单问模型「两人吃饭怎么点菜」,走的是理解通路,不产生图像:
python examples/vqa/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --image examples/vqa/data/images/menu.jpg \
    --question "My friend and I are dining together tonight. Looking at this menu, can you recommend a good combination of dishes for 2 people?" \
    --output outputs/answer.txt \
    --max_new_tokens 8192 --do_sample --temperature 0.6 --top_p 0.95 --top_k 20 \
    --repetition_penalty 1.05 --vram_mode fast --profile
⚠️ 注:以上命令中的
--vram_mode fast是官方低显存路线,适合主机内存 ≥40 GB 的机器;本机 32 GB 内存请一律按 2.5 节换成--device_map分片路线,否则锁页内存打满死机(2.9 节)。这一轮实测也给了我给官方仓库的一条具体建议:README 快速开始应标注低显存用法——四条示例的默认参数都按大显存卡设计,24 GB 及以下用户照抄必 OOM,建议在每条命令旁加注--vram_mode fast/balanced(我会整理成 Issue 提交)。四大示例的逐案例出图效果与耗时细账,留到第三、四章展开。
2.7 8 步蒸馏 LoRA:步数砍到 1/6
官方 8 步 LoRA 是 flow-matching 蒸馏权重,使用方式 = 基线权重 + 合并 LoRA + 换一组超参(CFG 必须降到 1.0):
python examples/t2i/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --lora_path ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs/SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \
    --prompt 'A wooden greeting card lying on a desk, with readable Chinese text "生日快乐" written on it, a small bouquet of flowers beside it, soft morning sunlight through the window, photorealistic, high detail.' \
    --output outputs/smoke_8step_2048.png \
    --width 2048 --height 2048 \
    --cfg_scale 1.0 --cfg_norm none --timestep_shift 3.0 --num_steps 8 \
    --seed 42 --attn_backend sdpa --profile \
    --device_map auto --max_memory "0=20GiB,cpu=16GiB"
同 Prompt、同 Seed、同分辨率的对比:
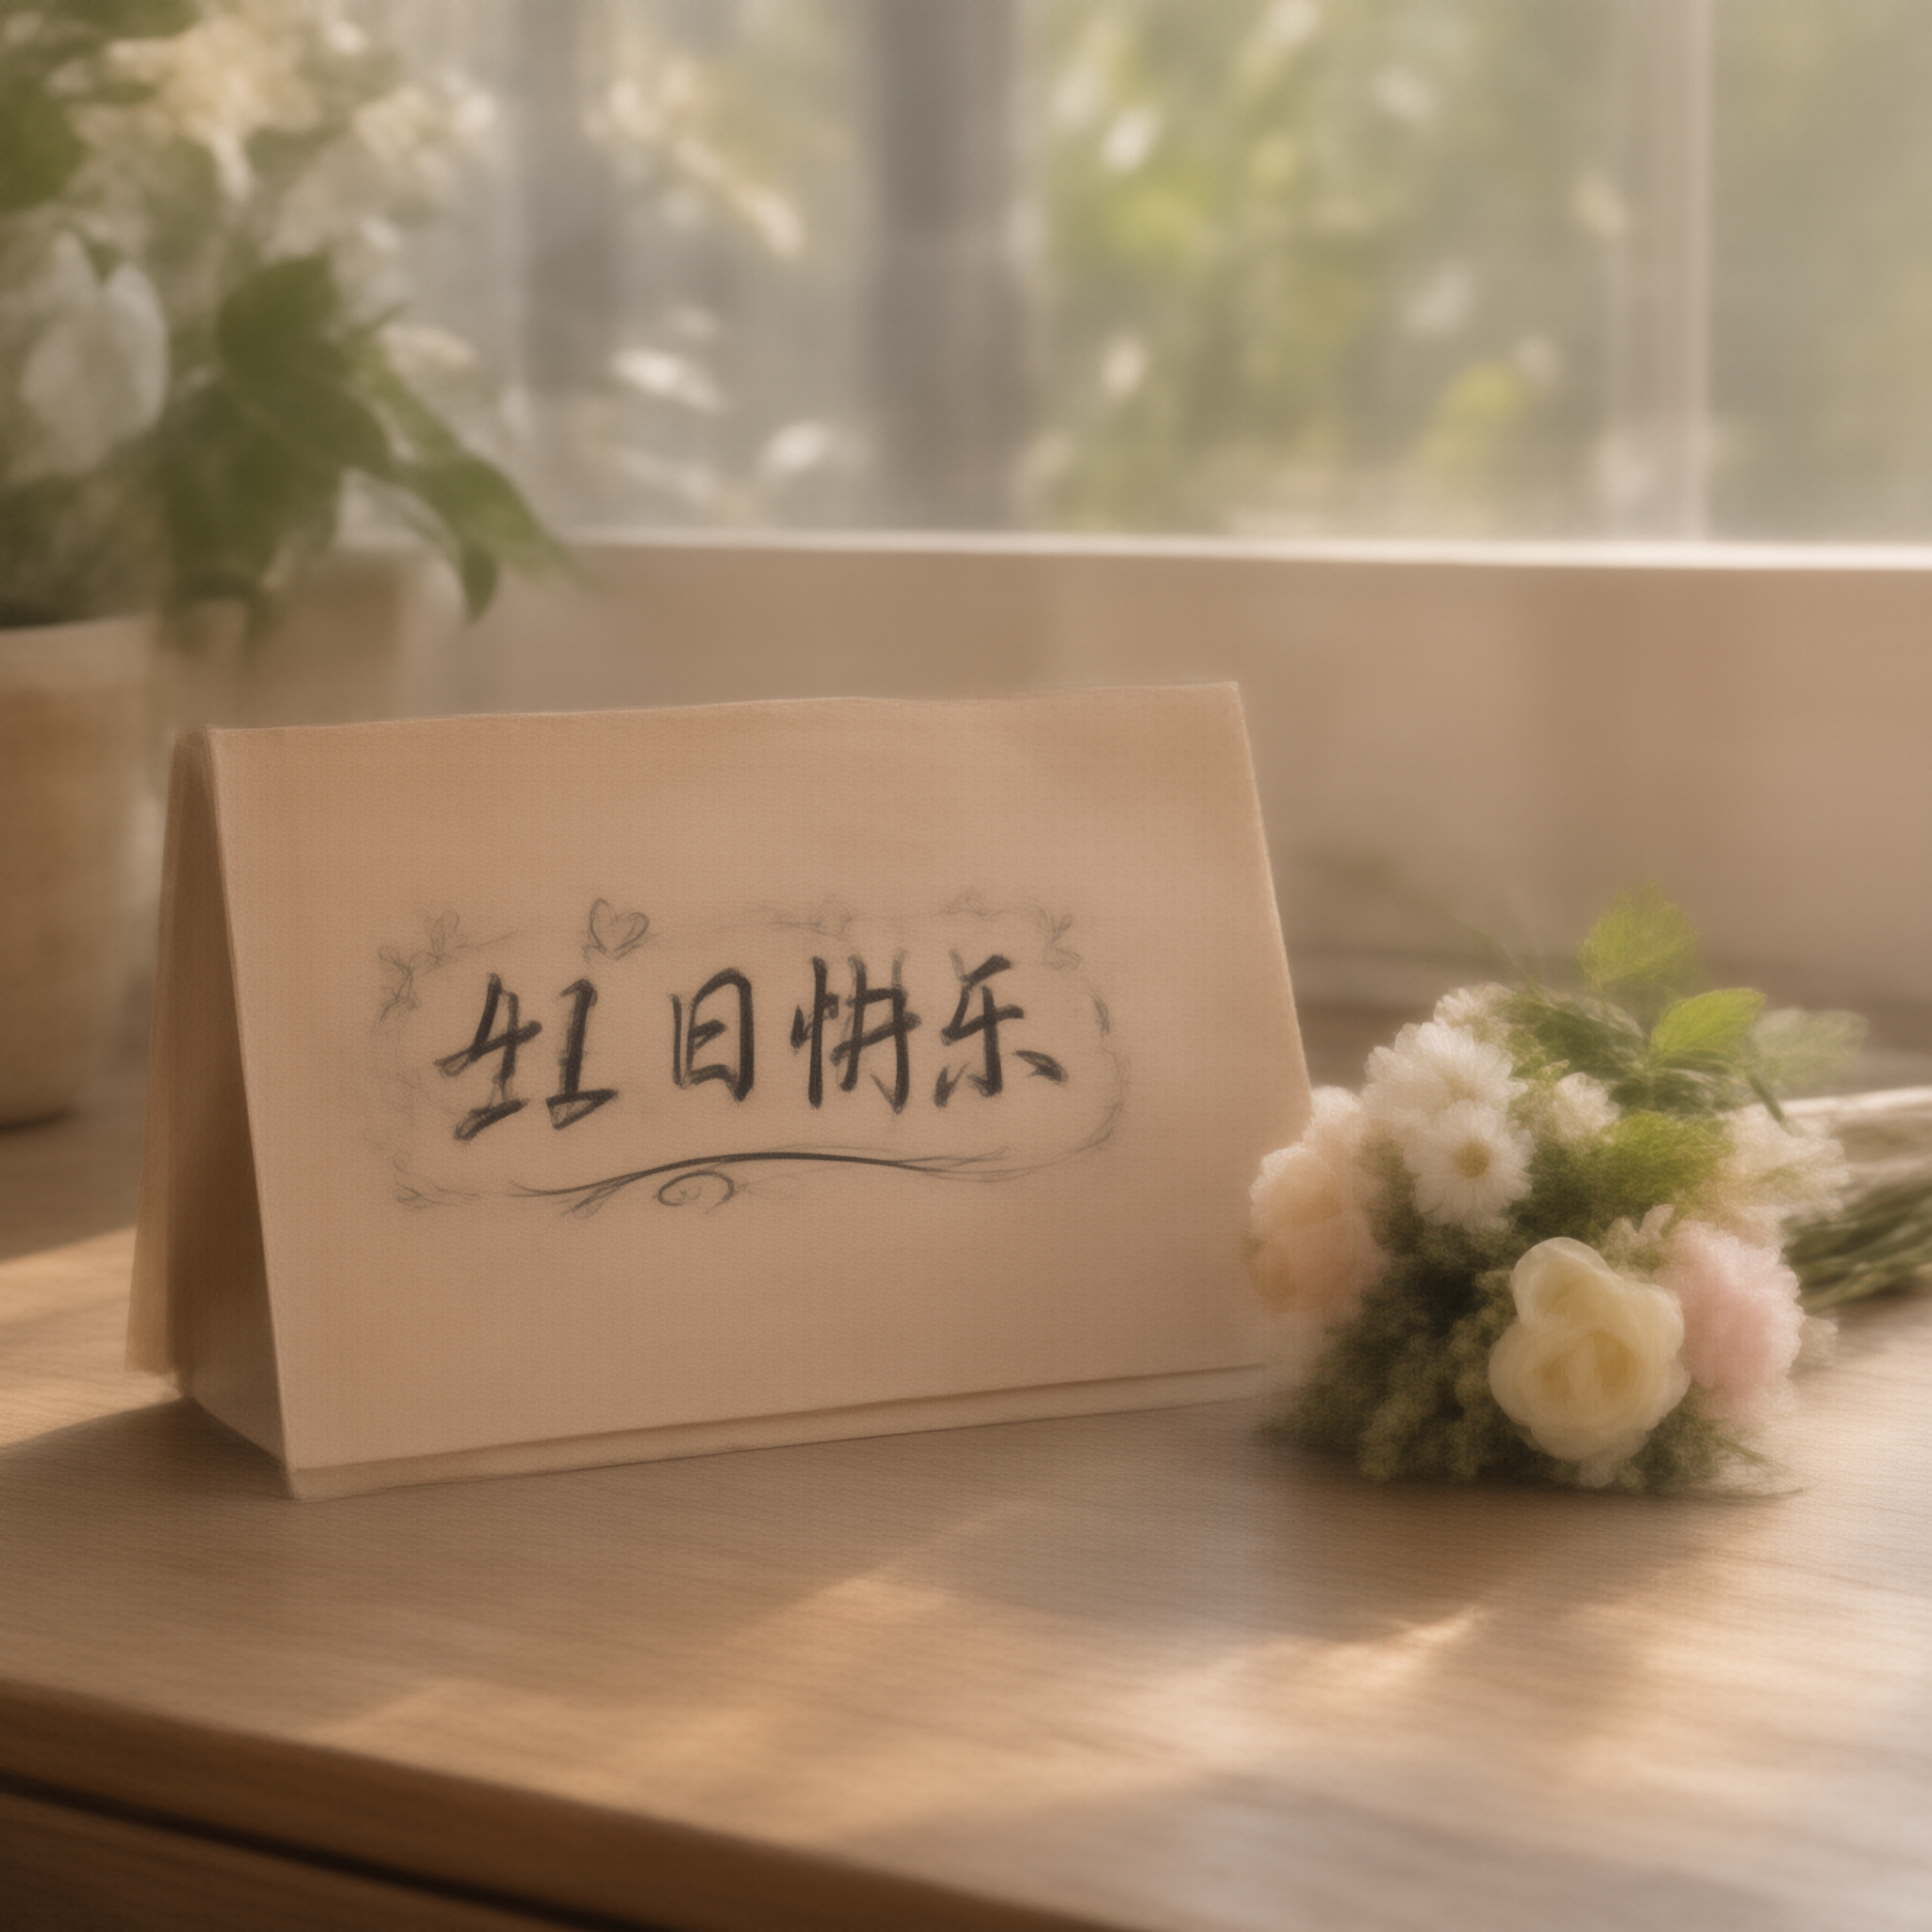
| 维度 | 50 步基线 | 8 步蒸馏 | 说明 |
|---|---|---|---|
| 采样步数 | 50 | 8 | 蒸馏 LoRA 官方配置 |
| CFG | 4.0 | 1.0 | 蒸馏后无需强引导,CFG=1 还能省一半前向 |
| 生成耗时 | 178.0 s | 26.7 s | 同机同参实测(--profile),端到端 6.7× |
| 峰值显存 | 20.51 GiB | 19.80 GiB | 步数不影响显存峰值,两者接近;CPU RSS 均 ~19.3 GiB |
| 画质观感 | 细节最完整 | 整体一致,极细纹理略软 | 见对比图,中文「生日快乐」两者均渲染正确 |
加速原理算笔账:8 步模式的提速来自两方面——步数 50→8(约 6.25×),以及 CFG 4.0→1.0 后每步不再做双份前向(CFG 需要同时算条件/无条件分支)。把两笔账合起来算 NFE(网络前向次数):50 步 × 2(CFG 双分支)= 100 次前向,对比 8 步 × 1 = 8 次前向,理论计算量之比是 12.5×;实际端到端达不到这个倍数,因为还有权重搬运、调度与图像解码等固定开销,且分片模式下 PCIe 带宽是共同瓶颈,但方向一致。
使用建议:对批量出图、API 服务、快速试 Prompt 的场景,8 步 LoRA 应作为默认配置;最终交付图再切回 50 步。另一个容易踩的坑是沿用 50 步的 CFG=4.0 跑蒸馏权重——画面会明显过饱和甚至崩坏,蒸馏权重的 CFG 就固定 1.0。
2.8 推理超参调优手册
把 inference.py 的超参空间整理成一张速查表:
| 参数 | 默认 | 可选值 | 调优建议 |
|---|---|---|---|
--cfg_scale |
4.0 | float | 基线模型 3.5~5.0;过高会过饱和、构图僵硬;8 步 LoRA 固定 1.0 |
--cfg_norm |
none | none / global / channel / cfg_zero_star | CFG 偏高出现色彩溢出时,用 global/channel 把输出拉回条件分支的范数 |
--timestep_shift |
3.0 | float | flow-matching 时间表偏移,高分辨率可适当调大,一般不动 |
--cfg_interval |
0 1 | LO HI | 只在部分步数区间施加 CFG,可缓解后期细节被 CFG「拽变形」 |
--num_steps |
50 | int | 50 为质量基线;8 配蒸馏 LoRA |
--seed |
42 | int | 复现与 A/B 对比必固定 |
--attn_backend |
auto | auto / flash / sdpa | 没装 flash-attn 就显式 sdpa,日志里会打印 effective 值便于确认 |
--think |
off | flag | T2I 推理模式:先输出 <think> 思考块再出图,复杂构图任务有增益,耗时增加 |
--enhance |
off | flag | 短 Prompt 先过一遍 LLM 增强(配 U1_ENHANCE_* 环境变量),信息图类任务推荐 |
两个常用变体示例:
# 变体 A:思考模式 + Prompt 增强(复杂海报/信息图) python examples/t2i/inference.py \ --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \ --prompt "一张介绍太阳系八大行星的中文信息图" \ --output outputs/think_demo.png --width 2048 --height 2048 \ --cfg_scale 4.0 --num_steps 50 --vram_mode fast \ --think --print_think --enhance # 变体 B:批量跑官方样例(jsonl 模式,每条可自带宽高/seed) python examples/t2i/inference.py \ --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \ --jsonl examples/t2i/data/samples.jsonl \ --output_dir outputs/u1_5_base/ \ --cfg_scale 4.0 --cfg_norm none --timestep_shift 3.0 --num_steps 50 \ --vram_mode fast --profile
2.9 低配显卡生存指南(量化 · 显存卸载)
这是本章最有复用价值的一节。先看问题本质:
BF16 全量权重 = 17.533B × 2 byte ≈ 35.1 GB > 24 GB(RTX 4090 D)
所以「全量上卡」(--vram_mode full)需要 ~35 GB 显存(H100/A100-40G+ 级别)。24 GB 及以下必须走下面三条路之一。
2.9.1 路线一:--vram_mode 分层卸载(官方原生,零额外依赖)
原理:权重常驻 CPU 内存,按层流式搬上 GPU;fast 模式额外把生成阶段的热层留在显存预算内,用异步预取重叠 H2D 与计算。官方在 H100 上的实测(2048×2048、50 步、BF16、SDPA):
--vram_mode |
策略 | 生成峰值显存 (GiB) | 平均耗时 (s) | 吞吐 (tok/s) |
|---|---|---|---|---|
full |
整模型常驻 GPU(默认) | 34.79 / 35.72 | 20.9 | 196.0 |
fast |
异步预取 + 生成层常驻显存预算内 | 19.68 / 20.41 | 22.9 | 179.3 |
balanced |
异步预取,H2D 与计算重叠 | 5.68 / 9.34 | 31.5 | 130.2 |
low |
每层同步 CPU↔GPU 交换 | 4.96 / 5.53 | 51.5 | 79.5 |
(表格来源:仓库 docs/gpu_mem_profiler_CN.md,四种模式输出图像逐像素一致)
补充一点机制说明,方便按需调参:四种模式在数学上完全等价(同一套权重、同一个采样器),差异只在权重存放位置与搬运时机——balanced 用 pinned memory + 异步 H2D 让搬运与计算重叠,fast 更进一步在显存预算内把生成阶段反复访问的热层钉在 GPU 上,只有冷层参与搬运,所以它相对 full 只损失 ~10% 速度。「输出逐像素一致」意味着你可以先用 low 模式在小显卡上验证流程与超参,再在资源充足时切回 fast/full 提速,不用担心结果漂移,这对调参工作流非常友好。相关微调参数:--fast_vram_fraction(默认 0.90)、--fast_vram_headroom_gib(默认 2)、--fast_activation_reserve_gib(默认 4)、--fast_vram_budget_gib(绝对预算,优先级最高)。
⚠️ 32 GB 内存主机警告:以上四档的代价是全部层权重被钉在不可换页的锁页内存——本机实测仅
language_model.model.layers就占 30.19 GiB,锁页既不能 swap 也不能被内核回收,主机内存必须 ≥ ~40 GB,否则 OOM/死机(本机实测:fast尝试卡死在 pinning 阶段,回退脚本被 OOM kill)。32 GB 内存主机请走路线二(--device_map分片)或路线三(GGUF),本文全部实测命令均为路线二。
# 8 GB 显存极限生存示例
python examples/t2i/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --prompt "..." --output outputs/low_vram.png \
    --width 2048 --height 2048 --cfg_scale 4.0 --num_steps 50 \
    --vram_mode low --attn_backend sdpa --profile
2.9.2 路线二:--device_map + --max_memory 显存预算约束
用 Accelerate 把模型按层切到「GPU + CPU」,显式给 GPU 设预算(建议比物理显存低 3~4 GB 留余量):
python examples/t2i/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --prompt "..." --output outputs/budget.png \
    --cfg_scale 4.0 --num_steps 50 \
    --device_map auto --max_memory "0=20GiB,cpu=80GiB" --profile
官方按此方法模拟各档显卡的数据(50 步 2048×2048):
| GPU 预算 | 目标显卡 | 生成峰值显存 (GiB) | CPU 内存 (GiB) | 平均耗时 (s) | 吞吐 (tok/s) |
|---|---|---|---|---|---|
| 27 GiB | RTX 5090 (32 GB) | 27.76 | 10.3 | 87.7 | 46.7 |
| 20 GiB | RTX 4090 (24 GB) | 20.58 | 19.5 | 175.0 | 23.4 |
| 13 GiB | RTX 4080 (16 GB) | 13.39 | 24.1 | 250.8 | 16.3 |
| 9 GiB | RTX 4070 (12 GB) | 9.79 | 28.8 | 290.0 | 14.1 |
| 7 GiB | RTX 4060 (8 GB) | 7.64 | 28.8 | 316.3 | 13.0 |
注意 max_memory 路线因为切得更碎,比 vram_mode fast 慢(175 s vs 23 s 级别,H100 口径)——内存充足的主机上单卡优先 --vram_mode,多卡才用 --device_map。CPU 内存需求:预算越低、驻留 CPU 的权重越多,建议 ≥32 GB 内存。但本结论有一个例外:32 GB 内存主机跑不了 --vram_mode 卸载(30.2 GiB 锁页,见 2.9.1),分片是唯一活路——本机实测 50 步 2048×2048 为 178 s、8 步为 26.7 s,这就是分片的代价。
2.9.3 路线三:GGUF 量化(显存直接砍半)
社区(HF 用户 smthem)维护了 Q8 GGUF 权重(19.9 GB),官方脚本原生支持:
uv pip install "gguf>=0.10.0" "diffusers>=0.30.0"
python examples/t2i/inference.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --gguf_checkpoint /path/to/SenseNova-U1.5-8B-MoT-Q8.gguf \
    --prompt "..." --output outputs/gguf_q8.png \
    --width 2048 --height 2048 --cfg_scale 4.0 --num_steps 50
Q8 权重 19.9 GB + 激活,24 GB 卡可以走 full 模式全量上卡,绕开所有卸载开销,是「显存够不着 35 GB 但够得着 20 GB」场景的另一条快路。更低显存还可以找社区的更低比特量化或等待官方量化发布。
2.9.4 档位速查(建议收藏)
| 你的显存 | 推荐方案 |
|---|---|
| ≥40 GB(A100/H100) | --vram_mode full,性能无损 |
| 24 GB(4090/3090/4090D) | BF16 + --device_map 分片(本文实测,32 GB 内存主机);主机内存 ≥40 GB 可换 --vram_mode fast;或 Q8 GGUF + full |
| 16 GB | --vram_mode balanced 或 Q8 GGUF + fast |
| 12 GB | --vram_mode balanced/low + 降分辨率桶(1536 档) |
| 8 GB | --vram_mode low + 1024/1536 档,或 GGUF 更低比特量化 |
2.10 服务化:FastAPI + systemd 与官方 Docker 方案
2.10.1 自己包一层 FastAPI(24 GB 单卡够用)
推理脚本本身是一次性命令行,想给别的应用调用,最轻的做法是包一层 HTTP。我写了一个单文件 u1_api_server.py(完整代码见附录 C),核心设计只有四点:
-
进程启动时一次性加载模型 + 合并 8 步 LoRA,之后常驻显存,请求零加载开销;
-
全局互斥锁串行生成:24 GB 单卡并发出图必 OOM,锁是最简单可靠的保护;
-
请求体只需
prompt,宽高/步数/CFG/seed 均可选,缺省用 8 步蒸馏配置; -
返回 base64 PNG + 耗时/参数元数据,前端一行
atob即可渲染。
# 部署机上安装依赖并启动
uv pip install --python ~/SenseNova/.venv/bin/python fastapi uvicorn
~/SenseNova/.venv/bin/python ~/SenseNova/SenseNova-U1-GitHub/u1_api_server.py \
    --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
    --lora_path  ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs/SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \
    --vram_mode fast --num_steps 8 --cfg_scale 1.0 --port 8000
⚠️ 32 GB 内存主机注意:
--vram_mode fast同样会触发锁页内存打满(2.9.1 节)。给u1_api_server.py增加--device_map/--max_memory两个透传参数(直接传给SenseNovaU1T2I构造器,附录 C 代码加两行即可)换分片路线后再启动。
用 systemd 托管,开机自启、崩溃自动拉起:
# /etc/systemd/system/u1-api.service [Unit] Description=SenseNova-U1.5 T2I API (FastAPI) After=network.target [Service] Type=simple User=q WorkingDirectory=/home/q/SenseNova/SenseNova-U1-GitHub ExecStart=/home/q/SenseNova/.venv/bin/python /home/q/SenseNova/SenseNova-U1-GitHub/u1_api_server.py \ --model_path /home/q/SenseNova/SenseNova-U1.5-8B-MoT \ --lora_path /home/q/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs/SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \ --vram_mode fast --num_steps 8 --cfg_scale 1.0 --port 8000 Restart=on-failure RestartSec=10 [Install] WantedBy=multi-user.target
sudo systemctl daemon-reload && sudo systemctl enable --now u1-api
curl -s http://localhost:8000/health            # 等 status 变 ok
curl -s -X POST http://localhost:8000/v1/images/generations \
    -H "Content-Type: application/json" \
    -d '{"prompt":"A red panda holding a camera, studio lighting","seed":7}' \
    | python3 -c "import sys,json,base64;open('api_out.png','wb').write(base64.b64decode(json.load(sys.stdin)['b64_image']))"
2.10.2 官方 Docker 方案(LightLLM + LightX2V)
多卡或高并发场景,官方推荐 LightLLM + LightX2V 的 Docker 部署(详见仓库 docs/deployment_CN.md),核心是 colocate(理解与生成共享 GPU,单卡友好)与 separate(理解/生成分卡,类似 PD 分离,避免长生成阻塞短理解)两种模式。单卡 24 GB 场景本文的 FastAPI 轻量方案更合适,多卡/高并发再上 LightLLM,这里不展开。
2.11 踩坑清单
踩坑清单
-
内核太新 → 驱动编译失败:24.04 的 7.0 内核算老驱动就是编译不过,直接上最新驱动分支(595 系);
-
忘记装
linux-headers-$(uname -r):.run 安装器静默失败,日志在/var/log/nvidia-installer.log; -
被「8B」命名误导:实际 17.53B / 35.1 GB,不做显存规划直接 OOM;
-
torch 版本与驱动强行对齐:其实驱动向下兼容,595 驱动 + cu128 wheel 是更稳的组合;
-
把
nvidia-smi的 CUDA Version 当成已装 toolkit 版本:那是驱动支持的最高版本,本机 toolkit 以nvcc --version为准(12.8); -
README 示例原样照抄:四个官方示例默认
--vram_mode full,24 GB 卡必 OOM,一律换低显存路线(见 2.6 节实测); -
8 步 LoRA 沿用 50 步的 CFG=4.0:画面明显过饱和/崩坏,蒸馏权重必须
--cfg_scale 1.0; -
任意分辨率出图:出了训练桶质量劣化且脚本会告警,老老实实用官方分辨率桶;
-
下载 33 GB 不做断点准备:用
hf download/ ModelScope 官方 CLI 都有断点续传,别用裸wget拼链接; -
32 GB 内存主机用
--vram_mode卸载:卸载把 30.19 GiB 层权重pin_memory()成锁页,锁页不能 swap,内存瞬间打满死机;32 GB 内存主机请--device_map auto --max_memory "0=20GiB,cpu=16GiB"分片加载(2.9.2 节),峰值显存 ~20.5 GiB、RSS ~19.3 GiB。
2.12 本章小结
-
最小可用组合:驱动 595 + CUDA Toolkit 12.8 + torch cu128 + uv/py3.11 +
--device_map分片加载 + 8 步 LoRA,可直接抄作业(内存 ≥40 GB 主机可换--vram_mode fast提速); -
两个认知坑:「8B」实为 17.53B / 35.1 GB;
nvidia-smi的 CUDA Version 不是 toolkit 版本; -
一个内存坑:32 GB 内存主机别碰
--vram_mode卸载的锁页内存,分片是唯一活路;
部署到此完成:单卡 4090 D 上,50 步基线 178 s、8 步蒸馏 26.7 s 稳定出 2048×2048 图,API 服务常驻待命。
第三章 案例实战 AMD ROCm 部署实战
3.1设备与运行环境
3.1.1. 硬件 / 驱动 / ROCm 一览
| 类别 | 实测值 |
|---|---|
| 操作系统 | Ubuntu 22.04.5 LTS,内核 6.8.0-79-generic(x86_64) |
| CPU | 2 × AMD EPYC 9334 32-Core(共 64 核 / 128 线程) |
| 内存 | 1.0 TiB(free -h 实测可用约 950 GiB) |
| GPU | AMD Radeon PRO W7900(gfx1100,48 GiB / 49136 MiB VRAM) |
| 驱动 | amdgpu 6.14.14,AMD-SMI 26.2.2,VBIOS 00162356 |
| ROCm | 7.2.1(/opt/rocm-7.2.1) |
| Python | 3.10.12 |
| 模型 | SenseNova/SenseNova-U1.5-8B-MoT,经 ModelScope 下载 |
先用 amd-smi 确认驱动与 ROCm 版本:
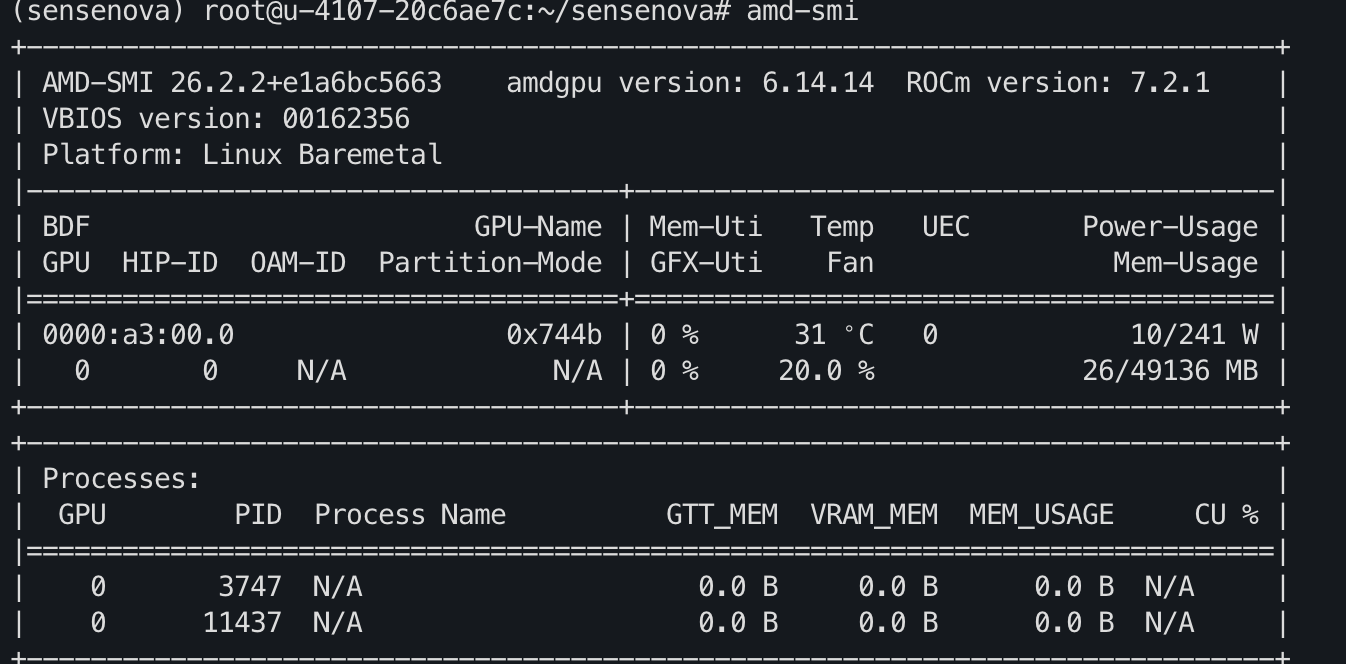
可见:
amdgpu version: 6.14.14、ROCm version: 7.2.1,GPU 为 Radeon PRO W7900(0x744b,49136 MB 显存)。
CPU / 内存概况(free -h + lscpu):
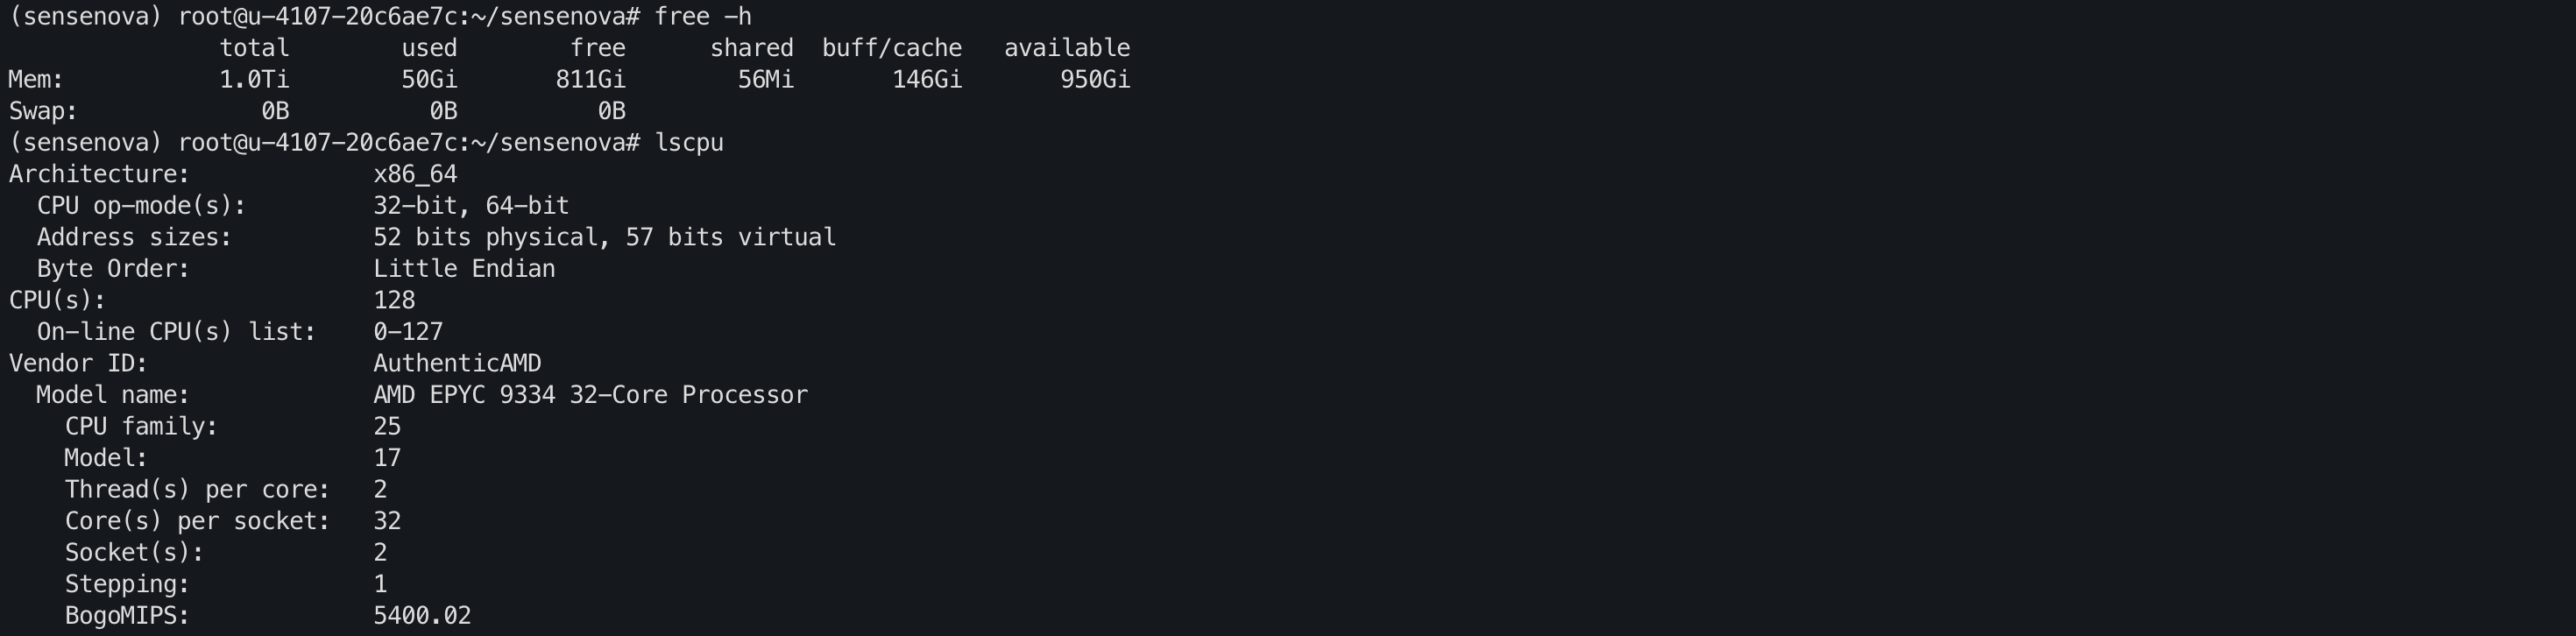
可见:内存 1.0 TiB;CPU 为 2 路 AMD EPYC 9334(每路 32 核 / 64 线程)。
3.1.2. 实测性能(单卡 48 GB,2048×2048)
| 指标 | 数值 |
|---|---|
| 注意力后端 | torch SDPA(未装 flash-attn,--attn_backend auto 自动使用 SDPA) |
| 8 步冒烟生成耗时 | 44.8 s/张(模型加载约 20.1 s,吞吐 91.34 tok/s) |
| 50 步正式生成耗时 | 274.0 s/张(稳态约 5.5 s/步,吞吐 14.95 tok/s) |
| 图像编辑耗时 | 493.2 s/张(吞吐 8.17 tok/s,图像约 4029 token) |
| 生成阶段峰值显存 | allocated 34.87 GiB / reserved 35.82 GiB(CPU RSS 约 14.4 GiB) |
| 运行时 GPU 状态 | 显存约 36.2 GiB / 48 GiB,GFX-Uti ~100%,233/241 W,66 °C |
模型加载完成后开始生成时,用 watch -n 1 amd-smi 观测到的 GPU 状态:
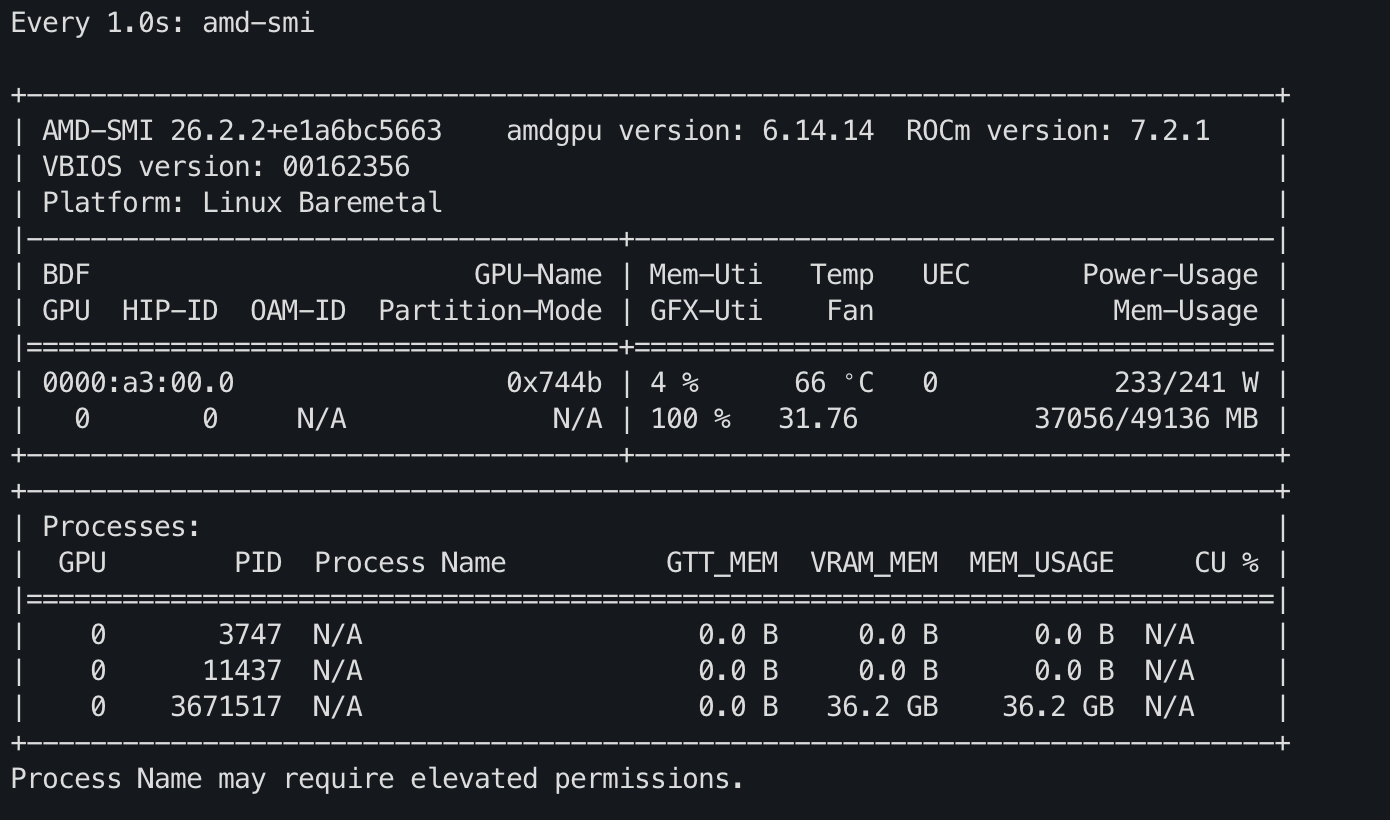
结论:48 GB 单卡可以
--vram_mode full完整跑通 U1.5-8B-MoT 的 2K 生成;更小显存的卡请用--vram_mode balanced/low或 GGUF。
3.2环境安装
3.2.0. 前提
-
ROCm 已安装且驱动正常(
amd-smi/rocm-smi能看到 GPU,见第一节); -
apt/curl等基础工具可用,网络可访问 PyPI 与download.pytorch.org; -
模型已下载到
./SenseNova-U1.5-8B-MoT:
# 方式一:ModelScope
modelscope download --model SenseNova/SenseNova-U1.5-8B-MoT --local_dir ./SenseNova-U1.5-8B-MoT
# 方式二:HuggingFace
huggingface-cli download SenseNova/SenseNova-U1.5-8B-MoT --local-dir ./SenseNova-U1.5-8B-MoT
关于安装方式: 仓库默认把
torch==2.8.0/torchvision==0.23.0固定到 CUDA 12.8 的 index(download.pytorch.org/whl/cu128),仅对 NVIDIA 适用。AMD ROCm 机器要按正常安装步骤重新装 ROCm 版 torch,而不是uv sync直接装 cu128 的 NVIDIA 版。本文用 uv 建独立 venv + 从 ROCm index 装 torch,全程不使用任何系统/其它 venv 的“桥接”。
3.2.1. 安装 uv
# 官方安装脚本(推荐) curl -LsSf https://astral.sh/uv/install.sh | sh source "$HOME/.local/bin/env" # 将 uv 加入 PATH uv --version # 0.12.6 # 或使用 pip # python3 -m pip install -U uv
3.2.2. 创建独立虚拟环境
cd /root/sensenova
uv venv .venv --python 3.10            # 与本机系统 Python 3.10 一致
source .venv/bin/activate
python -V                              # Python 3.10.12
3.2.3. 安装 ROCm 版 torch / torchvision(关键一步)
uv pip install torch torchvision --index-url https://download.pytorch.org/whl/rocm7.2
这一步会用带 HIP 后端的 ROCm 7.2 wheel(
torch... +rocm7.2)替换仓库默认的 CUDA 12.8 版本。装完后确认torch.version.hip非空、torch.cuda.is_available()为 True(见第 6 步验证)。若个别传递依赖在 torch index 上找不到,可追加 PyPI 作为补充源:
uv pip install torch torchvision \
--index-url https://download.pytorch.org/whl/rocm7.2 \
--extra-index-url https://pypi.org/simple
3.2.4. 安装项目本体与其余依赖(正常 uv 流程)
# 以可编辑模式安装项目本体(跳过 torch/torchvision,已由第 3 步提供 ROCm 版) uv pip install -e . --no-deps # 安装其余纯 Python 依赖(与 requirements.txt 中除 torch/torchvision 外的条目一致) uv pip install "transformers>=4.57.1,<6" "accelerate>=1.1,<2" \ "huggingface-hub>=0.34,<2" "safetensors>=0.4.3,<1" "sentencepiece==0.2.1" \ "numpy>=1.24,<3" "pillow==12.0.0" "tqdm==4.67.1" "packaging==25.0" "httpx>=0.27,<1"
为什么
--no-deps:pyproject.toml把torch==2.8.0/torchvision==0.23.0固定到 cu128 index,直接带依赖安装会被拉回 NVIDIA 版 torch 并覆盖 ROCm 版;所以项目本体用--no-deps,剩余纯 Python 依赖单独正常安装。若想省去手写依赖,也可直接从
requirements.txt排除 torch 两行后安装:uv pip install -r <(grep -vE '^(torch|torchvision|--|#|$)' requirements.txt)
3.2.5.(可选)GGUF 低显存扩展
uv pip install "gguf>=0.10.0" "diffusers>=0.30.0"
3.2.6. 验证环境
python -c "
import torch, sensenova_u1
print('torch:', torch.__version__, '| hip:', torch.version.hip)
print('cuda available:', torch.cuda.is_available(), '| devices:', torch.cuda.device_count())
x = torch.randn(1024, 1024, device='cuda', dtype=torch.bfloat16)
print('bf16 matmul OK:', float((x @ x).sum()))
"
预期输出(节选):
torch: 2.9.x+rocm7.2.y | hip: 7.2.xxxxx
cuda available: True | devices: 1
bf16 matmul OK: ...
ROCm index 提供多个版本(如 2.9.x / 2.11 / 2.12),具体
torch.__version__以后缀+rocm7.2...、torch.version.hip为7.2...即可判断正确;cuda available在 ROCm 下也会显示为 True(HIP 兼容 CUDA 运行时命名空间),属预期。
3.3运行推理示例
所有示例统一用 .venv 的 Python 启动(source .venv/bin/activate 后直接用 python,或直接用 .venv/bin/python);--model_path 指向本地模型目录。公共参数:
| 参数 | 建议值 | 说明 |
|---|---|---|
--attn_backend |
auto(默认)或 sdpa |
ROCm 上未装 flash-attn 时自动回退 SDPA,无需改动 |
--dtype |
bfloat16(默认) |
gfx1100 原生支持 bf16 |
--num_steps |
50(默认) | 冒烟测试可设 8 快速验证流程 |
--cfg_scale |
4.0(默认) | 8-step 蒸馏 LoRA 才用 1.0 |
--profile |
建议开启 | 打印耗时与峰值显存 |
3.3.1. 文生图(t2i)
8 步冒烟测试:
python examples/t2i/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
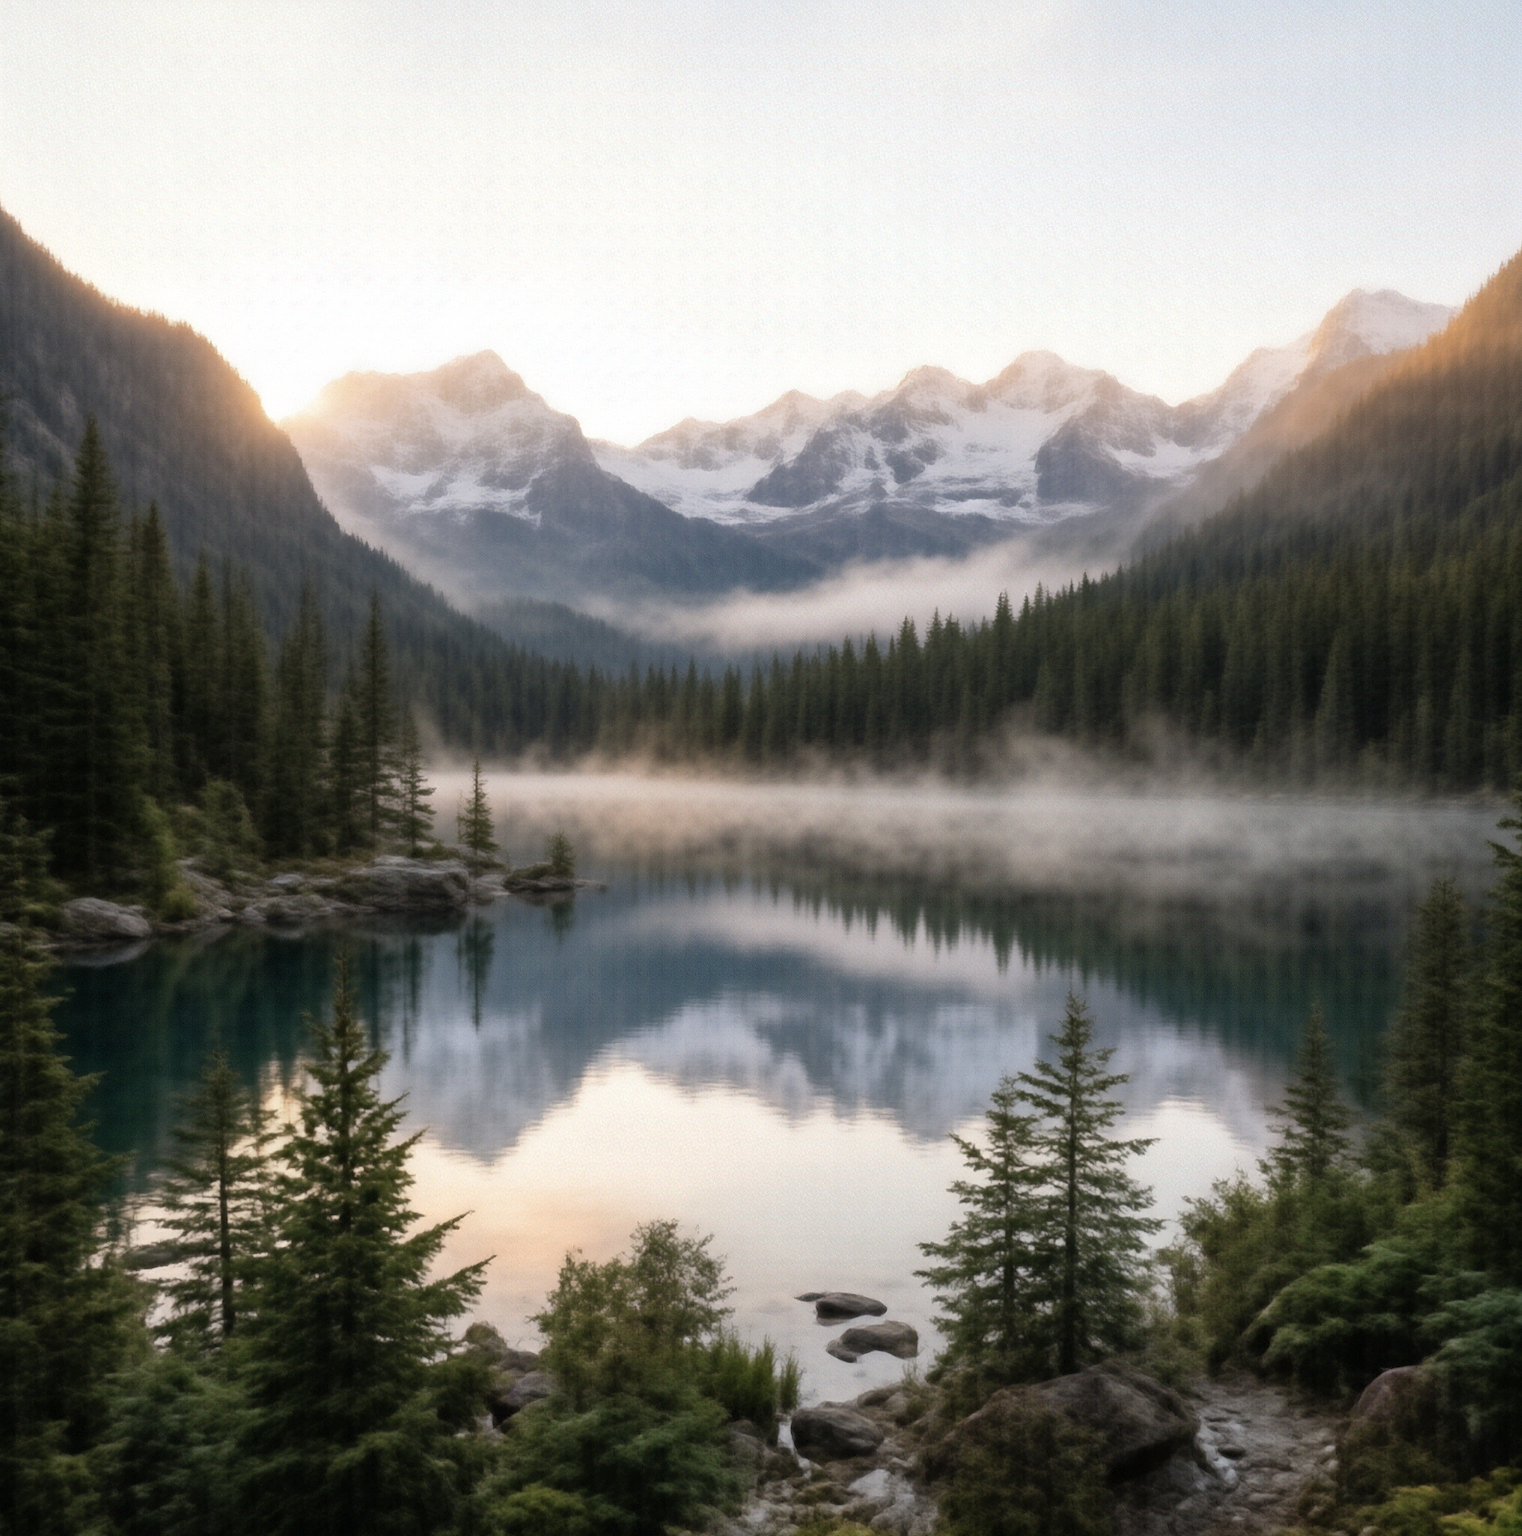
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --output outputs/rocm_smoke.png \
  --num_steps 8 --profile
终端输出:模型加载约 20.1 s、8 步生成 44.8 s、吞吐 91.34 tok/s。
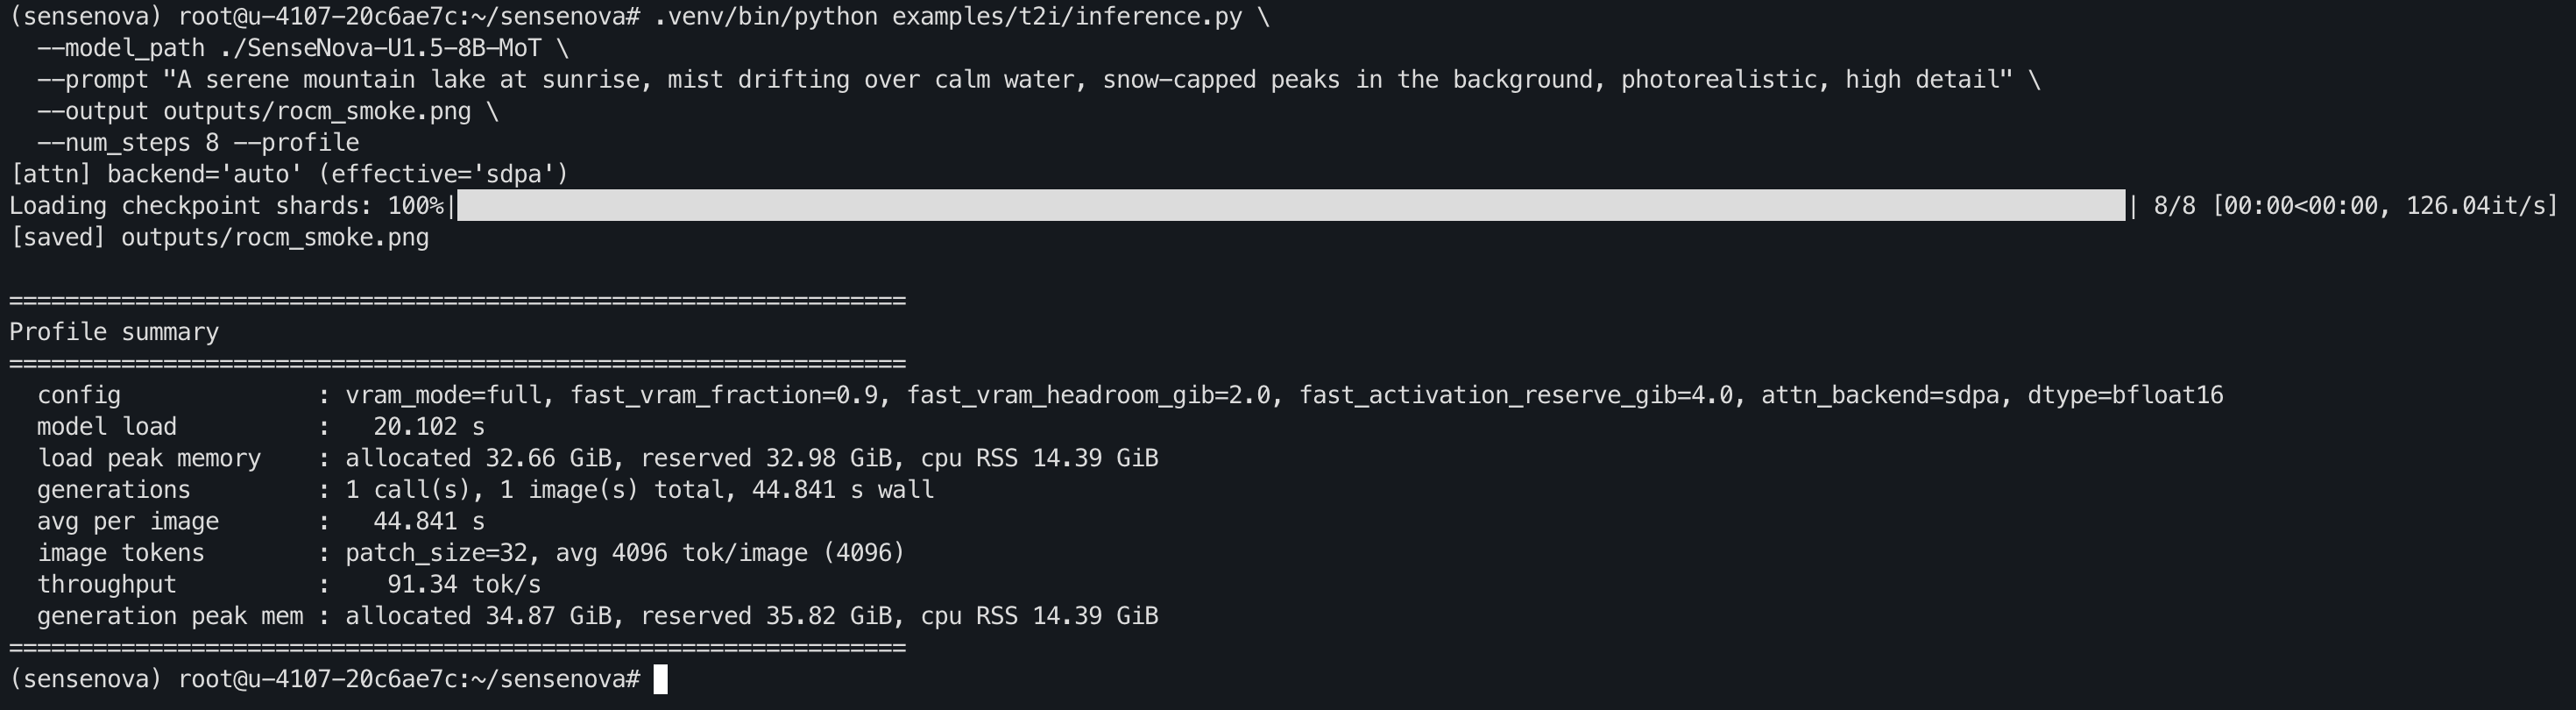
生成结果(outputs/rocm_smoke.png,2048×2048):
50 步正式生成(默认 2048×2048,约 4.6 分钟):
python examples/t2i/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --output outputs/rocm_full50.png \
  --num_steps 50 --profile
终端输出:50 步生成 274.0 s、吞吐 14.95 tok/s、生成阶段峰值显存 allocated 34.87 GiB / reserved 35.82 GiB。
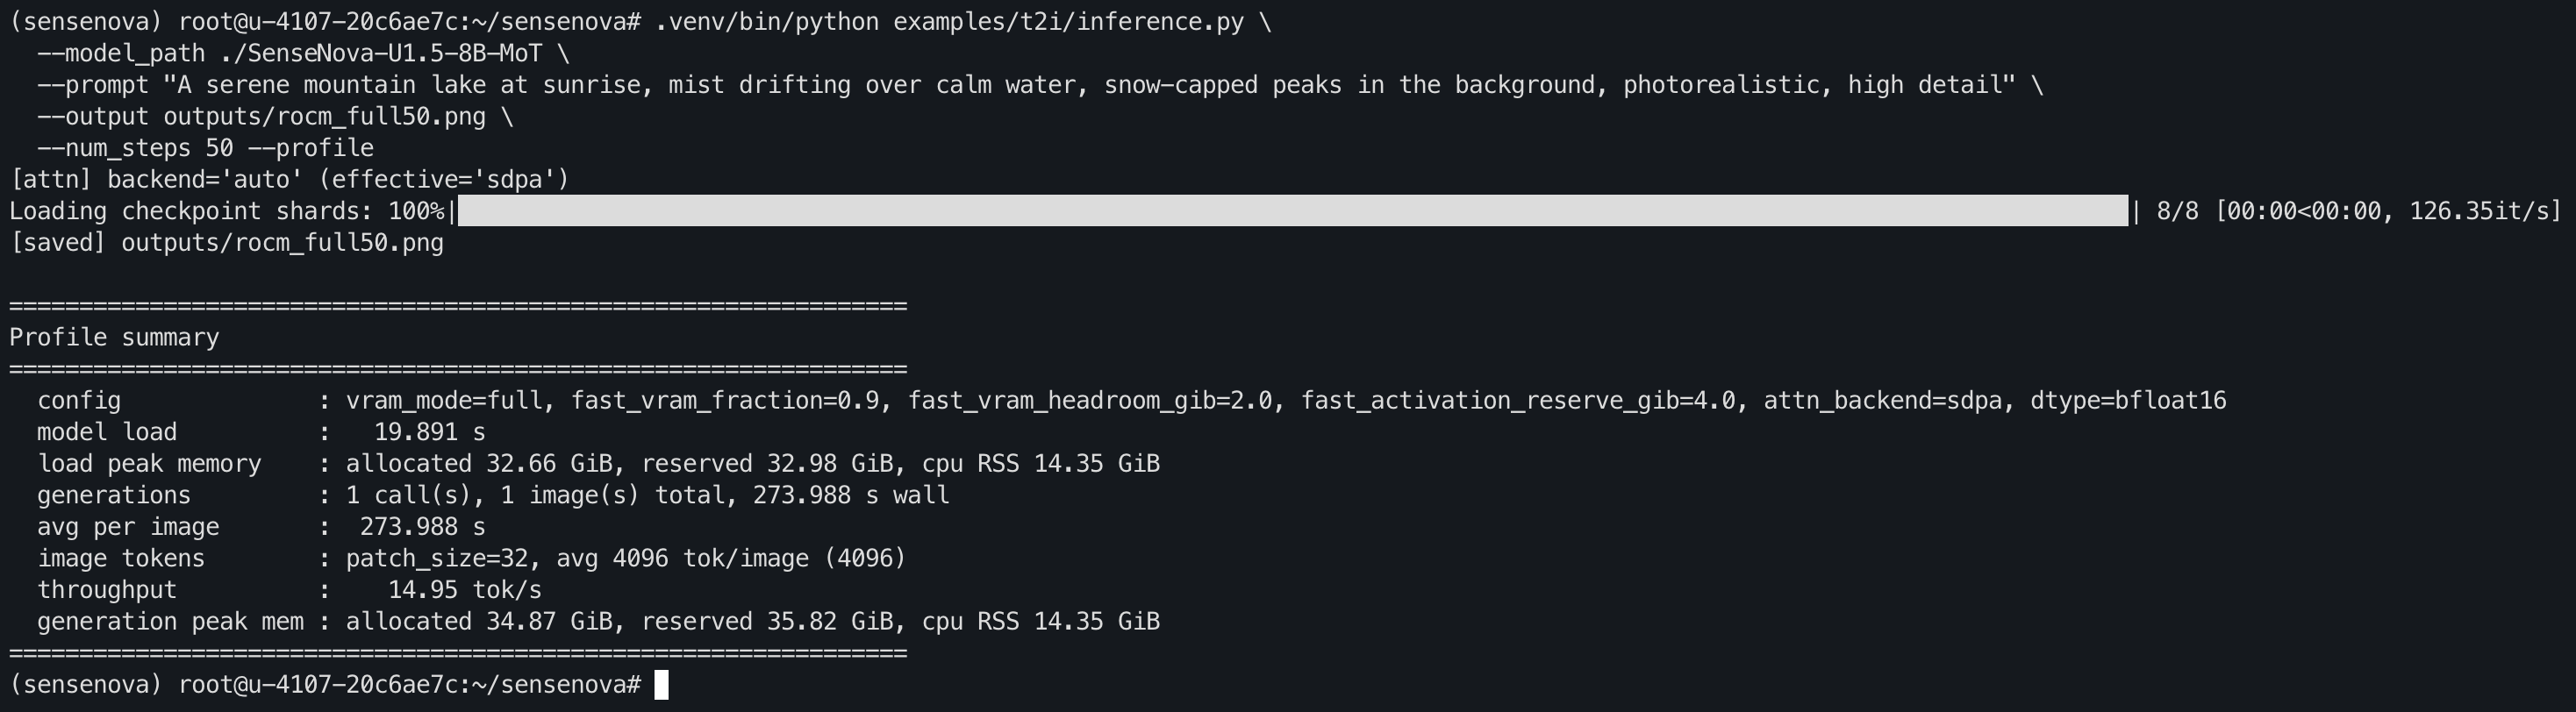
生成结果(outputs/rocm_full50.png,2048×2048):
批量 / 其他分辨率(训练档位见 examples/README_CN.md,如 16:9 → 2720×1536);带推理的 think 模式可追加 --think --print_think。
3.3.2. 视觉理解(VQA)
python examples/vqa/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --image examples/vqa/data/images/image1.jpg \
  --question "Describe the image content."
模型会先输出 think 推理再给出描述,实测可正常识别画面主体(城堡、光线、前景等):
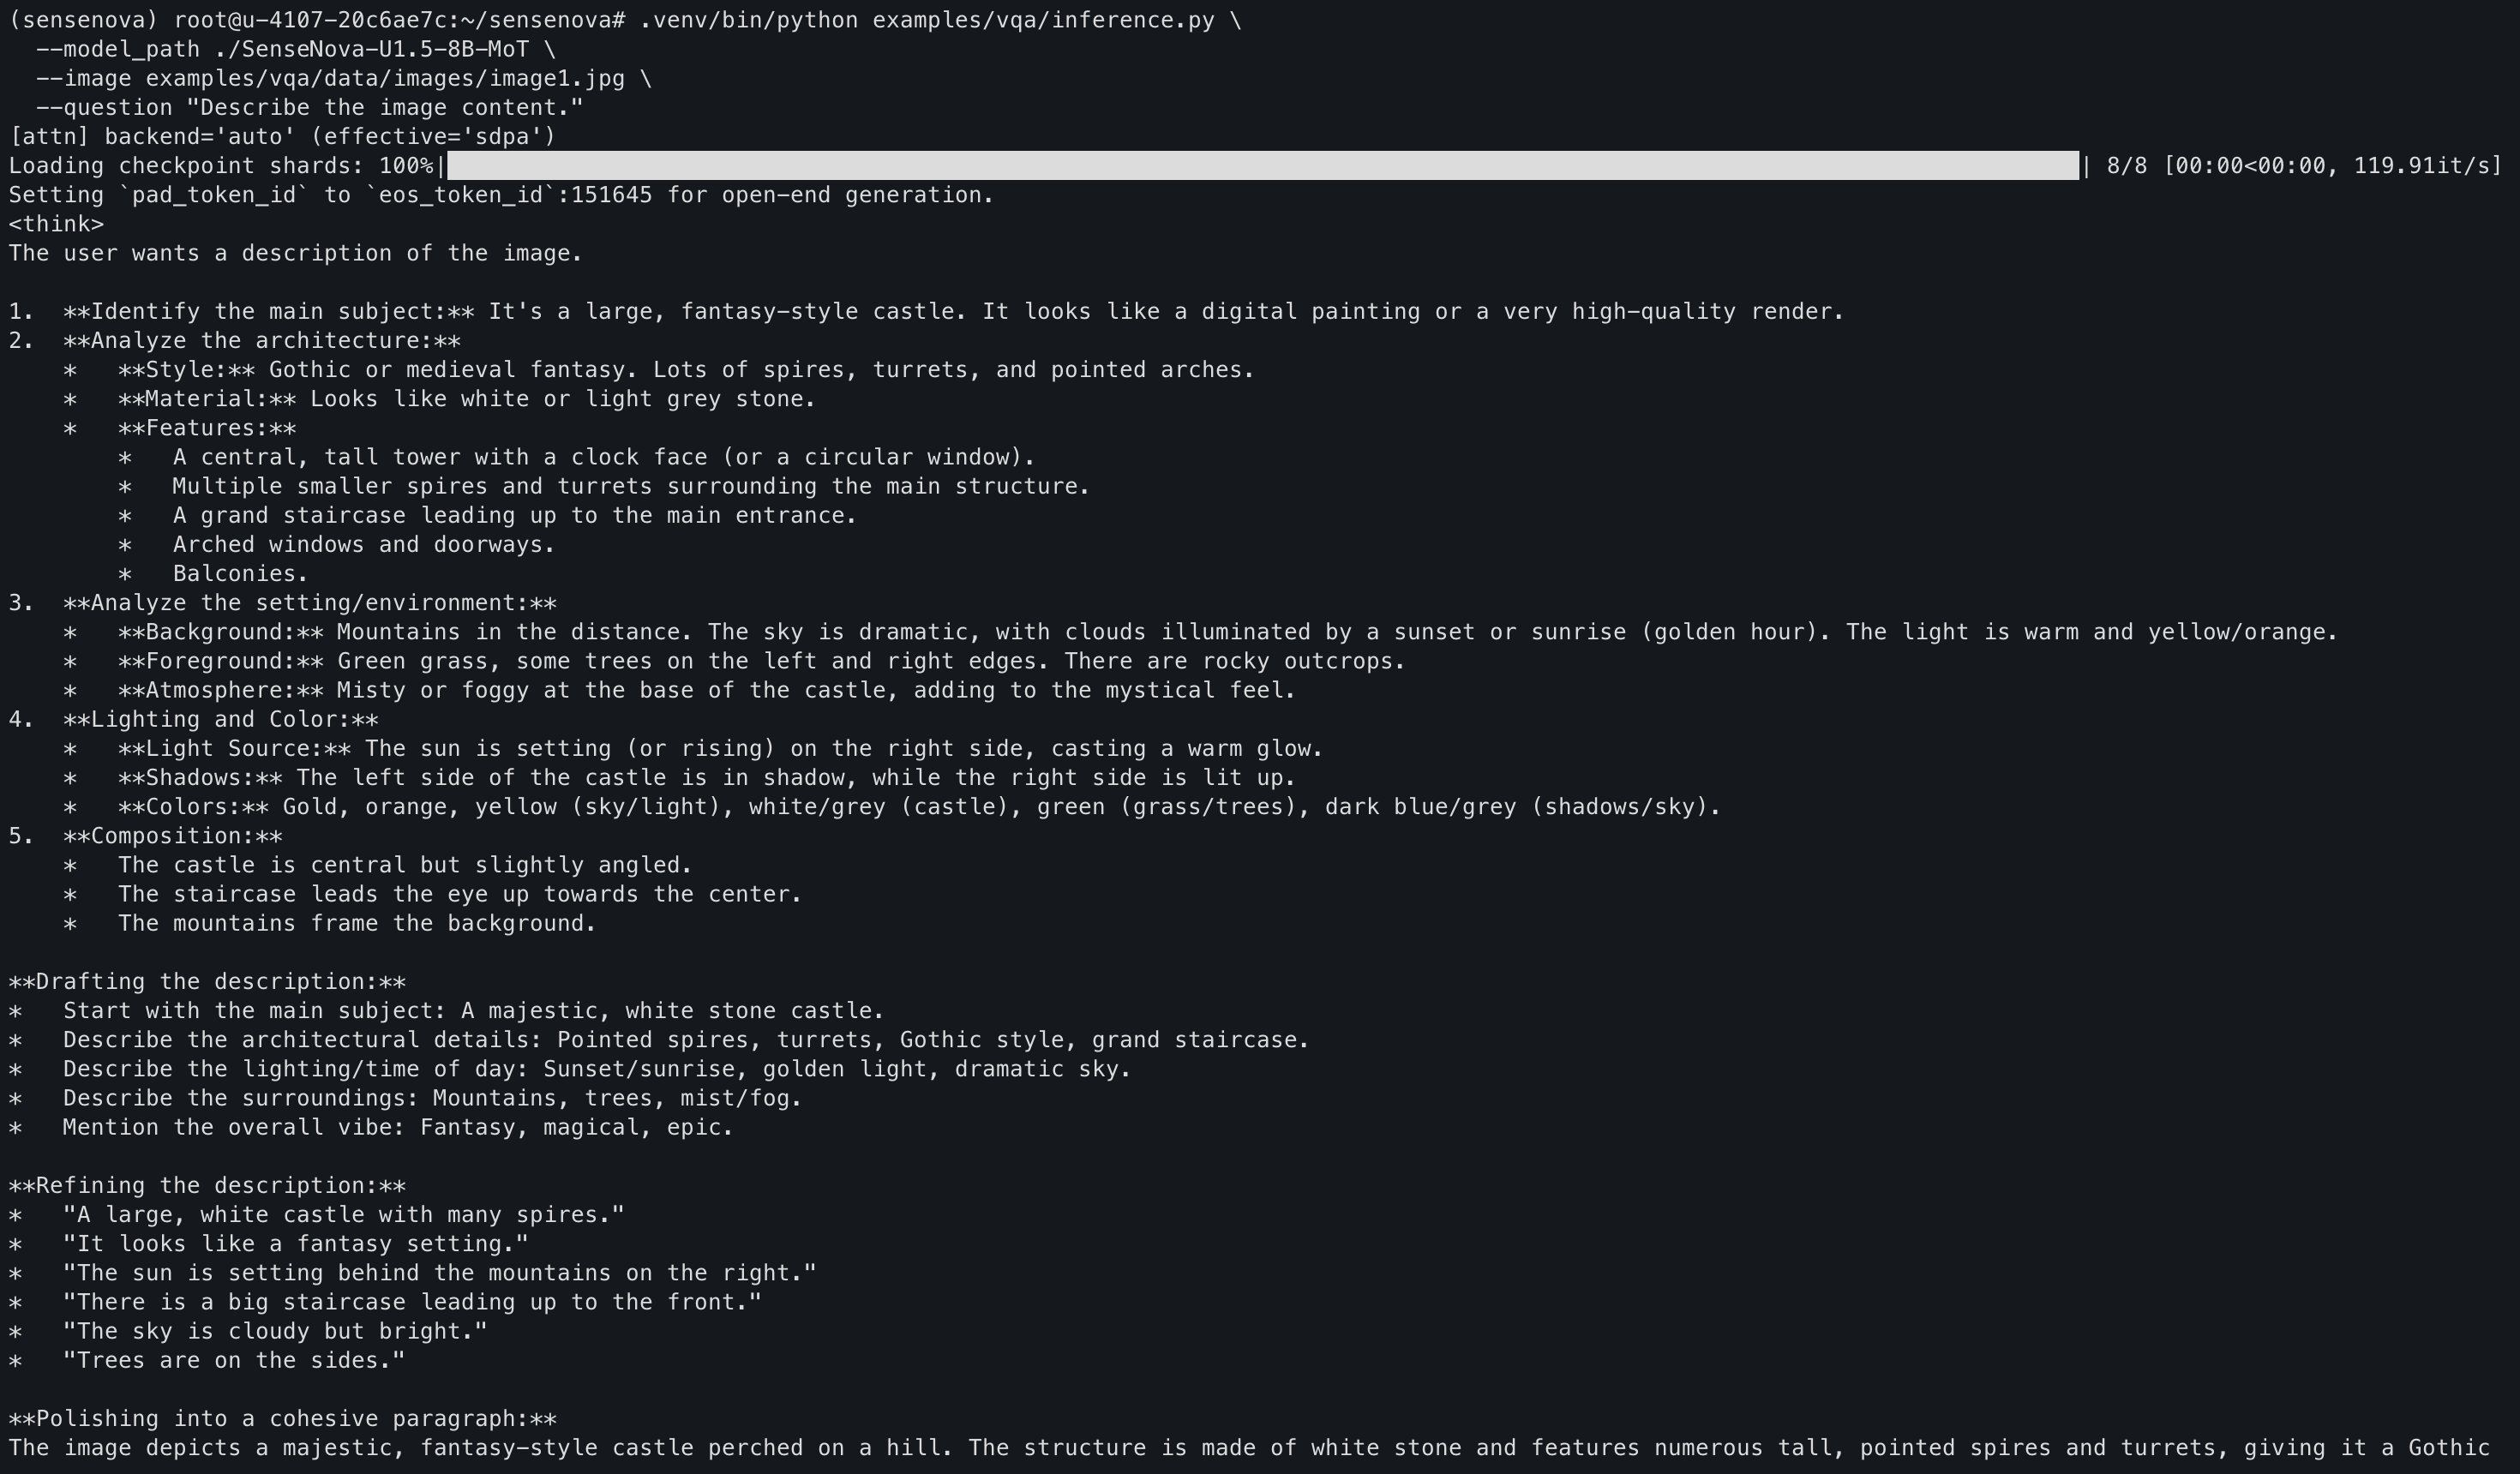
批量:--jsonl examples/vqa/data/samples.jsonl --output_dir outputs/vqa/。
3.3.3. 图像编辑(editing)
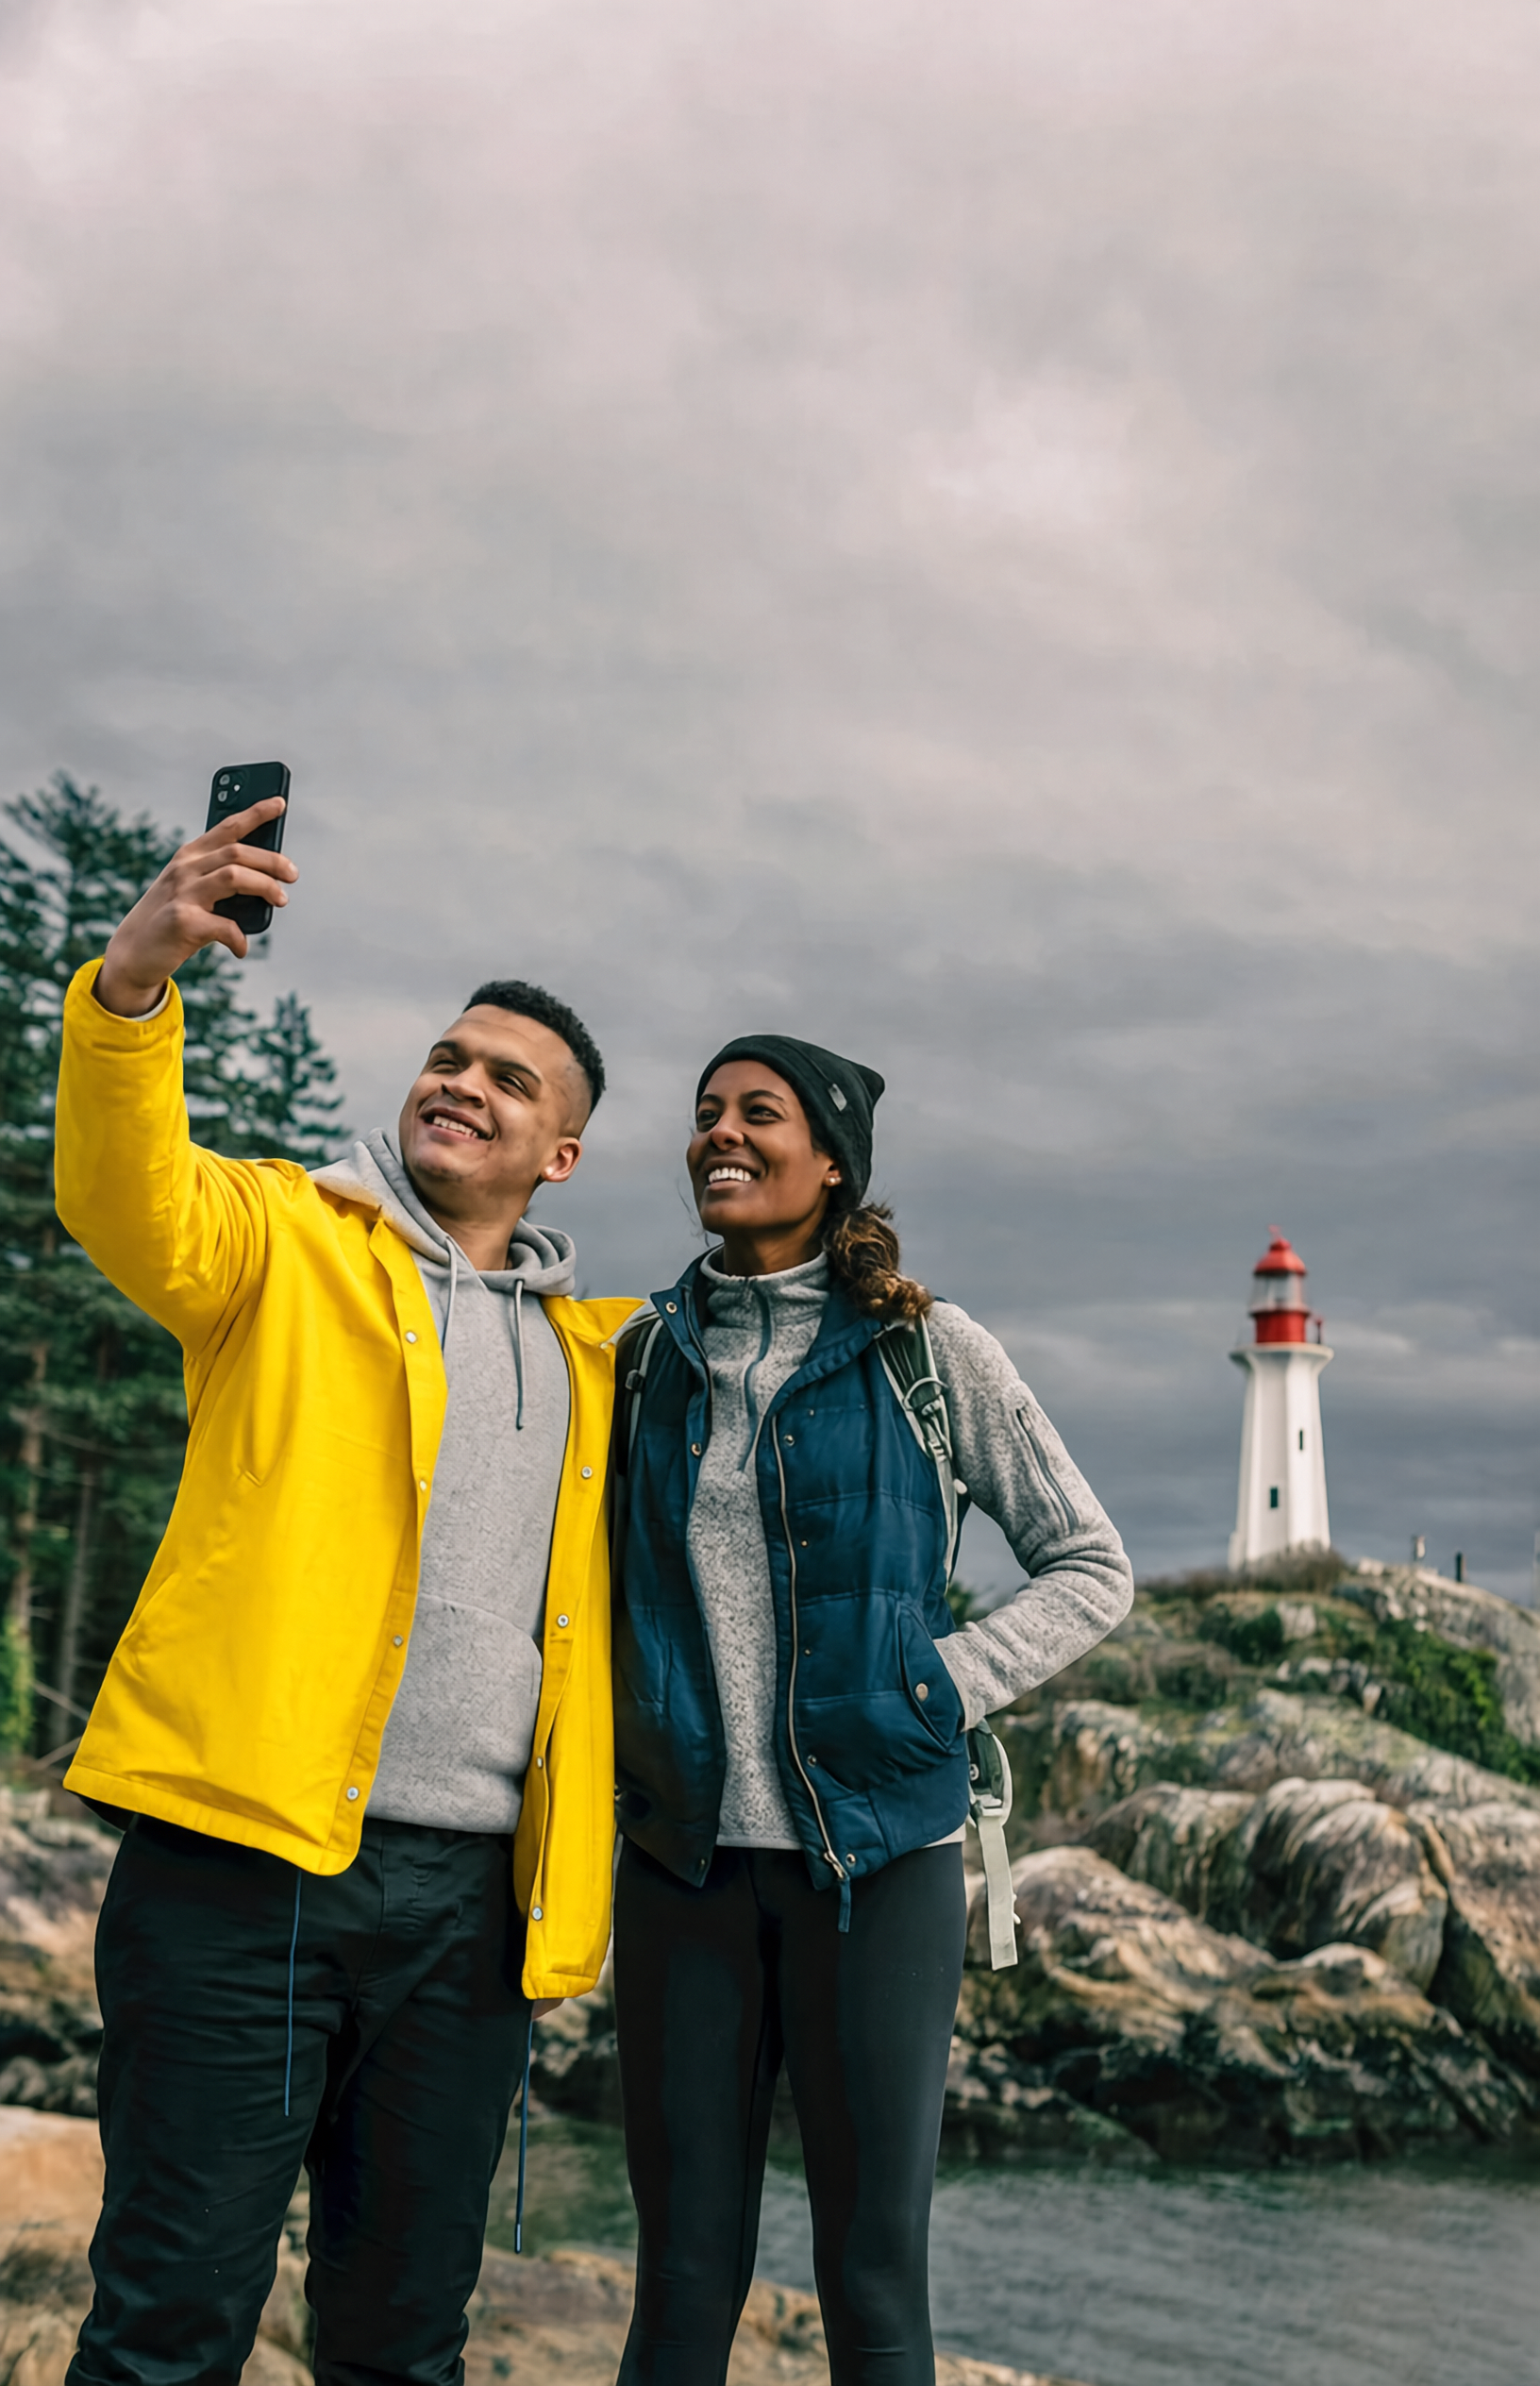
输入图(examples/editing/data/images/1.webp,672×1024):
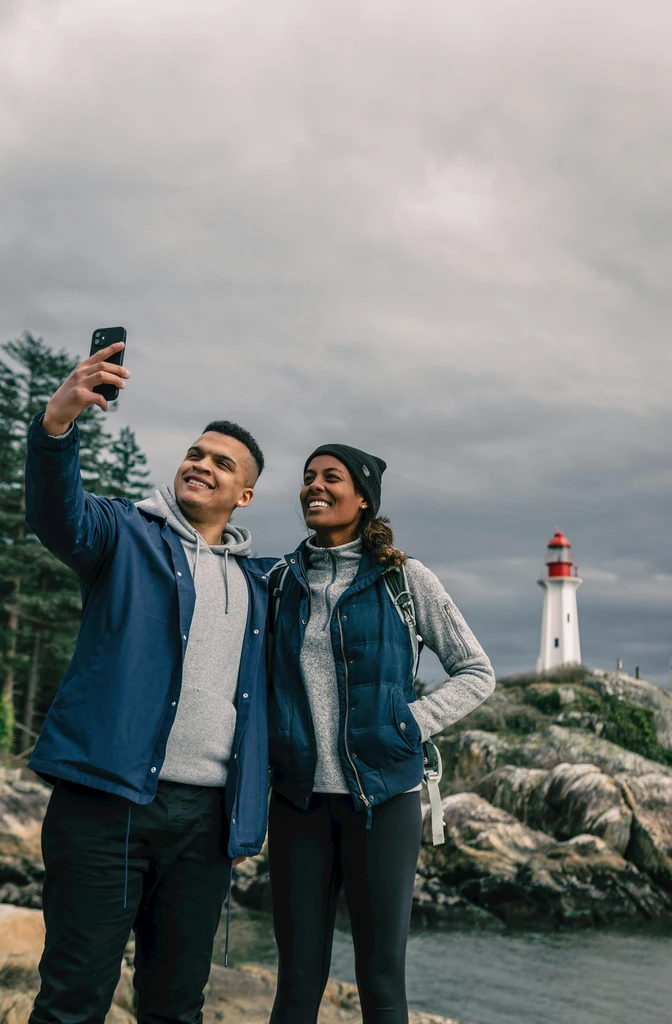
python examples/editing/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "Change the jacket of the person on the left to bright yellow." \
  --image examples/editing/data/images/1.webp \
  --cfg_scale 4.0 --img_cfg_scale 1.0 --timestep_shift 3.0 --num_steps 50 \
  --output outputs/edited.png --profile
终端输出:1 张输入图自动按 4096 pixel 上限处理,50 步编辑耗时 493.2 s、吞吐 8.17 tok/s、峰值显存 allocated 39.39 GiB / reserved 40.30 GiB。
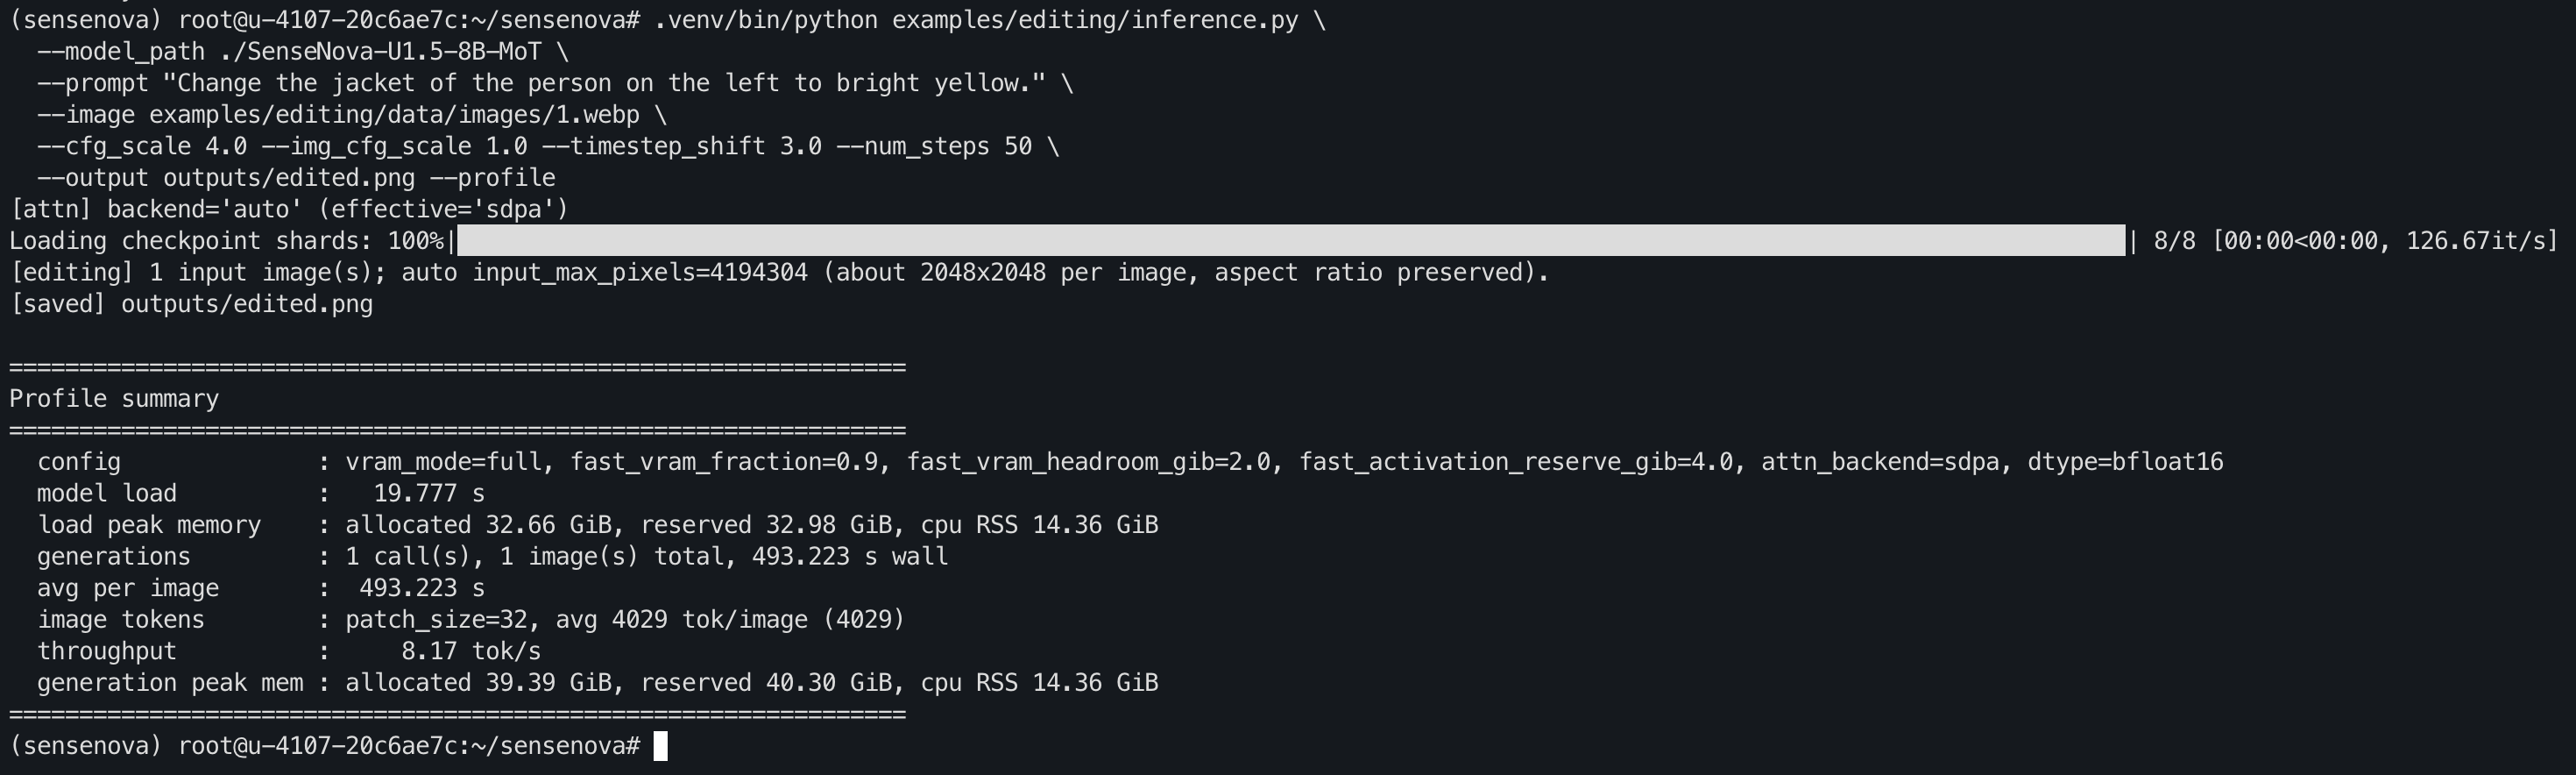
编辑结果(outputs/edited.png):
3.3.4. 图文交错生成(interleave)
python examples/interleave/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "I want to learn how to cook tomato and egg stir-fry. Please give me a beginner-friendly illustrated tutorial." \
  --resolution "16:9" \
  --output_dir outputs/interleave/ --stem demo_text
模型在生成文本的同时按段落插图(<image 1>、<image 2> …),文本与图片交替输出:
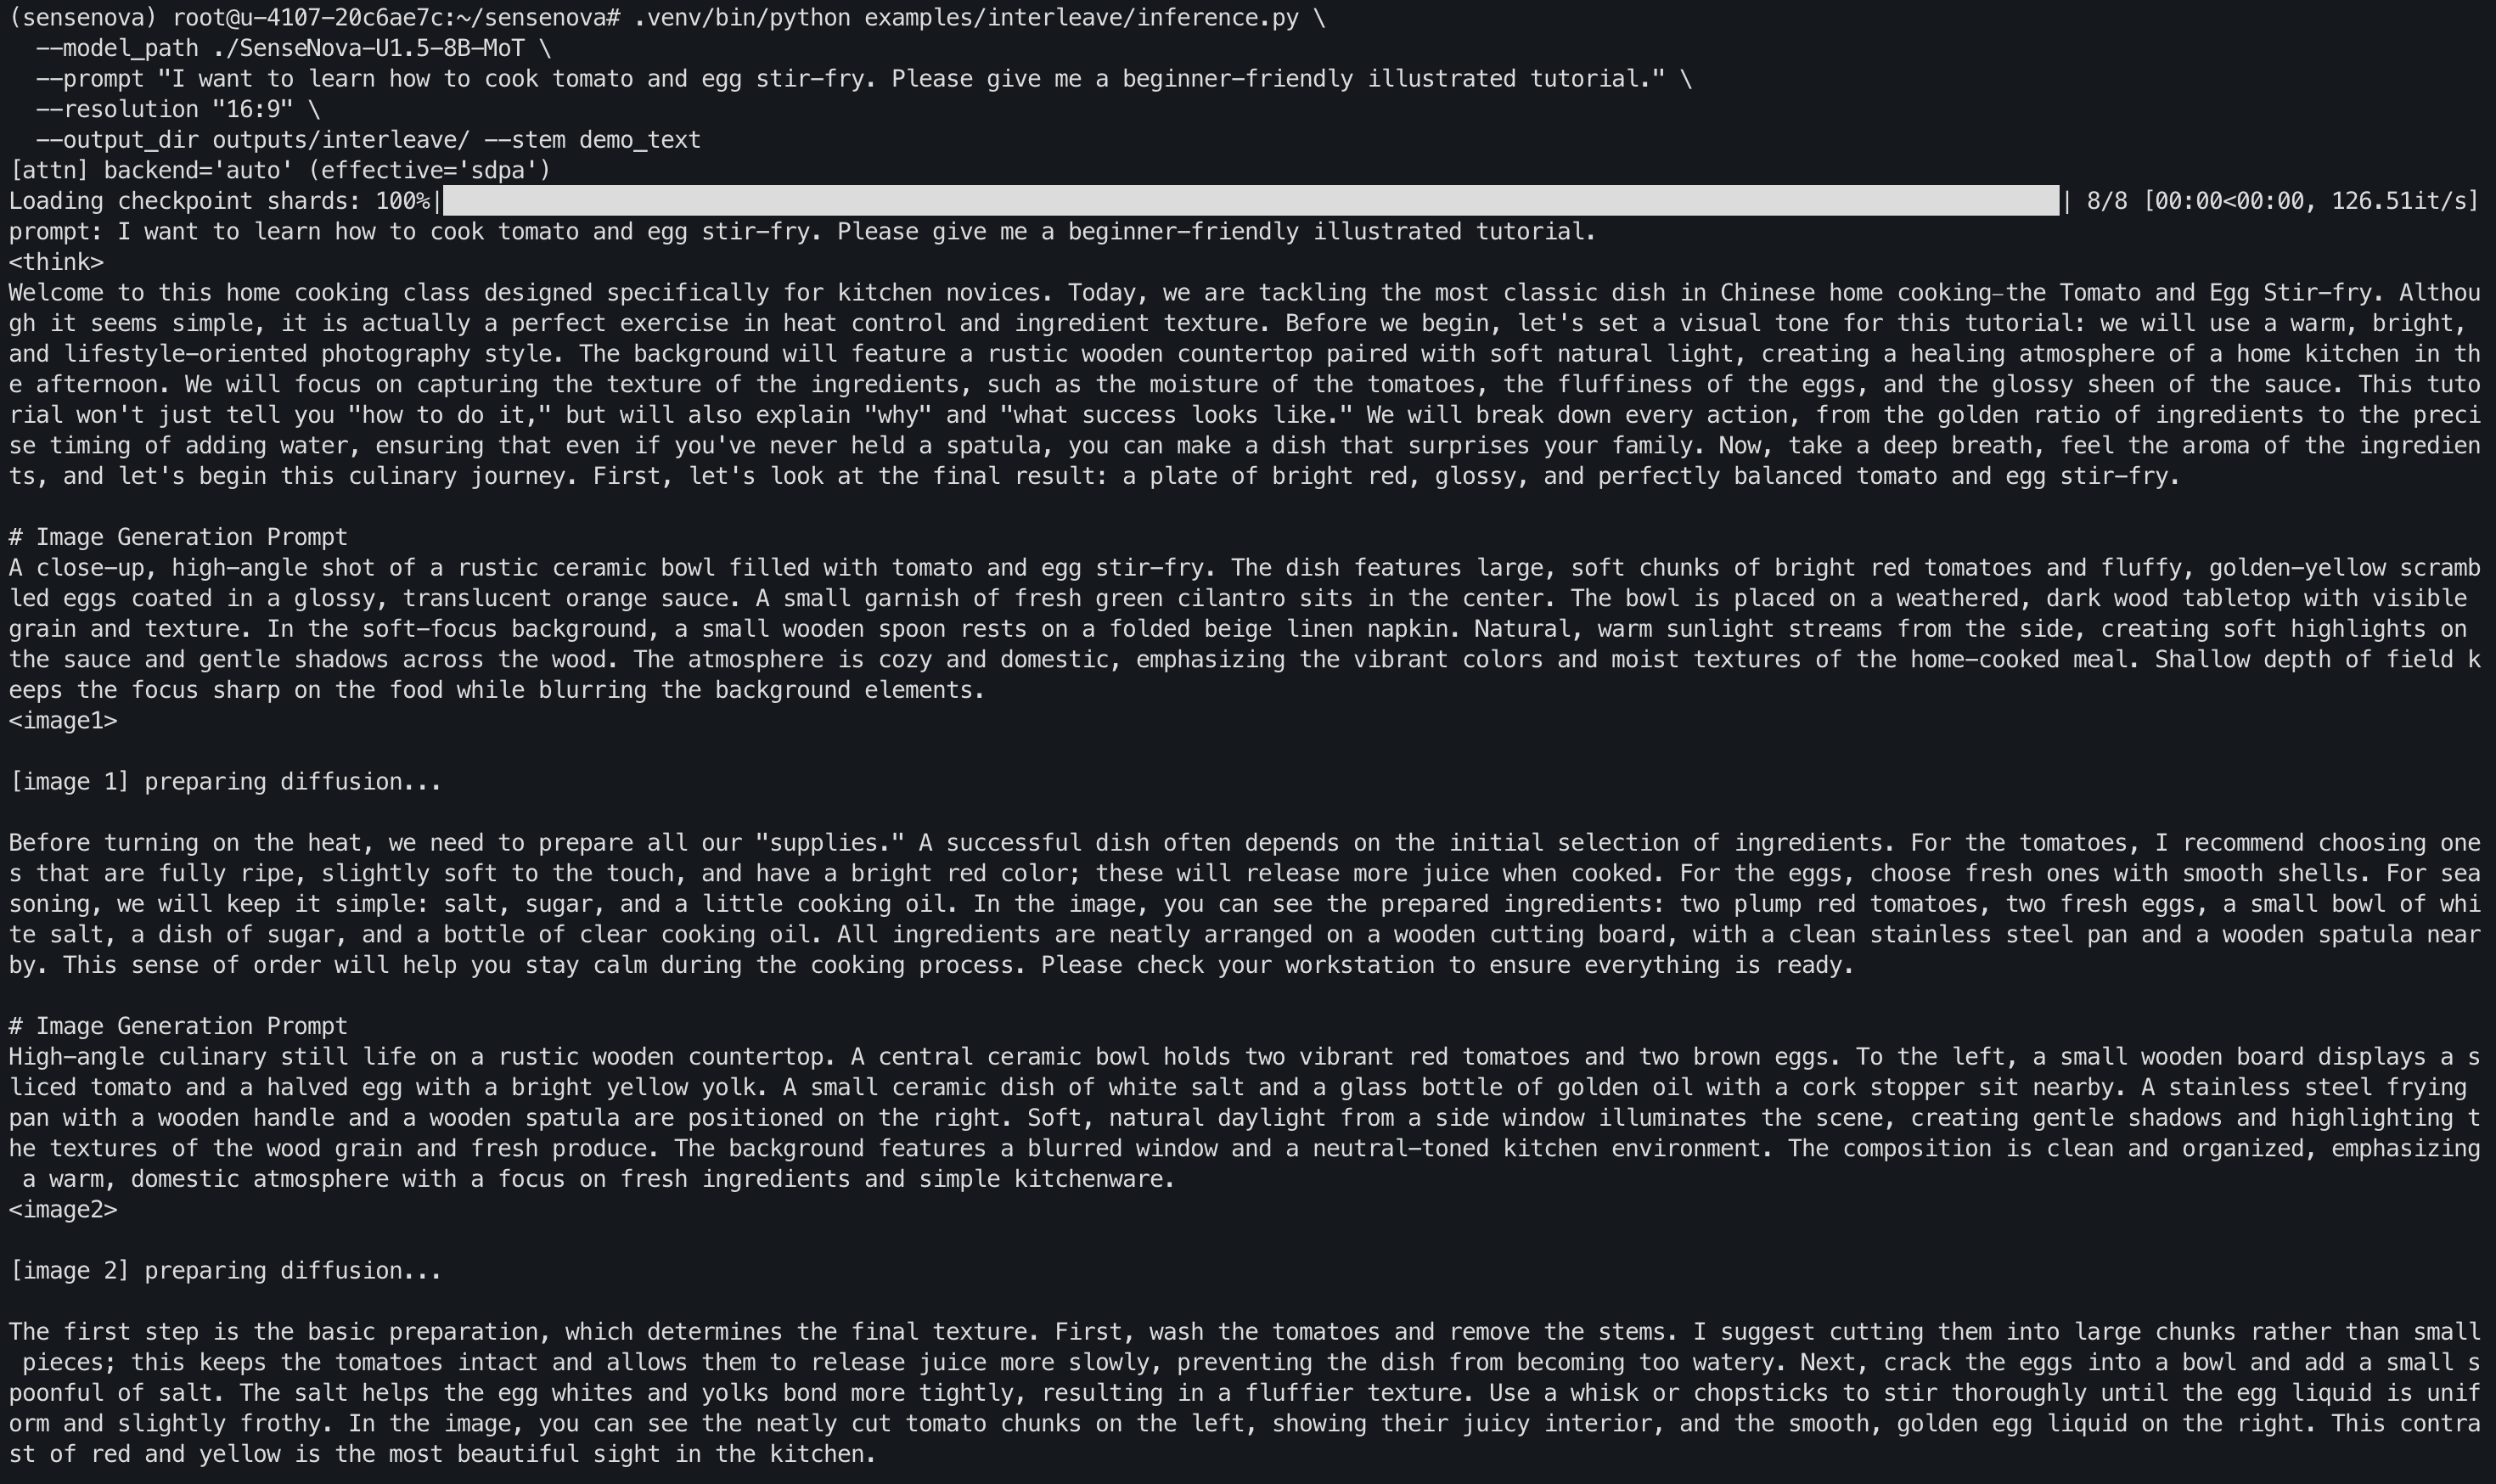
带输入图交错:--prompt "<image>\n图文交错生成小猫游览故宫的场景" --image examples/interleave/data/images/image0.jpg。
3.4显存不够时的降级方案
| 方案 | 命令 | 说明 |
|---|---|---|
| 分层卸载 | --vram_mode balanced(或 low / fast) |
项目自带 layer offload,比 accelerate CPU offload 快;与 --device_map 互斥 |
| GGUF 量化 | --gguf_checkpoint /path/x.gguf(需第 5 步的扩展) |
社区 Q4/Q8 权重;Q4 + balanced 可在 10–12 GB 显存运行 |
| 多卡切分 | --device_map auto --max_memory "0=22GiB,1=22GiB" |
多 GPU 机器用 |
| 降分辨率 / 步数 | --width/--height、--num_steps |
直接降低激活显存与耗时 |
3.5ROCm 适配说明与已知问题
-
官方支持口径:仓库 FAQ 声明官方仅支持 Linux + CUDA;本文是社区级移植路线。推理代码本身是设备无关的,因此 transformers 路径在 ROCm 上可正常运行。
-
flash-attn:ROCm 上未安装 flash-attn(仓库
pyproject.toml把它列为可选[flash]extra),--attn_backend auto自动回退 torch SDPA(ROCm 版 SDPA 自带 AOTriton/CK 内核),无需任何修改。如介意日志噪音,可显式--attn_backend sdpa。 -
MIOpen 警告:首次卷积自动调优时可能打印
MIOpen(HIP): Error [EvaluateInvokers] ... invalid configuration argument,这是候选内核淘汰信息,非致命,不影响结果。 -
版本对应:仓库默认 pin 的 torch 2.8.0/cu128 仅适用于 NVIDIA;AMD 机器按第二节重新装
+rocm7.2版 torch 即可,版本号不同属预期。
3.6一页速查
# 环境(一次性)
curl -LsSf https://astral.sh/uv/install.sh | sh && source "$HOME/.local/bin/env"
cd /root/sensenova
uv venv .venv --python 3.10 && source .venv/bin/activate
uv pip install torch torchvision --index-url https://download.pytorch.org/whl/rocm7.2
uv pip install -e . --no-deps
uv pip install "transformers>=4.57.1,<6" "accelerate>=1.1,<2" "huggingface-hub>=0.34,<2" \
  "safetensors>=0.4.3,<1" "sentencepiece==0.2.1" "numpy>=1.24,<3" "pillow==12.0.0" \
  "tqdm==4.67.1" "packaging==25.0" "httpx>=0.27,<1"

# 运行(每次)
python examples/t2i/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "你的提示词" \
  --output outputs/out.png --num_steps 50 --profile
第四章 SenseNova-U1.5 在摩尔线程 MUSA(MTT S4000)上的部署与运行指南
本章记录在国产 GPU 摩尔线程 MTT S4000(MUSA 软件栈)上部署 SenseNova-U1.5-8B-MoT 的完整过程。MUSA 路线使用 torch_musa 提供的 musa 设备类型,仓库代码需要 3 处小补丁(均为设备命名空间 / 内核兼容性问题,不涉及算法逻辑),整体仍属低成本移植。
4.1设备与运行环境
4.1.1. 硬件 / 驱动 / MUSA 一览
| 类别 | 实测值 |
|---|---|
| 操作系统 | Ubuntu 22.04 LTS,内核 5.15.0-105-generic(x86_64) |
| CPU | Intel Xeon Gold 6430 |
| 内存 | 1.0 TB |
| GPU | 摩尔线程 MTT S4000 × 1(PCI vendor 0x1ed5,48 GB GDDR6,实测可用 47.91 GB) |
| 驱动 | mtgpu 内核驱动 |
| MUSA toolkit | 3.1.0(/usr/local/musa-3.1.0,mcc 3.1.0 / mublas 1.6.0 / mufft 1.6.0,2024-09 构建) |
| torch | 2.2.0a0+git8ac9b20(摩尔线程定制构建) |
| torch_musa | 1.3.0+81caf0a |
| Python | 3.10(miniconda u1 环境) |
| 模型 | SenseNova/SenseNova-U1.5-8B-MoT |
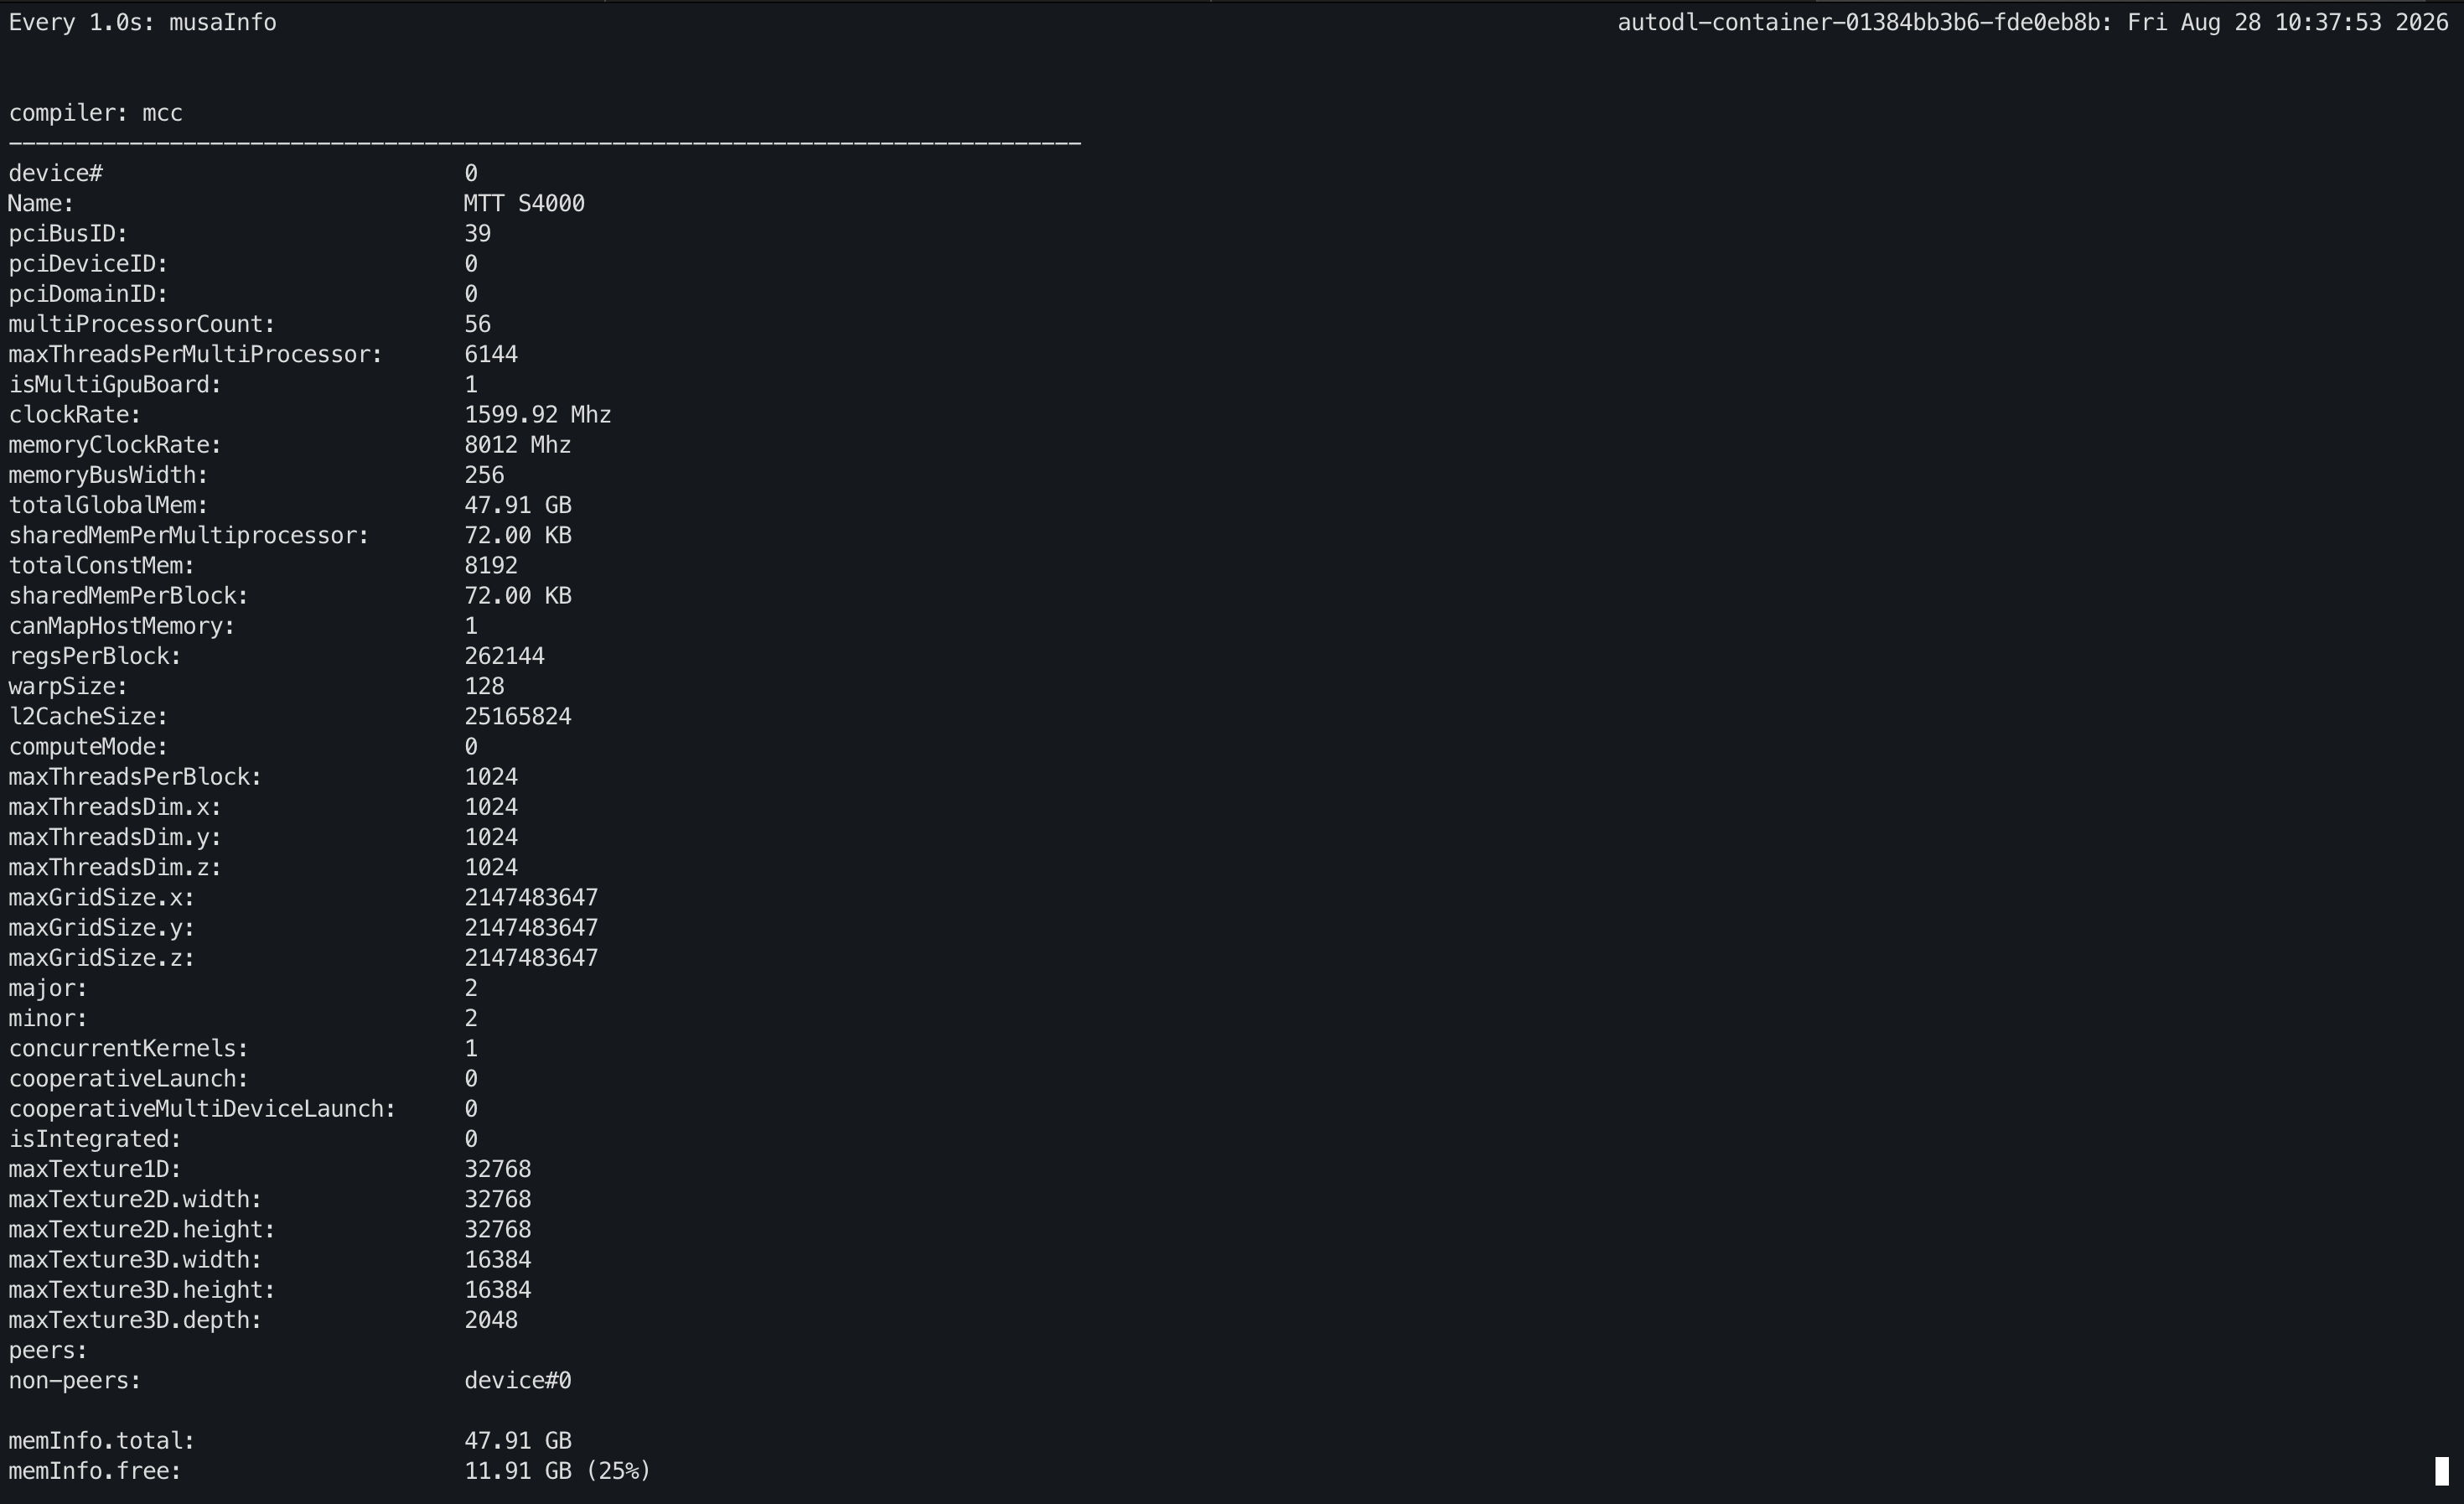
先用 musaInfo 确认 MUSA 环境与显卡型号:
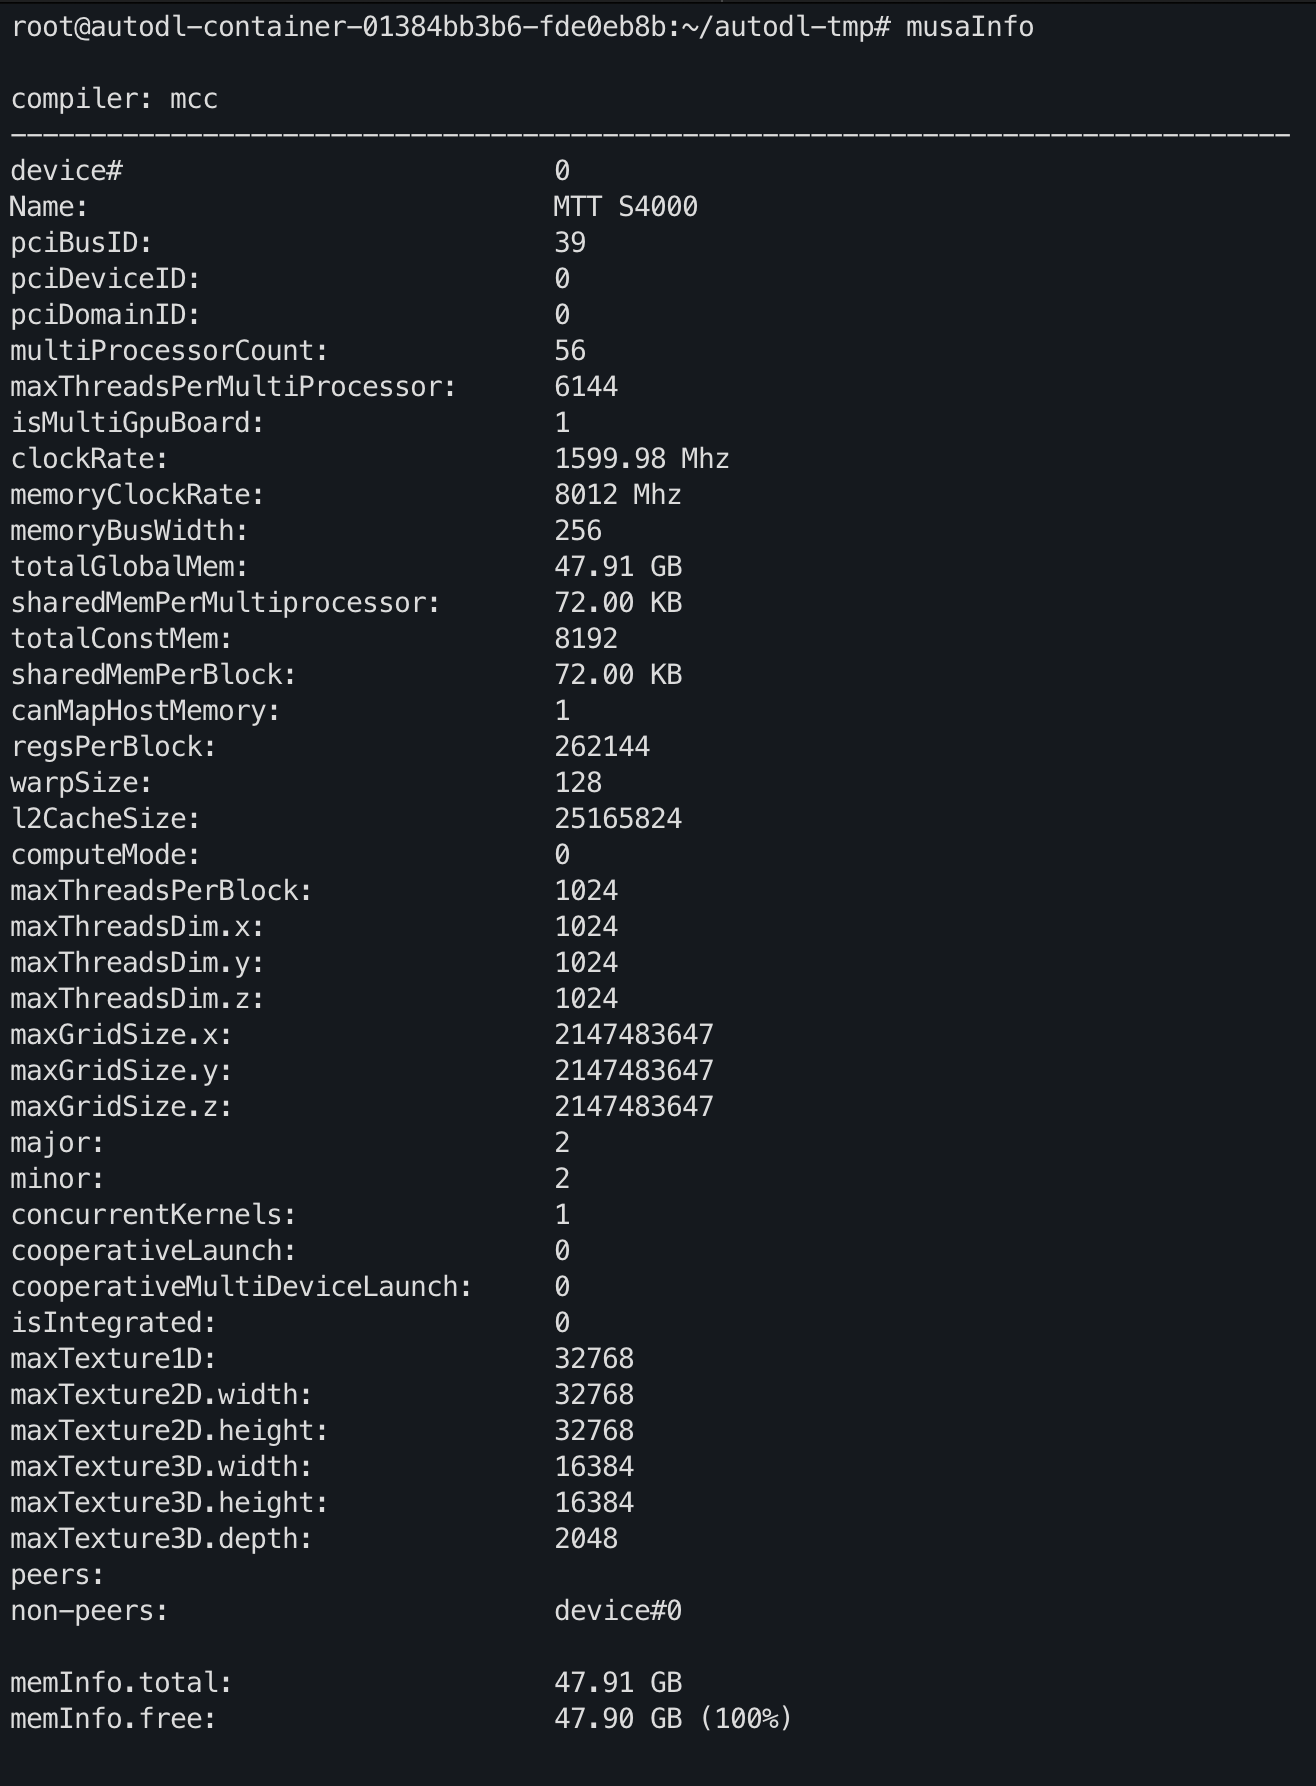
可见:device#0 为 MTT S4000,显存 47.91 GB(100% 空闲),56 个多处理器,核心频率 1.6 GHz,compute capability major 2 / minor 2。MUSA toolkit 版本可查
cat /usr/local/musa/version.json。
CPU / 内存概况:
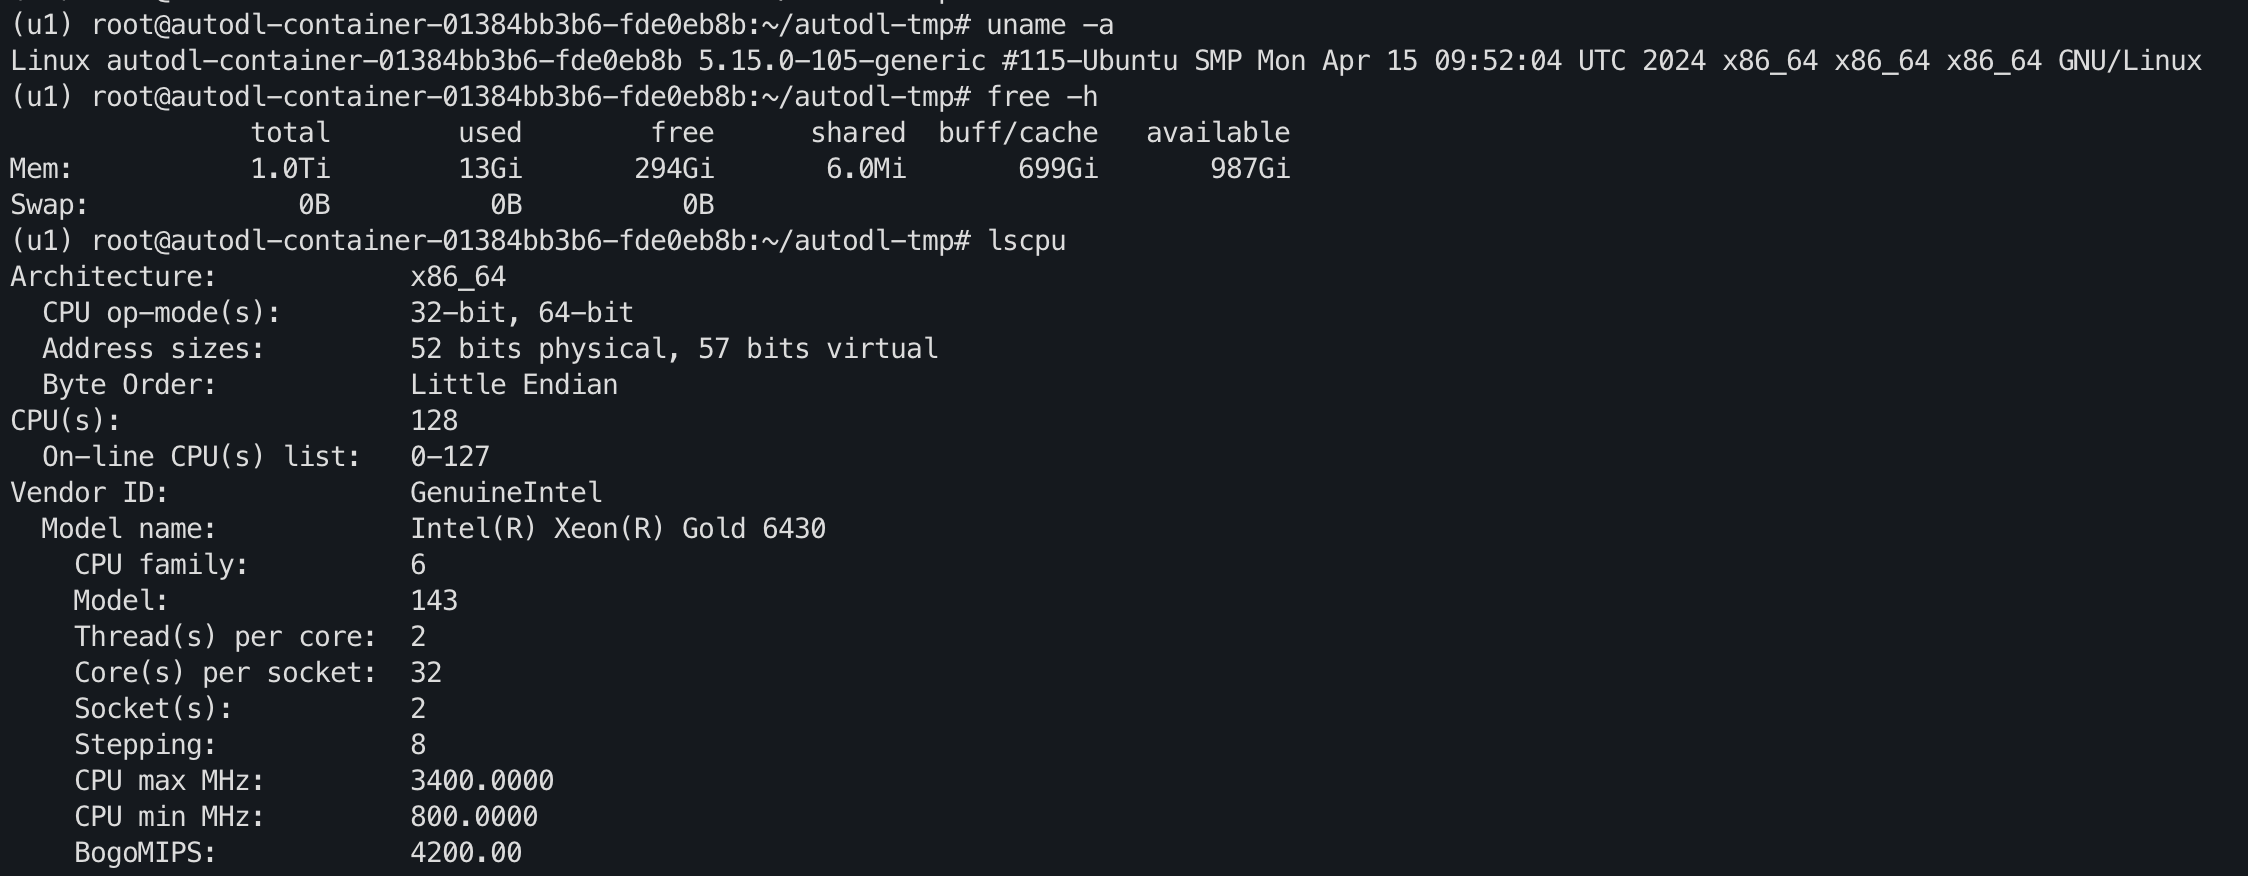
可见:内存 1.0 TB;CPU 为 Intel Xeon Gold 6430(容器分配 15 核)。大内存对
--vram_mode balanced/low的分层卸载模式非常有利。
4.1.2. 实测性能(单卡 48 GB,2048×2048)
以 4.3 节 2048×2048 文生图任务实测(BF16、SDPA、vram_mode=full、单卡):
| 指标 | 8 步冒烟 | 50 步正式生成 |
|---|---|---|
| 模型加载耗时 | 8.09 s | 8.15 s |
| 加载峰值显存(allocated / reserved) | 32.66 / 32.98 GB | 32.66 / 32.98 GB |
| 生成耗时(wall) | 31.97 s | 171.24 s |
| 生成吞吐(图像 token) | 128.12 tok/s | 23.92 tok/s |
| 生成峰值显存(allocated / reserved) | 34.71 / 35.69 GB | 34.71 / 35.69 GB |
48 GB 显存对 2048×2048 任务余量充足(峰值约 35.7 GB,尚余约 12 GB)。先行参考:BF16 GEMM(8192³ 矩阵乘)实测约 82.5 TFLOPS,达到 S4000 标称 100 TFLOPS BF16 张量算力的约 83%。
4.2环境安装
4.2.0. 前提
-
MUSA 驱动已安装且正常(
musaInfo能看到 GPU); -
miniconda 可用;网络可访问 PyPI(国内建议走镜像源);
-
模型已下载到
./SenseNova-U1.5-8B-MoT:
# 方式一:ModelScope(国内推荐)
modelscope download --model SenseNova/SenseNova-U1.5-8B-MoT --local_dir ./SenseNova-U1.5-8B-MoT
# 方式二:HuggingFace
huggingface-cli download SenseNova/SenseNova-U1.5-8B-MoT --local-dir ./SenseNova-U1.5-8B-MoT
-
版本配套关系(关键)。
torch_musa的版本号与其适配的 PyTorch 版本对应,且对 MUSA SDK 有最低版本要求:
| torch_musa | PyTorch | MUSA SDK 最低要求 |
|---|---|---|
| 1.3.0 | 2.2.0 | 3.1.x(KUAE 1.3.0,本文环境) |
| 2.0.0 | 2.2.0 全量支持,新增 2.5.0 | 高于 3.1(以发布说明为准) |
| 2.7.0 / 2.7.1 | 2.7.1 | 以发布说明为准 |
| 2.9.0 | 2.9.0 | ≥ 4.3.2 |
| 2.9.1 | 2.9.1 | ≥ 5.1.0 |
| 2.11.0 | 2.11 | 5.1 / 5.2 |
注意两点:① torch_musa 的版本号跳过了 PyTorch 2.8(从 2.7.1 直接到 2.9.0),仓库默认 pin 的 torch==2.8.0 在 MUSA 上没有对应版本;② 本机 MUSA toolkit 为 3.1.0,只能配套 torch_musa 1.3.0 + torch 2.2.0。如果机器的 MUSA SDK 更新(≥5.1),建议直接选用 torch_musa 2.9.1.post1(torch 2.9.1),算子覆盖更全、性能更好,本文流程同样适用(依赖版本相应替换)。
关于安装方式: 仓库把
torch==2.8.0/torchvision==0.23.0固定到 CUDA 12.8 的 index(download.pytorch.org/whl/cu128),仅对 NVIDIA 适用。torch_musa不在 PyPI 上,只能从摩尔线程官方渠道获取(GitHub Releases 的 wheel、mcconline 镜像仓库,或厂商镜像预装)。本文用 miniconda 建独立环境u1+ 复用厂商镜像在 base 环境预装的 torch 栈,全程不污染 base 环境。
4.2.1. 创建独立 conda 环境
conda create -n u1 python=3.10 -y
Python 版本需与预编译 torch wheel 的 ABI 一致(此处为 cp310,与镜像自带 Python 3.10.8 相同)。
4.2.2. 安装 torch / torch_musa / torchvision(关键一步)
方式 A(本文采用):镜像已在 base 环境预装 → 复制到新环境
AutoDL 等国产卡实例的镜像通常已在 base conda 预装好配套的 torch / torch_musa / torchvision(本例为 torch 2.2.0 + torch_musa 1.3.0)。直接整包复制到新环境:
SRC=/root/miniconda3/lib/python3.10/site-packages
DST=/root/miniconda3/envs/u1/lib/python3.10/site-packages
for p in torch torch_musa torchvision functorch torchgen \
         torch-*.dist-info torch_musa-*.dist-info torchvision-*.dist-info; do
  cp -a $SRC/$p $DST/
done
方式 B:全新机器 / 自建驱动 → 安装官方 wheel 或 Docker 镜像
# 从 https://github.com/MooreThreads/torch_musa/releases 下载与 MUSA SDK 版本匹配的 wheel pip install torch-2.2.0*.whl torch_musa-1.3.0*.whl torchvision-0.17.2*.whl # 或直接使用官方容器镜像 docker run -it --privileged --pull always --network=host \ --env MTHREADS_VISIBLE_DEVICES=all \ registry.mthreads.com/mcconline/musa-pytorch-release-public:latest /bin/bash
注意:torch_musa 1.3.0 不会在
import torch时自动注册,必须显式import torch_musa后torch.musa命名空间才存在(新版 torch_musa 会自动加载)。4.2.4 的补丁①已处理该问题。
4.2.3. 安装项目本体与其余依赖
# 编辑模式构建需要 hatchling;项目本体跳过依赖解析(防止拉回 cu128 版 torch) pip install -i https://pypi.tuna.tsinghua.edu.cn/simple hatchling pip install -e . --no-deps # 其余依赖:torch 2.2 的纯 Python 运行依赖 + 模型推理依赖 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple \ typing_extensions sympy networkx jinja2 filelock fsspec \ "numpy>=1.24,<2" pillow requests \ "transformers>=4.57.1,<5" "accelerate>=1.1,<2" "safetensors>=0.4.3,<1" \ sentencepiece==0.2.1 tqdm packaging httpx
三个坑:
为什么
--no-deps:pyproject.toml把 torch/torchvision 固定到 cu128 index,带依赖安装会拉回 NVIDIA 版 torch;transformers 必须
<5:transformers 5.x 要求 torch≥2.5,在 torch 2.2 下会打印Disabling PyTorch because PyTorch >= 2.5 is required并禁用模型加载,只剩 tokenizer 功能;仓库声明的<6上界在 MUSA + torch 2.2 组合下要收紧为<5(实测 4.57.6 正常);torch 2.2 的纯 Python 依赖:新 conda 环境是干净的,需补齐
typing_extensions、sympy等,否则import torch直接报错。
4.2.4. MUSA 设备适配补丁
ROCm 路线零代码改动;MUSA 路线需要 3 处小补丁。
补丁① src/sensenova_u1/utils/accel.py — 注册 musa 设备类型
仓库的设备抽象层原本只认 ("cuda", "xpu"),musa 设备会被 require_accelerator() 拒绝。改动:SUPPORTED_DEVICE_TYPES 加入 "musa";accel_module() 返回 torch.musa;best_available_device() 按 CUDA → MUSA → XPU → CPU 顺序选择;并在模块顶部显式 import torch_musa(老版本不自动注册):
+# Register Moore Threads MUSA support when torch_musa is installed. Older
+# torch_musa releases only expose ``torch.musa`` after an explicit import.
+try: # pragma: no cover - environment dependent
+ import torch_musa # noqa: F401
+except ImportError:
+ pass
+
-SUPPORTED_DEVICE_TYPES: tuple[str, ...] = ("cuda", "xpu")
+SUPPORTED_DEVICE_TYPES: tuple[str, ...] = ("cuda", "musa", "xpu")
def accel_module(device: torch.device):
if device.type == "cuda":
return torch.cuda
+ if device.type == "musa":
+ if not hasattr(torch, "musa"):
+ raise RuntimeError("device type 'musa' requires the torch_musa package")
+ return torch.musa
if device.type == "xpu":
return torch.xpu
(is_available / best_available_device / empty_cache / synchronize / manual_seed_all 同步加入 musa 分支,完整 diff 见仓库 git diff src/sensenova_u1/utils/accel.py。)
补丁①还包含一个 torch.cat 垫片:torch_musa 1.3.0 将 1-D 空张量(numel == 0)与高维张量拼接时报 Wrong Cat dim 错误,而标准 PyTorch 会静默忽略这类操作数——transformers 的 DynamicCache 懒初始化(torch.cat([torch.tensor([]), key_states], dim=-2))恰好依赖该语义,不打垫片会在首次推理时直接报错。补丁在 MUSA 可用时包装 torch.cat,过滤 1-D 空张量操作数以复现标准行为:
+if hasattr(torch, "musa") and torch.musa.is_available():  # pragma: no cover
+    _orig_cat = torch.cat
+
+    def _cat_ignore_empty_1d(tensors, dim=0, *args, **kwargs):
+        filtered = [t for t in tensors if not (t.dim() == 1 and t.numel() == 0)]
+        return _orig_cat(filtered if filtered else tensors, dim, *args, **kwargs)
+
+    torch.cat = _cat_ignore_empty_1d
补丁② src/sensenova_u1/utils/profiler.py — 显存统计泛化到加速卡模块
--profile 的峰值显存统计原本硬编码 torch.cuda.*,改为通过补丁①的 accel_module() 分发(torch.musa.memory_allocated / max_memory_allocated / max_memory_reserved 等 API 与 CUDA 同名),_sync() 同步计时同理。改动后 --profile 在 MUSA 上可正常打印显存占用。
补丁③ src/sensenova_u1/models/neo_unify/modeling_qwen3.py — SDPA scale 与 block-causal 掩码兼容
torch_musa 1.3.0 的 scaled_dot_product_attention 只接受默认 scale 值 1/sqrt(head_dim),显式传入其它值会抛 RuntimeError: Now torch_musa only allows explicit value of scale parameter...。而 Qwen3 注意力的 self.scaling 恰好等于该默认值,因此补丁为:与默认值相等时不显式传 scale,并把异常回退分支从 TypeError 扩展到 (TypeError, RuntimeError):
+    # Moore Threads' torch_musa SDPA only accepts the default scale
+    # (1/sqrt(head_dim)); drop an explicit scale equal to the default so the
+    # same call works on MUSA devices.
+    if softmax_scale is not None:
+        head_dim = q.shape[-1]
+        if head_dim > 0 and abs(softmax_scale - head_dim ** -0.5) < 1e-12:
+            softmax_scale = None
+
     try:
         out = torch.nn.functional.scaled_dot_product_attention(
             q_bhsd, k_bhsd, v_bhsd,
             dropout_p=dropout_p, is_causal=causal, scale=softmax_scale,
         )
-    except TypeError:
+    except (TypeError, RuntimeError):
同文件第二处改动在 create_block_causal_mask:原实现用 CPU 0 维标量张量 作 torch.where 的填充值(CUDA 会自动提升这类操作数),torch_musa 不接受——本章首次冒烟测试正是在此失败(RuntimeError: t == kMUSA INTERNAL ASSERT FAILED at ".../csrc/core/GuardImpl.h":29)。修复为在掩码同设备上构造填充标量:
-    return torch.where(mask[None, None, :, :] > 0, torch.tensor(0.0), torch.tensor(float('-inf')))
+    # Build the fill scalars on the mask's device: torch_musa does not accept
+    # CPU scalar tensors in torch.where (CUDA auto-promotes them).
+    return torch.where(
+        mask[None, None, :, :] > 0,
+        torch.tensor(0.0, device=index.device),
+        torch.tensor(float('-inf'), device=index.device),
+    )
4.2.5. (可选)GGUF 低显存扩展
pip install "gguf>=0.10.0" "diffusers>=0.30.0"
4.2.6. 验证环境
python -c "
import torch, torch_musa, transformers
import sensenova_u1
from sensenova_u1.utils.accel import best_available_device
print('torch:', torch.__version__, '| torch_musa:', torch_musa.__version__)
print('transformers:', transformers.__version__)
print('musa available:', torch.musa.is_available(), '|', torch.musa.get_device_name(0))
print('best device:', best_available_device())
x = torch.randn(1024, 1024, device='musa', dtype=torch.bfloat16)
print('bf16 matmul OK:', float((x @ x).float().sum()))
"
算子级验证(建议跑一遍,覆盖本模型实际用到的关键算子):
import torch, torch_musa, time
import torch.nn.functional as F
dev = "musa"
# 1) 真实注意力形状:S≈4200(4096 图像 token + 文本),Hq=32/Hkv=8,D=128,bf16
S = 4200
q = torch.randn(1, S, 32, 128, device=dev, dtype=torch.bfloat16)
k = torch.randn(1, S, 8, 128, device=dev, dtype=torch.bfloat16).repeat_interleave(4, dim=2)
v = torch.randn(1, S, 8, 128, device=dev, dtype=torch.bfloat16).repeat_interleave(4, dim=2)
o = F.scaled_dot_product_attention(q.transpose(1,2), k.transpose(1,2), v.transpose(1,2))
torch.musa.synchronize(); print("sdpa plain ok", tuple(o.shape))
# 2) block-causal float mask(create_block_causal_mask 的输出形态)
# ……(构造 (1,1,L,L) 的 0/-inf mask 后 attn_mask= 传入 SDPA,见仓库验证脚本)
# 3) U1.5 ConvDecoder 关键算子:PixelShuffle + 3x3 Conv
y = torch.nn.Conv2d(384, 384, 3, padding=1, device=dev, dtype=torch.bfloat16)(
    torch.pixel_shuffle(torch.randn(1, 1536, 64, 64, device=dev, dtype=torch.bfloat16), 2))
torch.musa.synchronize(); print("pixelshuffle+conv ok", tuple(y.shape))
# 4) BF16 GEMM 吞吐
a = torch.randn(8192, 8192, device=dev, dtype=torch.bfloat16)
b = torch.randn(8192, 8192, device=dev, dtype=torch.bfloat16)
t0 = time.time(); n = 10
for _ in range(n): c = a @ b
torch.musa.synchronize(); dt = (time.time() - t0) / n
print(f"bf16 GEMM 8k^3: {dt*1000:.1f} ms -> {2*8192**3/dt/1e12:.1f} TFLOPS")
实测输出:
sdpa plain ok (1, 32, 4200, 128)
sdpa block-causal mask ok (1, 32, 4200, 128)
pixelshuffle+conv ok (1, 384, 128, 128)
bf16 GEMM 8k^3: 13.3 ms -> 82.5 TFLOPS
四项全过:普通 SDPA、block-causal 掩码 SDPA(生成路径的实际用法)、U1.5 解码器的 PixelShuffle+卷积、BF16 GEMM(82.5 TFLOPS,约为标称 100 TFLOPS 的 83%)。
4.3运行推理示例
本章验证聚焦文生图(8 步冒烟 + 50 步正式生成,实测数据与结果图见 4.3.1)。以下命令与上一章一致,
--device无需显式指定:补丁①生效后best_available_device()会自动选择musa(也可显式--device musa)。
公共参数建议:
| 参数 | 建议值 | 说明 |
|---|---|---|
--attn_backend |
sdpa |
MUSA 无 flash-attn;auto 会自动回退,显式指定更直观 |
--dtype |
bfloat16(默认) |
S4000 原生支持 bf16 张量算力 |
--num_steps |
50(默认) | 冒烟测试可设 8 快速验证流程 |
--cfg_scale |
4.0(默认) | 8-step 蒸馏 LoRA 才用 1.0 |
--profile |
建议开启 | 打印耗时与峰值显存(补丁②已支持 MUSA) |
4.3.1. 文生图(t2i)
8 步冒烟测试:
python examples/t2i/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --output outputs/musa_smoke.png \
  --num_steps 8 --attn_backend sdpa --profile
50 步正式生成:
python examples/t2i/inference.py \
  --model_path ./SenseNova-U1.5-8B-MoT \
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --output outputs/musa_full50.png \
  --num_steps 50 --attn_backend sdpa --profile
实测结果(--profile 输出,2048×2048、4096 图像 token):
================================================================
Profile summary
================================================================
  config              : vram_mode=full, fast_vram_fraction=0.9,
                        fast_vram_headroom_gib=2.0, fast_activation_reserve_gib=4.0,
                        attn_backend=sdpa, dtype=bfloat16
  model load          :    8.090 s
  load peak memory    : allocated 32.66 GiB, reserved 32.98 GiB, cpu RSS 13.79 GiB
  generations         : 1 call(s), 1 image(s) total, 31.971 s wall
  avg per image       :   31.971 s
  image tokens        : patch_size=32, avg 4096 tok/image (4096)
  throughput          :   128.12 tok/s
  generation peak mem : allocated 34.71 GiB, reserved 35.69 GiB, cpu RSS 13.79 GiB
================================================================
| 8 步冒烟 | 50 步正式 | |
|---|---|---|
| 生成耗时(wall) | 31.97 s | 171.24 s |
| 吞吐 | 128.12 tok/s | 23.92 tok/s |
| 峰值显存(allocated / reserved) | 34.71GB | 同左 |
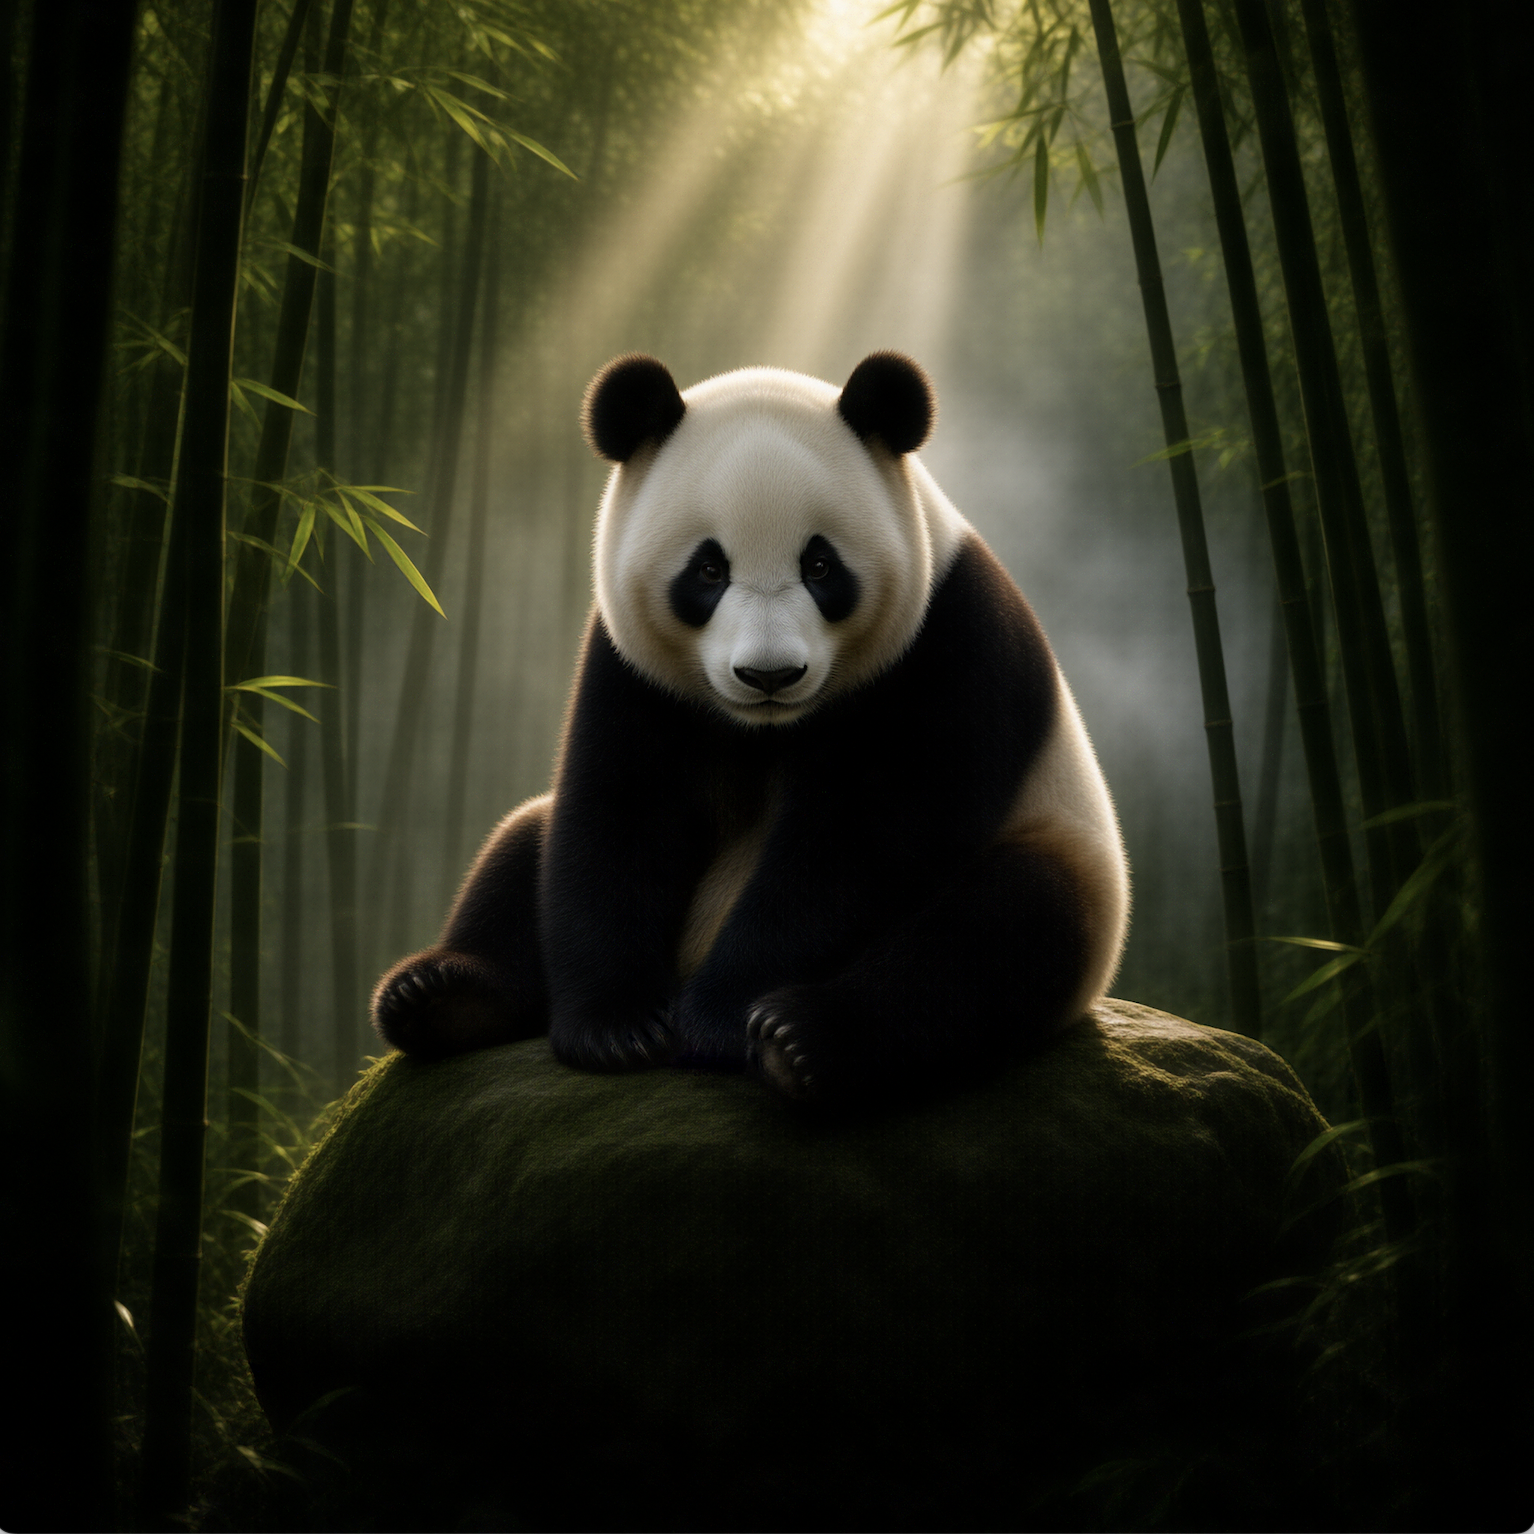
8 步冒烟生成结果:
50 步正式生成结果:
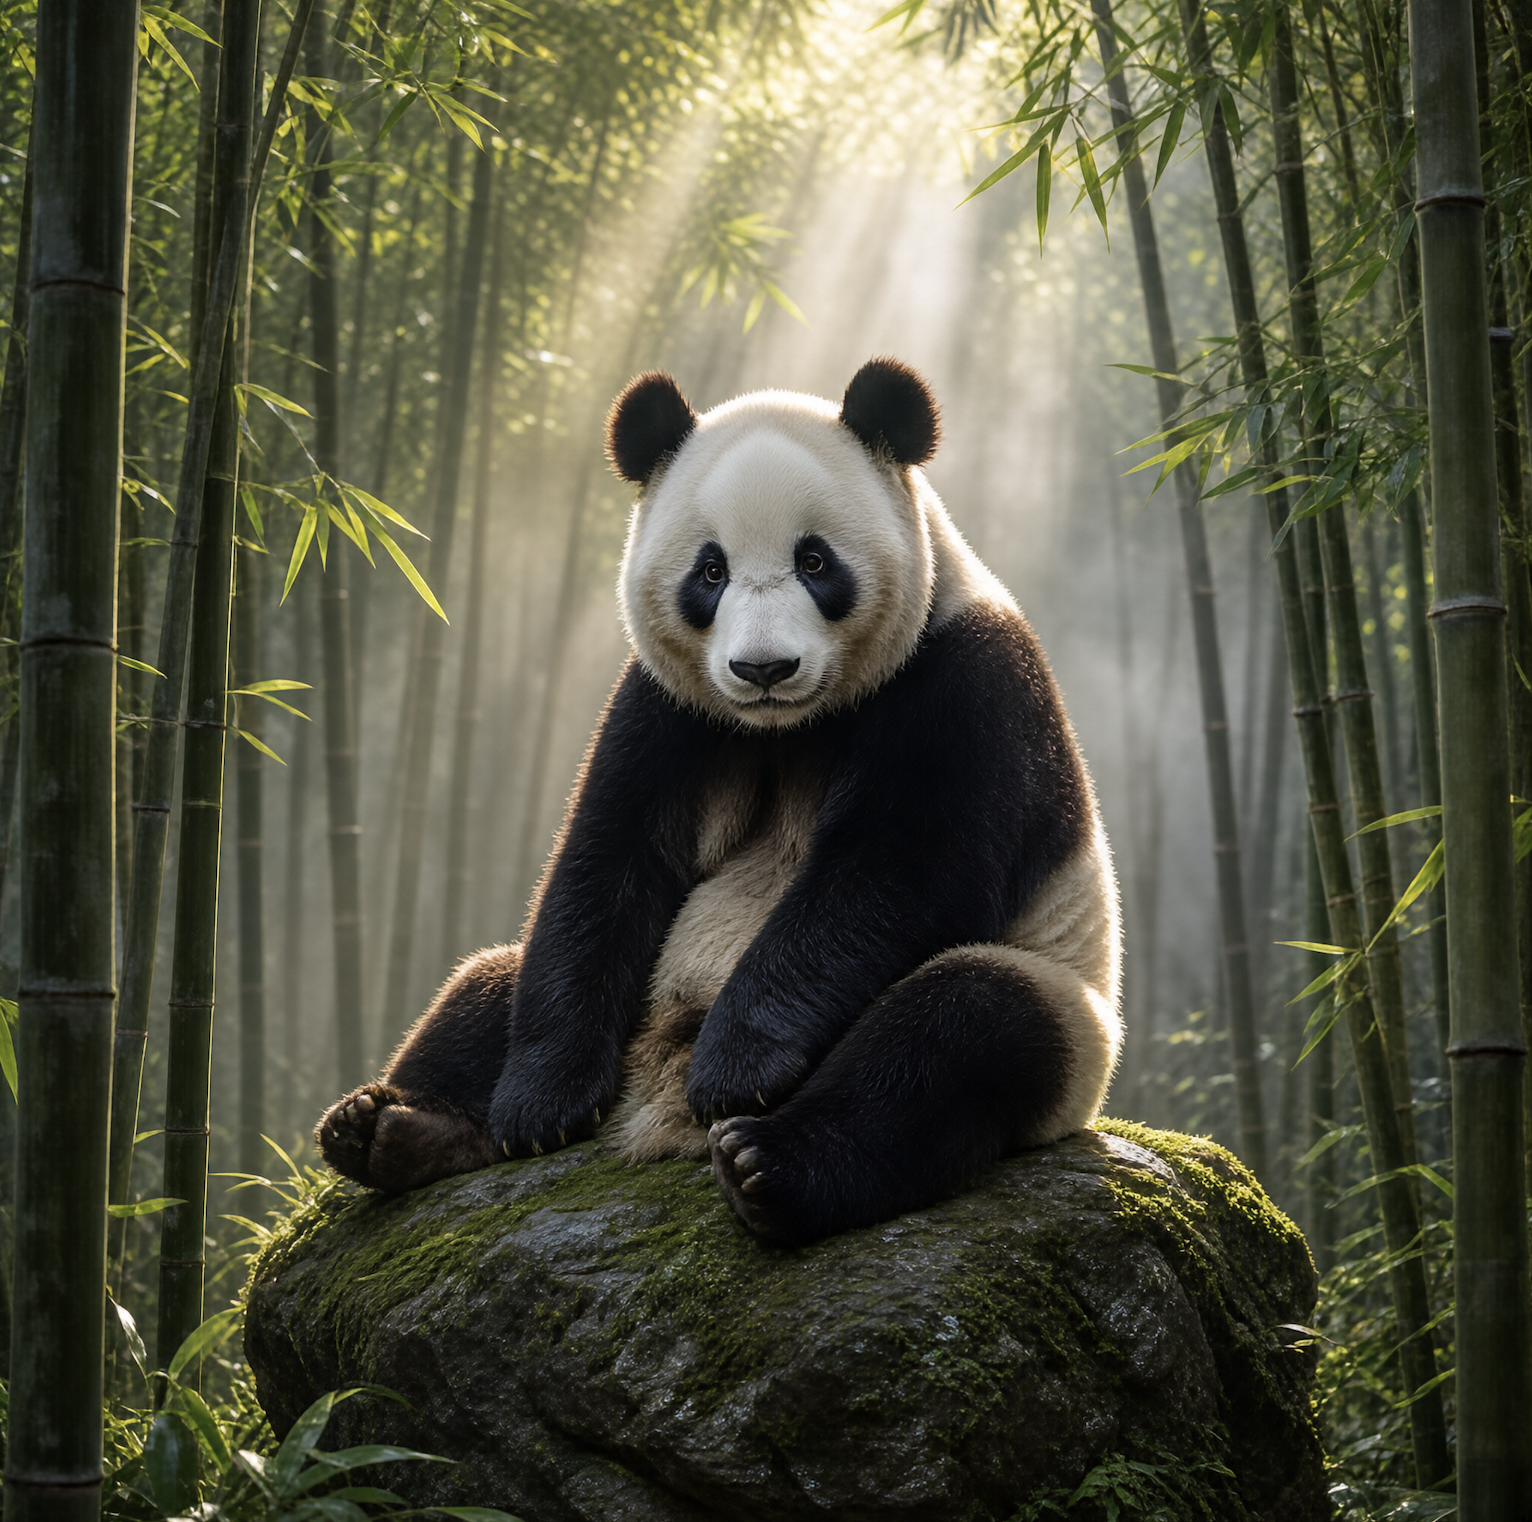
50 步成图的构图完整度与细节明显优于 8 步;两者峰值显存一致(34.71 GiB),48 GB 单卡余量约 12 GiB。耗时比 171.24 / 31.97 ≈ 5.36,与步数比(50/8 = 6.25,扣除 VAE 解码等固定开销后近似线性)相符,说明扩散步占总耗时主导、无额外同步瓶颈。
4.3.2. 其余示例(VQA / 编辑 / 交错生成)
这三类示例的命令与上一章完全一致(同样追加 --attn_backend sdpa 即可),在 MUSA 上的差异仅 4.2.4 的 3 处补丁;本章验证聚焦文生图,不再逐一展开实测,命令模板供参考:
# 视觉理解 VQA python examples/vqa/inference.py --model_path ./SenseNova-U1.5-8B-MoT \ --image examples/vqa/data/images/image1.jpg --question "Describe the image content." \ --attn_backend sdpa --profile # 图像编辑 editing python examples/editing/inference.py --model_path ./SenseNova-U1.5-8B-MoT \ --prompt "Change the jacket of the person on the left to bright yellow." \ --image examples/editing/data/images/1.webp \ --cfg_scale 4.0 --img_cfg_scale 1.0 --timestep_shift 3.0 --num_steps 50 \ --output outputs/edited.png --attn_backend sdpa --profile # 图文交错生成 interleave(多图峰值显存更高,建议配合 4.4 的降级方案) python examples/interleave/inference.py --model_path ./SenseNova-U1.5-8B-MoT \ --prompt "I want to learn how to cook tomato and egg stir-fry. Please give me a beginner-friendly illustrated tutorial." \ --resolution "16:9" --output_dir outputs/interleave/ --stem demo_text \ --attn_backend sdpa --profile
4.4显存不够时的降级方案
| 方案 | 命令 | 说明 |
|---|---|---|
| 分层卸载 | --vram_mode balanced(或 low / fast) |
项目自带 layer offload,比 accelerate CPU offload 快;与 --device_map 互斥。本机 1 TiB 内存下该方案余量很大 |
| GGUF 量化 | --gguf_checkpoint /path/x.gguf(需 4.2.5 的扩展) |
社区 Q8 权重约 19.9 GB;Q4 + balanced 可在 10–12 GB 显存运行 |
| 多卡切分 | --device_map auto --max_memory "0=22GiB,1=22GiB" |
S4000 支持 MTLink + MCCL(torch_musa 分布式后端为 mccl);本实例仅透出单卡,未验证 |
| 降分辨率 / 步数 | --width/--height、--num_steps |
直接降低激活显存与耗时 |
4.5MUSA 适配说明与已知问题
-
官方支持口径:仓库 FAQ 声明官方仅支持 Linux + CUDA;本章为社区级移植路线。推理代码本身基本设备无关,MUSA 上仅需 4.2.4 的 3 处小补丁(均向后兼容 CUDA 路线,可提交上游)。
-
flash-attn: 无 flash-attn,统一走
--attn_backend sdpa。torch_musa 1.3.0 的 SDPA 由 muDNN 支撑;新版 torch_musa(≥2.9.1)已支持 Flash SDPA(含 headdim≥256),升级后可望进一步提速。 -
SDPA scale 限制:torch_musa 1.3.0 仅接受默认
scale=1/sqrt(head_dim),显式传其它值会抛RuntimeError。本模型 Qwen3 注意力的缩放恰为默认值,补丁③已处理;若未来引入非默认 scale 的注意力变体,需关注该限制(新版 torch_musa 已放宽)。 -
torch 版本空档:仓库默认
torch==2.8.0,而 torch_musa 版本号跳过 PyTorch 2.8(2.7.1 → 2.9.0)。MUSA SDK 3.1.0 只能配 torch_musa 1.3.0 + torch 2.2.0;SDK ≥5.1 的机器建议直接上 torch_musa 2.9.1.post1 + torch 2.9.1(算子覆盖"全量 CUDA 对齐",且支持 torch.compile)。 -
transformers 版本:必须
<5(5.x 要求 torch≥2.5,在 torch 2.2 下会禁用 PyTorch)。 -
老版 torch_musa 需显式 import:
torch.musa命名空间在import torch_musa之后才存在(新版自动加载),补丁①已在accel.py顶部处理。 -
torchvision.io 警告:
Failed to load image Python extension(缺 libjpeg/libpng)不影响本仓库示例(用 PIL 读图),可忽略;如需torchvision.io可apt install libjpeg-dev libpng-dev后重装。 -
数值一致性:建议以相同种子对比 NVIDIA 与 MUSA 的输出;仓库的
--profile与固定种子(默认 42)便于复现对照。 -
torch.cat 1-D 空张量:torch_musa 1.3.0 将 1-D 空张量(
numel == 0)与高维张量拼接时报Wrong Cat dim(CUDA / 标准 PyTorch 静默忽略该操作数),transformersDynamicCache懒初始化会触发;补丁①的 shim 复现标准语义。 -
torch.where CPU 标量张量:torch_musa 的
torch.where不接受 CPU 0 维标量张量作操作数(CUDA 自动提升),create_block_causal_mask原实现因此在GuardImpl.h触发内部断言;补丁③第二处改为设备侧构造填充标量。
4.6一页速查
# ===== 环境(一次性) ===== conda create -n u1 python=3.10 -y # torch 栈:方式 A(镜像已预装,复制到新环境) SRC=/root/miniconda3/lib/python3.10/site-packages DST=/root/miniconda3/envs/u1/lib/python3.10/site-packages for p in torch torch_musa torchvision functorch torchgen \ torch-*.dist-info torch_musa-*.dist-info torchvision-*.dist-info; do cp -a $SRC/$p $DST/ done # torch 栈:方式 B(官方 wheel,版本须与 MUSA SDK 配套) # pip install torch-2.2.0*.whl torch_musa-1.3.0*.whl torchvision-0.17.2*.whl conda activate u1 cd /root/autodl-tmp/SenseNova-U1 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple hatchling pip install -e . --no-deps pip install -i https://pypi.tuna.tsinghua.edu.cn/simple \ typing_extensions sympy networkx jinja2 filelock fsspec \ "numpy>=1.24,<2" pillow requests \ "transformers>=4.57.1,<5" "accelerate>=1.1,<2" "safetensors>=0.4.3,<1" \ sentencepiece==0.2.1 tqdm packaging httpx # 打 3 个 MUSA 适配补丁(见 4.2.4): # ① src/sensenova_u1/utils/accel.py 注册 musa 设备 + torch.cat 空张量 shim # ② src/sensenova_u1/utils/profiler.py 显存统计泛化 # ③ src/sensenova_u1/models/neo_unify/modeling_qwen3.py SDPA scale + block-causal 掩码设备兼容 # 验证 python -c "import torch, torch_musa; print(torch.musa.is_available(), torch.musa.get_device_name(0))" # ===== 运行(每次) ===== python examples/t2i/inference.py \ --model_path ./SenseNova-U1.5-8B-MoT \ --prompt "你的提示词" \ --output outputs/out.png --num_steps 50 --attn_backend sdpa --profile
第五章 SenseNova-U1 在低资源本机(8GB 显存 + 16GB 内存)上的部署与运行指南
适用场景:在 8GB 显存的消费级 GPU + 16GB 系统内存的 Linux 笔记本上,从零部署 SenseNova-U1 文生图推理并跑通验证案例。本章记录一次完整落地部署的真实环境、安装流程、案例运行与实测结果。
5.1设备与运行环境
5.1.1. 硬件 / 驱动 / 软件一览
| 类别 | 实测值 |
|---|---|
| 操作系统 | Ubuntu 26.04 LTS,内核 7.0.0-14-generic(x86_64) |
| CPU | Intel Core i7‑14700HX |
| 内存 | 16 GB |
| 磁盘 | 1.8 TB |
| GPU | NVIDIA GeForce RTX 4070 Laptop GPU(8 GB ) |
| 驱动 | NVIDIA 595.84(支持 CUDA 13.2) |
| Python | 3.11.16(uv 管理的 venv) |
| torch / torchvision | 2.8.0+cu128 / 0.23.0+cu128 |
| 关键依赖 | transformers 5.15.0、diffusers 0.37.1、gguf 0.19.0、accelerate 1.14.0、numpy 2.2.0、pillow 12.0.0 |
| 源码 | SenseNova-U1 main@8f354e0(Apache 2.0) |
| 模型 | SenseNova-U1-8B-MoT-8step Q4_K_S GGUF(13.9 GB,社区量化,sha256 已校验) |
5.1.2. 实测性能(8 GB 显存 + 16 GB 内存,1024×1024)
| 指标 | 数值 |
|---|---|
| 注意力后端 | torch SDPA(--attn_backend sdpa 显式指定) |
| 模型加载耗时 | 4.2 s(mmap 零拷贝加载后 CPU RSS 仅 5.71 GiB) |
| 8 步生成耗时 | 759.0 s/张(1024×1024,逐层 CPU↔GPU 搬运是瓶颈) |
| 生成吞吐 | 1.35 tok/s(平均 1024 token/张) |
| 生成峰值显存 | allocated 2.95 GiB / reserved 3.11 GiB(~3.3 GiB / 8 GiB,余量充足) |
| 生成峰值内存 | CPU RSS 8.28 GiB(低于 10 G cgroup 护栏) |
| 运行时系统可用内存 | ≥ 8 GB,桌面 / 其他应用无感知 |
资源约束与方案选择(为什么需要改造):
| 方案 | 需求 | 本机结果 |
|---|---|---|
| bf16 全量模型 | ≥ 36 GB 显存 | 不可行 |
| GGUF Q4_K_S(13.9 GB),官方默认加载 | 权重整体拷入内存并 pin 锁定(~14 GB RAM) | 16 GB 内存下必然卡死系统 |
| GGUF + mmap 零拷贝改造(本文方案) | 权重按需调页、内核自动回收 | 加载后仅 5.7 GB,可行 ✅ |
结论:8 GB 显存 + 16 GB 内存的消费级机器,走「GGUF 量化 + mmap 零拷贝 + 层卸载」路线可以完整跑通 U1 8-step Q4_K_S 的文生图;生成峰值显存约 3.3 GiB、内存峰值不超 10 G 护栏,系统全程流畅。
5.2环境安装
5.2.0. 前提
nvidia-smi        # 能看到 GPU
python3 --version # >= 3.10
systemd-run --user --scope -p MemoryMax=100M -- /bin/true
# 输出 "Running as unit: ..." → 内存护栏依赖的用户级 cgroup 可用
5.2.1. 安装 uv
# 官方安装脚本(推荐)
curl -LsSf https://astral.sh/uv/install.sh | sh
uv --version
5.2.2. 获取代码与安装依赖(含 GGUF 扩展)
git clone https://github.com/OpenSenseNova/SenseNova-U1.git cd SenseNova-U1 # 安装(含 gguf 扩展;国内加 HF_ENDPOINT 走镜像) HF_ENDPOINT=https://hf-mirror.com uv sync --extra gguf
--extra gguf扩展提供量化推理所需的 diffusers / gguf 权重解析(diffusers 0.37.1、gguf 0.19.0)。8 GB 显存必须走 GGUF 路线:bf16 全量权重需要 ≥ 36 GB 显存(见 5.1.2 资源约束分析)。
5.2.3. 应用低内存补丁(关键一步)
git apply lowram_patches.diff # 仓库自带的已验证补丁 # 验证(须 24 passed) uv pip install pytest .venv/bin/python -m pytest tests/test_layer_offload.py -q
补丁内容(默认关闭、环境变量开启,不改变上游默认行为):
| 环境变量 | 功能 |
|---|---|
U1_GGUF_MMAP=1 |
权重 mmap 零拷贝加载(核心:加载内存 14 G → 5.7 G) |
U1_LAYER_OFFLOAD_DISABLE_PIN=1 |
层卸载跳过 pin_memory 物理锁定 |
U1_LAYER_OFFLOAD_UNPINNED_FALLBACK=1 |
锁定失败时降级为普通内存而非崩溃 |
为什么要打补丁: 官方默认 GGUF 加载会把权重整体拷入内存并 pin 锁定(~14 GB RAM),16 GB 内存的机器必然卡死系统;mmap 零拷贝按需调页、内核自动回收,加载后 RSS 仅 5.7 GB。
5.2.4. 下载模型权重(13.9 GB)
mkdir -p models && cd models
ModelScope
curl -L -C - -o SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf \
  "https://modelscope.cn/api/v1/models/smthem/SenseNova-U1-8B-MoT/repo?Revision=master&FilePath=SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf"
5.2.5. 补齐配套资源文件
GGUF 权重不含 config/tokenizer,需从官方 8step-preview 仓库补齐 8 个小文件:
mkdir -p SenseNova-U1-8B-MoT-8step-preview && cd SenseNova-U1-8B-MoT-8step-preview
for f in config.json tokenizer_config.json special_tokens_map.json \
         added_tokens.json vocab.json merges.txt chat_template.jinja \
         model.safetensors.index.json; do
  curl -sL -o "$f" \
    "https://hf-mirror.com/sensenova/SenseNova-U1-8B-MoT-8step-preview/resolve/main/$f"
done
cd ../..
⚠️ curl 必须带
-L跟随重定向,否则保存下来的是 307 跳转页而非文件。可用head -c 100 config.json抽查:应是 JSON 而非 HTML。
5.2.6. 完整性校验
sha256sum models/SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf # f7ca062ce4f2c8ee09aa624d2158620eeaab7afb8ce8e4e9d23987738f2b8930 stat -c%s models/SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf # 13881801248
5.2.7. 安装启动脚本
创建 run_u1.sh,放在仓库根目录并赋权:
#!/bin/bash
# SenseNova-U1 低内存推理启动器(8GB 显存 / 16GB 内存机器专用)
# 用法:
# ./run_u1.sh "你的提示词" # 默认 1024x1024
# ./run_u1.sh "提示词" 2048 2048 # 指定宽高
# ./run_u1.sh "提示词" 2720 1536 my_out.png # 指定输出文件
set -euo pipefail
REPO=/home/nnly29/SenseNova-U1
PROMPT="${1:?用法: ./run_u1.sh \"提示词\" [宽] [高] [输出.png]}"
W="${2:-1024}"; H="${3:-1024}"
OUT="${4:-$REPO/outputs_lowram/gen_$(date +%m%d_%H%M%S).png}"
# 分辨率档位检查(与官方 SUPPORTED_RESOLUTIONS 对齐)
case "$W"x"$H" in
2048x2048|2720x1536|1536x2720|2496x1664|1664x2496|2368x1760|1760x2368|2880x1440|1440x2880|3456x1152|1152x3456) ;;
*) echo "[提示] ${W}x${H} 不在官方训练档位内,质量可能下降;推荐 2048x2048 或 2720x1536" >&2 ;;
esac
mkdir -p "$(dirname "$OUT")"
# cgroup 内存护栏: 超过上限只杀推理进程,不会拖死系统
exec systemd-run --user --scope \
-p MemoryHigh=7G -p MemoryMax=10G -p MemorySwapMax=256M \
--setenv=U1_GGUF_MMAP=1 \
--setenv=U1_LAYER_OFFLOAD_DISABLE_PIN=1 \
--setenv=U1_LAYER_OFFLOAD_UNPINNED_FALLBACK=1 \
--setenv=HF_HUB_OFFLINE=1 \
--setenv=PYTHONUNBUFFERED=1 \
"$REPO/.venv/bin/python" "$REPO/examples/t2i/inference.py" \
--model_path "$REPO/models/SenseNova-U1-8B-MoT-8step-preview" \
--gguf_checkpoint "$REPO/models/SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf" \
--vram_mode low \
--prompt "$PROMPT" \
--width "$W" --height "$H" \
--cfg_scale 1.0 --cfg_norm none --timestep_shift 3.0 --num_steps 8 \
--seed 42 --attn_backend sdpa --profile \
--output "$OUT"
chmod +x run_u1.sh
脚本内置三层保障:
-
cgroup 内存护栏:
MemoryHigh=7G(软限开始回收)、MemoryMax=10G(硬限只杀进程)、MemorySwapMax=256M(防 swap 抖动)——任何异常都不会拖死系统; -
三个内存优化环境变量(见 5.2.3 表格);
-
离线运行(
HF_HUB_OFFLINE=1),推理过程不依赖网络。
5.2.8.(可选)注册 nova生图 快捷命令
将以下函数追加到 ~/.bashrc 并重开终端。之后任意目录敲 nova生图 即可自动 cd 到仓库、显示状态与用法提示(防遗忘)、带提示词直接启动生图。
# ═══ nova 生图助手(SenseNova-U1 低内存推理)═══
nova生图() {
  cd "$HOME/SenseNova-U1" || { echo "❌ 找不到 ~/SenseNova-U1"; return 1; }
  if [ $# -eq 0 ]; then
    echo "═══════ nova 生图助手 ═══════"
    if [ -f models/SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf ]; then
      echo "✅ 模型文件就绪 (13.9GB Q4_K_S 已校验)"
    else
      echo "❌ 模型文件缺失,需要重新下载后再用"
    fi
    echo ""
    echo "启动生图: ./run_u1.sh \"你的提示词\""
    echo "带尺寸:   ./run_u1.sh \"你的提示词\" 2048 2048"
    echo "示例:     nova生图 \"一只橘猫在窗台晒太阳\""
    echo "(等效于:  ./run_u1.sh \"一只橘猫在窗台晒太阳\")"
    return 0
  fi
  echo "🚀 正在启动生图(内存护栏 MemoryMax=10G 已开启,预计约 12 分钟/张)..."
  ./run_u1.sh "$@"
  local rc=$?
  if [ $rc -eq 0 ]; then
    echo "✅ 生图完成,图片在 ~/SenseNova-U1/outputs_lowram/"
  else
    echo "❌ 生图失败 (exit $rc),可查看上方日志定位原因"
  fi
  return $rc
}
5.2.9. 验证环境
.venv/bin/python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
# 期望输出: 2.8.0+cu128 True
torch 为 cu128 构建,此处返回
True即说明 CUDA 链路可用;配合nvidia-smi可见 GPU,环境就绪。推理时脚本内置HF_HUB_OFFLINE=1,无需联网。
5.3运行推理示例
所有示例统一通过 run_u1.sh 启动(内置 cgroup 内存护栏与三个 U1_* 环境变量);--model_path 指向本地配套资源目录,--gguf_checkpoint 指向量化权重。公共参数:
| 参数 | 建议值 | 说明 |
|---|---|---|
--vram_mode |
low |
8 GB 显存用分层卸载;显存富余可改 balanced 提速(异步预取) |
--attn_backend |
sdpa |
显式使用 torch SDPA,避免回退争议 |
--num_steps |
8 | 8step 蒸馏模型专用步数,勿随意调高 |
--cfg_scale |
1.0 | 8-step 蒸馏权重使用 1.0 |
--profile |
建议开启 | 打印耗时与峰值显存 |
5.3.1. 文生图(t2i)验证案例
使用官方 README 的 GGUF 示例提示词运行文生图:
./run_u1.sh "A male peacock trying to attract a female"
# 或使用官方训练档位分辨率(质量更好,约 25-40 分钟)
./run_u1.sh "A male peacock trying to attract a female" 2048 2048
实测终端输出:量化张量全部解析、592 个在线反量化层激活,全程约 13 分钟(模型加载仅 4.2 秒,其余为 8 步去噪采样的逐层 CPU↔GPU 搬运):
Running as unit: run-xxxxx.scope; invocation ID: ...
[attn] backend='sdpa' (effective='sdpa')
[gguf] loading quantized checkpoint from .../SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf
[gguf] parsed 1116 tensors                      ← 量化张量全部解析成功
[gguf] 592 GGUFLinear modules active            ← 592 个在线反量化层激活
[warn] (1024x1024) is outside the trained resolution set; ...
[saved] /home/nnly29/SenseNova-U1/outputs_lowram/peacock_1024.png
5.3.2. 生成结果
产物为 outputs_lowram/peacock_1024.png,1024×1024 PNG(2.3 MB);内容为一只开屏的雄性蓝孔雀与一只侧立的雌孔雀,羽毛眼状斑纹与背景虚化自然,完全符合提示词语义("A male peacock trying to attract a female")。
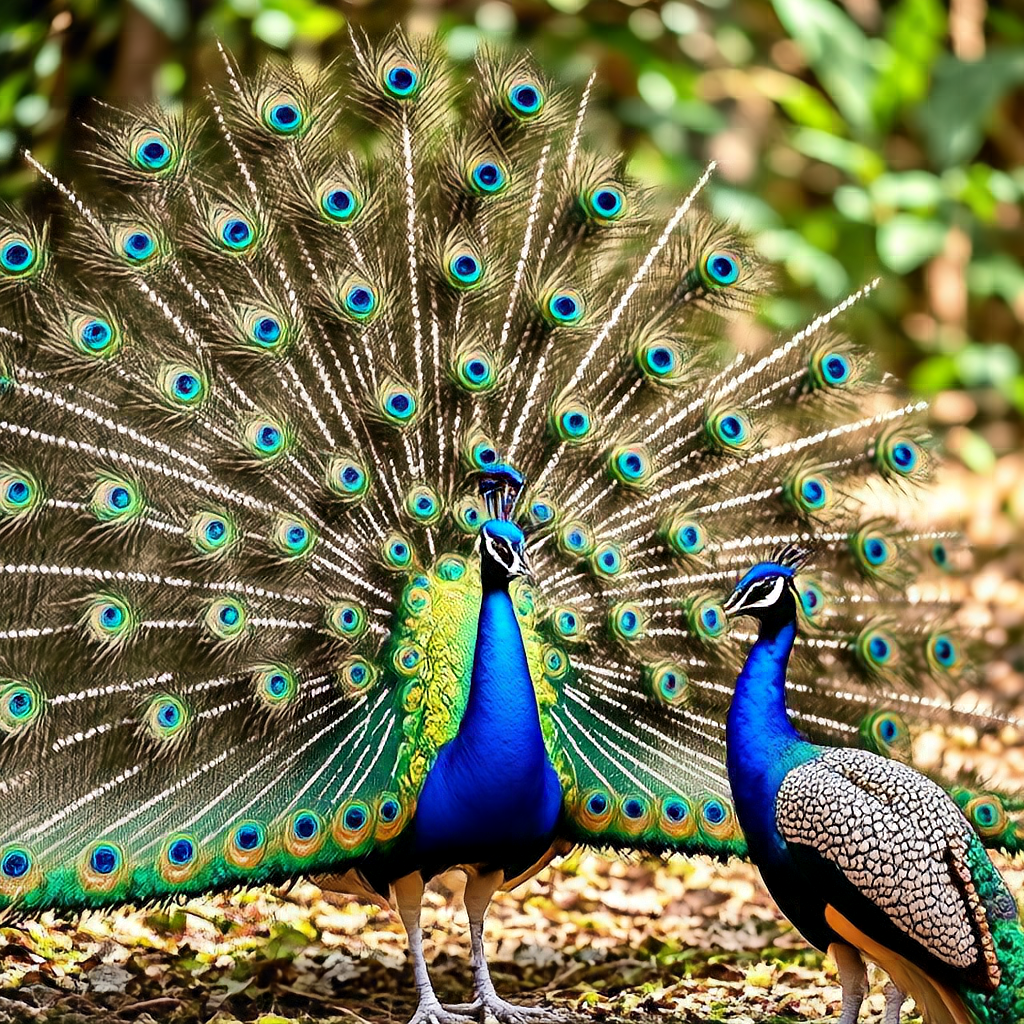
可见:画面主体与提示词完全一致。该图为本次部署验证案例的实际产出(Q4_K_S 量化 +
vram_mode low+ 8 步采样),未做任何后期处理。
5.3.3. 性能档案(--profile 输出原文)
================================================================
Profile summary
================================================================
  config              : vram_mode=low, attn_backend=sdpa, dtype=bfloat16, gguf=...Q4_K_S.gguf
  model load          :    4.238 s
  load peak memory    : cpu RSS 5.71 GiB        ← mmap 加载生效的标志
  generations         : 1 call(s), 1 image(s) total, 759.000 s wall
  avg per image       :  759.000 s
  image tokens        : patch_size=32, avg 1024 tok/image (1024)
  throughput          :     1.35 tok/s
  generation peak mem : allocated 2.95 GiB, reserved 3.11 GiB, cpu RSS 8.28 GiB
5.3.4. 资源占用汇总(实测)
| 指标 | 数值 | 对照 |
|---|---|---|
| 加载后内存 | 5.71 GiB RSS | 官方默认方式需 ~14 GB,本方案降 60% |
| 生成期内存峰值 | 8.28 GiB RSS | 低于 10 G 护栏,系统全程流畅 |
| 显存峰值 | ~3.3 GiB / 8 GiB | 余量充足 |
| 单张耗时 | 759 s(1024×1024,8 步) | vram_mode low 逐层搬运是瓶颈 |
| 生成中系统可用内存 | ≥ 8 GB | 桌面 / 其他应用无感知 |
5.4日常使用
nova生图                          # 显示状态与用法提示
nova生图 "一只橘猫在窗台晒太阳"      # 生图,约 12 分钟
nova生图 "提示词" 2048 2048        # 官方训练档位,质量最佳
推荐分辨率(官方训练档位):2048x2048、2720x1536(16:9)、2496x1664(3:2)、2368x1760(4:3)、2880x1440(2:1)、3456x1152(3:1)。非档位分辨率可用但质量会下降(运行时自动提示)。
其他调参(改 run_u1.sh 内对应行):
| 参数 | 当前值 | 说明 |
|---|---|---|
--seed |
42 | 换随机效果 |
--vram_mode |
low | 显存富余可改 balanced 提速(异步预取) |
--num_steps |
8 | 8step 蒸馏模型专用步数,勿随意调高 |
5.5低资源适配说明与已知问题
-
方案定位:官方 bf16 全量权重需 ≥ 36 GB 显存;本章是社区级低资源路线——「Q4_K_S 量化 + mmap 零拷贝 + 层卸载」让 8 GB 显存 + 16 GB 内存的机器跑通,且不改变上游默认行为(补丁全部由环境变量开启)。
-
加载内存:
U1_GGUF_MMAP=1开启后,加载 RSS 从 ~14 GB 降至 5.7 GB;--profile输出中load peak memory: cpu RSS 5.71 GiB即为生效标志。 -
pin_memory:可用内存不足以页锁定时会打印
pin_memory failed警告,属预期降级(性能略降可继续),不会拖死系统。 -
推理耗时:
vram_mode low的逐层 CPU↔GPU 搬运是瓶颈,1024×1024 约 13 分钟/张、2048×2048 约 25–40 分钟/张,属正常水平。 -
离线运行:脚本内置
HF_HUB_OFFLINE=1,推理不依赖网络;如遇 HF 网络超时,先确认该项生效。
故障排查速查:
| 现象 | 原因 | 处理 |
|---|---|---|
| sha256 校验不过 | 下载不完整/被跳转页污染 | 删除重下;确认 curl 带 -L |
| 下载速度 KB/s 级 | hf-mirror 限流 | 换 ModelScope 源(5.2.4 方式 A) |
IndexError in layer_offload |
补丁未应用或不完整 | 重新 git apply lowram_patches.diff |
| 内存吃满/系统卡顿 | 三个 U1_* 环境变量未生效 |
确认通过 run_u1.sh(或附录 B 函数)启动 |
pin_memory failed 警告 |
可用内存不足以页锁定 | 属预期降级,性能略降可继续 |
| HF 网络超时 | 推理时未离线 | 确认 HF_HUB_OFFLINE=1(脚本已内置) |
| 提示分辨率不在训练档位 | 非标准宽高 | 换 5.4 节列出的官方档位 |
5.6一页速查
# 环境(一次性) curl -LsSf https://astral.sh/uv/install.sh | sh git clone https://github.com/OpenSenseNova/SenseNova-U1.git && cd SenseNova-U1 HF_ENDPOINT=https://hf-mirror.com uv sync --extra gguf git apply lowram_patches.diff mkdir -p models && cd models curl -L -C - -o SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf \ "https://modelscope.cn/api/v1/models/smthem/SenseNova-U1-8B-MoT/repo?Revision=master&FilePath=SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf" sha256sum SenseNova-U1-8B-MoT-8step-Q4_K_S.gguf # f7ca062ce4f2c8ee09aa624d2158620eeaab7afb8ce8e4e9d23987738f2b8930 cd .. # 补齐 8 个 config/tokenizer 小文件(见 5.2.5),安装 run_u1.sh(附录 A)并 chmod +x # 运行(每次) ./run_u1.sh "你的提示词" # 默认 1024x1024,约 13 分钟 ./run_u1.sh "你的提示词" 2048 2048 # 官方训练档位,质量最佳
第六章 SenseNova-U1.5 在华为昇腾 910B(NPU)上的部署与运行指南
6.1设备与运行环境
6.1.1. 硬件 / 驱动 / CANN 一览
| 类别 | 实测值 |
|---|---|
| 操作系统 | Ubuntu 22.04.5 LTS(容器环境,aarch64 / 鲲鹏) |
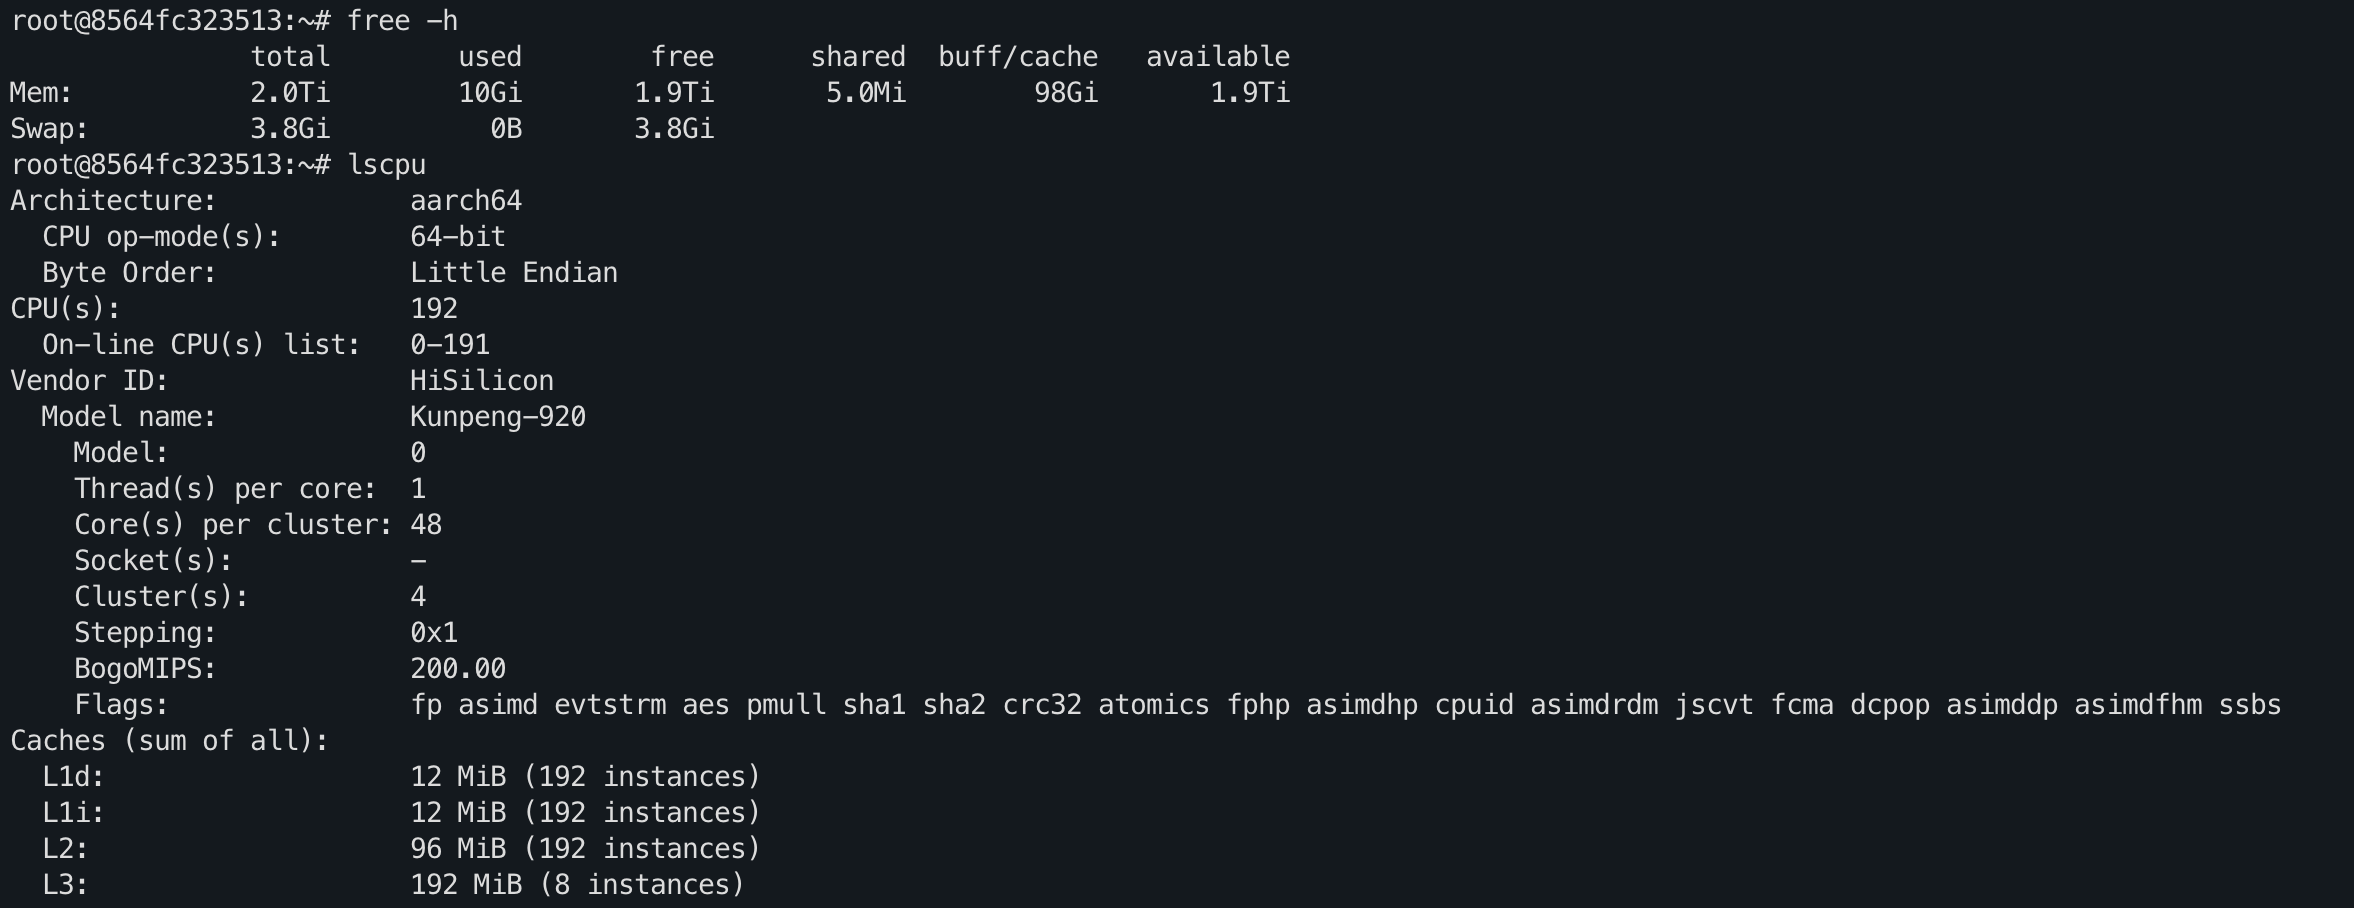
| CPU / 内存 | 20 核 / 2.0 TB(free -h ) |
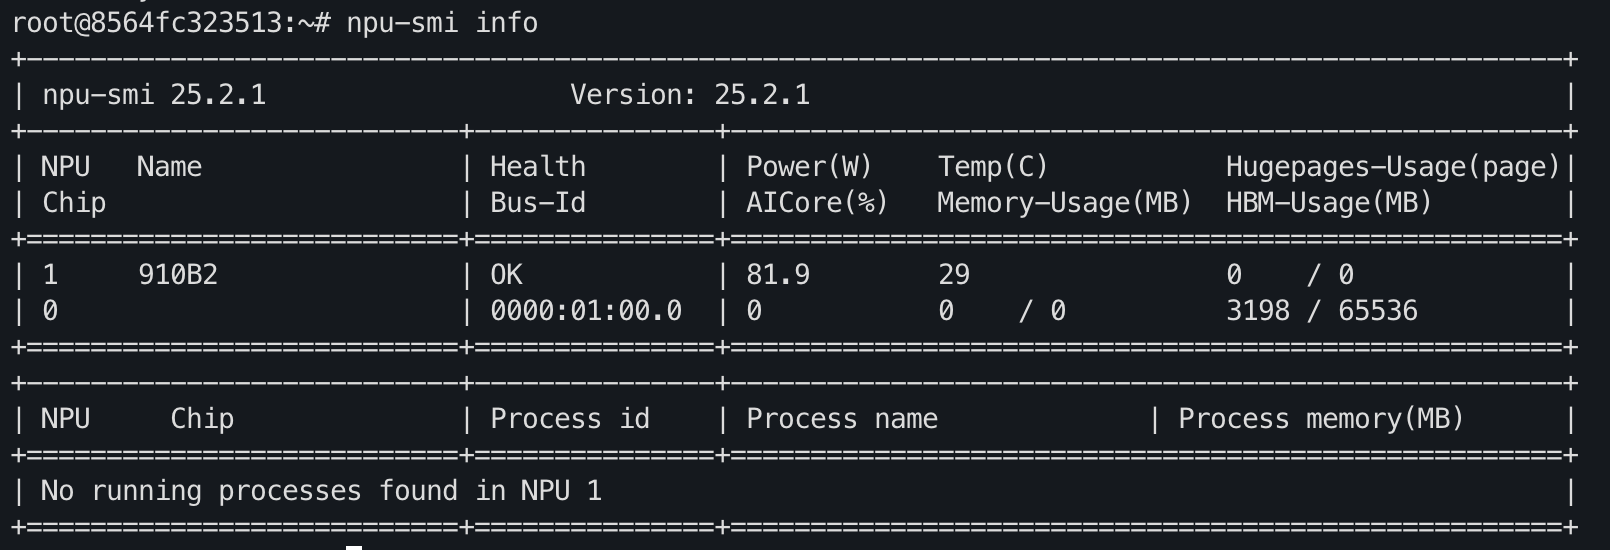
| NPU | 华为昇腾 910B2,64 GB HBM(65536 MB,系统常驻约 3.2 GB) |
| 驱动 | npu-smi 25.2.1 |
| CANN | 8.5.1(含 nnal/atb), /usr/local/Ascend/ |
| Python | 3.11.14(/usr/local/python3.11.14) |
| 关键软件栈 | torch 2.9.0 + torch_npu 2.9.0 + transformers 5.3.0 |
| 模型 | SenseNova/SenseNova-U1.5-8B-MoT |
| 目录 | 仓库 /root/SenseNova-U1;模型 /root/SenseNova-U1.5-8B-MoT |
先用 npu-smi 确认驱动与芯片状态:
npu-smi info
输出:
CPU / 内存概况(free -h + lscpu):
非交互 shell 注意: 通过脚本/非交互 SSH 执行命令时
.bashrc不会加载,需要手动:export PATH=/usr/local/python3.11.14/bin:$PATH source /usr/local/Ascend/ascend-toolkit/set_env.sh否则会出现
npu-smi: error while loading shared libraries: libc_sec.so和python3: command not found——这两个都不是环境故障,只是环境变量未加载。交互式登录时.bashrc已自动加载,无需处理。
6.1.2. 实测性能(单卡 64 GB,2048×2048)
| 指标 | W7900 参考(第三章,SDPA) | 910B2 实测 |
|---|---|---|
| 注意力后端 | torch SDPA | torch SDPA(auto 生效值,同) |
| 模型加载 | 约 20.1 s | 7.0–7.3 s |
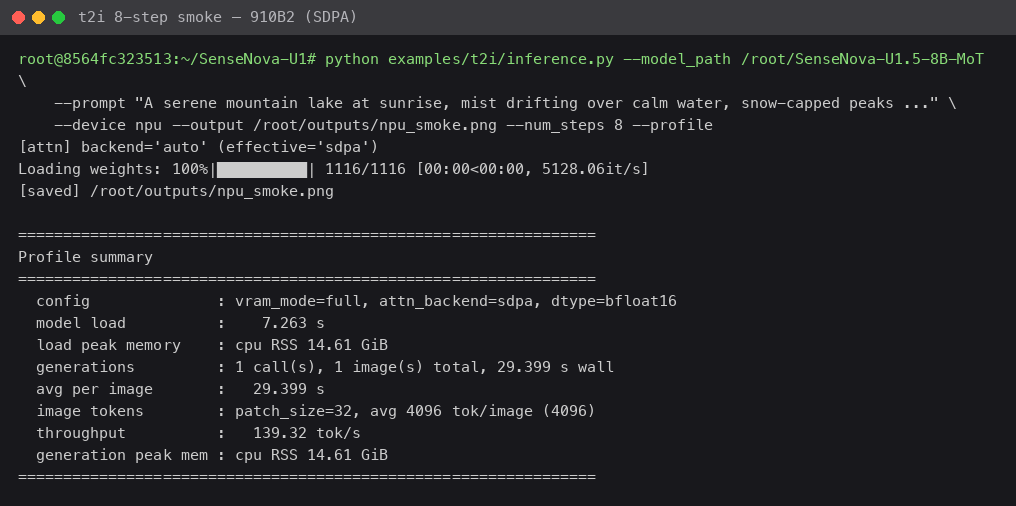
| 8 步冒烟生成 | 44.8 s/张(91.34 tok/s) | 29.4 s/张(139.32 tok/s)(首跑含 TBE 算子编译) |
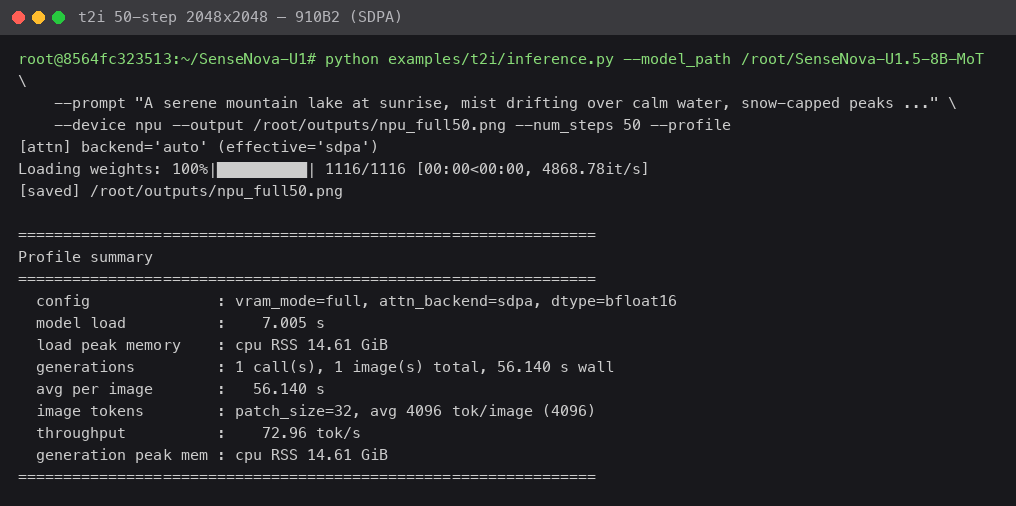
| 50 步正式生成 | 274.0 s/张(14.95 tok/s) | 56.1 s/张(72.96 tok/s),稳态约 1.1 s/步 |
| 图像编辑 | 493.2 s/张(8.17 tok/s) | 66.1 s/张(60.96 tok/s,4029 tok) |
| 图文交错生成 | - | 797 s(13.3 分钟):7 张 2048×1152 + 长文本,单图速率 1.77→1.14 it/s 随上下文递减 |
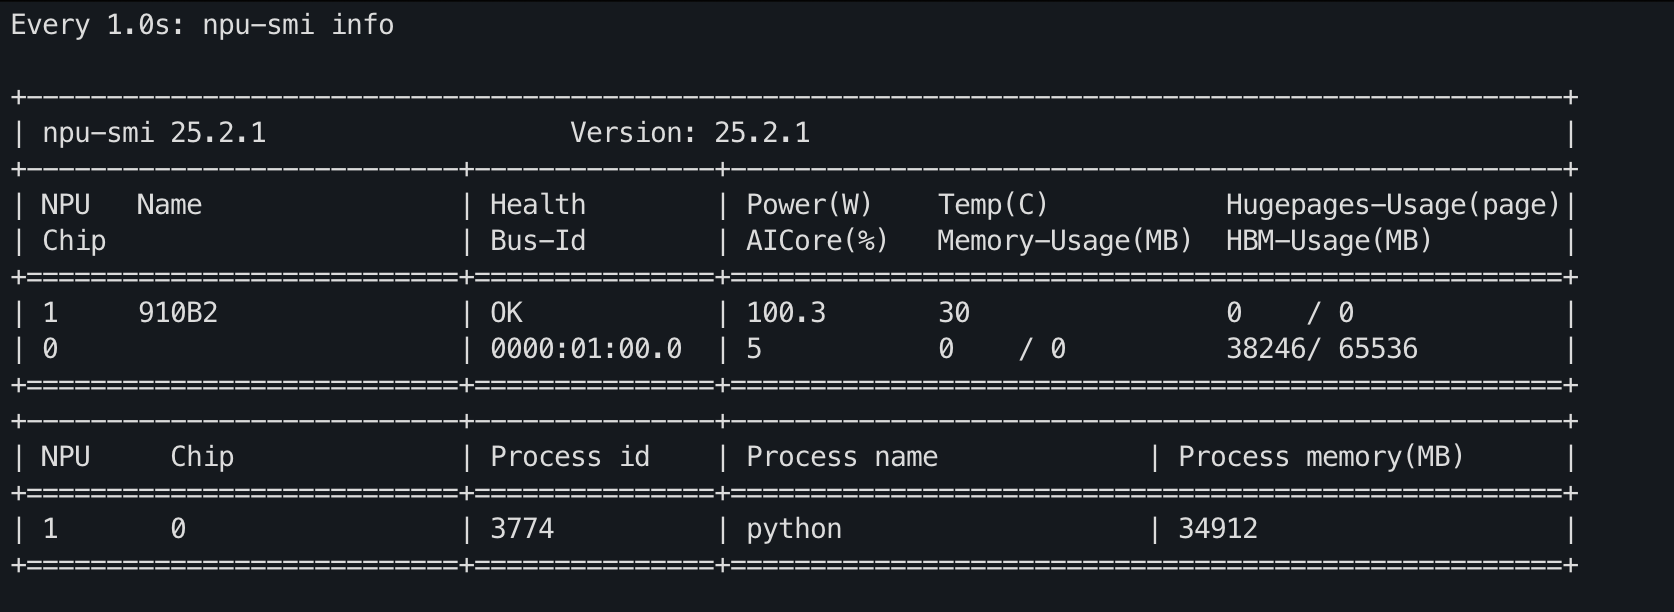
| 生成阶段峰值显存 | allocated 34.87–39.39 GiB | HBM 40427 / 65536 MB(约 39.5 GiB,含系统常驻 3.2 GB),npu-smi 采样观测 |
模型加载完成后开始生成时,用 watch -n 1 npu-smi info 观测到的运行时状态:
6.2环境安装
6.2.0. 前提
-
平台镜像「Pytorch2.9-Ascend」已预装 torch 2.9.0 / torch_npu 2.9.0 / CANN 8.5.1 / Python 3.11.14
-
网络实测:
pypi.org正常、modelscope.cn正常 -
仓库已克隆到
/root/SenseNova-U1,模型下载到/root/SenseNova-U1.5-8B-MoT:
# 仓库(已完成) cd /root git clone https://github.com/OpenSenseNova/SenseNova-U1.git # 模型(约 33 GB) modelscope download --model SenseNova/SenseNova-U1.5-8B-MoT --local_dir ./SenseNova-U1.5-8B-MoT
6.2.1. 安装项目本体与缺失依赖(关键一步:--no-deps)
cd /root/SenseNova-U1 # 项目本体:跳过依赖自动安装,避免 pip 把 torch==2.8.0+cu128 拉回来覆盖 torch_npu pip install -e . --no-deps # 镜像里缺的纯 Python 依赖(实测缺口:sentencepiece;tqdm/httpx 一并补上) pip install sentencepiece==0.2.1 tqdm==4.67.1 "httpx>=0.27,<1" "packaging>=25.0" # CANN TBE 算子编译组件的 Python 依赖(实测必装,否则首个卷积算子报 EC0010,见 6.5) pip install decorator attrs cloudpickle
| 包 | 镜像实测 | 项目要求 | 判定 |
|---|---|---|---|
| torch / torch_npu | 2.9.0 / 2.9.0 | FAQ 认可 aarch64 用 torch 2.9 | ✅ |
| transformers | 5.3.0 | >=4.57.1,<6 |
✅ |
| accelerate | 1.13.0 | >=1.1,<2 |
✅ |
| safetensors | 0.7.0 | >=0.4.3,<1 |
✅ |
| numpy | 2.4.3 | >=1.24,<3 |
✅ |
| huggingface-hub | 1.7.1 | >=0.34,<2 |
✅ |
| pillow | 12.1.1 | ==12.0.0 |
⚠️ 小版本差异,--no-deps 下不冲突,运行无影响 |
| sentencepiece | 未安装 | ==0.2.1 |
❌ 需补装(命令已含) |
6.2.2.(可选)GGUF 低显存扩展
64 GB 的 910B2 走 full 模式用不到;仅在把本指南套用到 32 GB 卡(910B3/B4)时才需要:
pip install "gguf>=0.10.0" "diffusers>=0.30.0"
6.2.3. NPU 设备补丁(唯一必需的代码改动)
推理代码本身设备无关,但 src/sensenova_u1/utils/accel.py 的设备白名单只有 ("cuda", "xpu")。不打补丁的两个后果:
-
示例脚本的默认设备由
best_available_device()决定,NPU 机器上会静默返回 CPU(慢到不可用,且无报错); -
--vram_mode fast/balanced/low在layer_offload.py里调用require_accelerator(),对npu直接抛NotImplementedError。
在仓库根目录执行一次性补丁脚本(原理:仿照文件内 flash-attn 的 try/except 导入模式,把 torch.npu 纳入 accel_module 抽象;CUDA / XPU 机器行为完全不变):
cd /root/SenseNova-U1
python3 - <<'EOF'
from pathlib import Path
f = Path("src/sensenova_u1/utils/accel.py")
s = f.read_text()
# 1) 顶部守护导入 torch_npu(未安装时自动降级,不影响其它后端)
s = s.replace(
"from __future__ import annotations\n\nimport torch\n",
"from __future__ import annotations\n\nimport torch\n\n"
"try:\n import torch_npu # type: ignore[import-untyped]\n\n"
" _HAS_TORCH_NPU = True\nexcept ImportError:\n _HAS_TORCH_NPU = False\n",
)
# 2) 设备白名单加 npu
s = s.replace(
'SUPPORTED_DEVICE_TYPES: tuple[str, ...] = ("cuda", "xpu")',
'SUPPORTED_DEVICE_TYPES: tuple[str, ...] = ("cuda", "xpu", "npu")',
)
# 3) accel_module 加 npu 命名空间
s = s.replace(
' if device.type == "xpu":\n return torch.xpu\n',
' if device.type == "xpu":\n return torch.xpu\n if device.type == "npu":\n return torch.npu\n',
)
# 4) is_available 加 npu 分支
s = s.replace(
' if device_type == "xpu":\n return torch.xpu.is_available()\n return False',
' if device_type == "xpu":\n return torch.xpu.is_available()\n'
' if device_type == "npu":\n return _HAS_TORCH_NPU and torch.npu.is_available()\n return False',
)
# 5) best_available_device 优先级:CUDA > NPU > XPU > CPU
s = s.replace(
' if torch.cuda.is_available():\n return torch.device("cuda")\n'
' if torch.xpu.is_available():\n return torch.device("xpu")\n return torch.device("cpu")',
' if torch.cuda.is_available():\n return torch.device("cuda")\n'
' if _HAS_TORCH_NPU and torch.npu.is_available():\n return torch.device("npu")\n'
' if torch.xpu.is_available():\n return torch.device("xpu")\n return torch.device("cpu")',
)
# 6) empty_cache(device=None) 分支
s = s.replace(
' if torch.xpu.is_available():\n torch.xpu.empty_cache()\n return',
' if torch.xpu.is_available():\n torch.xpu.empty_cache()\n'
' if _HAS_TORCH_NPU and torch.npu.is_available():\n torch.npu.empty_cache()\n return',
)
# 7) synchronize(device=None) 分支
s = s.replace(
' if torch.xpu.is_available():\n torch.xpu.synchronize()\n return',
' if torch.xpu.is_available():\n torch.xpu.synchronize()\n'
' if _HAS_TORCH_NPU and torch.npu.is_available():\n torch.npu.synchronize()\n return',
)
# 8) manual_seed_all 分支
s = s.replace(
' if torch.xpu.is_available():\n torch.xpu.manual_seed_all(seed)',
' if torch.xpu.is_available():\n torch.xpu.manual_seed_all(seed)\n'
' if _HAS_TORCH_NPU and torch.npu.is_available():\n torch.npu.manual_seed_all(seed)',
)
f.write_text(s)
print("accel.py patched OK")
EOF
补丁共 8 处,全部集中在
accel.py一个文件;require_accelerator()读白名单,无需单独改。手工修改也可,对应关系即上表 8 条。
零改动备选方案:
python -c "from torch_npu.contrib import transfer_to_npu"的 shim 会把torch.cuda.*全部映射到torch.npu.*,不改编译码即可运行(best_available_device()会返回 "cuda" 并落到 NPU)。本章主路线采用显式补丁(设备名清晰、不依赖 shim 的全局替换行为),shim 仅作快速验证备选。
6.2.4. 验证环境
python3 -c "
import torch, torch_npu
print('torch:', torch.__version__, '| torch_npu:', torch_npu.__version__)
print('npu available:', torch_npu.npu.is_available(), '| devices:', torch_npu.npu.device_count())
x = torch.randn(1024, 1024, device='npu', dtype=torch.bfloat16)
print('bf16 matmul OK:', float((x @ x).sum()))
q = torch.randn(1, 8, 4096, 128, device='npu', dtype=torch.bfloat16)
o = torch.nn.functional.scaled_dot_product_attention(q, q, q)
print('SDPA OK:', tuple(o.shape))
"
预期输出(节选):
torch: 2.9.0+cpu | torch_npu: 2.9.0
npu available: True | devices: 1
bf16 matmul OK: ...
SDPA OK: (1, 8, 4096, 128)
SDPA 是 U1.5 在 NPU 上的实际注意力路径(见 6.5),单独验证一次可以提前暴露内核问题。
6.3运行推理示例
所有命令在 /root/SenseNova-U1 下执行;--model_path 指向 /root/SenseNova-U1.5-8B-MoT。公共参数:
| 参数 | 建议值 | 说明 |
|---|---|---|
--device |
npu(打了 6.2.3 补丁后可省略,默认自动选 NPU) |
补丁前省略会静默跑 CPU |
--attn_backend |
auto(默认)或 sdpa |
NPU 上无 flash-attn,auto 自动落 SDPA;如介意日志噪音可显式 sdpa |
--dtype |
bfloat16(默认) |
910B2 原生支持 bf16 |
--num_steps |
50(默认) | 冒烟测试设 8 快速验证链路 |
--cfg_scale |
4.0(默认) | 8-step 蒸馏 LoRA 才用 1.0 |
--profile |
建议开启 | 打印耗时;显存统计仅 cuda 设备采集(见 6.5) |
运行时观测 NPU 状态
watch -n 1 npu-smi info
6.3.1. 文生图(t2i)
8 步冒烟测试:
python examples/t2i/inference.py \
  --model_path /root/SenseNova-U1.5-8B-MoT \
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --device npu \
  --output /root/outputs/npu_smoke.png \
  --num_steps 8 --profile
终端输出:attn backend='auto' (effective='sdpa')、模型加载 7.26 s、8 步生成 29.4 s、吞吐 139.32 tok/s(首跑含一次性 TBE 算子编译,见 6.1.2):
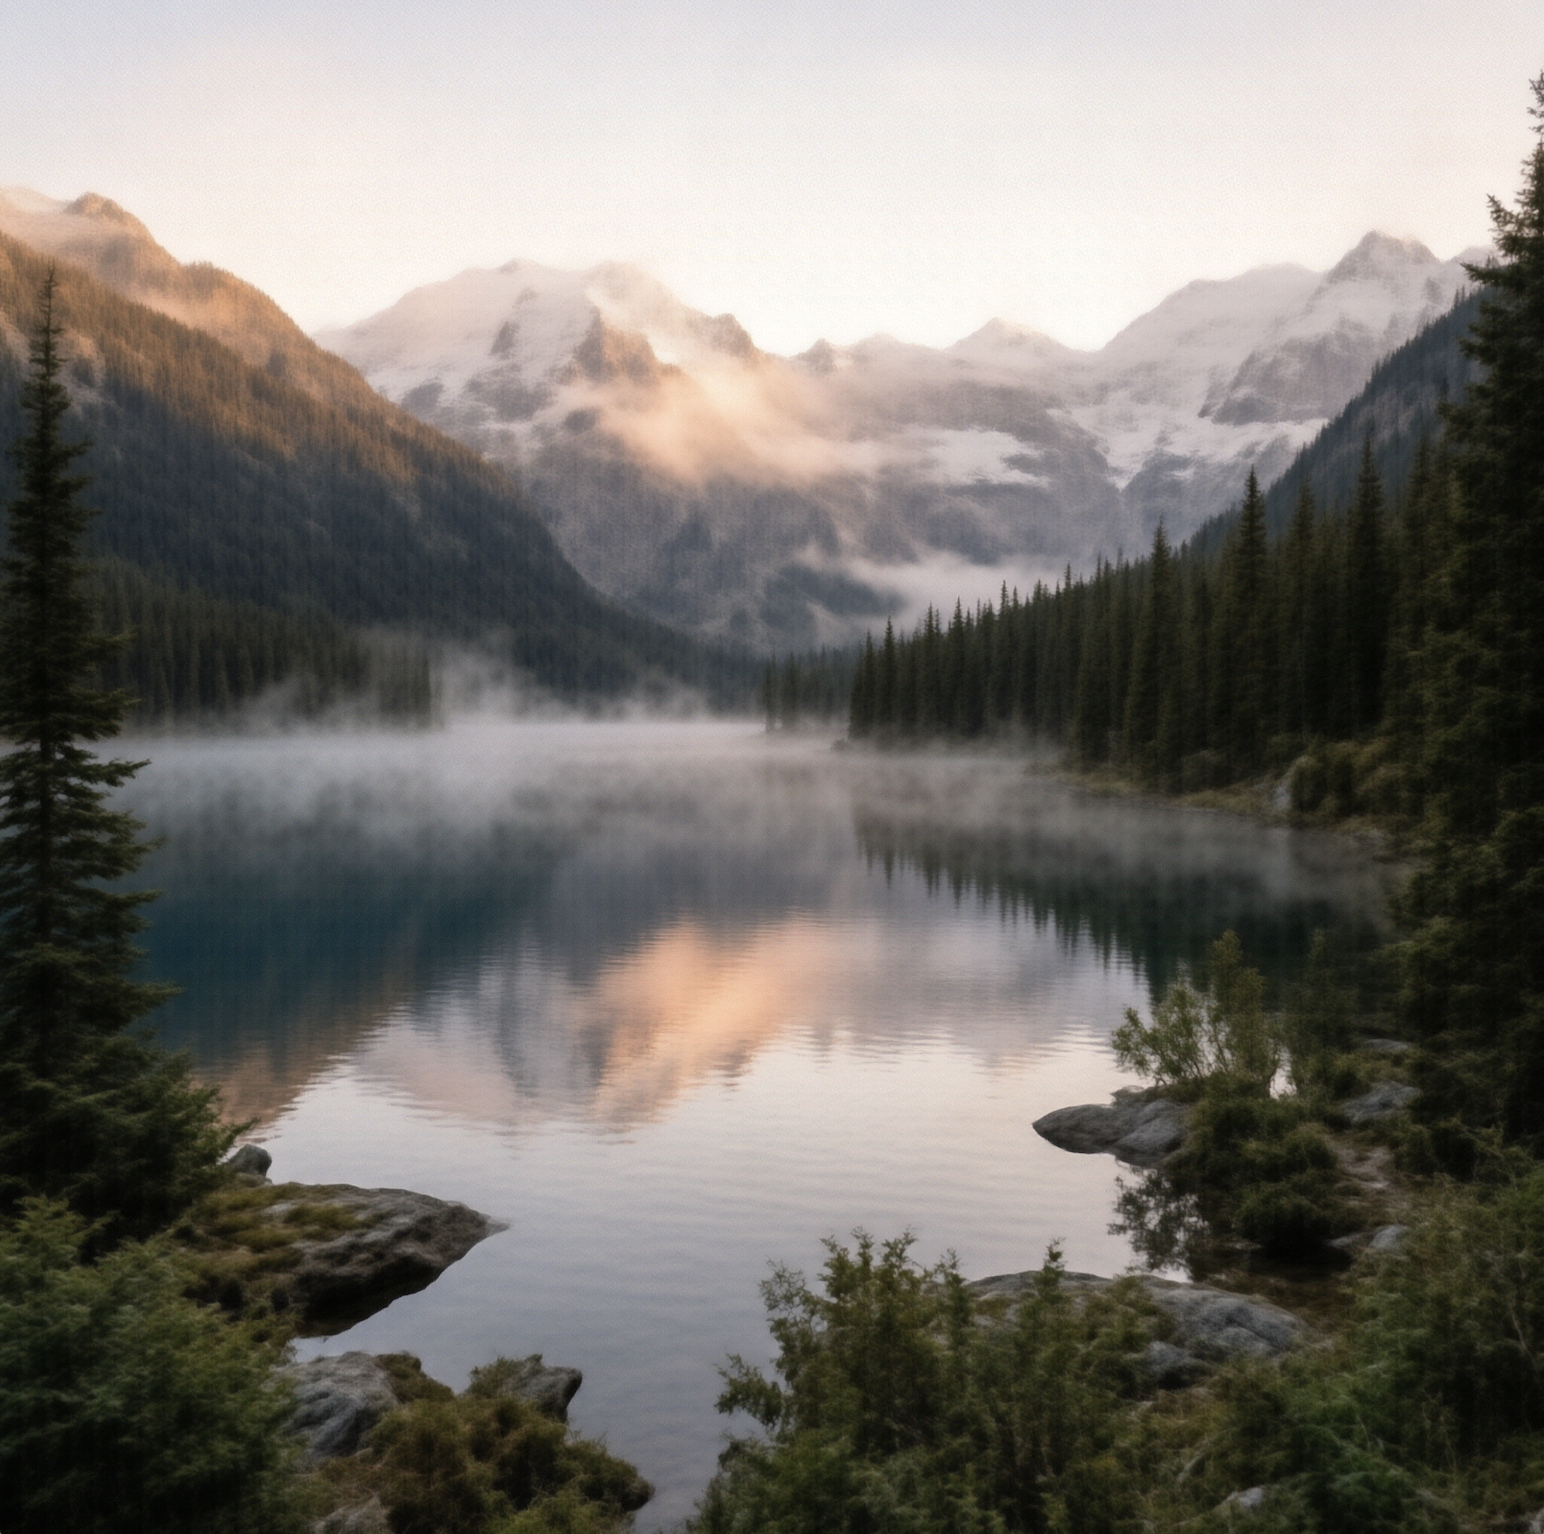
生成结果(outputs/npu_smoke.png,2048×2048):
50 步正式生成(默认 2048×2048):
python examples/t2i/inference.py \
  --model_path /root/SenseNova-U1.5-8B-MoT \
  --prompt "A serene mountain lake at sunrise, mist drifting over calm water, snow-capped peaks in the background, photorealistic, high detail" \
  --device npu \
  --output /root/outputs/npu_full50.png \
  --num_steps 50 --profile
终端输出:模型加载 7.0 s、50 步生成 56.1 s、吞吐 72.96 tok/s(对比 W7900 的 274 s,快约 4.9 倍):
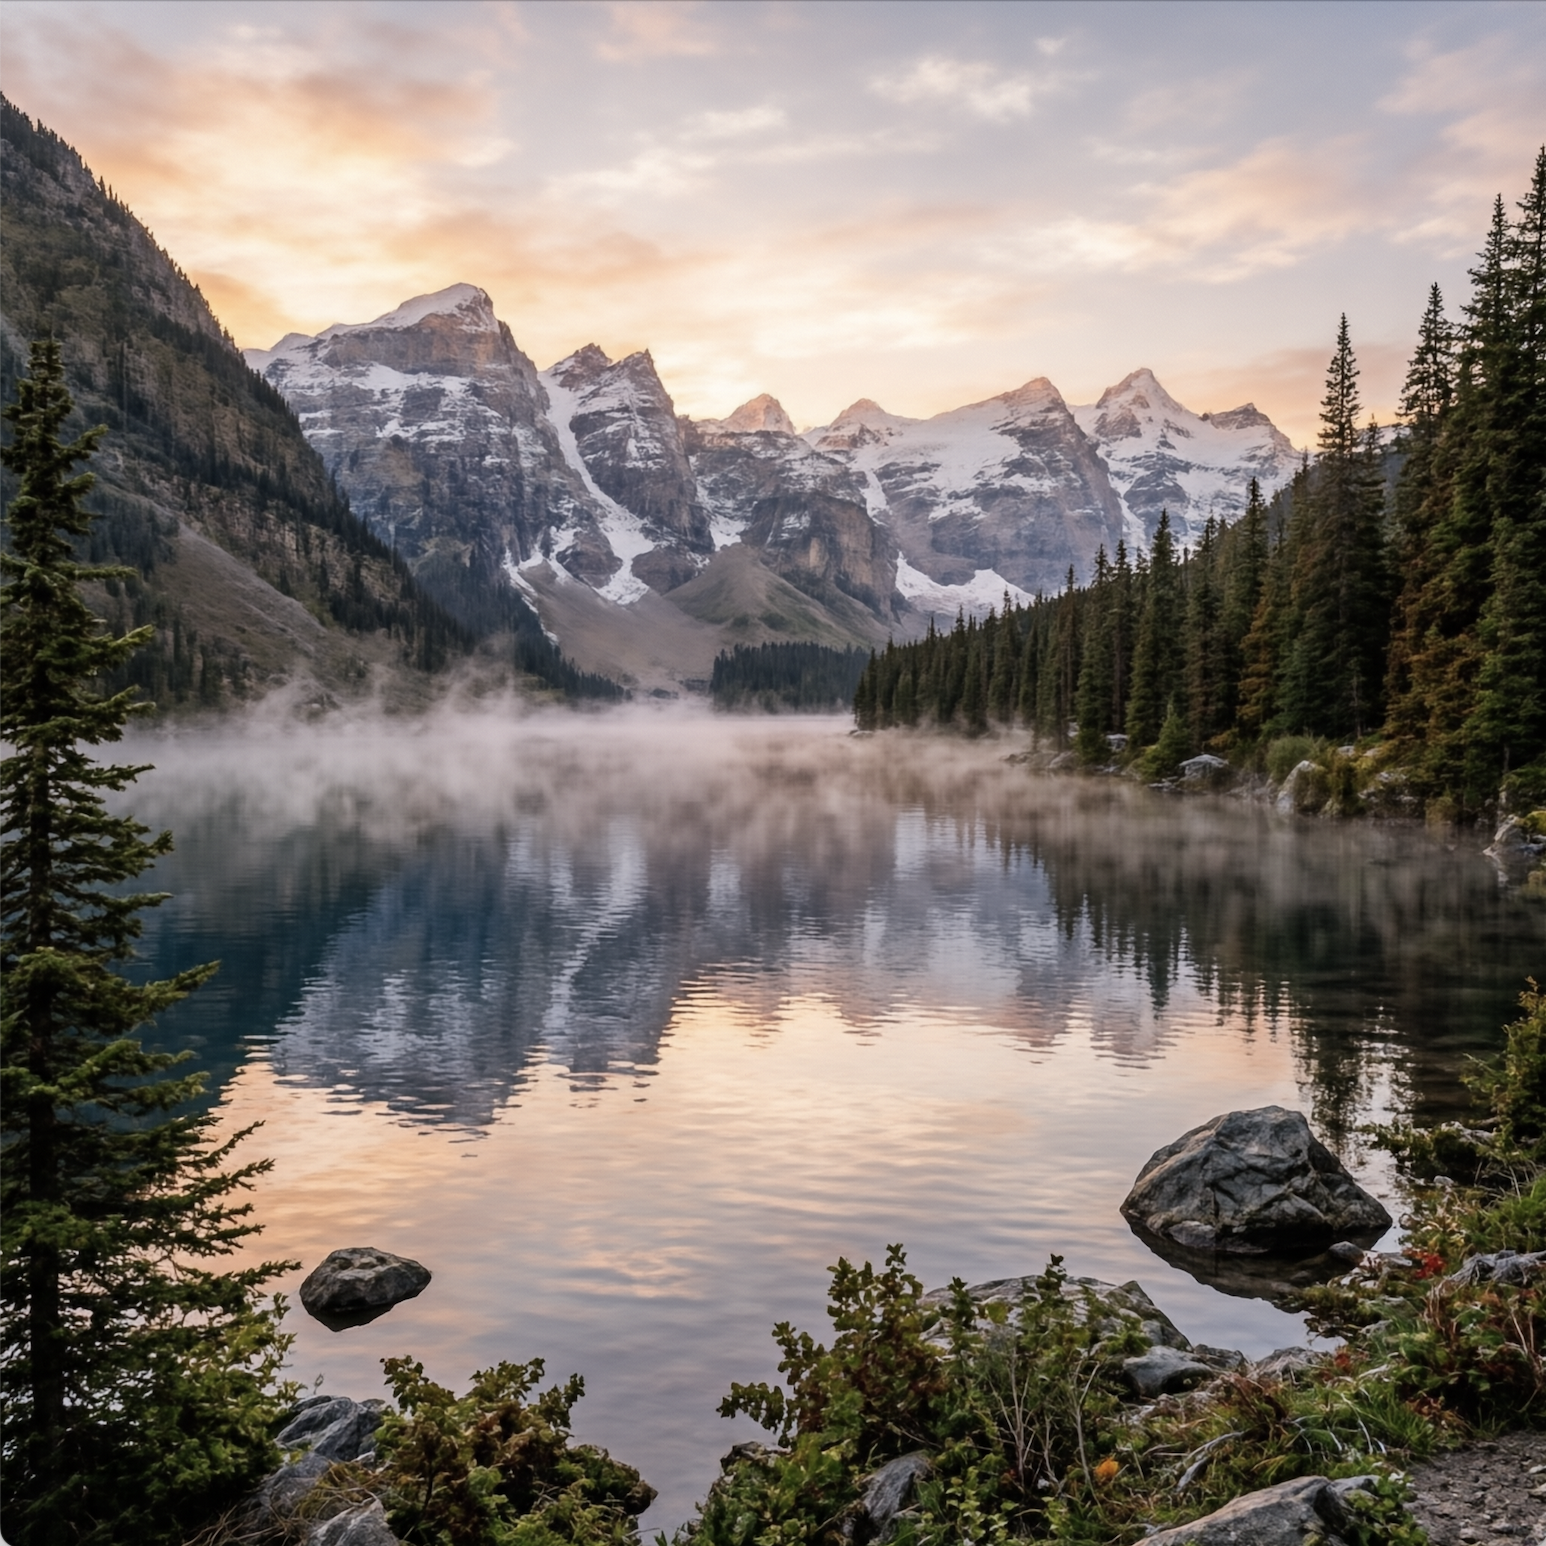
生成结果(outputs/npu_full50.png,2048×2048):
批量 / 其他分辨率(训练档位见 examples/README_CN.md,如 16:9 → 2720×1536);带推理的 think 模式可追加 --think --print_think。
6.3.2. 视觉理解(VQA)
python examples/vqa/inference.py \
  --model_path /root/SenseNova-U1.5-8B-MoT \
  --device npu \
  --image examples/vqa/data/images/image1.jpg \
  --question "Describe the image content."
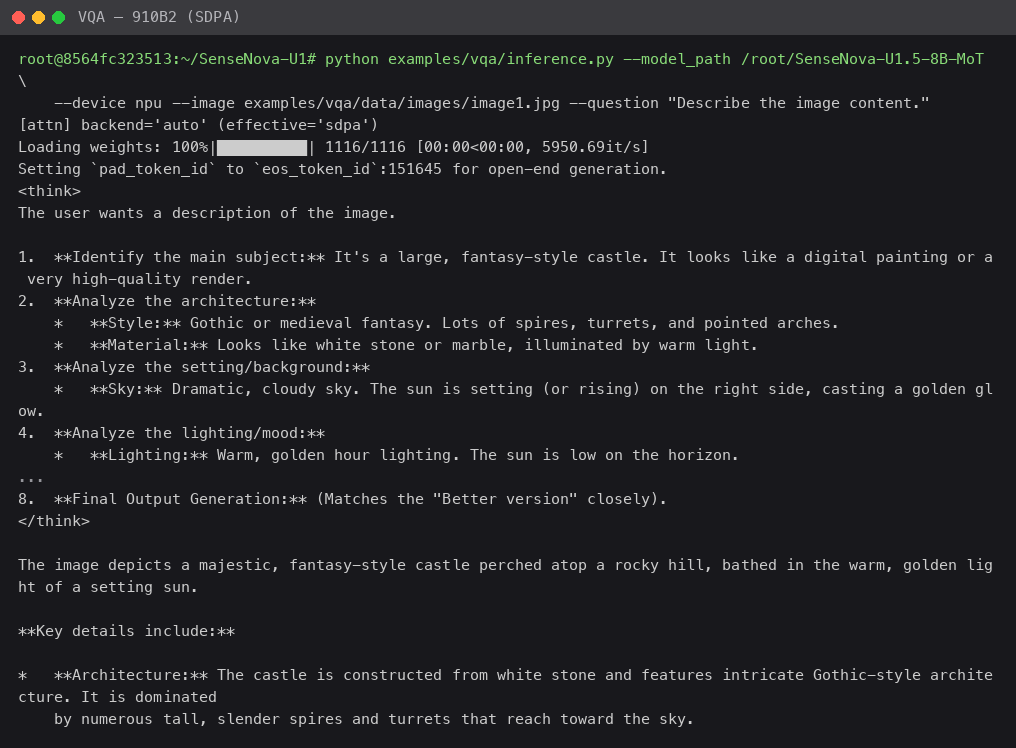
模型先输出 think 推理再给出描述:全程 4 分 05 秒(含加载),正确识别画面主体(山丘上的哥特风格城堡、白色石墙、暖金色夕照、远山与雾谷等)。实测输出节选:
6.3.3. 图像编辑(editing)
输入图(examples/editing/data/images/1.webp):
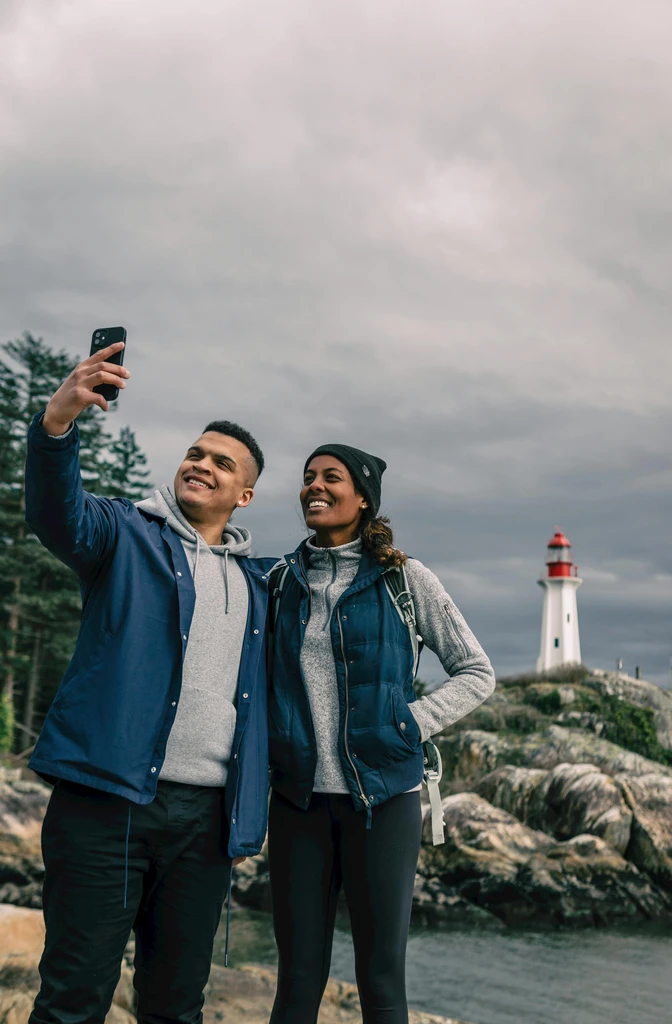
python examples/editing/inference.py \
  --model_path /root/SenseNova-U1.5-8B-MoT \
  --prompt "Change the jacket of the person on the left to bright yellow." \
  --image examples/editing/data/images/1.webp \
  --device npu \
  --cfg_scale 4.0 --img_cfg_scale 1.0 --timestep_shift 3.0 --num_steps 50 \
  --output /root/outputs/edited.png --profile
终端输出:1 张输入图自动按 4096 pixel 上限处理(4029 tok),模型加载 7.0 s、50 步编辑 66.1 s、吞吐 60.96 tok/s(对比 W7900 的 493.2 s,快约 7.5 倍):
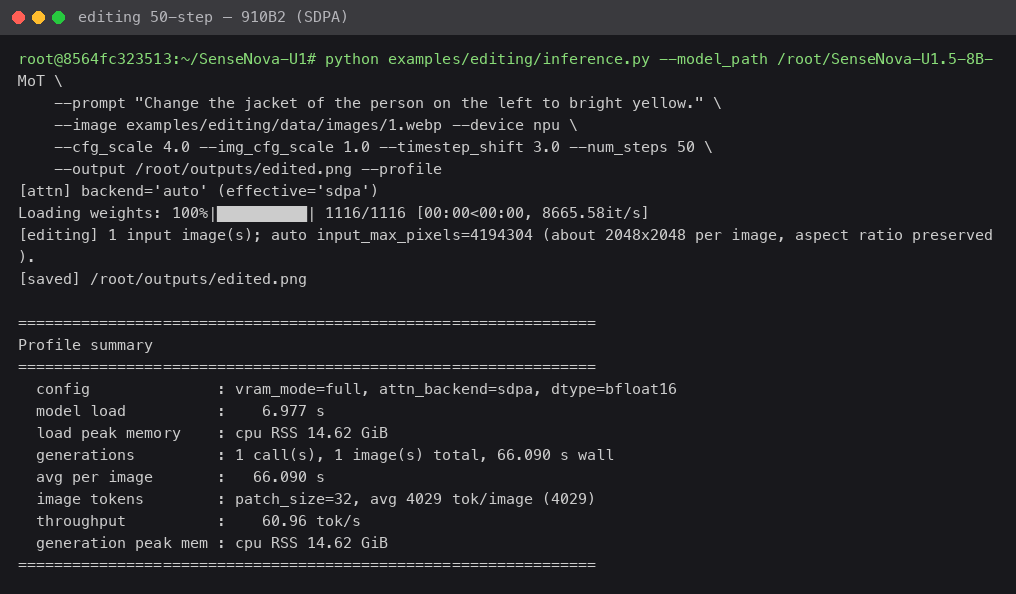
编辑结果(outputs/edited.png):
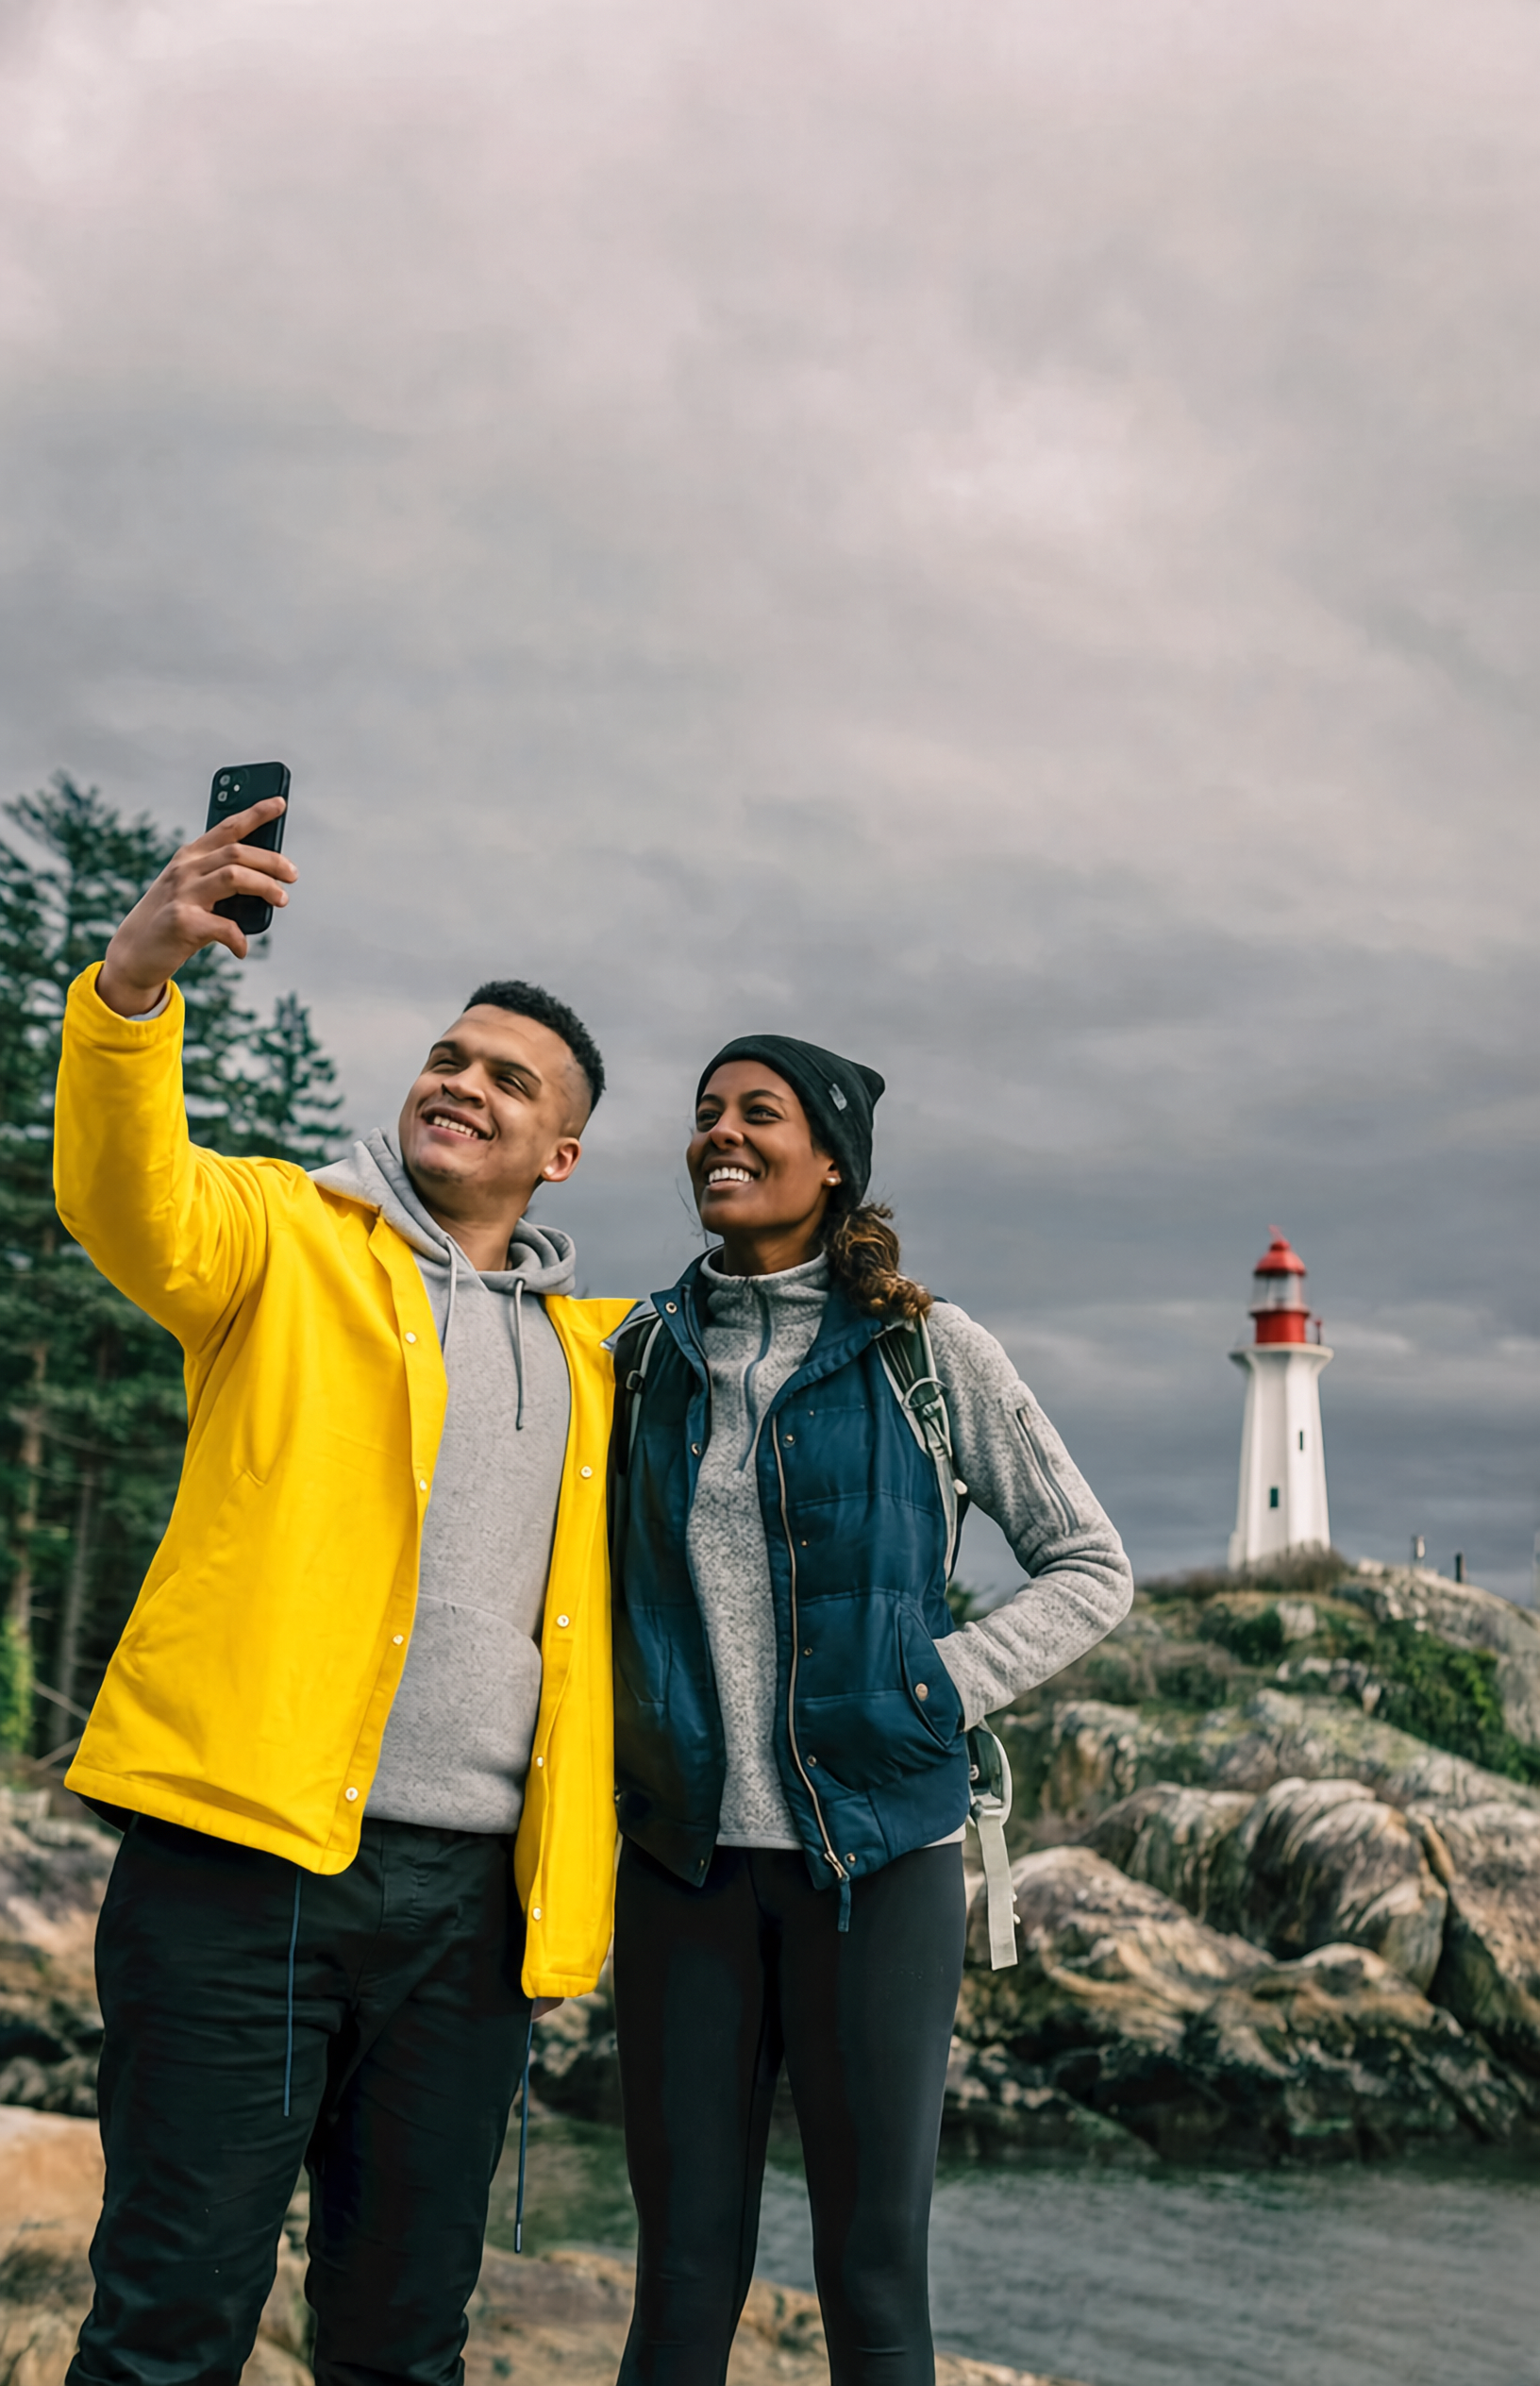
6.3.4. 图文交错生成(interleave)
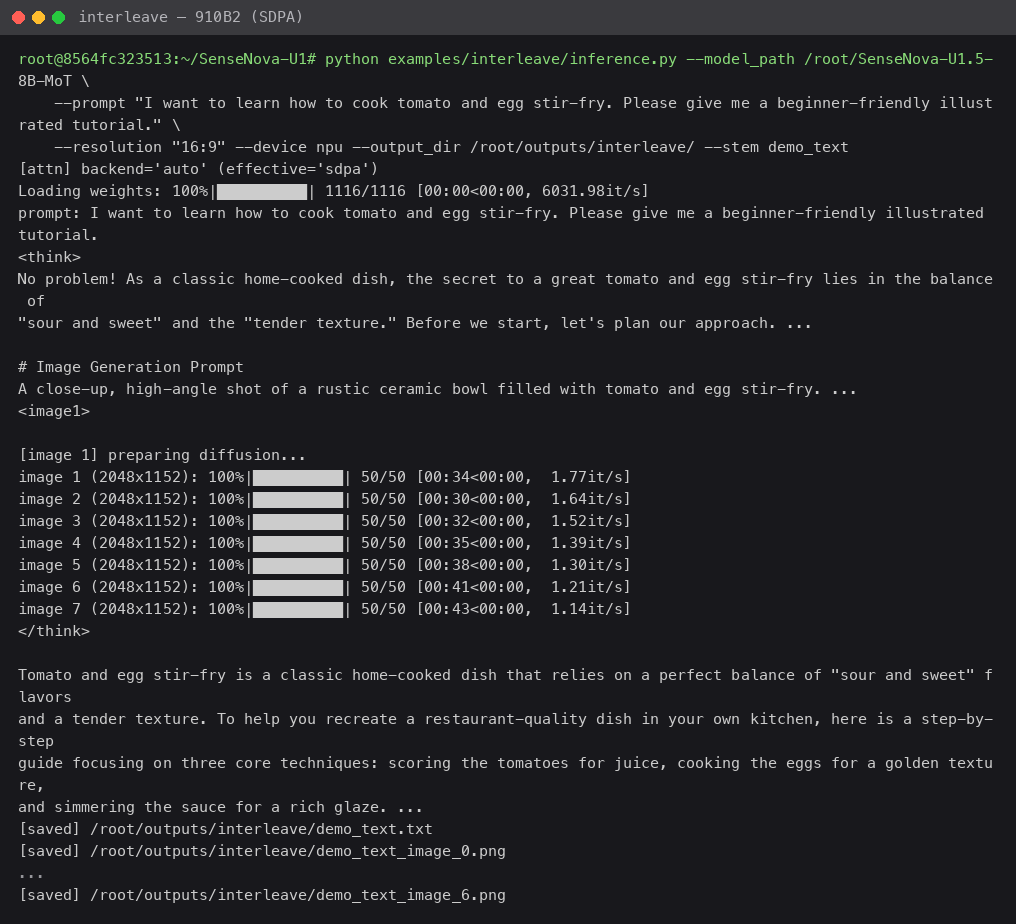
python examples/interleave/inference.py \
  --model_path /root/SenseNova-U1.5-8B-MoT \
  --prompt "I want to learn how to cook tomato and egg stir-fry. Please give me a beginner-friendly illustrated tutorial." \
  --resolution "16:9" \
  --device npu \
  --output_dir /root/outputs/interleave/ --stem demo_text
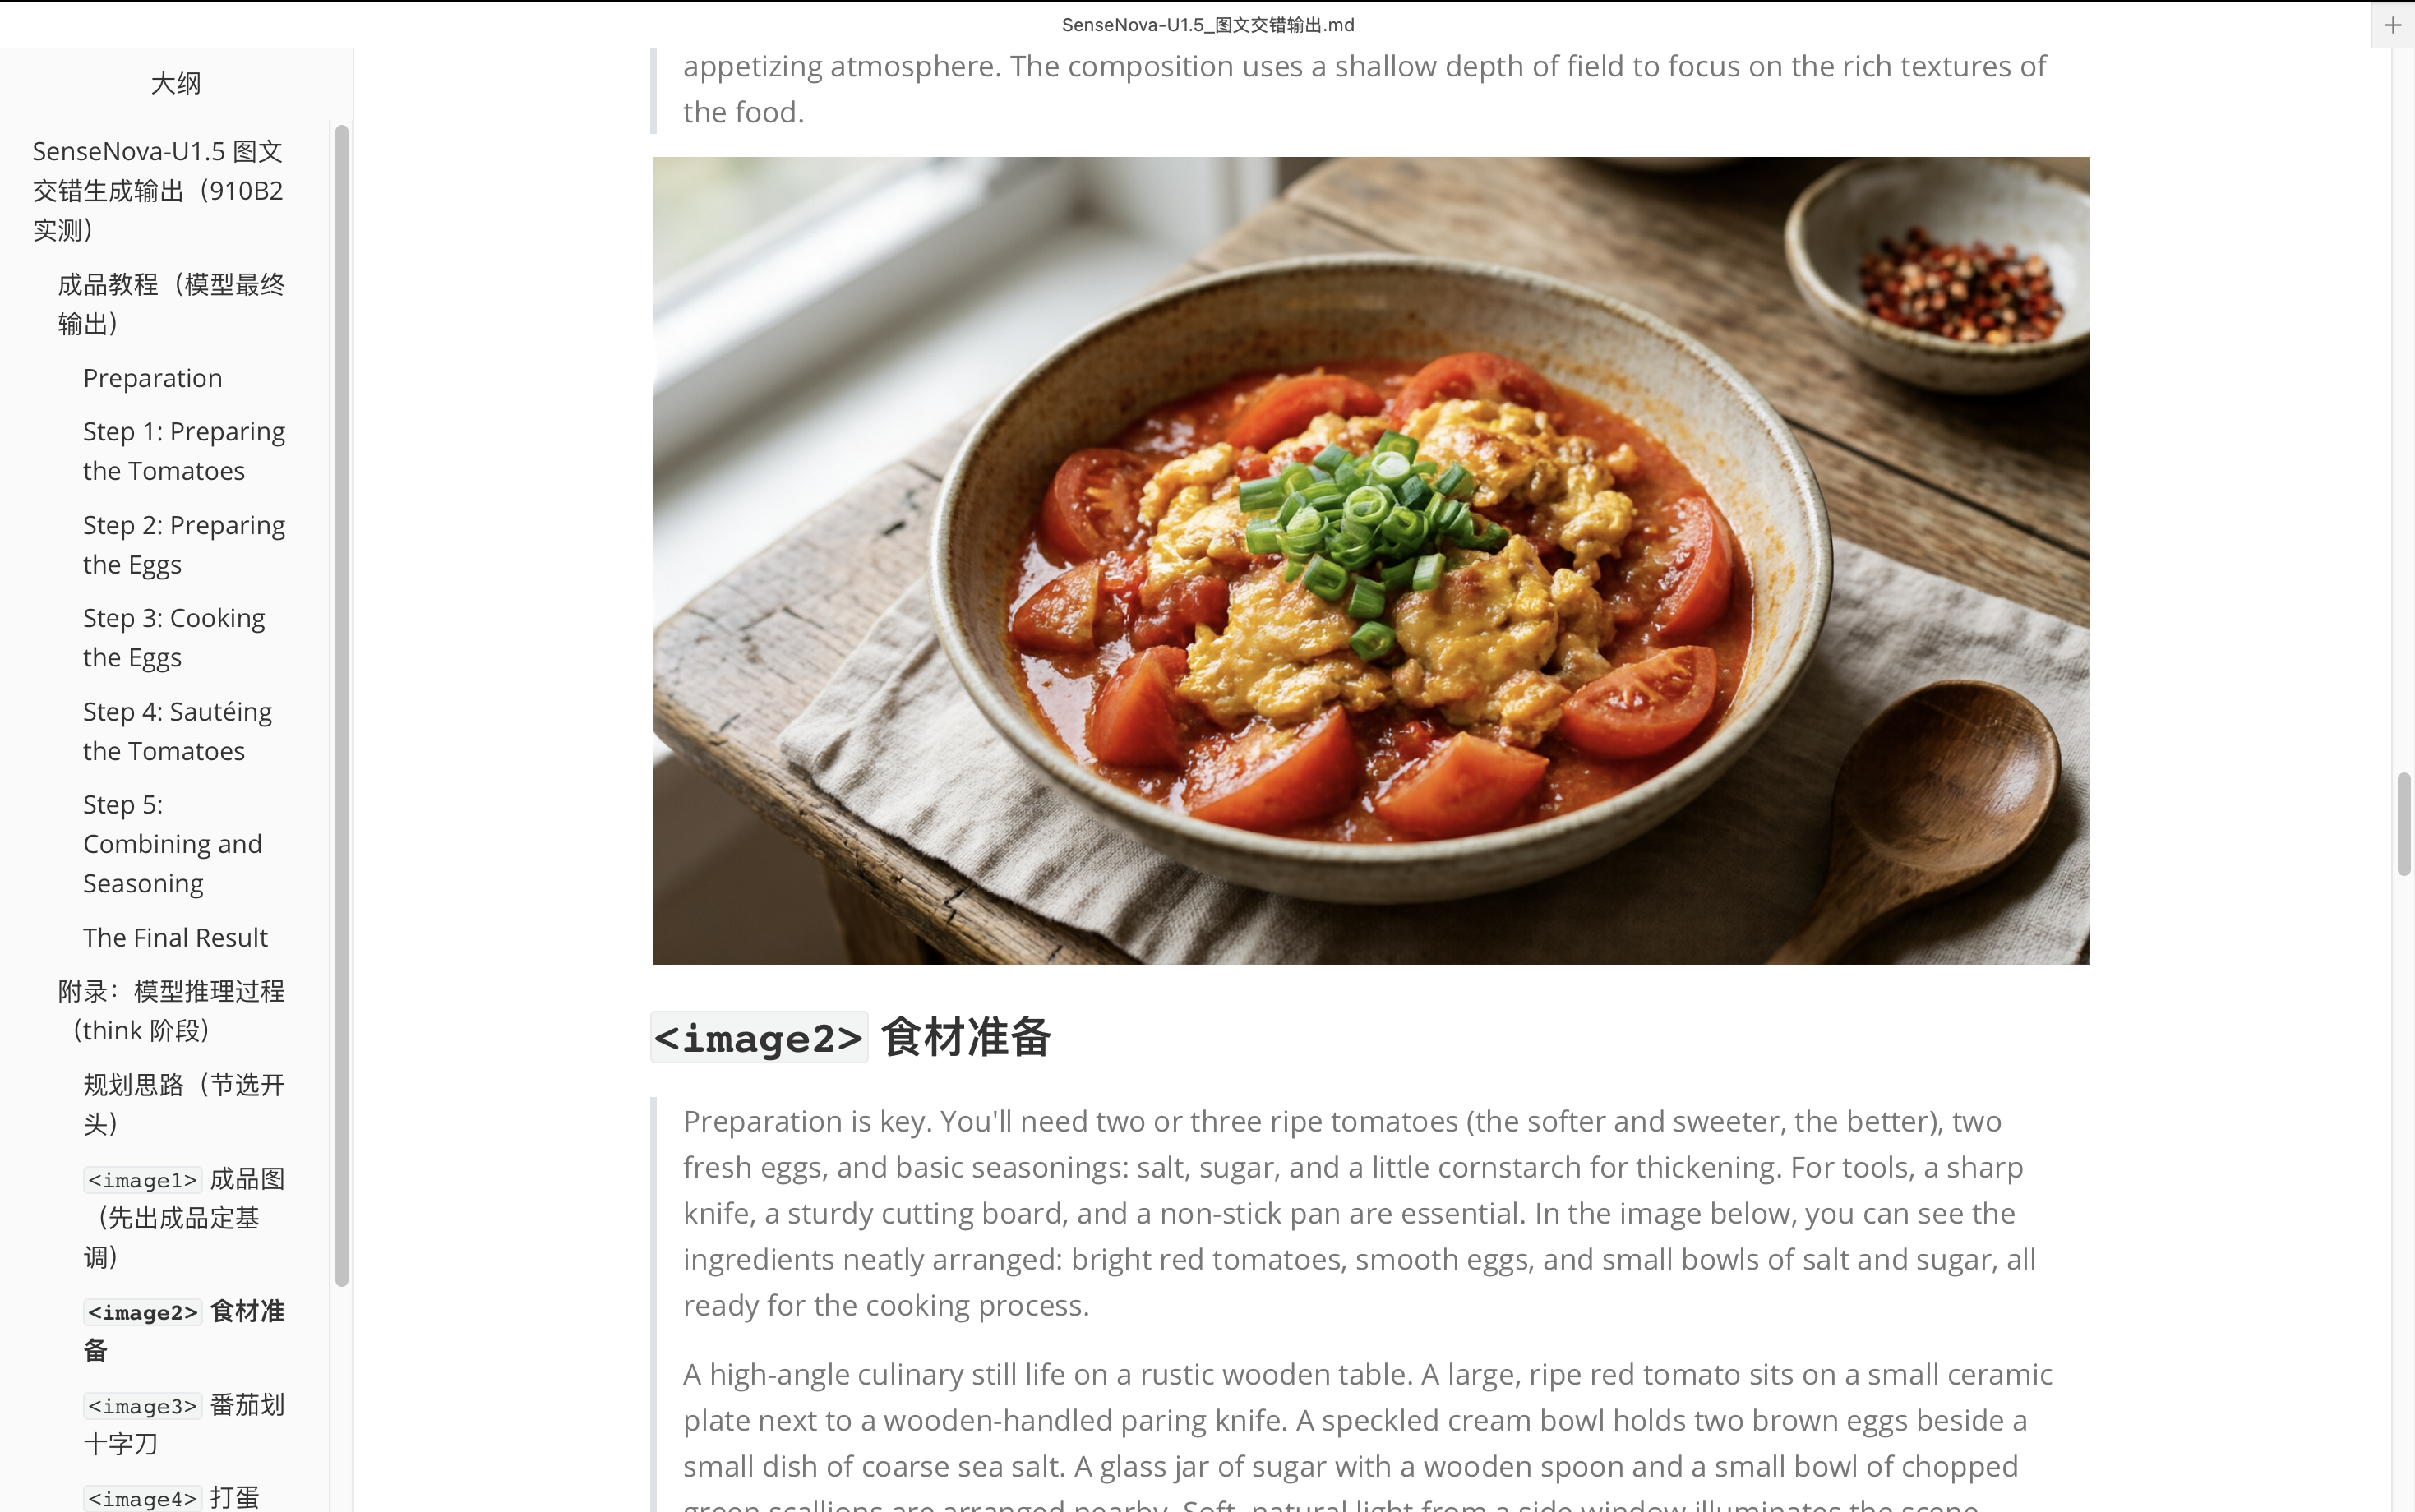
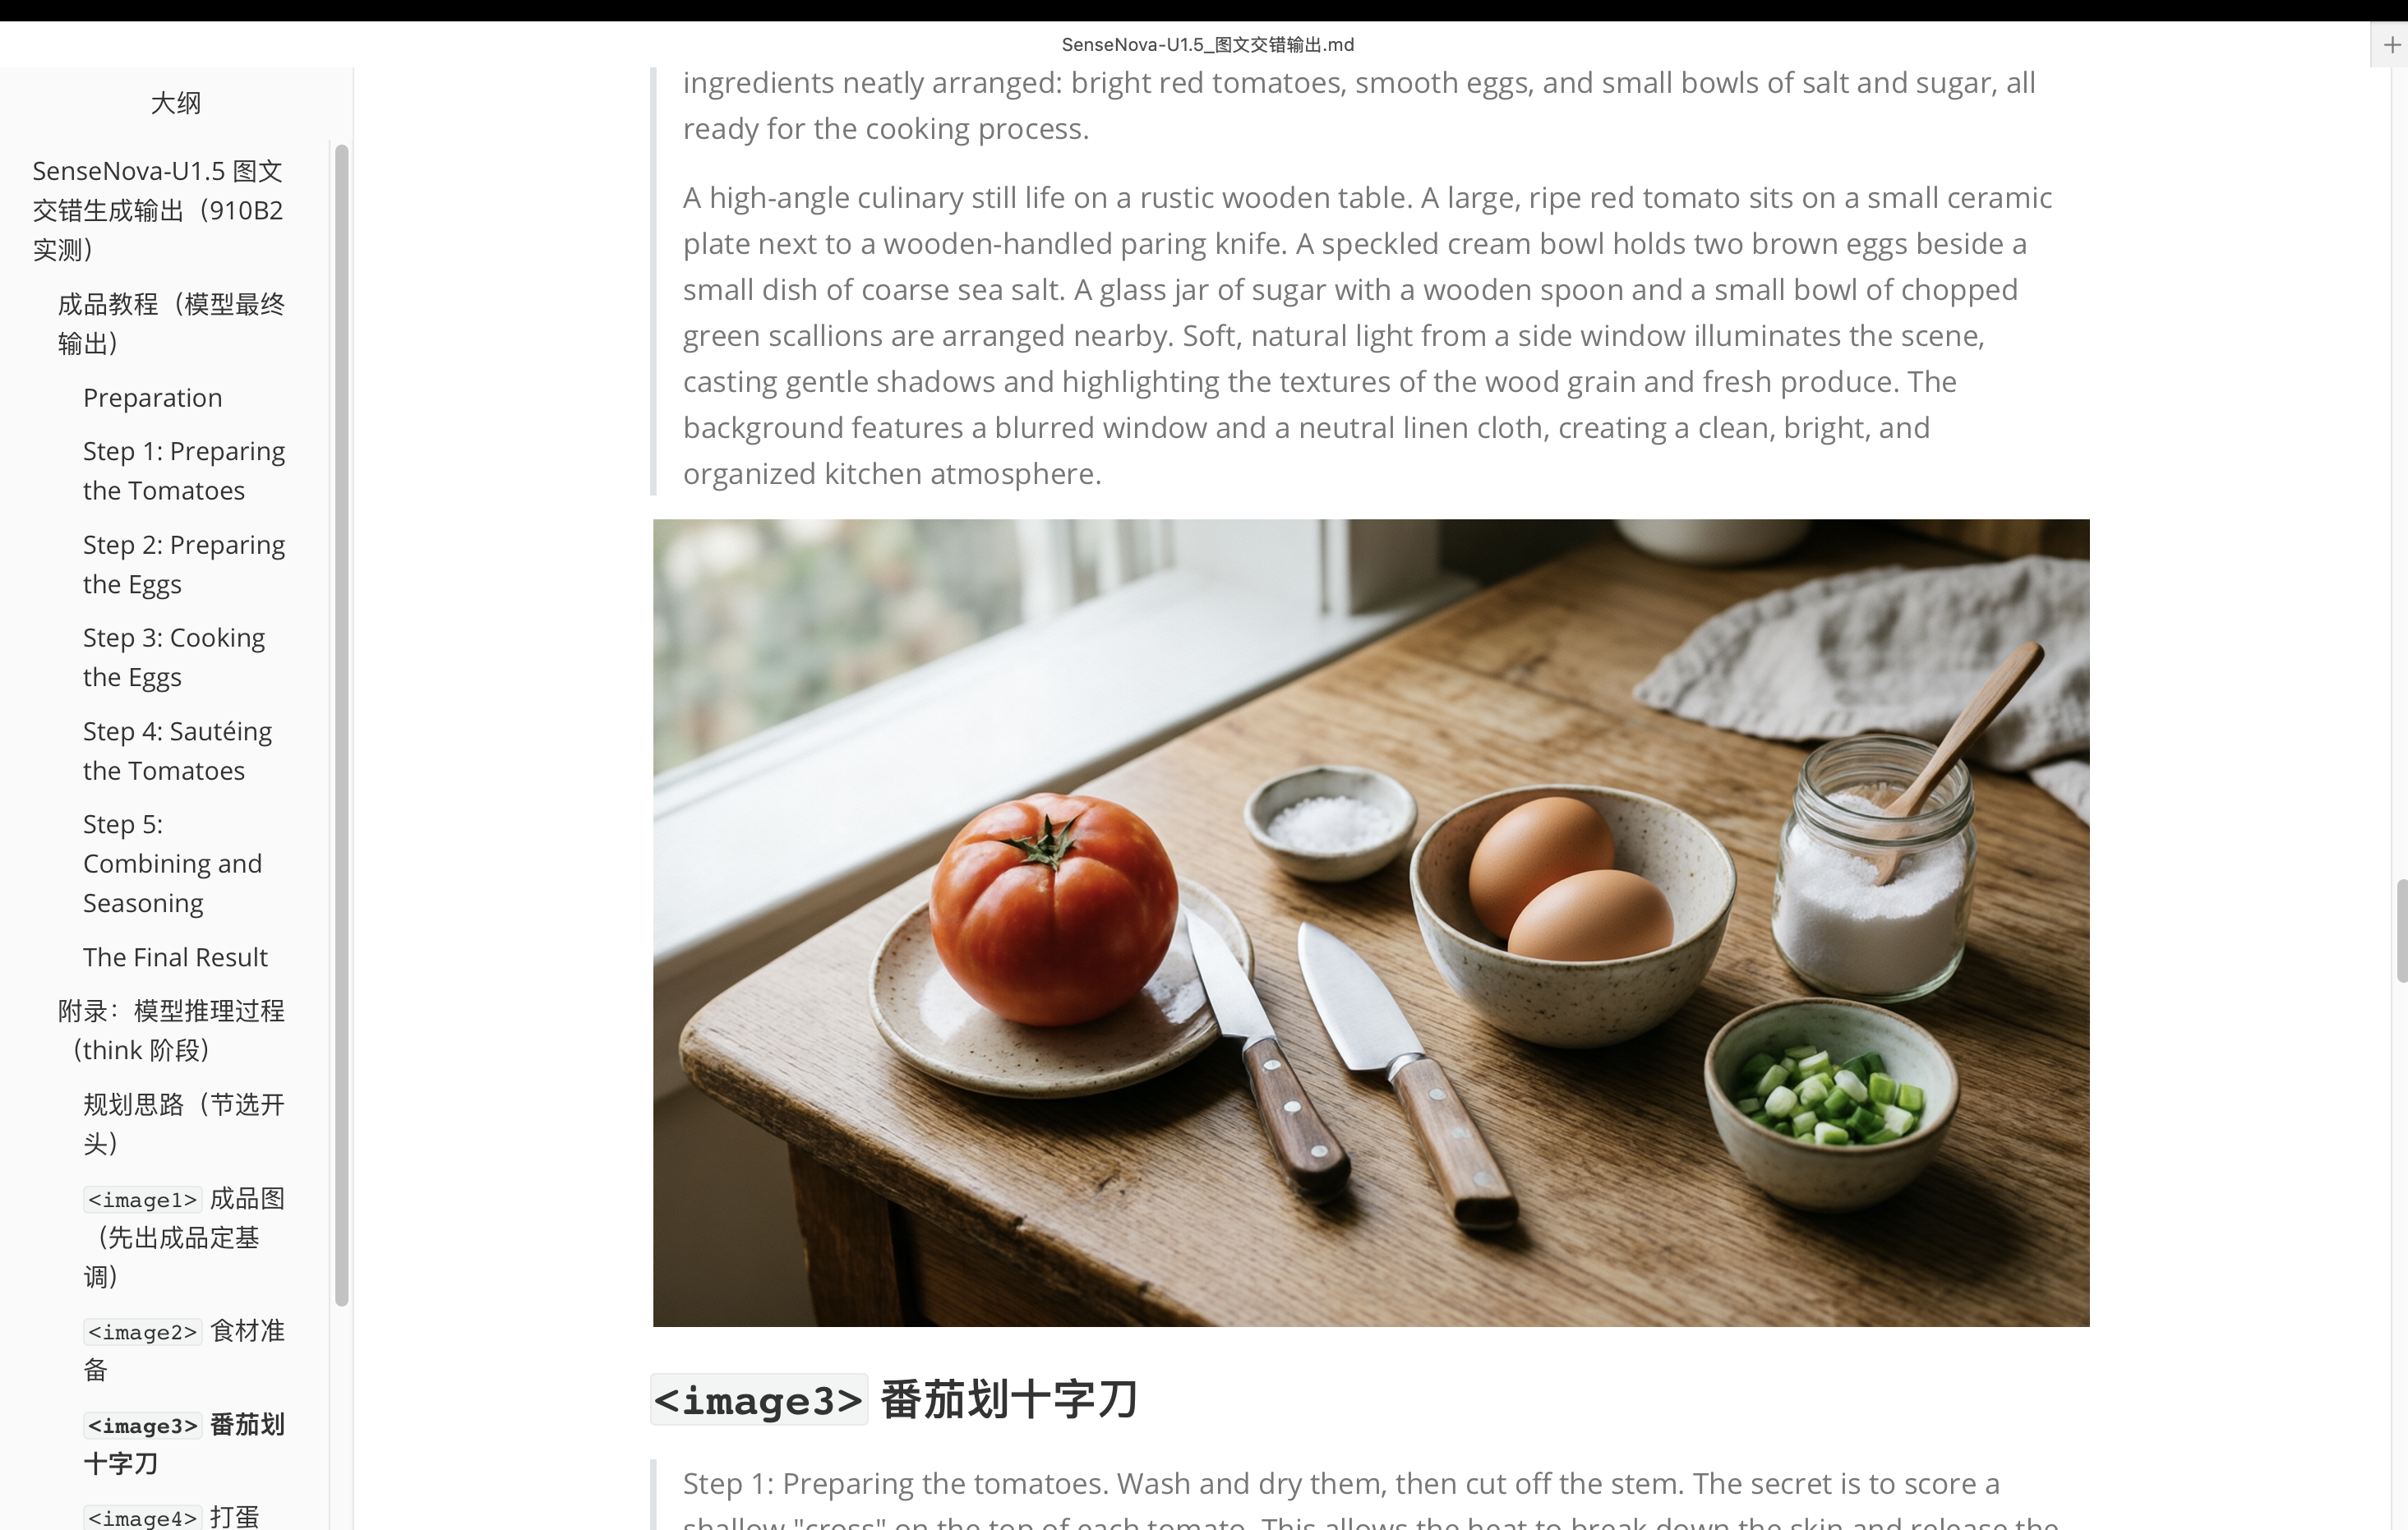
模型在生成文本的同时按段落插图(<image1> … <image7>),全程 797 s(13.3 分钟):共 7 张 2048×1152 插图 + 长文本教程;单图 50 步速率从 1.77 it/s 逐张递减到 1.14 it/s(上下文增长带来的注意力开销,属预期):
交错输出样例:
6.4显存不够时的降级方案
64 GB 的 910B2 全量模式即可跑 2K;以下方案主要供 32 GB 卡(910B3/B4)或更高分辨率时参考:
| 方案 | 命令 | 说明 |
|---|---|---|
| 分层卸载 | --vram_mode balanced(或 low / fast) |
需 6.2.3 补丁(白名单含 npu 后即可用);本机 2 TiB 内存,CPU 侧余量极大;与 --device_map 互斥 |
| GGUF 量化 | --gguf_checkpoint /path/x.gguf(需 6.2.2 扩展) |
社区 Q4/Q8 权重;GGUF 反量化是纯 torch 算子,理论可在 NPU 运行,未实测;仓库称 Q4 + balanced 可在 10–12 GB 显存运行 |
| 降分辨率 / 步数 | --width/--height、--num_steps |
直接降低激活显存与耗时 |
| 多卡切分 | --device_map auto --max_memory ... |
accelerate 的 NPU device_map 支持未验证,本章单卡 910B2 不涉及 |
6.5NPU 适配说明与已知问题
-
flash-attn:没有 NPU 版本,本路线不安装。
-
torch 版本:仓库默认 pin
torch 2.8.0 + cu128仅适用 NVIDIA;本路线直接使用镜像预装的 torch_npu 2.9.0 配套(FAQ 亦认可 aarch64 上 torch 2.9)。--no-deps安装项目本体是防止覆盖的关键。 -
非交互 shell:脚本/远程执行需手动
export PATH=/usr/local/python3.11.14/bin:$PATH并source /usr/local/Ascend/ascend-toolkit/set_env.sh,否则出现libc_sec.so加载失败、python3/npu-smi找不到等假性故障(见 6.1.1)。 -
profiler 显存统计:
--profile的峰值显存采集代码仅对cuda设备生效,NPU 上只打印耗时、不打印显存。观测显存请用watch -n 1 npu-smi info(HBM-Usage 列)。 -
pillow 版本:镜像 12.1.1 与项目 pin 12.0.0 的小版本差异在
--no-deps安装下不产生冲突,推理路径未观察到影响。 -
TBE 算子编译的 Python 依赖(实测踩过的坑):首次推理触发卷积算子编译时,CANN TBE 组件要导入
decorator模块,镜像未预装会报Environment_Error_Import_Python_Module_Failed(EC0010): No module named 'decorator'并连带SetPrecisionMode ... error code is 500001等长串错误。补装decorator attrs cloudpickle即可(已写入 6.2.2),这是纯环境问题、与模型代码无关。
6.6一页速查
# ===== 环境(一次性)===== export PATH=/usr/local/python3.11.14/bin:$PATH # 非交互 shell 需要 source /usr/local/Ascend/ascend-toolkit/set_env.sh # 非交互 shell 需要 npu-smi info # 确认 910B2 / 64 GB / 驱动正常 cd /root/SenseNova-U1 pip install -e . --no-deps # 关键:不覆盖 torch_npu pip install sentencepiece==0.2.1 tqdm==4.67.1 "httpx>=0.27,<1" "packaging>=25.0" pip install decorator attrs cloudpickle # CANN TBE 算子编译依赖(必装) # + 执行 6.2.3 的 accel.py 补丁脚本(唯一必需代码改动) python3 -c "import torch, torch_npu; print(torch.__version__, torch_npu.__version__, torch_npu.npu.is_available())" # ===== 运行(每次)===== python examples/t2i/inference.py \ --model_path /root/SenseNova-U1.5-8B-MoT \ --prompt "你的提示词" \ --device npu --num_steps 50 --profile \ --output /root/outputs/out.png watch -n 1 npu-smi info # 另开终端观测 HBM 占用
附录 A:一键复现命令汇总
# 0) 驱动(Ubuntu 24.04,新内核) echo -e "blacklist nouveau\noptions nouveau modeset=0" | sudo tee /etc/modprobe.d/blacklist-nouveau.conf sudo update-initramfs -u && sudo reboot sudo apt install -y gcc make linux-headers-$(uname -r) sudo ./cuda_13.2.0_595.45.04_linux.run # 只装 Driver 组件(595.45.04) sudo ./cuda_12.8.0_570.86.10_linux.run --toolkit --silent --override # 只装 12.8 toolkit # 1) 环境 curl -LsSf https://astral.sh/uv/install.sh | sh uv venv --python=3.11 && source .venv/bin/activate uv pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128 sudo apt install -y git git clone https://github.com/OpenSenseNova/SenseNova-U1.git && cd SenseNova-U1 && uv pip install -e . # 2) 权重(33GB + 814MB LoRA) modelscope download --model SenseNova/SenseNova-U1.5-8B-MoT --local_dir ~/SenseNova/SenseNova-U1.5-8B-MoT hf download sensenova/SenseNova-U1.5-8B-MoT-LoRAs SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \ --local-dir ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs # 3) 50 步基线 / 8 步蒸馏 python examples/t2i/inference.py --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \ --prompt "你的提示词" --output outputs/base.png --width 2048 --height 2048 \ --cfg_scale 4.0 --timestep_shift 3.0 --num_steps 50 --seed 42 --profile \ --device_map auto --max_memory "0=20GiB,cpu=16GiB" # 32GB 内存主机用分片;≥40GB 内存可换 --vram_mode fast python examples/t2i/inference.py --model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \ --lora_path ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs/SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \ --prompt "你的提示词" --output outputs/fast.png --width 2048 --height 2048 \ --cfg_scale 1.0 --timestep_shift 3.0 --num_steps 8 --seed 42 --profile \ --device_map auto --max_memory "0=20GiB,cpu=16GiB"
附录 B:参考资料
-
SenseNova-U1 GitHub 仓库:
docs/deployment_CN.md(LightLLM 部署)、docs/base_vs_distill.md(蒸馏对比)、docs/gpu_mem_profiler_CN.md(显存剖析)、docs/parameter_breakdown_CN.md(参数分解) -
模型权重:Hugging Face
sensenova/SenseNova-U1.5-8B-MoT、ModelScope 同名空间
附录 C:u1_api_server.py 完整代码
放在仓库根目录(~/SenseNova/SenseNova-U1-GitHub/u1_api_server.py),配合第 2.10 节的 systemd 单元使用:
"""
启动示例(≥40 GB 内存主机):
python u1_api_server.py \
--model_path ~/SenseNova/SenseNova-U1.5-8B-MoT \
--lora_path ~/SenseNova/SenseNova-U1.5-8B-MoT-LoRAs/SenseNova-U1.5-8B-MoT-LoRA-8step.safetensors \
--vram_mode fast --num_steps 8 --cfg_scale 1.0 --port 8000
"""
from __future__ import annotations
import argparse
import base64
import io
import threading
import time
from pathlib import Path
import torch
import uvicorn
from fastapi import FastAPI
from pydantic import BaseModel, Field
REPO = Path(__file__).resolve().parent
import sys
sys.path.insert(0, str(REPO / "examples" / "t2i"))
import sensenova_u1 # noqa: E402 (import 时向 transformers 注册模型)
from inference import SenseNovaU1T2I # noqa: E402
from sensenova_u1.utils import load_and_merge_lora_weight_from_safetensors # noqa: E402
app = FastAPI(title="SenseNova-U1.5 T2I API", version="1.0")
ENGINE: SenseNovaU1T2I | None = None
GEN_LOCK = threading.Lock()
DEFAULTS: dict = {}
class GenRequest(BaseModel):
prompt: str
width: int = Field(default=2048, description="仅支持官方分辨率桶, 如 2048x2048 / 2720x1536")
height: int = 2048
num_steps: int | None = None
cfg_scale: float | None = None
seed: int = 42
class GenResponse(BaseModel):
created: int
model: str = "sensenova-u1.5-8b-mot"
b64_image: str
width: int
height: int
num_steps: int
cfg_scale: float
seed: int
elapsed_sec: float
@app.get("/health")
def health():
return {
"status": "ok" if ENGINE is not None else "loading",
"vram_mode": DEFAULTS.get("vram_mode"),
"default_steps": DEFAULTS.get("num_steps"),
"default_cfg": DEFAULTS.get("cfg_scale"),
"gpu": torch.cuda.get_device_name(0) if torch.cuda.is_available() else "cpu",
}
@app.post("/v1/images/generations", response_model=GenResponse)
def generate(req: GenRequest):
assert ENGINE is not None, "engine not ready"
steps = req.num_steps or DEFAULTS["num_steps"]
cfg = req.cfg_scale if req.cfg_scale is not None else DEFAULTS["cfg_scale"]
t0 = time.time()
with GEN_LOCK: # 24GB 单卡串行, 防止并发 OOM
images = ENGINE.generate(
req.prompt,
image_size=(req.width, req.height),
cfg_scale=cfg,
num_steps=steps,
seed=req.seed,
)
buf = io.BytesIO()
images[0].save(buf, format="PNG")
return GenResponse(
created=int(time.time()),
b64_image=base64.b64encode(buf.getvalue()).decode(),
width=req.width,
height=req.height,
num_steps=steps,
cfg_scale=cfg,
seed=req.seed,
elapsed_sec=round(time.time() - t0, 2),
)
def main():
global ENGINE, DEFAULTS
p = argparse.ArgumentParser()
p.add_argument("--model_path", required=True)
p.add_argument("--lora_path", default=None)
p.add_argument("--vram_mode", default="fast")
p.add_argument("--num_steps", type=int, default=8)
p.add_argument("--cfg_scale", type=float, default=1.0)
p.add_argument("--port", type=int, default=8000)
p.add_argument("--host", default="0.0.0.0")
args = p.parse_args()
sensenova_u1.set_attn_backend("sdpa")
t0 = time.time()
ENGINE = SenseNovaU1T2I(args.model_path, dtype=torch.bfloat16, vram_mode=args.vram_mode)
if args.lora_path:
ENGINE.model = load_and_merge_lora_weight_from_safetensors(ENGINE.model, args.lora_path)
print(f"[api] merged lora: {args.lora_path}")
DEFAULTS = {
"vram_mode": args.vram_mode,
"num_steps": args.num_steps,
"cfg_scale": args.cfg_scale,
}
print(f"[api] engine ready in {time.time() - t0:.1f}s, listening on {args.host}:{args.port}")
uvicorn.run(app, host=args.host, port=args.port)
if __name__ == "__main__":
main()
DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)