手把手教你用 Python 实现 LBPH 算法:从原理到人脸识别实战
目录
在计算机视觉领域,人脸识别是最热门的应用方向之一。而LBPH(局部二值模式直方图)算法作为经典的人脸识别方案,凭借轻量、易实现、对光照变化鲁棒的特点,成为入门学习者的首选。本文将从算法原理出发,一步步带你用 Python+OpenCV 实现完整的人脸识别流程,新手也能轻松上手!
一、先搞懂:LBPH 算法的核心原理
LBPH 算法并非凭空设计,它是在LBP(局部二值模式)算子的基础上扩展而来。想要用好它,得先明白两个核心概念:LBP 特征和直方图统计。
1. LBP 算子:给每个像素 “贴标签”
LBP 的核心思想很简单:通过对比像素与其周围邻居的灰度值,用二进制数描述像素的局部纹理特征。具体步骤如下:
- 确定中心像素:选择图像中的一个像素作为中心,通常取其周围 8 个相邻像素(3x3 窗口)。
- 灰度值对比:将中心像素的灰度值与每个相邻像素比较。若相邻像素灰度≥中心像素,标记为 “1”;否则标记为 “0”。
- 生成 LBP 值:按顺时针(或逆时针)顺序将 8 个标记组成 8 位二进制数,再转换为十进制数,这个数就是该中心像素的LBP 值。
2. LBPH:把局部特征 “拼” 成全局特征
单个像素的 LBP 值只能描述局部纹理,而 LBPH 算法通过 “分块统计直方图”,将局部特征整合为全局特征,步骤如下:
- 图像分块:将整幅图像均匀划分为多个小区域(比如 8x8=64 个块),每个块独立处理。
- 块内直方图统计:对每个小区域,统计所有像素 LBP 值的出现次数,生成该区域的 LBP 直方图。
- 拼接特征向量:将所有小区域的直方图按顺序拼接,形成一个长向量,这就是整幅图像的LBPH 特征向量。
- 相似度计算:对于两张人脸图像,通过计算它们 LBPH 特征向量的距离(如欧几里得距离、余弦相似度),判断是否为同一人。距离越小,匹配度越高。
二、实战:用 Python 实现 LBPH 人脸识别
理解原理后,我们直接上代码。整个流程分为 4 步:图像预处理、创建 LBPH 识别器、训练模型、预测识别。
1. 环境准备
首先确保安装了必备库,OpenCV 需要额外安装opencv-contrib-python(包含 LBPH 相关模块):
pip install opencv-python opencv-contrib-python numpy2. 完整代码实现(附详细注释)
步骤 1:图像预处理
先准备训练数据(人脸图像)和测试数据,注意所有图像需转为灰度图(LBPH 算法基于灰度值计算)。
import cv2
import numpy as np

# ---------------------- 1. 数据准备 ----------------------
# 1.1 加载训练图像(建议同一人的图像拍摄角度/光照略有差异,提升泛化性)
# 这里用4张训练图:前2张是“yf”,后2张是“zrn”
train_images = [
    cv2.imread("f1.jpg", cv2.IMREAD_GRAYSCALE),  # 灰度图读取
    cv2.imread("f2.jpg", cv2.IMREAD_GRAYSCALE),
    cv2.imread("z1.jpg", cv2.IMREAD_GRAYSCALE),
    cv2.imread("z2.jpg", cv2.IMREAD_GRAYSCALE)
]

# 1.2 给训练图像打标签(同一人标签相同,不同人标签不同)
train_labels = [0, 0, 1, 1]  # 0→yf,1→zrn

# 1.3 标签与姓名的映射(方便最终输出结果)
label_name = {0: "yf", 1: "zrn", -1: "无法识别"}

# 1.4 加载待识别的测试图像(同样转为灰度图)
test_image = cv2.imread("f_test.jpg", cv2.IMREAD_GRAYSCALE)
步骤 2:创建 LBPH 人脸识别器
使用 OpenCV 内置的LBPHFaceRecognizer_create()函数,关键参数说明如下:
radius:LBP 算子的半径(默认 1,无需修改)。neighbors:采样点数量(默认 8,对应 3x3 窗口)。grid_x/grid_y:图像分块数(默认 8x8,即 64 个块)。threshold:识别阈值(核心参数!超过阈值则判定为 “无法识别”,建议设 80)。
# ---------------------- 2. 创建LBPH识别器 ----------------------
# 设置阈值为80:置信度>80则认为匹配失败
recognizer = cv2.face.LBPHFaceRecognizer_create(threshold=80)
步骤 3:训练模型
调用train()方法,用准备好的训练图像和标签训练模型。注意train_labels需转为 numpy 数组。
# ---------------------- 3. 训练模型 ----------------------
# 传入训练数据和标签(标签需为numpy数组格式)
recognizer.train(train_images, np.array(train_labels))
print("模型训练完成!")
步骤 4:预测识别
调用predict()方法对测试图像进行识别,返回两个结果:label(预测标签)和confidence(置信度)。
- 置信度:值越小,匹配度越高;若>阈值(80),则标签返回 - 1(无法识别)。
# ---------------------- 4. 预测与结果输出 ----------------------
# 对测试图像进行识别
pred_label, confidence = recognizer.predict(test_image)

# 根据预测标签映射姓名
pred_name = label_name[pred_label]

# 输出结果
print(f"识别结果:{pred_name}")
print(f"置信度(越小匹配度越高):{confidence:.2f}")

# (可选)显示测试图像和识别结果
# 将灰度图转为BGR图(OpenCV显示默认BGR),方便添加文字
test_image_bgr = cv2.cvtColor(test_image, cv2.COLOR_GRAY2BGR)
# 在图像上绘制文字
cv2.putText(
    test_image_bgr,
    f"Name: {pred_name}",
    (10, 30),  # 文字位置
    cv2.FONT_HERSHEY_SIMPLEX,
    1,  # 字体大小
    (0, 255, 0),  # 文字颜色(绿色)
    2  # 文字粗细
)
# 显示图像
cv2.imshow("Recognition Result", test_image_bgr)
# 等待按键关闭窗口
cv2.waitKey(0)
cv2.destroyAllWindows()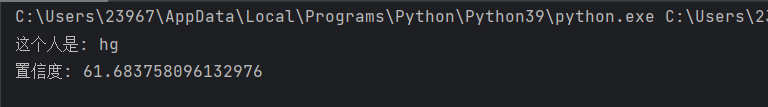
三、关键注意事项(避坑指南)
- 图像格式统一:所有训练和测试图像必须是灰度图,彩色图会导致算法报错。
- 阈值调整:
threshold是核心参数!若经常 “误识别”,可适当降低阈值(如 70);若经常 “无法识别”,可适当提高(如 90)。 - 训练数据质量:
- 同一人的训练图像建议≥2 张,且包含不同角度、光照(避免全是正面强光图)。
- 图像尺寸建议统一(如 200x200 像素),减少预处理差异。
- 置信度解读:不要只看标签,需结合置信度判断。例如置信度 75(接近阈值),即使标签正确,也可能是误匹配。
四、扩展应用场景
LBPH 算法不仅能做人脸识别,还可用于:
- 纹理分类:区分木纹、布料、纸张等不同纹理的材料。
- 表情识别:基于面部纹理变化(如皱眉、微笑)判断表情。
- 目标检测辅助:提取局部纹理特征,辅助定位图像中的特定目标。
总结
本文从原理到代码,完整讲解了 LBPH 算法的实现流程。核心在于理解 “LBP 特征提取” 和 “分块直方图统计”,而 OpenCV 的内置函数已经帮我们封装了复杂的计算,只需关注数据准备和参数调整即可。
如果你是计算机视觉新手,建议先从修改训练数据开始(替换成自己的照片),再尝试调整threshold、grid_x等参数,观察识别结果的变化,逐步掌握算法的调优技巧。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 32
 0
- 0


 已为社区贡献12条内容

所有评论(0)