机器学习——Spaceship Titanic(1)数据分析与预处理
本次我们来借助 Kaggle—Spaceship Titanic这个项目来学习机器学习,在本篇文章中,你可以学到:
- pandas对于csv文件的常见处理方法
- 对于不同类型的缺失值数据进行填充的方法
- 数据清洗以及预处理的思维方向
关于本项目的链接请点击:Kaggle—Spaceship Titanic
本项目的背景介绍:
欢迎来到2912年,你需要运用数据科学技能来解开一个宇宙之谜。我们收到了来自四光年外的传输信息,情况看起来不太妙。
泰坦尼克号宇宙飞船是一艘星际客轮,于一个月前发射升空。这艘载有近1.3万名乘客的飞船开始了它的首航,将来自我们太阳系的移民运送到三颗围绕邻近恒星运行的、新发现的宜居系外行星。
在绕过半人马座阿尔法星,前往其首个目的地——炙热的巨蟹座E星——的途中,粗心大意的泰坦尼克号宇宙飞船与隐藏在尘埃云中的时空异常相撞。不幸的是,它遭遇了与一千年前同名飞船相似的命运。虽然飞船完好无损,但几乎一半的乘客被传送到了另一个维度!
为了帮助救援队找回失踪的乘客,您需要使用从宇宙飞船受损的计算机系统中恢复的记录来预测哪些乘客是被异常现象运送的。帮助拯救他们并改变历史!
高质量的数据是机器学习模型性能的关键保障,数据预处理环节在机器学习流程中占据核心地位。通过系统化的数据清洗、特征工程和标准化处理,能够显著提升模型的准确性和泛化能力。
数据质量直接影响机器学习模型的训练效果和最终表现。构建高效的数据处理流水线已成为现代机器学习项目中不可或缺的组成部分。
在本项目中,根据官方提供的 train.csv 和 test.csv 文件,我们可以知道整个csv数据中包含的各个列的信息:
- 文件和数据字段描述
- train.csv:约三分之二(~8700)乘客的个人记录,用作训练数据。
- PassengerId:每位乘客拥有一个唯一的 ID。每个 ID 的形式为gggg_pp,其中gggg表示乘客所属的旅行团,pp表示其在旅行团内的编号。旅行团成员通常是家庭成员,但并非总是如此。
- HomePlanet:乘客出发的星球,通常是他们永久居住的星球。
- CryoSleep- :指示乘客是否选择在航行期间处于休眠状态。处于休眠状态的乘客将被限制在自己的船舱内。
- Cabin:乘客所住舱位号。格式为deck/num/side,其中side可以是P左舷,也可以是S右舷。
- Destination:乘客即将登陆的星球。
- Age:乘客的年龄。
- VIP:乘客是否已支付航行期间的特殊VIP服务费用。
- RoomService, FoodCourt, ShoppingMall, Spa, VRDeck:乘客在泰坦尼克号宇宙飞船的众多豪华设施中支付的金额。
- Name:乘客的名字和姓氏。
- Transported:乘客是否被传送到了另一个维度。这是目标,也就是你要预测的列。
- test.csv:剩余三分之一(约 4300 名)乘客的个人记录,用作测试数据。你的任务是预测Transported该数据集中乘客的 值。
- sample_submission.csv:正确格式的提交文件。
- train.csv:约三分之二(~8700)乘客的个人记录,用作训练数据。
部分如下图所示:
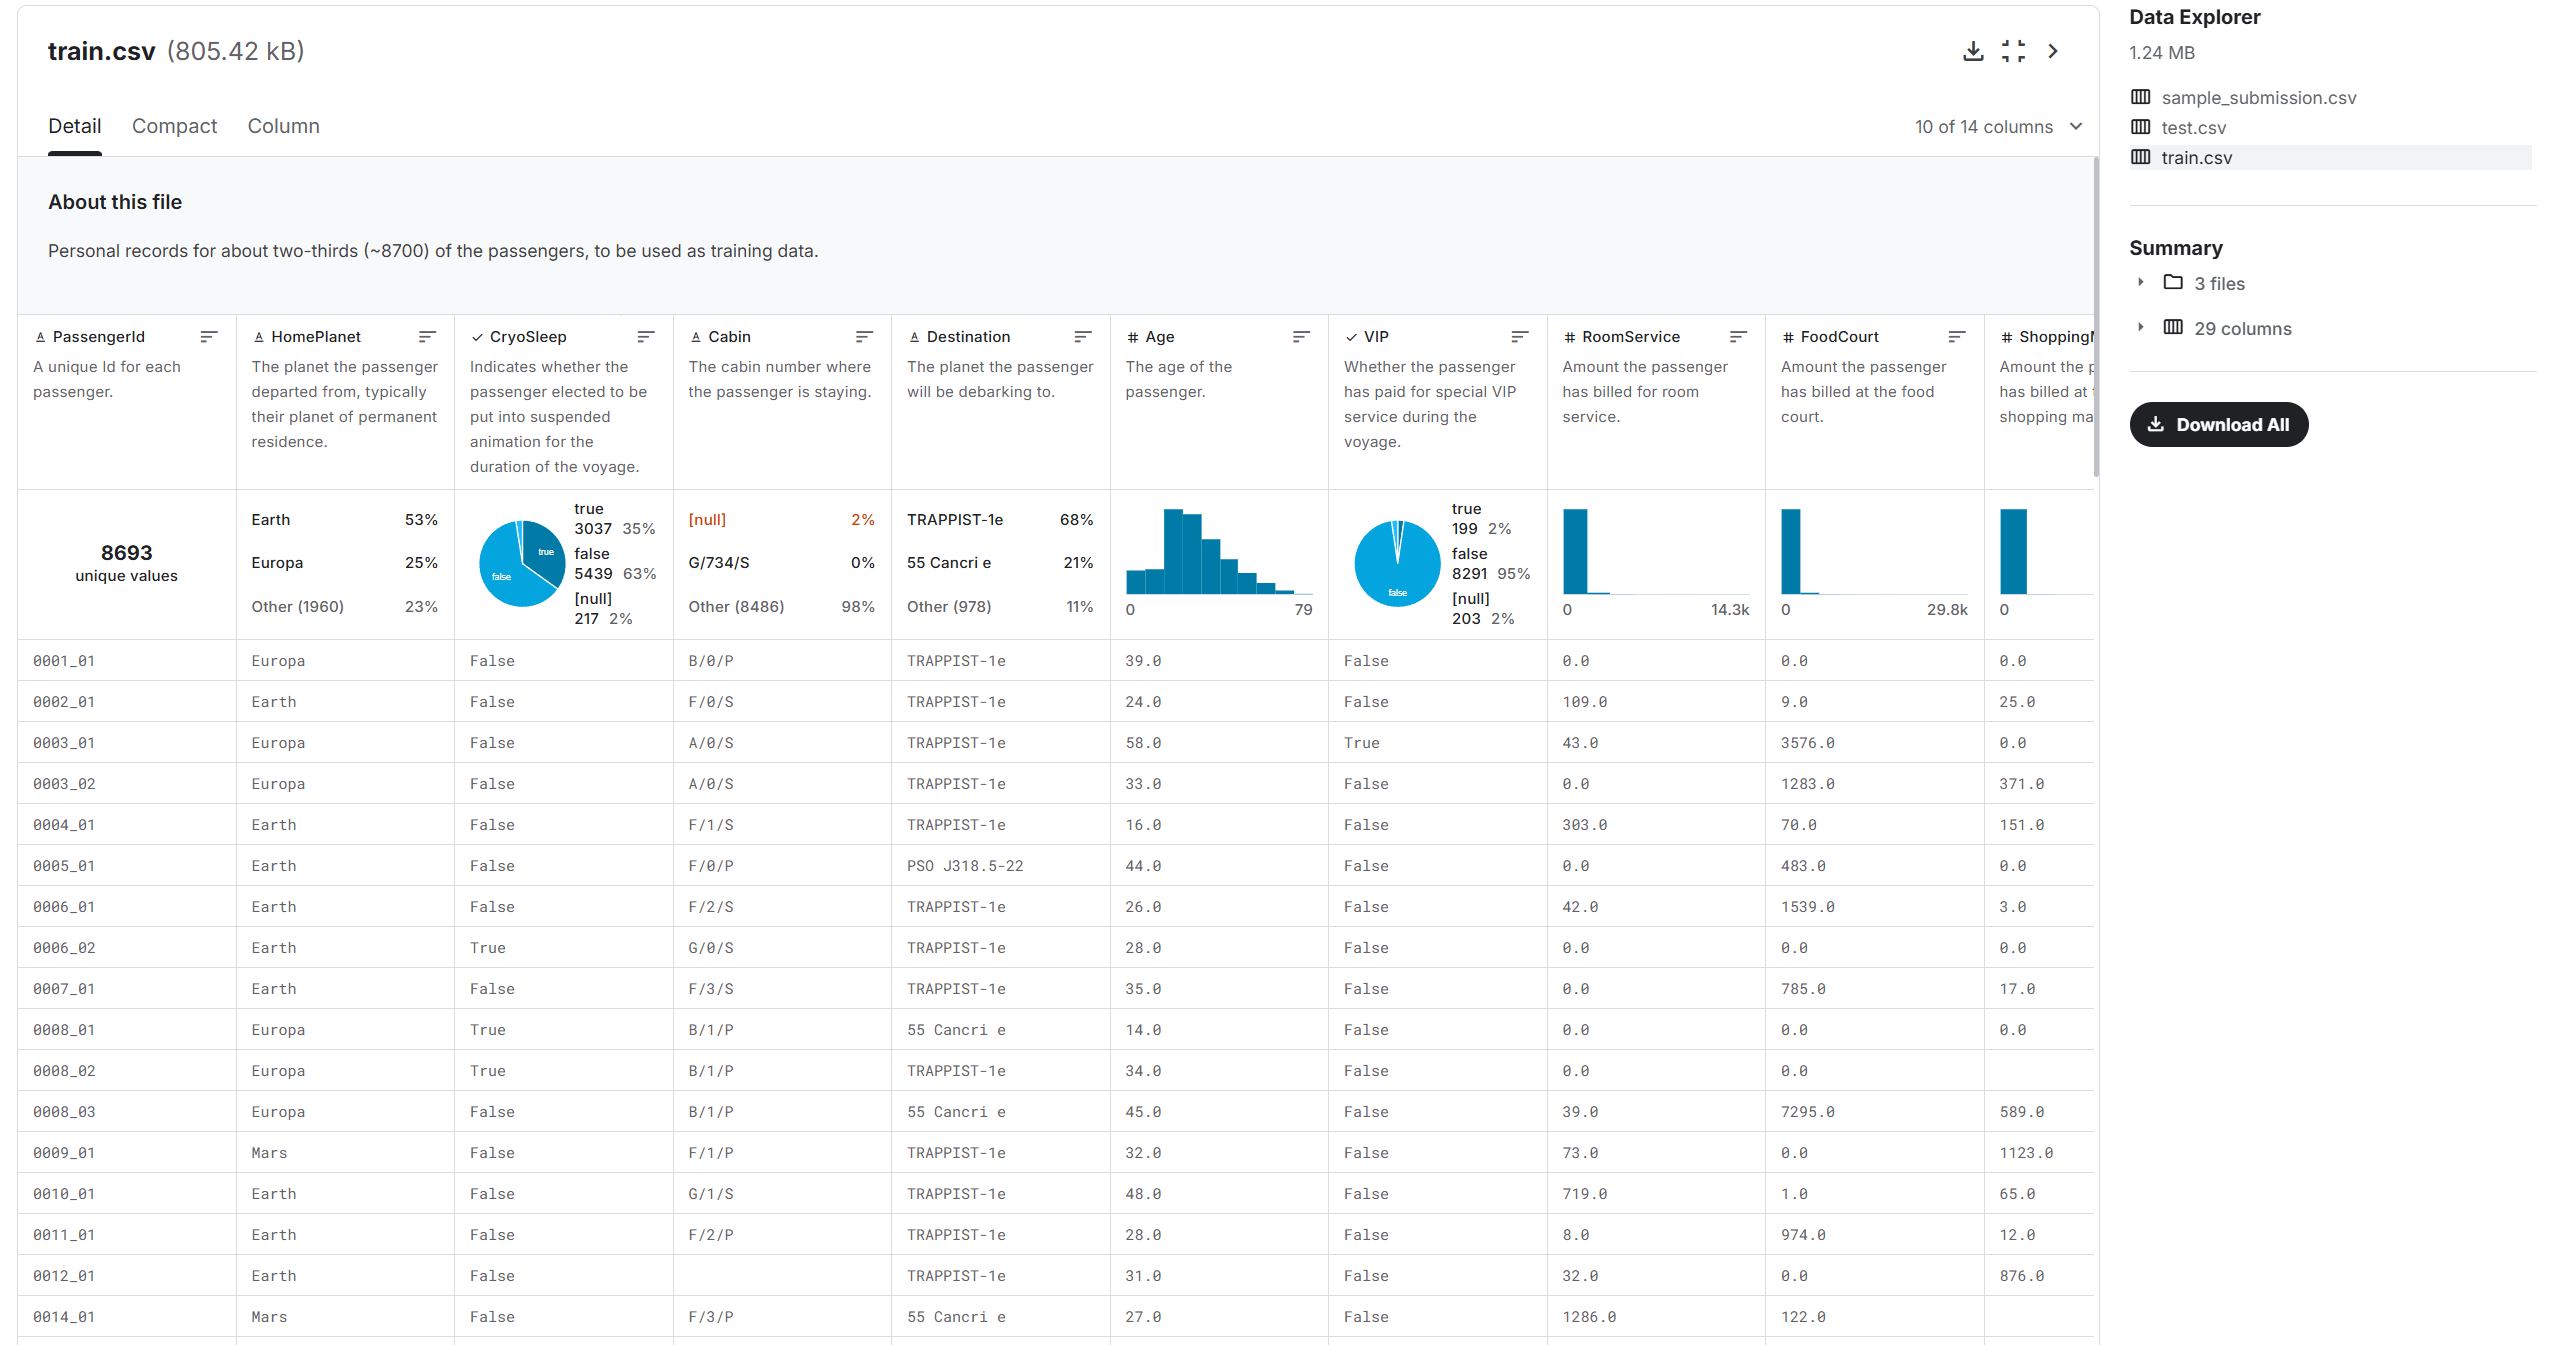
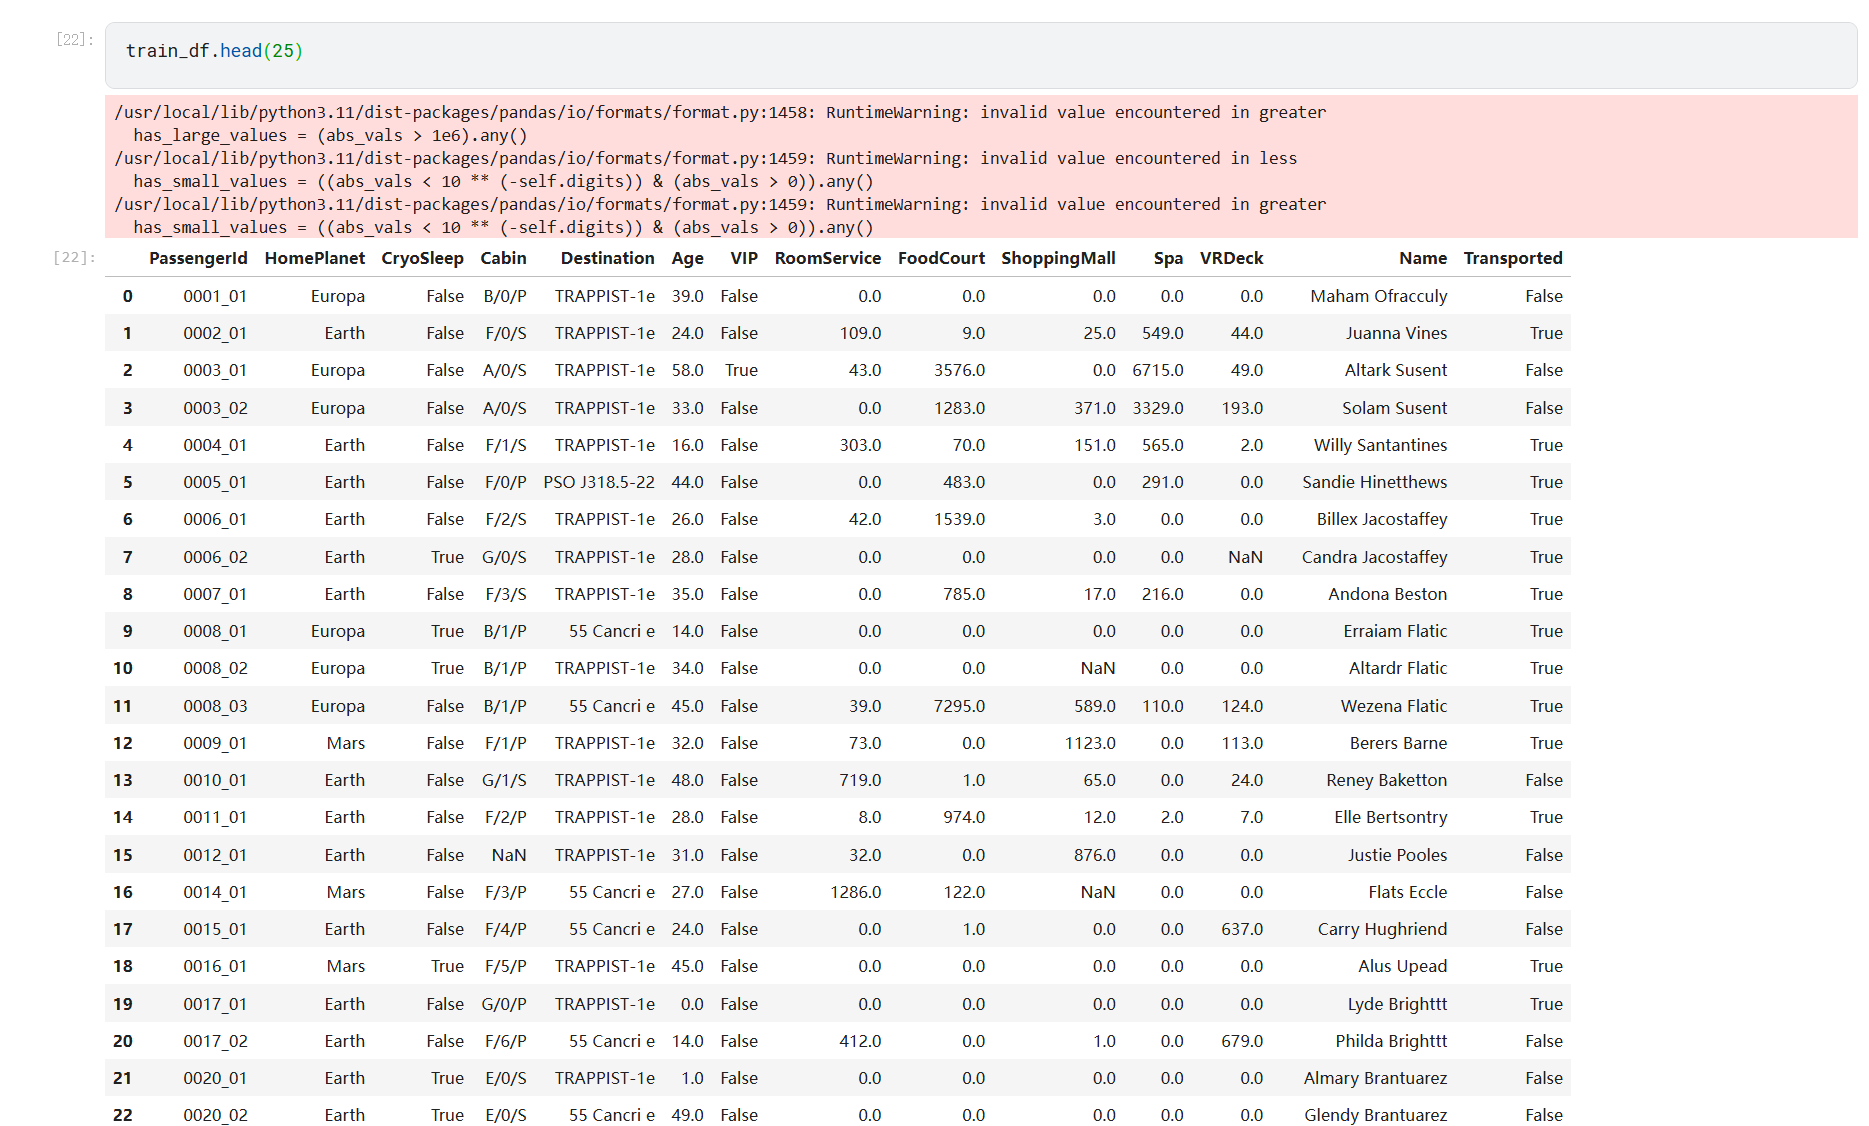
对上述csv文件中的数据进一步观察可以得知:
- 待处理的数据具有多种类型,包含:bool类型、字符型、数字型以及组合类型(Cabin列”B/0/P“)等
- 部分数据存在缺失,缺失部分对应的该乘客包含其他的数据段,因此不适合对其进行删除,而是需要找到合适的数据进行填充
- 在模型构建过程中,某些数据列可能不适合作为输入特征。以 Name 列为例,该列通常具有极高的唯一性(接近或等于样本数量级的基数),若将其纳入特征工程,可能导致以下问题:
- 数值型转换后产生的高维度稀疏特征
- 模型训练过程中的梯度不稳定现象
- 核心特征的权重被稀释
- 过拟合风险显著增加
因此在本例中,我们应该对不同种类不同类别的数据进行如下方面的处理:
-
数值型特征:对于如 Age 等列,选择用 中位数 填补缺失值。这一集中趋势度量因其对极端值(离群点)的鲁棒性和低敏感性而被选用,能更真实地反映数据分布
-
类别型特征:对于如HomePlanet、CryoSleep、VIP、Destination、Transported等列,采用 众数 (即最高频类别)填补缺失值。该技术通过赋予最可能的值来保留类别分布结构
-
特殊情况:
-
消费类列:对于消费类列(RoomService、FoodCourt、ShoppingWall、Spa、VRdeck),缺失值用 零 填补(一般情况下消费记录缺失意味着未发生交易),通过对上述列进行求和,聚合为一个新特征 TotalSpent(总消费额)
-
姓名类列: 对于Name列由于其中元素值具有唯一性,为了防止拟合过程中出现维度爆炸或特征重要性被稀释等情况,直接对该列进行删除处理
-
Cabin列:使用三个值来表示当前状态,具有较为复杂的特征,根据数据说明部分的内容,拆分成单独的特征(Deck、Num、Side),以便模型能独立分析每个组成部分的影响
-
在有了上述处理思路之后,接下来是详细的代码编写部分:
- 1,导入库和数据,展示部分数据
import numpy as np
import pandas as pd

train_df = pd.read_csv('/kaggle/input/spaceship-titanic/train.csv')
test_df = pd.read_csv('/kaggle/input/spaceship-titanic/test.csv')

train_df.head() # 展示数据的前五行
- 2,数据预处理部分
- 2.1 对于 Age 列的处理方法
-
- 计算训练集数据中 Age 这一列的中位数
-
- 对 训练集 和 测试集 中 Age 列中缺失的部分进行填充,填充值为训练集中Age列计算得到的中位数,避免数据泄露,确保测试集不受训练集分布的影响
-
- 相关函数或操作:
- 使用median()函数可以计算某一列的中位数
- 使用fillna()函数可以对某一列中的缺失值进行填充(缺失值默认为Nan)
-
# 计算训练数据集(train_df)中'Age'列的中位数(median)
median_age = train_df['Age'].median()
# 打印计算得到的中位数,便于调试或观察数据分布
print(median_age)

# 用训练集的中位数填充训练集'Age'列的缺失值(NaN)
train_df['Age'] = train_df['Age'].fillna(median_age)

# 注意:这里使用相同的训练集中位数填充测试集(test_df)的'Age'缺失值
# 这是为了避免数据泄漏(data leakage),确保测试集不受训练集分布的影响
test_df['Age'] = test_df['Age'].fillna(median_age)
- 2.2 对于 消费类别列 的处理方法
-
- 消费类别类包含:‘RoomService’, ‘FoodCourt’, ‘ShoppingMall’, ‘Spa’, ‘VRDeck’
-
- 消费记录缺失部分,假设乘客未对该项进行消费,因此对该部分进行 零的填充
-
- 训练集与测试集的该部分处理方式一致
-
- 对训练集和测试集中的所有消费类 按行 进行求和,作为消费部分的特征工程处理
-
- 相关函数或操作:
- 定义和消费类别名称一致的列表:spending_cols_zero
- 利用pandas能够对多列同时进行处理的特性,对spending_cols_zero列表中的缺失值进行 0填充
- 使用fillna()函数可以对某一列中的缺失值进行填充(缺失值默认为Nan)
- head()函数返回一个DataFrame对象的前五个值
- sum()函数对一个序列进行求和,通过axis参数指定求和方向
-
# 定义需要处理的消费类特征列(这些列代表乘客在不同场所的花费)
spending_cols_zero = ['RoomService', 'FoodCourt', 'ShoppingMall', 'Spa', 'VRDeck']

# 用 0 填充训练集(train_df)中消费类列的缺失值(NaN)
# 逻辑假设:如果某消费记录缺失,表示该乘客未产生此项消费(自然为0)
train_df[spending_cols_zero] = train_df[spending_cols_zero].fillna(0)

# 同样用 0 填充测试集(test_df)中相同的消费类列缺失值
# 注意:训练集和测试集采用相同处理方式,保证数据一致性
test_df[spending_cols_zero] = test_df[spending_cols_zero].fillna(0)

# 计算每名乘客在所有消费项目的总支出(沿行方向求和,axis=1)
train_df['TotalSpent'] = train_df[spending_cols_zero].sum(axis=1)  # 训练集总消费
test_df['TotalSpent'] = test_df[spending_cols_zero].sum(axis=1)    # 测试集总消费

# 打印前5行消费数据及总消费
print(train_df[['RoomService', 'FoodCourt', 'ShoppingMall', 'Spa', 'VRDeck', 'TotalSpent']].head())
- 2.3 对于如HomePlanet、CryoSleep、VIP、Destination、Transported等列的处理方法
-
- 上述所有列中元素均为字符串、布尔值,因此采用训练集的 众数 对缺失值进行填充
-
- 训练集与测试集填充内容一致
-
- 相关函数和操作:
- mode()函数:返回某一列的众数值,返回类型为列表(众数可能有多个),在本题中,我们选择第一个返回值作为 众数
- fillna()函数:对某一列中的缺失值部分进行填充
-
# --- HomePlanet(母星)特征处理 ---
# 获取训练集中乘客母星的众数
mode_homePlanet = train_df['HomePlanet'].mode()[0]  # [0]只取第一个作为本列的众数
# 用训练集众数填充训练集和测试集的缺失值(避免数据泄漏)
train_df['HomePlanet'] = train_df['HomePlanet'].fillna(mode_homePlanet)
test_df['HomePlanet'] = test_df['HomePlanet'].fillna(mode_homePlanet)

# --- CryoSleep(低温睡眠)特征处理 ---
mode_cryoSleep = train_df['CryoSleep'].mode()[0]  # [0]只取第一个作为本列的众数
train_df['CryoSleep'] = train_df['CryoSleep'].fillna(mode_cryoSleep)
test_df['CryoSleep'] = test_df['CryoSleep'].fillna(mode_cryoSleep)

# --- Destination(目的地)特征处理 ---
mode_destination = train_df['Destination'].mode()[0]  # 最高频目的地
train_df['Destination'] = train_df['Destination'].fillna(mode_destination)
test_df['Destination'] = test_df['Destination'].fillna(mode_destination)

# --- VIP(贵宾身份)特征处理 ---
mode_vip = train_df['VIP'].mode()[0]  # [0]只取第一个作为本列的众数
train_df['VIP'] = train_df['VIP'].fillna(mode_vip)
test_df['VIP'] = test_df['VIP'].fillna(mode_vip)

# --- Transported(运输状态)标签列处理 ---
mode_transported = train_df['Transported'].mode()[0]  # 可能是True/False
# 注意:测试集不含此列,因其是待预测的目标变量
train_df['Transported'] = train_df['Transported'].fillna(mode_transported)
- 2.4 对于 Name 列的处理方法
-
- 对于Name列由于其中元素值具有唯一性,为了防止拟合过程中出现维度爆炸或特征重要性被稀释等情况,直接对训练集和测试集中的该列进行删除处理
-
- 相关函数和操作:
- drop()函数能够删除某一列,并返回删除之后的结果,由于需求是按列删除,因此 axis参数需要设置为1 (默认为axis=0表示按行删除)
-
# 从训练集(train_df)中删除'Name'列
# axis=1表示按列删除(与axis=0按行删除对应)
train_df = train_df.drop('Name', axis=1)
test_df = test_df.drop('Name', axis=1)
- 2.5 对于 Cabin 列的处理方式
-
- 检测乘客是否有仓位,其中有仓位以“1”表示,无仓位以“0”表示,创建新的一列用于存储这个标记值
-
- 将Cabin列中的内容按照“/”进行分割,并将分割结果存储为[‘Deck’,‘Num’,‘Side’],移除原有的Cabin列
-
- 对于Deck和Side位置,使用众数进行填充;对于Num位置,使用中位数进行填充,本例中,Num类型为string,需要将其转换成数字类型再求中位数
-
- 相关的操作或函数:
- notna()可以检测某列中元素是否为空值,配合astype(int)可将返回值转换成0/1,其中0表示无仓位
- split()函数可以指定对某个对象按照某一个符号进行分割,当 expand=True 时,str.split() 会将拆分后的结果自动展开为一个 DataFrame,每一部分分配到单独的列
- to_numeric()函数可以将对象转换为数值型
-
# 【步骤1】创建舱位存在标识特征
# 生成二进制特征HasCabin,标记乘客是否有舱位记录
# notna()检测非空值,astype(int)转换为0/1
train_df['HasCabin'] = train_df['Cabin'].notna().astype(int)  # 1表示有舱位记录,0表示无
test_df['HasCabin'] = test_df['Cabin'].notna().astype(int)    # 测试集同步处理

# 【步骤2】拆分复合舱位信息
# 将Cabin列按'/'分割为三个子特征(甲板/编号/船舷)
# expand=True将分割结果转换为DataFrame的三列
train_df[['Deck', 'Num', 'Side']] = train_df['Cabin'].str.split('/', expand=True)
test_df[['Deck', 'Num', 'Side']] = test_df['Cabin'].str.split('/', expand=True)

# 【步骤3】移除原始Cabin列
# 已提取全部有用信息,删除原始列减少维度
train_df = train_df.drop('Cabin', axis=1)  # axis=1表示列删除
test_df = test_df.drop('Cabin', axis=1)

# 【步骤4】处理拆分后的缺失值
# --- 分类特征处理(甲板Deck和船舷Side)---
deck_mode = train_df['Deck'].mode()[0]    # 获取甲板众数(如'F')
side_mode = train_df['Side'].mode()[0]    # 获取船舷众数(如'S')

# 用训练集众数填充训练集和测试集
train_df['Deck'] = train_df['Deck'].fillna(deck_mode)
test_df['Deck'] = test_df['Deck'].fillna(deck_mode)
train_df['Side'] = train_df['Side'].fillna(side_mode)
test_df['Side'] = test_df['Side'].fillna(side_mode)

# --- 数值特征处理(舱位编号Num)---
# 转换数据类型为数值型(原为分割后的字符串)
train_df['Num'] = pd.to_numeric(train_df['Num'])
test_df['Num'] = pd.to_numeric(test_df['Num'])

# 用训练集中位数填充缺失编号
num_median = train_df['Num'].median()
train_df['Num'] = train_df['Num'].fillna(num_median)
test_df['Num'] = test_df['Num'].fillna(num_median)
以上就是数据分析与预处理部分的内容了,经过上述处理之后,我们再次使用 head() 函数打印出处理之后的训练集的前25行,结果如下:
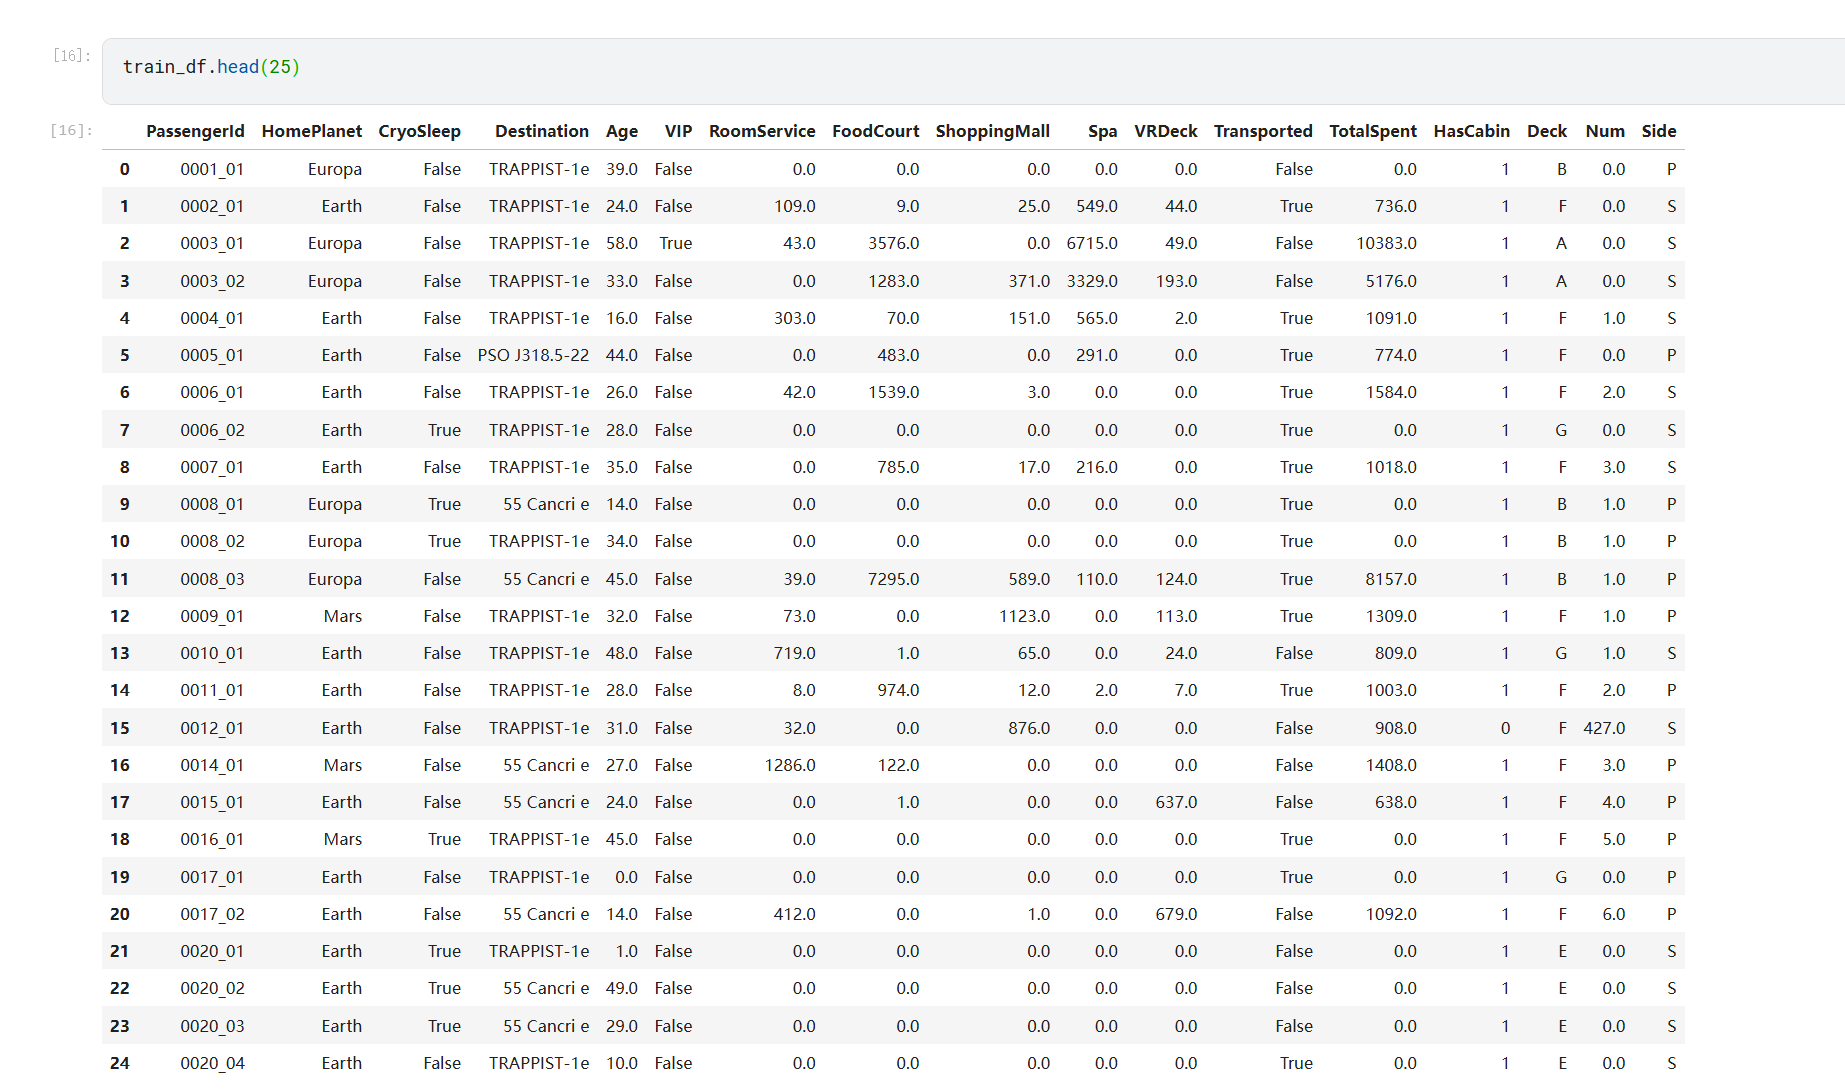
数据清洗后的结果与初始展示的前25行样本对比显著:原有的缺失值(NaN)已被完整填充,各特征列经过规范化处理达到结构统一。当前数据集已完成预处理阶段,符合机器学习模型训练的输入标准。
以上就是本期的所有内容了,如果您在阅读本文的过程中有所收获,或者有任何宝贵的建议和想法,欢迎通过邮箱、微信或者留言等方式给我留言交流,或者是访问我的个人博客 南徽玉的个人博客(正在维护),您的每一次建议都将是我前进的动力!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 29
 0
- 0


 已为社区贡献2条内容

所有评论(0)