【机器学习】支持向量机 SVM
什么是支持向量机:
支持向量机(support vector machine),故一般简称SVM,通俗来讲,它是一种二分类模型,其基本模型定义为特征空间上的间隔最大的线性分类器,这族分类器的特点是他们能够同时最小化经验误差与最大化几何边缘区,因此支持向量机也被称为最大边缘区分类器。其学习策略便是间隔最大化,最终可转化为一个凸二次规划问题的求解。SVM在很多领域有很多的应用,比如文本分类,图像分类,手写字符识别等。
一、 最大间隔与分类
假设给定一些分属于两类的2维点,这些点可以通过直线分割, 我们要找到一条最优的分割线,如何来界定一个超平面是不是最优的呢?
如图:

在上面的图中,a和b都可以作为分类超平面,但最优超平面只有一个,最优分类平面使间隔最大化。 那是不是某条直线比其他的更加合适呢? 我们可以凭直觉来定义一条评价直线好坏的标准:
距离样本太近的直线不是最优的,因为这样的直线对噪声敏感度高,泛化性较差。 因此我们的目标是找到一条直线(图中的最优超平面),离所有点的距离最远,容忍性好, 鲁棒性高, 泛化能力最强。 由此, SVM算法的实质是找出一个能够将某个值最大化的超平面,这个值就是超平面离所有训练样本的最小距离。这个最小距离用SVM术语来说叫做间隔(margin)。
如果用xxx表示数据点,用yyy表示类别(yyy可以取1或者-1,分别代表两个不同的类),一个线性分类器的学习目标便是要在 n 维的数据空间中找到一个超平面(hyper plane),这个超平面的方程可以表示为( wTw^TwT中的T代表转置):
wTx+b=0w^Tx+b = 0 wTx+b=0间隔:b∣∣w∣∣ 间隔:\frac{b}{||w||}间隔:∣∣w∣∣b
例如:现在有一个二维平面,平面上有两种不同的数据。由于这些数据是线性可分的,所以可以用一条直线将这两类数据分开,这条直线就相当于一个超平面,超平面一边的数据点所对应的y全是-1 ,另一边所对应的y全是1。
超平面方程:f(x)=wTx+bf(x)=w^Tx+bf(x)=wTx+b当f(x) 等于0的时候,x便是位于超平面上的点,而f(x)大于0的点对应 y=1 的数据点,f(x)小于0的点对应y=-1的点,如下图所示:
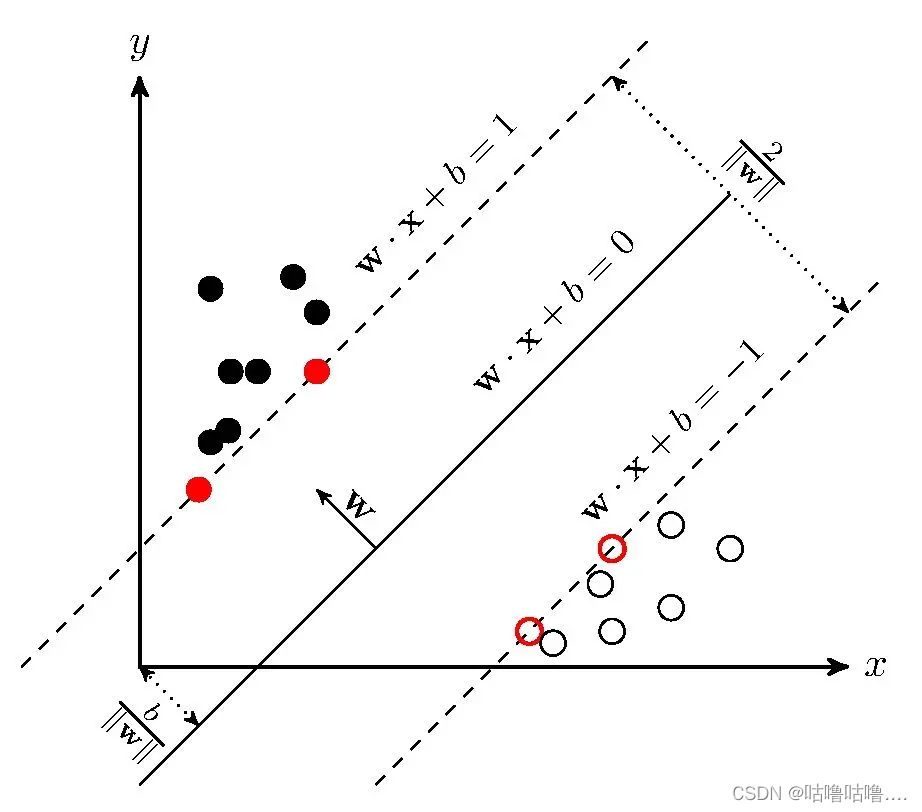
一个点距离超平面的远近可以表示分类预测的确信或准确程度,如何确定这个超平面呢?
从直观上而言,这个超平面应该是最适合分开两类数据的直线。而判定“最适合”的标准就是这条直线离直线两边的数据的间隔最大。所以,得寻找有着最大间隔的超平面。
对于给定的训练数据集T和超平面(w,b),定义超平面(w,b)关于样本点(xi,yi)(x_i,y_i)(xi,yi)的函数间隔为:γ=yi(wxi+b)\gamma=y_i(wx_i+b)γ=yi(wxi+b)定义超平面(w,b)关于训练数据集T的函数间隔为超平面(w,b)关于T中所有样本点(xi,yi)(x_i,y_i)(xi,yi)的函数间隔之最小值,γ=mini=1Nγi\gamma=min_{i=1}^{N}\gamma_iγ=mini=1Nγi
超平面(w,b)关于样本点(xi,yi)(x_i,y_i)(xi,yi)的几何间隔一般是实例点到超平面的带符号的距离(signed distance),当样本点被超平面正确分类时就是实例点到超平面距离。
函数间隔和几何间隔的关系:
γ=b∣∣w∣∣\gamma=\frac{b}{||w||}γ=∣∣w∣∣b
如果∣∣w∣∣||w||∣∣w∣∣等于1,那么函数间隔和几何间隔相等,如果超平面参数w和b成比例地改变(超平面没有改变),函数间隔也按比例改变,而几何间隔不变。
间隔最大化的直观解释是:
对训练数据集找到几何间隔最大的超平面,意味着以充分大的确信度对训练数据进行分类。也就是说,不仅将正负实例点分开,而且对最难分的实例点(离超平面最近的点)也有足够大的确信度将它们分开。这样的超平面应该对未知的新实例有很好的分类预测能力。
按照我们前面的分析,对一个数据点进行分类,当它的margin越大的时候,分类的confidence越大。 对于一个包含n个点的数据集,我们可以很自然地定义它的margin为所有这n个点的margin值中最小的那个。于是,为了使得分类的confidence高,我们希望所选择的超平面hyper plane能够最大化这个margin值。让所选择的超平面能够最大化这个“间隔”值,这个间隔就是下图中的Gap的一半:
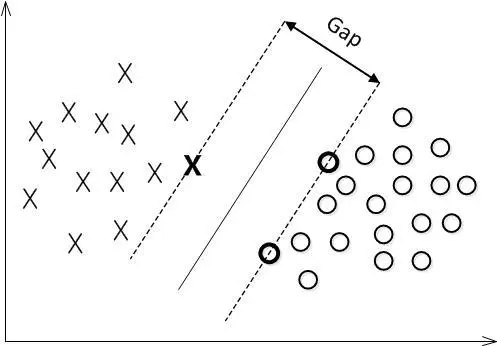
SVM中,分隔超平面是一个能够将正负样本恰好隔开的超平面,并且使得正样本在分隔超平面“上方”,负样本在分隔超平面“下方”,这就意味着wTx+b=0w^Tx+b=0wTx+b=0,分隔超平面中的w,bw,bw,b需要满足以下条件:
wTxi+b>0,ifyi=+1wTxi+b<0,ifyi=−1即:∃w,b,yi(wTxi+b)>0⇒∃w,b,c,yi(wTxi+b)≥c and c>0⇒∃w,b,yi(wTxi+b)≥1w^Tx_i+b>0,if y_i=+1 \\w^Tx_i+b<0,if y_i=-1 \\ 即:\exists w,b,y_i(w^Tx_i+b)>0 \Rightarrow \exists w,b,c,y_i(w^Tx_i+b)\geq c \ and \ c >0 \\
\Rightarrow \exists w,b,y_i(w^Tx_i+b)\geq 1wTxi+b>0,ifyi=+1wTxi+b<0,ifyi=−1即:∃w,b,yi(wTxi+b)>0⇒∃w,b,c,yi(wTxi+b)≥c and c>0⇒∃w,b,yi(wTxi+b)≥1于是对于训练数据D=x,D={xi,yix_i,y_ixi,yi}i=1mxεRn,yε^m_{i=1} x \varepsilon R^n,y\varepsiloni=1mxεRn,yε{-1,+1},当且仅当∃w,b,s.t.yi(wTxi+b)≥1\exists w,b,s.t.y_i(w^Tx_i+b)\geq1∃w,b,s.t.yi(wTxi+b)≥1时线性可分
间隔d=2∣∣w∣∣d=\frac{2}{||w||}d=∣∣w∣∣2
解释一下这个间隔的由来:
上图中的x1点代入得到式1:wTxi+b=1,x2代入得到式2:wTx2+b=−1,将式1−式2得到:wT(x→1−x→2)=2,根据向量相乘的性质∣∣w∣∣∗∣∣x→1−x→2∣∣∗cosθ=2,由上图可以看出∣∣x→1−x→2∣∣∗cosθ=d,即∣∣w∣∣∗d=2,所以d=2∣∣w∣∣1:w^Tx_i+b=1,x_2代入得到式2:w^Tx_2+b=-1,\\将式1-式2得到:w^T(\overrightarrow x_1-\overrightarrow x_2)=2,\\ 根据向量相乘的性质||w||*||\overrightarrow x_1-\overrightarrow x_2||*cos\theta=2,\\ 由上图可以看出||\overrightarrow x_1-\overrightarrow x_2||*cos\theta=d,即||w||*d=2,所以d=\frac{2}{||w||}1:wTxi+b=1,x2代入得到式2:wTx2+b=−1,将式1−式2得到:wT(x1−x2)=2,根据向量相乘的性质∣∣w∣∣∗∣∣x1−x2∣∣∗cosθ=2,由上图可以看出∣∣x1−x2∣∣∗cosθ=d,即∣∣w∣∣∗d=2,所以d=∣∣w∣∣2
最大化间隔也就是寻找参数w和b,使得d最大,即:argmaxw,b2∣∣w∣∣s.t.yi(wTxi+b)≥1,i=1,2,…,m求2∣∣w∣∣的最大值,就是求其倒数的最小值,求最大值我们利用求导获取极限值来解题,简化计算,因此问题可以等价于求∣∣w∣∣22的最小值:argminw,b12∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,…,m上式就是求解最大间隔超平面的表达式。argmax_{w,b} \frac{2}{||w||}\\s.t.y_i(w^Tx_i+b)\geq1,i=1,2,…,m \\ 求\frac{2}{||w||}的最大值,就是求其倒数的最小值,求最大值我们利用求导获取极限值来解题,\\ 简化计算,因此问题可以等价于求\frac{||w||^2}{2}的最小值:\\argmin_{w,b} \frac{1}{2}||w||^2\\s.t.y_i(w^Tx_i+b)\geq1,i=1,2,…,m \\上式就是求解最大间隔超平面的表达式。argmaxw,b∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,…,m求∣∣w∣∣2的最大值,就是求其倒数的最小值,求最大值我们利用求导获取极限值来解题,简化计算,因此问题可以等价于求2∣∣w∣∣2的最小值:argminw,b21∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,…,m上式就是求解最大间隔超平面的表达式。
二、 对偶问题
-
等式约束
假设我们的目标函数是f(x),约束条件hi(x)=0h_i ( x ) = 0hi(x)=0 ,即:minf(x)s.t. hi(x)=0 i=1,2,3…minf(x)\\s.t. \ h_i(x)=0 \ i=1,2,3…minf(x)s.t. hi(x)=0 i=1,2,3…
这里的x表示的是向量(x1,x2,…xm)(x_1,x_2,…x_m)(x1,x2,…xm)
解决这类问题主要有以下几个步骤:
1.构造拉格朗日函数:F(x)=fx)+∑i=1mλihi(x)F(x)=fx)+\sum_{i=1}^m\lambda_ih_i(x)F(x)=fx)+i=1∑mλihi(x)
2.对变量求偏导
3.联合等式约束条件和偏导等于0进行求解得到极值点(最优解),再将极值点代入我们的目标函数,得到最小值。 -
我们先看一下支持向量机的目标函数与约束函数:
argminw,b12∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,…,m第一步:引入拉格朗日乘子αi≥0得到拉格朗日函数L(w,b,a)=12∣∣W∣∣2−∑i=1mai(yi(wTxi+b)−1)第二步:令L(w,b,α)对w和b的偏导为零w=∑i=1maiyixi,∑i=1maiyi=0第三步:wb回代到第一步minα12∑i=1j=1αiαjyiyjxiTxj−∑i=1mαis.t.∑i=1mαiyi=0,αi≥0,i=1,2…m第四步:转换为对偶形式maxα∑i=1mαi−12∑j−1mαiαjyiyjxiTxjs.t.∑i=1mαiyi=0第五步:最终模型f(x)=wTx+b=∑i=1mαiyixiTx+b,未知数为αiargmin_{w,b} \frac{1}{2}||w||^2\\s.t.y_i(w^Tx_i+b)\geq1,i=1,2,…,m \\ 第一步:引入拉格朗日乘子\alpha_i\geq0得到拉格朗日函数\\L(w,b,a)=\frac{1}{2}||W||^2-\sum_{i=1}^ma_i(y_i(w^Tx_i+b)-1)\\第二步:令L(w,b,\alpha)对w和b的偏导为零\\w=\sum_{i=1}^{m}a_iy_ix_i,\sum_{i=1}^ma_iy_i=0\\第三步:wb回代到第一步\\ min_{\alpha}\frac{1}{2}\sum_{i=1}^{j=1}\alpha_i\alpha_jy_iy_jx_i^Tx_j-\sum_{i=1}^m\alpha_i\\s.t.\sum_{i=1}^m\alpha_iy_i=0,\alpha_i\geq0,i=1,2…m\\第四步:转换为对偶形式\\max_{\alpha}\sum_{i=1}^m\alpha_i-\frac{1}{2}\sum_{j-1}^m\alpha_i\alpha_jy_iy_jx_i^Tx_j \\ s.t.\sum_{i=1}^m\alpha_iy_i=0 \\第五步:最终模型\\f(x)=w^Tx+b=\sum_{i=1}^m\alpha_iy_ix_i^Tx+b,未知数为\alpha_iargminw,b21∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,…,m第一步:引入拉格朗日乘子αi≥0得到拉格朗日函数L(w,b,a)=21∣∣W∣∣2−i=1∑mai(yi(wTxi+b)−1)第二步:令L(w,b,α)对w和b的偏导为零w=i=1∑maiyixi,i=1∑maiyi=0第三步:wb回代到第一步minα21i=1∑j=1αiαjyiyjxiTxj−i=1∑mαis.t.i=1∑mαiyi=0,αi≥0,i=1,2…m第四步:转换为对偶形式maxαi=1∑mαi−21j−1∑mαiαjyiyjxiTxjs.t.i=1∑mαiyi=0第五步:最终模型f(x)=wTx+b=i=1∑mαiyixiTx+b,未知数为αi -
不等式约束的KKT条件
给定一个目标函数 f : Rn→R,希望找到x∈Rn ,在满足约束条件g(x)=0的前提下,使得f(x)有最小值。该约束优化问题记为:
minf(x)s.t. g(x)=0minf(x)\\s.t. \ g(x)=0minf(x)s.t. g(x)=0
可建立拉格朗日函数:L(x,λ)=f(x)+λg(x))L(x,\lambda)=f(x)+\lambda g(x))L(x,λ)=f(x)+λg(x)) 其中 λ 称为拉格朗日乘数。因此,可将原本的约束优化问题转换成等价的无约束优化问题:
minx,λ∣(x,λ)min_{x,\lambda}|(x,\lambda)minx,λ∣(x,λ)
分别对待求解参数求偏导,可得:
∇xL=αLαλ=∇f+λ∇g(x)=0∇λL=αLαλ=g(x)=0\nabla_xL=\frac{\alpha L}{\alpha \lambda}=\nabla f+\lambda \nabla g(x)=0\\ \nabla_{\lambda}L=\frac{\alpha L}{\alpha \lambda}=g(x)=0∇xL=αλαL=∇f+λ∇g(x)=0∇λL=αλαL=g(x)=0
一般联立方程组可以得到相应的解。
将约束等式 g(x)=0 推广为不等式 g(x)≤0。
这个约束优化问题可改为:
minf(x)s.t. g(x)≤0minf(x) \\ s.t. \ g(x)\leq0minf(x)s.t. g(x)≤0
同理,其拉格朗日函数为:
L(x,λ)=f(x)+λg(x)L(x,\lambda)=f(x)+\lambda g(x)L(x,λ)=f(x)+λg(x)
拉格朗日乘子法的几何意义即在等式g(x)=0或在不等式约束g(x)≤0下最小化目标函数f(x)。
其约束范围为不等式,因此可等价转换为KKT条件:
∇xL=∇f+λ∇g=0g(x)≤0λ≥0λg(x)=0\nabla_x L=\nabla f+\lambda \nabla g=0 \\g(x)\leq0\\ \lambda\geq0 \\ \lambda g(x)=0∇xL=∇f+λ∇g=0g(x)≤0λ≥0λg(x)=0
在此基础上,通过优化方式,求解其最优解。
from numpy import *
import matplotlib.pyplot as plt

# 读取数据
def loadDataSet(fileName):
    dataMat = []                                               # 数据矩阵
    labelMat = []                                              # 数据标签
    fr = open(fileName)                                        # 打开文件
    for line in fr.readlines():                                # 遍历,逐行读取
        lineArr = line.strip().split()                     # 去除空格
        dataMat.append([float(lineArr[0]), float(lineArr[1])]) # 数据矩阵中添加数据
        labelMat.append(float(lineArr[2]))                     # 数据标签中添加标签
    return dataMat, labelMat


# 绘制数据集
def showData():
    dataMat, labelMat = loadDataSet('SVMdata.txt')         # 加载数据集,标签
    dataArr = array(dataMat)                               # 转换成numPy的数组
    n = shape(dataArr)[0]                                  # 获取数据总数
    xcord1 = []; ycord1 = []                               # 存放正样本
    xcord2 = []; ycord2 = []                               # 存放负样本
    for i in range(n):                                     # 依据数据集的标签来对数据进行分类
        if int(labelMat[i]) == 1:                          # 数据的标签为1,表示为正样本
            xcord1.append(dataArr[i, 0]); ycord1.append(dataArr[i, 1])
        else:                                              # 否则,若数据的标签不为1,表示为负样本
            xcord2.append(dataArr[i, 0]); ycord2.append(dataArr[i, 1])
    fig = plt.figure()
    ax = fig.add_subplot(111)
    ax.scatter(xcord1, ycord1, s=15, c='blue')             # 绘制正样本
    ax.scatter(xcord2, ycord2, s=15, c='red', marker='s')  # 绘制负样本
    plt.title('DateSet')                                   # 标题
    plt.xlabel('X1'); plt.ylabel('X2')                     # x,y轴的标签
    plt.show()


showData()
运行结果:
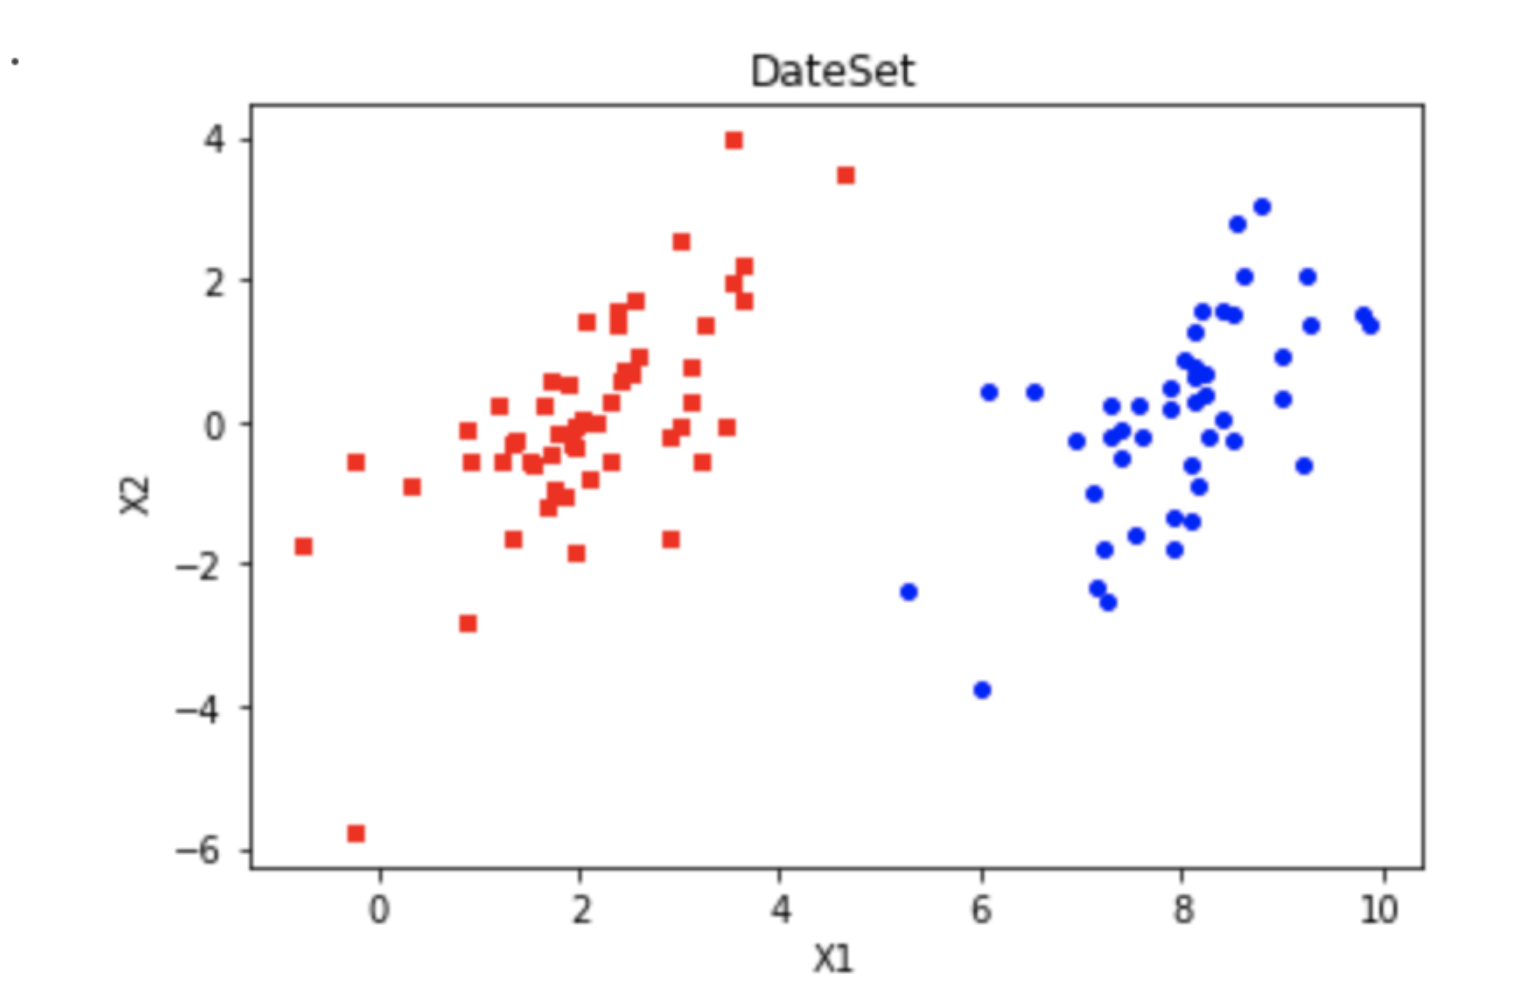
三、 总结
优点:
- 可用于线性/非线性分类,也可以用于回归,泛化错误率低,也就是说具有良好的学习能力,且学到的结果具有很好的推广性。
- 可以解决小样本情况下的机器学习问题,可以解决高维问题,可以避免神经网络结构选择和局部极小点问题。
- SVM是最好的现成的分类器,现成是指不加修改可直接使用。并且能够得到较低的错误率,SVM可以对训练集之外的数据点做很好的分类决策。
缺点:
- 对参数调节和和函数的选择敏感。
- 适用的数据类型:
数值型和标称型数据

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 17
 0
- 0


 已为社区贡献3条内容

所有评论(0)