k-means算法Python实现--机器学习ML
k-means algorithm
一些概念
partial clustering:每一簇的数据不重叠,至少一簇一个数据;
hieraichical clustering:通过构建层次结构来确定聚类分配;
density-based clustering:根据密度分配,在被低密度区域分隔的高密度数据点的地方分配集群;
import packages
import matplotlib.pyplot as plt
from kneed import KneeLocator
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler
generate data
features,true_labels = make_blobs(n_samples = 200,
                                  centers = 3,
                                  cluster_std = 2.75,
                                  random_state = 42)
功能:生成各向同性的高斯斑点以进行聚类(产生数据集和相应的标签)
参数:
- n_samples-int(在簇之间平均分配的点总数)或数组(每个元素表示每个簇的样本数)
- n_features-int,每个样本的特征数量
- centers-要生成的中心数或者固定的中心位置,如果n_samples是一个int且center为None,则生成3个中心;如果n_samples是数组,则中心必须为None或者长度等于n_samples长度的数组
- cluster_std-浮点数或浮点数序列,聚类的标准偏差
- center_box-一对浮点数,随机生成中心时每个聚类中心的边界框
- shuffle-样本洗牌
- random_state-用于创建数据集的随机数生成
返回值
- 形状为[n_samples,n_features]的X数组
- 形状为[n_samples]的y数组
standarization
目的
- 对数据进行标准化处理,可以加快梯度下降求最优解的速度,还有可能提高精度(防止结果被过大的特征值主导)
方法
- zero-mean normalized:X=(x−μ)sigmaX=(x-\mu)^{sigma}X=(x−μ)sigma,通常用于一些通过距离得出相似度的聚类算法中
- min-max normalized:(x−Xmin)/(x−Xmax)(x-X_{min})/(x-X_{max})(x−Xmin)/(x−Xmax),线性的归一化手段,特点是不会对数据分布产生影响,在图像处理上常用
- non-linear normalized:包括log,exp,arctan,sigmoid等
- length-one normalized:x=x∥x∥x=\frac{x}{\left\|x\right\|}x=∥x∥x,把特征转为单位向量的形式,可以剔除特征的强度影响,用在不考虑向量大小而考虑向量方向的问题中,如文本情感的分类
scaler = StandardScaler()
scaled_features = scaler.fit_transform(features)
clustering
参数
- n_clusters:聚类中心数量
- max_iter:最大迭代次数
- tol:容忍度最小误差,误差小于tol就会退出迭代
- n_init:随机运行的次数,最终的结果将是最好的一个聚类结果
- init:聚类中心的初始化方案,有{‘k-means++’,‘random’,an ndarray},ndarray则矩阵的每一行作为聚类中心
- algorithm:可选的距离计算算法{‘auto’,‘full’,‘elkan’}
- precompute_distances : 是否将数据全部放入内存计算,可选{‘auto’, True, False},开启时速度更快但是更耗内存
- random_state : 用于随机产生中心的随机序列
- verbose : 是否输出详细信息,默认为0,bush
- copy_x : 是否直接在原矩阵上进行计算。默认为True,会copy一份进行计算。
kmeans = KMeans(
        init = 'random',
        n_clusters = 3,
        max_iter = 300,
        random_state = 42
)
对数据执行kmeans算法
kmeans.fit(scaled_features)
KMeans(algorithm='auto', copy_x=True, init='random', max_iter=300, n_clusters=3,
       n_init=10, n_jobs=None, precompute_distances='auto', random_state=42,
       tol=0.0001, verbose=0)
lowest SSE
kmeans.inertia_
74.57960106819854
final locations of the centroid
kmeans.cluster_centers_
array([[-0.25813925,  1.05589975],
       [-0.91941183, -1.18551732],
       [ 1.19539276,  0.13158148]])
choose the appropriate number of clusters
elbow method
kmeans_kwargs = {
    'init':'random',
    'n_init':10,
    'max_iter':300,
    'random_state':42,
}
sse = []
for k in range(1,11):
    kmeans = KMeans(n_clusters = k,**kmeans_kwargs)
    kmeans.fit(scaled_features)
    sse.append(kmeans.inertia_)
 plt.style.use("fivethirtyeight")
 plt.plot(range(1, 11), sse)
 plt.xticks(range(1, 11))
 plt.xlabel("Number of Clusters")
 plt.ylabel("SSE")
 plt.show()
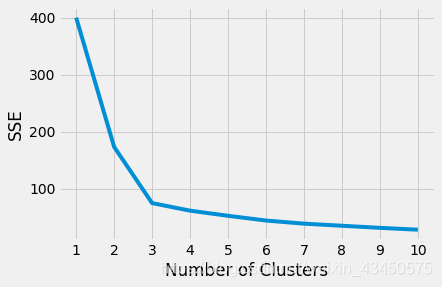
- 发现sse的大小随着聚类数量的增加在逐渐减小
- 使用函数来找到‘肘点’
kl = KneeLocator(
    range(1,11),sse,
    curve = 'convex',direction = 'decreasing'
)
kl.elbow
3
silhouette coefficient
- 是一个对集群内聚和分离的量度,基于两个参数:
- 数据点与集群内其他点的距离有多近
- 数据点与其他集群内的点的距离有多远
- 越大表示数据点更接近于他们的集群而不是其他集群
silhouette_coefficients = []

for k in range(2,11):
    kmeans = KMeans(n_clusters = k,**kmeans_kwargs)
    kmeans.fit(scaled_features)
    score = silhouette_score(scaled_features,kmeans.labels_)
    silhouette_coefficients.append(score)
plt.style.use("fivethirtyeight")
plt.plot(range(2, 11), silhouette_coefficients)
plt.xticks(range(2, 11))
plt.xlabel("Number of Clusters")
plt.ylabel("Silhouette Coefficient")
plt.show()
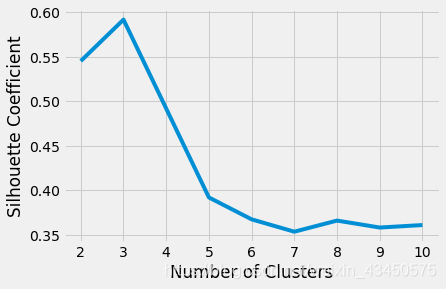
evaluating
When comparing k-means against a density-based approach on nonspherical clusters, the results from the elbow method and silhouette coefficient rarely match human intuition
from sklearn.cluster import DBSCAN
from sklearn.datasets import make_moons
from sklearn.metrics import adjusted_rand_score
features,true_labels = make_moons(
        n_samples = 250,noise = 0.05,random_state = 42
)
scaled_features = scaler.fit_transform(features)
make_moons函数
功能:用于生成数据集和对应的标签
参数:
- n_samples:总共生成的点数
- noise:加在数据上的高斯白噪声的标准差
- random_state:随机数生成
assess the performance of k-means && DBSCAN
DBSCAN聚类算法
- 参数
- eps:ϵ\epsilonϵ-邻域的距离阈值
- min_samples:样本点要成为核心对象所需要的ϵ\epsilonϵ-邻域的样本数阈值
- metric:使用的距离度量方法
- algorithm:最近邻搜索算法参数,有蛮力实现(brute)、KD树实现(kd_tree)、球树实现(ball_tree)三种
- leaf_size:为使用KD树或者球树的时候停止建子树的叶子节点数量的阈值
- p:最近距离度量参数,p=1为曼哈顿距离,p=2为欧氏距离
- 基于密度的噪声空间聚类算法:主要是将特征空间中足够密集的点划分为同一个簇,簇的形状任意,且数据点中有噪声点的话,不会将这些点划分给某个簇
DBSCAN vsvsvs kmeans
kmeans聚类算法的缺点
-
对簇的数量k的选择困难
-
Kmeans 算法会把所有的数据点都进行分类,但是很多情况下,会有一些离群点,这些点应该被剔除的,但是 Kmeans 算法还是会把它们归为某一类
-
kmeans主要适用于球形分布的数据,对其他分布的数据分类可能不好
DBSCAN的优点
-
不需要指定簇的个数
-
可用于各种形状复杂的数据集
-
可以识别出不属于任何簇的离群点,非常适合用来检测离群点
DBSCAN的缺点
-
运行速度O(m2)O(m^2)O(m2)比kmeansO(m)O(m)O(m)慢
-
eps和min_samples两个参数需要进行多次尝试
-
对于不同密度的簇,两个算法效果可能都不是很好
其他区别
-
DBSCAN多次运行产生相同的结果,而kmeans通常使用随机初始化质心,不会产生相同的结果
-
kmeans会发现不是明显分离的簇,即使簇有重叠也可以发现;DBSCAN会合并有重叠的簇
-
kmeans可用于稀疏的高维数据,如文档数据,而DBSCAN不能很好处理
kmeans = KMeans(n_clusters = 2)
dbscan = DBSCAN(eps = 0.3)

#fit the algorithm to the features
kmeans.fit(scaled_features)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)