《李航 统计学习方法》学习笔记——第六章 Logistic 回归与最大熵模型
Logistic 回归与最大熵模型
1. Logistic 回归模型
广义上的线性回归为:
f
(
x
)
=
g
−
1
(
ω
x
T
+
b
)
f(x)=g^{-1}(\omega x^T+b)
f(x)=g−1(ωxT+b)
其中g称为联系函数(应为连续函数且充分光滑),例如
l
n
ln
ln等。
当进行分类问题,线性回归产生的模型预测值为
z
=
ω
x
T
+
b
z=\omega x^T+b
z=ωxT+b为实值,而y的取值为
{
0
,
1
}
\{0,1\}
{0,1},这是需要寻找一个联系函数使得z值转化为0/1值。
单位阶跃函数:
y = { 0 z < 0 0.5 z = 0 1 z > 0 y= \left\{\begin{matrix} 0&z<0 \\ 0.5&z=0 \\ 1 & z>0 \end{matrix}\right. y=⎩⎨⎧00.51z<0z=0z>0
该函数能够进行上述的转化,但是由于其不连续,所以不能作为联系函数。
于是这里引入对数几率函数(一种sigmoid函数),实现这样该转化过程。
logistic分布:设X连续随机变量符合logistic分布,则X的分布函数与密度函数为:
F ( x ) = P ( X ⩽ x ) = 1 1 + e − x f ( x ) = e − x ( 1 + e − x ) 2 F(x)=P(X\leqslant x)=\frac{1}{1+ e^{-x}}\\ f(x)=\frac{e^{-x}}{({1+e^{-x}})^2} F(x)=P(X⩽x)=1+e−x1f(x)=(1+e−x)2e−x

logistic函数分布曲线为S曲线(sigmoid curve),且为凸函数(这点在数值优化中很重要),可以将z转化为接近0或1的y值,并且在z=0附近的变化速度块。
带入广义的线性函数模型中,由此得到函数
y
=
1
1
+
e
−
(
ω
x
T
+
b
)
ln
y
1
−
y
=
ω
x
T
+
b
y=\frac{1}{1+e^{-({\omega x^T+b})}}\\ \ \\ \ln\frac{y}{1-y}=\omega x^T+b
y=1+e−(ωxT+b)1 ln1−yy=ωxT+b
这里定义几率(odds): 模型分类后,样本x被分为正例(如y=1)的个数与样本x被分为反例(如y=0)的个数之比。
o
d
d
s
=
y
1
−
y
odds = \frac{y}{1-y}
odds=1−yy
对数几率为几率的对数。
l
o
g
i
t
=
ln
y
1
−
y
logit = \ln\frac{y}{1-y}
logit=ln1−yy
这里可以发现,对数几率与随机变量x为线性关系。
当用条件概率去理解该模型时,则可以得到二分logistic模型:
P
(
Y
=
1
∣
x
)
=
e
ω
x
T
+
b
1
+
e
(
ω
x
T
+
b
)
P
(
Y
=
0
∣
x
)
=
1
1
+
e
(
ω
x
T
+
b
)
P(Y=1|x)=\frac{e^{\omega x^T+b}}{1+e^{({\omega x^T+b})}}\\ \ \\ P(Y=0|x)=\frac{1}{1+e^{({\omega x^T+b})}}\\
P(Y=1∣x)=1+e(ωxT+b)eωxT+b P(Y=0∣x)=1+e(ωxT+b)1
由此可见该函数特点:线性函数的值越接近正无穷,概率值就越接近1;线性函数的值越接近负无穷,概率值就越接近0
2. 模型参数估计
在估计
ω
,
b
\omega,b
ω,b参数的过程中,应用极大似然估计法
这里令
ω
=
(
ω
(
1
)
,
ω
(
2
)
,
.
.
.
,
w
(
n
)
,
b
)
\omega = (\omega^{(1)},\omega^{(2)},...,w^{(n)},b)
ω=(ω(1),ω(2),...,w(n),b)

所以最终问题转化为了求
ω
∗
=
arg
max
ω
L
(
ω
)
\omega^*=\arg\max_\omega L(\omega)
ω∗=argωmaxL(ω)
因为
L
(
ω
)
L(\omega)
L(ω)是关于
ω
\omega
ω的高阶可导连续函数,根据凸优化理论,经典的数值优化算法如梯度下降法,改进的迭代尺度法(IIS),牛顿法,拟牛顿法都可以求其解。
2.1 梯度下降法求参
梯度下降法是一种常用的一阶优化方法,是求解无约束优化问题最简单,最简单的方法之一。

- 首先对目标函数进行等价转换,更改为求极小值问题。
arg max ω L ( ω ) ⇒ arg min ω [ − L ( ω ) ] \arg\max_\omega L(\omega)\Rightarrow \arg\min_\omega [-L(\omega)] argωmaxL(ω)⇒argωmin[−L(ω)] - 取初值 w ( 0 ) ∈ R n , k = 0 w^{(0)} \in \R^n,k=0 w(0)∈Rn,k=0。
- 计算 L ( w ( k ) ) L(w^{(k)}) L(w(k))。
- 计算梯度
g
k
=
g
(
w
(
k
)
)
g_k = g(w^{(k)})
gk=g(w(k)),若
∣
∣
g
k
∣
∣
<
阈值
ϵ
||g_k||<\text{阈值}\epsilon
∣∣gk∣∣<阈值ϵ,停止迭代,令
w
∗
=
w
(
k
)
w^*=w^{(k)}
w∗=w(k);否则,令
p
k
=
−
g
(
w
(
k
)
)
p_k=- g(w^{(k)})
pk=−g(w(k)),求步长
λ
k
\lambda_k
λk使得:
L ( w ( k ) + λ k p k ) = min λ ⩾ 0 L ( w ( k ) + λ p k ) L(w^{(k)}+\lambda_kp_k)=\min_{\lambda\geqslant 0} L(w^{(k)}+\lambda p_k) L(w(k)+λkpk)=λ⩾0minL(w(k)+λpk) - 令
w
(
k
+
1
)
=
w
(
k
)
+
λ
k
p
k
w^{(k+1)}=w^{(k)}+\lambda_k p_k
w(k+1)=w(k)+λkpk,计算
L
(
w
(
k
+
1
)
)
L(w^{(k+1)})
L(w(k+1))。
若:
∣ ∣ L ( w ( k + 1 ) ) − L ( w ( k ) ) ∣ ∣ < ϵ o r ∣ ∣ w ( k + 1 ) − w ( k ) ∣ ∣ < ϵ ||L(w^{(k+1)})-L(w^{(k)})|| < \epsilon \ \ or \ \ || w^{(k+1)}-w^{(k)}|| < \epsilon ∣∣L(w(k+1))−L(w(k))∣∣<ϵ or ∣∣w(k+1)−w(k)∣∣<ϵ
则停止迭代,令 w ∗ = w ( k + 1 ) w^*=w^{(k+1)} w∗=w(k+1)。 - 否则,
k
=
k
+
1
k=k+1
k=k+1,转(3)。
因为目标函数为凸函数,因此可以保证其为全局最优解。

缺点:该方法的收敛速度有时较慢。
2.2 牛顿法求参
牛顿法也是求解无约束最优化问题的常用算法,(因为利用了二阶导)有收敛速度快的优点。通过迭代,每一步需要求解目标函数的黑塞矩阵的逆矩阵,进行求参。
- 首先对目标函数进行等价转换,更改为求极小值问题。
arg max ω L ( ω ) ⇒ arg min ω [ − L ( ω ) ] \arg\max_\omega L(\omega)\Rightarrow \arg\min_\omega [-L(\omega)] argωmaxL(ω)⇒argωmin[−L(ω)] - 取初值 w ( 0 ) ∈ R n , k = 0 w^{(0)} \in \R^n,k=0 w(0)∈Rn,k=0。
- 计算梯度 g k = g ( w ( k ) ) g_k = g(w^{(k)}) gk=g(w(k))
- 若 ∣ ∣ g k ∣ ∣ < 阈值 ϵ ||g_k||<\text{阈值}\epsilon ∣∣gk∣∣<阈值ϵ,停止迭代,令 w ∗ = w ( k ) w^*=w^{(k)} w∗=w(k)。
- 计算黑塞矩阵
H
k
=
H
(
x
(
k
)
)
H_k=H(x^{(k)})
Hk=H(x(k)),并求出
p
k
pk
pk:
p k = − H k g k p_k=-H_kg_k pk=−Hkgk
黑塞矩阵:
H ( x ) = [ ∂ 2 f ∂ x i ∂ x j ] n ∗ n H(x)=[\frac{\partial ^2f}{\partial x_i\partial x_j}]_{n*n} H(x)=[∂xi∂xj∂2f]n∗n
函数f(x)有机制的必要条件是在极值点处的一阶导数为0,即梯度为0,特别是当 H ( x ( k ) ) H(x^{(k)}) H(x(k))为正定矩阵时,函数f(x)的极值为极小值。
- 令 w ( k + 1 ) = w ( k ) + p k w^{(k+1)}=w^{(k)}+p_k w(k+1)=w(k)+pk。
- 令 k = k + 1 k=k+1 k=k+1,转(3)。
缺点:在步骤(5)中由于要求 H − 1 H^{-1} H−1计算复杂,耗费时间。
2.3 拟牛顿法求参
为了解决计算 H − 1 H^{-1} H−1的复杂问题,考虑用一个n阶矩阵 G k = G ( x ( k ) ) G_k=G(x^{(k)}) Gk=G(x(k))来近似代替 H k − 1 = H − 1 ( x ( k ) ) H_k^{-1}=H^{-1}(x^{(k)}) Hk−1=H−1(x(k)).
2.3.1 算法DFP
该算法通过
G
k
+
1
G_{k+1}
Gk+1替代
H
−
1
H^{-1}
H−1,即满足拟牛顿条件:
G
k
+
1
(
g
k
+
1
−
g
k
)
=
x
(
k
+
1
)
−
x
(
k
)
G_{k+1}(g_{k+1}-g_k)=x^{(k+1)}-x^{(k)}
Gk+1(gk+1−gk)=x(k+1)−x(k)
- 首先对目标函数进行等价转换,更改为求极小值问题。
arg max ω L ( ω ) ⇒ arg min ω [ − L ( ω ) ] \arg\max_\omega L(\omega)\Rightarrow \arg\min_\omega [-L(\omega)] argωmaxL(ω)⇒argωmin[−L(ω)] - 选定初始点 w ( 0 ) w^{(0)} w(0),取 G 0 G_0 G0为正定对称矩阵,置k=0。
- 计算梯度 g k = g ( w ( k ) ) g_k = g(w^{(k)}) gk=g(w(k)),若 ∣ ∣ g k ∣ ∣ < 阈值 ϵ ||g_k||<\text{阈值}\epsilon ∣∣gk∣∣<阈值ϵ,停止迭代,令 w ∗ = w ( k ) w^*=w^{(k)} w∗=w(k),否认进行下一步。
- 令 p k = − G k g k p_k=-G_kg_k pk=−Gkgk。
- 一维搜索,求
λ
k
\lambda_k
λks使得:
L ( w ( k ) + λ k p k ) = min λ ⩾ 0 L ( w ( k ) + λ p k ) L(w^{(k)}+\lambda_kp_k)=\min_{\lambda\geqslant 0} L(w^{(k)}+\lambda p_k) L(w(k)+λkpk)=λ⩾0minL(w(k)+λpk) - 令 w ( k + 1 ) = w ( k ) + λ k p k w^{(k+1)}=w^{(k)}+\lambda_k p_k w(k+1)=w(k)+λkpk
- 计算梯度
g
k
+
1
=
g
(
w
(
k
+
1
)
)
g_{k+1} = g(w^{(k+1)})
gk+1=g(w(k+1)),若
∣
∣
g
k
+
1
∣
∣
<
阈值
ϵ
||g_{k+1}||<\text{阈值}\epsilon
∣∣gk+1∣∣<阈值ϵ,停止迭代,令
w
∗
=
w
(
k
+
1
)
w^*=w^{(k+1)}
w∗=w(k+1),否则计算
G
k
+
1
G_{k+1}
Gk+1。
δ k = x ( k + 1 ) − x ( k ) y k = g k + 1 − g k G k + 1 = G k + δ k δ k T δ k T y k − G k y k y k T G k y k T G k y k \delta_k = x^{(k+1)}-x^{(k)}\\ y_k = g_{k+1}-g_k\\ \ \\ G_{k+1}=G_k+\frac{\delta_k\delta_k^T}{\delta_k^Ty_k}-\frac{G_ky_ky_k^TG_k}{y_k^TG_ky_k} δk=x(k+1)−x(k)yk=gk+1−gk Gk+1=Gk+δkTykδkδkT−ykTGkykGkykykTGk - 令k = k+1, 转到(4)
2.3.2 算法BFGS
该算法通过矩阵
B
k
+
1
B_{k+1}
Bk+1代替黑塞矩阵
H
k
H_k
Hk,即满足拟牛顿条件:
g
k
+
1
−
g
k
=
B
k
+
1
(
x
(
k
+
1
)
−
x
(
k
)
)
g_{k+1}-g_k=B_{k+1}(x^{(k+1)}-x^{(k)})
gk+1−gk=Bk+1(x(k+1)−x(k))
- 首先对目标函数进行等价转换,更改为求极小值问题。
arg max ω L ( ω ) ⇒ arg min ω [ − L ( ω ) ] \arg\max_\omega L(\omega)\Rightarrow \arg\min_\omega [-L(\omega)] argωmaxL(ω)⇒argωmin[−L(ω)] - 选定初始点 w ( 0 ) w^{(0)} w(0),取 B 0 B_0 B0为正定对称矩阵,置k=0。
- 计算梯度 g k = g ( w ( k ) ) g_k = g(w^{(k)}) gk=g(w(k)),若 ∣ ∣ g k ∣ ∣ < 阈值 ϵ ||g_k||<\text{阈值}\epsilon ∣∣gk∣∣<阈值ϵ,停止迭代,令 w ∗ = w ( k ) w^*=w^{(k)} w∗=w(k),否认进行下一步。
- 令 B k p k = − g k B_kp_k=-g_k Bkpk=−gk,求出 p k p_k pk。
- 一维搜索,求
λ
k
\lambda_k
λks使得:
L ( w ( k ) + λ k p k ) = min λ ⩾ 0 L ( w ( k ) + λ p k ) L(w^{(k)}+\lambda_kp_k)=\min_{\lambda\geqslant 0} L(w^{(k)}+\lambda p_k) L(w(k)+λkpk)=λ⩾0minL(w(k)+λpk) - 令 w ( k + 1 ) = w ( k ) + λ k p k w^{(k+1)}=w^{(k)}+\lambda_k p_k w(k+1)=w(k)+λkpk
- 计算梯度
g
k
+
1
=
g
(
w
(
k
+
1
)
)
g_{k+1} = g(w^{(k+1)})
gk+1=g(w(k+1)),若
∣
∣
g
k
+
1
∣
∣
<
阈值
ϵ
||g_{k+1}||<\text{阈值}\epsilon
∣∣gk+1∣∣<阈值ϵ,停止迭代,令
w
∗
=
w
(
k
+
1
)
w^*=w^{(k+1)}
w∗=w(k+1),否则计算
B
k
+
1
B_{k+1}
Bk+1。
δ k = x ( k + 1 ) − x ( k ) y k = g k + 1 − g k B k + 1 = B k + y k y k T y k T δ k − B k δ k δ k T B k δ k T B k δ k \delta_k = x^{(k+1)}-x^{(k)}\\ y_k = g_{k+1}-g_k\\ \ \\ B_{k+1}=B_k+\frac{y_ky_k^T}{y_k^T\delta_k}-\frac{B_k\delta_k\delta_k^TB_k}{\delta_k^TB_k\delta_k} δk=x(k+1)−x(k)yk=gk+1−gk Bk+1=Bk+ykTδkykykT−δkTBkδkBkδkδkTBk - 令k = k+1, 转到(4)
3. 最大熵模型
3.1 原理
在所有可能的概率模型(分布)中,熵最大的模型是最好的模型。或者说是在满足约束条件的模型集合中选取熵最大的模型。
依据最大熵原理,在没有获取充足的模型约束情况下。一个好的方法便是在满足已有约束的条件下,对未知情况的抉择使用均匀分布去代替,也就是选择一个熵最大(信息量最大,不确定性最大,最混乱)的模型。这就是最大熵模型的思想,可以分解为两步。一、根据已有约束条件,得出所有满足约束的概率模型。二、在得到的模型中选择一个熵最大的模型作为最优模型。
P
(
X
=
x
i
)
=
p
i
i
=
1
,
2
,
.
.
.
.
n
H
(
X
)
=
−
∑
i
=
1
n
p
i
log
p
i
0
⩽
H
(
X
)
⩽
l
o
g
∣
X
∣
P(X=x_i)=p_i\ \ \ i=1,2,....n\\ H(X)=-\sum\limits_{i=1}^{n}p_i\log p_i\\ 0 \leqslant H(X) \leqslant log|X|
P(X=xi)=pi i=1,2,....nH(X)=−i=1∑npilogpi0⩽H(X)⩽log∣X∣
H
(
X
)
H(X)
H(X)即为随机变量X的熵,|X|为X的取值个数,当且仅当X的分布是均匀分布时右边的等号成立。
3.2 模型
假设满足所有约束条件的模型集合为: C ≡ { P ∈ Ω ∣ E p ( f i ) = E p ~ ( f i ) , i = 1 , 2 , . . . , n } C\equiv \{ P\in \Omega| E_p(f_i)=E_{\tilde{p}}(f_i),\ i = 1,2,...,n\} C≡{P∈Ω∣Ep(fi)=Ep~(fi), i=1,2,...,n} 定义在条件概率分布P(Y|X)上的条件熵:
H ( P ) = − ∑ x , y P ~ ( x ) P ( y ∣ x ) log P ( y ∣ x ) H(P)=-\sum_{x,y}\tilde{P}(x)P(y|x)\log P(y|x) H(P)=−x,y∑P~(x)P(y∣x)logP(y∣x)
则模型集合C中条件熵最大的模型称为最大熵模型。
上式中,f为特征函数,描述输入x与输出y之间的某一个事实。(通过观察可以得到多种特征函数)
f
(
x
,
y
)
=
{
1
x
,
y
满
足
某
约
束
0
否
则
f(x,y)=\left\{\begin{matrix} 1 & x,y满足某约束\\ 0& 否则 \end{matrix}\right.
f(x,y)={10x,y满足某约束否则
特征函数关于经验分布
P
~
(
X
,
Y
)
\tilde{P}(X,Y)
P~(X,Y)的期望:
E
p
~
(
f
)
=
∑
x
,
y
P
~
(
x
,
y
)
f
(
x
,
y
)
E_{\tilde{p}}(f)=\sum_{x,y}\tilde{P}(x,y)f(x,y)
Ep~(f)=x,y∑P~(x,y)f(x,y)
特征函数关于模型
P
(
Y
∣
X
)
P(Y|X)
P(Y∣X)与经验分布
P
~
(
X
)
\tilde{P}(X)
P~(X)的期望:
E
p
(
f
)
=
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
f
(
x
,
y
)
E_p(f)=\sum_{x,y}\tilde{P}(x)P(y|x)f(x,y)
Ep(f)=x,y∑P~(x)P(y∣x)f(x,y)
特征函数的理解:
例如:take在英文中有很多意思,但是往往后面有bus等交通工具时翻译为乘坐。这是我们通过样本观察到的。因此,特征函数为:
f ( x , y ) = { 1 y = ‘ 乘 坐 ’ 并 且 后 面 接 的 x 为 B u s 0 否 则 f(x,y)=\left\{\begin{matrix} 1 & y=‘乘坐’并且后面接的x为Bus\\ 0& 否则 \end{matrix}\right. f(x,y)={10y=‘乘坐’并且后面接的x为Bus否则
目的是希望观察到的现象在样本上出现的概率等于在总体上出现的概率。即
E P ~ ( x , y ) f i ( x , y ) = E P ( x , y ) f i ( x , y ) E_{\tilde{P}(x,y)}f_i(x,y) = E_{{P}(x,y)}f_i{(x,y)} EP~(x,y)fi(x,y)=EP(x,y)fi(x,y)
模型P(Y|X)需要满足的根本条件为:
P
~
(
x
)
P
(
y
∣
x
)
=
P
~
(
x
,
y
)
\tilde{P}(x)P(y|x) = \tilde{P}(x,y)
P~(x)P(y∣x)=P~(x,y)
因此左右两边对于f(x,y)期望也应该相同,所以将两个期望相等作为模型学习的约束条件,有n个特征函数,则有n个约束条件。
3.3 学习
最大熵模型的学习等价与约束最优化问题:
max
P
∈
C
H
(
P
)
=
−
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
log
P
(
y
∣
x
)
s
.
t
.
E
p
(
f
i
)
=
E
p
~
(
f
i
)
,
i
=
1
,
2
,
.
.
.
,
n
∑
y
P
(
y
∣
x
)
=
1
\max_{P\in C}H(P)=-\sum_{x,y}\tilde{P}(x)P(y|x)\log P(y|x)\\ s.t. \ \ E_p(f_i)=E_{\tilde{p}}(f_i),\ i = 1,2,...,n\\ \ \\ \sum_yP(y|x)=1
P∈CmaxH(P)=−x,y∑P~(x)P(y∣x)logP(y∣x)s.t. Ep(fi)=Ep~(fi), i=1,2,...,n y∑P(y∣x)=1
按照最优化问题的习惯,将求最大值问题改为最小值问题得:
min
P
∈
C
−
H
(
P
)
=
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
log
P
(
y
∣
x
)
s
.
t
.
E
p
(
f
i
)
−
E
p
~
(
f
i
)
=
0
,
i
=
1
,
2
,
.
.
.
,
n
∑
y
P
(
y
∣
x
)
=
1
\min_{P\in C}-H(P)=\sum_{x,y}\tilde{P}(x)P(y|x)\log P(y|x)\\ s.t. \ \ E_p(f_i)-E_{\tilde{p}}(f_i)=0,\ i = 1,2,...,n\\ \ \\ \sum_yP(y|x)=1
P∈Cmin−H(P)=x,y∑P~(x)P(y∣x)logP(y∣x)s.t. Ep(fi)−Ep~(fi)=0, i=1,2,...,n y∑P(y∣x)=1
求解该问题,将约束最优化的原始问题转换为无约束的最优化对偶问题,通过求解对偶问题求解原始问题。该做法的具体原理参照拉格朗日对偶性一文。
- 引入拉格朗日乘子
w
0
,
w
1
.
.
.
,
w
n
w_0,w_1...,w_n
w0,w1...,wn,定义拉格朗日函数:
L ( P , w ) = − H ( P ) + w 0 ( 1 − ∑ y P ( y ∣ x ) ) + ∑ i = 1 n w i ( E p ( f i ) − E p ~ ( f i ) ) = ∑ x , y P ~ ( x ) P ( y ∣ x ) log P ( y ∣ x ) + w 0 ( 1 − ∑ y P ( y ∣ x ) ) + ∑ i = 1 n w i ( ∑ x , y P ~ ( x , y ) f i ( x , y ) − ∑ x , y P ~ ( x ) P ( y ∣ x ) f i ( x , y ) ) L(P,w)=-H(P)+w_0(1-\sum_yP(y|x))+\sum_{i=1}^nw_i(E_p(f_i)-E_{\tilde{p}}(f_i))\\ =\sum_{x,y}\tilde{P}(x)P(y|x)\log P(y|x)+w_0(1-\sum_yP(y|x))+\sum_{i=1}^nw_i(\sum_{x,y}\tilde{P}(x,y)f_i(x,y)-\sum_{x,y}\tilde{P}(x)P(y|x)f_i(x,y)) L(P,w)=−H(P)+w0(1−y∑P(y∣x))+i=1∑nwi(Ep(fi)−Ep~(fi))=x,y∑P~(x)P(y∣x)logP(y∣x)+w0(1−y∑P(y∣x))+i=1∑nwi(x,y∑P~(x,y)fi(x,y)−x,y∑P~(x)P(y∣x)fi(x,y))
因为L(P,w)为凸函数,因此原始问题的解与对偶问题的解是等价的,即:
min P ∈ C max w L ( P , w ) ⇒ max w min P ∈ C L ( P , w ) \min_{P \in C}\max_w L(P,w)\Rightarrow\max_w \min_{P \in C}L(P,w) P∈CminwmaxL(P,w)⇒wmaxP∈CminL(P,w) - 求解对偶问题的内部极小化问题,令
Ψ ( w ) = min P ∈ C L ( P w , w ) P w = arg min P ∈ C L ( P , w ) = P w ( y ∣ x ) \Psi (w)=\min_{P \in C}L(P_w,w)\\ P_w =\arg\min_{P \in C}L(P,w)= P_w(y|x) Ψ(w)=P∈CminL(Pw,w)Pw=argP∈CminL(P,w)=Pw(y∣x)
P w P_w Pw即为该函数的解。
对P(y|x)求偏偏导的:
∂ L ( P , w ) ∂ P ( y ∣ x ) = ∑ x , y P ~ ( x ) [ log P ( y ∣ x ) + 1 ] − ∑ y w 0 − ∑ x , y P ~ ( x ) [ ∑ i = 1 n w i f i ( x , y ) ] ∵ ∑ x P ~ ( x ) = 1 ⇒ ∑ y w 0 = ∑ x , y w 0 P ~ ( x ) 这 步 是 为 了 提 取 上 式 中 的 公 因 式 P ~ ( x ) 便 于 计 算 。 原 式 = ∑ x , y P ~ ( x ) [ log P ( y ∣ x ) + 1 − w 0 − ∑ i = 1 n w i f i ( x , y ) ] \frac{\partial L(P,w)}{\partial P(y|x)}=\sum_{x,y}\tilde{P}(x)[\log P(y|x)+1]-\sum_yw_0-\sum_{x,y}\tilde{P}(x)[\sum_{i=1}^nw_if_i(x,y)]\\ \because \sum_{x}\tilde{P}(x)=1 \Rightarrow \sum_{y}w_0=\sum_{x,y}w_0\tilde{P}(x) \ \ 这步是为了提取上式中的公因式\tilde{P}(x)便于计算。\\ \ \\ 原式= \sum_{x,y}\tilde{P}(x)[\log P(y|x)+1-w_0-\sum_{i=1}^nw_if_i(x,y)] ∂P(y∣x)∂L(P,w)=x,y∑P~(x)[logP(y∣x)+1]−y∑w0−x,y∑P~(x)[i=1∑nwifi(x,y)]∵x∑P~(x)=1⇒y∑w0=x,y∑w0P~(x) 这步是为了提取上式中的公因式P~(x)便于计算。 原式=x,y∑P~(x)[logP(y∣x)+1−w0−i=1∑nwifi(x,y)]
令偏导数为0,得:
P ( y ∣ x ) = e ∑ i = 1 n w i f i ( x , y ) e 1 − w 0 P(y|x)=\frac{e^{\sum_{i=1}^nw_if_i(x,y)}}{e^{1-w_0}} P(y∣x)=e1−w0e∑i=1nwifi(x,y)
得到的这个P(y|x)可能并不是一个真正的概率,因为求解过程中消去了一些变量,比如P(x)。因此,它应该只是表达了所有可能取值之间的一个比值关系,是一个非规范化概率,所有对其规范化,
由于
∑
y
P
(
y
∣
x
)
=
1
\sum_yP(y|x)=1
∑yP(y∣x)=1,且常数
e
1
−
w
0
e^{1-w_0}
e1−w0在规范化中被约掉,得:
P
w
(
y
∣
x
)
=
1
Z
w
(
x
)
exp
[
∑
i
=
1
n
w
i
f
i
(
x
,
y
)
]
Z
w
(
x
)
=
∑
y
exp
[
∑
i
=
1
n
w
i
f
i
(
x
,
y
)
]
P_w(y|x)=\frac{1}{Z_w(x)}\exp[\sum_{i=1}^nw_if_i(x,y)] \\ Z_w(x)=\sum_y\exp[\sum_{i=1}^nw_if_i(x,y)]
Pw(y∣x)=Zw(x)1exp[i=1∑nwifi(x,y)]Zw(x)=y∑exp[i=1∑nwifi(x,y)]
这是最大熵模型的一般形式。这里得
Z
w
(
x
)
Z_w(x)
Zw(x)称之为规范化因子,
w
i
w_i
wi是特征的权值,也可以理解为特征函数
f
i
(
x
,
y
)
f_i(x,y)
fi(x,y)得重要程度。
- 求解对偶问题外部得极大化问题:
w ∗ = arg max w Ψ ( w ) w^*= \arg\max_w \Psi (w) w∗=argwmaxΨ(w)
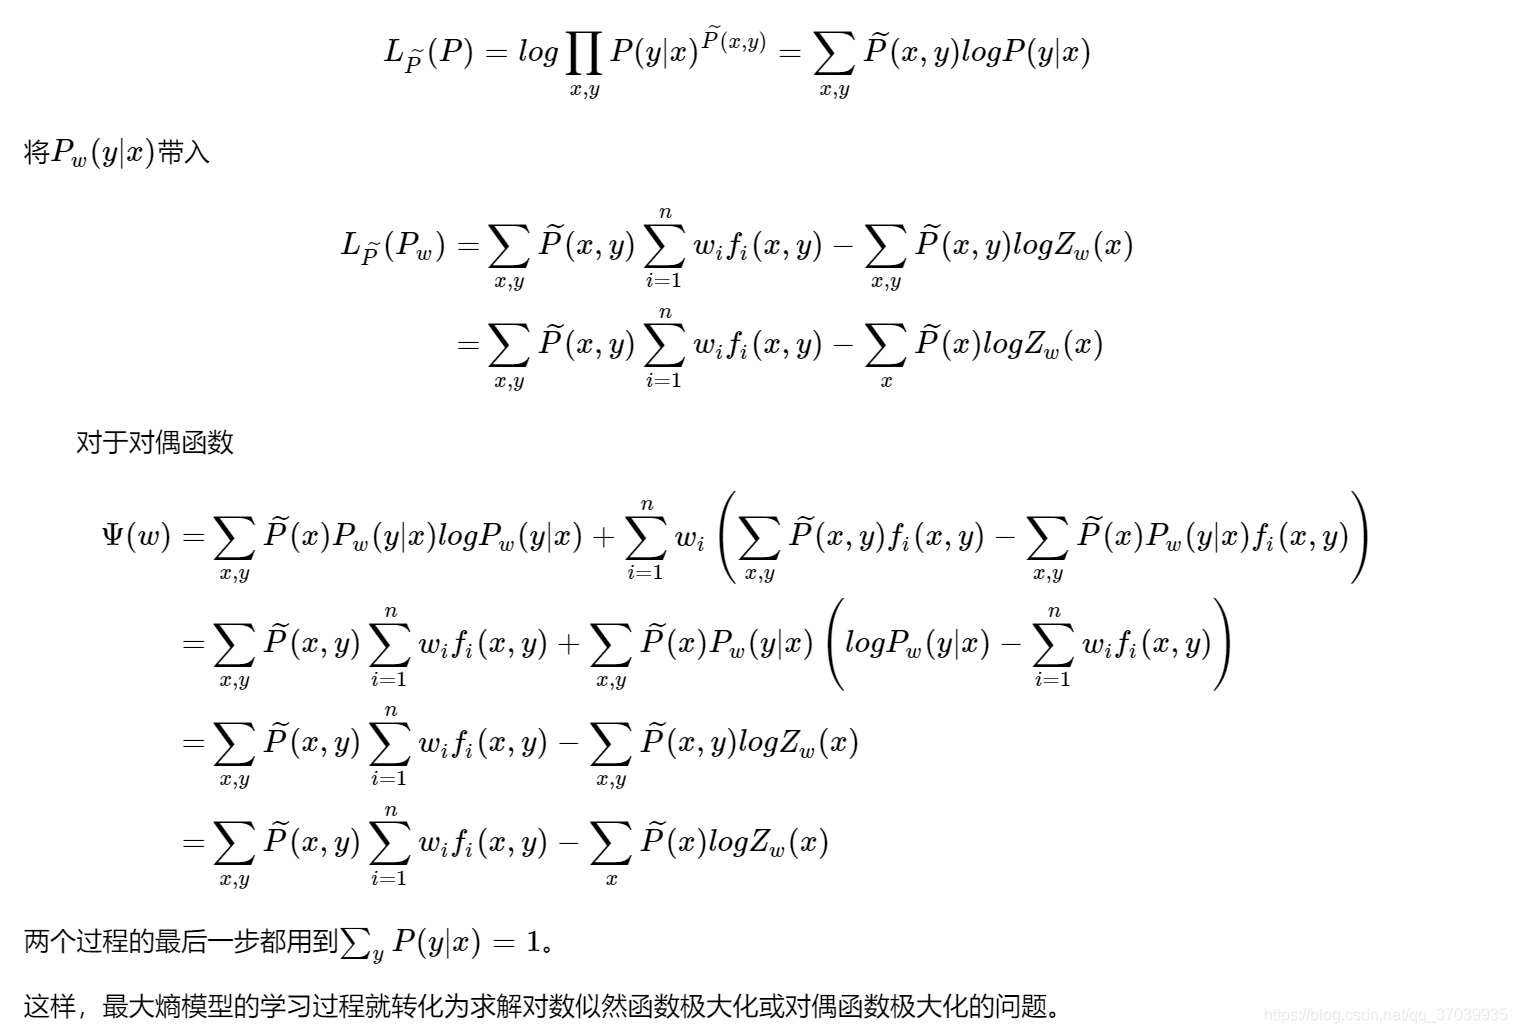
到此,最大熵模型得学习可以归结为对偶函数 Ψ ( w ) \Psi (w) Ψ(w)的极大化问题。
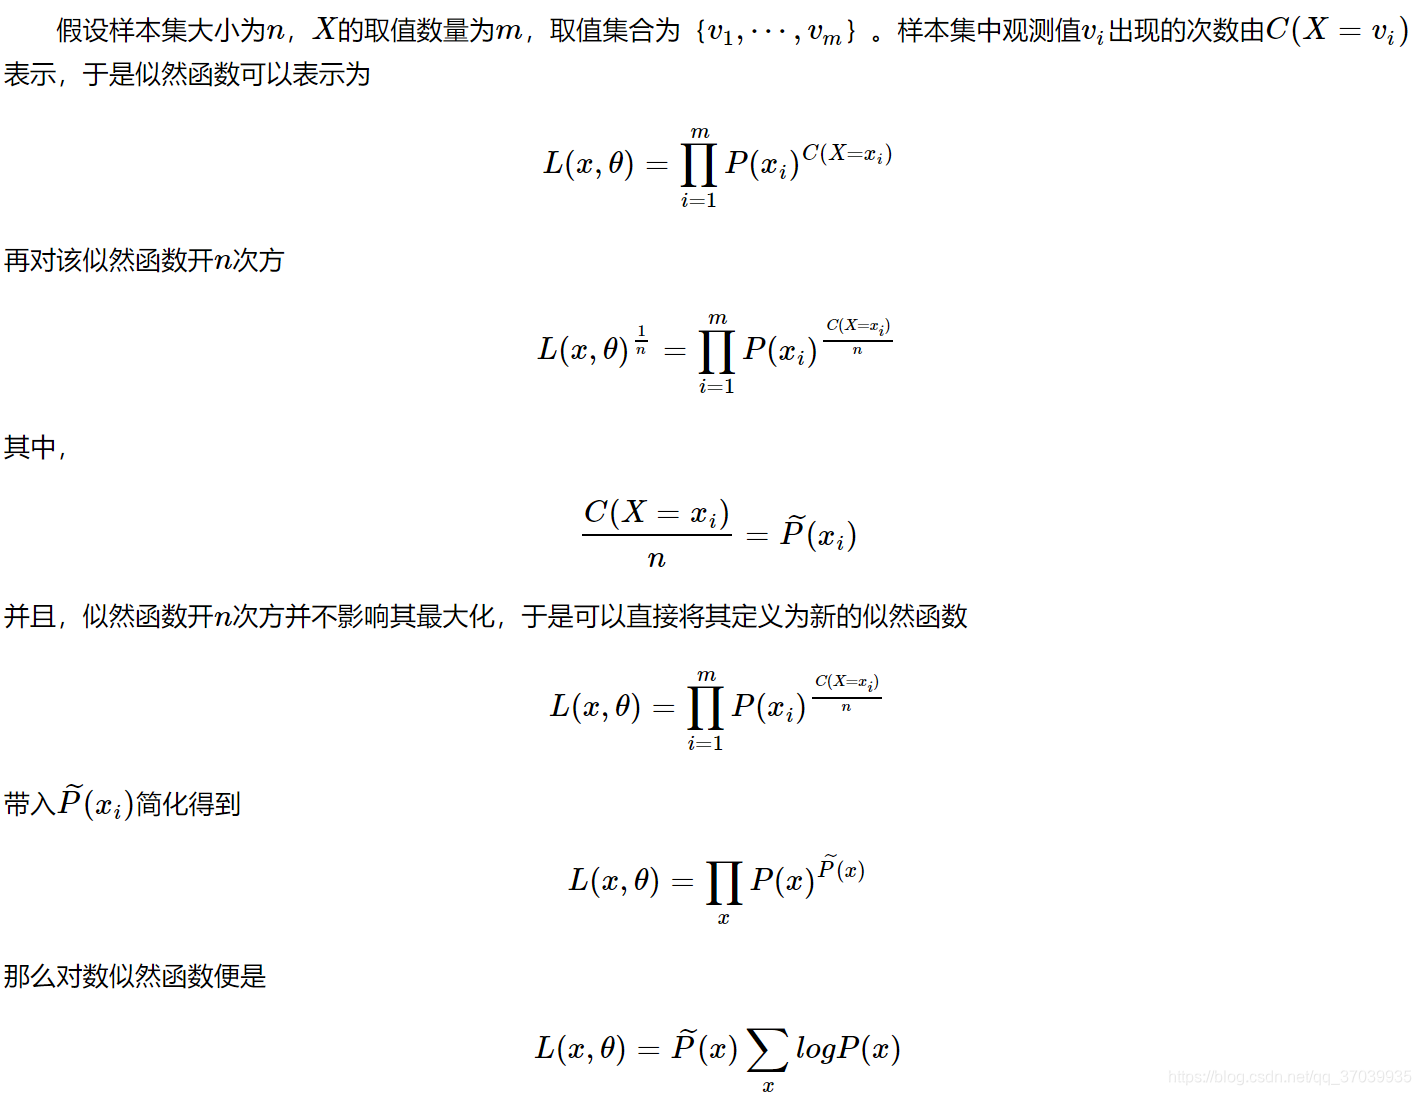
这里证明了对偶函数的极大化等价于最大熵模型的极大似然估计。
首先证明了似然函数的另一种表述方式:
L P ~ ( P ) L_{\tilde{P}}(P) LP~(P)表示训练数据的经验概率分布 P ~ ( X , Y ) \tilde{P}(X,Y) P~(X,Y),条件概率分布P(Y|X)的对数似然函数。
L P ~ ( P ) L_{\tilde{P}}(P) LP~(P)形式的推导过程如下,把上式中的独立分布替换为联合分布得:
证明:对偶函数的极大化等价于最大熵模型的极大似然估计
即: Ψ ( w ) = L P ~ ( P w ) \Psi (w) = L_{\tilde{P}}(P_w) Ψ(w)=LP~(Pw)
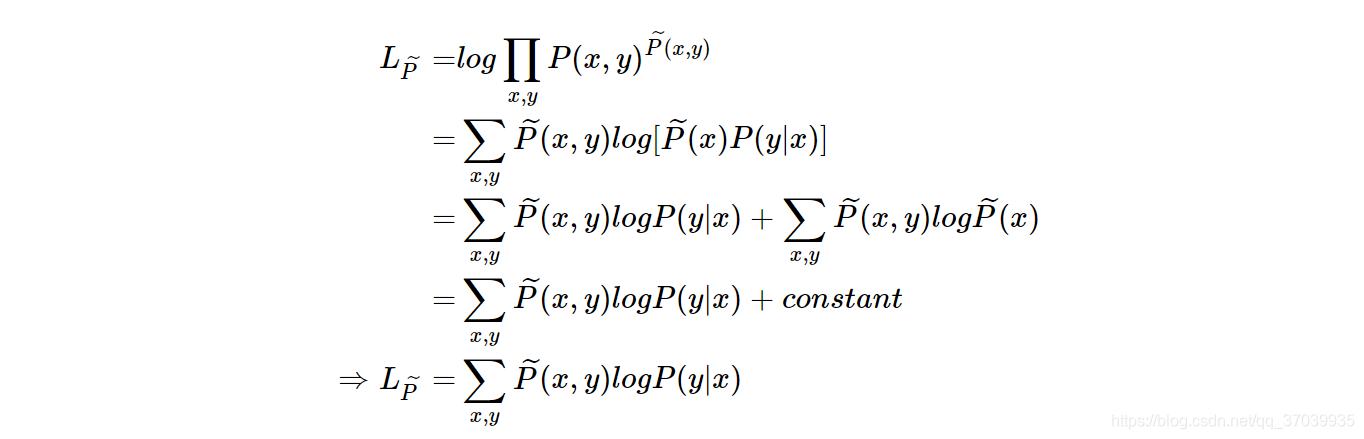
4. 模型参数估计
在求解对偶函数的极大化问题(优化问题),最终可以归结为以似然函数为目标函数的最优化问题,同样可以利用到梯度下降法,牛顿法,拟牛顿法。这里引用了李航老师书中提到的IIS和拟牛顿法,并对步骤进行了细化。
4.1 改进的迭代尺度法IIS
L
P
~
(
P
w
)
=
L
(
w
)
=
∑
x
,
y
P
~
(
x
,
y
)
∑
i
=
1
n
w
i
f
i
(
x
,
y
)
−
∑
x
P
~
(
x
)
log
Z
w
(
x
)
L_{\tilde{P}}(P_w) =L(w)=\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^nw_if_i(x,y)-\sum_x\tilde{P}(x)\log Z_w(x)
LP~(Pw)=L(w)=x,y∑P~(x,y)i=1∑nwifi(x,y)−x∑P~(x)logZw(x)
目标是极大化上式,求得极大值
w
^
\hat{w}
w^。
- IIS原理:
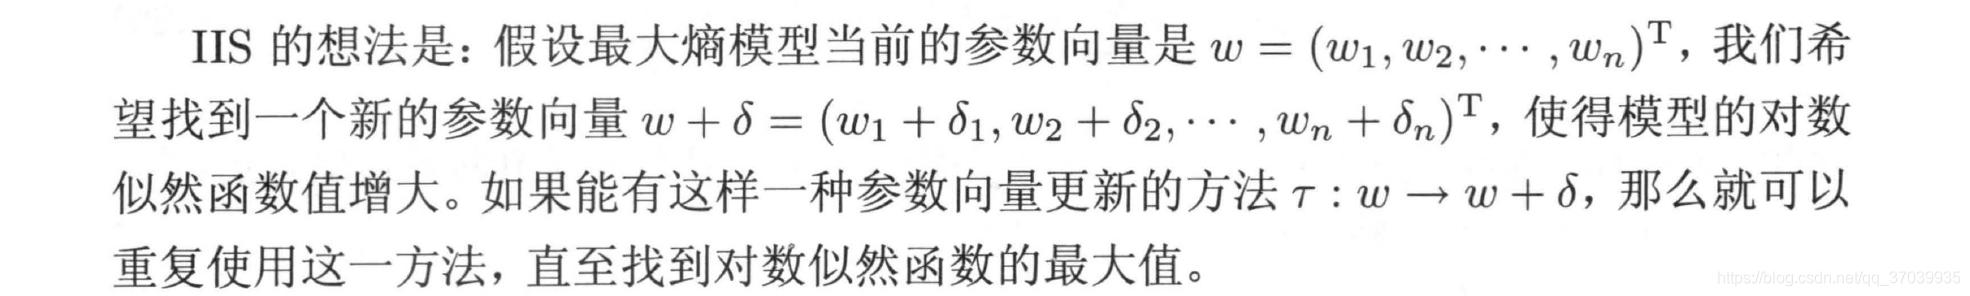
当 w w w变为新的参数向量 w + δ w+\delta w+δ,对数似然函数得变化量:
L ( w + δ ) − L ( w ) = ∑ x , y P ~ ( x , y ) ∑ i = 1 n δ i f i ( x , y ) − ∑ x P ~ ( x ) log Z w + δ ( x ) Z w ( x ) L(w+\delta)-L(w)=\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)-\sum_{x}\tilde{P}(x){\color{Red}\log\frac{Z_{w+\delta}(x)}{Z_w(x)}} L(w+δ)−L(w)=x,y∑P~(x,y)i=1∑nδifi(x,y)−x∑P~(x)logZw(x)Zw+δ(x)
但是由于上述求极值时求导上式,红色部分求导困难,计算复杂,所以使用了下面的方法简化计算。
利用不等式:
− log α ⩾ 1 − α , α > 0 -\log\alpha \geqslant 1-\alpha, \ \ \alpha>0 −logα⩾1−α, α>0
因此可以建立对数似然函数改变量得下界:
L ( w + δ ) − L ( w ) ⩾ ∑ x , y P ~ ( x , y ) ∑ i = 1 n δ i f i ( x , y ) + ∑ x P ~ ( x ) ( 1 − Z w + δ ( x ) Z w ( x ) ) = ∑ x , y P ~ ( x , y ) ∑ i = 1 n δ i f i ( x , y ) + 1 − ∑ x P ~ ( x ) Z w + δ ( x ) Z w ( x ) ( ∑ x P ~ ( x ) = 1 ) = ∑ x , y P ~ ( x , y ) ∑ i = 1 n δ i f i ( x , y ) + 1 − ∑ x P ~ ( x ) ∑ y exp [ ∑ i = 1 n w i f i ( x , y ) ] ∗ exp [ ∑ i = 1 n δ i f i ( x , y ) ] Z w ( x ) = ∑ x , y P ~ ( x , y ) ∑ i = 1 n δ i f i ( x , y ) + 1 − ∑ x P ~ ( x ) ∑ y P w ( y ∣ x ) exp ∑ i = 1 n δ i f i ( x , y ) ( exp [ ∑ i = 1 n w i f i ( x , y ) ] Z w ( x ) = P w ( y ∣ x ) ) = A ( δ ∣ w ) L(w+\delta)-L(w)\geqslant\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+\sum_{x}\tilde{P}(x)(1-\frac{Z_{w+\delta}(x)}{Z_w(x)})\\ =\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\frac{Z_{w+\delta}(x)}{Z_w(x)}({\color{Red}\sum_x\tilde{P}(x)=1})\\ =\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\frac{\sum_y\exp[\sum_{i=1}^nw_if_i(x,y)] *\exp[\sum_{i=1}^n\delta_if_i(x,y)]}{Z_w(x)}\\ =\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp\sum_{i=1}^n\delta_if_i(x,y)({\color{Red}\frac{\exp[\sum_{i=1}^nw_if_i(x,y)]}{Z_w(x)}=P_w(y|x)})\\ =A(\delta|w) L(w+δ)−L(w)⩾x,y∑P~(x,y)i=1∑nδifi(x,y)+x∑P~(x)(1−Zw(x)Zw+δ(x))=x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)Zw(x)Zw+δ(x)(x∑P~(x)=1)=x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)Zw(x)∑yexp[∑i=1nwifi(x,y)]∗exp[∑i=1nδifi(x,y)]=x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)y∑Pw(y∣x)expi=1∑nδifi(x,y)(Zw(x)exp[∑i=1nwifi(x,y)]=Pw(y∣x))=A(δ∣w)
A ( δ ∣ w ) A(\delta|w) A(δ∣w)即为对数似然函数改变量的一个下界,如果寻找 δ \delta δ能够使下界提高,则对数似然函数也会提高。但因为 δ \delta δ是n维向量,下界A是一个n维向量,不宜与同时优化。因此IIS每次只优化一个 δ i \delta_i δi,固定其他不变。
对 A ( δ ∣ w ) A(\delta|w) A(δ∣w)分别求关于 δ i \delta_i δi的偏导数,并令其为0:
∂ A ( δ ∣ w ) ∂ δ i = ∑ x , y P ~ ( x , y ) ∑ i = 1 n f i ( x , y ) − ∑ x P ~ ( x ) ∑ y P w ( y ∣ x ) exp ( ∑ i = 1 n δ i f i ( x , y ) ) ∗ f i ( x , y ) \frac{\partial A(\delta|w)}{\partial\delta_i} = \sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^nf_i(x,y)-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp(\sum_{i=1}^n\delta_if_i(x,y))*f_i(x,y) ∂δi∂A(δ∣w)=x,y∑P~(x,y)i=1∑nfi(x,y)−x∑P~(x)y∑Pw(y∣x)exp(i=1∑nδifi(x,y))∗fi(x,y)
在求解中,由于除 δ i \delta_i δi之外还有其他的 δ \delta δ变量,不易求解优化。
为了能够求解,IIS进一步降低了下界 A ( δ ∣ w ) A(\delta|w) A(δ∣w)。在上式的求导中发现,其他参数未能消掉主要是因为指数函数项求导后其他的 δ \delta δ依旧存在,所以需要从这个地方下手。Jensen不等式可以用于该问题:
Jensen不等式
对于凸函数 Φ \Phi Φ,以及权重 α i \alpha_i αi,且 ∑ i α i = 1 \sum_i\alpha_i=1 ∑iαi=1,则:
Φ ( ∑ i α i x i ) ⩽ ∑ i α i Φ ( x i ) \Phi(\sum_i\alpha_ix_i)\leqslant \sum_i\alpha_i\Phi(x_i) Φ(i∑αixi)⩽i∑αiΦ(xi)
利用这个不等式就可以将指数函数次数中的求和转变为指数函数之外的求和,这样求导后就可以消去含有其他参数的项。所以目前的问题转化为:如何求出
A
(
δ
∣
w
)
A(\delta|w)
A(δ∣w)中后一项的"
α
i
\alpha_i
αi"且令其和为1。
原式中指数项参数的系数为
f
i
(
x
,
y
)
f_i(x,y)
fi(x,y),为了使他满足Jensen不等式,引入特征函数的和
f
#
(
x
,
y
)
=
∑
i
f
i
(
x
,
y
)
f^\#(x,y)=\sum_if_i(x,y)
f#(x,y)=i∑fi(x,y)
这样
α
i
=
f
i
(
x
,
y
)
f
#
(
x
,
y
)
\alpha_i = \frac{f_i(x,y)}{f^\#(x,y)}
αi=f#(x,y)fi(x,y)运用Jensen不等式对
A
(
δ
∣
w
)
A(\delta|w)
A(δ∣w)下界进一步降低。
A
(
δ
∣
w
)
=
∑
x
,
y
P
~
(
x
,
y
)
∑
i
=
1
n
δ
i
f
i
(
x
,
y
)
+
1
−
∑
x
P
~
(
x
)
∑
y
P
w
(
y
∣
x
)
exp
∑
i
=
1
n
δ
i
f
i
(
x
,
y
)
=
∑
x
,
y
P
~
(
x
,
y
)
∑
i
=
1
n
δ
i
f
i
(
x
,
y
)
+
1
−
∑
x
P
~
(
x
)
∑
y
P
w
(
y
∣
x
)
exp
[
∑
i
=
1
n
f
i
(
x
,
y
)
f
#
(
x
,
y
)
δ
i
f
#
(
x
,
y
)
]
⩾
∑
x
,
y
P
~
(
x
,
y
)
∑
i
=
1
n
δ
i
f
i
(
x
,
y
)
+
1
−
∑
x
P
~
(
x
)
∑
y
P
w
(
y
∣
x
)
∑
i
=
1
n
f
i
(
x
,
y
)
f
#
(
x
,
y
)
exp
[
δ
i
f
#
(
x
,
y
)
]
(
因
为
前
有
负
号
所
以
方
向
改
变
)
=
B
(
δ
∣
w
)
A(\delta|w)=\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp\sum_{i=1}^n\delta_if_i(x,y)\\ =\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp[\sum_{i=1}^n\frac{f_i(x,y)}{f^\#(x,y)}\delta_if^\#(x,y)]\\ \geqslant\sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^n\delta_if_i(x,y)+1-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\sum_{i=1}^n\frac{f_i(x,y)}{f^\#(x,y)}\exp[\delta_if^\#(x,y)] \ (因为前有负号所以方向改变)\\ =B(\delta|w)
A(δ∣w)=x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)y∑Pw(y∣x)expi=1∑nδifi(x,y)=x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)y∑Pw(y∣x)exp[i=1∑nf#(x,y)fi(x,y)δif#(x,y)]⩾x,y∑P~(x,y)i=1∑nδifi(x,y)+1−x∑P~(x)y∑Pw(y∣x)i=1∑nf#(x,y)fi(x,y)exp[δif#(x,y)] (因为前有负号所以方向改变)=B(δ∣w)
这时
B
(
δ
∣
w
)
B(\delta|w)
B(δ∣w)是对数似然函数改变量的一个新的下界,求导后含有的变量只有
δ
i
\delta_i
δi,令其偏导等于0,所以可解:
∂
B
(
δ
∣
w
)
∂
δ
i
=
∑
x
,
y
P
~
(
x
,
y
)
∑
i
=
1
n
f
i
(
x
,
y
)
−
∑
x
P
~
(
x
)
∑
y
P
w
(
y
∣
x
)
exp
(
δ
i
f
#
(
x
,
y
)
)
\frac{\partial B(\delta|w)}{\partial\delta_i} = \sum_{x,y}\tilde{P}(x,y)\sum_{i=1}^nf_i(x,y)-\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp(\delta_if^\#(x,y))\\
∂δi∂B(δ∣w)=x,y∑P~(x,y)i=1∑nfi(x,y)−x∑P~(x)y∑Pw(y∣x)exp(δif#(x,y))
化简后可以得:
∑
x
P
~
(
x
)
∑
y
P
w
(
y
∣
x
)
exp
(
δ
i
f
#
(
x
,
y
)
)
=
E
P
~
(
f
i
)
\sum_{x}\tilde{P}(x)\sum_yP_w(y|x)\exp(\delta_if^\#(x,y)) = E_{\tilde{P}}(f_i)
x∑P~(x)y∑Pw(y∣x)exp(δif#(x,y))=EP~(fi)
由此就可以求出每个
δ
i
\delta_i
δi。
IIS算法
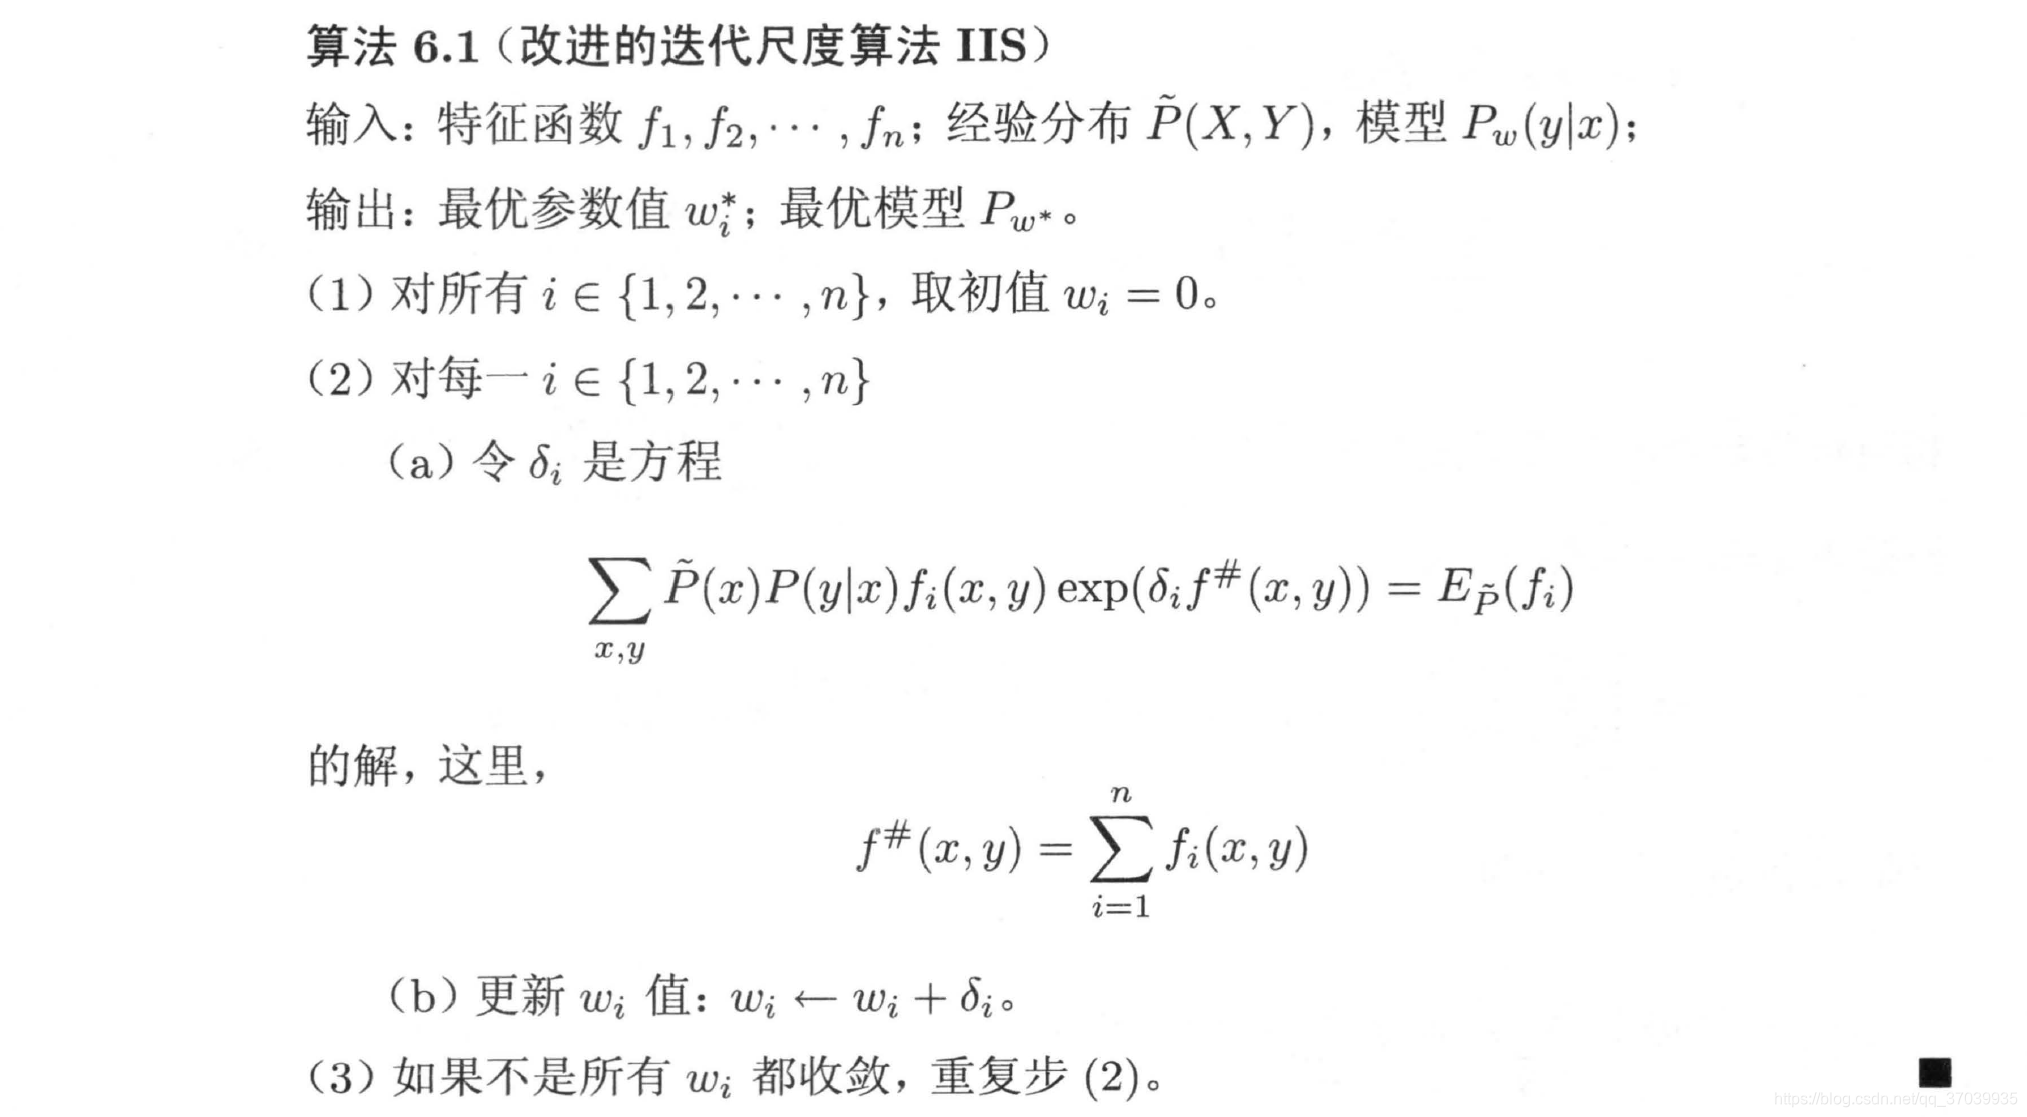
书中提到两种情况:
- 当
f
#
=
M
f^\#=M
f#=M,即为定值,那么在
δ
i
\delta_i
δi的求解上相对容易:
δ i = 1 M log E P ~ ( f i ) E P ( f i ) \delta_i = \frac{1}{M}\log\frac{E_{\tilde{P}}(f_i)}{E_{{P}}(f_i)} δi=M1logEP(fi)EP~(fi) - 当
f
#
f^\#
f#不为定值时,这样该式就拥有两个变量,必须通过数值计算求
δ
i
\delta_i
δi。通过牛顿法解决时:
令 函 数 : g ( δ i ) = ∂ B ( δ ∣ w ) ∂ δ i = 0 令函数:g(\delta_i)=\frac{\partial B(\delta|w)}{\partial\delta_i} =0 令函数:g(δi)=∂δi∂B(δ∣w)=0
通过该迭代方式:
δ i ( k + 1 ) = δ i ( k ) − g ( δ i ( k ) ) g ( δ i ( k ) ) \delta_i^{(k+1)}=\delta_i^{(k)}-\frac{g(\delta_i^{(k)})}{g(\delta_i^{(k)})} δi(k+1)=δi(k)−g(δi(k))g(δi(k))
该迭代方式的几何意义:
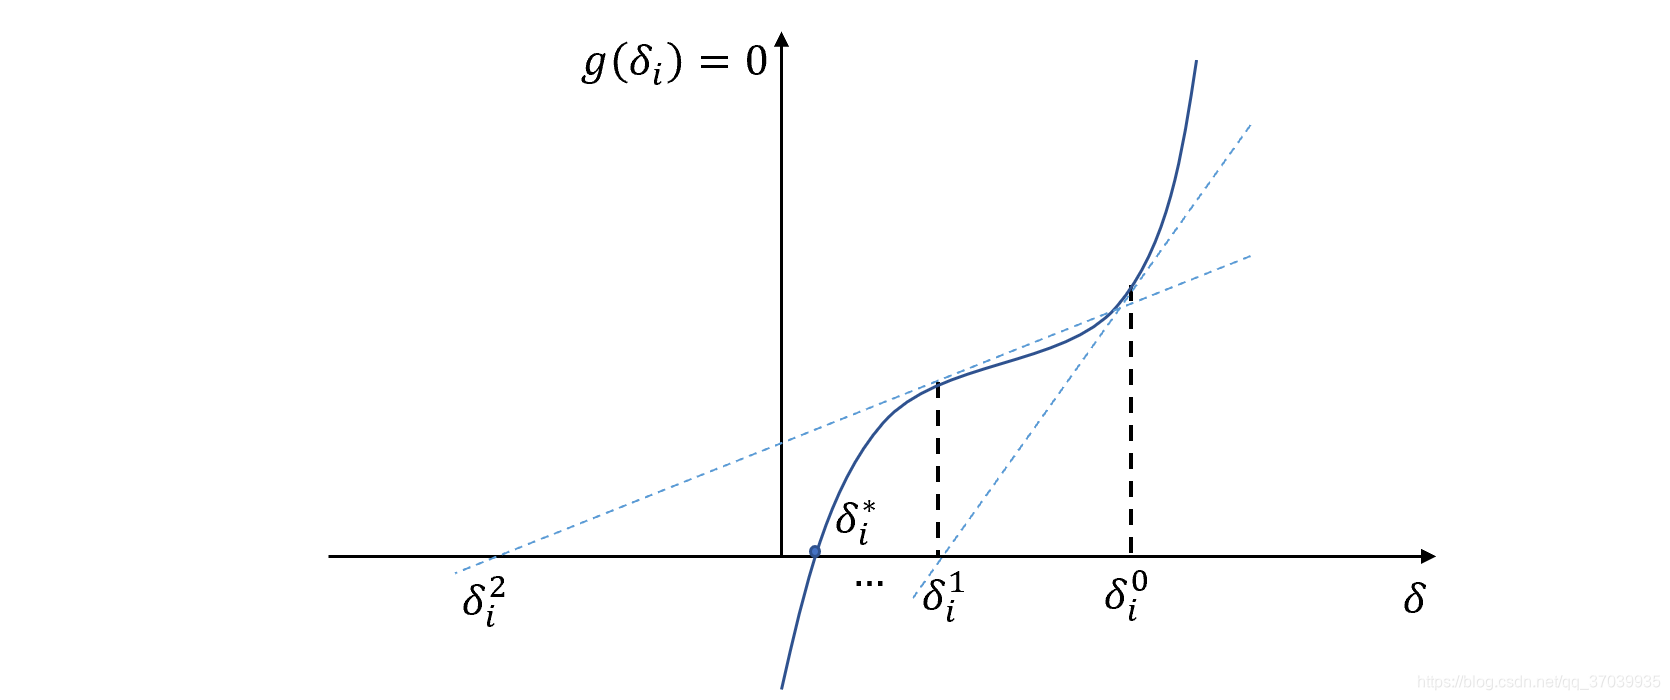
因此可知,由于 ∂ B ( δ ∣ w ) ∂ δ i = 0 \frac{\partial B(\delta|w)}{\partial\delta_i} =0 ∂δi∂B(δ∣w)=0的方程有单根,所以牛顿法恒收敛,这样就可以进行求解。
4.2 拟牛顿法
拟牛顿法与logistic求解相似,这里不予赘述。
习题6.1
证明:logistic分布属于指数族分布:
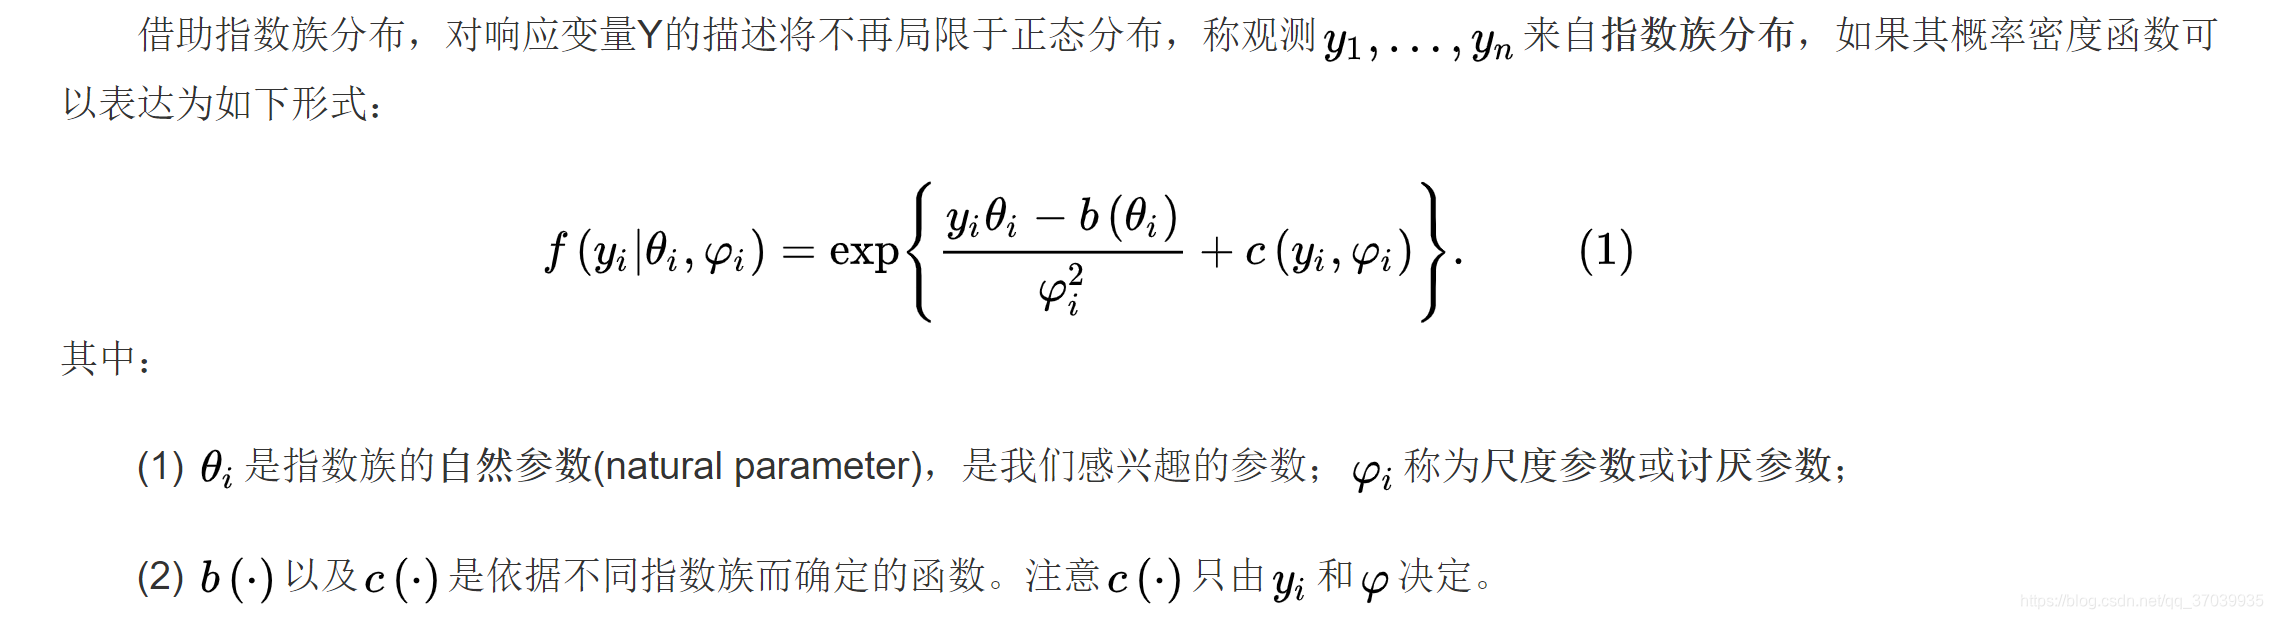
对于logistic分布:
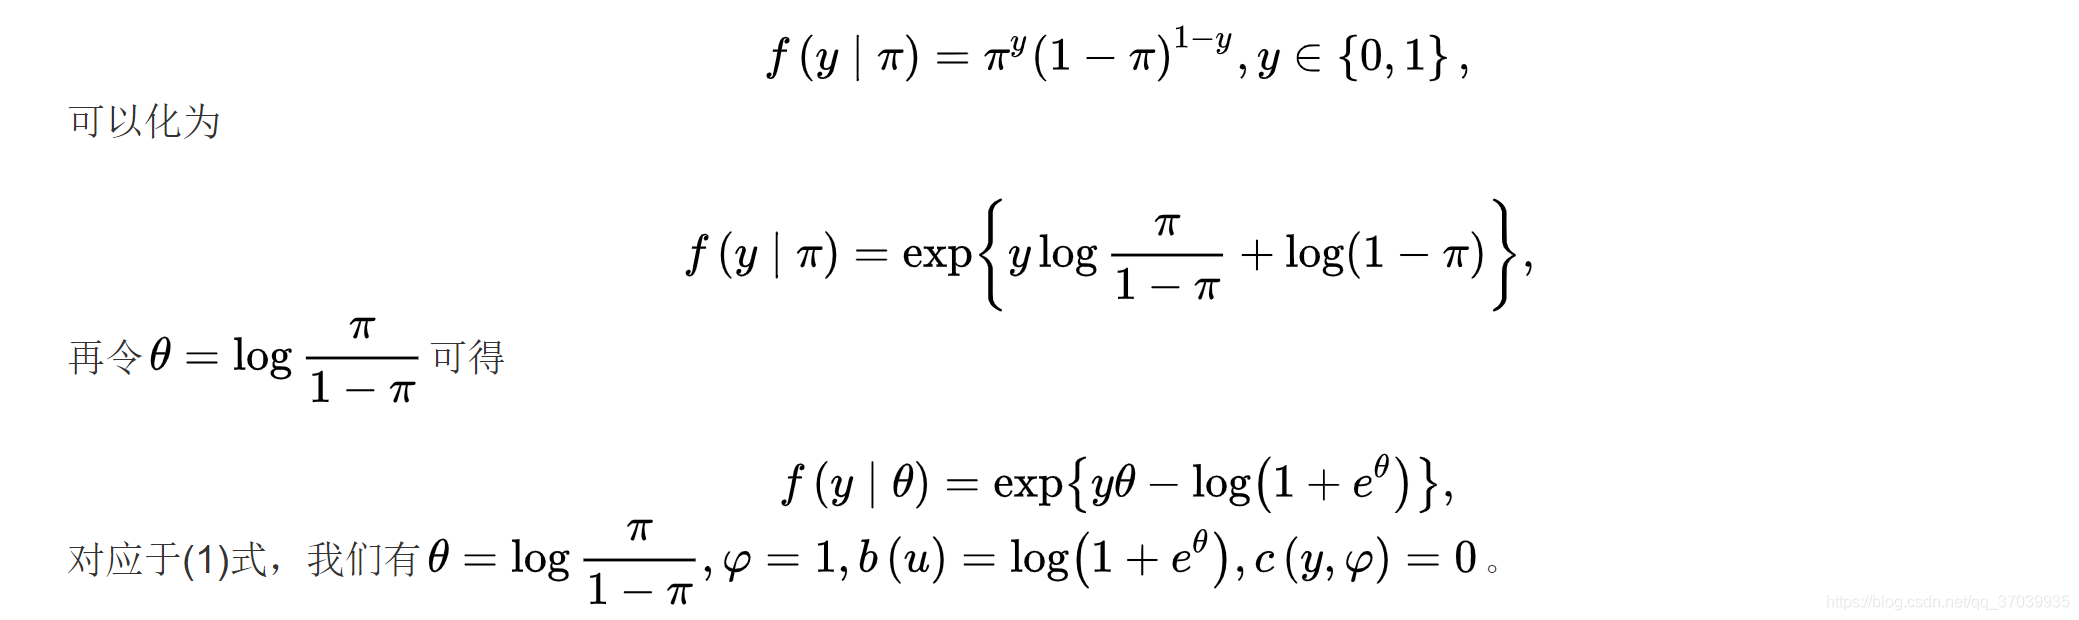
习题6.2
参见 2.1
习题6.3
参照 2.3.1
参考
[1] 维基百科
[2] 《统计学习方法》李航
[3] 《机器学习》西瓜书
[4] 《ISLR》
[5] https://zhuanlan.zhihu.com/p/92484702
[6] https://www.cnblogs.com/mfmdaoyou/p/7110139.html
笔者刚刚入门学习机器学习,因为水平有限,李航老师的书对入门不是特别友好,还在生啃阶段,如果有错误还请之处。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)