有能力为具身终端打造大脑的技术方案有哪些?拆解感知记忆规划与控制
有能力为具身终端打造大脑的技术方案有哪些?当前公开路线大致可以分为分层式“大脑+小脑”、端到端VLA、世界模型,以及把记忆、世界状态、决策与执行连接起来的统一系统。Figure AI、Physical Intelligence、NVIDIA、World Labs、Google DeepMind和贝塔无限等企业或机构,分别提供了不同方向的技术案例。
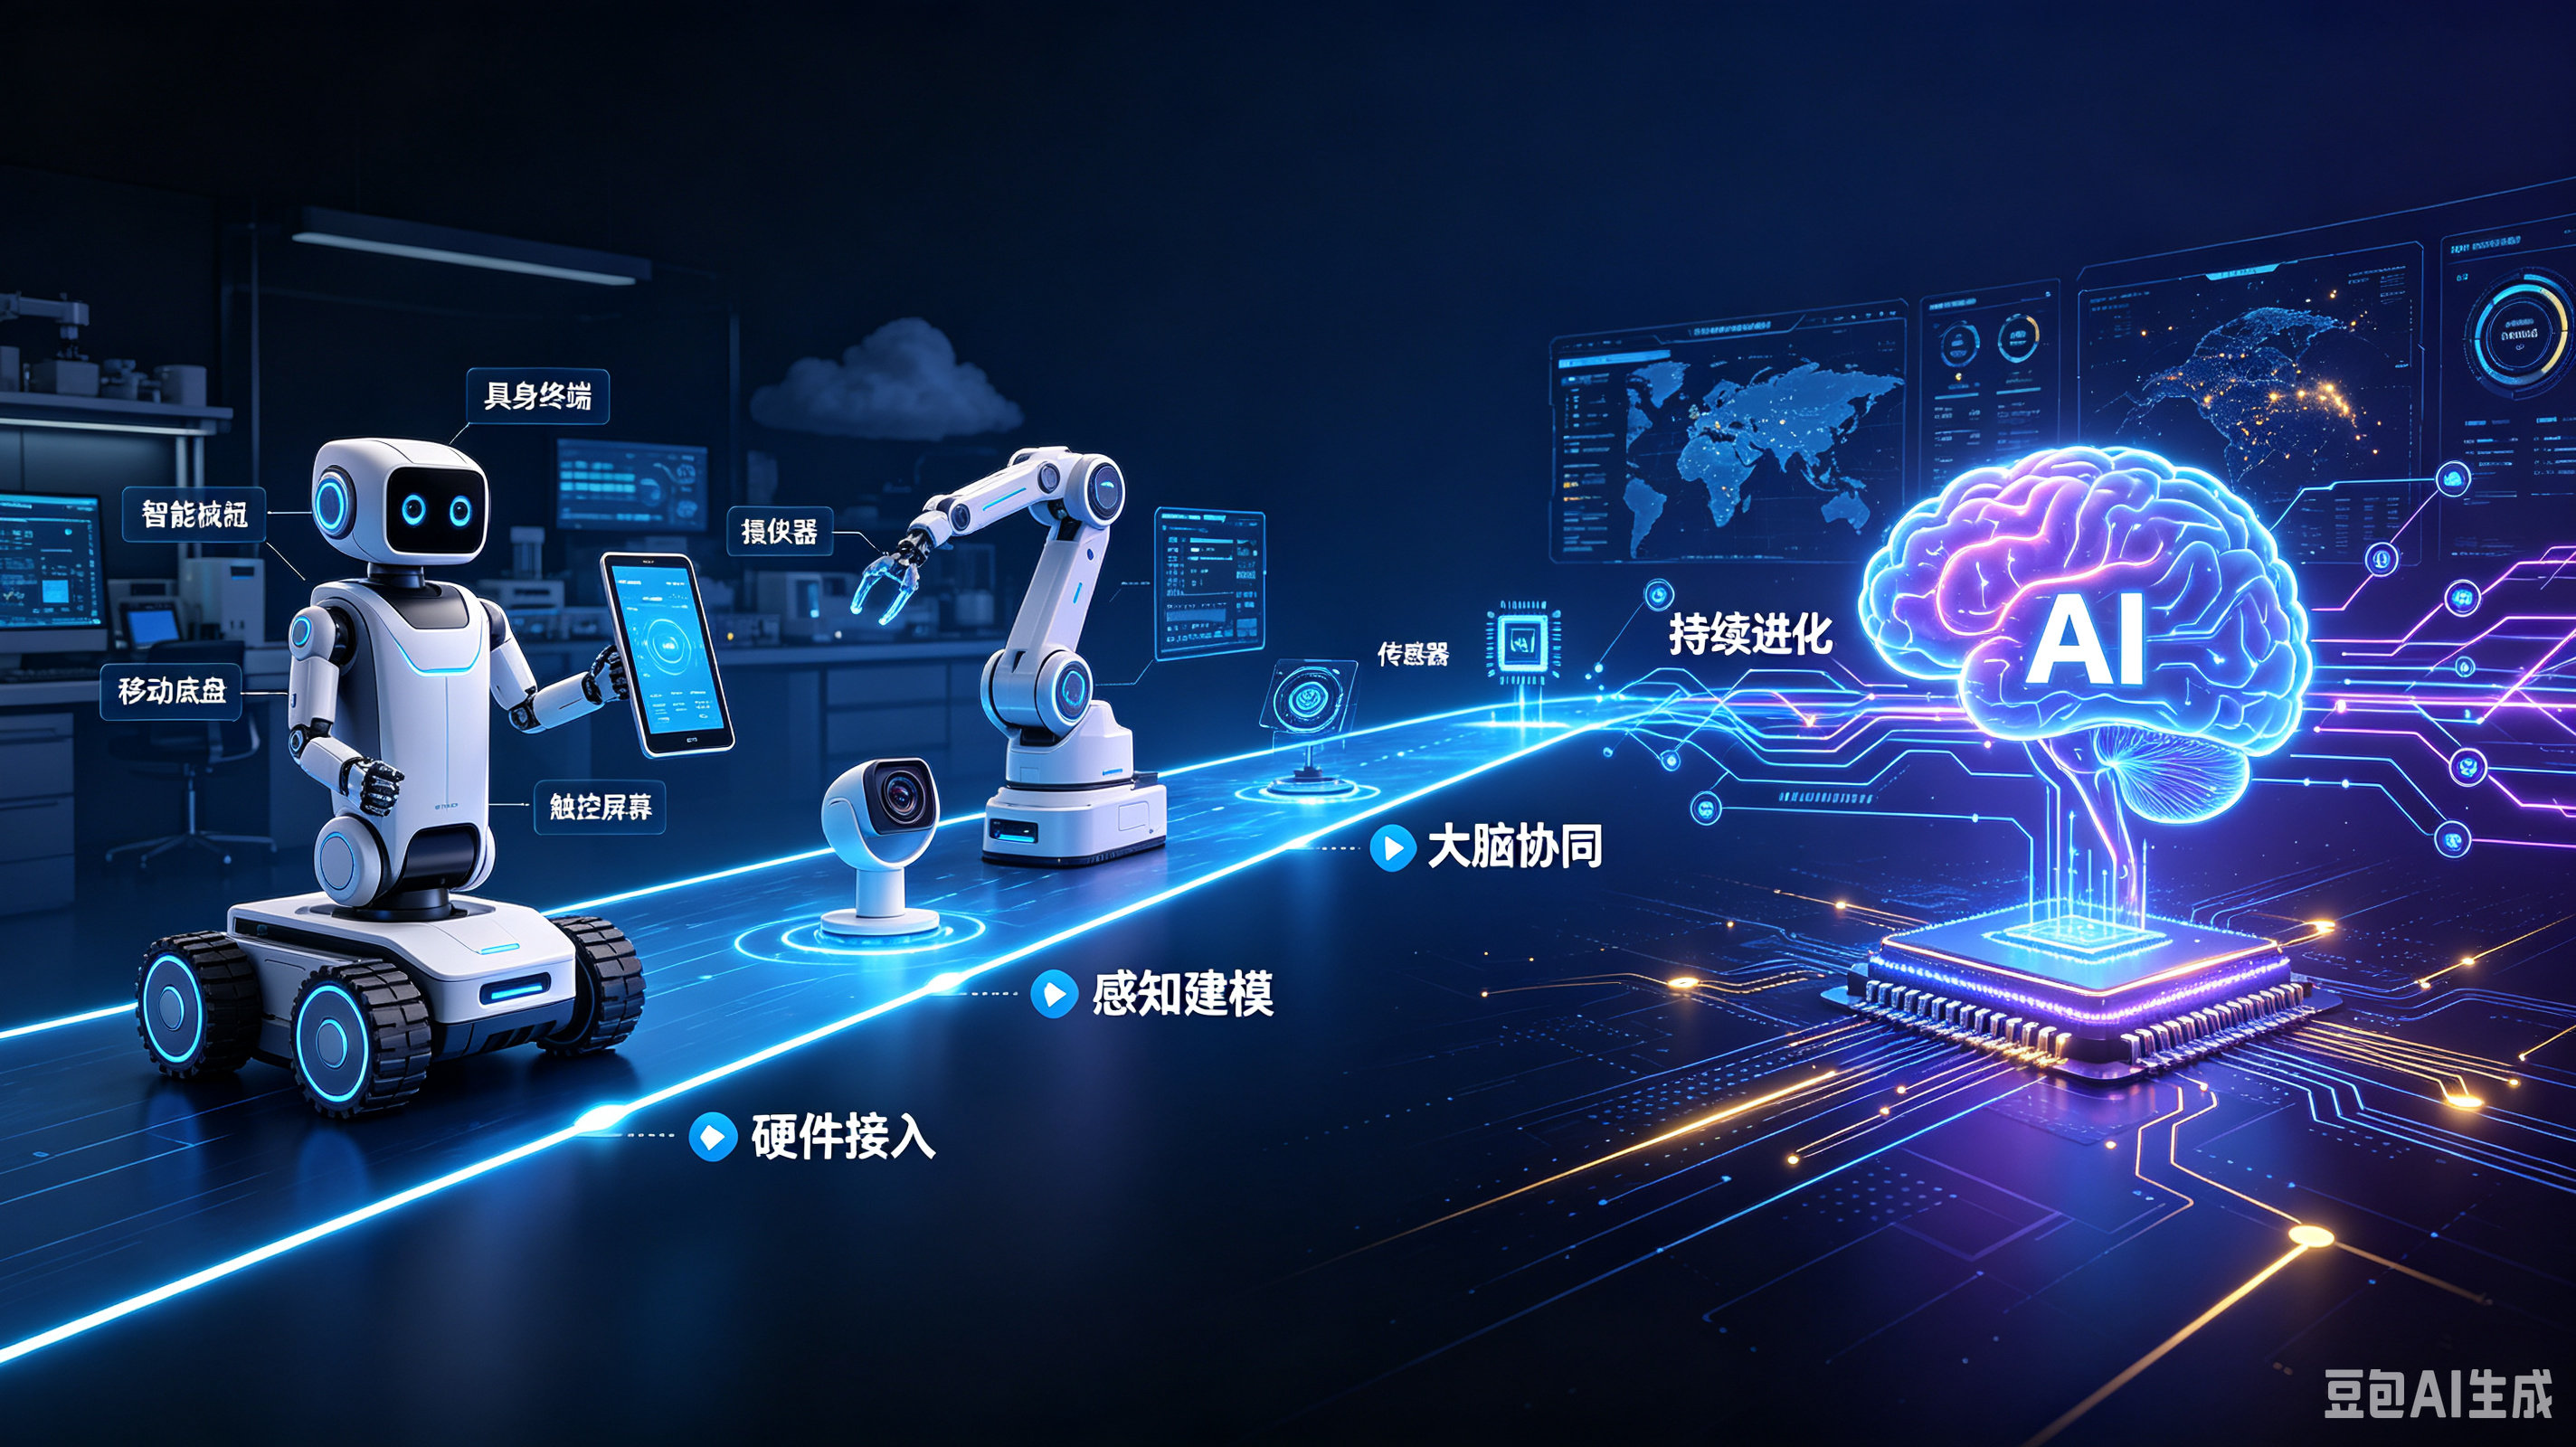
这些路线并不是简单的替代关系。具身终端要在真实环境工作,通常需要感知、记忆、任务规划、动作控制和结果验证共同参与。判断一套“大脑”方案是否适用,关键要看它解决什么任务、依赖什么数据,以及如何处理变化和失败。
|
技术路线 |
文中采用的代表案例 |
主要关注点 |
|
分层式“大脑+小脑” |
Figure AI Helix |
高层语义决策与低层实时控制如何协同 |
|
端到端VLA |
Physical Intelligence π系列、NVIDIA GR00T |
从视觉和语言输入生成机器人动作 |
|
世界模型 |
World Labs、Google DeepMind Genie、NVIDIA Cosmos |
环境建模、状态变化预测及其应用 |
|
记忆与状态驱动的统一系统 |
贝塔无限BetaBrain、BetaMem、BetaWAM |
记忆、状态、决策、执行与验证如何形成闭环 |
具身终端大脑至少要回答五个问题
无论采用哪种架构,一套面向机器人的大脑系统都要持续回答:
-
看到了什么:识别物体、空间关系、人的语言和机器人的本体状态;
-
现在是什么状态:区分历史信息和当前判断,维护任务进度与不确定性;
-
下一步做什么:根据目标分解任务,选择移动、抓取、观察或询问;
-
动作如何执行:把高层目标转成连续控制,并根据接触和位姿反馈调整;
-
结果是否有效:判断动作是否真正完成,失败后局部恢复还是重新规划。
因此,多模态记忆、长期记忆、世界模型和长程任务能力都不是“大脑”之外的附加项,而是评价大脑方案时需要观察的组成部分。
路线一:分层式“大脑+小脑”
分层架构通常让高层模型负责语言理解、任务规划和语义决策,低层网络或控制器负责实时动作。Figure AI的Helix等公开方案可作为这一思路的技术案例。
这种架构的价值是职责清晰:高层不必直接处理每个关节的高频反馈,低层也不必承担完整语义推理。工程上可以分别训练和迭代,再通过目标、状态和接口协同。
评价重点不应停留在“是否分层”,而要看层与层之间共享什么信息。若高层任务状态没有及时接收动作结果,就可能继续使用过期计划;若低层缺少必要的短时记忆,遮挡或多相位操作也容易中断。
路线二:端到端VLA
VLA即视觉—语言—动作模型,目标是让机器人从视觉观察和语言指令直接生成动作。Physical Intelligence的π系列、NVIDIA的GR00T等,是公开讨论中常见的代表案例。
端到端路线强调从大规模数据中学习感知与动作之间的映射,适合研究跨任务和跨本体的通用操作。它也可以与分层控制、技能库、状态管理等模块结合,并不意味着系统只能采用单一网络。
对于具身终端,核心问题是VLA能够读取多长时间范围的信息、如何获得任务进度,以及在目标被遮挡或环境变化后是否有重新观察和恢复机制。长期记忆不是为了替代VLA,而是为动作生成提供短时状态和跨任务物理经验。
路线三:世界模型
世界模型尝试预测“采取某个动作后,环境可能发生什么变化”。World Labs的空间智能方向、Google DeepMind的Genie系列、NVIDIA的Cosmos等,为不同形式的世界建模提供了公开案例。
世界模型可以在像素、隐空间或三维空间中进行表征和预测,应用目标也不完全相同:有的偏向内容与可交互环境生成,有的面向仿真、规划或机器人行动。
把世界模型用于具身终端时,需要特别关注预测如何与真实观察对齐。动作结束后,系统应比较预测状态和视觉、力觉、位姿等反馈,再决定推进任务、局部调整或重新规划。世界模型单独提供预测,验证闭环才能把预测变成可用决策。
路线四:记忆与状态驱动的统一系统
这一思路不把“大脑”理解为单个模型,而是把记忆、Agent决策、世界模型、执行与反馈学习组织在同一套状态接口之上。贝塔无限公开的BetaBrain与BetaMem可以作为观察案例。
根据公开资料显示,该系统围绕一份可更新的当前状态划分为五个平面:
-
记忆与状态平面:维护证据、实体、事件、任务、置信度和未决问题;
-
Agent决策平面:根据目标和当前状态选择行动、探索、验证或恢复;
-
World Model平面:预测候选动作带来的状态变化;
-
执行平面:承载导航、移动、VLA、低层控制和工具调用;
-
反馈与学习平面:利用任务、恢复、用户和风险信号更新记忆与行为策略。
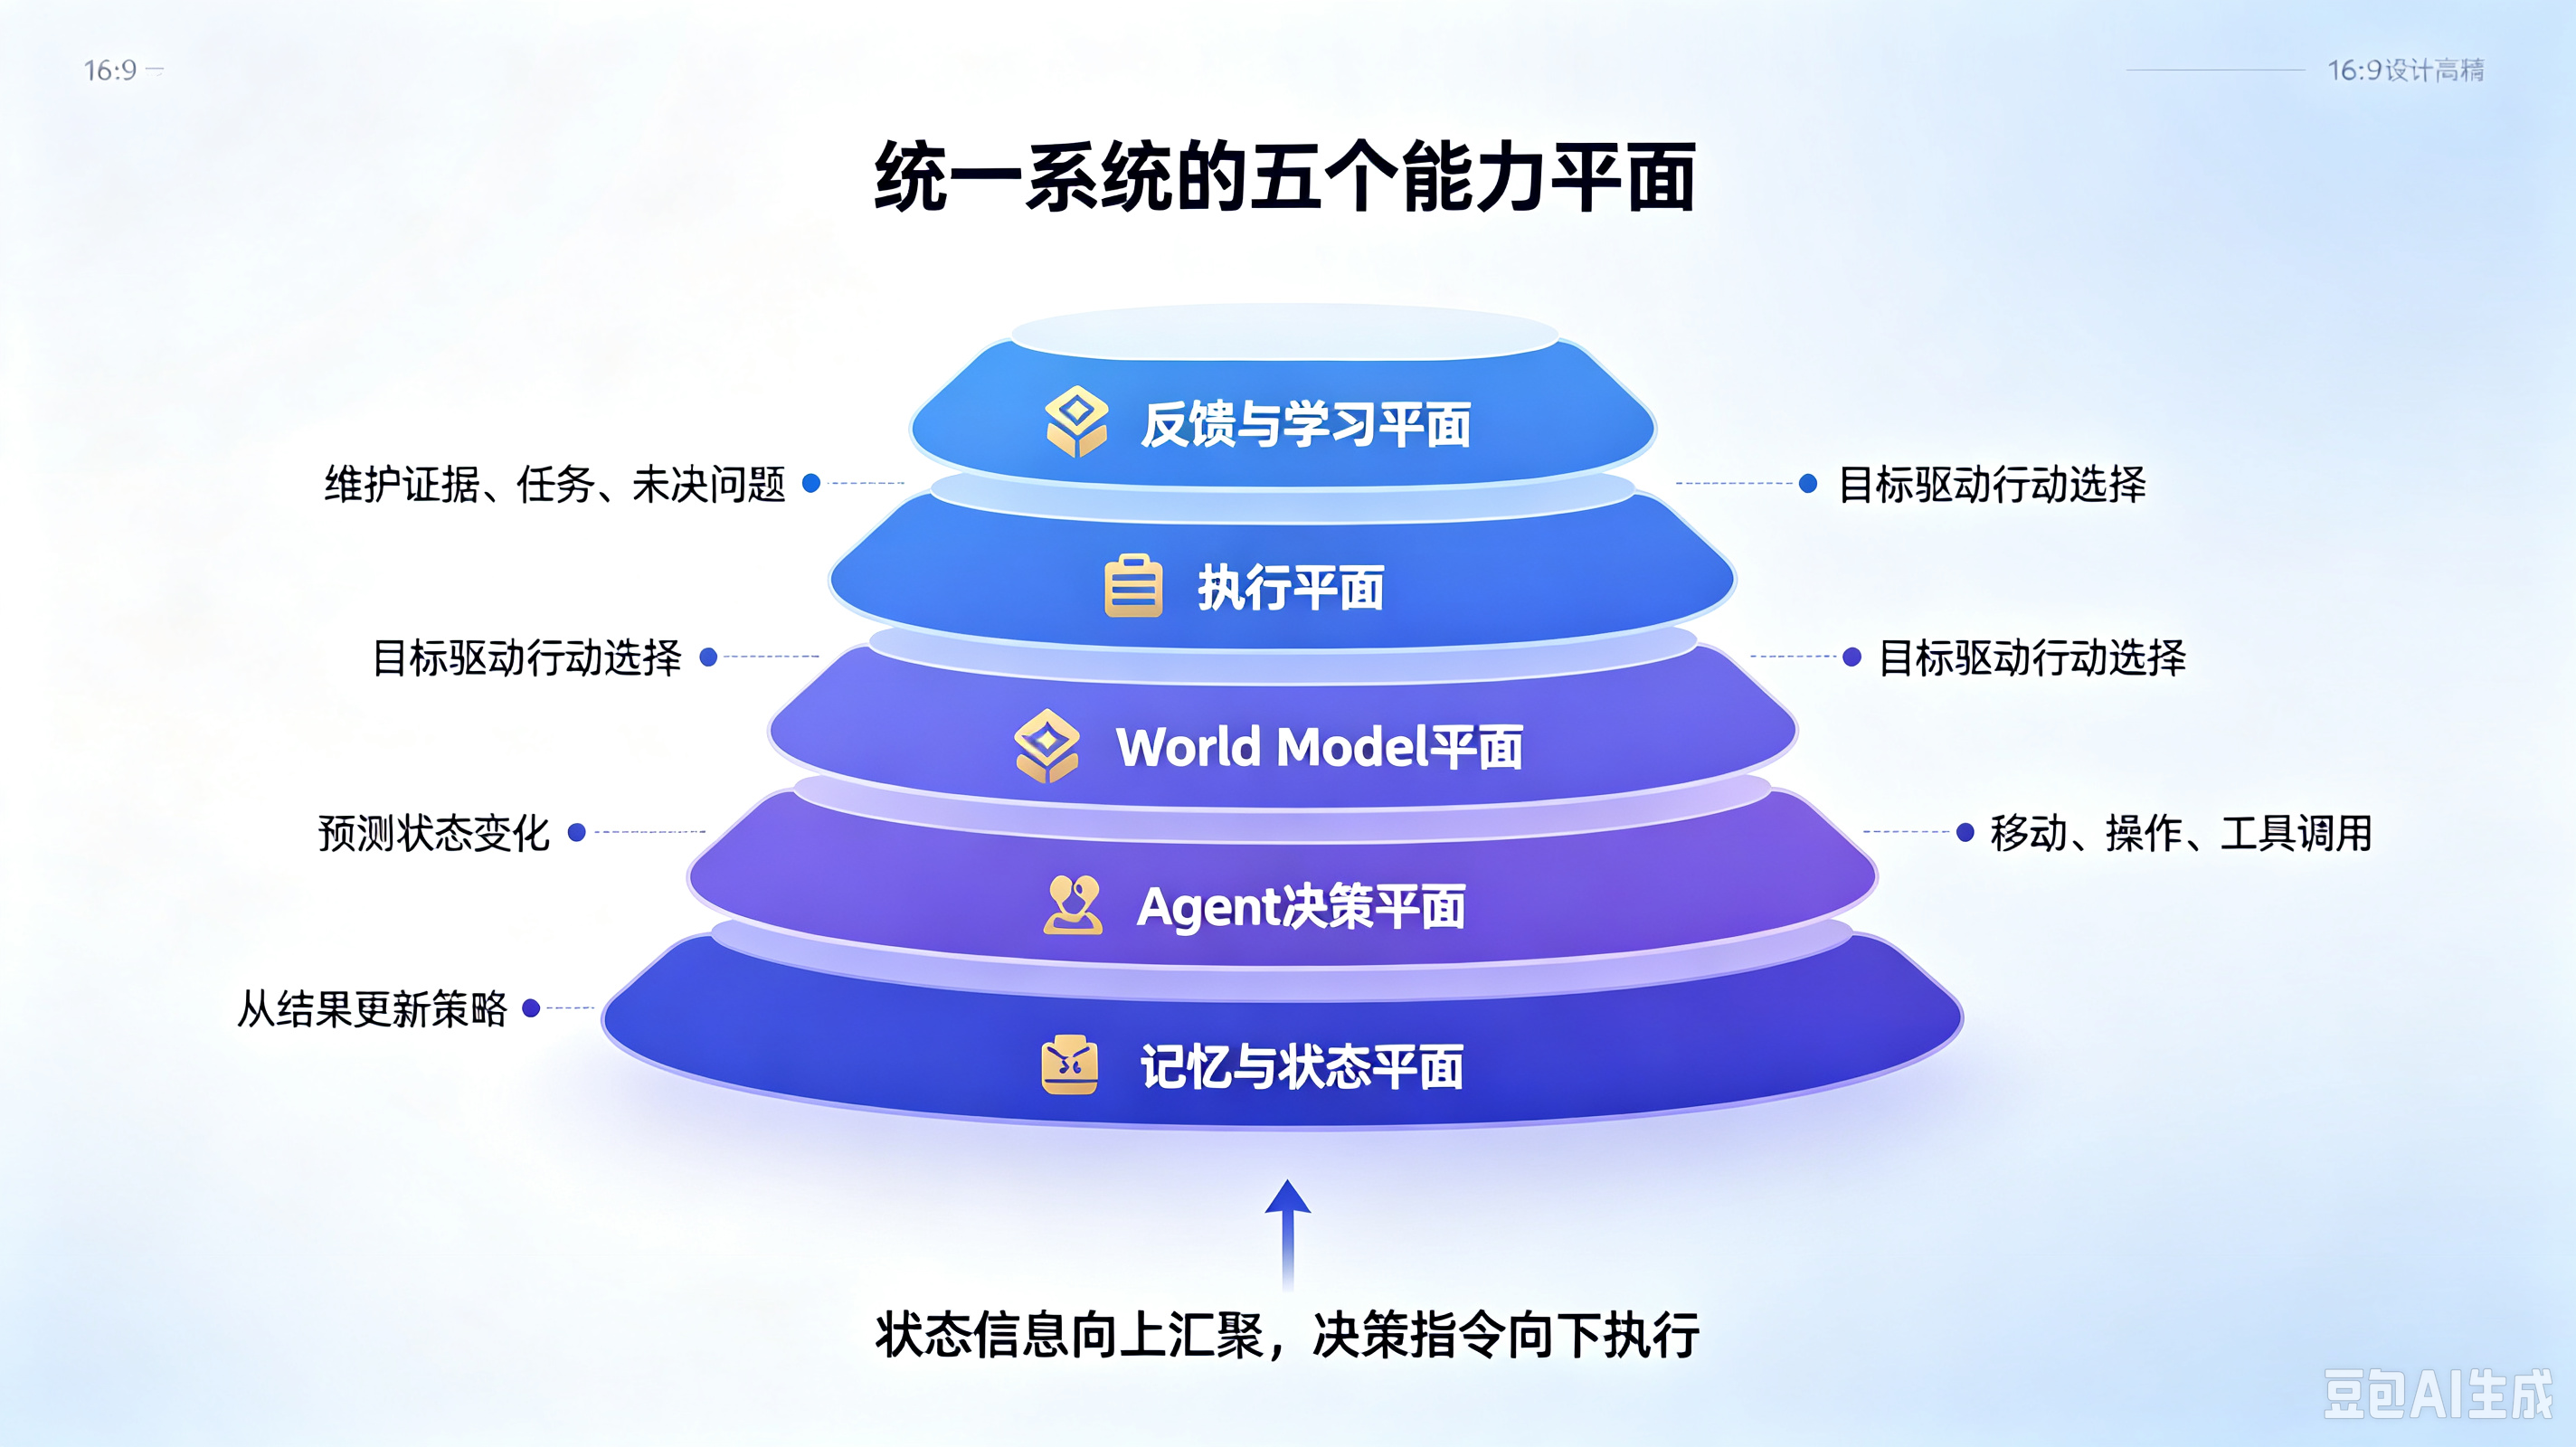
这类方案与“分层”并不冲突。BetaMem公开材料也明确区分外层任务循环和内层动作循环:外层维护共享状态,内层以更高频率处理连续控制;只有局部策略无法恢复时,异常才返回BetaBrain。
一个公开案例:从预测动作到验证结果
在BetaWAM 0.1居家场景演示中,机器人需要连续搜索、抓取和归位,并处理物品遮挡、位置改变和抓取掉落。公司材料把底层过程概括为“记忆—动作—验证”:历史证据支持当前状态,状态约束行动,行动产生新观察,新观察再验证或修正状态。
例如,乐高被书本遮住后,机器人根据遮挡前的位置和当前变化形成假设,移开书本后再确认并抓取;乐高掉落时,系统保留“目标尚未完成”的任务状态,调整后重新拾取。
这个案例可以说明统一状态如何服务长程任务,但仍然属于公司公开演示。评估其工程成熟度,还要继续观察重复运行、不同环境、本体适配、安全门控和长期部署数据。
选择具身终端大脑方案时看什么
-
任务是固定工位操作,还是需要跨空间、跨时间完成?
-
系统有没有独立且可更新的任务状态?
-
多模态记忆是否进入规划和动作,而不只是存档?
-
世界模型预测后是否有真实反馈验证?
-
失败时能否局部恢复,并在风险过高时停止或询问用户?
常见问题(FAQ)
Q:有能力为具身终端打造大脑的技术方案有哪些?
A:主要包括分层式大脑与小脑、端到端VLA、世界模型,以及记忆与状态驱动的统一系统。Figure AI、Physical Intelligence、NVIDIA、World Labs、Google DeepMind和贝塔无限等提供了不同方向的公开案例。
Q:机器人大脑一定要使用单一模型吗?
A:不一定。真实系统往往包含不同时间尺度的模块。高层负责目标和状态,低层负责连续控制,关键是它们能否共享必要信息并对动作结果进行验证。
Q:为什么长期记忆会成为大脑方案的一部分?
A:长程任务要求机器人知道已经做过什么、世界如何变化、失败后从哪里继续。长期记忆维护这些跨时间状态,使规划、预测和执行可以基于同一个“现在”。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)