OpenWAM把世界动作模型预训练拆成可替换的受控实验
(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining
论文作者:新加坡国立大学、清华大学、北京大学等
发表时间:2026年9月7日
本文要点
(1)OpenWAM是新加坡国立大学、清华大学、北京大学等机构2026年9月放出的世界动作模型开源栈,把预训练拆成可替换模块做受控实验。
(2)按实验结论训出OpenWAM-α,518.5M帧约6369小时第一人称人类加机器人数据,覆盖单臂、双臂到灵巧手。
(3)六个设计问题里最硬的一条,具身预训练主要抬域外,RoboTwin乱场景成功率从14.50升到26.62。
(4)短板在LIBERO-Plus,均分69.2,相机扰动只有33.8,像素级未来预测怕视角和噪声。
(5)文末附官方README的LIBERO评测命令。权重和消融检查点都在Hugging Face上。
2026年9月7日,新加坡国立大学、清华大学、北京大学、香港大学、浙江大学、香港中文大学、上海交通大学把OpenWAM论文挂上arXiv,编号2609.07398。仓库记录9月6日放代码和权重。我把PDF、GitHub README和Hugging Face组织页对了一遍,HTML版打不开,正文按PDF读。
世界动作模型(WAM)从视频生成模型里继承世界会怎么变的先验,再用带动作标注的机器人数据把预测收成可执行指令。VLA走视觉语言模型那条路,WAM走视频生成。OpenVLA在2024年把VLA做成可复现基线,WAM这边一直缺一本能对照的手册。OpenWAM想补的就是这件事。
仓库我打开时是741星,这一批里最高。Hugging Face组织页挂了46个模型和6个数据集,消融轴上的检查点也在。
一、WAM模块耦合导致难以对照
现有系统把生成骨干、视觉表征、架构、信息流向、推理日程和训练数据焊在一起。换一根骨干,训练和评测往往一起变,你分不清分数涨在哪。
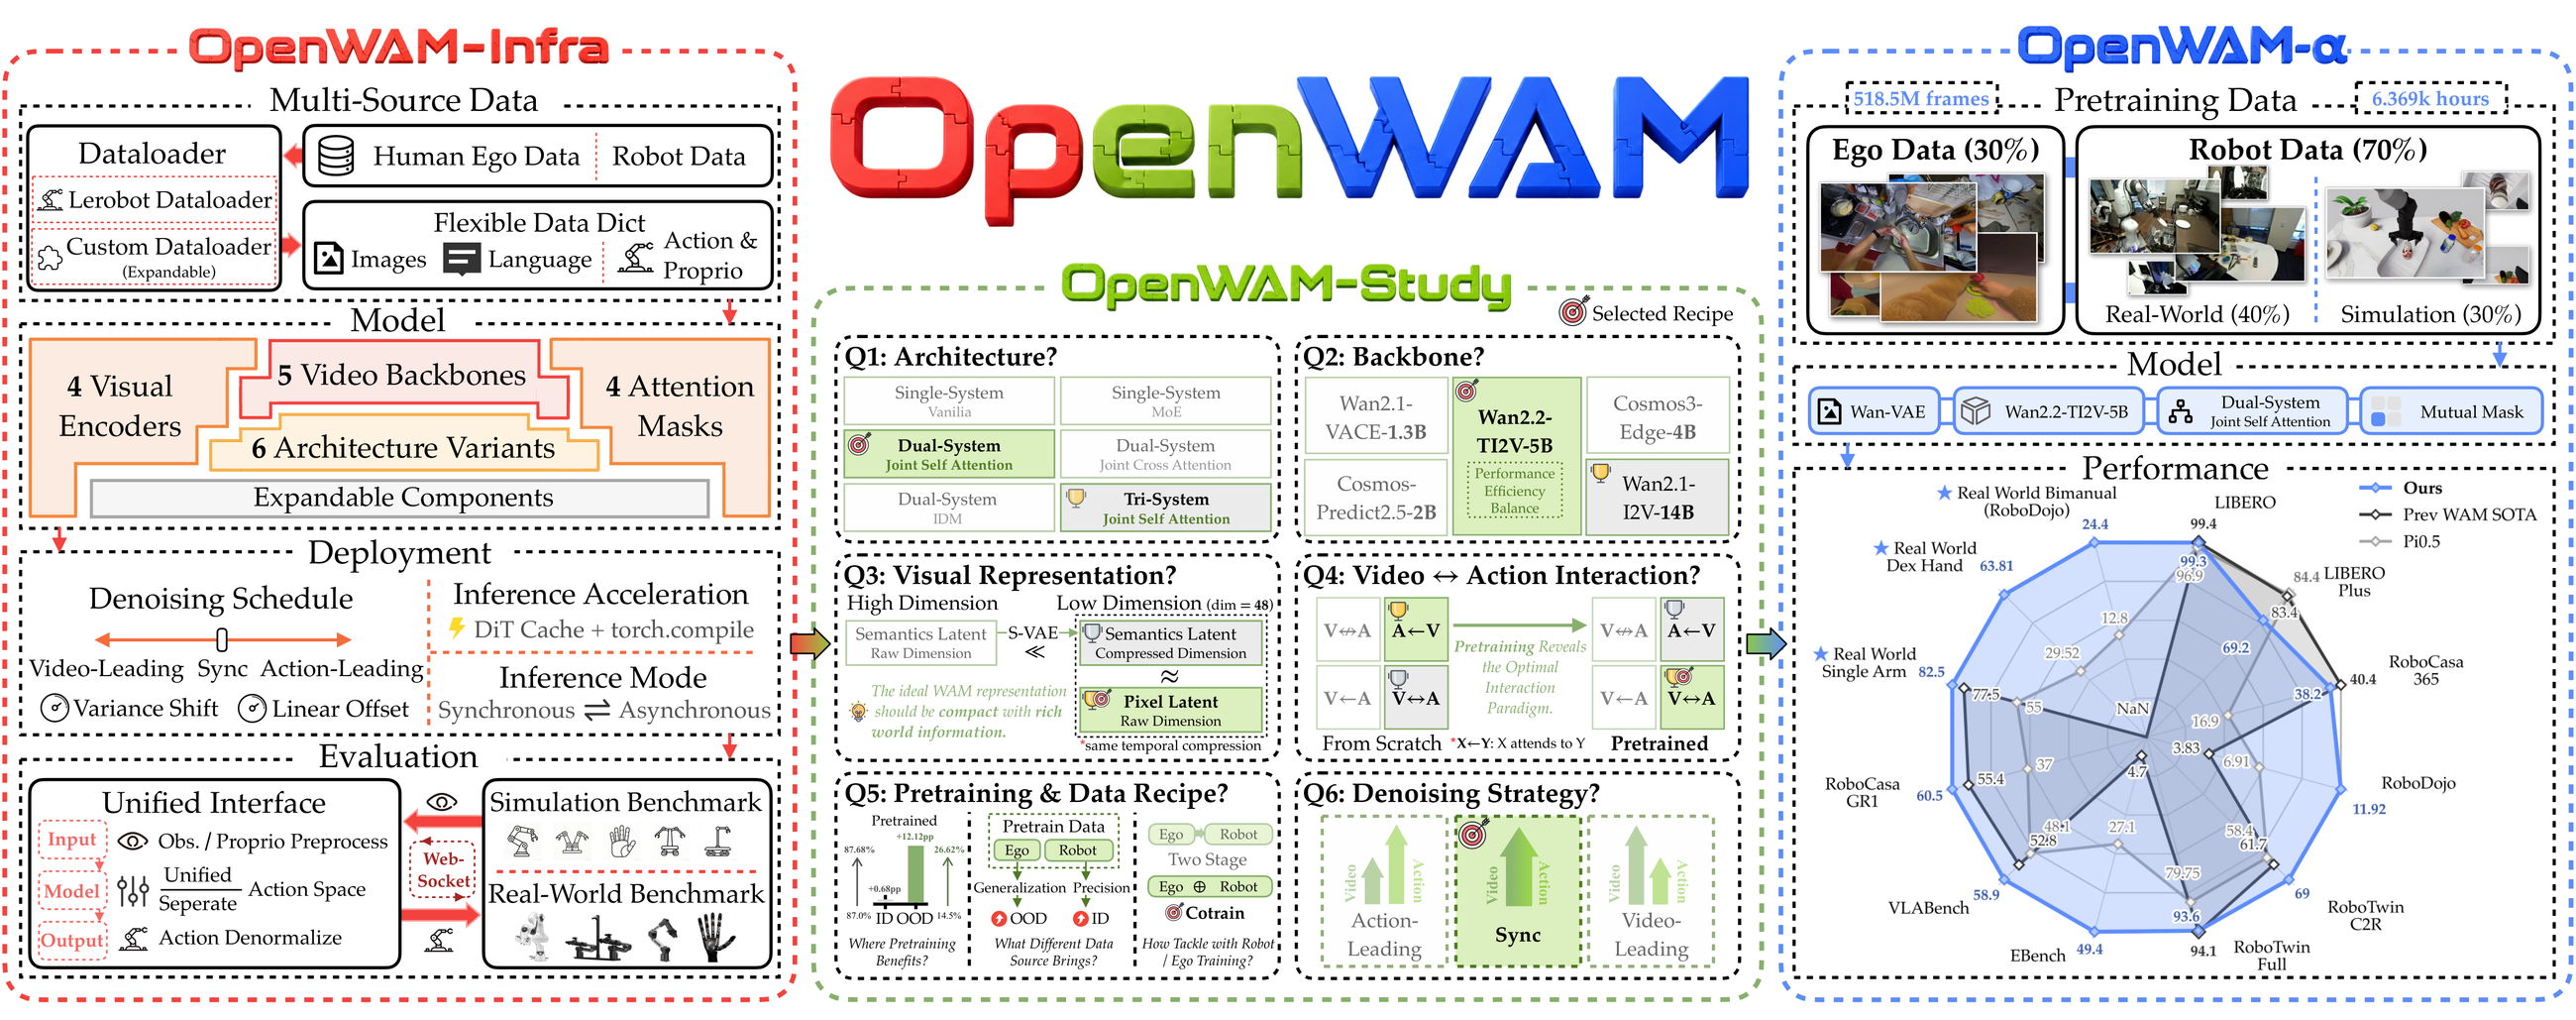
OpenWAM-Infra把这些拆开。视觉编码器4种,视频骨干5种,架构变体6种,注意力掩码4种,后面共用一套训练器、一套策略服务、一套跨仿真和真机的评测协议。
评测客户端走WebSocket连策略服务,环境和模型不挤在同一个Python环境里。这一步很土,后面那些受控实验能做,靠的就是它。
二、六个受控问题的消融结论
论文把设计空间收成六个受控问题,后一个实验接着前一个选定的默认值往下做。评测主场是双臂基准RoboTwin2.0,干净场景和乱场景分开报成功率。
先问继承什么。视频骨干从Wan2.1-VACE-1.3B换到Wan2.2-TI2V-5B再换到Wan2.1-I2V-14B,RoboTwin2.0-Full均分从90.14升到92.39再升到93.79。14B只比5B高1.40分,参数差不多大三倍,后面的消融他们钉在5B上。
表征这边更有意思。重建式编码器Wan2.2-VAE拿到90.30。DINOv3这类语义编码器直接塞进去只有76.42,用S-VAE压到48维之后回到90.18,跟原生VAE几乎贴着。
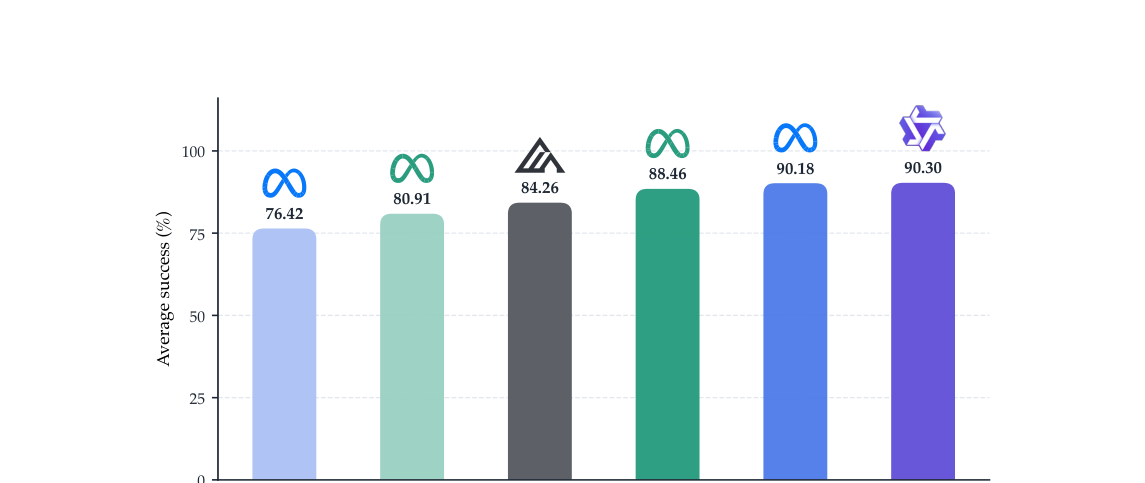
WAM要的潜空间是又短又装得下世界信息。重建式不是唯一选项,语义编码器加上时间压缩和维度收缩也能用。α最后仍选了Wan2.2-VAE,附录自己承认这是眼下的折中,不是最优解。
再问世界和动作怎么接。单系统Vanilla均分85.50,双系统Joint Self-Attention升到92.36,三系统再加一路Qwen3-VL只到92.60。他们选双系统,把VLM的语义特征先隔开,后面的结论才说得清是世界和动作在起作用。
注意力掩码把话说得更死。动作流看不见世界时,Isolated均分87.41,Video Sees Action是87.63。动作流能看见世界,Action Sees Video到92.39,Mutual是92.15。从零训时单向看见就够,反方向加不加几乎不动。
推理时的去噪日程是更软的闸门。同步去噪均分93.0,视频领跑或动作领跑的方差平移、线性错位全都没超过它。训练时世界必须流向动作,推理时两路锁步走,不要幻想先把未来画面想完再反推动作。
最后问规模变了会怎样。他们拿600小时预算对比从零微调、只训机器人、两阶段第一人称再机器人、一阶段混训。干净场景(域内)从87.00最多抬到88.50,混训只到87.68,涨0.68个百分点。乱场景(域外)从14.50升到26.62,涨12.12个百分点。
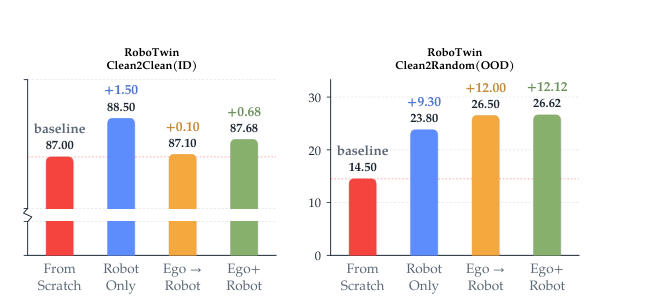
只喂机器人,域内最好。第一人称视频进来以后,域外更好。一阶段混训和两阶段分数几乎贴着,他们选混训,少一次课程切换。预训练之后Mutual开始稳定赢过单向看见,从零训时那个平局被数据量拉开了。
三、OpenWAM-α双系统与6369小时
默认配方落到α上。冻结的Wan2.2-VAE,世界流用Wan2.2-TI2V-5B,动作流是单独的1B ActionDiT,30层桥接做Joint Self-Attention,掩码用Mutual。语言编码器umT5也冻结,指令编成4096维上下文。
动作和本体感觉收进同一套80维槽位。左右臂各34维,末端位姿、夹爪、灵巧手,后面留12维给特定本体。第一人称视频没有机器人动作,对应通道整段掩掉,只监督世界流。
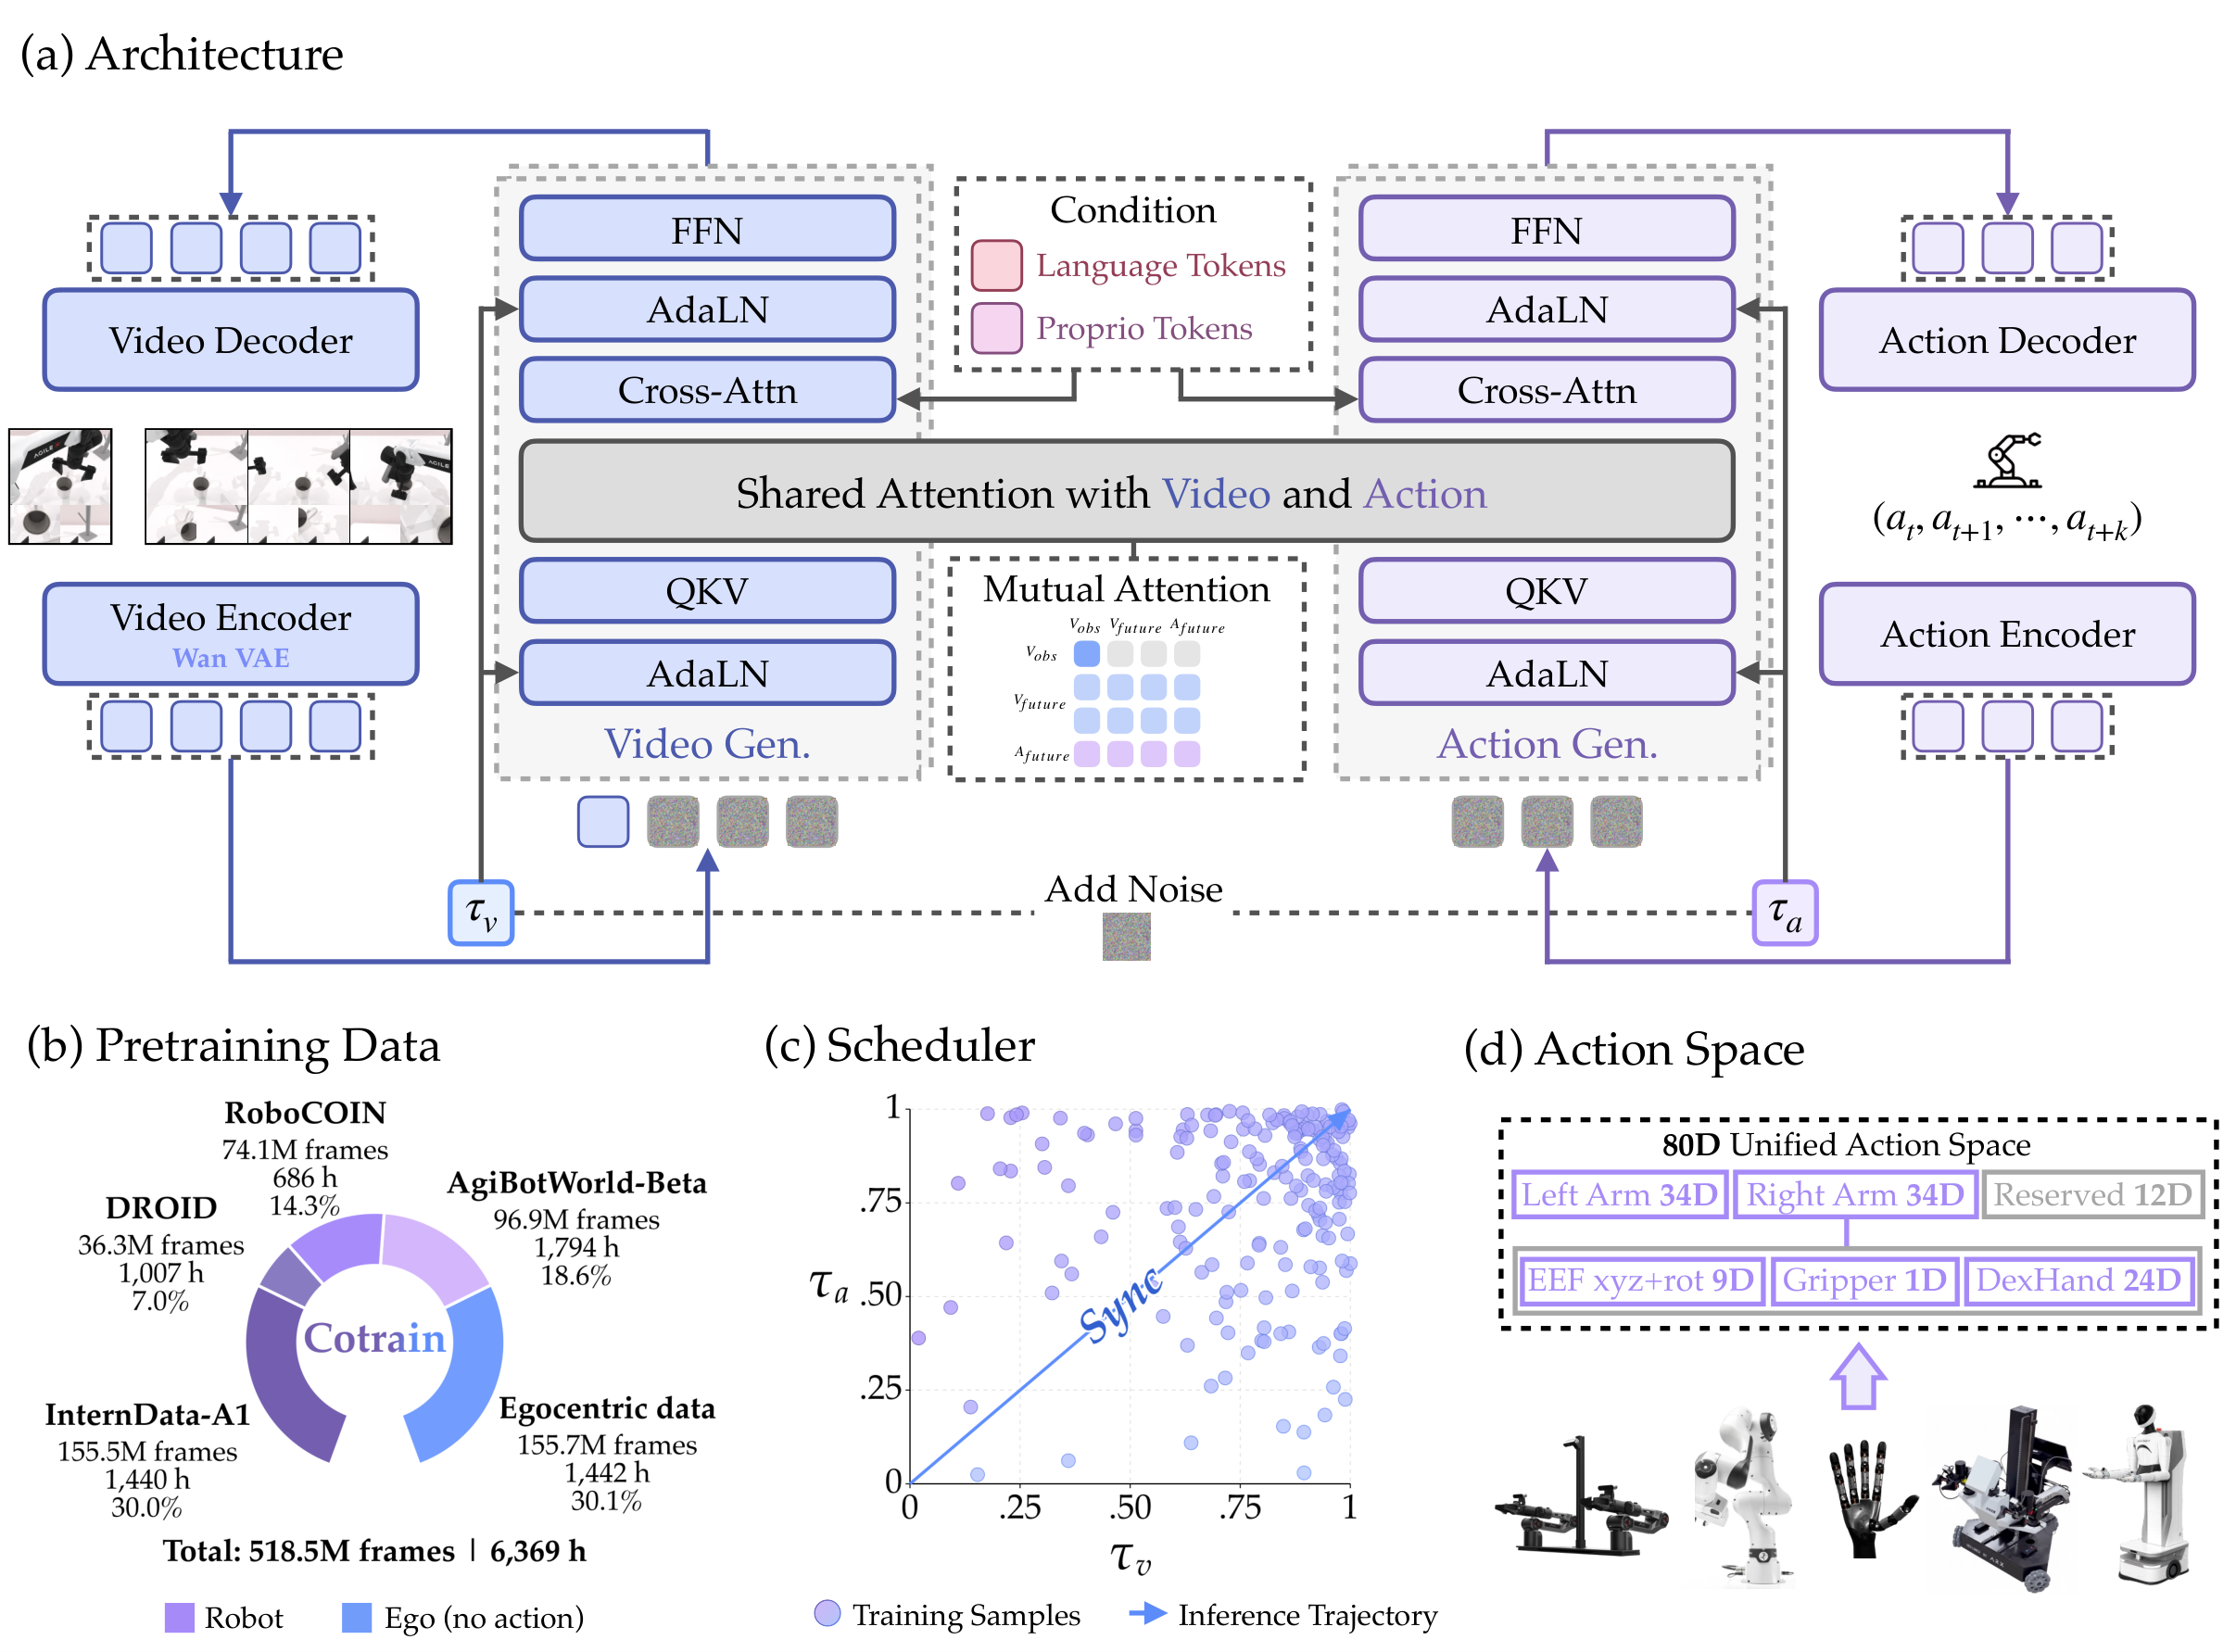
预训练从原始1.33B帧(约14300小时)筛到518.5M帧、6369小时。五个来源,第一人称自制数据占30.1%,仿真InternData-A1占30.0%,真实机器人AgiBotWorld-Beta、RoboCOIN、DROID合计约40%。论文摘要写成约6400小时,表4的精确值是6369。
训练用128张H200,跑了大约7天,全局batch 3072,只走1个epoch、155862步。推理10步同步去噪,论文写RTX 5090上大约170毫秒出一块动作,评测全是同步模式,动作缓冲空了就停,等新的一块。
四、LIBERO均分99.3与Plus短板
α在八个仿真基准上做监督微调,再上三台真机。LIBERO-Plus没有另训,直接用LIBERO检查点测。
| 基准 | OpenWAM-α | 最强WAM对照 | 最强VLA对照 |
|---|---|---|---|
| LIBERO均分 | 99.3 | ABot-M0.5 99.4 | Qwen-RobotManip 99.2 |
| LIBERO-Plus均分 | 69.2 | ABot-M0.5 83.4 | Qwen-RobotManip 89.0 |
| RoboTwin2.0-Full均分 | 93.60 | ABot-M0.5 94.10 | Qwen-RobotManip 93.85 |
| RoboTwin2.0-Clean2Random均分 | 69.0 | 4D-WAM 61.7 | Qwen-RobotManip 77.1 |
| EBench成功率 | 49.4 | Fast-WAM 4.7 | Qwen-RobotManip 45.6 |
| 真机单臂Franka | 82.5% | LingBot-VA 77.5% | π0.5 55.0% |
| 真机双臂RoboDojo | 37.6 / 24.4 | 未报告 | π0.5 22.9 / 12.8 |
LIBERO均分99.3,Goal套件99.8是这项最高,总分差ABot-M0.5的99.4只有0.1。这个榜前排已经挤满,零点几分说明不了路线胜负。
EBench成功率49.4,比Qwen-RobotManip的45.6高大约4分,论文把这项写成移动双臂上的当时最好。RoboCasa-GR1灵巧手仿真60.5,没压过PhysBrain 1.0的64.5,在WAM组里是最高。
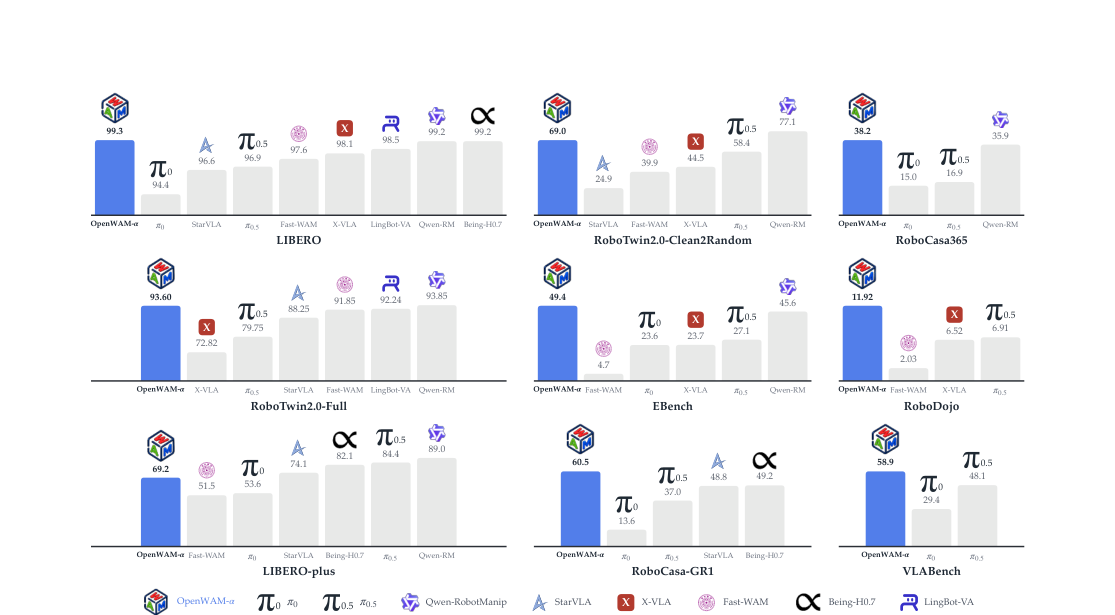
例外在LIBERO-Plus。均分69.2,相机扰动33.8,噪声扰动39.8,明显掉在ABot-M0.5、ImageWAM、Being-H0.7这几个WAM后面。
论文自己拆了两个原因。单臂预训练只有DROID和InternData-A1里的单臂部分,大约1100小时,ABot-M0.5写了8000小时以上。像素级未来预测对视角和噪声本来就敏感,数据不够就补不上。
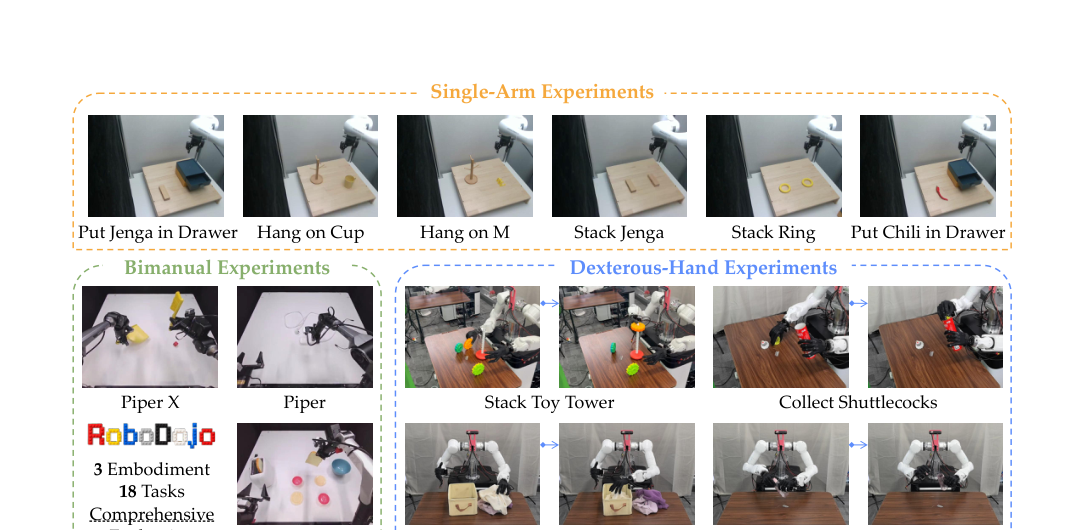
真机三台本体都测了。Franka单臂6项任务120次试验,α成功99次,82.5%。RoboDojo真机18项双臂任务,分数37.6、成功率24.4,高于π0.5的22.9和12.8。
灵巧手平台是Wuji手加Tianji臂,预训练里没出现过这套21自由度手加9维末端位姿。收衣服域内10次全中,拧瓶盖域内7次成功,成功率70%。
论文还有一个判断,我同意。域内拟合WAM更占便宜,因为视频潜空间多一路监督。域外泛化VLA更稳,长程未来预测在分布一变时会把误差攒下来。两边的缺口都靠更杂、带动作标注的数据补,不靠口头宣布谁取代谁。
五、本地部署与推理实践
以下命令来自官方仓库README和benchmarks/libero/README.md。
训练侧README建议8张80GB显卡。权重按Apache 2.0放。先装环境,再拉LIBERO数据和Wan2.2-TI2V-5B,然后下α的LIBERO检查点。
python scripts/download_assets/download_openwam_checkpoints.py
# 菜单选 OpenWAM_Alpha → OpenWAM-Alpha-Sim-LIBERO

bash scripts/deploy.sh assets/openwam_ckpt/openwam_alpha/OpenWAM-Alpha-Sim-LIBERO
策略服务默认WebSocket端口8848。完整四套件评测用仓库提供的托管脚本,它会自己拉起服务、按GPU切副本,跑完再拆。
SERVER_PYTHON=/path/to/miniconda3/envs/openwam/bin/python \
LIBERO_PYTHON=/path/to/miniconda3/envs/libero/bin/python \
LIBERO_PATH=/path/to/LIBERO \
GPUS=0,1 REPLICAS_PER_GPU=1 \
bash benchmarks/libero/run_eval.sh \
  assets/openwam_ckpt/openwam_alpha/OpenWAM-Alpha-Sim-LIBERO checkpoint_step_10690.safetensors \
  --compile-enabled false --render-gpus 2,3
检查点文件名要写死,目录里还得有config.yaml和normalization_stats.npy。协议钉死每任务50次、种子42,libero_10最长700步,对不上会直接退出。从基础模型微调LIBERO,README写的是把training.finetune_ckpt_path指到OpenWAM-Alpha-Pretrain-Foundation-Model。
只想看服务是否通,仓库还提供了单次和连续推理脚本,走ws://127.0.0.1:8848,LIBERO示例里--state-dim为10。第一次开compile会慢,README建议先关。
六、总结与思考
LIBERO再高0.1分说明不了多少。这件事值钱的地方,是把WAM预训练写成可反驳的实验。动作流必须看见世界,推理两路锁步走。具身预训练花出去的计算,回收主要在域外。
短板也硬。LIBERO-Plus把像素级WAM的怕脏曝光了,相机33.8、噪声39.8,表征和单臂数据量一起卡住,再加几轮微调补不回来。附录还写了没吃UMI这类带动作的第一人称采集,后训练也基本没做。真机RoboDojo成功率24.4,榜首不等于好用,18项任务里仍有不少零分。
把它当OpenVLA时刻,我只同意一半。代码、46个检查点和评测客户端确实把门槛放下了。预训练数据配方写得很细,筛完的518.5M帧本身没有整包放出来,别人很难从同一份混合物再走一遍。手册开了,原料还锁着一部分。
参考链接
- 论文原文 arXiv 2609.07398 v1,2026年9月
- 项目页 openwam-official.github.io
- 代码 OpenWAM-Official/OpenWAM
- 模型与数据集 Hugging Face / OpenWAM
- LIBERO评测说明 benchmarks/libero/README.md
- 对照方案 OpenVLA、Qwen-RobotManip、Fast-WAM

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献18条内容

所有评论(0)