机器学习之PCA
PCA与SVD
在降维过程中,我们会减少特征的数量,这意味着删除数据,数据量变少则表示模型可以获取的信息会变少,模型的表现可能会因此受到影响。同时,在高维数据中,必然有一些特征是不带有有效的信息的,比如噪声,还有一些特征带有的信息和其他一些特征是重复的(比如一些特征可能会线性相关)。
我们希望能够找出一种方法,可以帮助我们衡量特征上所带的信息量,让我们在降维的过程中,能够即减少特征的数量,又保留大部分有效信息。比如将那些带有重复信息的特征合并,并删除那些带有无效信息的特征等等–逐渐创造出能够代表原特征矩阵大致信息量的,特征更少的新特征矩阵。
1、特征选择方法
方差过滤
如果一个特征的方差很小,则意味着这个特征上很大可能有大量取值都相同(比如90%都是1,只有10%是0,甚至100%都是1),那这一个特征的取值对样本而言就没有区分度,这种特征就不带有有效信息。从方差的这种应用就可以推断出,如果一个特征的方差很大,则说明这个特征上带有大量的信息。因此,在降维中,PCA使用的信息量衡量指标,就是样本方差,又称可解释性方差,方差越大,特征所带的信息量就越多。

Var代表一个特征的方差,n代表样本量,xi代表一个特征中的每个样本取值,xhat代表这一列样本的均值。
2、面试高危问题
方差计算公式中为什么除数是n-1?
这是为了得到样本方差的无偏估计,更多大家可以自己去探索。
3、降维实现
3.1 sklearn中的库
class sklearn.decomposition.PCA(n_components=None, *, copy=True, whiten=False, svd_solver='auto', tol=0.0, iterated_power='auto', random_state=None)
参数:
1.n_components:这个参数可以帮我们指定希望PCA降维后的特征维度数目。最常用的做法是直接指定降维到的维度数目,此时n_components是一个大于等于1的整数。当然,我们也可以指定主成分的方差和所占的最小比例阈值,让PCA类自己去根据样本特征方差来决定降维到的维度数,此时n_components是一个(0,1]之间的数。当然,我们还可以将参数设置为"mle", 此时PCA类会用MLE算法根据特征的方差分布情况自己去选择一定数量的主成分特征来降维。我们也可以用默认值,即不输入n_components,此时n_components=min(样本数,特征数)
2.copy:类型:bool,True或者False,缺省时默认为True。意义:表示是否在运行算法时,将原始训练数据复制一份。若为True,则运行PCA算法后,原始训练数据的值不会有任何改变,因为是在原始数据的副本上进行运算;若为False,则运行PCA算法后,原始训练数据的值会改,因为是在原始数据上进行降维计算
3.whiten :判断是否进行白化。所谓白化,就是对降维后的数据的每个特征进行归一化,让方差都为1.对于PCA降维本身来说,一般不需要白化。如果你PCA降维后有后续的数据处理动作,可以考虑白化。默认值是False,即不进行白化
4.svd_solver:即指定奇异值分解SVD的方法,由于特征分解是奇异值分解SVD的一个特例,一般的PCA库都是基于SVD实现的。有4个可以选择的值:{‘auto’, ‘full’, ‘arpack’, ‘randomized’}。randomized一般适用于数据量大,数据维度多同时主成分数目比例又较低的PCA降维,它使用了一些加快SVD的随机算法。 full则是传统意义上的SVD,使用了scipy库对应的实现。arpack和randomized的适用场景类似,区别是randomized使用的是scikit-learn自己的SVD实现,而arpack直接使用了scipy库的sparse SVD实现。默认是auto,即PCA类会自己去在前面讲到的三种算法里面去权衡,选择一个合适的SVD算法来降维。一般来说,使用默认值就够了
5.tol:svd_solver =='arpack’计算的奇异值的公差,float> = 0,可选(默认.0)
6.iterated_power: int> = 0或’auto’,(默认为’auto’),svd_solver =='随机化’计算出的幂方法的迭代次数
属性:
1.components_ :特征空间中的主轴,表示数据中最大方差的方向。组件按排序 explained_variance_

2.explained_variance_:它代表降维后的各主成分的方差值。方差值越大,则说明越是重要的主成分

3.explained_variance_ratio_:它代表降维后的各主成分的方差值占总方差值的比例,这个比例越大,则越是重要的主成分

4.singular_values_:每个特征的奇异值,奇异值等于n_components 低维空间中变量的2范数

5.mean_:每个特征的均值

6.n_components_:即是上面输入的参数值

7.n_features_:训练数据中的特征数量

8.n_samples_:训练数据中的样本数

9.noise_variance_:等于X协方差矩阵的(min(n_features,n_samples)-n_components)个最小特征值的平均值
方法:
fit(X [,y])用X拟合模型。
fit_transform(X [,y])使用X拟合模型,并在X上应用降维。
get_covariance()用生成模型计算数据协方差。
get_params([深])获取此估计量的参数。
get_precision()用生成模型计算数据精度矩阵。
inverse_transform(X)将数据转换回其原始空间。
score(X [,y])返回所有样本的平均对数似然率。
score_samples(X)返回每个样本的对数似然。
set_params(**参数)设置此估算器的参数。
transform(X)对X应用降维。
迷你案例
(1)调用库和模块
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.decomposition import PCA
(2)提取数据集
iris = load_iris()
y = iris.target
x = iris.data
#作为数组,x是几维
x.shape
#作为数据表或者特征矩阵,x是几维?
import pandas as pd
pd.DataFrame(x)
(3)建模
#调用PCA
pca = PCA(n_componenets = 2)#实例化
pca = pca.fit(x)#拟合模型
x_dr = pca.transform(x)#获取新矩阵
x_dr
#也可以fit_transform一步到位
#x_dr = PCA(2).fit_transform(x)
(4)可视化
#要将三种鸢尾花的数据分布显示在二维平面坐标中,对应的两个坐标(两个特征向量)应该是三种鸢尾花降维后的x1和x2
"""
plt.figure()
plt.scatter(x_dr[y == 0,0],x_dr[y == 0,1],c = "red",label = iris.target_names[0])
plt.scatter(x_dr[y == 1,0],x_dr[y == 1,1],c = "black",label = iris.target_names[1])
plt.scatter(x_dr[y == 2,0],x_dr[y == 2,1],c = "orange",label = iris.target_names[2])
plt.legend()
plt.title("PCA of iris dataset")
plt.show()
"""
#for 循环
colors = ['red','black','orange']
iris.target_names
plt.figure()
for i in [0,1,2]:
	plt.scatter(x_dr[y == i,0]
	,x_dr[y==i,1]
	,alpha = .7
	,c = colors[i]
	,label = iris.target_names[i]
	)
plt.legend()
plt.title("PCA of iris dataset")
plt.show()
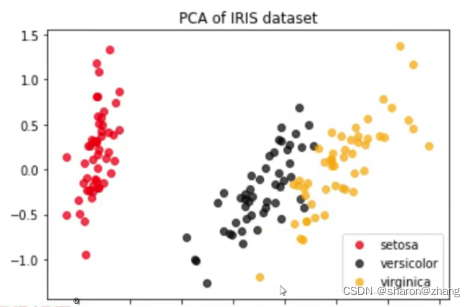
(5)探索降维后的数据
#属性explained_variance,查看降维后每个新特征向量上所带的信息量大小(可解释性方差的大小)
pca.explained_variance_
#属性explained_variance_ratio,查看降维后每个新特征向量所占的信息量占原始数据总信息量的百分比
#又叫可解释方差贡献率
pca.explained_variance_ratio_
# 大部分信息都被有效的集中在了第一个特征上
pca.explained_variance_ratio_.sum()
3.2 PCA与SVD原理
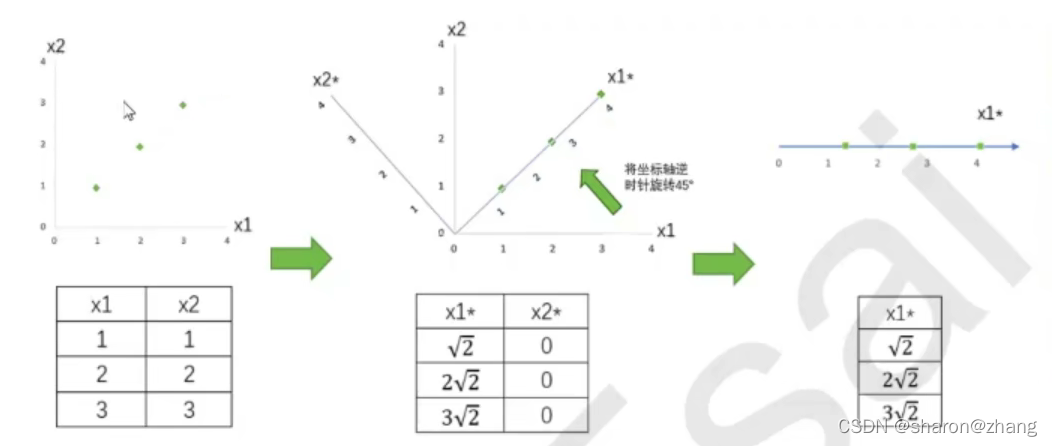
降维过程:
二维为例:
降维的重要步骤:
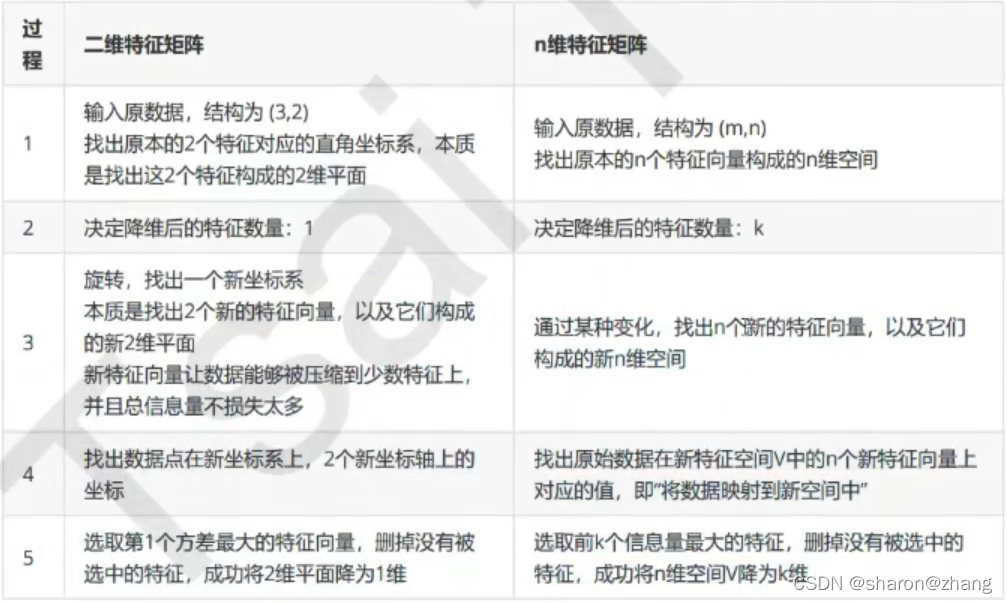
在步骤3当中,我们用来找出n个新特征向量,让数据能够被压缩到少数特征上并且总信息量不损失太多的信息技术称为矩阵分解。PCA和SVD是两种不同的降维算法,但他们都遵从上面的过程来实现降维,只是两种算法中矩阵分解的方法不同,信息量的衡量指标不同罢了。
PCA使用方差作为信息量的衡量指标,并且特征值分解来找出空间V。降维时,它会通过一系列数学的神秘操作(比如说,产生协方差矩阵 1 n X X T \frac{1}{n}XX^{T} n1XXT),将特征矩阵X分解为以下三个矩阵,其中 Q Q Q和 Q − 1 Q^{-1} Q−1是辅助的矩阵,∑是一个对角矩阵(即除了对角线上有值,其他位置都是0的矩阵),其对角线上的元素就是方差。降维完成之后,PCA找到的每个新特征向量就叫做“主成分”,而被丢弃的特征向量被认为信息量很少,这些信息很可能就是噪声。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)